
حجم عينة الاستبيان هو عدد الردود المكتملة التي يشملها تحليلك، ويُرمز له بـ n. وهو يختلف عن عدد الدعوات أو عدد الأشخاص في قائمتك. ووفق افتراضات العينة التي تعتمدها الحاسبة، تُضيّق العينة الأكبر هامش الخطأ؛ لكنها لا تزيل الاستقطاب المتحيز ولا الأسئلة سيئة الصياغة.
حاسبة حجم العينة
لا شيء مخفي خلف شرط إنشاء حساب، ولا يُرسل أي شيء إلى أي مكان. تعمل الحاسبة في متصفحك، وتبدأ بإجابة محسوبة معروضة على الشاشة مسبقًا، وتطبع المعادلة والحساب الذي استخدمته لتتمكن من التحقق منه أو إعادته يدويًا.
كم ردًا أحتاج؟
اضبط مدخلاتك الستة. تتحدث الإجابة والمعادلة والحساب كلها أثناء الكتابة.
الردود المكتملة التي تحتاجها
370
بعد تصحيح المجتمع المحدود.
الأشخاص الذين ترسل إليهم دعوة
1,234
عند معدل استجابة 30 في المئة.
نسبة العينة إلى المجتمع
3.7%
حصة مجتمع الدراسة التي تحتاج إلى سماع رأيها.
الإجمالي، محسوبًا لكل مجموعة فرعية
370
الحساب، خطوة بخطوة
| هامش الخطأ | الردود المكتملة المطلوبة | الدعوات المطلوبة |
|---|
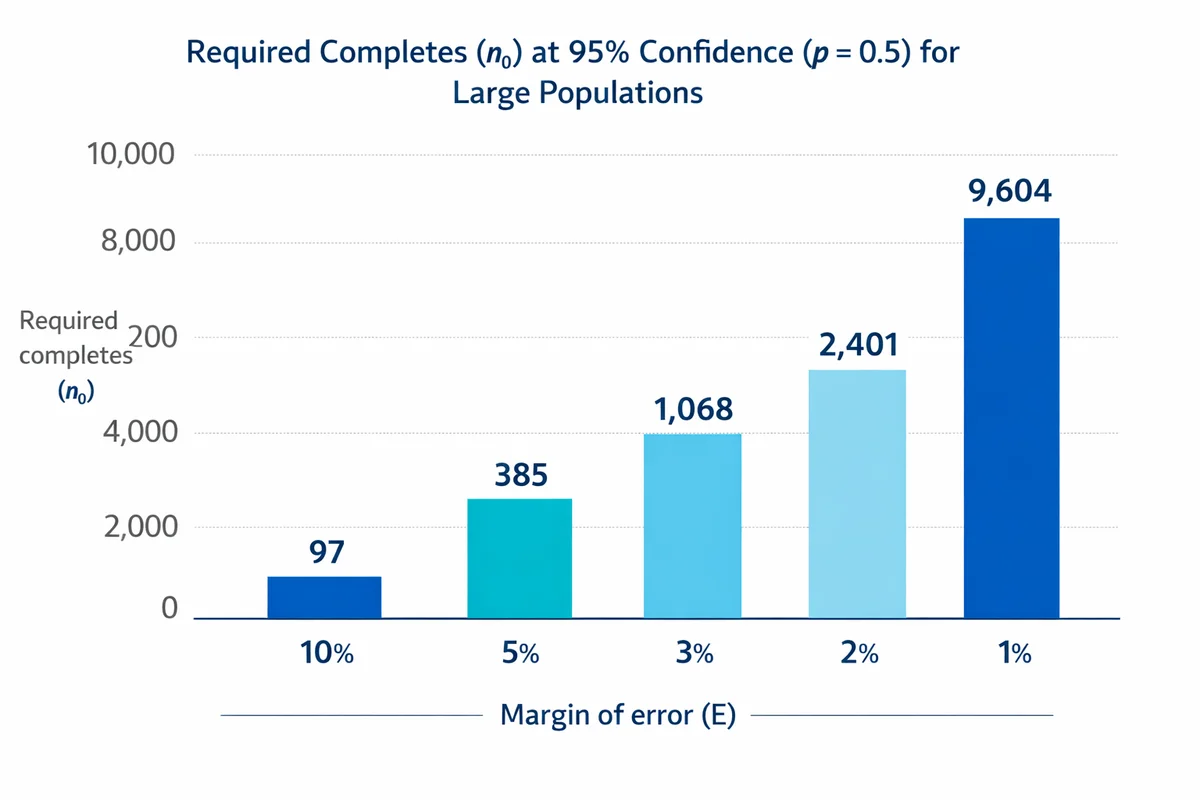
الدقة الأعلى تكلّف ردودًا بما يقارب مربع مقدار التحسين. فتنصيف هامش الخطأ يضاعف العينة نحو أربع مرات.
يكتب زر النسخ فقرة منهجية قصيرة بأرقامك والمعادلة والمرجع، جاهزة للصقها في ملخص مشروع أو فصل المنهجية.
استشهد بهذه الحاسبة: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
النتيجة هي ردود مكتملة، لا دعوات. إنها العدد الذي تحتاج إلى أن يكون بين يديك في نهاية العمل الميداني. أما عدد الدعوات فهو هذا العدد مقسومًا على معدل الاستجابة الذي تتوقعه، وهنا تخطئ معظم خطط العينات. وبعد تحديد الهدف، أنشئ استبيانك وأجرِ له تطبيقًا تجريبيًا مع الجمهور المقصود. واستخدم التطبيق التجريبي للتحقق من الصياغة وتقدير معدل التحول من الدعوة إلى الإكمال في مشروعك.
ما معنى حجم العينة
حجم العينة هو عدد الأشخاص الذين يكملون استبيانك. ويُرمز له بـ n في كل معادلة في هذه الصفحة، وهو الكمية الوحيدة التي تحصل عليها بالعمل الميداني بدلًا من أن تختارها على الورق، وهو الرقم الذي يُحسب منه هامش الخطأ لديك.
ثلاثة أعداد يُخلط بينها وبينه، والتمييز بينها هو معظم ما تفعله خطة العينة:
- مجتمع الدراسة (N): كل من تريد وصفهم. قائمة عملاء، أو عدد الموظفين، أو دولة.
- الدعوات: عدد الأشخاص الذين تتواصل معهم. وهو دائمًا أكبر من n، لأن ليس الجميع يجيبون.
- حجم العينة (n): عدد الردود المكتملة التي بين يديك حين ينتهي العمل الميداني. وهو العدد الذي تحسبه المعادلة، والوحيد من الثلاثة الذي يغيّر هامش الخطأ لديك.
حجم العينة يمنحك الدقة الإحصائية، أي عرض نطاق الزائد أو الناقص حول كل نتيجة. لكنه لا يمنحك صحة النتيجة، أي ما إذا كان من أجابوا يشبهون من لم يجيبوا. فقد تكون عينة ميسّرة كبيرة أبعد عن الحقيقة من عينة عشوائية صغيرة، ولا توجد قيمة لـ n تصلح ذلك. ويتناول قسم أين يخطئ التخطيط لحجم العينة هذا الفرق، وطريقة سحب العينة هي ما يحسمه.
الإجابة المختصرة، إن كنت تريد رقمًا فقط
أرقام أساسية
- 385 ردًا مكتملًا هي الإجابة الافتراضية. وهذا ما تعطيه المعادلة عند مستوى ثقة 95 في المئة، وهامش خطأ زائد أو ناقص 5 نقاط مئوية، ودون تقدير مسبق للنتيجة.
- المجتمعات الصغيرة تحتاج إلى عدد أقل بكثير. فقائمة من 1,000 شخص تحتاج إلى 278. وقائمة من 100 تحتاج إلى 80. وهذا هو أثر تصحيح المجتمع المحدود.
- الدقة مكلفة. تنصيف هامش الخطأ يضاعف العينة نحو أربع مرات. والانتقال من زائد أو ناقص 5 نقاط إلى زائد أو ناقص 1 نقطة يأخذك من 385 إلى 9,604.
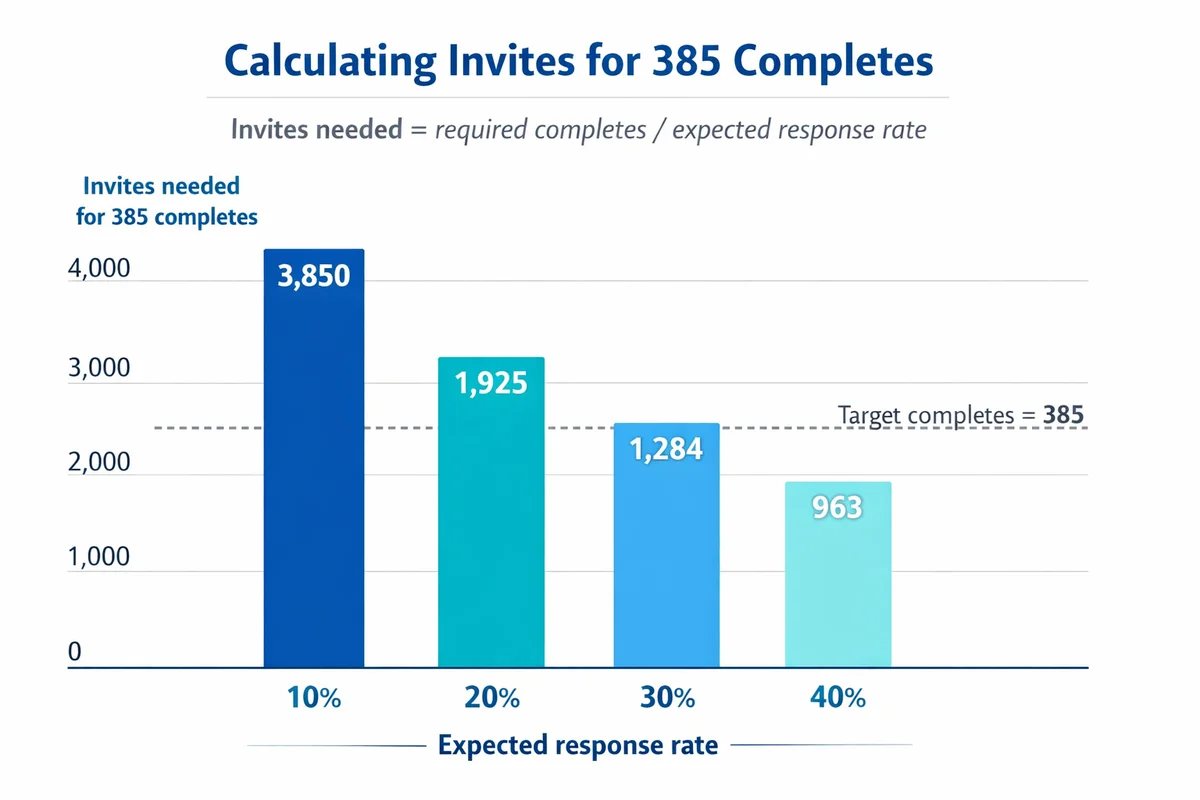
- المعادلات تحسب الردود المكتملة لا الدعوات. عدد الدعوات المطلوبة يساوي عدد الردود المكتملة مقسومًا على معدل الاستجابة المتوقع. فعند 30 في المئة، تعني 385 ردًا مكتملًا إرسال دعوة إلى 1,284 شخصًا.
- هامش الخطأ يغطي نوعًا واحدًا من الخطأ. فهو يقيس التشويش الناتج عن سحب عينة من بعض الأشخاص بدلًا من جميعهم. ولا يقول شيئًا عن الأشخاص الذين لم يجيبوا قط.
معادلة حجم العينة، وكيف تحسبه يدويًا
في الاستبيان الذي يعرض نسبة مئوية، تكون نقطة البداية المعتادة حجم العينة لمجتمع دراسة كبير بما يكفي لمعاملته على أنه غير محدود:
n0 = (z^2 x p x (1 - p)) / E^2
قراءتها من اليسار إلى اليمين:
- n0 هو عدد الردود المكتملة المطلوب، قبل أي تصحيح لحجم المجتمع.
- z هي الدرجة المعيارية z لمستوى الثقة لديك. استخدم 1.96 لمستوى 95 في المئة.
- p هي النسبة التي تتوقع قياسها، بصيغة عشرية. استخدم 0.5 إن كنت لا تعرفها.
- E هو هامش الخطأ بصيغة عشرية. خمس نقاط مئوية تساوي 0.05.
رمز حجم العينة هو n. وتكتب بعض المصادر الرقم غير المصحح n0 والمصحح n، وهو الاصطلاح المستخدم هنا.
| مستوى الثقة | z | ما يكلّفك |
|---|---|---|
| 80 في المئة | 1.282 | 165 ردًا مكتملًا عند زائد أو ناقص 5 نقاط |
| 90 في المئة | 1.645 | 271 ردًا مكتملًا |
| 95 في المئة (المعتاد) | 1.960 | 385 ردًا مكتملًا |
| 99 في المئة | 2.576 | 664 ردًا مكتملًا |
| 99.9 في المئة | 3.291 | 1,084 ردًا مكتملًا |
مثال تطبيقي: من 385 إلى قائمة دعوات
السيناريو. تريد معرفة نسبة العملاء الذين سيوصون بك. وتريد مستوى ثقة 95 في المئة وزائد أو ناقص 5 نقاط. وليس لديك تقدير مسبق، لذا p = 0.5.
اختر مستوى الثقة وهامش الخطأ
مستوى ثقة 95 في المئة يجعل z = 1.96. وزائد أو ناقص 5 نقاط مئوية يعني E = 0.05.
اختر النتيجة المتوقعة
p = 0.5، لأنه لا يوجد تقدير مسبق، والقيمة 0.5 تعطي أكبر عينة. فلا شيء تعرفه لاحقًا يمكن أن يتركك بعدد ناقص.
طبّق معادلة حجم العينة
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
قرّب إلى الأعلى: 385 ردًا مكتملًا. قرّب إلى الأعلى دائمًا، فلا يمكنك جمع جزء من استبيان.
صحّح لمجتمع دراسة صغير
إذا كان هؤلاء العملاء قائمة من 1,000 شخص لا سوقًا مفتوحة، فطبّق التصحيح: n = 384.16 / (1 + 383.16 / 1,000) = 384.16 / 1.38316 = 277.7، أي 278 ردًا مكتملًا. ولا يكون للتصحيح أثر ملموس إلا حين تصبح العينة حصة كبيرة من مجتمع الدراسة.
حوّل الردود المكتملة إلى دعوات
عند معدل استجابة 30 في المئة، الدعوات = 278 / 0.30 = 926.7، فأرسل دعوة إلى 927 شخصًا. فالردود المكتملة هي ما تحسبه المعادلة، والدعوات هي ما ترسله فعلًا، ولا يمكن أن تتجاوز مجتمع الدراسة الذي تسحب منه.
عند مستوى ثقة 95 في المئة مع p = 0.5، تختصر المعادلة كلها إلى 0.9604 مقسومًا على مربع E. وهذا الاختصار الواحد يجيب عن معظم أسئلة حجم العينة في سطر واحد، ولهذا يظهر الرقم 385 مرارًا في جداول حجم العينة التي تجدها في أماكن أخرى.
جدول حجم العينة لأحجام المجتمع الشائعة
حُسبت هذه الأرقام بالمعادلة أعلاه عند مستوى ثقة 95 في المئة، وزائد أو ناقص 5 نقاط، وp = 0.5، ثم صُححت بحسب حجم مجتمع الدراسة. والعمودان الأخيران مراجعتنا الخاصة مقارنةً بالجدول الذي نشره Krejcie وMorgan عام 1970، وهو الجدول الذي تستشهد به معظم فصول المنهجية.
| مجتمع الدراسة (N) | الردود المكتملة المطلوبة | Krejcie وMorgan (1970) | الفرق |
|---|---|---|---|
| 10 | 10 | 10 | مطابق |
| 25 | 24 | غير مدرج | |
| 50 | 45 | 44 | أكثر بـ 1 |
| 100 | 80 | 80 | مطابق |
| 200 | 132 | 132 | مطابق |
| 500 | 218 | 217 | أكثر بـ 1 |
| 1,000 | 278 | 278 | مطابق |
| 2,000 | 323 | 322 | أكثر بـ 1 |
| 5,000 | 357 | 357 | مطابق |
| 10,000 | 370 | 370 | مطابق |
| 50,000 | 382 | 381 | أكثر بـ 1 |
| 100,000 | 383 | 384 | أقل بـ 1 |
كيف راجعناه. طبّقنا المعادلة على 21 حجمًا لمجتمع الدراسة، وقارنّا كل نتيجة بالقيمة المنشورة لدى Krejcie وMorgan. فتطابقت اثنتا عشرة نتيجة تمامًا، واختلفت التسع الأخرى بفارق رد واحد بالضبط، وهو ناتج عن موضع التقريب في كل طريقة، لا عن خلاف في الحساب. فإن سألك مشرف لماذا يختلف رقمك عن الجدول بواحد، فهذا هو السبب.
من المفيد أن تعرف إن كنت تستشهد بذلك الجدول: لم يشتق Krejcie وMorgan معادلتهما الخاصة. فورقتهما المنشورة عام 1970 تقع في نحو 400 كلمة وجدول واحد، ومرجعها الوحيد ينسب المعادلة إلى نشرة بحثية صدرت عام 1960 عن الجمعية الوطنية للتعليم (National Education Association). ولا يزال ملخصهما للنمط أفضل وصف له في سطر واحد: أنه كلما كبر مجتمع الدراسة زادت العينة المطلوبة بمعدل متناقص، حتى تستقر عند ما يزيد قليلًا على 380 حالة.
اختيار المدخلات، واحدًا تلو الآخر
أربعة أرقام تحدد الإجابة. ثلاثة منها قرارات لا حقائق، ولكل منها طريقة لاختياره يمكن الدفاع عنها.
مستوى الثقة: كم مرة تصيب الطريقة
مستوى الثقة يصف الطريقة، لا هذا الاستبيان بعينه. فعند مستوى ثقة 95 في المئة، تحتوي الفترات المبنية بهذه الطريقة على القيمة الحقيقية 95 مرة من كل 100 على المدى الطويل. وهذا لا يعني أن احتمال صحة إجابتك المحددة 95 في المئة.
استخدم 95 في المئة ما لم يكن لديك سبب لغير ذلك. فالانتقال إلى 99 في المئة يرفع العينة من 385 إلى 664 للدقة نفسها، أي زيادة في التكلفة بنسبة 72 في المئة مقابل مكسب ضئيل جدًا. والفكرة المقابلة في اختبار الفرضيات هي ألفا، ولهذا يخلط الناس بينهما. وإن كان هذا التمييز غامضًا لديك، فاقرأ الدلالة الإحصائية ومعنى القيمة الاحتمالية قبل أن تختار رقمًا.
هامش الخطأ: متغير القرار
هذا هو المدخل الذي يستحق أكبر قدر من التفكير، لأنه الوحيد الذي يربط العينة بقرار. اختره بأن تسأل نفسك: ما الفارق الذي سيغيّر ما تفعله؟
إذا كنت ستتصرف بشكل مختلف حين يكون الرضا 72 في المئة بدلًا من 74 في المئة، فأنت تحتاج إلى هامش ضيق. وإذا كنت لن تتصرف إلا عند 72 مقابل 82، فزائد أو ناقص 5 نقاط يكفي تمامًا. وعادةً ما تستقر التقارير العامة على 5 نقاط لقياس سريع للنبض أو 3 نقاط للتتبع المستمر. وتحت 2 نقطة ترتفع التكلفة بسرعة.
حجم مجتمع الدراسة: لا أهمية له غالبًا، إلى أن تصبح له أهمية
في المجتمعات الكبيرة لا تكاد العينة المطلوبة تتحرك. فعشرة آلاف شخص يحتاجون إلى 370 ردًا، ومئة ألف يحتاجون إلى 383. ولا يكون لحجم مجتمع الدراسة أثر إلا حين تكون عينتك حصة معتبرة منه، كما في قوائم الموظفين وسجلات الأعضاء ودفعات الطلاب في المدارس. وهذا ما يعالجه القسم التالي.
النتيجة المتوقعة (p): استخدم 0.5 حين لا تعرفها
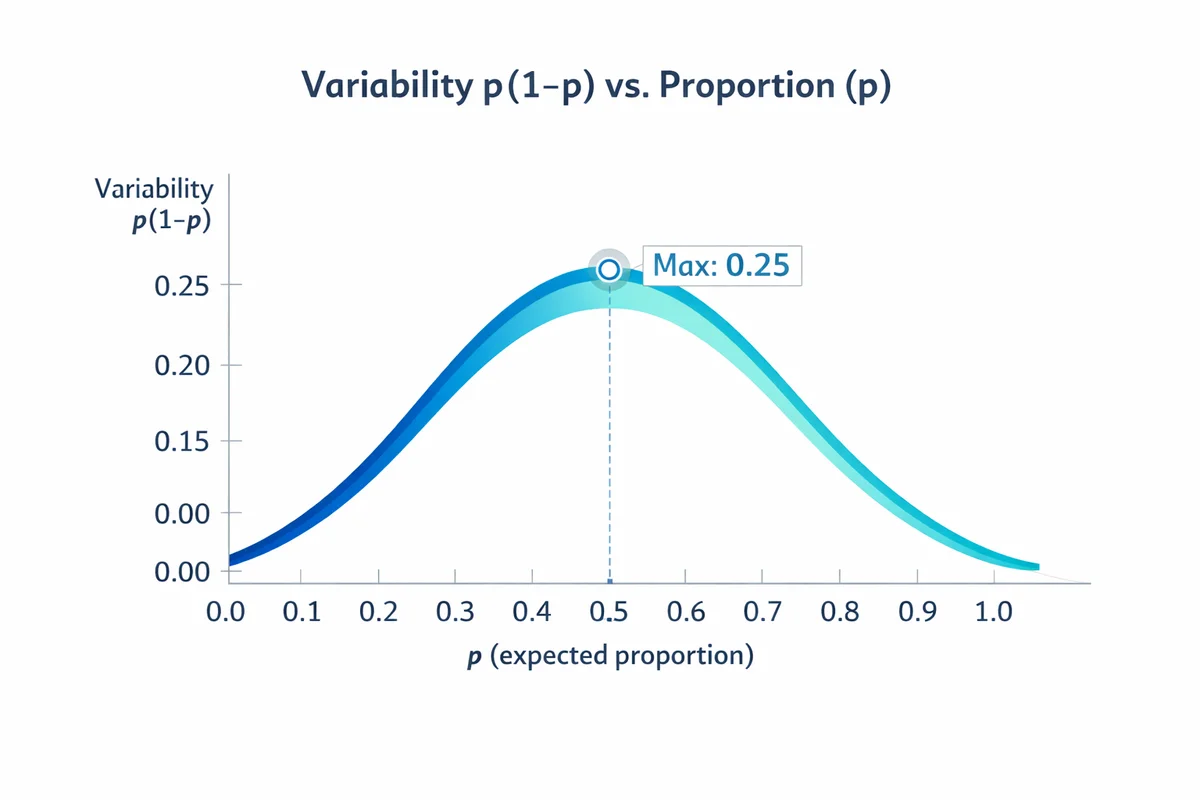
في سؤال النسبة المئوية، يتحدد عدم اليقين بحاصل ضرب p في (1 ناقص p). وهذا الحد يبلغ أقصاه عند p = 0.5، لذا فإن 0.5 هو الخيار المتحفظ الذي يعطي أكبر عينة. وهو القيمة الافتراضية الصحيحة حين لا يكون لديك تقدير مسبق.
وإن كان لديك تقدير فاستخدمه، لأن التوفير كبير. فعند مستوى ثقة 95 في المئة وزائد أو ناقص 5 نقاط، تطلب p = 0.5 عدد 385 ردًا، بينما تطلب p = 0.9 عدد 139. والاستبيانات السابقة، أو التطبيق التجريبي، أو معيار مرجعي منشور، كلها مصادر مقبولة لهذا التقدير. والأسئلة المشوِّشة تضخّم التشتت أيضًا، لذا فالصياغة الأوضح قد تجعل النتيجة أكثر استقرارًا دون أي ردود إضافية. وكتابة أسئلة استبيان أفضل كثيرًا ما تكون أرخص من جمع مزيد من الردود.
المجتمعات الصغيرة: تصحيح المجتمع المحدود
تفترض المعادلة الأساسية أنك تسحب من مخزون عميق بما يكفي بحيث لا يغيّر سحب الأشخاص منه شيئًا. وحين تصبح عينتك شريحة حقيقية من مجتمع الدراسة، يحمّلك هذا الافتراض أكثر مما ينبغي. وتصحيح المجتمع المحدود يعيد إليك تلك الردود.
n = n0 / (1 + ((n0 - 1) / N))
- n هو العدد المصحح من الردود المكتملة الذي تحتاجه.
- n0 هو الرقم غير المصحح من المعادلة أعلاه.
- N هو حجم مجتمع الدراسة.
والقاعدة المعتادة لتطبيقه أن تزيد n0 على نحو 5 في المئة من N. وتحت ذلك لا يكاد التصحيح يغيّر شيئًا، فلا يستحق أن تشرحه لأحد.
مثال تطبيقي: استبيان للموظفين
السيناريو. لديك 1,200 موظف. وتريد مستوى ثقة 95 في المئة، وزائد أو ناقص 5 نقاط، وتستخدم p = 0.5.
- دون تصحيح، n0 = 384.16.
- بعد التصحيح: n = 384.16 / (1 + (383.16 / 1,200)) = 384.16 / 1.3193 = 291.2.
- قرّب إلى الأعلى: 292 ردًا مكتملًا.
دون التصحيح ستلاحق 385 ردًا من قائمة من 1,200، أي 32 في المئة من الجميع. ومع التصحيح، يمنحك 292 ردًا الدقة نفسها. وفي قائمة بهذا الحجم يعني ذلك شهرًا من الملاحقة لست مضطرًا إليه.
تحت نحو 200 شخص تصبح العينة المصححة حصة كبيرة من القائمة إلى حد أن دعوة الجميع أبسط وأسهل في الدفاع عنها. فالحصر الشامل لـ 150 شخصًا ليس فيه أي خطأ ناتج عن العينة. ويذهب جهدك عندئذ إلى معدل الاستجابة وإلى من هم غائبون، وهذا هو الموضع الصحيح له.
هامش الخطأ: المعادلة نفسها، معكوسة
هامش الخطأ هو نطاق الزائد أو الناقص حول نتيجة الاستبيان، الناتج عن سؤال بعض الأشخاص بدلًا من جميعهم. فإذا اختار 62 في المئة من 385 مشاركًا خيارًا ما وكان هامش الخطأ 5 نقاط، فإنك تعرض 62 في المئة وتذكر أن النطاق المعقول يمتد من 57 إلى 67 في المئة.
إعادة ترتيب معادلة حجم العينة لإيجاد E تعطي:
E = z x الجذر التربيعي لـ (p x (1 - p) / n)
ومع مجتمع دراسة محدود، اضرب ذلك في الجذر التربيعي لـ (N - n) مقسومًا على (N - 1). والصيغتان كلتاهما موجودتان في الحاسبة أدناه، التي تنتقل بينهما تلقائيًا حين تحدد مربع مجتمع الدراسة أو تلغي تحديده.
ما هامش الخطأ في الردود التي لديّ بالفعل؟
المعادلة نفسها، بعد إعادة ترتيبها. أدخل الردود التي جمعتها واقرأ الدقة الناتجة.
هامش الخطأ
5.0
نقاط مئوية، زائدًا أو ناقصًا.
الفترة لديك
45.0 إلى 55.0
نسبة مئوية، عند مستوى ثقة 95 في المئة.
الحساب، خطوة بخطوة
هل يزيد هامش الخطأ مع حجم العينة؟
إنه يتقلص كلما زاد الجذر التربيعي لـ n. وهذا الجذر التربيعي هو اقتصاد الاستبيانات كله. فأربعمئة رد تعطيك نصف خطأ مئة رد. ولتنصيفه مرة أخرى تحتاج إلى 1,600. وكل منزلة عشرية إضافية من الدقة تكلّف نحو أربعة أضعاف العمل الميداني، ولهذا يُعد 385 نقطة وصول شائعة جدًا: فعنده تتوقف التكلفة والدقة عن التنازع.
أربعة مصطلحات يخلط الناس بينها
يُستخدم الخطأ المعياري وهامش الخطأ ومستوى الثقة وفترة الثقة كأنها قابلة للتبادل. لكنها أربعة أشياء مختلفة، والفرق مهم حين يشكك أحد في رقمك.
| المصطلح | ما هو | عند 385 ردًا و50 في المئة |
|---|---|---|
| الخطأ المعياري | التشتت الخام للتقدير. الجذر التربيعي لحاصل ضرب p في (1 ناقص p) مقسومًا على n. | 0.0255، أي 2.55 نقطة مئوية |
| هامش الخطأ | الخطأ المعياري مضروبًا في الدرجة المعيارية z لمستوى الثقة الذي اخترته. | زائد أو ناقص 5.0 نقاط عند 95 في المئة |
| مستوى الثقة | قيمة z التي اخترتها، معبَّرًا عنها بنسبة مئوية. إنها اختيار لا قياس. | 95 في المئة، أي z = 1.96 |
| فترة الثقة | النتيجة بعد تطبيق هامش الخطأ، مكتوبةً على شكل نطاق. | من 45.0 في المئة إلى 55.0 في المئة |
الخلاصة: الخطأ المعياري خاصية في بياناتك، ومستوى الثقة اختيار قمت به، وهامش الخطأ حاصل ضرب الاثنين، وفترة الثقة هي ما تطبعه في التقرير.
ما لا يغطيه هامش الخطأ
إنه يغطي خطأ العينة العشوائي ولا شيء غيره. فلا يغطي الأشخاص الذين تجاهلوا الدعوة، ولا قائمة كان ينقصها جزء من مجتمع الدراسة، ولا سؤالًا قرأه نصف المشاركين بطريقة مختلفة عمّا قصدته. فقد يكون للاستبيان هامش خطأ مرتب ويظل مخطئًا. راجع تحيز الاستجابة وتحيز عدم الاستجابة لمعرفة الأخطاء التي لا يصلحها أي حجم للعينة.
وتقول الهيئة المهنية لأبحاث الاستبيانات هذا بصراحة أكبر مما تقوله معظم الشركات. إذ تذكر AAPOR أنه لا يوجد شيء اسمه هامش خطأ إجمالي قابل للقياس لأي استطلاع، لأن الاستبيانات تحمل أخطاء أخرى لا يمكن قياسها إطلاقًا، من طريقة كتابة الأسئلة إلى طريقة إجراء المقابلات. فما يمكنك حسابه هو الجزء الخاص بالعينة. وهذا هو الجزء الذي تعطيك إياه الحاسبة، ومن المهم أن يكون واضحًا أنه جزء فقط.
قاعدتان للاستخدام من المصدر نفسه، تخطئ فيهما معظم الكتابات عن الاستبيانات:
- إنه نقاط مئوية، لا نسبة مئوية. اكتب «زائد أو ناقص 3 نقاط مئوية»، لا «زائد أو ناقص 3 في المئة». فلكل منهما معنى مختلف.
- لا ينطبق إطلاقًا على عينات التسجيل الطوعي. فهامش الخطأ يفترض أن لكل شخص احتمال اختيار معروفًا وغير صفري. والرابط المفتوح، أو لوحة المتطوعين، أو منشور على وسائل التواصل الاجتماعي لا يحقق ذلك. ونشر هامش خطأ بجانب نتائج من رابط مفتوح ادعاءٌ لدقة لم تدفع ثمنها.
تحويل الردود المكتملة إلى دعوات
تعطيك المعادلة الردود المكتملة، ويعطيك العمل الميداني معدل الاستجابة. وفي الفجوة بينهما تفشل خطط العينات عادةً، والحساب سطر واحد:
الدعوات = الردود المكتملة المطلوبة / معدل الاستجابة المتوقع
استخدم المعدل بصيغة عشرية، فـ 30 في المئة تساوي 0.30، وقرّب إلى الأعلى. فلـ 292 ردًا مكتملًا عند 35 في المئة، يكون الناتج 292 مقسومًا على 0.35 = 834.3، فأرسل دعوة إلى 835 شخصًا على الأقل.
| الردود المكتملة المطلوبة | معدل الاستجابة المتوقع | الدعوات |
|---|---|---|
| 385 | 60 في المئة | 642 |
| 385 | 30 في المئة | 1,284 |
| 385 | 15 في المئة | 2,567 |
| 292 | 50 في المئة | 584 |
| 292 | 35 في المئة | 835 |
| 292 | 20 في المئة | 1,460 |
اختيار معدل استجابة يمكنك الدفاع عنه
تاريخك الخاص أفضل من أي معيار مرجعي منشور، ما دام الجمهور نفسه والقناة نفسها وطول الاستبيان متقاربًا. وإن لم يكن لديك ما تستند إليه، فخطّط لثلاثة سيناريوهات عند 20 و30 و40 في المئة، وتعامل مع قائمة الدعوات على أنها أداة قابلة للتعديل أثناء العمل الميداني. فالتذكيرات، ومدة أطول، وقائمة أوسع، كلها أمور يمكنك تغييرها في منتصف الطريق. أما هدف الردود المكتملة فلا.
تذكر معظم جداول المعايير المرجعية على الإنترنت متوسطًا واحدًا دون مصدر. ولا يوجد متوسط واحد. وإليك ما تذكره المصادر الأولية فعلًا، لتستشهد بالصف الذي يطابق وضعك بدلًا من رقم اختلقه أحدهم.
| السياق | معدل الاستجابة | الحجم والمصدر |
|---|---|---|
| الوكالات الفيدرالية الأمريكية التي يقل موظفوها عن 1,000 | 71 في المئة | استبيان آراء الموظفين الفيدراليين لعام 2024 (OPM) |
| الوكالات الفيدرالية الأمريكية التي يتراوح موظفوها بين 1,000 و9,999 | 60 في المئة | الاستبيان نفسه، العام نفسه (OPM) |
| الوكالات الفيدرالية الأمريكية التي يزيد موظفوها على 75,000 | 37 في المئة | الاستبيان نفسه، العام نفسه (OPM) |
| جميع الموظفين الفيدراليين الأمريكيين | 41 في المئة | أكثر من 1.6 مليون مدعو، وأكثر من 674,000 استجابوا، 2024 (OPM) |
| الاستبيانات الإلكترونية المنشورة، بجميع أنواعها | متوسط 44.1 في المئة | تحليل بعدي لـ 1,071 معدلًا منشورًا (Wu وزملاؤه، 2022) |
| البحوث التنظيمية المنشورة | 68 في المئة في 2020، ارتفاعًا من 48 في المئة في 2005 | 1,014 استبيانًا في 17 مجلة علمية (Holtom وزملاؤه، 2022) |
| الاستطلاعات الهاتفية لعامة الناس | 6 في المئة في 2018، انخفاضًا من 36 في المئة في 1997 | المعدل الذي يتتبعه Pew Research Center بنفسه (Kennedy وHartig، 2019) |
| الويب مقابل أي وسيلة أخرى | أقل بنحو 12 نقطة | تحليل بعدي لـ 114 مقارنة تجريبية (Daikeler وزملاؤه، 2020) |
يخرج من هذا الجدول أمران. أولًا، حجم المجموعة التي تستطلع آراءها يتنبأ بالمعدل أفضل من أي شيء آخر تقريبًا تتحكم فيه. فشركة من 300 شخص ووكالة من 300,000 شخص لا تجريان الاستبيان نفسه. ثانيًا، الادعاء المتكرر بأن معدلات الاستجابة تنهار في كل مكان صحيح في بعض الأماكن فقط. فالاستطلاعات الهاتفية انهارت فعلًا، أما البحوث التنظيمية المنشورة فسارت في الاتجاه المعاكس، من 48 في المئة إلى 68 في المئة على مدى خمسة عشر عامًا.
وحساب تخطيطي آخر يستحق أن تستعيره: التوجيه المعتاد في برامج الإرشاد هو أن تضيف نحو 10 في المئة إلى قائمة الدعوات للأشخاص الذين لا يمكنك الوصول إليهم ببساطة، ونحو 30 في المئة للأشخاص الذين يستطيعون الإجابة ولا يجيبون.
ما تقوله مجموعة قوالبنا عن الطول
معدل الاستجابة المستعار من استبيان شخص آخر لا ينتقل جيدًا، والطول من الأمور القليلة في تلك القائمة التي تتحكم فيها كليًا. وإليك رقمًا نستطيع إنتاجه ولا يستطيعه المنافس، لأنه مأخوذ من عدّ مجموعتنا المنشورة لا من سؤال الممارسين عمّا يظنون أنهم يفعلونه.
في مراجعتنا بتاريخ 21 أغسطس 2026، كانت قوالب الاستبيانات الـ 87 كلها من 14 سؤالًا أو أقل، و86 منها من 10 أسئلة أو أقل. وضمّت معًا 799 سؤالًا. وكان الوسيط 9 أسئلة، وتجاوز قالب واحد بالضبط 10 أسئلة. وتصف هذه الأرقام تلك اللقطة المؤرخة، لا المكتبة الحالية.
| عدد الأسئلة في القالب | القوالب | الحصة من المجموعة |
|---|---|---|
| 7 أسئلة | 4 | 5 في المئة |
| 8 أسئلة | 17 | 20 في المئة |
| 9 أسئلة | 29 | 33 في المئة |
| 10 أسئلة | 36 | 41 في المئة |
| 14 سؤالًا | 1 | 1 في المئة |
بحسب صيغة الإجابة، فإن 355 من الأسئلة الـ 799 مقاييس تقييم، و281 قوائم اختيار فردي، و163 تطلب من القارئ أن يكتب شيئًا. وهذه المجموعة الأخيرة هي التي تكلّفك ردودًا مكتملة، لذا قرأناها يدويًا بدلًا من الثقة بالحقل المخزّن. ومن الـ 163، 137 مربعات تعليق متعددة الأسطر. والـ 26 الأخرى مربعات من سطر واحد، وأظهرت قراءتها أن 22 منها حقول تعريف أو تصنيف قصيرة: اسم، أو عنوان بريد إلكتروني، أو تاريخ، أو قسم، أو مسمى وظيفي. و4 فقط إجابات قصيرة ذات مضمون. لذا فالعدد الصادق للأسئلة المفتوحة فعلًا هو 141، أي نحو سؤال واحد من كل ستة، لا سؤال من كل خمسة كما كان سيعطينا الحقل الخام.
كيف عددنا، وكيف تحققنا. حللنا قائمة الأسئلة المخزنة لكل قالب استبيان منشور على هذا الموقع في 21 أغسطس 2026، واحتفظنا بالعناصر التي تحمل نص سؤال، ثم جلبنا كل صفحة منشورة وقارنّا المجموعتين بدلًا من الثقة بقاعدة بياناتنا وحدها. فأعادت الصفحات الـ 87 كلها HTTP 200، بينما أعاد رابط نعرف أنه معطل 410 في التشغيل نفسه، فكان التحقق قادرًا على التمييز لا ناجحًا على الدوام. 785 من الأسئلة الـ 799، أي 98 في المئة، تظهر في الصفحة المنشورة. وستة من هذه التطابقات تختلف عن قاعدة البيانات فقط في نوع حرف الفاصلة العليا المستخدم، وقد عددناها تطابقات، ونفضّل الإفصاح عن ذلك على تقريبه بصمت. وتحقق ستة وثمانون قالبًا من القوالب الـ 87 بالكامل. والقالب الذي لم يتحقق هو أطولها، بـ 14 سؤالًا، وصفحته المنشورة لا تعرض حاليًا أي أسئلة معاينة، فلم يمكن تأكيد أسئلته من الخارج.
طول القالب لا يخبرك بمعدل الاستجابة للدعوات. فـالمعيار المرجعي لاستجابة الاستبيانات المنفصل لدينا يدرس السلوك بعد تفاعل الأشخاص مع الاستبيان؛ ولا يعدّ كل من دُعوا. وللتخطيط للدعوات، استخدم معدلًا موثقًا من مشروع مماثل أو من تطبيق تجريبي، وحافظ على اتساق المقام.
والاستخدام العملي محدود وحقيقي. فإذا كنت تستعير معدل استجابة لحساب عدد الدعوات في الحاسبة، فاستعره من استبيان بطول الاستبيان الذي توشك على إرساله تقريبًا، لجمهور مماثل عبر قناة مماثلة. وأدواتنا المنشورة تقع بين 7 و10 أسئلة، وهذا أقصر مما تبدأ به معظم المسودات.
زيادة الدعوات لا تعني تحيزًا أقل
معدل الاستجابة المنخفض يخلق مشكلتين تبدوان كمشكلة واحدة. الأولى أنك تنتهي دون هدفك، فيكون هامش الخطأ أوسع مما خططت له. والثانية أن من أجابوا قد يختلفون عمّن لم يجيبوا بطرق تؤثر في نتيجتك.
دعوة مزيد من الأشخاص تحل المشكلة الأولى، لكنها لا تحل الثانية بشكل موثوق. فقد جمع Groves وPeytcheva نتائج 59 دراسة قاست تحيز عدم الاستجابة الفعلي مقارنةً بحقيقة معروفة، ووجدا علاقة ضعيفة فقط بين معدل استجابة الاستبيان ومدى تحيزه. واختبر Pew الفكرة نفسها مباشرة: إذ طبّق استبانة واحدة مرتين، مرة بالأساليب المعتادة فحصل على معدل استجابة 9 في المئة، ومرة ببروتوكول عالي الجهد فحصل على 22 في المئة. ومن الأسئلة الـ 40 المشتركة بين الاستبيانين، جاءت نتائج 28 منها متقاربة في حدود 2 نقطة.
الحالة المعاكسة بصدق. هذه النتيجة لا تنطبق على كل موضوع، ومن المفيد أن تعرف أين تنكسر. ففي استبيانات الرضا تكون العلاقة حقيقية وكبيرة. فقد وجدت دراسة شملت 717 استبيانًا لرضا المرضى في 164 مستشفى سويسريًا أن متوسط درجة الرضا ومعدل الاستجابة مترابطان بقيمة r = 0.61، لأن الأشخاص المسرورين جدًا والغاضبين جدًا يجيبون، بينما لا يجيب الوسط المتردد. فإن كنت تقيس CSAT أو NPS، فقد يحرّك ارتفاع معدل الاستجابة درجتك وحده، والمعدل المنخفض يجمّل صورتك على الأرجح.
إذن: لاحق معدل الاستجابة حين تقيس شعور الناس تجاهك. ولا تعامله على أنه شهادة صحة حين تقيس أي شيء آخر.
حجم العينة في البحث الكمي: ما يحتاجه فصل المنهجية
لا يوجد حجم عينة واحد جيد للبحث الكمي، وأي مصدر يعطيك رقمًا دون أن يسألك عمّا تقيسه فهو يخمّن. فما يجعل فصل المنهجية مقبولًا ليس رقمًا كبيرًا، بل رقم مُعلن، مكتوب بجانبه مستوى الثقة وهامش الخطأ والنسبة المفترضة وحجم مجتمع الدراسة، ومرفقة به معادلة مسمّاة.
يتوقع المشرفون عادةً واحدًا من أربعة مناهج مسمّاة. وهي متوافقة في معظمها، ومن المفيد أن تعرف أيها يُطلب منك.
| المنهج المسمّى | ما يطلبه منك | النتيجة لـ N = 1,000 عند 95 في المئة و5 نقاط | استخدمه حين |
|---|---|---|---|
| Cochran (1977) | z وp وE، ثم تصحيح المجتمع المحدود إذا كان مجتمع الدراسة صغيرًا | 278 | الخيار الافتراضي. إنها المعادلة الموجودة في هذه الصفحة، والتي تُشتق منها الطرق الأخرى. |
| Krejcie وMorgan (1970) | لا شيء. تقرأ الإجابة من جدول منشور بحسب حجم مجتمع الدراسة. | 278 | تريد جدولًا قابلًا للاستشهاد بدلًا من الحساب. إنه Cochran بإعدادات ثابتة. |
| Yamane (1967)، ويُسمّى غالبًا Slovin | N وهامش الخطأ فقط | 286 | فقط حين تكون p مجهولة فعلًا وتقبل بمستوى ثقة 95 في المئة مدمجًا فيها. راجع التحذير أدناه. |
| تحليل القوة الإحصائية | حجم الأثر، والقوة الإحصائية، وألفا، والاختبار الذي ستجريه | يعتمد كليًا على حجم الأثر | تختبر فرضية بدلًا من تقدير نسبة مئوية. استخدم G*Power أو OpenEpi، لا هذه الصفحة. |
Cochran، ولماذا كل ما عداه اختصار له
معادلة Cochran هي المعادلة الموجودة أعلى هذه الصفحة: n0 = مربع z مضروبًا في p مضروبًا في (1 ناقص p)، مقسومًا على مربع E، يليها تصحيح المجتمع المحدود حين يكون مجتمع الدراسة صغيرًا. أما الطرق المسمّاة الأخرى فتثبّت بعض هذه المدخلات لتقصير الحساب. وحين تعرف ذلك، تتوقف هذه العائلة عن الظهور كأربع قواعد متنافسة، وتبدو قاعدة واحدة بثلاثة إعدادات مسبقة.
Yamane وSlovin: استخدمهما وأنت مدرك لحدودهما
تظهر المعادلة n = N / (1 + N x e^2) في آلاف الرسائل الجامعية، وتُنسب عادةً إلى Slovin. وهي سريعة: فلـ N = 1,000 وe = 0.05 تعطي 286.
ثلاثة أمور تستحق أن تعرفها قبل أن تستشهد بها.
- إنها معادلة Cochran بإعدادات مغلقة بإحكام. فبالعمل عكسيًا، المعادلة هي معادلة النسبة مع تثبيت p عند 0.5، ومستوى الثقة عند 95 في المئة، وتقريب z من 1.96 إلى 2. ولا يمكنها الإجابة عن سؤال عند أي مستوى ثقة آخر، وليس فيها أي مدخل لمدى تباين مجتمع الدراسة. فمجتمعان بالحجم نفسه لكن بتشتت مختلف جدًا يحصلان على الإجابة نفسها، وهذا لا يمكن أن يكون صحيحًا.
- هذا التقريب هو سبب ارتفاع أرقامها. فمع z = 2 يكون الحد الأقصى للمعادلة في مجتمع غير محدود 1 مقسومًا على مربع e تمامًا، أي 400. أما الحد الأقصى لدى Cochran فهو 384.16، لأن مربع 1.96 يساوي 3.8416 لا 4. وكل رقم من أرقام Yamane في الجدول أعلاه أكبر ببضعة في المئة من رقم Cochran لهذا السبب تحديدًا. وإن تساءلت يومًا لماذا يعطيك كتابان مختلفان حجمي عينة مختلفين للدراسة نفسها، فهذا هو الجواب عادةً.
- النسبة إلى Slovin لا تصمد. فقد تتبعت مجلة إحصائية تاريخ المعادلة وخلصت إلى أنه لا يوجد شخص اسمه Slovin يمكن العثور عليه وراءها، وأن أقدم مصدر يمكن تتبعه هو كتاب Taro Yamane المنشور عام 1967. ويصفها موقع Wolfram MathWorld بأنها معادلة مخصصة تفتقر إلى الصرامة الرياضية. فإن كان قسمك يتوقعها، فاستخدمها واستشهد بـ Yamane لا بـ Slovin. وإن كان لك الخيار، فاستخدم Cochran، لأنها تصمد أمام سؤال: من أين جاءت الـ 95 في المئة؟
قواعد تقريبية، مقيّمة بصدق
هذه القواعد منتشرة على نطاق واسع. بعضها مفيد وبعضها من الموروث الشعبي، ومن المفيد أن تميّز بينها.
- 30 على الأقل في كل مجموعة. معقولة كحد أدنى لمقارنة المجموعات، لا كهدف. وأصلها النقطة التي تبدأ عندها توزيعات العينات في الانتظام، لا أي متطلب للدقة.
- عشر حالات لكل متغير في الانحدار. قاعدة عمل تقريبية، مستخدمة على نطاق واسع ومنتقدة على نطاق واسع. اذكرها على أنها قاعدة تقريبية، لا قاعدة ملزمة أبدًا.
- عشرة في المئة من مجتمع الدراسة. هذه خاطئة ببساطة، والجدول أعلاه يبيّن السبب. فعشرة في المئة من 100,000 تساوي 10,000 رد، بينما يعطيك 383 الدقة نفسها.
- 385 دائمًا. صحيحة فقط لمجتمع دراسة كبير عند 95 في المئة و5 نقاط. اذكرها مع هذه الشروط وإلا فلا معنى لها.
- عدد n صغير لدراسات قابلية الاستخدام والمنتجات. تنشر Nielsen Norman Group النسخة الصادقة من ذلك: 40 مشاركًا يعطونك مقياسًا من نوع نعم أو لا بدقة زائد أو ناقص 15 نقطة عند مستوى ثقة 95 في المئة، و47 يعطونك متوسطًا بالدقة نفسها. وهذه الأرقام صغيرة لأن الدقة المدّعاة فضفاضة. فصرّح بالدقة، وستتوقف العينات الصغيرة عن أن تكون مصدر إحراج.
إذا كانت دراستك تقارن بين مجموعات بدلًا من تقدير نسبة مئوية واحدة، فإن حجم العينة يصبح مسألة قوة إحصائية، وهذه ليست الحاسبة المناسبة. فأنت تحتاج إلى حجم أثر مستعد للدفاع عنه، إضافةً إلى ألفا والقوة الإحصائية. وG*Power وOpenEpi هما الأداتان المجانيتان اللتان يتوقعهما معظم المشرفين، وكلتاهما مجانية. وتوضيح حدود الأداة أنفع من التظاهر بأنها تفعل كل شيء.
العمل النوعي يُحسب حجمه بطريقة مختلفة
المقابلات ومجموعات التركيز لا يُحسب حجمها بهامش خطأ، لأنها لا تقدّر نسبة مئوية في مجتمع الدراسة. والحجة المعتادة هي التشبع: تواصل حتى يتوقف المشاركون الجدد عن إضافة موضوعات جديدة، ثم تذكر متى حدث ذلك وكيف حكمت عليه. وتمرير دراسة نوعية عبر هذه الحاسبة ينتج رقمًا يبدو دقيقًا ولا يعني شيئًا.
إذا كنت تحتاج إلى نتائج لكل مجموعة فرعية، فاحسب الحجم للمجموعة الفرعية
يُطلب من معظم الاستبيانات عرض النتائج حسب المنطقة أو الدور الوظيفي أو مدة الخدمة أو خط المنتجات. وهنا تنكسر خطط العينات بصمت، والقاعدة قصيرة.
هامش الخطأ لديك ينطبق على مجموعة ما فقط إذا كان لديها ذلك العدد من الردود المكتملة. فإن أردت زائد أو ناقص 5 نقاط لكل منطقة من ست مناطق، فأنت تحتاج إلى نحو 385 ردًا مكتملًا في كل منطقة، لا 385 إجمالًا. أي استبيانًا يبلغ ستة أضعاف الحجم الذي ظننت أنك تخطط له.
مخرجان صادقان:
- زِد تمثيل المجموعات الصغيرة. ادعُ عمدًا حصة أعلى من الشرائح الأصغر حتى تبلغ كل منها هدفها الخاص. ثم رجّح النتائج لإعادتها إلى نسبها بعد ذلك.
- اقبل نطاقات أوسع للنتائج التفصيلية. احتفظ برقم إجمالي واحد قوي، وانشر نتيجة كل مجموعة فرعية مع هامش خطئها الخاص الأكبر بجانبها. وهذه هي الإجابة الصحيحة عادةً.
في الحاسبة حقل لذلك. اضبط المجموعات الفرعية التي تُعرض نتائجها منفصلة على عدد المجموعات التي تلتزم بتقديم نتيجة لها، فتحسب حجم كل مجموعة بشكل صحيح وتجمعها.
حدد النطاق قبل العمل الميداني. اسرد الشرائح التي يجب أن تعرض نتائجها، لا تلك التي سيكون من الجميل امتلاكها. وقدّر عدد الردود المكتملة التي يمكن أن تنتجها كل منها واقعيًا، مستخدمًا الأسئلة الديموغرافية لتحديدها. فإن كانت شريحة ما لا تعطي إلا 80 ردًا، فلا تعد بزائد أو ناقص 5 نقاط لها. فعند 80 ردًا يكون النطاق زائد أو ناقص 11 نقطة.
تستخدم AAPOR مثالًا تطبيقيًا يستحق الحفظ. فاستبيان من 1,000 بالغ يحمل هامش خطأ إجماليًا يقارب زائد أو ناقص 3 نقاط. وإذا كان 200 من هؤلاء هم المجموعة الفرعية التي تريد الحديث عنها فعلًا، فهامش خطأ تلك المجموعة زائد أو ناقص 6.9 نقطة، أي أكثر من الضعف. والرقم الرئيسي على غلاف التقرير ليس الرقم الذي يحكم الرسم البياني في الصفحة التاسعة.
الإرشادات المنشورة عن الحد الأدنى لأحجام الخلايا أقدم وأكثر تساهلًا من المعادلات، ومن الإنصاف التعامل معها كحد أدنى لا كهدف: نحو 100 رد لمجموعة فرعية ستعرض نتائجها بشكل كامل، ومن 20 إلى 50 لمجموعة ثانوية ستذكرها عرضًا.
أين يخطئ التخطيط لحجم العينة
حجم العينة يعالج خطأ العينة، أي التشويش العشوائي الناتج عن عدم سؤال الجميع. لكن الاستبيانات الحقيقية تحمل أيضًا خطأً منهجيًا، لا يصلحه أي حجم للعينة، وقد تخفيه العينة الكبيرة.
معاملة العينة الميسّرة كأنها عينة احتمالية
كل معادلة هنا تفترض أن لكل شخص احتمال اختيار معروفًا وغير صفري، وأن الإجابة لم تكن مرتبطة ارتباطًا قويًا بما تقيسه. والرابط المفتوح على وسائل التواصل الاجتماعي لا يحقق أيًا من الشرطين. ولا يزال بإمكانك حساب هامش خطأ من الردود، وسيبدو مطمئنًا، ولن يعني ما يقوله. فكن صريحًا بشأن نوع العينة التي سحبتها فعلًا.
اعتبار n الأكبر قياسًا أفضل
العينة الكبيرة تجعل القياس المشوَّش مشوَّشًا بدقة. فإذا كان السؤال غامضًا أو مزدوجًا أو موجِّهًا، فلن تنقذه ردود أكثر. وارتفاع معدلات التخطي والإجابات غير المتسقة علامتان على ضرورة إصلاح الأداة أولًا. وإعادة كتابة سؤال واحد سيئ كثيرًا ما تفعل أكثر من مضاعفة العينة ثلاث مرات.
اختيار الدقة دون قرار يستند إليها
لا تكون للدقة إجابة صحيحة إلا حين تعرف الغرض منها. فحجم العينة سهل الدفاع عنه حين تستطيع إكمال هذه الجملة: نحتاج إلى التمييز بين نتائج تختلف بمقدار X نقطة. ومستحيل الدفاع عنه حين يكون المبرر الوحيد أن الرقم الأكبر بدا أكثر أمانًا. فاربطه بـتصميم البحث لديك وبما ستفعله بالنتيجة.
الأرقام في هذه الصفحة، ومدى جودتها
كل رقم مذكور أعلاه إما حساب يمكنك إعادته في الحاسبة أو مرجع يمكنك التحقق منه. التصنيف A يعني نتيجة تكررت أو يمكن حسابها مباشرة، وB يعني دراسة واحدة قوية، وC يعني رقمًا متكررًا على نطاق واسع لكنه موضع خلاف.
| الادعاء | الرقم | التقدير | المصدر |
|---|---|---|---|
| عند مستوى ثقة 95 في المئة ودون تقدير مسبق، يحتاج مجتمع الدراسة الكبير إلى 385 ردًا مكتملًا للحصول على زائد أو ناقص 5 نقاط. | 385 | A | حساب مباشر من معادلة النسبة المعتادة. NIST القسم 3.3.3؛ Israel (1992). |
| تعيد المعادلة في هذه الصفحة إنتاج جدول حجم العينة المنشور لدى Krejcie وMorgan بفارق لا يتجاوز ردًا واحدًا في كل حجم من أحجام المجتمع الـ 21 التي تحققنا منها. | 21 من 21 بفارق لا يتجاوز 1 | A | مراجعتنا الخاصة مقارنةً بـ Krejcie وMorgan (1970). الطريقة مذكورة أسفل الجدول. |
| معدل الاستجابة مؤشر ضعيف على تحيز عدم الاستجابة. فقد وجد تحليل بعدي لـ 59 دراسة مخصصة للتحيز علاقة ضعيفة فقط بين الاثنين. | 59 دراسة | A | Groves وPeytcheva (2008)، Public Opinion Quarterly. |
| طبّق Pew الاستبانة نفسها بمعدل استجابة 9 في المئة و22 في المئة. ومن 40 سؤالًا مشتركًا، جاءت نتائج 28 متقاربة في حدود 2 نقطة. | 28 من 40 في حدود 2 نقطة | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| لكن في استبيانات الرضا تكون العلاقة حقيقية وكبيرة. فعبر 717 استبيانًا في المستشفيات، ارتبط متوسط درجة الرضا بمعدل الاستجابة بقيمة r = 0.61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux and Combescure (2020), BMC Health Services Research. |
| معدل الاستجابة في استبيانات الموظفين يتبع حجم المؤسسة بشكل شبه تام. ففي 2024 حصل استبيان الموظفين الفيدراليين الأمريكيين على 71 في المئة من الوكالات التي يقل موظفوها عن 1,000 و37 في المئة من الوكالات التي يزيد موظفوها على 75,000. | 71 مقابل 37 في المئة | A | مكتب إدارة شؤون الموظفين الأمريكي (US Office of Personnel Management) (2024)، FEVS Governmentwide Management Report، أكثر من 1.6 مليون موظف مدعو. |
| بلغ متوسط معدل الاستجابة عبر 1,071 استبيانًا إلكترونيًا منشورًا 44.1 في المئة. ولا يوجد معدل طبيعي واحد. | 44.1 في المئة | A | تحليل بعدي لـ Wu وZhao وFils-Aime (2022)، Computers in Human Behavior Reports. |
| تحصل استبيانات الويب على معدل استجابة أقل بنحو 12 نقطة مئوية من الوسائل الأخرى، عبر 114 مقارنة تجريبية. | أقل بـ 12 نقطة | A | تحليل بعدي لـ Daikeler وBosnjak وLozar Manfreda (2020)، JSSAM. |
| تنصيف هامش الخطأ يضاعف العينة المطلوبة نحو أربع مرات، لأن n تتناسب مع 1 على مربع E. ومضاعفة العينة من 1,000 إلى 2,000 لا تكسبك إلا نحو نقطة واحدة. | نحو 4 أضعاف | A | خاصية جبرية للمعادلة؛ وتذكر AAPOR حالة 1,000 إلى 2,000 صراحةً. |
| افتراض p = 0.5 بدلًا من قيمة معروفة p = 0.9 يضاعف العينة المطلوب منك جمعها ثلاث مرات تقريبًا، من 139 إلى 385. | 139 مقابل 385 | A | حساب مباشر. يمكن إعادته في الحاسبة بتغيير النتيجة المتوقعة. |
| قوالب الاستبيانات الـ 87 المنشورة على هذا الموقع كلها من 14 سؤالًا أو أقل، و86 من الـ 87 من 10 أسئلة أو أقل. وقد تأكد ظهور 785 من أسئلتها الـ 799 في الصفحات المنشورة. | 87 قالبًا، 799 سؤالًا | A | عدّنا الخاص لمجموعة القوالب المنشورة، بتاريخ 21 أغسطس 2026، مع التحقق منها مقابل الصفحات المنشورة الـ 87 كلها. الطريقة والمراجعة اليدوية ومعدل التحقق مذكورة مع الجدول. |
| لا يوجد شخص يمكن تتبعه اسمه Slovin وراء المعادلة التي تحمل هذا الاسم. وأقدم مصدر يمكن تتبعه هو Yamane (1967). | لا مؤلف يمكن تتبعه | B | Tejada وPunzalan (2012)، The Philippine Statistician؛ ويصفها Wolfram MathWorld بأنها معادلة مخصصة. |
«تحتاج دائمًا إلى 385 ردًا». فقط عند مستوى ثقة 95 في المئة، وزائد أو ناقص 5 نقاط، وp = 0.5، ومجتمع دراسة كبير. وإذا ذُكر مجردًا فهو خاطئ لكل مجتمع دراسة صغير.
«استطلع آراء 10 في المئة من مجتمع الدراسة». لا أساس إحصائيًا لذلك. فهو يبالغ كثيرًا في حجم العينة للمجتمعات الكبيرة ويقلّله للمجتمعات الصغيرة.
«معدل استجابة أقل من 50 أو 60 في المئة يُبطل الاستبيان». لا يوجد حد يفعل ذلك. وسُلّم 50 و60 و70 في المئة قاعدة تقريبية من الكتب لا يقف وراءها أي اشتقاق تجريبي، والتحليل البعدي لـ Groves وPeytcheva يناقضها. فمعدل الاستجابة يحدد أسوأ حالة ممكنة للتحيز، لكنه لا يقيس التحيز الفعلي.
«متوسط معدل الاستجابة للاستبيانات X في المئة». الأرقام الموثقة من السنوات القليلة نفسها تتراوح بين 6 في المئة و71 في المئة بحسب من تُستطلع آراؤهم كليًا. وأي متوسط واحد يخفي ذلك. فاستشهد بدلًا من ذلك بالصف الذي يطابق وضعك من الجدول أعلاه.
تقديم معادلة Slovin على أنها اشتقاق. إنها معادلة Cochran مع دمج مستوى ثقة 95 في المئة وp = 0.5 فيها وتقريب z إلى 2، ونسبتها إلى Slovin لا مصدر لها يمكن تتبعه.
قالب التبرير
تفشل معظم الحجج المتعلقة بحجم العينة لأن الافتراضات لم تُدوَّن قط. وزر نسخ التبرير في الحاسبة يكتب ذلك بأرقامك جاهزة فيه. وإن كنت تفضّل تجميعه بنفسك، فهذه هي الأمور التسعة التي سيبحث عنها المحكّم.
- مجتمع الدراسة (N): عرّف مجتمع الدراسة واذكر عدده. مثلًا: جميع العملاء النشطين خلال آخر 90 يومًا، N = 48,200.
- ما تقيسه: نسبة (نسبة مئوية) أو متوسط (متوسط تقييم). والمعادلة هنا تحسب حجم العينة للنسب، وهذا يغطي معظم مؤشرات الأداء الرئيسية التي تُعرض.
- مستوى الثقة: المستوى الذي اخترته وسبب اختياره. والعرف المتبع ومدى تقبّل المخاطرة كلاهما سبب مقبول إن صرّحت به.
- هامش الخطأ (E): الدقة المستهدفة إجمالًا، وبشكل منفصل لكل مجموعة فرعية وعدت بعرض نتائجها.
- النسبة المفترضة (p): القيمة المستخدمة ومصدرها. واذكر صراحةً إن كانت 0.5 لعدم توفر ما هو أفضل.
- تصحيح المجتمع المحدود: هل طبّقته وما الذي استدعاه، مثل تجاوز n0 نسبة 10 في المئة من N.
- هدف الردود المكتملة (n): العدد النهائي المطلوب من الردود المكتملة بعد كل تعديل.
- معدل الاستجابة المتوقع: المعدل المفترض، والسجل السابق الذي أُخذ منه، وعدد الدعوات الناتج.
- كيف ستختار الأشخاص: عشوائية بسيطة، أو طبقية، أو حصر شامل، أو عينة ميسّرة، إضافةً إلى أي زيادة في تمثيل الشرائح الرئيسية. وسمِّها بصدق.
بعد أن يبدأ جمع البيانات، استمر في مراقبة الردود المكتملة حسب الشريحة لا الإجمالي. فالرقم الإجمالي الجيد قد يخفي شريحة لن تبلغ هدفها أبدًا، وهي مشكلة يمكنك إصلاحها في الأسبوع الأول ولا يمكنك إصلاحها في الأسبوع الرابع. وحين تعرض النتائج، أرفق بكل نسبة مئوية هامش خطئها، واقرأ كيف تحلل بيانات الاستبيان قبل أن تعامل تحركًا بمقدار نقطتين على أنه حقيقي.
ورقة التخطيط لحجم العينة
صفحة واحدة يمكنك طباعتها وملؤها يدويًا وإرفاقها بملخص المشروع. املأ العمود الأوسط قبل بدء العمل الميداني لا بعده. لا يُرسل أي شيء إلى أي مكان ولا حاجة إلى حساب.
| القرار | قيمتك | إرشاد |
|---|---|---|
| مجتمع الدراسة (N) | من بالضبط، وكم عددهم. اكتب التعريف، لا الرقم فقط. | |
| ما تقيسه | نسبة مئوية أو متوسط. هذه الصفحة تحسب حجم العينة للنسب المئوية. | |
| مستوى الثقة | 95 في المئة ما لم يكن لديك سبب. اكتب السبب. | |
| هامش الخطأ (E) | الفارق الذي تحتاج إلى أن تستطيع التمييز عنده، بالنقاط. | |
| النسبة المفترضة (p) | 0.5 إن لم يوجد ما هو أفضل. واذكر من أين جاءت أي قيمة مختلفة. | |
| تصحيح المجتمع المحدود | مطبّق أم لا، وما الذي استدعاه. | |
| هدف الردود المكتملة (n) | الرقم النهائي بعد كل تعديل. | |
| المجموعات الفرعية التي تُعرض نتائجها منفصلة | كم عددها، وعدد الردود المكتملة المطلوب لكل منها على حدة. | |
| معدل الاستجابة المتوقع | المعدل، والسجل السابق الذي يستند إليه. لا رقمًا من الإنترنت. | |
| الدعوات التي سترسلها | الردود المكتملة مقسومة على المعدل، مقرّبة إلى الأعلى. ولا تزيد أبدًا على N. | |
| كيف يُختار الأشخاص | عشوائية، أو طبقية، أو حصر شامل، أو عينة ميسّرة. وسمِّها بصدق. | |
| نقطة المراجعة أثناء العمل الميداني | التاريخ الذي ستراجع فيه الردود المكتملة حسب الشريحة، لا الإجمالي فقط. |
المعادلة: n0 = (z^2 x p x (1 - p)) / E^2، ثم n = n0 / (1 + (n0 - 1) / N). المصدر: Cochran (1977)؛ NIST/SEMATECH e-Handbook القسم 3.3.3؛ Israel (1992). ورقة العمل من https://www.supersurvey.com/Sample-Size
الأسئلة الشائعة
ما حجم العينة؟
حجم العينة هو عدد الردود المكتملة في الاستبيان، ويُرمز له بـ n. وهو ليس عدد الأشخاص الذين دعوتهم، ولا حجم مجتمع الدراسة الذي تصفه. إنه العدد الذي تنهي به العمل الميداني، والرقم الذي يُحسب منه هامش الخطأ لديك: فـ 385 ردًا مكتملًا تعطي نحو زائد أو ناقص 5 نقاط عند مستوى ثقة 95 في المئة حين يكون مجتمع الدراسة كبيرًا. ويوضح قسم ما معنى حجم العينة الفرق بين مجتمع الدراسة والدعوات وn.
كم ردًا أحتاج في الاستبيان؟
في معظم الاستبيانات تكون الإجابة العملية 385 ردًا مكتملًا. وهذا ما تعطيه المعادلة عند مستوى ثقة 95 في المئة، وهامش خطأ زائد أو ناقص 5 نقاط مئوية، ودون تقدير مسبق للنتيجة. وإذا كان مجتمع الدراسة صغيرًا فأنت تحتاج إلى عدد أقل: 278 لقائمة من 1,000 شخص، و80 لقائمة من 100. أدخل أرقامك في الحاسبة لترى الرقم الدقيق والحساب الذي يقف وراءه.
ما حجم العينة الذي أحتاجه لمستوى ثقة 95 في المئة وهامش خطأ 5 في المئة؟
385 ردًا مكتملًا، إذا كان مجتمع الدراسة كبيرًا واستخدمت p = 0.5. والحساب هو n0 = مربع 1.96 مضروبًا في 0.5 مضروبًا في 0.5، مقسومًا على مربع 0.05، أي 0.9604 مقسومًا على 0.0025، أي 384.16. وبالتقريب إلى الأعلى تحصل على 385. وإذا كان مجتمع الدراسة صغيرًا، فطبّق تصحيح المجتمع المحدود فينخفض العدد.
ما هامش الخطأ؟
هامش الخطأ هو نطاق الزائد أو الناقص حول نتيجة الاستبيان، الناتج عن سحب عينة من بعض الأشخاص بدلًا من جميعهم. فالنتيجة 62 في المئة مع هامش خطأ قدره 5 نقاط تعني أن الطريقة ستنتج فترة تحتوي على القيمة الحقيقية في معظم الأحيان، وأن هذه الفترة بعينها تمتد من 57 إلى 67 في المئة. وهو يصف خطأ العينة العشوائي فقط، ولا يقول شيئًا عن الأشخاص الذين لم يجيبوا قط.
كيف تحسب هامش الخطأ؟
خذ الجذر التربيعي لحاصل ضرب p في (1 ناقص p) مقسومًا على n، ثم اضربه في الدرجة المعيارية z لمستوى الثقة لديك. فعند مستوى ثقة 95 في المئة، و385 ردًا، وp = 0.5، يكون الناتج 1.96 مضروبًا في الجذر التربيعي لـ 0.25 مقسومًا على 385، أي 1.96 مضروبًا في 0.025482، أي 0.0499. فيكون هامش الخطأ زائد أو ناقص 5.0 نقاط مئوية. وحاسبة هامش الخطأ في هذه الصفحة تحسبه لك وتعرض خطوات الحل.
هل يزيد هامش الخطأ مع حجم العينة؟
لا، بل يتقلص كلما زاد الجذر التربيعي لحجم العينة. فالانتقال من 100 رد إلى 400 ينصّف هامش الخطأ، والانتقال من 400 إلى 1,600 ينصّفه مرة أخرى. وعلاقة الجذر التربيعي هذه هي سبب ارتفاع تكلفة الدقة: فكل منزلة عشرية إضافية من الدقة تكلّف نحو أربعة أضعاف الردود.
هل هامش الخطأ هو نفسه الخطأ المعياري؟
لا. الخطأ المعياري هو التشتت الأساسي للتقدير. وهامش الخطأ هو الخطأ المعياري مضروبًا في الدرجة المعيارية z لمستوى الثقة الذي اخترته. فعند مستوى ثقة 95 في المئة يساوي هامش الخطأ نحو 1.96 خطأ معياريًا. فالخطأ المعياري خاصية في البيانات، وهامش الخطأ اختيار في طريقة العرض يُبنى فوقه.
ما حجم العينة الجيد للبحث الكمي؟
لا يوجد رقم واحد جيد، وأي مصدر يعطيك رقمًا دون أن يسألك عمّا تقيسه فهو يخمّن. ففي دراسة تعرض نسبًا مئوية من مجتمع دراسة يقل عن نحو 10,000، تكون الإجابة القابلة للدفاع هي ما تعطيه المعادلة عند مستوى ثقة 95 في المئة وهامش خطأ يمكنك تبريره. ولقائمة من 1,000 يكون ذلك 278. والرقم الذي يجعل فصل المنهجية مقبولًا ليس رقمًا كبيرًا، بل رقم مُعلن مكتوب بجانبه مستوى الثقة وهامش الخطأ والنسبة المفترضة وحجم مجتمع الدراسة. راجع حجم العينة في البحث الكمي لمعرفة المعادلات المسمّاة التي قد يتوقعها مشرفك.
ما معدل الاستجابة الطبيعي للاستبيان؟
لا يوجد معدل طبيعي واحد، وأي صفحة تذكر رقمًا واحدًا فهي تخمّن. فالأرقام الحقيقية الموثقة من الحقبة نفسها تتراوح بين 6 في المئة (الاستطلاعات الهاتفية لدى Pew في 2018) و71 في المئة (الوكالات الفيدرالية الأمريكية الصغيرة في استبيان آراء الموظفين الفيدراليين لعام 2024). ووجد تحليل بعدي لـ 1,071 استبيانًا إلكترونيًا منشورًا متوسطًا قدره 44.1 في المئة. ولحجم المؤسسة أهمية كبيرة جدًا: فالاستبيان الفيدرالي نفسه حصل على 71 في المئة من الوكالات التي يقل موظفوها عن 1,000 و37 في المئة من الوكالات التي يزيد موظفوها على 75,000. استخدم سجلك السابق أولًا، وراجع جدول المعايير المرجعية للاطلاع على أرقام يمكنك الاستشهاد بها.
هل يهم حجم مجتمع الدراسة في حجم العينة؟
بالكاد، إلى أن تصبح عينتك حصة كبيرة من مجتمع الدراسة. فالانتقال من 100,000 شخص إلى 1,000,000 يغيّر المطلوب من 383 إلى 385. أما الانتقال من 1,000 شخص إلى 100 فيغيّره من 278 إلى 80. فحجم مجتمع الدراسة مهم في الطرف الصغير، وهو بالضبط الموضع الذي ينطبق فيه تصحيح المجتمع المحدود.
متى تكون p = 0.5 الخيار الصحيح؟
استخدم p = 0.5 كلما لم يكن لديك تقدير مسبق يمكن الدفاع عنه. فالحد p مضروبًا في (1 ناقص p) يبلغ أقصاه عند 0.5، فينتج أكبر عينة مطلوبة. وهذا يجعله الافتراض الآمن: لن تجد نفسك بعدد ناقص. وإن كان لديك تطبيق تجريبي أو معيار مرجعي أو رقم العام الماضي، فاستخدمه. فافتراض p = 0.9 بدلًا من 0.5 يخفض العينة المطلوبة من 385 إلى 139.
إذا دعوت عددًا أكبر من الأشخاص، فهل أتخلص من تحيز عدم الاستجابة؟
لا. المزيد من الدعوات يعطيك مزيدًا من الردود المكتملة، وهذا يقلص هامش الخطأ. أما التحيز فمشكلة منفصلة: فهو يعتمد على ما إذا كان من أجابوا يختلفون عمّن لم يجيبوا. وقد وجد تحليل بعدي لـ 59 دراسة عن تحيز عدم الاستجابة علاقة ضعيفة فقط بين معدل الاستجابة والتحيز الفعلي. وطبّق Pew الاستبانة نفسها مرتين، بمعدل استجابة 9 في المئة و22 في المئة، فجاءت نتائج 28 من الأسئلة الـ 40 المشتركة متقاربة في حدود 2 نقطة. راجع تحيز الاستجابة وتحيز عدم الاستجابة.
كيف أتعامل مع حجم العينة إذا كنت أحتاج إلى نتائج حسب القسم أو المنطقة؟
احسب حجم كل مجموعة فرعية على حدة. فهامش الخطأ لديك ينطبق على مجموعة ما فقط إذا كان لديها ذلك العدد من الردود المكتملة. فإن أردت زائد أو ناقص 5 نقاط لكل منطقة، فكل منطقة تحتاج إلى 385 ردًا مكتملًا خاصًا بها، أو إلى عددها الخاص بعد تصحيح المجتمع المحدود. واستخدم الأسئلة الديموغرافية لتحديد المجموعات، وخطّط لزيادة تمثيل المجموعات الصغيرة.
ما حجم العينة الذي أحتاجه للحصول على نتيجة ذات دلالة إحصائية؟
هذا السؤال يخلط بين فكرتين. فمعادلات حجم العينة تحسب حجم تقدير بدقة مختارة. أما اختبار الدلالة فيقارن بين رقمين ويسأل ما إذا كان الفارق قد يكون مصادفة على نحو معقول. والحجم الذي تحتاجه يعتمد على مدى صغر الفارق الذي تريد أن تستطيع رصده، لا على حد ثابت. احسب حجم الاستبيان هنا، ثم اقرأ الدلالة الإحصائية قبل أن تختبر نتيجة مقابل أخرى.
هل تصلح هذه المعادلات للبحث النوعي؟
لا. المقابلات ومجموعات التركيز والعمل القائم على الأسئلة المفتوحة لا يُحسب حجمها بهامش خطأ، لأنها لا تقدّر نسبة مئوية في مجتمع الدراسة. فحجم العينة النوعية يُبرَّر بالتشبع، أي النقطة التي يتوقف عندها المشاركون الجدد عن إضافة موضوعات جديدة، ويُعرض على أنه حكم مدعوم بالأدلة لا معادلة. فلا تمرر دراسة نوعية عبر هذه الحاسبة.
المراجع
- National Institute of Standards and Technology (NIST). (n.d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, section 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.