
El tamaño de muestra de una encuesta es el número de envíos completados que se incluyen en tu análisis, y se escribe n. Es distinto del número de invitaciones o de personas de tu lista. Con los supuestos de muestreo de la calculadora, una muestra más grande estrecha el margen de error; no elimina un reclutamiento sesgado ni unas preguntas mal redactadas.
Calculadora del tamaño de muestra
No hay nada oculto tras un registro y no se envía nada a ninguna parte. La calculadora funciona en tu navegador, empieza con una respuesta de ejemplo ya en pantalla y muestra la fórmula y los cálculos que ha usado para que puedas comprobarlos o reproducirlos a mano.
¿Cuántos envíos necesito?
Introduce tus seis datos. La respuesta, la fórmula y los cálculos se actualizan mientras escribes.
Envíos completados que necesitas
370
Tras la corrección por población finita.
Personas que invitar
1,234
Con una tasa de respuesta del 30 %.
Fracción de muestreo
3.7%
Proporción de la población de la que necesitas respuesta.
Total, calculado por subgrupo
370
Los cálculos, paso a paso
| Margen de error | Envíos completados necesarios | Invitaciones necesarias |
|---|
El coste en envíos de una precisión más ajustada crece aproximadamente con el cuadrado de la mejora. Reducir a la mitad el margen de error multiplica la muestra por cuatro, aproximadamente.
El botón de copiar escribe un breve párrafo de métodos con tus cifras, la fórmula y la cita, listo para pegar en el resumen de un proyecto o en un capítulo de metodología.
Cita esta calculadora: Hodge, M. (2026). Calculadora del tamaño de muestra para encuestas. SuperSurvey. https://www.supersurvey.com/Sample-Size
El resultado son envíos completados, no invitaciones. Es el número que necesitas tener al final del trabajo de campo. La cifra de invitaciones es ese número dividido entre la tasa de respuesta que esperas, y ahí es donde fallan la mayoría de los planes de muestreo. Una vez fijado el objetivo, crea tu encuesta y haz una prueba piloto con el público previsto. Usa la prueba piloto para comprobar la redacción y estimar la proporción entre invitaciones y envíos completados de tu propio proyecto.
Qué significa el tamaño de muestra
El tamaño de muestra es el número de personas que completan tu encuesta. Se escribe n en todas las fórmulas de esta página, es la única cantidad que compras con trabajo de campo en lugar de elegirla sobre el papel, y es la cifra a partir de la cual se calcula tu margen de error.
Hay tres recuentos que se confunden con él, y distinguirlos es la mayor parte de lo que hace un plan de muestreo:
- Población (N): todas las personas que quieres describir. Una lista de clientes, una plantilla, un país.
- Invitaciones: a cuántas personas contactas. Siempre más que n, porque no todo el mundo responde.
- Tamaño de muestra (n): cuántos envíos completados tienes cuando termina el trabajo de campo. Es el número que calcula la fórmula, y el único de los tres que cambia tu margen de error.
El tamaño de muestra compra precisión, que es la anchura de la franja de más o menos alrededor de cada resultado. No compra exactitud, que es si las personas que respondieron se parecen a las que no lo hicieron. Una muestra grande por conveniencia puede estar más lejos de la verdad que una pequeña aleatoria, y ningún valor de n lo arregla. Dónde falla la planificación del tamaño de muestra explica la diferencia, y cómo extraes la muestra es lo que la decide.
La respuesta breve, si solo quieres una cifra
Cifras clave
- 385 envíos completados es la respuesta por defecto. Es lo que devuelve la fórmula con un 95 % de confianza, un margen de error de más o menos 5 puntos porcentuales y ninguna estimación previa del resultado.
- Las poblaciones pequeñas necesitan muchos menos. Una lista de 1000 personas necesita 278. Una lista de 100 necesita 80. Es la corrección por población finita en acción.
- La precisión es cara. Reducir a la mitad el margen de error multiplica la muestra por cuatro, aproximadamente. Pasar de más o menos 5 puntos a más o menos 1 punto te lleva de 385 a 9604.
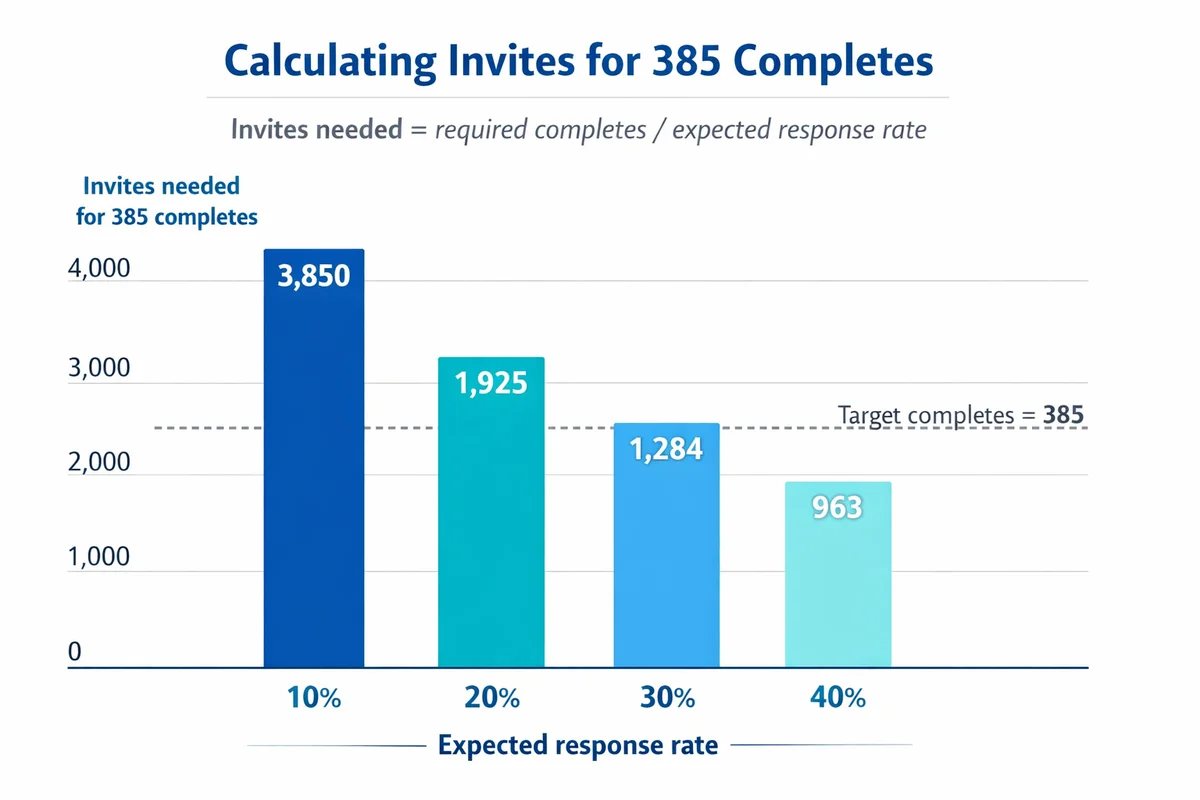
- Las fórmulas cuentan envíos completados, no invitaciones. Las invitaciones necesarias son los envíos completados divididos entre tu tasa de respuesta esperada. Con un 30 %, 385 envíos completados suponen invitar a 1284 personas.
- El margen de error cubre un solo tipo de error. Mide el ruido de muestrear a algunas personas en lugar de a todas. No dice nada sobre las personas que nunca respondieron.
La fórmula del tamaño de muestra y cómo calcularla a mano
Para una encuesta que informa de un porcentaje, el punto de partida estándar es el tamaño de muestra para una población lo bastante grande como para tratarla como ilimitada:
n0 = (z^2 x p x (1 - p)) / E^2
Leída de izquierda a derecha:
- n0 son los envíos completados necesarios, antes de cualquier corrección por población.
- z es la puntuación z de tu nivel de confianza. Usa 1,96 para el 95 %.
- p es la proporción que esperas medir, en forma decimal. Usa 0,5 si no la conoces.
- E es el margen de error en forma decimal. Cinco puntos porcentuales son 0,05.
El símbolo del tamaño de muestra es n. Algunas fuentes escriben la cifra sin corregir como n0 y la corregida como n, que es la convención que se usa aquí.
| Nivel de confianza | z | Lo que te cuesta |
|---|---|---|
| 80 % | 1.282 | 165 envíos completados con más o menos 5 puntos |
| 90 % | 1.645 | 271 envíos completados |
| 95 % (estándar) | 1.960 | 385 envíos completados |
| 99 % | 2.576 | 664 envíos completados |
| 99,9 % | 3.291 | 1084 envíos completados |
Ejemplo resuelto: de 385 a una lista de invitaciones
Escenario. Quieres conocer el porcentaje de clientes que te recomendarían. Quieres un 95 % de confianza y más o menos 5 puntos. No tienes ninguna estimación previa, así que p = 0,5.
Elige tu nivel de confianza y tu margen de error
Un 95 % de confianza fija z = 1,96. Más o menos 5 puntos porcentuales es E = 0,05.
Elige un resultado esperado
p = 0,5, porque no hay ninguna estimación previa y 0,5 produce la muestra más grande. Nada de lo que averigües después puede dejarte corto.
Aplica la fórmula del tamaño de muestra
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Redondea hacia arriba: 385 envíos completados. Redondea siempre hacia arriba. No se puede recoger una fracción de encuesta.
Corrige para una población pequeña
Si esos clientes son una lista de 1000 y no un mercado abierto, aplica la corrección: n = 384,16 / (1 + 383,16 / 1000) = 384,16 / 1,38316 = 277,7, así que 278 envíos completados. La corrección solo se nota cuando la muestra es una parte grande de la población.
Convierte los envíos completados en invitaciones
Con una tasa de respuesta del 30 %, invitaciones = 278 / 0,30 = 926,7, así que invita a 927 personas. Los envíos completados son lo que calcula la fórmula. Las invitaciones son lo que realmente envías, y nunca pueden superar la población de la que extraes la muestra.
Con un 95 % de confianza y p = 0,5, toda la fórmula se reduce a 0,9604 dividido entre E al cuadrado. Ese único atajo responde en una línea a la mayoría de las preguntas sobre el tamaño de muestra, y es la razón por la que 385 aparece una y otra vez en las tablas de tamaño de muestra que encuentras en otros sitios.
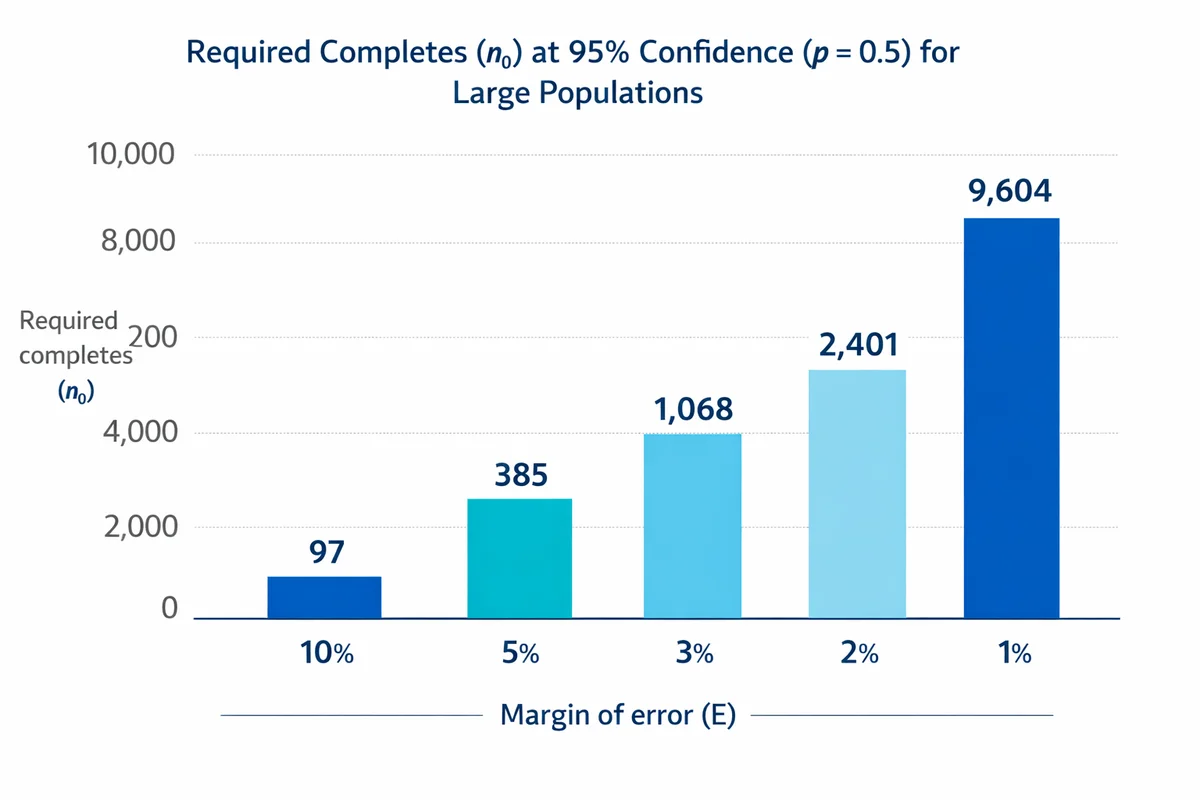
Tabla de tamaño de muestra para tamaños de población habituales
Estas cifras se calculan con la fórmula anterior con un 95 % de confianza, más o menos 5 puntos y p = 0,5, y después se corrigen según la población. Las dos últimas columnas son nuestra propia comprobación frente a la tabla publicada por Krejcie y Morgan en 1970, que es la tabla que citan la mayoría de los capítulos de metodología.
| Población (N) | Envíos completados necesarios | Krejcie y Morgan (1970) | Diferencia |
|---|---|---|---|
| 10 | 10 | 10 | igual |
| 25 | 24 | no figura | |
| 50 | 45 | 44 | 1 más |
| 100 | 80 | 80 | igual |
| 200 | 132 | 132 | igual |
| 500 | 218 | 217 | 1 más |
| 1,000 | 278 | 278 | igual |
| 2,000 | 323 | 322 | 1 más |
| 5,000 | 357 | 357 | igual |
| 10,000 | 370 | 370 | igual |
| 50,000 | 382 | 381 | 1 más |
| 100,000 | 383 | 384 | 1 menos |
Cómo lo comprobamos. Aplicamos la fórmula a 21 tamaños de población y comparamos cada resultado con el valor publicado por Krejcie y Morgan. Doce coincidieron exactamente. Los otros nueve diferían en exactamente un envío, lo que se debe a dónde redondea cada método, no a un desacuerdo sobre los cálculos. Si un director de tesis te pregunta por qué tu cifra difiere de la tabla en uno, esa es la razón.
Conviene saberlo si citas esa tabla: Krejcie y Morgan no dedujeron su propia fórmula. Su artículo de 1970 tiene unas 400 palabras más una tabla, y su única referencia atribuye la fórmula a un boletín de investigación de 1960 de la National Education Association. Su propio resumen del patrón sigue siendo la mejor descripción en una línea: a medida que crece la población, la muestra necesaria aumenta a un ritmo decreciente y se estabiliza en algo más de 380 casos.
Cómo elegir tus datos de entrada, uno a uno
Cuatro cifras determinan la respuesta. Tres de ellas son decisiones, no hechos, y cada una tiene una forma defendible de elegirla.
Nivel de confianza: con qué frecuencia acierta el método
El nivel de confianza describe el método, no esta encuesta en concreto. Con un 95 % de confianza, los intervalos construidos de esta forma contienen el valor real 95 veces de cada 100 a largo plazo. No es un 95 % de probabilidad de que tu respuesta concreta sea correcta.
Usa el 95 % salvo que tengas un motivo para no hacerlo. Pasar al 99 % eleva la muestra de 385 a 664 para la misma precisión, lo que supone un 72 % más de coste para ganar muy poco. La idea relacionada en el contraste de hipótesis es alfa, y por eso se confunden las dos. Si esa distinción no te queda clara, lee la significación estadística y qué significan los valores p antes de elegir una cifra.
Margen de error: la variable de decisión
Este es el que más tienes que pensar, porque es el único dato que vincula la muestra a una decisión. Elígelo preguntándote qué diferencia cambiaría lo que haces.
Si actúas de forma distinta cuando la satisfacción es del 72 % y no del 74 %, necesitas un margen ajustado. Si solo actúas ante un 72 frente a un 82, más o menos 5 puntos es de sobra. Los informes generales suelen quedarse en 5 puntos para una toma de pulso o en 3 puntos para un seguimiento. Por debajo de 2 puntos, el coste se dispara.
Tamaño de la población: casi irrelevante, hasta que deja de serlo
Con poblaciones grandes, la muestra necesaria apenas se mueve. Diez mil personas necesitan 370 envíos. Cien mil necesitan 383. El tamaño de la población solo influye cuando tu muestra es una parte significativa de ella, como ocurre con las listas de empleados, los registros de socios y las cohortes escolares. Eso es lo que trata la siguiente sección.
Resultado esperado (p): usa 0,5 cuando no lo sepas
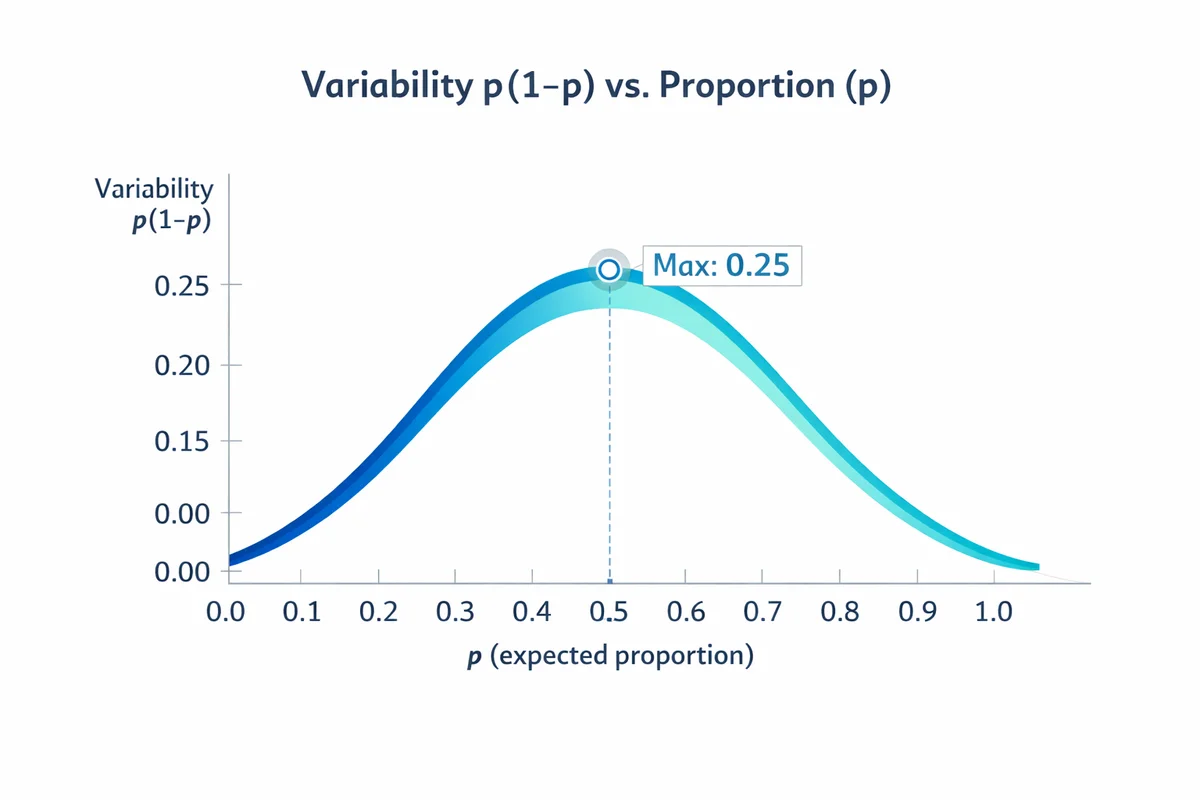
En una pregunta de porcentaje, la incertidumbre depende de p por (1 menos p). Ese término es máximo con p = 0,5, así que 0,5 es la opción conservadora y produce la muestra más grande. Es el valor por defecto correcto cuando no tienes una estimación previa.
Si la tienes, úsala, porque el ahorro es grande. Con un 95 % de confianza y más o menos 5 puntos, p = 0,5 pide 385 envíos y p = 0,9 pide 139. Encuestas anteriores, una prueba piloto o una referencia publicada son fuentes válidas para esa estimación. Las preguntas confusas también aumentan la dispersión, así que una redacción más clara puede estabilizar un resultado sin ningún envío adicional. Redactar mejores preguntas de encuesta suele salir más barato que recoger más envíos.
Poblaciones pequeñas: la corrección por población finita
La fórmula básica supone que extraes la muestra de un conjunto tan grande que sacar personas de él no cambia nada. En cuanto tu muestra es una parte real de la población, ese supuesto te cobra de más. La corrección por población finita te devuelve esos envíos.
n = n0 / (1 + ((n0 - 1) / N))
- n es el número corregido de envíos completados que necesitas.
- n0 es la cifra sin corregir de la fórmula anterior.
- N es el tamaño de la población.
El criterio habitual es que n0 supere aproximadamente el 5 % de N. Por debajo de eso, la corrección apenas cambia nada, así que no merece la pena explicársela a nadie.
Ejemplo resuelto: una encuesta a la plantilla
Escenario. Tienes 1200 empleados. Quieres un 95 % de confianza, más o menos 5 puntos, y usas p = 0,5.
- Sin corregir, n0 = 384,16.
- Corregido: n = 384,16 / (1 + (383,16 / 1200)) = 384,16 / 1,3193 = 291,2.
- Redondea hacia arriba: 292 envíos completados.
Sin la corrección perseguirías 385 envíos de una lista de 1200, es decir, el 32 % de todo el mundo. Con ella, 292 te dan la misma precisión. En una lista de ese tamaño, es un mes de insistir que te ahorras.
Por debajo de unas 200 personas, la muestra corregida es una parte tan grande de la lista que invitar a todo el mundo es más sencillo y más defendible. Un censo de 150 personas no tiene ningún error de muestreo. Tu esfuerzo se dedica entonces a la tasa de respuesta y a quién falta, que es donde debe estar.
Margen de error: la misma fórmula, al revés
El margen de error es la franja de más o menos alrededor del resultado de una encuesta que se debe a haber preguntado a algunas personas en lugar de a todas. Si el 62 % de 385 participantes elige una opción y el margen de error es de 5 puntos, informas del 62 % y dices que el rango plausible va del 57 al 67 %.
Despejando E en la fórmula del tamaño de muestra se obtiene:
E = z x raíz cuadrada de (p x (1 - p) / n)
Con una población finita, multiplícalo por la raíz cuadrada de (N - n) dividido entre (N - 1). Ambas versiones están en la calculadora de abajo, que cambia automáticamente al marcar o desmarcar la casilla de la población.
¿Cuál es el margen de error de los envíos que ya tengo?
La misma fórmula, despejada. Introduce los envíos que has recogido y lee la precisión resultante.
Margen de error
5.0
Puntos porcentuales, más o menos.
Tu intervalo
45,0 a 55,0
Porcentaje, con un 95 % de confianza.
Los cálculos, paso a paso
¿Aumenta el margen de error con el tamaño de muestra?
Disminuye, y disminuye con la raíz cuadrada de n. Esa raíz cuadrada es toda la economía de las encuestas. Cuatrocientos envíos te dan la mitad de error que cien. Para reducirlo otra vez a la mitad necesitas 1600. Cada decimal adicional de precisión cuesta aproximadamente cuatro veces más trabajo de campo, y por eso 385 es un punto de llegada tan habitual: es donde el coste y la precisión dejan de discutir.
Cuatro términos que se confunden
El error estándar, el margen de error, el nivel de confianza y el intervalo de confianza se usan como si fueran intercambiables. Son cuatro cosas distintas, y la diferencia importa cuando alguien cuestiona tu cifra.
| Término | Qué es | Con 385 envíos y un 50 % |
|---|---|---|
| Error estándar | La dispersión bruta de la estimación. La raíz cuadrada de p por (1 menos p) dividido entre n. | 0,0255, es decir, 2,55 puntos porcentuales |
| Margen de error | El error estándar multiplicado por la puntuación z del nivel de confianza que elegiste. | Más o menos 5,0 puntos al 95 % |
| Nivel de confianza | La puntuación z que elegiste, expresada como porcentaje. Una elección, no una medición. | 95 %, así que z = 1,96 |
| Intervalo de confianza | El resultado con el margen de error aplicado, escrito como un rango. | Del 45,0 % al 55,0 % |
En resumen: el error estándar es una propiedad de tus datos, el nivel de confianza es una elección que hiciste, el margen de error es el producto de ambos y el intervalo de confianza es lo que publicas en el informe.
Lo que no cubre el margen de error
Cubre el error de muestreo aleatorio y nada más. No cubre a las personas que ignoraron la invitación, una lista a la que le faltaba parte de la población ni una pregunta que la mitad de tus participantes entendió de forma distinta a la que pretendías. Una encuesta puede tener un margen de error impecable y aun así estar equivocada. Consulta el sesgo de respuesta y el sesgo de no respuesta para conocer los errores que ningún tamaño de muestra corrige.
El organismo profesional de la investigación por encuesta lo dice con más claridad que la mayoría de los proveedores. La AAPOR afirma que no existe un margen de error global medible para un sondeo, porque las encuestas arrastran otros errores que no se pueden medir en absoluto, desde cómo se redactaron las preguntas hasta cómo se hicieron las entrevistas. Lo que se puede calcular es la parte del muestreo. Esa es la parte que te da la calculadora, y conviene tener claro que es solo una parte.
Dos reglas de uso de la misma fuente, y la mayoría de los textos sobre encuestas incumplen ambas:
- Son puntos porcentuales, no un porcentaje. Escribe «más o menos 3 puntos porcentuales», no «más o menos un 3 %». Significan cosas distintas.
- No se aplica en absoluto a las muestras de participación voluntaria. Un margen de error supone que cada persona tenía una probabilidad de selección conocida y distinta de cero. Un enlace abierto, un panel de voluntarios o una publicación en redes sociales no cumplen eso. Publicar un margen de error junto a los resultados de un enlace abierto es atribuirse una precisión que no has pagado.
Cómo convertir los envíos completados en invitaciones
La fórmula te da envíos terminados. El trabajo de campo te da una tasa de respuesta. La distancia entre ambos es donde suelen fallar los planes de muestreo, y el cálculo cabe en una línea:
Invitaciones = envíos completados necesarios / tasa de respuesta esperada
Usa la tasa en forma decimal, de modo que el 30 % es 0,30, y redondea hacia arriba. Para 292 envíos completados con un 35 %, son 292 entre 0,35 = 834,3, así que invita al menos a 835 personas.
| Envíos completados necesarios | Tasa de respuesta esperada | Invitaciones |
|---|---|---|
| 385 | 60 % | 642 |
| 385 | 30 % | 1,284 |
| 385 | 15 % | 2,567 |
| 292 | 50 % | 584 |
| 292 | 35 % | 835 |
| 292 | 20 % | 1,460 |
Cómo elegir una tasa de respuesta defendible
Tu propio historial es mejor que cualquier referencia publicada, siempre que sea el mismo público, el mismo canal y una encuesta de duración similar. Si no tienes nada en lo que basarte, planifica tres escenarios, con un 20, un 30 y un 40 %, y trata la lista de invitaciones como una palanca ajustable durante el trabajo de campo. Los recordatorios, un plazo más largo y una lista más amplia son cosas que puedes cambiar a mitad de camino. El objetivo de envíos completados no.
La mayoría de las tablas de referencia de internet citan una única media sin fuente. No existe una única media. Esto es lo que dicen realmente las fuentes primarias, para que puedas citar la fila que corresponde a tu situación en lugar de una cifra que alguien se inventó.
| Contexto | Tasa de respuesta | Escala y fuente |
|---|---|---|
| Agencias federales de EE. UU. con menos de 1000 empleados | 71 % | Federal Employee Viewpoint Survey de 2024 (OPM) |
| Agencias federales de EE. UU. de 1000 a 9999 empleados | 60 % | Misma encuesta, mismo año (OPM) |
| Agencias federales de EE. UU. con más de 75.000 empleados | 37 % | Misma encuesta, mismo año (OPM) |
| Todos los empleados federales de EE. UU. | 41 % | Más de 1,6 millones de invitados y más de 674.000 respondieron, 2024 (OPM) |
| Encuestas online publicadas, de todo tipo | 44,1 % de media | Metaanálisis de 1071 tasas publicadas (Wu y colaboradores, 2022) |
| Investigación organizacional publicada | 68 % en 2020, frente al 48 % en 2005 | 1014 encuestas en 17 revistas (Holtom y colaboradores, 2022) |
| Sondeos telefónicos al público general | 6 % en 2018, frente al 36 % en 1997 | Tasa registrada por el propio Pew Research Center (Kennedy y Hartig, 2019) |
| Modo web frente a cualquier otro modo | unos 12 puntos menos | Metaanálisis de 114 comparaciones experimentales (Daikeler y colaboradores, 2020) |
De esa tabla se desprenden dos cosas. Primero, el tamaño del grupo que encuestas predice la tasa mejor que casi cualquier otra cosa que controles. Una empresa de 300 personas y una agencia de 300.000 no están haciendo la misma encuesta. Segundo, la afirmación tan repetida de que las tasas de respuesta se desploman en todas partes solo es cierta en algunos sitios. Los sondeos telefónicos sí se desplomaron. La investigación organizacional publicada fue en la dirección contraria, del 48 % al 68 % en quince años.
Otro cálculo de planificación que merece la pena tomar prestado: la recomendación habitual de las guías de extensión universitaria es añadir alrededor de un 10 % a tu lista de invitaciones por las personas a las que simplemente no podrás contactar, y alrededor de un 30 % por las que podrían responder y no lo hacen.
Lo que dice nuestro propio corpus de plantillas sobre la duración
Una tasa de respuesta tomada de la encuesta de otra persona se traslada mal, y la duración es una de las pocas cosas de esa lista que controlas por completo. Aquí tienes una cifra que nosotros podemos producir y un competidor no, porque procede de contar nuestro propio corpus publicado y no de preguntar a profesionales qué creen que hacen.
En nuestra auditoría del 21 de agosto de 2026, las 87 plantillas de encuesta tenían 14 preguntas o menos, y 86 tenían 10 preguntas o menos. En conjunto contenían 799 preguntas. La mediana era de 9 preguntas y exactamente una plantilla pasaba de 10. Estas cifras describen esa instantánea fechada, no la biblioteca actual.
| Preguntas de la plantilla | Plantillas | Proporción del corpus |
|---|---|---|
| 7 preguntas | 4 | 5 % |
| 8 preguntas | 17 | 20 % |
| 9 preguntas | 29 | 33 % |
| 10 preguntas | 36 | 41 % |
| 14 preguntas | 1 | 1 % |
Por formato de respuesta, 355 de las 799 preguntas son escalas de valoración, 281 son listas de opción única y 163 piden al lector que escriba algo. Ese último grupo es el que te cuesta envíos completados, así que lo leímos a mano en lugar de fiarnos del campo almacenado. De las 163, 137 son cuadros de comentarios de varias líneas. Las otras 26 son cuadros de una sola línea, y al leerlas vimos que 22 son campos breves de identificación o clasificación: un nombre, una dirección de correo electrónico, una fecha, un departamento, un puesto de trabajo. Solo 4 son respuestas breves sustantivas. Así que el recuento honesto de preguntas realmente abiertas es de 141, es decir, aproximadamente una de cada seis, y no una de cada cinco, como habría indicado el campo sin revisar.
Cómo contamos y cómo lo comprobamos. Analizamos la lista de preguntas almacenada de cada plantilla de encuesta publicada en este sitio el 21 de agosto de 2026, conservamos las entradas con texto de pregunta y después descargamos cada página publicada y comparamos los dos conjuntos, en lugar de fiarnos solo de nuestra propia base de datos. Las 87 páginas devolvieron HTTP 200, mientras que una dirección que sabemos que ya no existe devolvió 410 en la misma ejecución, así que la comprobación discriminaba de verdad y no daba siempre verde. 785 de las 799 preguntas, es decir, el 98 %, aparecen en la página publicada. Seis de esas coincidencias solo difieren de la base de datos en el carácter de apóstrofo utilizado, y las contamos como coincidencias, algo que preferimos declarar antes que redondear sin decirlo. Ochenta y seis de las 87 plantillas se verificaron por completo. La que no se pudo verificar es la más larga, con 14 preguntas, y su página publicada no muestra actualmente ninguna pregunta de vista previa, así que sus preguntas no se pudieron confirmar desde fuera.
La duración de la plantilla no te dice la tasa de respuesta a las invitaciones. Nuestro estudio de referencia sobre envíos de encuestas, que es independiente, examina el comportamiento después de que las personas interactúan con una encuesta; no cuenta a todas las personas invitadas. Para planificar las invitaciones, usa una tasa documentada de un proyecto comparable o de una prueba piloto, y mantén coherente el denominador.
El uso práctico es limitado y real. Si tomas prestada una tasa de respuesta para el número de invitaciones de la calculadora, tómala de una encuesta de una duración parecida a la que vas a enviar, a un público similar y por un canal similar. Nuestros propios instrumentos publicados tienen entre 7 y 10 preguntas, menos de lo que suelen tener los primeros borradores.
Más invitaciones no te compran menos sesgo
Una tasa de respuesta baja crea dos problemas que parecen uno. El primero es que te quedas por debajo de tu objetivo, así que tu margen de error es más amplio de lo previsto. El segundo es que las personas que respondieron pueden diferir de las que no lo hicieron en aspectos que importan para tu resultado.
Invitar a más personas resuelve el primer problema. No resuelve de forma fiable el segundo. Groves y Peytcheva agruparon 59 estudios que midieron el sesgo de no respuesta real frente a valores verdaderos conocidos, y solo encontraron una relación pequeña entre la tasa de respuesta de una encuesta y lo sesgada que resultó. Pew comprobó la misma idea directamente: aplicó un mismo cuestionario dos veces, una con métodos estándar que obtuvieron una tasa de respuesta del 9 % y otra con un protocolo de alto esfuerzo que obtuvo un 22 %. De las 40 preguntas que compartían ambas encuestas, 28 dieron resultados a menos de 2 puntos entre sí.
El contraejemplo honesto. Ese hallazgo no se generaliza a todos los temas, y conviene saber dónde falla. En las encuestas de satisfacción, la relación es real y grande. Un estudio de 717 encuestas de satisfacción de pacientes en 164 hospitales suizos encontró que la puntuación media de satisfacción y la tasa de respuesta tenían una correlación de r = 0,61, porque las personas encantadas y las furiosas responden y el término medio ambivalente no. Si haces encuestas CSAT o NPS, una tasa de respuesta al alza puede mover tu puntuación por sí sola, y una baja probablemente te favorece.
Así que: persigue la tasa de respuesta cuando midas lo que la gente siente por ti. No la trates como un certificado de validez cuando midas cualquier otra cosa.
Tamaño de muestra en investigación cuantitativa: lo que necesita un capítulo de metodología
No existe un único tamaño de muestra adecuado para la investigación cuantitativa, y cualquier fuente que te dé uno sin preguntar qué estás midiendo está adivinando. Lo que hace que se apruebe un capítulo de metodología no es una cifra grande. Es una cifra declarada, con el nivel de confianza, el margen de error, la proporción supuesta y la población escritos al lado, y una fórmula con nombre.
Los directores de tesis suelen esperar uno de cuatro enfoques con nombre propio. En general coinciden entre sí, y conviene saber cuál te están pidiendo.
| Enfoque | Qué te pide | Resultado para N = 1000 al 95 % y 5 puntos | Úsalo cuando |
|---|---|---|---|
| Cochran (1977) | z, p, E y, después, la corrección por población finita si la población es pequeña | 278 | El predeterminado. Es la fórmula de esta página, y la que sirve de base a las demás. |
| Krejcie y Morgan (1970) | Nada. Lees la respuesta en una tabla publicada según el tamaño de la población. | 278 | Quieres una tabla citable en lugar de cálculos. Es Cochran con parámetros fijos. |
| Yamane (1967), a menudo llamada fórmula de Slovin | Solo N y el margen de error | 286 | Solo cuando p sea realmente desconocida y aceptes que el 95 % de confianza viene fijado. Consulta la advertencia de abajo. |
| Análisis de potencia | Tamaño del efecto, potencia, alfa y la prueba que vas a aplicar | Depende por completo del tamaño del efecto | Estás contrastando una hipótesis en lugar de estimar un porcentaje. Usa G*Power u OpenEpi, no esta página. |
Cochran, y por qué todo lo demás es un atajo de su fórmula
La fórmula de Cochran es la que aparece al principio de esta página: n0 = z al cuadrado por p por (1 menos p), dividido entre E al cuadrado, seguida de la corrección por población finita cuando la población es pequeña. Los demás métodos con nombre propio fijan algunos de esos datos para acortar los cálculos. Una vez que lo sabes, la familia deja de parecer cuatro reglas rivales y pasa a parecer una sola regla con tres ajustes predefinidos.
Yamane y Slovin: úsalas con los ojos abiertos
La fórmula n = N / (1 + N x e^2) aparece en miles de tesis, normalmente atribuida a Slovin. Es rápida: para N = 1000 y e = 0,05 da 286.
Conviene saber tres cosas antes de citarla.
- Es Cochran con los ajustes soldados. Si se deshace el cálculo, la fórmula es la de la proporción con p fijada en 0,5, la confianza fijada en el 95 % y z redondeada de 1,96 a 2. No puede responder con ningún otro nivel de confianza, y no tiene ningún dato de entrada para la variabilidad de tu población. Dos poblaciones del mismo tamaño pero con una dispersión muy distinta obtienen la misma respuesta, y eso no puede ser correcto.
- Ese redondeo es la razón por la que sus cifras salen altas. Con z = 2, el techo de la fórmula para una población ilimitada es exactamente 1 dividido entre e al cuadrado, es decir, 400. El techo de Cochran es 384,16, porque 1,96 al cuadrado es 3,8416 y no 4. Todas las cifras de Yamane de la tabla anterior superan en un pequeño porcentaje a las de Cochran exactamente por esa razón. Si alguna vez te has preguntado por qué dos manuales te dan dos tamaños de muestra distintos para el mismo estudio, esa suele ser la respuesta.
- La atribución no se sostiene. Una revista de estadística rastreó la historia de la fórmula y concluyó que no se puede encontrar a ninguna persona llamada Slovin detrás de ella, y que la fuente más antigua rastreable es el manual de Taro Yamane de 1967. Wolfram MathWorld la describe como una fórmula ad hoc sin rigor matemático. Si tu departamento la espera, úsala y cita a Yamane en lugar de a Slovin. Si puedes elegir, usa Cochran, porque resiste la pregunta de dónde sale el 95 %.
Reglas empíricas, calificadas con honestidad
Estas circulan mucho. Algunas son útiles, otras son folclore, y conviene saber cuál es cuál.
- Al menos 30 por grupo. Razonable como mínimo para comparar grupos, no como objetivo. Procede del punto en que las distribuciones muestrales empiezan a comportarse bien, no de ningún requisito de precisión.
- Diez casos por variable en una regresión. Una heurística práctica, muy usada y muy criticada. Preséntala como heurística, nunca como regla.
- El diez por ciento de la población. Esta es simplemente errónea, y la tabla anterior muestra por qué. El diez por ciento de 100.000 son 10.000 envíos, cuando 383 te dan la misma precisión.
- Siempre 385. Correcto solo para una población grande al 95 % y 5 puntos. Cítalo con esas condiciones o no significa nada.
- Una n pequeña para estudios de usabilidad y de producto. Nielsen Norman Group publica la versión honesta de esto: 40 participantes te dan una medida de sí o no con más o menos 15 puntos y un 95 % de confianza, y 47 te dan una media con la misma precisión. Esas cifras son pequeñas porque la precisión que se afirma es holgada. Declara la precisión en voz alta y las muestras pequeñas dejan de ser motivo de vergüenza.
Si tu estudio compara grupos en lugar de estimar un porcentaje, el tamaño de muestra se convierte en una cuestión de potencia y esta no es la calculadora adecuada. Necesitas un tamaño del efecto que estés dispuesto a defender, además de alfa y la potencia. G*Power y OpenEpi son las herramientas gratuitas que esperan la mayoría de los directores de tesis, y ambas son gratuitas. Decir dónde termina una herramienta es más útil que fingir que lo hace todo.
El trabajo cualitativo se dimensiona de otra forma
Las entrevistas y los grupos focales no se dimensionan con un margen de error, porque no estiman un porcentaje de la población. El argumento habitual es la saturación: sigues hasta que los nuevos participantes dejan de aportar temas nuevos, y luego explicas dónde ocurrió y cómo lo juzgaste. Pasar un estudio cualitativo por esta calculadora produce una cifra que parece precisa y no significa nada.
Si necesitas resultados por subgrupo, dimensiona para el subgrupo
A la mayoría de las encuestas se les pide informar por región, puesto, antigüedad o línea de producto. Aquí es donde los planes de muestreo se rompen sin hacer ruido, y la regla es breve.
Tu margen de error se aplica a un grupo solo si ese grupo tiene esa cantidad de envíos completados. Si quieres más o menos 5 puntos para cada una de seis regiones, necesitas unos 385 envíos completados en cada región, no 385 en total. Es una encuesta seis veces mayor de la que creías estar planificando.
Dos salidas honestas:
- Sobremuestrea los grupos pequeños. Invita deliberadamente a una proporción mayor de los segmentos más pequeños para que cada uno alcance su propio objetivo. Después vuelves a ponderar los resultados.
- Acepta franjas más amplias en los desgloses. Mantén una cifra global sólida y publica cada subgrupo con su propio margen de error, más amplio, al lado. Esta suele ser la respuesta correcta.
La calculadora tiene un campo para esto. Pon en Subgrupos de los que informar por separado el número de grupos de los que debes dar un resultado, y dimensionará cada grupo correctamente y sumará el total.
Delimítalo antes de lanzar la encuesta. Enumera los segmentos de los que debes informar, no los que estaría bien tener. Estima los envíos completados que cada uno puede producir de forma realista, usando preguntas demográficas para identificarlos. Si un segmento solo puede dar 80 envíos, no prometas más o menos 5 puntos para él. Con 80 envíos, la franja es de más o menos 11 puntos.
La AAPOR usa un ejemplo resuelto que merece la pena memorizar. Una encuesta a 1000 adultos tiene un margen de error global de unos 3 puntos, más o menos. Si 200 de esas personas son el subgrupo del que de verdad quieres hablar, el margen de error de ese subgrupo es de más o menos 6,9 puntos, más del doble. La cifra destacada en la portada del informe no es la que rige el gráfico de la página nueve.
Las recomendaciones publicadas sobre el tamaño mínimo de las celdas son más antiguas y más laxas que las fórmulas, y es razonable tratarlas como un mínimo y no como un objetivo: unos 100 envíos para un subgrupo del que vayas a informar como es debido, y de 20 a 50 para uno secundario que solo mencionarás de pasada.
Dónde falla la planificación del tamaño de muestra
El tamaño de muestra gestiona el error de muestreo, el ruido aleatorio de no preguntar a todo el mundo. Las encuestas reales también arrastran error sistemático, que ningún tamaño de muestra corrige y que una muestra grande puede disimular.
Tratar una muestra por conveniencia como una muestra probabilística
Todas las fórmulas de esta página suponen que cada persona tenía una probabilidad conocida y distinta de cero de ser seleccionada, y que responder no estaba muy ligado a lo que mides. Un enlace abierto en redes sociales no cumple ninguna de las dos condiciones. Aun así puedes calcular un margen de error a partir de los envíos, parecerá tranquilizador y no significará lo que dice. Explica con claridad qué tipo de muestra extrajiste realmente.
Interpretar una n mayor como una mejor medición
Una muestra grande hace que una medición ruidosa sea ruidosa con precisión. Si una pregunta es ambigua, doble o tendenciosa, más envíos no la rescatarán. Las tasas altas de preguntas sin responder y las respuestas incoherentes son señales de que primero hay que arreglar el instrumento. Reescribir una pregunta mala suele aportar más que triplicar la muestra.
Elegir la precisión sin una decisión detrás
La precisión solo tiene una respuesta correcta cuando sabes para qué es. Un tamaño de muestra es fácil de defender cuando puedes terminar esta frase: necesitamos distinguir resultados que difieren en X puntos. Es imposible de defender cuando la única justificación es que una cifra mayor parecía más segura. Vincúlalo a tu diseño de investigación y a lo que harás con el resultado.
Las cifras de esta página y su solidez
Cada cifra citada arriba es un cálculo que puedes reproducir en la calculadora o una cita que puedes comprobar. La calificación A significa replicado o directamente calculable, la B un único estudio sólido y la C muy repetido pero discutido.
| Afirmación | Cifra | Calificación | Fuente |
|---|---|---|---|
| Con un 95 % de confianza y sin estimación previa, una población grande necesita 385 envíos completados para más o menos 5 puntos. | 385 | A | Cálculo directo con la fórmula estándar de la proporción. NIST, sección 3.3.3; Israel (1992). |
| La fórmula de esta página reproduce la tabla de tamaños de muestra publicada por Krejcie y Morgan con una diferencia máxima de un envío en cada uno de los 21 tamaños de población que comprobamos. | 21 de 21 con 1 de diferencia como máximo | A | Nuestra propia comprobación frente a Krejcie y Morgan (1970). Método indicado debajo de la tabla. |
| La tasa de respuesta es un mal predictor del sesgo de no respuesta. Un metaanálisis de 59 estudios dedicados al sesgo solo encontró una relación pequeña entre ambos. | 59 estudios | A | Groves y Peytcheva (2008), Public Opinion Quarterly. |
| Pew aplicó el mismo cuestionario con una tasa de respuesta del 9 % y del 22 %. De 40 preguntas compartidas, 28 dieron resultados a menos de 2 puntos. | 28 de 40 a menos de 2 puntos | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Pero en las encuestas de satisfacción la relación es real y grande. En 717 encuestas hospitalarias, la puntuación media de satisfacción tenía una correlación de r = 0,61 con la tasa de respuesta. | r = 0.61 | B | Perneger, Peytremann-Bridevaux y Combescure (2020), BMC Health Services Research. |
| La tasa de respuesta de las encuestas a la plantilla sigue casi a la perfección el tamaño de la organización. En 2024, la encuesta a los empleados federales de EE. UU. obtuvo un 71 % en las agencias de menos de 1000 personas y un 37 % en las de más de 75.000. | 71 frente a 37 % | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, más de 1,6 millones de empleados invitados. |
| La tasa de respuesta media de 1071 encuestas online publicadas fue del 44,1 %. No existe una única tasa normal. | 44,1 % | A | Metaanálisis de Wu, Zhao y Fils-Aime (2022), Computers in Human Behavior Reports. |
| Las encuestas web obtienen una respuesta unos 12 puntos porcentuales menor que otros modos, en 114 comparaciones experimentales. | 12 puntos menos | A | Metaanálisis de Daikeler, Bosnjak y Lozar Manfreda (2020), JSSAM. |
| Reducir a la mitad el margen de error multiplica la muestra necesaria por cuatro, aproximadamente, porque n crece con 1 entre E al cuadrado. Duplicar una muestra de 1000 a 2000 aporta alrededor de un punto. | unas 4 veces | A | Propiedad algebraica de la fórmula; la AAPOR expone explícitamente el caso de 1000 a 2000. |
| Suponer p = 0,5 en lugar de una p conocida de 0,9 casi triplica la muestra que te dicen que recojas, de 139 a 385. | 139 frente a 385 | A | Cálculo directo. Reproducible en la calculadora cambiando el resultado esperado. |
| Las 87 plantillas de encuesta publicadas en este sitio tienen 14 preguntas o menos, y 86 de las 87 tienen 10 o menos. Se confirmaron 785 de sus 799 preguntas en las páginas publicadas. | 87 plantillas, 799 preguntas | A | Nuestro propio recuento del corpus de plantillas publicado, 21 de agosto de 2026, contrastado con las 87 páginas publicadas. Método, revisión manual y tasa de verificación indicados junto a la tabla. |
| No hay ninguna persona rastreable llamada Slovin detrás de la fórmula que lleva ese nombre. La fuente más antigua rastreable es Yamane (1967). | ningún autor rastreable | B | Tejada y Punzalan (2012), The Philippine Statistician; Wolfram MathWorld la califica de ad hoc. |
«Siempre necesitas 385 envíos». Solo con un 95 % de confianza, más o menos 5 puntos, p = 0,5 y una población grande. Citado sin más, es erróneo para cualquier población pequeña.
«Encuesta al 10 % de tu población». No tiene ninguna base estadística. Sobremuestrea enormemente las poblaciones grandes e inframuestrea las pequeñas.
«Una tasa de respuesta inferior al 50 o al 60 % invalida una encuesta». Ningún umbral hace eso. La escala del 50, el 60 y el 70 % es una regla general de manual sin ninguna derivación empírica detrás, y el metaanálisis de Groves y Peytcheva la contradice. La tasa de respuesta acota el sesgo en el peor de los casos. No mide el sesgo real.
«La tasa de respuesta media de las encuestas es del X %». Las cifras verificadas de los mismos pocos años van del 6 % al 71 % según quién sea la población encuestada. Cualquier media única esconde eso. Cita en su lugar la fila de la tabla anterior que corresponda a tu situación.
La fórmula de Slovin presentada como una derivación. Es la fórmula de Cochran con un 95 % de confianza y p = 0,5 fijados y z redondeada a 2, y la atribución a Slovin no tiene ninguna fuente rastreable.
La plantilla de justificación
La mayoría de los argumentos sobre el tamaño de muestra fracasan porque los supuestos nunca se pusieron por escrito. El botón Copiar la justificación de la calculadora lo redacta con tus propias cifras ya incluidas. Si prefieres montarlo tú, estas son las nueve cosas que buscará un revisor.
- Población (N): define la población e indica el recuento. Por ejemplo, todos los clientes activos de los últimos 90 días, N = 48.200.
- Qué mides: una proporción (un porcentaje) o una media (una valoración media). La fórmula de esta página dimensiona proporciones, lo que cubre la mayoría de los KPI que se publican.
- Nivel de confianza: el nivel que elegiste y por qué. La convención y la tolerancia al riesgo son motivos aceptables si lo dices.
- Margen de error (E): tu precisión objetivo global y, por separado, la de cualquier subgrupo del que prometiste informar.
- Proporción supuesta (p): el valor utilizado y de dónde salió. Di claramente si es 0,5 porque no había nada mejor.
- Corrección por población finita: si la aplicaste y qué la motivó, por ejemplo que n0 superara el 10 % de N.
- Objetivo de envíos completados (n): el número final de envíos completados necesarios después de todos los ajustes.
- Tasa de respuesta esperada: la tasa supuesta, el historial del que procede y el número de invitaciones resultante.
- Cómo seleccionarás a las personas: aleatorio simple, estratificado, censo o por conveniencia, más cualquier sobremuestreo de los segmentos clave. Nómbralo con honestidad.
Una vez lanzada la encuesta, vigila los envíos completados por segmento y no el total. Una cifra global sana puede esconder un segmento que nunca alcanzará su objetivo, y ese es un problema que todavía puedes arreglar en la primera semana y no en la cuarta. Cuando informes, acompaña cada porcentaje de su margen de error, y lee cómo analizar los datos de una encuesta antes de tratar un cambio de dos puntos como real.
Hoja de planificación del tamaño de muestra
Una página que puedes imprimir, rellenar a mano y grapar al resumen de un proyecto. Rellena la columna central antes de empezar el trabajo de campo, no después. No se envía nada a ninguna parte y no hace falta ninguna cuenta.
| Decisión | Tu valor | Indicación |
|---|---|---|
| Población (N) | Quiénes exactamente y cuántos son. Escribe la definición, no solo la cifra. | |
| Qué mides | Un porcentaje o una media. Esta página dimensiona porcentajes. | |
| Nivel de confianza | 95 % salvo que tengas un motivo. Escribe el motivo. | |
| Margen de error (E) | La diferencia que necesitas poder distinguir, en puntos. | |
| Proporción supuesta (p) | 0,5 si no hay nada mejor. Indica de dónde salió un valor distinto. | |
| Corrección por población finita | Aplicada o no, y qué la motivó. | |
| Objetivo de envíos completados (n) | La cifra final después de todos los ajustes. | |
| Subgrupos de los que se informa por separado | Cuántos, y los envíos completados que necesita cada uno por sí solo. | |
| Tasa de respuesta esperada | La tasa y el historial que la respalda. No una cifra sacada de internet. | |
| Invitaciones que enviar | Envíos completados divididos entre la tasa, redondeados hacia arriba. Nunca más que N. | |
| Cómo se selecciona a las personas | Aleatorio, estratificado, censo o por conveniencia. Nómbralo con honestidad. | |
| Control del trabajo de campo | La fecha en la que revisarás los envíos completados por segmento, no solo el total. |
Fórmula: n0 = (z^2 x p x (1 - p)) / E^2, después n = n0 / (1 + (n0 - 1) / N). Fuente: Cochran (1977); NIST/SEMATECH e-Handbook, sección 3.3.3; Israel (1992). Hoja de https://www.supersurvey.com/Sample-Size
Preguntas frecuentes
¿Qué es el tamaño de muestra?
El tamaño de muestra es el número de envíos completados de una encuesta, y se escribe n. No es el número de personas a las que invitaste ni el tamaño de la población que describes. Es el recuento con el que terminas el trabajo de campo, y es la cifra a partir de la cual se calcula tu margen de error: 385 envíos completados dan unos 5 puntos, más o menos, con un 95 % de confianza cuando la población es grande. Qué significa el tamaño de muestra explica la diferencia entre la población, las invitaciones y n.
¿Cuántos envíos necesito para una encuesta?
Para la mayoría de las encuestas, la respuesta práctica es 385 envíos completados. Es lo que devuelve la fórmula con un 95 % de confianza, un margen de error de más o menos 5 puntos porcentuales y ninguna estimación previa del resultado. Si tu población es pequeña, necesitas menos: 278 para una lista de 1000 personas, 80 para una lista de 100. Introduce tus propias cifras en la calculadora para ver la cifra exacta y los cálculos que hay detrás.
¿Qué tamaño de muestra necesito para un 95 % de confianza y un margen de error del 5 %?
385 envíos completados, si la población es grande y usas p = 0,5. El cálculo es n0 = 1,96 al cuadrado por 0,5 por 0,5, dividido entre 0,05 al cuadrado, es decir, 0,9604 dividido entre 0,0025, que da 384,16. Redondea hacia arriba y obtienes 385. Si tu población es pequeña, aplica la corrección por población finita y la cifra baja.
¿Qué es el margen de error?
El margen de error es la franja de más o menos alrededor del resultado de una encuesta que se debe a haber muestreado a algunas personas en lugar de a todas. Un resultado del 62 % con un margen de error de 5 puntos significa que el método produciría un intervalo que contiene el valor real la mayoría de las veces, y que este intervalo concreto va del 57 al 67 %. Describe solo el error de muestreo aleatorio. No dice nada sobre las personas que nunca respondieron.
¿Cómo se calcula el margen de error?
Calcula la raíz cuadrada de p por (1 menos p) dividido entre n y multiplícala por la puntuación z de tu nivel de confianza. Con un 95 % de confianza, 385 envíos y p = 0,5, es 1,96 por la raíz cuadrada de 0,25 dividido entre 385, es decir, 1,96 por 0,025482, que da 0,0499. Así que el margen de error es de más o menos 5,0 puntos porcentuales. La calculadora del margen de error de esta página lo hace por ti y muestra los cálculos.
¿Aumenta el margen de error con el tamaño de muestra?
No, disminuye, y disminuye con la raíz cuadrada de la muestra. Pasar de 100 envíos a 400 reduce a la mitad el margen de error. Pasar de 400 a 1600 lo reduce a la mitad otra vez. Esa relación con la raíz cuadrada es la razón por la que la precisión sale cara: cada decimal adicional de exactitud cuesta aproximadamente cuatro veces más envíos.
¿Es lo mismo el margen de error que el error estándar?
No. El error estándar es la dispersión subyacente de la estimación. El margen de error es el error estándar multiplicado por la puntuación z del nivel de confianza que elegiste. Con un 95 % de confianza, el margen de error equivale a unos 1,96 errores estándar. El error estándar es una propiedad de los datos. El margen de error es una decisión de presentación que se superpone a él.
¿Cuál es un buen tamaño de muestra para una investigación cuantitativa?
No existe una única cifra adecuada, y cualquier fuente que te dé una sin preguntar qué estás midiendo está adivinando. Para un estudio que informa de porcentajes de una población de menos de unas 10.000 personas, la respuesta defendible es lo que devuelva la fórmula con un 95 % de confianza y un margen de error que puedas justificar. Para una lista de 1000 son 278. La cifra que hace que se apruebe un capítulo de metodología no es una cifra grande, es una cifra declarada, con el nivel de confianza, el margen de error, la proporción supuesta y la población escritos al lado. Consulta el tamaño de muestra en investigación cuantitativa para ver las fórmulas con nombre propio que puede esperar tu director de tesis.
¿Cuál es una tasa de respuesta normal en una encuesta?
No existe una única tasa normal, y cualquier página que cite una sola cifra está adivinando. Las cifras reales y con fuente de la misma época van del 6 % (sondeos telefónicos de Pew en 2018) al 71 % (pequeñas agencias federales de EE. UU. en la Federal Employee Viewpoint Survey de 2024). Un metaanálisis de 1071 encuestas online publicadas encontró una media del 44,1 %. El tamaño de la organización importa muchísimo: la misma encuesta federal obtuvo un 71 % en las agencias de menos de 1000 personas y un 37 % en las de más de 75.000. Usa primero tu propio historial y consulta la tabla de referencias para ver cifras que puedes citar.
¿Influye el tamaño de la población en el tamaño de muestra?
Apenas, hasta que tu muestra se convierte en una parte grande de la población. Pasar de 100.000 personas a 1.000.000 cambia el requisito de 383 a 385. Pasar de 1000 personas a 100 lo cambia de 278 a 80. El tamaño de la población importa en el extremo pequeño, que es justo donde se aplica la corrección por población finita.
¿Cuándo es p = 0,5 la elección correcta?
Usa p = 0,5 siempre que no tengas una estimación previa defendible. El término p por (1 menos p) es máximo en 0,5, así que produce la mayor muestra necesaria. Eso lo convierte en el supuesto seguro: no te puedes quedar corto. Si tienes una prueba piloto, una referencia o la cifra del año pasado, úsala. Suponer p = 0,9 en lugar de 0,5 reduce la muestra necesaria de 385 a 139.
Si invito a más personas, ¿elimino el sesgo de no respuesta?
No. Más invitaciones te dan más envíos completados, lo que reduce el margen de error. El sesgo es un problema distinto: depende de si las personas que respondieron difieren de las que no lo hicieron. Un metaanálisis de 59 estudios sobre el sesgo de no respuesta solo encontró una relación pequeña entre la tasa de respuesta y el sesgo real. Pew aplicó el mismo cuestionario dos veces, con una tasa de respuesta del 9 % y del 22 %, y 28 de las 40 preguntas compartidas dieron resultados a menos de 2 puntos entre sí. Consulta el sesgo de respuesta y el sesgo de no respuesta.
¿Cómo calculo el tamaño de muestra si necesito resultados por departamento o región?
Dimensiona cada subgrupo por separado. Tu margen de error se aplica a un grupo solo si ese grupo tiene esa cantidad de envíos completados. Si quieres más o menos 5 puntos para cada región, cada región necesita sus propios 385 envíos completados, o su propia cifra corregida por población finita. Usa preguntas demográficas para identificar los grupos y planifica sobremuestrear los pequeños.
¿Qué tamaño de muestra necesito para un resultado estadísticamente significativo?
Esa pregunta mezcla dos ideas. Las fórmulas del tamaño de muestra dimensionan una estimación para una precisión elegida. Las pruebas de significación comparan dos cifras y se preguntan si la diferencia podría deberse plausiblemente al azar. El tamaño que necesitas depende de lo pequeña que sea la diferencia que quieres poder detectar, no de un umbral fijo. Dimensiona la encuesta aquí y después lee la significación estadística antes de contrastar un resultado con otro.
¿Sirven estas fórmulas para la investigación cualitativa?
No. Las entrevistas, los grupos focales y el trabajo con preguntas abiertas no se dimensionan con un margen de error, porque no estiman un porcentaje de la población. El tamaño de muestra cualitativo se argumenta a partir de la saturación, el punto en el que los nuevos participantes dejan de aportar temas nuevos, y se presenta como un juicio con pruebas y no como una fórmula. No pases un estudio cualitativo por esta calculadora.
Referencias
- National Institute of Standards and Technology (NIST). (s. f.). Selecting Sample Sizes. En NIST/SEMATECH e-Handbook of Statistical Methods, sección 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.