
Το μέγεθος δείγματος μιας έρευνας είναι ο αριθμός των ολοκληρωμένων υποβολών που περιλαμβάνονται στην ανάλυσή σας και συμβολίζεται με n. Διαφέρει από τον αριθμό των προσκλήσεων ή των ατόμων στη λίστα σας. Με τις παραδοχές δειγματοληψίας του υπολογιστή, ένα μεγαλύτερο δείγμα στενεύει το περιθώριο σφάλματος· δεν εξαλείφει τη μεροληπτική στρατολόγηση ούτε τις κακοδιατυπωμένες ερωτήσεις.
Υπολογιστής μεγέθους δείγματος
Τίποτα δεν κρύβεται πίσω από εγγραφή και τίποτα δεν αποστέλλεται πουθενά. Ο υπολογιστής λειτουργεί στο πρόγραμμα περιήγησής σας, ξεκινά με μια έτοιμη απάντηση ήδη στην οθόνη και εμφανίζει τον τύπο και τους υπολογισμούς που χρησιμοποίησε, ώστε να μπορείτε να τους ελέγξετε ή να τους επαναλάβετε με το χέρι.
Πόσες υποβολές χρειάζομαι;
Ορίστε τις έξι τιμές εισόδου. Η απάντηση, ο τύπος και οι υπολογισμοί ενημερώνονται όσο πληκτρολογείτε.
Ολοκληρωμένες υποβολές που χρειάζεστε
370
Μετά τη διόρθωση πεπερασμένου πληθυσμού.
Άτομα προς πρόσκληση
1,234
Με ποσοστό απόκρισης 30%.
Κλάσμα δειγματοληψίας
3.7%
Το μερίδιο του πληθυσμού από το οποίο χρειάζεστε απάντηση.
Σύνολο, με μέγεθος ανά υποομάδα
370
Οι υπολογισμοί, βήμα προς βήμα
| Περιθώριο σφάλματος | Απαιτούμενες ολοκληρώσεις | Απαιτούμενες προσκλήσεις |
|---|
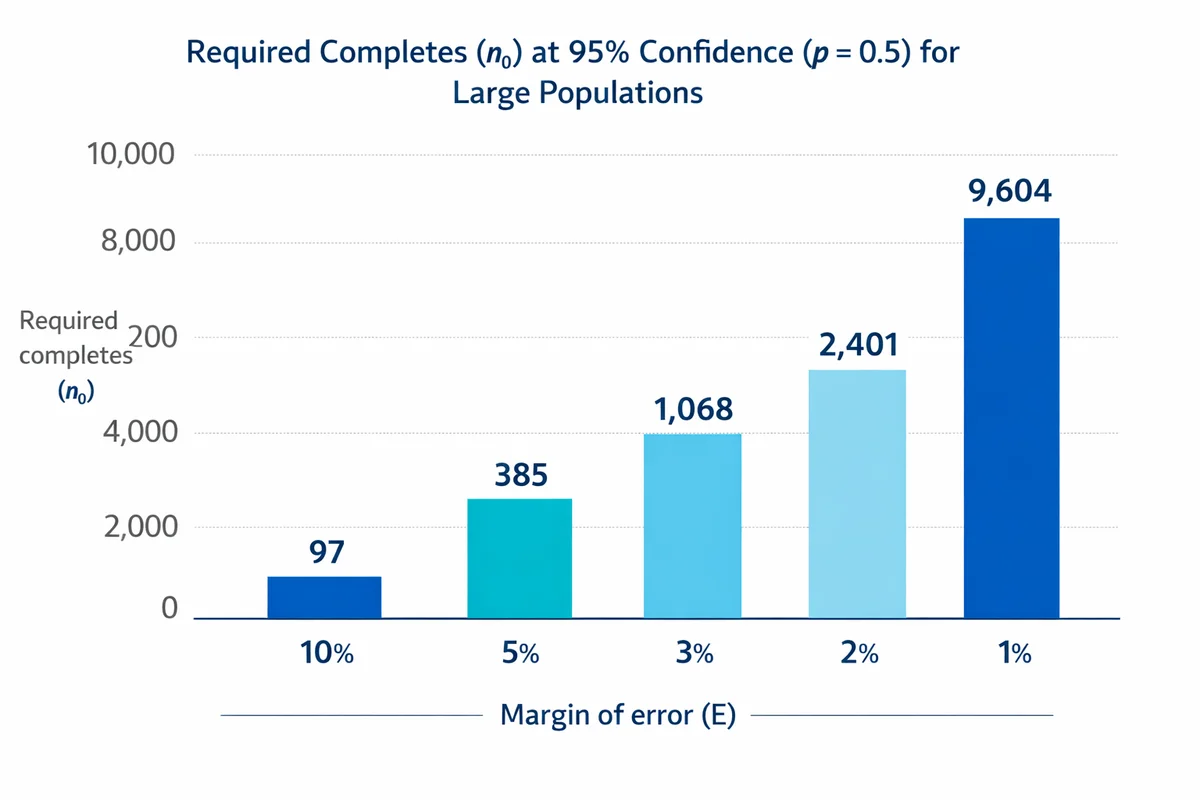
Η μεγαλύτερη ακρίβεια κοστίζει υποβολές περίπου στο τετράγωνο της βελτίωσης. Ο υποδιπλασιασμός του περιθωρίου σφάλματος πολλαπλασιάζει το δείγμα περίπου επί τέσσερα.
Το κουμπί αντιγραφής γράφει μια σύντομη παράγραφο μεθοδολογίας με τους αριθμούς σας, τον τύπο και την παραπομπή, έτοιμη για επικόλληση σε μια περιγραφή έργου ή σε ένα κεφάλαιο μεθοδολογίας.
Παραπομπή σε αυτόν τον υπολογιστή: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Το αποτέλεσμα είναι ολοκληρωμένες υποβολές, όχι προσκλήσεις. Είναι ο αριθμός που πρέπει να έχετε στα χέρια σας στο τέλος της έρευνας πεδίου. Ο αριθμός των προσκλήσεων είναι αυτός ο αριθμός διαιρεμένος με το ποσοστό απόκρισης που αναμένετε, και εκεί κάνουν λάθος τα περισσότερα σχέδια δείγματος. Μόλις οριστεί ο στόχος, δημιουργήστε το ερωτηματολόγιό σας και κάντε πιλοτική έρευνα με το κοινό για το οποίο προορίζεται. Χρησιμοποιήστε την πιλοτική έρευνα για να ελέγξετε τη διατύπωση και να εκτιμήσετε το ποσοστό από πρόσκληση σε ολοκλήρωση για το δικό σας έργο.
Τι σημαίνει μέγεθος δείγματος
Το μέγεθος δείγματος είναι ο αριθμός των ατόμων που ολοκληρώνουν την έρευνά σας. Συμβολίζεται με n σε κάθε τύπο αυτής της σελίδας, είναι το μόνο μέγεθος που αγοράζετε με την έρευνα πεδίου αντί να το επιλέγετε στο χαρτί, και είναι ο αριθμός από τον οποίο υπολογίζεται το περιθώριο σφάλματός σας.
Τρεις αριθμοί συγχέονται μαζί του, και η διάκρισή τους είναι το μεγαλύτερο μέρος της δουλειάς ενός σχεδίου δείγματος:
- Πληθυσμός (N): όλοι όσοι θέλετε να περιγράψετε. Μια λίστα πελατών, ο αριθμός του προσωπικού, μια χώρα.
- Προσκλήσεις: πόσα άτομα προσεγγίζετε. Πάντα περισσότερα από το n, επειδή δεν απαντούν όλοι.
- Μέγεθος δείγματος (n): πόσες ολοκληρωμένες υποβολές έχετε όταν τελειώνει η έρευνα πεδίου. Αυτός είναι ο αριθμός που υπολογίζει ο τύπος, και ο μόνος από τους τρεις που αλλάζει το περιθώριο σφάλματός σας.
Το μέγεθος δείγματος αγοράζει ακρίβεια, δηλαδή το εύρος της ζώνης συν ή πλην γύρω από κάθε αποτέλεσμα. Δεν αγοράζει ορθότητα, δηλαδή το αν όσοι απάντησαν μοιάζουν με όσους δεν απάντησαν. Ένα μεγάλο δείγμα ευκολίας μπορεί να απέχει περισσότερο από την αλήθεια από ένα μικρό τυχαίο, και καμία τιμή του n δεν το διορθώνει αυτό. Η ενότητα Πού κάνει λάθος ο σχεδιασμός του μεγέθους δείγματος εξηγεί τη διαφορά, και αυτό που την κρίνει είναι ο τρόπος που αντλείτε το δείγμα.
Η σύντομη απάντηση, αν θέλετε απλώς έναν αριθμό
Βασικοί αριθμοί
- Οι 385 ολοκληρωμένες υποβολές είναι η προεπιλεγμένη απάντηση. Αυτό δίνει ο τύπος με επίπεδο εμπιστοσύνης 95%, περιθώριο σφάλματος συν ή πλην 5 ποσοστιαίες μονάδες και χωρίς προηγούμενη εκτίμηση του αποτελέσματος.
- Οι μικροί πληθυσμοί χρειάζονται πολύ λιγότερες. Μια λίστα 1.000 ατόμων χρειάζεται 278. Μια λίστα 100 χρειάζεται 80. Αυτό είναι το αποτέλεσμα της διόρθωσης πεπερασμένου πληθυσμού.
- Η ακρίβεια είναι ακριβή. Ο υποδιπλασιασμός του περιθωρίου σφάλματος πολλαπλασιάζει το δείγμα περίπου επί τέσσερα. Το πέρασμα από συν ή πλην 5 μονάδες σε συν ή πλην 1 μονάδα σας πηγαίνει από 385 σε 9.604.
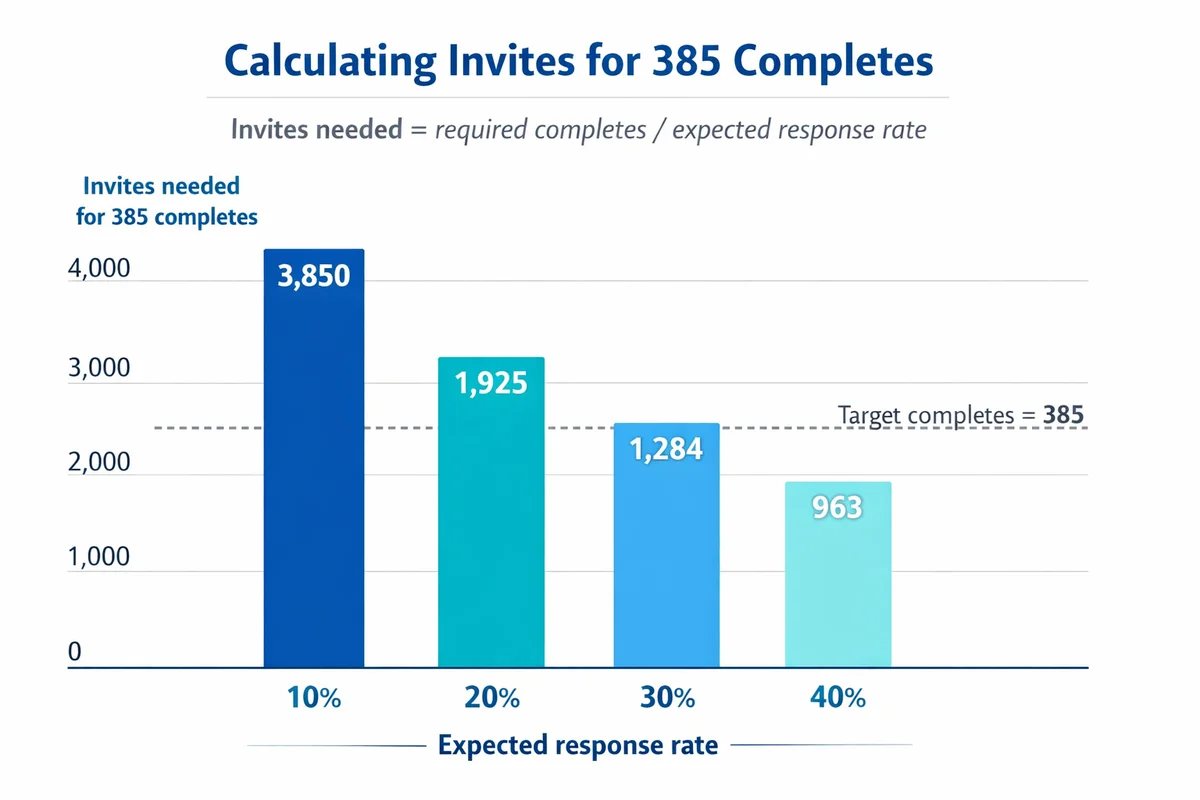
- Οι τύποι μετρούν ολοκληρώσεις, όχι προσκλήσεις. Οι απαιτούμενες προσκλήσεις ισούνται με τις ολοκληρώσεις διαιρεμένες με το αναμενόμενο ποσοστό απόκρισης. Με 30%, 385 ολοκληρώσεις σημαίνουν πρόσκληση 1.284 ατόμων.
- Το περιθώριο σφάλματος καλύπτει ένα μόνο είδος σφάλματος. Μετρά τον θόρυβο από τη δειγματοληψία ορισμένων ατόμων αντί για όλους. Δεν λέει τίποτα για όσους δεν απάντησαν ποτέ.
Ο τύπος του μεγέθους δείγματος και πώς να τον υπολογίσετε με το χέρι
Για μια έρευνα που αναφέρει ένα ποσοστό, το τυπικό σημείο εκκίνησης είναι το μέγεθος δείγματος για πληθυσμό αρκετά μεγάλο ώστε να θεωρείται απεριόριστος:
n0 = (z^2 x p x (1 - p)) / E^2
Διαβάζοντάς τον από αριστερά προς τα δεξιά:
- n0 είναι οι απαιτούμενες ολοκληρωμένες υποβολές, πριν από οποιαδήποτε διόρθωση πληθυσμού.
- z είναι η τιμή z για το επίπεδο εμπιστοσύνης σας. Χρησιμοποιήστε 1,96 για 95%.
- p είναι η αναλογία που αναμένετε να μετρήσετε, ως δεκαδικός. Χρησιμοποιήστε 0,5 αν δεν τη γνωρίζετε.
- E είναι το περιθώριο σφάλματος ως δεκαδικός. Πέντε ποσοστιαίες μονάδες είναι 0,05.
Το σύμβολο του μεγέθους δείγματος είναι το n. Ορισμένες πηγές γράφουν τον αδιόρθωτο αριθμό ως n0 και τον διορθωμένο ως n, σύμβαση που χρησιμοποιείται και εδώ.
| Επίπεδο εμπιστοσύνης | z | Τι σας κοστίζει |
|---|---|---|
| 80% | 1.282 | 165 ολοκληρώσεις για συν ή πλην 5 μονάδες |
| 90% | 1.645 | 271 ολοκληρώσεις |
| 95% (τυπικό) | 1.960 | 385 ολοκληρώσεις |
| 99% | 2.576 | 664 ολοκληρώσεις |
| 99,9% | 3.291 | 1.084 ολοκληρώσεις |
Λυμένο παράδειγμα: από τις 385 σε μια λίστα προσκλήσεων
Σενάριο. Θέλετε το ποσοστό των πελατών που θα σας σύστηναν. Θέλετε επίπεδο εμπιστοσύνης 95% και συν ή πλην 5 μονάδες. Δεν έχετε προηγούμενη εκτίμηση, οπότε p = 0,5.
Επιλέξτε επίπεδο εμπιστοσύνης και περιθώριο σφάλματος
Το επίπεδο εμπιστοσύνης 95% δίνει z = 1,96. Το συν ή πλην 5 ποσοστιαίες μονάδες είναι E = 0,05.
Επιλέξτε ένα αναμενόμενο αποτέλεσμα
p = 0,5, επειδή δεν υπάρχει προηγούμενη εκτίμηση και το 0,5 δίνει το μεγαλύτερο δείγμα. Τίποτα από όσα μάθετε αργότερα δεν μπορεί να σας αφήσει με έλλειμμα.
Εφαρμόστε τον τύπο του μεγέθους δείγματος
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Στρογγυλοποιήστε προς τα πάνω: 385 ολοκληρωμένες υποβολές. Πάντα προς τα πάνω. Δεν μπορείτε να συλλέξετε κλάσμα ερωτηματολογίου.
Διορθώστε για μικρό πληθυσμό
Αν αυτοί οι πελάτες είναι μια λίστα 1.000 ατόμων και όχι μια ανοιχτή αγορά, εφαρμόστε τη διόρθωση: n = 384,16 / (1 + 383,16 / 1.000) = 384,16 / 1,38316 = 277,7, άρα 278 ολοκληρώσεις. Η διόρθωση έχει ουσιαστική επίδραση μόνο όταν το δείγμα είναι μεγάλο μερίδιο του πληθυσμού.
Μετατρέψτε τις ολοκληρώσεις σε προσκλήσεις
Με ποσοστό απόκρισης 30%, προσκλήσεις = 278 / 0,30 = 926,7, άρα προσκαλέστε 927 άτομα. Οι ολοκληρώσεις είναι αυτό που υπολογίζει ο τύπος. Οι προσκλήσεις είναι αυτό που πραγματικά στέλνετε, και δεν μπορούν ποτέ να ξεπεράσουν τον πληθυσμό από τον οποίο αντλείτε.
Με επίπεδο εμπιστοσύνης 95% και p = 0,5, ολόκληρος ο τύπος απλοποιείται σε 0,9604 διά E στο τετράγωνο. Αυτή η μία συντόμευση απαντά στις περισσότερες ερωτήσεις μεγέθους δείγματος σε μία γραμμή, και γι’ αυτό το 385 εμφανίζεται συνεχώς στους πίνακες μεγέθους δείγματος που βρίσκετε αλλού.
Πίνακας μεγέθους δείγματος για συνηθισμένα μεγέθη πληθυσμού
Οι τιμές αυτές υπολογίζονται με τον παραπάνω τύπο, με επίπεδο εμπιστοσύνης 95%, συν ή πλην 5 μονάδες και p = 0,5, και στη συνέχεια διορθώνονται για τον πληθυσμό. Οι δύο τελευταίες στήλες είναι δικός μας έλεγχος σε σύγκριση με τον πίνακα που δημοσίευσαν οι Krejcie και Morgan το 1970, τον πίνακα που παραθέτουν τα περισσότερα κεφάλαια μεθοδολογίας.
| Πληθυσμός (N) | Απαιτούμενες ολοκληρώσεις | Krejcie και Morgan (1970) | Διαφορά |
|---|---|---|---|
| 10 | 10 | 10 | ίδιο |
| 25 | 24 | δεν αναφέρεται | |
| 50 | 45 | 44 | 1 παραπάνω |
| 100 | 80 | 80 | ίδιο |
| 200 | 132 | 132 | ίδιο |
| 500 | 218 | 217 | 1 παραπάνω |
| 1,000 | 278 | 278 | ίδιο |
| 2,000 | 323 | 322 | 1 παραπάνω |
| 5,000 | 357 | 357 | ίδιο |
| 10,000 | 370 | 370 | ίδιο |
| 50,000 | 382 | 381 | 1 παραπάνω |
| 100,000 | 383 | 384 | 1 λιγότερη |
Πώς το ελέγξαμε. Εφαρμόσαμε τον τύπο σε 21 μεγέθη πληθυσμού και συγκρίναμε κάθε αποτέλεσμα με τη δημοσιευμένη τιμή των Krejcie και Morgan. Δώδεκα ταίριαξαν ακριβώς. Οι άλλες εννέα διέφεραν κατά ακριβώς μία υποβολή, κάτι που οφείλεται στο σημείο όπου στρογγυλοποιεί κάθε μέθοδος και όχι σε διαφωνία για τους υπολογισμούς. Αν ένας επιβλέπων σας ρωτήσει γιατί ο αριθμός σας διαφέρει κατά ένα από τον πίνακα, αυτός είναι ο λόγος.
Αξίζει να το ξέρετε αν παραθέτετε αυτόν τον πίνακα: οι Krejcie και Morgan δεν διατύπωσαν δικό τους τύπο. Το άρθρο τους του 1970 είναι περίπου 400 λέξεις και ένας πίνακας, και η μοναδική του παραπομπή αποδίδει τον τύπο σε ένα ερευνητικό δελτίο του 1960 της National Education Association. Η δική τους περίληψη του μοτίβου παραμένει η καλύτερη περιγραφή του σε μία γραμμή: καθώς ο πληθυσμός μεγαλώνει, το απαιτούμενο δείγμα αυξάνεται με φθίνοντα ρυθμό και σταθεροποιείται σε λίγο περισσότερες από 380 περιπτώσεις.
Επιλογή των τιμών εισόδου, μία προς μία
Τέσσερις αριθμοί καθορίζουν την απάντηση. Οι τρεις από αυτούς είναι αποφάσεις, όχι δεδομένα, και ο καθένας έχει έναν υποστηρίξιμο τρόπο επιλογής.
Επίπεδο εμπιστοσύνης: πόσο συχνά η μέθοδος πέφτει μέσα
Το επίπεδο εμπιστοσύνης περιγράφει τη μέθοδο, όχι τη συγκεκριμένη έρευνα. Με επίπεδο εμπιστοσύνης 95%, τα διαστήματα που κατασκευάζονται με αυτόν τον τρόπο περιέχουν την πραγματική τιμή 95 φορές στις 100 μακροπρόθεσμα. Δεν είναι πιθανότητα 95% ότι η συγκεκριμένη απάντησή σας είναι σωστή.
Χρησιμοποιήστε 95%, εκτός αν έχετε λόγο να μην το κάνετε. Η μετάβαση στο 99% αυξάνει το δείγμα από 385 σε 664 για την ίδια ακρίβεια, δηλαδή αύξηση κόστους 72% για ελάχιστο όφελος. Η σχετική έννοια στον έλεγχο υποθέσεων είναι το άλφα, γι’ αυτό και πολλοί τα συγχέουν. Αν αυτή η διάκριση δεν σας είναι ξεκάθαρη, διαβάστε για τη στατιστική σημαντικότητα και τι σημαίνουν οι τιμές p πριν επιλέξετε αριθμό.
Περιθώριο σφάλματος: η μεταβλητή της απόφασης
Αυτή είναι η τιμή που αξίζει τη μεγαλύτερη σκέψη, επειδή είναι η μόνη τιμή εισόδου που συνδέει το δείγμα με μια απόφαση. Επιλέξτε τη ρωτώντας ποια διαφορά θα άλλαζε αυτό που κάνετε.
Αν ενεργείτε διαφορετικά όταν η ικανοποίηση είναι 72% αντί για 74%, χρειάζεστε στενό περιθώριο. Αν ενεργείτε μόνο στη διαφορά 72 έναντι 82, το συν ή πλην 5 μονάδες είναι υπεραρκετό. Οι γενικές συνοπτικές αναφορές συνήθως καταλήγουν στις 5 μονάδες για έναν γρήγορο έλεγχο ή στις 3 μονάδες για παρακολούθηση. Κάτω από τις 2 μονάδες το κόστος ανεβαίνει γρήγορα.
Μέγεθος πληθυσμού: ως επί το πλείστον αδιάφορο, μέχρι να μην είναι
Για μεγάλους πληθυσμούς το απαιτούμενο δείγμα σχεδόν δεν αλλάζει. Δέκα χιλιάδες άτομα χρειάζονται 370 υποβολές. Εκατό χιλιάδες χρειάζονται 383. Το μέγεθος του πληθυσμού έχει επίδραση μόνο όταν το δείγμα σας είναι σημαντικό μερίδιό του, όπως στις λίστες εργαζομένων, στα μητρώα μελών και στις σχολικές τάξεις. Αυτό εξετάζει η επόμενη ενότητα.
Αναμενόμενο αποτέλεσμα (p): χρησιμοποιήστε 0,5 όταν δεν το γνωρίζετε
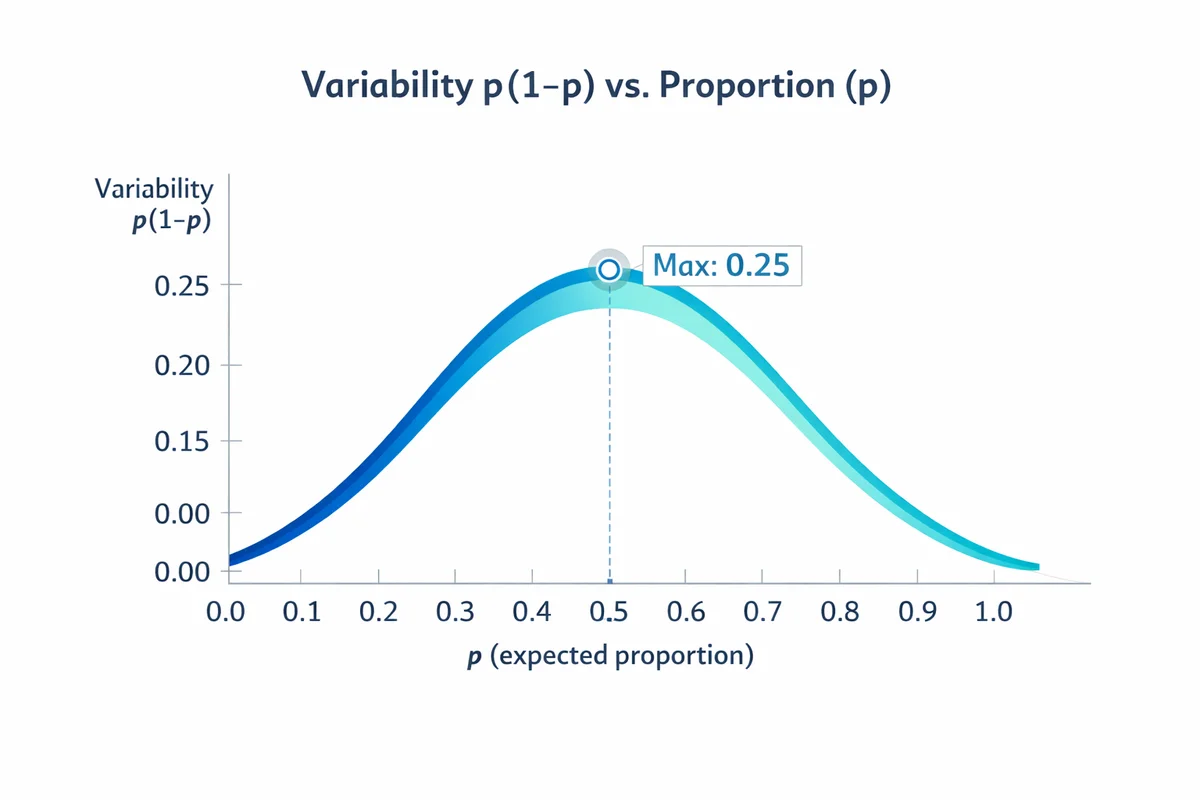
Για μια ερώτηση ποσοστού, την αβεβαιότητα την καθορίζει το p επί (1 μείον p). Αυτός ο όρος είναι μέγιστος στο p = 0,5, οπότε το 0,5 είναι η συντηρητική επιλογή και δίνει το μεγαλύτερο δείγμα. Είναι η σωστή προεπιλογή όταν δεν έχετε προηγούμενη εκτίμηση.
Αν έχετε, χρησιμοποιήστε τη, γιατί η εξοικονόμηση είναι μεγάλη. Με επίπεδο εμπιστοσύνης 95% και συν ή πλην 5 μονάδες, το p = 0,5 απαιτεί 385 υποβολές και το p = 0,9 απαιτεί 139. Προηγούμενες έρευνες, μια πιλοτική έρευνα ή ένα δημοσιευμένο σημείο αναφοράς είναι όλες θεμιτές πηγές για αυτή την εκτίμηση. Οι θορυβώδεις ερωτήσεις διογκώνουν επίσης τη διασπορά, οπότε η σαφέστερη διατύπωση μπορεί να σταθεροποιήσει ένα αποτέλεσμα χωρίς επιπλέον υποβολές. Η διατύπωση καλύτερων ερωτήσεων για έρευνες είναι συχνά φθηνότερη από τη συλλογή περισσότερων υποβολών.
Μικροί πληθυσμοί: η διόρθωση πεπερασμένου πληθυσμού
Ο βασικός τύπος υποθέτει ότι αντλείτε από μια δεξαμενή τόσο βαθιά ώστε η αφαίρεση ατόμων να μην αλλάζει τίποτα. Όταν το δείγμα σας είναι ένα πραγματικό κομμάτι του πληθυσμού, αυτή η παραδοχή σας χρεώνει παραπάνω. Η διόρθωση πεπερασμένου πληθυσμού σας επιστρέφει τις υποβολές.
n = n0 / (1 + ((n0 - 1) / N))
- n είναι ο διορθωμένος αριθμός ολοκληρώσεων που χρειάζεστε.
- n0 είναι ο αδιόρθωτος αριθμός από τον παραπάνω τύπο.
- N είναι το μέγεθος του πληθυσμού.
Το συνηθισμένο κριτήριο είναι το n0 να ξεπερνά περίπου το 5% του N. Κάτω από αυτό η διόρθωση δεν αλλάζει σχεδόν τίποτα, οπότε δεν αξίζει να την εξηγήσετε σε κανέναν.
Λυμένο παράδειγμα: μια έρευνα εργαζομένων
Σενάριο. Έχετε 1.200 εργαζομένους. Θέλετε επίπεδο εμπιστοσύνης 95%, συν ή πλην 5 μονάδες, και χρησιμοποιείτε p = 0,5.
- Χωρίς διόρθωση, n0 = 384,16.
- Με διόρθωση: n = 384,16 / (1 + (383,16 / 1.200)) = 384,16 / 1,3193 = 291,2.
- Στρογγυλοποίηση προς τα πάνω: 292 ολοκληρωμένες υποβολές.
Χωρίς τη διόρθωση θα κυνηγούσατε 385 υποβολές από μια λίστα 1.200 ατόμων, δηλαδή το 32% όλων. Με αυτήν, οι 292 δίνουν την ίδια ακρίβεια. Σε μια λίστα τέτοιου μεγέθους, αυτό είναι ένας μήνας κυνηγητού που δεν χρειάζεται να κάνετε.
Κάτω από περίπου 200 άτομα, το διορθωμένο δείγμα είναι τόσο μεγάλο μερίδιο της λίστας που η πρόσκληση όλων είναι απλούστερη και πιο υποστηρίξιμη. Μια απογραφή 150 ατόμων δεν έχει καθόλου δειγματοληπτικό σφάλμα. Η προσπάθειά σας στρέφεται τότε στο ποσοστό απόκρισης και στο ποιοι λείπουν, εκεί όπου ανήκει.
Περιθώριο σφάλματος: ο ίδιος τύπος, αντίστροφα
Το περιθώριο σφάλματος είναι η ζώνη συν ή πλην γύρω από ένα αποτέλεσμα έρευνας, που προκύπτει επειδή ρωτήσατε ορισμένα άτομα αντί για όλους. Αν το 62% από 385 συμμετέχοντες επιλέξει μια απάντηση και το περιθώριο σφάλματος είναι 5 μονάδες, αναφέρετε 62% και λέτε ότι το εύλογο εύρος είναι από 57 έως 67%.
Αν λύσετε τον τύπο του μεγέθους δείγματος ως προς E, προκύπτει:
E = z x τετραγωνική ρίζα του (p x (1 - p) / n)
Με πεπερασμένο πληθυσμό, πολλαπλασιάστε το επί την τετραγωνική ρίζα του (N - n) διά (N - 1). Και οι δύο εκδοχές υπάρχουν στον παρακάτω υπολογιστή, ο οποίος αλλάζει αυτόματα όταν επιλέγετε ή αποεπιλέγετε το πλαίσιο του πληθυσμού.
Ποιο είναι το περιθώριο σφάλματος για τις υποβολές που έχω ήδη;
Ο ίδιος τύπος, αναδιατεταγμένος. Εισαγάγετε τις υποβολές που συλλέξατε και δείτε την ακρίβεια.
Περιθώριο σφάλματος
5.0
Ποσοστιαίες μονάδες, συν ή πλην.
Το διάστημά σας
45,0 έως 55,0
Ποσοστό, με επίπεδο εμπιστοσύνης 95%.
Οι υπολογισμοί, βήμα προς βήμα
Αυξάνεται το περιθώριο σφάλματος με το μέγεθος δείγματος;
Μειώνεται, και μειώνεται με την τετραγωνική ρίζα του n. Αυτή η τετραγωνική ρίζα είναι ολόκληρη η οικονομία των ερευνών. Τετρακόσιες υποβολές σας δίνουν το μισό σφάλμα από εκατό. Για να το υποδιπλασιάσετε ξανά χρειάζεστε 1.600. Κάθε επιπλέον δεκαδικό ψηφίο ακρίβειας κοστίζει περίπου τετραπλάσια έρευνα πεδίου, γι’ αυτό το 385 είναι τόσο συνηθισμένο σημείο κατάληξης: εκεί σταματούν να αντιμάχονται το κόστος και η ακρίβεια.
Τέσσερις όροι που συγχέονται
Το τυπικό σφάλμα, το περιθώριο σφάλματος, το επίπεδο εμπιστοσύνης και το διάστημα εμπιστοσύνης χρησιμοποιούνται σαν να ήταν εναλλάξιμα. Είναι τέσσερα διαφορετικά πράγματα, και η διαφορά μετράει όταν κάποιος αμφισβητεί τον αριθμό σας.
| Όρος | Τι είναι | Με 385 υποβολές και 50% |
|---|---|---|
| Τυπικό σφάλμα | Η βασική διασπορά της εκτίμησης. Η τετραγωνική ρίζα του p επί (1 μείον p) διά n. | 0,0255, δηλαδή 2,55 ποσοστιαίες μονάδες |
| Περιθώριο σφάλματος | Το τυπικό σφάλμα πολλαπλασιασμένο με την τιμή z του επιπέδου εμπιστοσύνης που επιλέξατε. | Συν ή πλην 5,0 μονάδες στο 95% |
| Επίπεδο εμπιστοσύνης | Η τιμή z που επιλέξατε, εκφρασμένη ως ποσοστό. Επιλογή, όχι μέτρηση. | 95%, άρα z = 1,96 |
| Διάστημα εμπιστοσύνης | Το αποτέλεσμα με εφαρμοσμένο το περιθώριο σφάλματος, γραμμένο ως εύρος. | 45,0% έως 55,0% |
Συνοπτικά: το τυπικό σφάλμα είναι ιδιότητα των δεδομένων σας, το επίπεδο εμπιστοσύνης είναι μια επιλογή που κάνατε, το περιθώριο σφάλματος είναι το γινόμενο των δύο και το διάστημα εμπιστοσύνης είναι αυτό που τυπώνετε στην αναφορά.
Τι δεν καλύπτει το περιθώριο σφάλματος
Καλύπτει το τυχαίο δειγματοληπτικό σφάλμα και τίποτε άλλο. Δεν καλύπτει όσους αγνόησαν την πρόσκληση, μια λίστα από την οποία έλειπε μέρος του πληθυσμού, ή μια ερώτηση που οι μισοί συμμετέχοντες διάβασαν διαφορετικά από ό,τι εννοούσατε. Μια έρευνα μπορεί να έχει ένα τακτοποιημένο περιθώριο σφάλματος και να είναι παρ’ όλα αυτά λάθος. Δείτε τη μεροληψία απόκρισης και τη μεροληψία μη απόκρισης για τα σφάλματα που κανένα μέγεθος δείγματος δεν διορθώνει.
Ο επαγγελματικός φορέας της έρευνας με ερωτηματολόγια το λέει πιο ωμά από τους περισσότερους παρόχους. Η AAPOR δηλώνει ότι δεν υπάρχει μετρήσιμο συνολικό περιθώριο σφάλματος για μια δημοσκόπηση, επειδή οι έρευνες φέρουν και άλλα σφάλματα που δεν μετρώνται καθόλου, από τον τρόπο διατύπωσης των ερωτήσεων μέχρι τον τρόπο διεξαγωγής των συνεντεύξεων. Αυτό που μπορείτε να υπολογίσετε είναι το δειγματοληπτικό κομμάτι. Αυτό το κομμάτι σας δίνει ο υπολογιστής, και αξίζει να είναι σαφές ότι πρόκειται για ένα κομμάτι.
Δύο κανόνες χρήσης από την ίδια πηγή, που τα περισσότερα κείμενα για έρευνες κάνουν λάθος:
- Είναι ποσοστιαίες μονάδες, όχι ποσοστό. Γράψτε «συν ή πλην 3 ποσοστιαίες μονάδες», όχι «συν ή πλην 3%». Σημαίνουν διαφορετικά πράγματα.
- Δεν ισχύει καθόλου για δείγματα εθελοντικής συμμετοχής. Ένα περιθώριο σφάλματος προϋποθέτει ότι κάθε άτομο είχε γνωστή, μη μηδενική πιθανότητα επιλογής. Ένας ανοιχτός σύνδεσμος, ένα πάνελ εθελοντών ή μια ανάρτηση στα μέσα κοινωνικής δικτύωσης δεν το πληρούν. Αν δημοσιεύετε περιθώριο σφάλματος δίπλα σε αποτελέσματα από ανοιχτό σύνδεσμο, ισχυρίζεστε μια ακρίβεια που δεν αγοράσατε.
Μετατροπή των ολοκληρώσεων σε προσκλήσεις
Ο τύπος σας δίνει ολοκληρωμένες υποβολές. Η έρευνα πεδίου σας δίνει ένα ποσοστό απόκρισης. Το κενό ανάμεσά τους είναι εκεί όπου συνήθως αποτυγχάνουν τα σχέδια δείγματος, και ο υπολογισμός είναι μία γραμμή:
Προσκλήσεις = απαιτούμενες ολοκληρώσεις / αναμενόμενο ποσοστό απόκρισης
Χρησιμοποιήστε το ποσοστό ως δεκαδικό, άρα 30% είναι 0,30, και στρογγυλοποιήστε προς τα πάνω. Για 292 ολοκληρώσεις με 35%, αυτό είναι 292 διά 0,35 = 834,3, οπότε προσκαλέστε τουλάχιστον 835 άτομα.
| Απαιτούμενες ολοκληρώσεις | Αναμενόμενο ποσοστό απόκρισης | Προσκλήσεις |
|---|---|---|
| 385 | 60% | 642 |
| 385 | 30% | 1,284 |
| 385 | 15% | 2,567 |
| 292 | 50% | 584 |
| 292 | 35% | 835 |
| 292 | 20% | 1,460 |
Επιλογή ενός ποσοστού απόκρισης που μπορείτε να υποστηρίξετε
Το δικό σας ιστορικό είναι καλύτερο από οποιοδήποτε δημοσιευμένο σημείο αναφοράς, αρκεί να αφορά το ίδιο κοινό, το ίδιο κανάλι και παρόμοιο μήκος ερωτηματολογίου. Αν δεν έχετε κανένα στοιχείο, σχεδιάστε τρία σενάρια με 20, 30 και 40% και αντιμετωπίστε τη λίστα προσκλήσεων ως ρυθμιζόμενο μοχλό κατά την έρευνα πεδίου. Οι υπενθυμίσεις, ένα μεγαλύτερο χρονικό παράθυρο και μια ευρύτερη λίστα είναι όλα πράγματα που μπορείτε να αλλάξετε στην πορεία. Ο στόχος ολοκληρώσεων όχι.
Οι περισσότεροι πίνακες σημείων αναφοράς στο διαδίκτυο παραθέτουν έναν μέσο όρο χωρίς πηγή. Δεν υπάρχει ενιαίος μέσος όρος. Ορίστε τι αναφέρουν πραγματικά οι πρωτογενείς πηγές, ώστε να παραθέσετε τη γραμμή που ταιριάζει στην περίπτωσή σας αντί για έναν αριθμό που επινόησε κάποιος.
| Πλαίσιο | Ποσοστό απόκρισης | Κλίμακα και πηγή |
|---|---|---|
| Ομοσπονδιακοί φορείς των ΗΠΑ με λιγότερους από 1.000 υπαλλήλους | 71% | 2024 Federal Employee Viewpoint Survey (OPM) |
| Ομοσπονδιακοί φορείς των ΗΠΑ με 1.000 έως 9.999 υπαλλήλους | 60% | Ίδια έρευνα, ίδιο έτος (OPM) |
| Ομοσπονδιακοί φορείς των ΗΠΑ με περισσότερους από 75.000 υπαλλήλους | 37% | Ίδια έρευνα, ίδιο έτος (OPM) |
| Όλοι οι ομοσπονδιακοί υπάλληλοι των ΗΠΑ | 41% | Πάνω από 1,6 εκατομμύρια προσκλήσεις, πάνω από 674.000 υποβολές, 2024 (OPM) |
| Δημοσιευμένες διαδικτυακές έρευνες, όλων των ειδών | 44,1% κατά μέσο όρο | Μετα-ανάλυση 1.071 αναφερόμενων ποσοστών (Wu κ.ά., 2022) |
| Δημοσιευμένη οργανωσιακή έρευνα | 68% το 2020, από 48% το 2005 | 1.014 έρευνες σε 17 επιστημονικά περιοδικά (Holtom κ.ά., 2022) |
| Τηλεφωνικές δημοσκοπήσεις στο ευρύ κοινό | 6% το 2018, από 36% το 1997 | Το ποσοστό που παρακολουθεί το ίδιο το Pew Research Center (Kennedy και Hartig, 2019) |
| Διαδικτυακή συλλογή έναντι οποιουδήποτε άλλου τρόπου | περίπου 12 μονάδες χαμηλότερο | Μετα-ανάλυση 114 πειραματικών συγκρίσεων (Daikeler κ.ά., 2020) |
Δύο πράγματα προκύπτουν από αυτόν τον πίνακα. Πρώτον, το μέγεθος της ομάδας που ερευνάτε προβλέπει το ποσοστό καλύτερα από σχεδόν οτιδήποτε άλλο ελέγχετε. Μια εταιρεία 300 ατόμων και ένας φορέας 300.000 ατόμων δεν κάνουν την ίδια έρευνα. Δεύτερον, ο ευρέως επαναλαμβανόμενος ισχυρισμός ότι τα ποσοστά απόκρισης καταρρέουν παντού ισχύει μόνο σε ορισμένα πεδία. Οι τηλεφωνικές δημοσκοπήσεις όντως κατέρρευσαν. Η δημοσιευμένη οργανωσιακή έρευνα κινήθηκε προς την αντίθετη κατεύθυνση, από 48% σε 68% μέσα σε δεκαπέντε χρόνια.
Ένας ακόμη υπολογισμός σχεδιασμού που αξίζει να δανειστείτε: η τυπική καθοδήγηση είναι να προσθέσετε περίπου 10% στη λίστα προσκλήσεων για άτομα που απλώς δεν μπορείτε να προσεγγίσετε και περίπου 30% για άτομα που θα μπορούσαν να απαντήσουν αλλά δεν απαντούν.
Τι λέει για το μήκος η δική μας συλλογή προτύπων
Ένα ποσοστό απόκρισης δανεισμένο από την έρευνα κάποιου άλλου δεν μεταφέρεται καλά, και το μήκος είναι από τα λίγα πράγματα σε αυτή τη λίστα που ελέγχετε πλήρως. Ακολουθεί ένα στοιχείο που μπορούμε να παράγουμε εμείς και όχι ένας ανταγωνιστής, επειδή προέρχεται από την καταμέτρηση της δικής μας δημοσιευμένης συλλογής και όχι από την ερώτηση σε επαγγελματίες για το τι νομίζουν ότι κάνουν.
Στον έλεγχό μας της 21ης Αυγούστου 2026, και τα 87 πρότυπα ερωτηματολογίων είχαν 14 ερωτήσεις ή λιγότερες, και τα 86 είχαν 10 ερωτήσεις ή λιγότερες. Συνολικά περιείχαν 799 ερωτήσεις. Η διάμεσος ήταν 9 ερωτήσεις και μόνο ένα πρότυπο ξεπερνούσε τις 10. Αυτά τα στοιχεία περιγράφουν εκείνο το χρονολογημένο στιγμιότυπο, όχι την τρέχουσα βιβλιοθήκη.
| Ερωτήσεις στο πρότυπο | Πρότυπα | Μερίδιο της συλλογής |
|---|---|---|
| 7 ερωτήσεις | 4 | 5% |
| 8 ερωτήσεις | 17 | 20% |
| 9 ερωτήσεις | 29 | 33% |
| 10 ερωτήσεις | 36 | 41% |
| 14 ερωτήσεις | 1 | 1% |
Κατά μορφή απάντησης, 355 από τις 799 ερωτήσεις είναι κλίμακες αξιολόγησης, 281 είναι λίστες μίας επιλογής και 163 ζητούν από τον αναγνώστη να πληκτρολογήσει κάτι. Αυτή η τελευταία ομάδα είναι αυτή που σας κοστίζει ολοκληρώσεις, γι’ αυτό τη διαβάσαμε με το χέρι αντί να εμπιστευτούμε το αποθηκευμένο πεδίο. Από τις 163, οι 137 είναι πλαίσια σχολίων πολλών γραμμών. Οι υπόλοιπες 26 είναι πλαίσια μίας γραμμής, και η ανάγνωσή τους έδειξε ότι οι 22 είναι σύντομα πεδία αναγνώρισης ή κατάταξης: ένα όνομα, μια διεύθυνση email, μια ημερομηνία, ένα τμήμα, ένας τίτλος θέσης. Μόνο 4 είναι ουσιαστικές σύντομες απαντήσεις. Έτσι, η έντιμη καταμέτρηση των πραγματικών ερωτήσεων ανοιχτού τύπου είναι 141, δηλαδή περίπου μία ερώτηση στις έξι, και όχι μία στις πέντε που θα μας έδινε το ακατέργαστο πεδίο.
Πώς μετρήσαμε και πώς το ελέγξαμε. Αναλύσαμε την αποθηκευμένη λίστα ερωτήσεων κάθε προτύπου ερωτηματολογίου που ήταν διαθέσιμο σε αυτόν τον ιστότοπο στις 21 Αυγούστου 2026, κρατήσαμε τις εγγραφές που είχαν κείμενο ερώτησης και στη συνέχεια ανακτήσαμε κάθε δημοσιευμένη σελίδα και συγκρίναμε τα δύο σύνολα, αντί να εμπιστευτούμε μόνο τη δική μας βάση δεδομένων. Και οι 87 σελίδες επέστρεψαν HTTP 200, ενώ μια διεύθυνση που ξέρουμε ότι δεν υπάρχει επέστρεψε 410 στην ίδια εκτέλεση, οπότε ο έλεγχος έκανε πραγματικές διακρίσεις και δεν έβγαζε απλώς παντού θετικό αποτέλεσμα. 785 από τις 799 ερωτήσεις, δηλαδή το 98%, εμφανίζονται στη δημοσιευμένη σελίδα. Έξι από αυτές τις αντιστοιχίσεις διαφέρουν από τη βάση δεδομένων μόνο ως προς τον χαρακτήρα αποστρόφου που χρησιμοποιείται, και τις μετρήσαμε ως αντιστοιχίσεις, κάτι που προτιμούμε να γνωστοποιήσουμε παρά να το εξαφανίσουμε σιωπηλά με στρογγυλοποίηση. Ογδόντα έξι από τα 87 πρότυπα επαληθεύτηκαν πλήρως. Αυτό που δεν επαληθεύτηκε είναι το μεγαλύτερό μας, με 14 ερωτήσεις, και η δημοσιευμένη σελίδα του αυτή τη στιγμή δεν εμφανίζει καθόλου ερωτήσεις προεπισκόπησης, οπότε οι ερωτήσεις του δεν μπόρεσαν να επιβεβαιωθούν από έξω.
Το μήκος του προτύπου δεν σας λέει το ποσοστό απόκρισης στις προσκλήσεις. Το ξεχωριστό μας σημείο αναφοράς για τις υποβολές ερευνών εξετάζει τη συμπεριφορά αφού τα άτομα αλληλεπιδράσουν με ένα ερωτηματολόγιο· δεν μετρά όλους όσοι προσκλήθηκαν. Για τον σχεδιασμό των προσκλήσεων, χρησιμοποιήστε ένα τεκμηριωμένο ποσοστό από ένα συγκρίσιμο έργο ή μια πιλοτική έρευνα και κρατήστε τον παρονομαστή συνεπή.
Η πρακτική χρήση είναι περιορισμένη αλλά πραγματική. Αν δανείζεστε ένα ποσοστό απόκρισης για τον αριθμό προσκλήσεων στον υπολογιστή, δανειστείτε το από μια έρευνα με μήκος παρόμοιο με εκείνη που πρόκειται να στείλετε, σε παρόμοιο κοινό και μέσω παρόμοιου καναλιού. Τα δικά μας δημοσιευμένα ερωτηματολόγια έχουν από 7 έως 10 ερωτήσεις, δηλαδή είναι συντομότερα από τα περισσότερα αρχικά προσχέδια.
Περισσότερες προσκλήσεις δεν σας αγοράζουν λιγότερη μεροληψία
Ένα χαμηλό ποσοστό απόκρισης δημιουργεί δύο προβλήματα που μοιάζουν με ένα. Το πρώτο είναι ότι μένετε κάτω από τον στόχο σας, οπότε το περιθώριο σφάλματος είναι ευρύτερο από ό,τι σχεδιάσατε. Το δεύτερο είναι ότι όσοι απάντησαν μπορεί να διαφέρουν από όσους δεν απάντησαν, με τρόπους που έχουν σημασία για το αποτέλεσμά σας.
Η πρόσκληση περισσότερων ατόμων διορθώνει το πρώτο πρόβλημα. Δεν διορθώνει αξιόπιστα το δεύτερο. Οι Groves και Peytcheva συγκέντρωσαν 59 μελέτες που μέτρησαν την πραγματική μεροληψία μη απόκρισης σε σχέση με γνωστές πραγματικές τιμές, και βρήκαν μόνο μικρή σχέση ανάμεσα στο ποσοστό απόκρισης μιας έρευνας και στο πόσο μεροληπτική αποδείχθηκε. Το Pew εξέτασε την ίδια ιδέα άμεσα: έτρεξε ένα ερωτηματολόγιο δύο φορές, μία με τυπικές μεθόδους που πέτυχαν ποσοστό απόκρισης 9% και μία με ένα πρωτόκολλο υψηλής προσπάθειας που πέτυχε 22%. Από τις 40 ερωτήσεις που είχαν κοινές οι δύο έρευνες, οι 28 έδωσαν αποτελέσματα με απόκλιση έως 2 μονάδες μεταξύ τους.
Το έντιμο αντεπιχείρημα. Αυτό το εύρημα δεν γενικεύεται σε κάθε θέμα, και αξίζει να ξέρετε πού παύει να ισχύει. Στις έρευνες ικανοποίησης η σχέση είναι πραγματική και μεγάλη. Μια μελέτη 717 ερευνών ικανοποίησης ασθενών σε 164 ελβετικά νοσοκομεία βρήκε ότι η μέση βαθμολογία ικανοποίησης και το ποσοστό απόκρισης συσχετίζονταν με r = 0,61, επειδή οι ενθουσιασμένοι και οι εξοργισμένοι απαντούν, ενώ η αμφίθυμη μέση όχι. Αν κάνετε έρευνες CSAT ή NPS, ένα αυξανόμενο ποσοστό απόκρισης μπορεί από μόνο του να μετακινήσει τη βαθμολογία σας, και ένα χαμηλό μάλλον σας κολακεύει.
Άρα: κυνηγήστε το ποσοστό απόκρισης όταν μετράτε τι αισθάνονται οι άνθρωποι για εσάς. Μην το αντιμετωπίζετε ως πιστοποιητικό εγκυρότητας όταν μετράτε οτιδήποτε άλλο.
Μέγεθος δείγματος για ποσοτική έρευνα: τι χρειάζεται ένα κεφάλαιο μεθοδολογίας
Δεν υπάρχει ένα μοναδικό καλό μέγεθος δείγματος για ποσοτική έρευνα, και κάθε πηγή που σας δίνει ένα χωρίς να ρωτήσει τι μετράτε μαντεύει. Αυτό που κάνει ένα κεφάλαιο μεθοδολογίας να εγκριθεί δεν είναι ένας μεγάλος αριθμός. Είναι ένας δηλωμένος αριθμός, με το επίπεδο εμπιστοσύνης, το περιθώριο σφάλματος, την υποτιθέμενη αναλογία και τον πληθυσμό γραμμένα δίπλα του, και με έναν κατονομαζόμενο τύπο.
Οι επιβλέποντες συνήθως περιμένουν μία από τέσσερις κατονομαζόμενες προσεγγίσεις. Σε γενικές γραμμές συμφωνούν μεταξύ τους, και αξίζει να ξέρετε ποια σας ζητείται.
| Προσέγγιση | Τι σας ζητά | Αποτέλεσμα για N = 1.000 στο 95% και 5 μονάδες | Πότε τη χρησιμοποιείτε |
|---|---|---|---|
| Cochran (1977) | z, p, E και στη συνέχεια τη διόρθωση πεπερασμένου πληθυσμού αν ο πληθυσμός είναι μικρός | 278 | Η προεπιλογή. Είναι ο τύπος αυτής της σελίδας και αυτός από τον οποίο προκύπτουν οι υπόλοιποι. |
| Krejcie και Morgan (1970) | Τίποτα. Διαβάζετε την απάντηση από έναν δημοσιευμένο πίνακα ανά μέγεθος πληθυσμού. | 278 | Θέλετε έναν πίνακα που μπορεί να παρατεθεί αντί για υπολογισμούς. Είναι ο Cochran με σταθερές ρυθμίσεις. |
| Yamane (1967), που συχνά αποκαλείται Slovin | Μόνο το N και το περιθώριο σφάλματος | 286 | Μόνο όταν το p είναι πραγματικά άγνωστο και αποδέχεστε ενσωματωμένο επίπεδο εμπιστοσύνης 95%. Δείτε την προειδοποίηση παρακάτω. |
| Ανάλυση ισχύος | Μέγεθος επίδρασης, ισχύς, άλφα και ο έλεγχος που θα εφαρμόσετε | Εξαρτάται εξ ολοκλήρου από το μέγεθος επίδρασης | Ελέγχετε μια υπόθεση αντί να εκτιμάτε ένα ποσοστό. Χρησιμοποιήστε το G*Power ή το OpenEpi, όχι αυτή τη σελίδα. |
Ο Cochran, και γιατί όλα τα άλλα είναι συντομεύσεις του
Ο τύπος του Cochran είναι αυτός στην κορυφή αυτής της σελίδας: n0 = z στο τετράγωνο επί p επί (1 μείον p), διά E στο τετράγωνο, και στη συνέχεια η διόρθωση πεπερασμένου πληθυσμού όταν ο πληθυσμός είναι μικρός. Οι άλλες κατονομαζόμενες μέθοδοι σταθεροποιούν κάποιες από αυτές τις τιμές για να συντομεύσουν τους υπολογισμούς. Όταν το καταλάβετε αυτό, η οικογένεια παύει να μοιάζει με τέσσερις ανταγωνιστικούς κανόνες και αρχίζει να μοιάζει με έναν κανόνα με τρεις προκαθορισμένες ρυθμίσεις.
Yamane και Slovin: χρησιμοποιήστε τους με ανοιχτά μάτια
Ο τύπος n = N / (1 + N x e^2) εμφανίζεται σε χιλιάδες διπλωματικές και διδακτορικές εργασίες, συνήθως με απόδοση στον Slovin. Είναι γρήγορος: για N = 1.000 και e = 0,05 δίνει 286.
Τρία πράγματα αξίζει να ξέρετε πριν τον παραθέσετε.
- Είναι ο Cochran με κλειδωμένες ρυθμίσεις. Αν τον αναλύσετε αντίστροφα, ο τύπος είναι ο τύπος αναλογίας με το p σταθερό στο 0,5, το επίπεδο εμπιστοσύνης σταθερό στο 95% και το z στρογγυλοποιημένο από 1,96 σε 2. Δεν μπορεί να απαντήσει για κανένα άλλο επίπεδο εμπιστοσύνης και δεν έχει καμία τιμή εισόδου για το πόσο μεταβλητός είναι ο πληθυσμός σας. Δύο πληθυσμοί του ίδιου μεγέθους αλλά με εντελώς διαφορετική διασπορά παίρνουν την ίδια απάντηση, κάτι που δεν μπορεί να είναι σωστό.
- Αυτή η στρογγυλοποίηση εξηγεί γιατί οι αριθμοί του βγαίνουν υψηλοί. Με z = 2, το ανώτατο όριο του τύπου για απεριόριστο πληθυσμό είναι ακριβώς 1 διά e στο τετράγωνο, δηλαδή 400. Το ανώτατο όριο του Cochran είναι 384,16, επειδή το 1,96 στο τετράγωνο είναι 3,8416 και όχι 4. Κάθε τιμή του Yamane στον παραπάνω πίνακα είναι κατά μερικά τοις εκατό μεγαλύτερη από την τιμή του Cochran ακριβώς γι’ αυτόν τον λόγο. Αν έχετε ποτέ αναρωτηθεί γιατί δύο εγχειρίδια σας δίνουν δύο διαφορετικά μεγέθη δείγματος για την ίδια μελέτη, αυτή είναι συνήθως η απάντηση.
- Η απόδοση δεν ευσταθεί. Ένα στατιστικό περιοδικό εξέτασε την ιστορία του τύπου και κατέληξε ότι δεν μπορεί να εντοπιστεί κανένα πρόσωπο με το όνομα Slovin πίσω από αυτόν και ότι η παλαιότερη ανιχνεύσιμη πηγή είναι το εγχειρίδιο του Taro Yamane του 1967. Το Wolfram MathWorld τον περιγράφει ως ad hoc τύπο που στερείται μαθηματικής αυστηρότητας. Αν το τμήμα σας τον περιμένει, χρησιμοποιήστε τον και παραπέμψτε στον Yamane και όχι στον Slovin. Αν έχετε επιλογή, χρησιμοποιήστε τον Cochran, γιατί αντέχει στην ερώτηση από πού προήλθε το 95%.
Εμπειρικοί κανόνες, με έντιμη βαθμολόγηση
Αυτοί κυκλοφορούν ευρέως. Κάποιοι είναι χρήσιμοι, κάποιοι είναι λαϊκή σοφία, και βοηθά να ξέρετε ποιος είναι ποιος.
- Τουλάχιστον 30 ανά ομάδα. Λογικό ως κατώτατο όριο για συγκρίσεις ομάδων, όχι ως στόχος. Προέρχεται από το σημείο όπου οι δειγματοληπτικές κατανομές αρχίζουν να συμπεριφέρονται καλά, όχι από κάποια απαίτηση ακρίβειας.
- Δέκα περιπτώσεις ανά μεταβλητή σε μια παλινδρόμηση. Ένας πρακτικός ευρετικός κανόνας, που χρησιμοποιείται και επικρίνεται ευρέως. Αναφέρετέ τον ως ευρετικό κανόνα, ποτέ ως κανόνα.
- Το δέκα τοις εκατό του πληθυσμού. Αυτός είναι απλώς λάθος, και ο παραπάνω πίνακας δείχνει γιατί. Το δέκα τοις εκατό των 100.000 είναι 10.000 υποβολές, ενώ οι 383 σας δίνουν την ίδια ακρίβεια.
- Πάντα 385. Σωστό μόνο για μεγάλο πληθυσμό στο 95% και 5 μονάδες. Αναφέρετέ το μαζί με αυτές τις προϋποθέσεις, αλλιώς δεν σημαίνει τίποτα.
- Μικρό n για μελέτες χρηστικότητας και προϊόντων. Η Nielsen Norman Group δημοσιεύει την έντιμη εκδοχή του: 40 συμμετέχοντες σας δίνουν ένα μέτρο ναι ή όχι με ακρίβεια συν ή πλην 15 μονάδες σε επίπεδο εμπιστοσύνης 95%, και 47 σας δίνουν έναν μέσο όρο με την ίδια ακρίβεια. Αυτοί οι αριθμοί είναι μικροί επειδή η ακρίβεια που διεκδικείται είναι χαλαρή. Δηλώστε την ακρίβεια ανοιχτά και τα μικρά δείγματα παύουν να είναι ντροπή.
Αν η μελέτη σας συγκρίνει ομάδες αντί να εκτιμά ένα ποσοστό, το μέγεθος δείγματος γίνεται ζήτημα ισχύος και αυτός δεν είναι ο κατάλληλος υπολογιστής. Χρειάζεστε ένα μέγεθος επίδρασης που είστε διατεθειμένοι να υποστηρίξετε, καθώς και άλφα και ισχύ. Το G*Power και το OpenEpi είναι τα δωρεάν εργαλεία που περιμένουν οι περισσότεροι επιβλέποντες, και είναι και τα δύο δωρεάν. Το να λέτε πού σταματά ένα εργαλείο είναι πιο χρήσιμο από το να προσποιείστε ότι κάνει τα πάντα.
Η ποιοτική έρευνα υπολογίζεται διαφορετικά
Οι συνεντεύξεις και οι ομάδες εστίασης δεν υπολογίζονται με περιθώριο σφάλματος, επειδή δεν εκτιμούν ένα ποσοστό πληθυσμού. Το συνηθισμένο επιχείρημα είναι ο κορεσμός: συνεχίζετε μέχρι οι νέοι συμμετέχοντες να μην παράγουν πια νέα θέματα και μετά αναφέρετε πού συνέβη αυτό και πώς το κρίνατε. Αν περάσετε μια ποιοτική μελέτη από αυτόν τον υπολογιστή, θα πάρετε έναν αριθμό που φαίνεται ακριβής και δεν σημαίνει τίποτα.
Αν χρειάζεστε αποτελέσματα ανά υποομάδα, υπολογίστε για την υποομάδα
Από τις περισσότερες έρευνες ζητείται αναφορά ανά περιοχή, ρόλο, προϋπηρεσία ή σειρά προϊόντων. Εδώ τα σχέδια δείγματος σπάνε αθόρυβα, και ο κανόνας είναι σύντομος.
Το περιθώριο σφάλματός σας ισχύει για μια ομάδα μόνο αν αυτή η ομάδα έχει τόσες ολοκληρώσεις. Αν θέλετε συν ή πλην 5 μονάδες για καθεμία από έξι περιοχές, χρειάζεστε περίπου 385 ολοκληρώσεις σε κάθε περιοχή, όχι 385 συνολικά. Αυτό είναι μια έρευνα έξι φορές μεγαλύτερη από αυτή που νομίζατε ότι σχεδιάζατε.
Δύο έντιμες λύσεις:
- Κάντε υπερδειγματοληψία στις μικρές ομάδες. Προσκαλέστε σκόπιμα μεγαλύτερο μερίδιο από τα μικρότερα τμήματα, ώστε καθένα να φτάσει τον δικό του στόχο. Στη συνέχεια σταθμίζετε τα αποτελέσματα πίσω.
- Αποδεχτείτε ευρύτερες ζώνες για τις αναλύσεις ανά ομάδα. Κρατήστε έναν ισχυρό συνολικό αριθμό και δημοσιεύστε κάθε υποομάδα με το δικό της, μεγαλύτερο περιθώριο σφάλματος δίπλα της. Αυτή είναι συνήθως η σωστή απάντηση.
Ο υπολογιστής έχει πεδίο γι’ αυτό. Ορίστε το Υποομάδες με χωριστή αναφορά στον αριθμό των ομάδων για τις οποίες οφείλετε αποτέλεσμα, και θα υπολογίσει σωστά το μέγεθος κάθε ομάδας και θα τις αθροίσει.
Καθορίστε το εύρος πριν από τη συλλογή. Καταγράψτε τα τμήματα για τα οποία πρέπει να αναφέρετε, όχι αυτά που θα ήταν ωραίο να έχετε. Εκτιμήστε τις ολοκληρώσεις που μπορεί ρεαλιστικά να δώσει το καθένα, χρησιμοποιώντας δημογραφικές ερωτήσεις για να τα εντοπίσετε. Αν ένα τμήμα μπορεί να δώσει μόνο 80 υποβολές, μην υποσχεθείτε συν ή πλην 5 μονάδες γι’ αυτό. Με 80 υποβολές η ζώνη είναι συν ή πλην 11 μονάδες.
Η AAPOR χρησιμοποιεί ένα λυμένο παράδειγμα που αξίζει να απομνημονεύσετε. Μια έρευνα σε 1.000 ενήλικες έχει συνολικό περιθώριο σφάλματος περίπου συν ή πλην 3 μονάδες. Αν 200 από αυτά τα άτομα είναι η υποομάδα για την οποία θέλετε πραγματικά να μιλήσετε, το περιθώριο σφάλματος αυτής της υποομάδας είναι συν ή πλην 6,9 μονάδες, πάνω από το διπλάσιο. Ο κεντρικός αριθμός στο εξώφυλλο της αναφοράς δεν είναι ο αριθμός που διέπει το γράφημα στη σελίδα εννέα.
Οι δημοσιευμένες οδηγίες για τα ελάχιστα μεγέθη κελιών είναι παλαιότερες και χαλαρότερες από τους τύπους, και είναι θεμιτό να τις αντιμετωπίζετε ως κατώτατο όριο και όχι ως στόχο: περίπου 100 υποβολές για μια υποομάδα για την οποία θα αναφέρετε κανονικά αποτελέσματα, και 20 έως 50 για μια δευτερεύουσα που θα αναφέρετε παρεμπιπτόντως.
Πού κάνει λάθος ο σχεδιασμός του μεγέθους δείγματος
Το μέγεθος δείγματος διαχειρίζεται το δειγματοληπτικό σφάλμα, τον τυχαίο θόρυβο που προκύπτει επειδή δεν ρωτάτε όλους. Οι πραγματικές έρευνες φέρουν επίσης συστηματικό σφάλμα, που κανένα μέγεθος δείγματος δεν διορθώνει και που ένα μεγάλο δείγμα μπορεί να συγκαλύψει.
Αντιμετώπιση ενός δείγματος ευκολίας σαν πιθανοτικού δείγματος
Κάθε τύπος εδώ προϋποθέτει ότι κάθε άτομο είχε γνωστή, μη μηδενική πιθανότητα επιλογής και ότι η απάντηση δεν συνδεόταν έντονα με αυτό που μετράτε. Ένας ανοιχτός σύνδεσμος στα μέσα κοινωνικής δικτύωσης δεν πληροί καμία από τις δύο προϋποθέσεις. Μπορείτε και πάλι να υπολογίσετε ένα περιθώριο σφάλματος από τις υποβολές, θα φαίνεται καθησυχαστικό και δεν θα σημαίνει αυτό που λέει. Δηλώστε ξεκάθαρα τι είδους δείγμα αντλήσατε πραγματικά.
Ερμηνεία ενός μεγαλύτερου n ως καλύτερης μέτρησης
Ένα μεγάλο δείγμα κάνει μια θορυβώδη μέτρηση θορυβώδη με ακρίβεια. Αν μια ερώτηση είναι ασαφής, διπλή ή καθοδηγητική, περισσότερες υποβολές δεν θα τη σώσουν. Τα υψηλά ποσοστά παράλειψης και οι ασυνεπείς απαντήσεις είναι ενδείξεις ότι πρέπει πρώτα να διορθώσετε το ερωτηματολόγιο. Η αναδιατύπωση μίας κακής ερώτησης συχνά κάνει περισσότερα από τον τριπλασιασμό του δείγματος.
Επιλογή ακρίβειας χωρίς απόφαση πίσω της
Η ακρίβεια έχει σωστή απάντηση μόνο όταν ξέρετε για ποιο σκοπό χρειάζεται. Ένα μέγεθος δείγματος υποστηρίζεται εύκολα όταν μπορείτε να ολοκληρώσετε αυτή την πρόταση: πρέπει να ξεχωρίσουμε αποτελέσματα που διαφέρουν κατά X μονάδες. Είναι αδύνατο να υποστηριχθεί όταν η μόνη αιτιολόγηση είναι ότι ένας μεγαλύτερος αριθμός έμοιαζε ασφαλέστερος. Συνδέστε το με τον ερευνητικό σχεδιασμό σας και με αυτό που θα κάνετε με το αποτέλεσμα.
Οι αριθμοί αυτής της σελίδας και πόσο αξιόπιστοι είναι
Κάθε στοιχείο που παρατίθεται παραπάνω είναι είτε υπολογισμός που μπορείτε να αναπαραγάγετε στον υπολογιστή είτε παραπομπή που μπορείτε να ελέγξετε. Βαθμός A σημαίνει ότι έχει αναπαραχθεί ή υπολογίζεται άμεσα, B σημαίνει μία ισχυρή μελέτη, C σημαίνει ότι επαναλαμβάνεται ευρέως αλλά αμφισβητείται.
| Ισχυρισμός | Αριθμός | Βαθμός | Πηγή |
|---|---|---|---|
| Με επίπεδο εμπιστοσύνης 95% και χωρίς προηγούμενη εκτίμηση, ένας μεγάλος πληθυσμός χρειάζεται 385 ολοκληρωμένες υποβολές για συν ή πλην 5 μονάδες. | 385 | A | Άμεσος υπολογισμός από τον τυπικό τύπο αναλογίας. NIST ενότητα 3.3.3· Israel (1992). |
| Ο τύπος αυτής της σελίδας αναπαράγει τον δημοσιευμένο πίνακα μεγέθους δείγματος των Krejcie και Morgan με απόκλιση έως μία υποβολή σε καθένα από τα 21 μεγέθη πληθυσμού που ελέγξαμε. | 21 από 21 με απόκλιση έως 1 | A | Δικός μας έλεγχος σε σύγκριση με τους Krejcie και Morgan (1970). Η μέθοδος περιγράφεται κάτω από τον πίνακα. |
| Το ποσοστό απόκρισης είναι αδύναμος προγνωστικός δείκτης της μεροληψίας μη απόκρισης. Μια μετα-ανάλυση 59 ειδικών μελετών μεροληψίας βρήκε μόνο μικρή σχέση μεταξύ των δύο. | 59 μελέτες | A | Groves και Peytcheva (2008), Public Opinion Quarterly. |
| Το Pew έτρεξε το ίδιο ερωτηματολόγιο με ποσοστό απόκρισης 9% και 22%. Από 40 κοινές ερωτήσεις, οι 28 έδωσαν αποτελέσματα με απόκλιση έως 2 μονάδες. | 28 από 40 με απόκλιση έως 2 μονάδες | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Στις έρευνες ικανοποίησης όμως η σχέση είναι πραγματική και μεγάλη. Σε 717 έρευνες νοσοκομείων, η μέση βαθμολογία ικανοποίησης συσχετιζόταν με το ποσοστό απόκρισης με r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux και Combescure (2020), BMC Health Services Research. |
| Το ποσοστό απόκρισης στις έρευνες εργαζομένων ακολουθεί σχεδόν τέλεια το μέγεθος του οργανισμού. Το 2024 η έρευνα ομοσπονδιακών υπαλλήλων των ΗΠΑ πέτυχε 71% σε φορείς με λιγότερα από 1.000 άτομα και 37% σε φορείς με περισσότερα από 75.000. | 71% έναντι 37% | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, πάνω από 1,6 εκατομμύρια προσκεκλημένοι υπάλληλοι. |
| Το μέσο ποσοστό απόκρισης σε 1.071 δημοσιευμένες διαδικτυακές έρευνες ήταν 44,1%. Δεν υπάρχει ενιαίο φυσιολογικό ποσοστό. | 44,1% | A | Μετα-ανάλυση των Wu, Zhao και Fils-Aime (2022), Computers in Human Behavior Reports. |
| Οι διαδικτυακές έρευνες έχουν περίπου 12 ποσοστιαίες μονάδες χαμηλότερη απόκριση από τους άλλους τρόπους συλλογής, σε 114 πειραματικές συγκρίσεις. | 12 μονάδες χαμηλότερη | A | Μετα-ανάλυση των Daikeler, Bosnjak και Lozar Manfreda (2020), JSSAM. |
| Ο υποδιπλασιασμός του περιθωρίου σφάλματος πολλαπλασιάζει το απαιτούμενο δείγμα περίπου επί τέσσερα, επειδή το n είναι ανάλογο του 1 διά E στο τετράγωνο. Ο διπλασιασμός ενός δείγματος από 1.000 σε 2.000 κερδίζει περίπου μία μονάδα. | περίπου 4x | A | Αλγεβρική ιδιότητα του τύπου· η AAPOR αναφέρει ρητά την περίπτωση από 1.000 σε 2.000. |
| Η υπόθεση p = 0,5 αντί για ένα γνωστό p = 0,9 σχεδόν τριπλασιάζει το δείγμα που σας λένε να συλλέξετε, από 139 σε 385. | 139 έναντι 385 | A | Άμεσος υπολογισμός. Αναπαράγεται στον υπολογιστή αν αλλάξετε το αναμενόμενο αποτέλεσμα. |
| Και τα 87 πρότυπα ερωτηματολογίων που έχουν δημοσιευτεί σε αυτόν τον ιστότοπο έχουν 14 ερωτήσεις ή λιγότερες, και τα 86 από τα 87 έχουν 10 ή λιγότερες. 785 από τις 799 ερωτήσεις τους επιβεβαιώθηκαν στις δημοσιευμένες σελίδες. | 87 πρότυπα, 799 ερωτήσεις | A | Δική μας καταμέτρηση της ενεργής συλλογής προτύπων, 21 Αυγούστου 2026, με έλεγχο και στις 87 δημοσιευμένες σελίδες. Η μέθοδος, ο χειροκίνητος έλεγχος και το ποσοστό επαλήθευσης περιγράφονται μαζί με τον πίνακα. |
| Δεν υπάρχει ανιχνεύσιμο πρόσωπο με το όνομα Slovin πίσω από τον τύπο που φέρει αυτό το όνομα. Η παλαιότερη ανιχνεύσιμη πηγή είναι ο Yamane (1967). | κανένας ανιχνεύσιμος συγγραφέας | B | Tejada και Punzalan (2012), The Philippine Statistician· το Wolfram MathWorld τον χαρακτηρίζει ad hoc. |
«Χρειάζεστε πάντα 385 υποβολές.» Μόνο με επίπεδο εμπιστοσύνης 95%, συν ή πλην 5 μονάδες, p = 0,5 και μεγάλο πληθυσμό. Αν παρατεθεί σκέτο, είναι λάθος για κάθε μικρό πληθυσμό.
«Ερευνήστε το 10% του πληθυσμού σας.» Δεν έχει καμία στατιστική βάση. Δίνει υπερβολικά μεγάλα δείγματα στους μεγάλους πληθυσμούς και πολύ μικρά στους μικρούς.
«Ποσοστό απόκρισης κάτω από 50 ή 60% ακυρώνει μια έρευνα.» Κανένα όριο δεν το κάνει αυτό. Η κλίμακα 50, 60 και 70% είναι ένας εμπειρικός κανόνας εγχειριδίων χωρίς καμία εμπειρική τεκμηρίωση, και η μετα-ανάλυση των Groves και Peytcheva τον διαψεύδει. Το ποσοστό απόκρισης θέτει όριο στη χειρότερη δυνατή μεροληψία. Δεν μετρά την πραγματική μεροληψία.
«Το μέσο ποσοστό απόκρισης στις έρευνες είναι X%.» Επαληθευμένα στοιχεία από τα ίδια λίγα χρόνια κυμαίνονται από 6% έως 71%, ανάλογα αποκλειστικά με το ποιοι ερευνώνται. Κάθε ενιαίος μέσος όρος το αποκρύπτει. Παραθέστε αντί γι’ αυτό τη γραμμή του παραπάνω πίνακα που ταιριάζει στην περίπτωσή σας.
Ο τύπος του Slovin παρουσιασμένος ως παραγωγή. Είναι ο τύπος του Cochran με ενσωματωμένα το επίπεδο εμπιστοσύνης 95% και το p = 0,5 και με το z στρογγυλοποιημένο σε 2, και η απόδοση στον Slovin δεν έχει καμία ανιχνεύσιμη πηγή.
Το πρότυπο αιτιολόγησης
Τα περισσότερα επιχειρήματα για το μέγεθος δείγματος αποτυγχάνουν επειδή οι παραδοχές δεν καταγράφηκαν ποτέ. Το κουμπί Αντιγραφή αιτιολόγησης στον υπολογιστή το γράφει με τους δικούς σας αριθμούς ήδη συμπληρωμένους. Αν προτιμάτε να το συντάξετε μόνοι σας, αυτά είναι τα εννέα πράγματα που θα αναζητήσει ένας αξιολογητής.
- Πληθυσμός (N): ορίστε τον πληθυσμό και δηλώστε το πλήθος του. Για παράδειγμα, όλοι οι ενεργοί πελάτες των τελευταίων 90 ημερών, N = 48.200.
- Τι μετράτε: μια αναλογία (ένα ποσοστό) ή έναν μέσο όρο (μια μέση αξιολόγηση). Ο τύπος εδώ υπολογίζει για αναλογίες, κάτι που καλύπτει τους περισσότερους δείκτες που αναφέρονται.
- Επίπεδο εμπιστοσύνης: το επίπεδο που επιλέξατε και γιατί. Η σύμβαση και η ανοχή στον κίνδυνο είναι και τα δύο αποδεκτοί λόγοι, αν το δηλώσετε.
- Περιθώριο σφάλματος (E): η ακρίβεια-στόχος συνολικά και χωριστά για κάθε υποομάδα για την οποία υποσχεθήκατε αναφορά.
- Υποτιθέμενη αναλογία (p): η τιμή που χρησιμοποιήθηκε και από πού προήλθε. Δηλώστε απλά αν είναι 0,5 επειδή δεν υπήρχε κάτι καλύτερο.
- Διόρθωση πεπερασμένου πληθυσμού: αν την εφαρμόσατε και τι την ενεργοποίησε, για παράδειγμα το ότι το n0 ξεπερνά το 10% του N.
- Στόχος ολοκληρώσεων (n): ο τελικός απαιτούμενος αριθμός ολοκληρωμένων υποβολών μετά από κάθε προσαρμογή.
- Αναμενόμενο ποσοστό απόκρισης: το ποσοστό που υποτέθηκε, το ιστορικό από το οποίο προήλθε και ο αριθμός προσκλήσεων που προκύπτει.
- Πώς θα επιλέξετε τα άτομα: απλή τυχαία, στρωματοποιημένη, απογραφή ή ευκολίας, καθώς και κάθε υπερδειγματοληψία για βασικά τμήματα. Κατονομάστε τη με ειλικρίνεια.
Όταν η έρευνα βρίσκεται σε εξέλιξη, παρακολουθείτε τις ολοκληρώσεις ανά τμήμα και όχι το σύνολο. Ένας ικανοποιητικός συνολικός αριθμός μπορεί να κρύβει ένα τμήμα που δεν θα φτάσει ποτέ τον στόχο του, και αυτό είναι πρόβλημα που μπορείτε ακόμη να διορθώσετε την πρώτη εβδομάδα και όχι την τέταρτη. Όταν αναφέρετε αποτελέσματα, συνοδεύετε κάθε ποσοστό με το περιθώριο σφάλματός του και διαβάστε πώς να αναλύσετε δεδομένα ερευνών πριν θεωρήσετε πραγματική μια μεταβολή δύο μονάδων.
Φύλλο σχεδιασμού μεγέθους δείγματος
Μία σελίδα που μπορείτε να εκτυπώσετε, να συμπληρώσετε με το χέρι και να συρράψετε σε μια περιγραφή έργου. Συμπληρώστε τη μεσαία στήλη πριν ξεκινήσει η έρευνα πεδίου, όχι μετά. Τίποτα δεν αποστέλλεται πουθενά και δεν χρειάζεται λογαριασμός.
| Απόφαση | Η τιμή σας | Οδηγία |
|---|---|---|
| Πληθυσμός (N) | Ποιοι ακριβώς και πόσοι. Γράψτε τον ορισμό, όχι μόνο τον αριθμό. | |
| Τι μετράτε | Ένα ποσοστό ή έναν μέσο όρο. Αυτή η σελίδα υπολογίζει για ποσοστά. | |
| Επίπεδο εμπιστοσύνης | 95%, εκτός αν έχετε λόγο. Γράψτε τον λόγο. | |
| Περιθώριο σφάλματος (E) | Η διαφορά που πρέπει να μπορείτε να διακρίνετε, σε μονάδες. | |
| Υποτιθέμενη αναλογία (p) | 0,5 αν δεν υπάρχει κάτι καλύτερο. Αναφέρετε από πού προήλθε μια διαφορετική τιμή. | |
| Διόρθωση πεπερασμένου πληθυσμού | Αν εφαρμόστηκε ή όχι, και τι την ενεργοποίησε. | |
| Στόχος ολοκληρώσεων (n) | Ο τελικός αριθμός μετά από κάθε προσαρμογή. | |
| Υποομάδες με χωριστή αναφορά | Πόσες, και οι ολοκληρώσεις που χρειάζεται η καθεμία μόνη της. | |
| Αναμενόμενο ποσοστό απόκρισης | Το ποσοστό και το ιστορικό πίσω από αυτό. Όχι ένας αριθμός από το διαδίκτυο. | |
| Προσκλήσεις προς αποστολή | Οι ολοκληρώσεις διαιρεμένες με το ποσοστό, στρογγυλοποιημένες προς τα πάνω. Ποτέ περισσότερες από το N. | |
| Πώς επιλέγονται τα άτομα | Τυχαία, στρωματοποιημένη, απογραφή ή ευκολίας. Κατονομάστε τη με ειλικρίνεια. | |
| Σημείο ελέγχου κατά την έρευνα πεδίου | Η ημερομηνία κατά την οποία θα ελέγξετε τις ολοκληρώσεις ανά τμήμα, όχι μόνο το σύνολο. |
Τύπος: n0 = (z^2 x p x (1 - p)) / E^2, και στη συνέχεια n = n0 / (1 + (n0 - 1) / N). Πηγή: Cochran (1977)· NIST/SEMATECH e-Handbook ενότητα 3.3.3· Israel (1992). Φύλλο από τη διεύθυνση https://www.supersurvey.com/Sample-Size
Συχνές ερωτήσεις
Τι είναι το μέγεθος δείγματος;
Το μέγεθος δείγματος είναι ο αριθμός των ολοκληρωμένων υποβολών σε μια έρευνα και συμβολίζεται με n. Δεν είναι ο αριθμός των ατόμων που προσκαλέσατε ούτε το μέγεθος του πληθυσμού που περιγράφετε. Είναι ο αριθμός με τον οποίο τελειώνετε την έρευνα πεδίου, και είναι ο αριθμός από τον οποίο υπολογίζεται το περιθώριο σφάλματός σας: 385 ολοκληρωμένες υποβολές δίνουν περίπου συν ή πλην 5 μονάδες σε επίπεδο εμπιστοσύνης 95% όταν ο πληθυσμός είναι μεγάλος. Η ενότητα Τι σημαίνει μέγεθος δείγματος εξηγεί τη διαφορά ανάμεσα στον πληθυσμό, τις προσκλήσεις και το n.
Πόσες υποβολές χρειάζομαι για μια έρευνα;
Για τις περισσότερες έρευνες η πρακτική απάντηση είναι 385 ολοκληρωμένες υποβολές. Αυτό δίνει ο τύπος με επίπεδο εμπιστοσύνης 95%, περιθώριο σφάλματος συν ή πλην 5 ποσοστιαίες μονάδες και χωρίς προηγούμενη εκτίμηση του αποτελέσματος. Αν ο πληθυσμός σας είναι μικρός, χρειάζεστε λιγότερες: 278 για μια λίστα 1.000 ατόμων, 80 για μια λίστα 100. Βάλτε τους δικούς σας αριθμούς στον υπολογιστή για να δείτε τον ακριβή αριθμό και τους υπολογισμούς πίσω από αυτόν.
Τι μέγεθος δείγματος χρειάζομαι για επίπεδο εμπιστοσύνης 95% και περιθώριο σφάλματος 5%;
385 ολοκληρωμένες υποβολές, αν ο πληθυσμός είναι μεγάλος και χρησιμοποιείτε p = 0,5. Ο υπολογισμός είναι n0 = 1,96 στο τετράγωνο επί 0,5 επί 0,5, διά 0,05 στο τετράγωνο, δηλαδή 0,9604 διά 0,0025, δηλαδή 384,16. Στρογγυλοποιήστε προς τα πάνω και παίρνετε 385. Αν ο πληθυσμός σας είναι μικρός, εφαρμόστε τη διόρθωση πεπερασμένου πληθυσμού και ο αριθμός μειώνεται.
Τι είναι το περιθώριο σφάλματος;
Το περιθώριο σφάλματος είναι η ζώνη συν ή πλην γύρω από ένα αποτέλεσμα έρευνας, που προκύπτει επειδή έγινε δειγματοληψία σε ορισμένα άτομα αντί για όλους. Ένα αποτέλεσμα 62% με περιθώριο σφάλματος 5 μονάδων σημαίνει ότι η μέθοδος θα έδινε ένα διάστημα που περιέχει την πραγματική τιμή τις περισσότερες φορές, και αυτό το συγκεκριμένο διάστημα είναι από 57 έως 67%. Περιγράφει μόνο το τυχαίο δειγματοληπτικό σφάλμα. Δεν λέει τίποτα για όσους δεν απάντησαν ποτέ.
Πώς βρίσκετε το περιθώριο σφάλματος;
Πάρτε την τετραγωνική ρίζα του p επί (1 μείον p) διά n και πολλαπλασιάστε με την τιμή z του επιπέδου εμπιστοσύνης σας. Με επίπεδο εμπιστοσύνης 95%, 385 υποβολές και p = 0,5, αυτό είναι 1,96 επί την τετραγωνική ρίζα του 0,25 διά 385, δηλαδή 1,96 επί 0,025482, δηλαδή 0,0499. Άρα το περιθώριο σφάλματος είναι συν ή πλην 5,0 ποσοστιαίες μονάδες. Ο υπολογιστής περιθωρίου σφάλματος αυτής της σελίδας το κάνει για εσάς και δείχνει τους υπολογισμούς.
Αυξάνεται το περιθώριο σφάλματος με το μέγεθος δείγματος;
Όχι, μειώνεται, και μειώνεται με την τετραγωνική ρίζα του δείγματος. Το πέρασμα από 100 υποβολές σε 400 υποδιπλασιάζει το περιθώριο σφάλματος. Το πέρασμα από 400 σε 1.600 το υποδιπλασιάζει ξανά. Αυτή η σχέση τετραγωνικής ρίζας είναι ο λόγος που η ακρίβεια γίνεται ακριβή: κάθε επιπλέον δεκαδικό ψηφίο ακρίβειας κοστίζει περίπου τετραπλάσιες υποβολές.
Είναι το περιθώριο σφάλματος το ίδιο με το τυπικό σφάλμα;
Όχι. Το τυπικό σφάλμα είναι η υποκείμενη διασπορά της εκτίμησης. Το περιθώριο σφάλματος είναι το τυπικό σφάλμα πολλαπλασιασμένο με την τιμή z του επιπέδου εμπιστοσύνης που επιλέξατε. Σε επίπεδο εμπιστοσύνης 95%, το περιθώριο σφάλματος είναι περίπου 1,96 τυπικά σφάλματα. Το τυπικό σφάλμα είναι ιδιότητα των δεδομένων. Το περιθώριο σφάλματος είναι μια επιλογή αναφοράς που προστίθεται πάνω σε αυτό.
Ποιο είναι ένα καλό μέγεθος δείγματος για ποσοτική έρευνα;
Δεν υπάρχει ένας μοναδικός καλός αριθμός, και κάθε πηγή που σας δίνει έναν χωρίς να ρωτήσει τι μετράτε μαντεύει. Για μια μελέτη που αναφέρει ποσοστά από έναν πληθυσμό κάτω από περίπου 10.000, η υποστηρίξιμη απάντηση είναι ό,τι δίνει ο τύπος με επίπεδο εμπιστοσύνης 95% και ένα περιθώριο σφάλματος που μπορείτε να αιτιολογήσετε. Για μια λίστα 1.000 ατόμων αυτό είναι 278. Ο αριθμός που κάνει ένα κεφάλαιο μεθοδολογίας να εγκριθεί δεν είναι ένας μεγάλος αριθμός· είναι ένας δηλωμένος αριθμός, με το επίπεδο εμπιστοσύνης, το περιθώριο σφάλματος, την υποτιθέμενη αναλογία και τον πληθυσμό γραμμένα δίπλα του. Δείτε το μέγεθος δείγματος για ποσοτική έρευνα για τους κατονομαζόμενους τύπους που μπορεί να περιμένει ο επιβλέπων σας.
Ποιο είναι ένα φυσιολογικό ποσοστό απόκρισης σε έρευνες;
Δεν υπάρχει ενιαίο φυσιολογικό ποσοστό, και κάθε σελίδα που παραθέτει έναν αριθμό μαντεύει. Πραγματικά στοιχεία με πηγές από την ίδια περίοδο κυμαίνονται από 6% (τηλεφωνικές δημοσκοπήσεις του Pew το 2018) έως 71% (μικροί ομοσπονδιακοί φορείς των ΗΠΑ στην έρευνα Federal Employee Viewpoint Survey του 2024). Μια μετα-ανάλυση 1.071 δημοσιευμένων διαδικτυακών ερευνών βρήκε μέσο όρο 44,1%. Το μέγεθος του οργανισμού μετράει πάρα πολύ: η ίδια ομοσπονδιακή έρευνα πέτυχε 71% σε φορείς με λιγότερα από 1.000 άτομα και 37% σε φορείς με περισσότερα από 75.000. Χρησιμοποιήστε πρώτα το δικό σας ιστορικό και δείτε τον πίνακα σημείων αναφοράς για στοιχεία που μπορείτε να παραθέσετε.
Παίζει ρόλο το μέγεθος του πληθυσμού στο μέγεθος δείγματος;
Ελάχιστα, μέχρι το δείγμα σας να γίνει μεγάλο μερίδιο του πληθυσμού. Το πέρασμα από 100.000 άτομα σε 1.000.000 αλλάζει την απαίτηση από 383 σε 385. Το πέρασμα από 1.000 άτομα σε 100 την αλλάζει από 278 σε 80. Το μέγεθος του πληθυσμού μετράει στο μικρό άκρο, ακριβώς εκεί όπου εφαρμόζεται η διόρθωση πεπερασμένου πληθυσμού.
Πότε είναι το p = 0,5 η σωστή επιλογή;
Χρησιμοποιήστε p = 0,5 όποτε δεν έχετε μια υποστηρίξιμη προηγούμενη εκτίμηση. Ο όρος p επί (1 μείον p) είναι μέγιστος στο 0,5, οπότε δίνει το μεγαλύτερο απαιτούμενο δείγμα. Αυτό τον κάνει ασφαλή παραδοχή: δεν μπορεί να βρεθείτε με έλλειμμα. Αν έχετε πιλοτική έρευνα, σημείο αναφοράς ή τον αριθμό της περσινής χρονιάς, χρησιμοποιήστε τον. Η υπόθεση p = 0,9 αντί για 0,5 μειώνει το απαιτούμενο δείγμα από 385 σε 139.
Αν προσκαλέσω περισσότερα άτομα, εξαλείφω τη μεροληψία μη απόκρισης;
Όχι. Περισσότερες προσκλήσεις σας δίνουν περισσότερες ολοκληρώσεις, κάτι που μειώνει το περιθώριο σφάλματος. Η μεροληψία είναι ξεχωριστό πρόβλημα: εξαρτάται από το αν όσοι απάντησαν διαφέρουν από όσους δεν απάντησαν. Μια μετα-ανάλυση 59 μελετών μεροληψίας μη απόκρισης βρήκε μόνο μικρή σχέση ανάμεσα στο ποσοστό απόκρισης και στην πραγματική μεροληψία. Το Pew έτρεξε το ίδιο ερωτηματολόγιο δύο φορές, με ποσοστό απόκρισης 9% και 22%, και 28 από τις 40 κοινές ερωτήσεις έδωσαν αποτελέσματα με απόκλιση έως 2 μονάδες μεταξύ τους. Δείτε τη μεροληψία απόκρισης και τη μεροληψία μη απόκρισης.
Πώς χειρίζομαι το μέγεθος δείγματος αν χρειάζομαι αποτελέσματα ανά τμήμα ή περιοχή;
Υπολογίστε κάθε υποομάδα χωριστά. Το περιθώριο σφάλματός σας ισχύει για μια ομάδα μόνο αν αυτή η ομάδα έχει τόσες ολοκληρώσεις. Αν θέλετε συν ή πλην 5 μονάδες για κάθε περιοχή, κάθε περιοχή χρειάζεται τις δικές της 385 ολοκληρώσεις ή τον δικό της αριθμό μετά τη διόρθωση πεπερασμένου πληθυσμού. Χρησιμοποιήστε δημογραφικές ερωτήσεις για να εντοπίσετε τις ομάδες και προγραμματίστε υπερδειγματοληψία στις μικρές.
Τι μέγεθος δείγματος χρειάζομαι για ένα στατιστικά σημαντικό αποτέλεσμα;
Αυτή η ερώτηση αναμειγνύει δύο ιδέες. Οι τύποι μεγέθους δείγματος υπολογίζουν μια εκτίμηση με μια επιλεγμένη ακρίβεια. Ο έλεγχος σημαντικότητας συγκρίνει δύο αριθμούς και ρωτά αν η διαφορά θα μπορούσε εύλογα να οφείλεται στην τύχη. Το μέγεθος που χρειάζεστε εξαρτάται από το πόσο μικρή διαφορά θέλετε να μπορείτε να εντοπίσετε, όχι από ένα σταθερό όριο. Υπολογίστε το μέγεθος της έρευνας εδώ και μετά διαβάστε για τη στατιστική σημαντικότητα πριν ελέγξετε ένα αποτέλεσμα έναντι ενός άλλου.
Ισχύουν αυτοί οι τύποι για ποιοτική έρευνα;
Όχι. Οι συνεντεύξεις, οι ομάδες εστίασης και η εργασία με ερωτήσεις ανοιχτού τύπου δεν υπολογίζονται με περιθώριο σφάλματος, επειδή δεν εκτιμούν ένα ποσοστό πληθυσμού. Το μέγεθος δείγματος στην ποιοτική έρευνα τεκμηριώνεται με τον κορεσμό, το σημείο όπου οι νέοι συμμετέχοντες παύουν να παράγουν νέα θέματα, και αναφέρεται ως κρίση με στοιχεία και όχι ως τύπος. Μην περνάτε μια ποιοτική μελέτη από αυτόν τον υπολογιστή.
Βιβλιογραφία
- National Institute of Standards and Technology (NIST). (n.d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, section 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.