
Pontos principais
- Comece por uma decisão, não por um tema. Anote o que você fará de diferente dependendo das respostas. Qualquer item que não possa mudar uma decisão é candidato a ser excluído.
- Uma ideia, um item, um período de referência. Se uma pergunta esconde duas perguntas, não há como saber qual das metades determinou a resposta.
- A redação mexe nos números. Um experimento com amostra dividida alterou em 45 pontos percentuais o apoio aos mesmos programas do governo apenas mudando o nome deles; por isso, a redação neutra é uma escolha de medição, e não uma gentileza.
- Elabore as opções de resposta com o mesmo cuidado que a pergunta. Faixas sobrepostas, categorias ausentes e um ponto central sem rótulo causam mais estrago do que um enunciado deselegante.
- Faça o pré-teste com pessoas e depois o teste piloto com dados. Uma leitura em voz alta com alguns respondentes revela as interpretações erradas que você não consegue enxergar do lugar de quem escreveu.
O que é a elaboração de questionário e o que ela não resolve
Elaboração de questionário é o processo de transformar um objetivo de pesquisa em perguntas que as pessoas conseguem entender e responder com precisão. Inclui a redação, as opções de resposta, a ordem, a introdução e os testes. As sete etapas abaixo mostram como essas escolhas funcionam juntas em um questionário completo.
Um item está bem elaborado quando duas pessoas com a mesma experiência o leem da mesma forma, conseguem recuperar a resposta da memória e escolhem a mesma opção para descrevê-la. Tudo o que vem a seguir é uma forma de chegar mais perto disso.
Há duas coisas que ela não resolve. Não resolve o público errado: faça perguntas perfeitas às pessoas erradas e você terá respostas precisas para uma pergunta que ninguém fez. Esse é um problema de amostragem, não de redação. Também não resolve um número pequeno demais de respostas, que é um problema de tamanho da amostra.
Também vale separar duas palavras usadas como se fossem sinônimos. O questionário é o instrumento: a lista de itens e opções de resposta. A pesquisa é todo o estudo em torno dele: a quem você pergunta, como chega até essas pessoas e o que faz com os dados. Se você precisa do processo mais amplo, ele está no nosso guia sobre desenho de pesquisa. Esta página trata apenas do instrumento.
As 7 etapas da elaboração de questionário
Quem pesquisa pede sete etapas mais do que qualquer outro número, e as listas que aparecem são, na maioria, cópias de um único post de blog de uma agência, de 2006, cuja página original já não existe. Por isso, a sequência abaixo não é aquela lista. É o processo de desenvolvimento que a literatura de metodologia de pesquisa de fato descreve16, 17, 20, dividido nos sete pontos em que o trabalho realmente muda de natureza, com as duas coisas que essas cópias deixam de fora: o que cada etapa produz e onde cada uma costuma falhar.
| Etapa | O que você decide | O que você produz | Onde costuma falhar |
|---|---|---|---|
| 1. Decisões primeiro | O que os resultados precisam decidir | Uma lista curta de decisões e das comparações por trás delas | Partir de um tema, de modo que nada indica quando parar de acrescentar itens |
| 2. Itens e formatos | Um item por decisão, com seu formato de resposta | Uma lista preliminar de itens com um formato ao lado de cada um | Escolher o formato por hábito, e não pela análise de que você precisa |
| 3. Redação respondível | Como cada enunciado é redigido | Enunciados com termos definidos e um período de referência explícito | Pedir uma lembrança que ninguém tem, ou esconder duas perguntas em uma |
| 4. Opções e escalas | O conjunto de respostas de cada item fechado | Opções que não se sobrepõem e não deixam ninguém sem alternativa | Faixas sobrepostas, nenhuma opção de saída, um ponto central sem rótulo |
| 5. Redação neutra | Quais palavras estão empurrando uma resposta | Enunciados neutros e conjuntos de opções equilibrados | Adjetivos no enunciado e listas de respostas que pendem para um lado |
| 6. Ordem e introdução | Sequência, agrupamento e o texto de abertura | Um instrumento ordenado, com uma introdução curta | Itens sensíveis cedo demais e uma introdução que ninguém lê |
| 7. Pré-teste e teste piloto | Se ele funciona com pessoas reais | Um instrumento revisado e uma estimativa de tempo | Pular essa etapa ou achar que uma rodada basta |
As etapas 3, 4 e 5 aparecem separadas aqui porque falham de maneiras diferentes e se corrigem com medidas diferentes. Na prática, você vai percorrê-las mais de uma vez. A linha tracejada no diagrama é o laço que mais importa: o que o pré-teste encontra costuma levar você de volta à etapa 3.
Etapa 1. Anote as decisões antes de escrever uma única pergunta
A maioria dos questionários inchados parte de um tema. Os bons partem de uma decisão. Antes de redigir um item, escreva a lista curta do que você fará de diferente dependendo do que voltar.
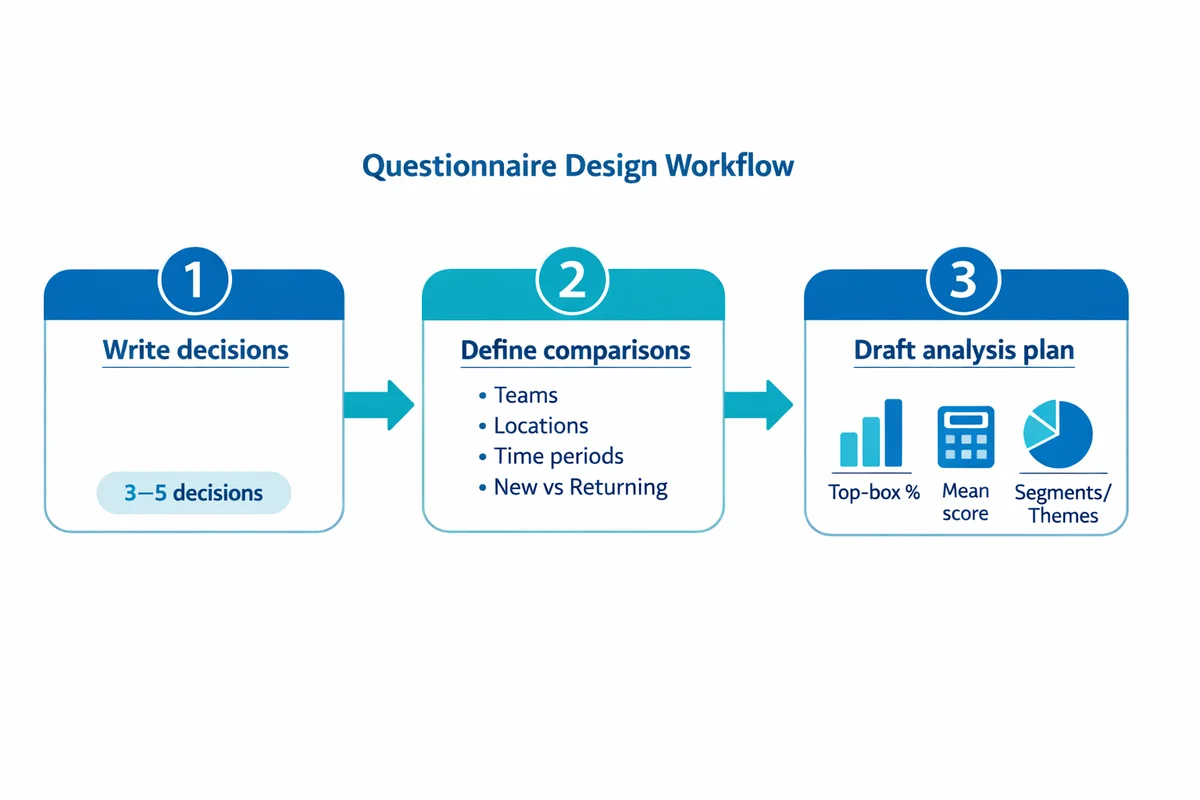
Liste de três a cinco decisões
Escreva-as como escolhas, não como temas. “Repetir o formato de dois dias ou passar para sessões on-line curtas” é uma decisão. “Feedback do treinamento” é um tema.
Defina as comparações que você precisa fazer
Equipes, unidades, turnos, períodos, primeira vez versus recorrentes. As comparações determinam tanto a redação quanto as opções de resposta, então defina-as agora, e não depois.
Esboce os resultados em uma página
Rascunhe as tabelas e os gráficos que você realmente espera fazer. Se você não consegue desenhar o resultado que um item alimenta, esse item não tem função.
Esta é a etapa que os guias de metodologia colocam em primeiro lugar, e pelo mesmo motivo: é a única coisa que indica quando parar de acrescentar perguntas.16, 17
Leia cada item preliminar e complete esta frase: “Se todos responderem B em vez de A, nós vamos...” Se você não conseguir completá-la, corte o item ou reescreva-o até conseguir.
Etapa 2. Transforme cada decisão em um item e escolha o formato de propósito
O formato da pergunta é uma decisão de medição, não uma preferência de layout. Escolha o formato que o leitor consegue responder e que o resultado planejado consegue usar.
| Se o resultado for | Use | Exemplo de enunciado |
|---|---|---|
| Um número que você vai acompanhar ao longo do tempo | Um item fechado de avaliação, com todos os pontos rotulados | “Quão fácil ou difícil foi concluir a configuração sem ajuda?” |
| Uma lista ordenada do que corrigir | Escolha única e, depois, uma pergunta de acompanhamento | “Qual seria a mudança que mais ajudaria você?” e depois “Por que essa?” |
| Uma contagem ou uma taxa | Faixas fechadas que não se sobrepõem | “Nos últimos 30 dias, quantas vezes você entrou em contato com o suporte?” |
| Termos que você ainda não ouviu | Uma caixa de texto aberta e bem direcionada | “Qual foi o principal motivo do seu contato hoje?” |
| Elegibilidade para os itens seguintes | Uma pergunta de triagem com lógica de salto | “Você usou a aba de relatórios nos últimos 30 dias?” |
Itens fechados são mais baratos de analisar e mais fáceis de comparar entre ondas. Itens abertos encontram o que a sua lista de opções esqueceu. O motivo prático de os itens fechados predominarem é o custo: respostas abertas precisam de um esquema de codificação e de mais de um codificador antes de significarem algo.1 Use um ou dois itens abertos, posicionados onde realmente valem a pena, e mantenha o restante fechado. Nossos guias sobre perguntas de múltipla escolha e perguntas abertas e perguntas fechadas aprofundam cada formato.
Um alerta sobre escalas de concordância. Se você pode perguntar algo diretamente, pergunte diretamente. Em um experimento com quatro amostras, itens com opções de resposta específicas do construto atingiram coeficientes de confiabilidade de 0,87 a 0,93, enquanto o mesmo conteúdo, perguntado como afirmações de concordo ou discordo, atingiu apenas 0,36 a 0,73.4 É uma diferença grande para um formato que a maioria das pessoas escolhe por hábito. Dois efeitos de resposta conhecidos explicam boa parte dela. A aquiescência é a tendência de concordar com o que quer que a afirmação diga, de modo que o formato acrescenta uma inclinação que você não consegue separar depois. O satisficing é o leitor fazer apenas o esforço suficiente para dar uma resposta que passe, e não uma que seja precisa, e uma coluna de afirmações de concordo ou discordo torna isso muito fácil. Os dois pioram à medida que o questionário fica mais longo. Se você precisar mesmo desse formato, siga nossas orientações sobre escala Likert.
Etapa 3. Escreva um enunciado que as pessoas consigam realmente responder
Muitos itens ruins não são vagos. São impossíveis de responder. Pedem uma lembrança que ninguém tem ou um conhecimento que o respondente nunca recebeu.
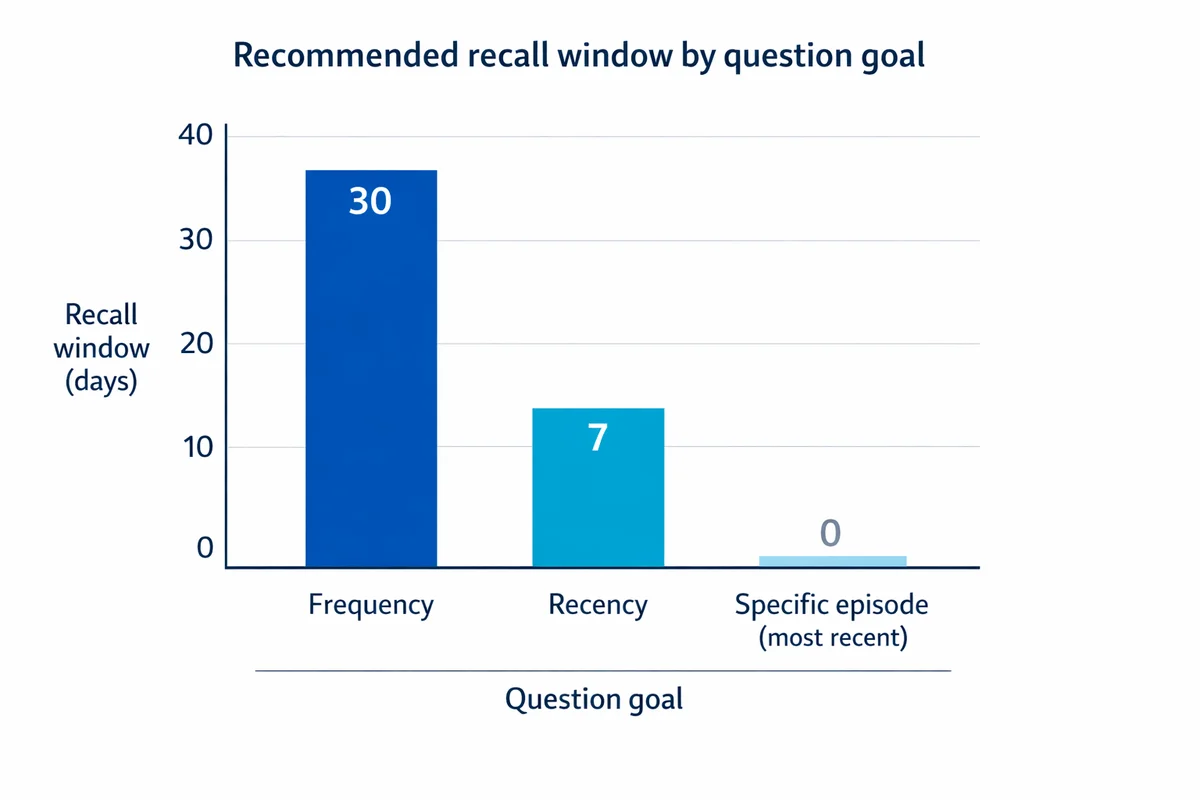
Dê um período de referência a toda pergunta sobre comportamento
“Com que frequência você entra em contato com o suporte?” não tem âncora, então duas pessoas com comportamento idêntico vão responder de forma diferente. Especifique o período e ajuste-o à frequência com que o comportamento acontece.
| Você quer | Difícil de responder | Respondível |
|---|---|---|
| Uma frequência | “Com que frequência você entra em contato com o suporte?” | “Nos últimos 30 dias, quantas vezes você entrou em contato com o suporte?” |
| Um comportamento recente | “Você faz exercícios regularmente?” | “Nos últimos 7 dias, em quantos dias você fez pelo menos 30 minutos de exercício?” |
| Um episódio | “O onboarding foi tranquilo?” | “Pensando na sua configuração mais recente, quão fácil ou difícil foi concluí-la sem ajuda?” |
Use as palavras que seus leitores usam
- Escolha a palavra comum. “Ajuda” é melhor que “assistência”. “Comprar” é melhor que “adquirir”. Palavras mais simples também são mais fáceis de traduzir.
- Defina qualquer termo que você não possa evitar. Se o item depende de “incidente” ou “caso”, diga no próprio enunciado o que conta como tal.
- Escreva a sigla por extenso uma vez. Depois, reutilize-a. Não presuma que todos conhecem as abreviações internas.
- Pergunte o que aconteceu, não por quê. As pessoas conseguem relatar acontecimentos. Em geral, não conseguem relatar as causas dentro da sua organização.
Uma ideia por item
Um item que esconde duas perguntas produz uma resposta que você não consegue interpretar. Quem adorou o preço e detestou a qualidade não tem uma opção honesta e, seja qual for a escolha, você não saberá qual das metades a determinou.
Qual é o seu grau de satisfação com o preço e a qualidade?
Em vez disso, dois itens. “Qual é o seu grau de satisfação com a qualidade?” e “Qual é o seu grau de satisfação com o preço?”
Vale ser honesto sobre as evidências aqui. Separar perguntas duplas é quase uma regra universal, mas a literatura experimental direta por trás dela é escassa e recente. O teste mais claro concluiu que um item duplo e sua versão reescrita com uma única ideia não mediam a mesma coisa, e que a versão com uma única ideia era mais válida.15 Trate a regra como sólida e bem fundamentada, não como uma conclusão consolidada há quarenta anos, como os efeitos de redação da etapa 5.
Etapa 4. Monte opções de resposta e escalas que você consiga analisar
Muitos questionários falham na lista de respostas, e não no enunciado. Dois testes pegam a maior parte dos problemas. As opções não podem se sobrepor e precisam deixar todos com uma escolha honesta.
Qual é a sua idade? 18 a 30, 30 a 40, 40 a 55, 55 ou mais
Qual é a sua idade? 18 a 29, 30 a 39, 40 a 54, 55 ou mais, Prefiro não dizer
Escalas de avaliação
| Escolha | O que fazer | Por quê |
|---|---|---|
| Número de pontos | De cinco a sete para atitudes | A confiabilidade e a validade sobem bastante até cerca de sete pontos, depois se estabilizam, e a confiabilidade teste-reteste volta a cair acima de dez.5, 1 |
| Rótulos | Rotule todos os pontos sempre que possível | Números sozinhos variam de sentido. Duas pessoas leem “6 de 10” de forma diferente; as duas leem “Razoavelmente fácil” da mesma forma. |
| Direção | Mantenha a mesma direção do início ao fim | Inverter a direção no meio do questionário gera cliques errados que parecem mudanças reais de opinião. |
| Ponto central | Inclua um quando a neutralidade for uma posição real | Removê-lo não revela uma inclinação oculta. As pessoas escolhem ao acaso perto de onde ele estaria.1 |
| Não se aplica | Mantenha essa opção separada do ponto central | Caso contrário, quem não consegue avaliar é contado como neutro, o que desloca sua média sem ninguém perceber. |
O ponto central e o “não sei” não são chaves independentes, que é como a maioria das recomendações os trata. Oferecer uma opção “não sei” junto com um ponto central reduziu a parcela que escolhia o ponto central em cerca de 7 a 17 pontos percentuais, dependendo do item.6 Em outras palavras, boa parte do seu grupo neutro é formada por pessoas que não têm opinião, e não por pessoas no meio-termo. Decida sobre as duas opções em conjunto. Nosso guia sobre perguntas com escala de avaliação trata dos detalhes de layout.
Em um item de atitude, 15% escolheram a opção “não sei” quando ela foi oferecida. Em itens relacionados da mesma entrevista sem essa opção, apenas 3% e 4% não deram uma resposta substantiva, e essas respostas ainda previram como as pessoas votaram depois.7 Uma saída fácil é usada, e parte do que ela recolhe era uma opinião real.
Etapa 5. Mantenha a redação neutra e verifique se há viés
Esta é a etapa com mais evidências e com os maiores efeitos medidos. Experimentos com amostra dividida já deslocaram resultados em dezenas de pontos percentuais sobre a mesma opinião de fundo, apenas trocando palavras.
Na General Social Survey de 1985, 65,2% dos americanos disseram que se gastava pouco demais com “assistance to the poor” (assistência aos pobres). Perguntados sobre os mesmos programas com o rótulo “welfare” (assistência social), apenas 19,8% disseram que se gastava pouco demais. É uma diferença de 45 pontos causada por uma palavra, e ela se repetiu no ano seguinte, com 62,8 contra 23,1.2, 3
O enquadramento faz o mesmo. O apoio a uma ação militar no Iraque era de 68% e caiu para 43% quando a mesma pergunta acrescentou “mesmo que isso significasse que as forças dos EUA poderiam sofrer milhares de baixas”.8
São experimentos com amostra dividida: duas metades aleatórias da mesma pesquisa, cada uma com uma redação. É esse desenho que transforma “a redação importa” de uma opinião em uma medição.
O que eliminar
| Padrão | Direcionada | Neutra |
|---|---|---|
| Adjetivo no enunciado | “Quão útil foi nossa excelente equipe de suporte?” | “Quão útil ou pouco útil foi nossa equipe de suporte?” |
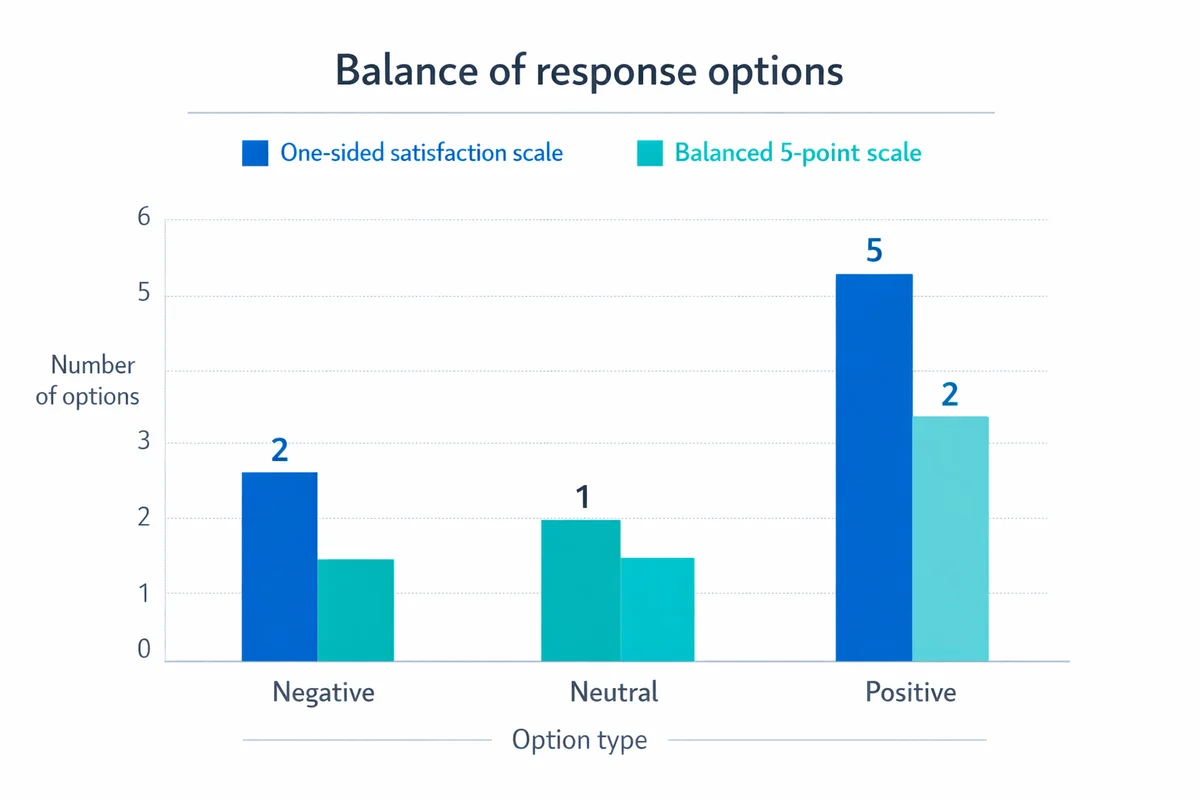
| Só uma direção oferecida | “Quão frustrante foi fazer o cadastro?” | “Quão fácil ou difícil foi fazer o cadastro?” |
| Lista de respostas que pende para um lado | “Qual é o seu grau de satisfação?” só com opções positivas | Quantidades iguais de opções negativas e positivas |
| Comportamento presumido | “Como você usa a aba de relatórios?” | “Você usou a aba de relatórios nos últimos 30 dias?” |
O viés também vem do respondente, e não só da redação. Três hábitos causam a maior parte do estrago. A desejabilidade social é responder do jeito que parece melhor. A aquiescência é concordar com o que quer que a afirmação diga. O satisficing é fazer apenas o esforço suficiente para dar uma resposta que passe, e não uma que seja precisa. Nosso guia sobre viés de resposta trata dos três.
Etapa 6. Ordene os itens e depois escreva uma introdução curta
A ordem não é cosmética. Uma pergunta anterior pode mudar a resposta a uma posterior, e o efeito é mensurável. O apoio a acordos legais para casais do mesmo sexo foi de 45% quando o item vinha depois de uma pergunta sobre casamento, e de 37% quando aparecia sozinho.9 Nada no item mudou, exceto o que veio antes dele.
Uma sequência que funciona
Triagem
Confirme que a pessoa é elegível antes de perguntar qualquer outra coisa. Encaminhe as demais direto para a saída.
Aquecimento
Itens fáceis e factuais que mostram que o questionário trata de algo que a pessoa reconhece.
Blocos principais
Agrupe por tema. Mantenha a mesma escala dentro de um bloco, para que ninguém precise reaprendê-la.
Diagnóstico
Os motivos e obstáculos que explicam as avaliações acima deles.
Itens sensíveis e segmentos
Por último, e só os que você realmente vai usar. Veja perguntas demográficas para os padrões de redação.
Encerramento
Uma caixa aberta de “algo mais”, depois um agradecimento e o que acontece em seguida.
Uma introdução que você pode copiar
Limite-a a cinco linhas. As pessoas vieram para responder, não para ler.
Objetivo: estamos coletando feedback para melhorar [processo ou serviço].
Tempo: cerca de [X] minutos.
Privacidade: suas respostas são [anônimas ou confidenciais], e [quem] verá os resultados.
Participação voluntária: você pode pular qualquer pergunta.
Contato: dúvidas? [nome e e-mail].
Cuidado com a estimativa de tempo, porque ela muda quem participa. Quando o mesmo questionário foi anunciado com 10, 20 ou 30 minutos de duração, a parcela de pessoas que começaram caiu de 75% para 64,9% e para 62,4%, e, entre os que começaram, a parcela que terminou caiu de 68,2% para 56,8% e para 46,8%.10 Informar a duração é o certo a fazer. Só garanta que o número seja um que o seu pré-teste produziu.
Diga com clareza quem vê as respostas brutas e por quanto tempo você as guarda, e confira se isso corresponde aos seus compromissos de privacidade reais. O consentimento e a clareza sobre o objetivo fazem parte do desenvolvimento do questionário, e não são burocracia acrescentada depois.17
Etapa 7. Faça o pré-teste com pessoas, o teste piloto com dados e então lance
É aqui que os questionários realmente melhoram. Um pré-teste mostra o que as pessoas acham que o item quer dizer. Um teste piloto mostra como ficam os dados quando elas o respondem. São tarefas diferentes, e você precisa das duas.16, 19 Monte o teste piloto no nosso criador de pesquisas grátis e teste a ordem das perguntas, as opções de resposta e as ramificações em um celular antes de compartilhá-lo com a sua amostra completa.
Leia em voz alta
Peça a alguém que leia cada item em voz alta. Tudo em que a pessoa tropeçar, reler ou reformular é candidato a ser reescrito.
Investigue o significado
Pergunte “o que esta pergunta significa para você?” e “como você chegou a essa resposta?”. Você está testando a compreensão, não a opinião.
Cronometre
Registre quanto tempo leva de verdade. Esse número vai na sua introdução, e costuma ser maior do que você imaginava.
Reescreva e repita
Uma rodada raramente basta para um instrumento novo. Corrija e depois teste as correções com outra pessoa.
Quantas entrevistas de pré-teste
Mais do que você imagina. Uma modelagem do pré-teste por entrevista cognitiva concluiu que problemas reais nas perguntas continuavam aparecendo à medida que o número de entrevistas crescia, sem um patamar claro em que se possa parar com segurança.14 Trate qualquer número fixo como um orçamento, não como cobertura, e use-o com pessoas parecidas com os seus respondentes reais.
Para que serve o teste piloto
- Cobertura das opções. Se “Outro” ou “Prefiro não dizer” forem muito escolhidos, falta algo na sua lista.
- Uso da escala. Respostas acumuladas em uma ponta costumam indicar que a redação as empurrou para lá.
- Straightlining. Respostas idênticas em um bloco inteiro. Em dados de painel, vai de 15% a 40% nos blocos em que é um padrão plausível, e fica abaixo de 2% onde não é.13
- Lógica. Confirme que as pessoas só veem as perguntas de acompanhamento que se aplicam a elas.
- Ponto de abandono. Anote o item em que as pessoas desistem. Em geral, o problema é esse item, não a extensão.
São dois números diferentes que respondem a duas perguntas diferentes, e tratar um como o outro é um erro comum e caro. Trinta pessoas bastam para expor uma lista de opções com defeito, um enunciado que ninguém lê da mesma forma ou um ramo de lógica que nunca é acionado. É só para isso que serve um teste piloto. Está longe de bastar para estimar uma porcentagem ou para distinguir dois grupos com alguma confiança. Corrija o instrumento com o teste piloto e depois dimensione o estudo real à parte, com nosso guia sobre tamanho da amostra.
Ao lançar, conte com uma taxa de resposta modesta: em painéis on-line não probabilísticos, taxas de 10% ou menos já são comuns.21
Um exemplo prático: um questionário montado ao longo das sete etapas
Todo guia sobre o assunto mostra perguntas isoladas sendo corrigidas. Quase nenhum mostra um questionário sendo montado. Então aqui está um completo, da decisão no topo ao instrumento no final, seguindo as etapas acima em ordem.
Uma equipe de operações de cerca de 40 pessoas fez um treinamento de segurança de dois dias em maio. A gerência precisa escolher o formato da próxima rodada, e ninguém tem dados. Esse é o briefing inteiro. Agora, siga as etapas.
| Etapa | O que ela produziu aqui |
|---|---|
| 1. Decisões primeiro | Três decisões: manter o formato de dois dias ou passar para sessões on-line curtas; qual módulo reescrever primeiro; se o material está sendo usado no trabalho. Tudo abaixo remete a uma delas. |
| 2. Itens e formatos | Nove itens. Duas contagens fechadas, duas avaliações rotuladas, três listas de escolha única, uma caixa aberta direcionada e uma caixa aberta de encerramento. Uma pergunta de triagem no início. |
| 3. Redação respondível | Todo item sobre comportamento ganhou um período explícito (“nos 30 dias desde o treinamento”). “O checklist” é definido no enunciado, em vez de presumido. |
| 4. Opções e escalas | As contagens usam faixas que não se sobrepõem. As duas avaliações usam os mesmos cinco pontos na mesma direção. “Ainda não usei” fica separado do ponto central. |
| 5. Remover o viés | “Quão útil foi o excelente novo checklist” virou “Quão útil ou pouco útil”. O item sobre o formato oferece as duas opções, mais “qualquer um dos dois” e “nenhum dos dois”, para não empurrar uma resposta preferida. |
| 6. Ordem e introdução | Triagem, depois comportamento, depois avaliações, depois a decisão sobre o formato, depois o obstáculo, depois o turno, depois o encerramento aberto. O turno fica perto do fim porque é o único item que as pessoas podem não querer responder. |
| 7. Pré-teste e teste piloto | Leitura em voz alta com quatro pessoas. Duas entenderam “o checklist” como outro documento, então a P2 ganhou as palavras “o checklist de uma página do Módulo 2”. Essa única correção é todo o argumento a favor da etapa 7. |
O questionário pronto
Nove itens e uma pergunta de triagem. Copie e depois troque os substantivos. Não copie a estimativa de tempo: obtenha-a da sua própria leitura em voz alta.
Questionário pós-treinamento: 10 itens
- P0. Você participou do treinamento de segurança nos dias 12 e 13 de maio? Escolha única, triagemUma pergunta de triagem, não de aquecimento. Quem responder “Não” deve ser encaminhado direto para o fim. Sem ela, não há como distinguir quem não participou de quem participou e ficou insatisfeito.
- P1. Nos 30 dias desde o treinamento, quantas vezes você usou o checklist de uma página do Módulo 2 em um trabalho real? Escolha única, contagensUm período explícito e um documento identificado pelo nome. As faixas não se sobrepõem, então quem o usou três vezes tem exatamente um lugar para marcar. Este item responde sozinho à decisão três.
- P2. Quão fácil ou difícil foi usar o checklist em um trabalho real? Avaliação de cinco pontos, todos rotulados1Muito difícil2345Muito fácilAs duas direções estão no enunciado, então nada está sendo sugerido. “Ainda não usei” fica fora da escala, e não dentro dela, para que quem não consegue avaliar não seja contado como neutro.
- P3. Qual parte do treinamento foi mais difícil de acompanhar? Escolha única, com uma opção de saídaEsta responde à decisão dois. “Nada foi difícil de acompanhar” importa tanto quanto os módulos: sem essa opção, todos são obrigados a apontar um problema que talvez não exista.
- P4. O que tornou essa parte difícil de acompanhar? Texto aberto, exibido só se um módulo foi escolhido na P3Resposta curtaO único item aberto que justifica seu lugar. É direcionado a uma resposta específica, é pulado pela maioria das pessoas e é a única coisa que vai dizer como reescrever o módulo.
- P5. Se o mesmo treinamento fosse oferecido de novo, qual formato permitiria que você participasse dele inteiro? Escolha única, equilibradaO item da decisão. Pergunta sobre a participação, que as pessoas conseguem responder, e não sobre preferência, que convida a um palpite. “Qualquer um” e “nenhum” são respostas reais, e as duas levam a uma ação.
- P6. O que dificultaria sua participação? Marque todas as opções que se aplicam. Múltipla escolha, com uma opção de saídaMarcar todas as opções que se aplicam exige esforço, então use com moderação. Aqui se justifica porque os obstáculos se acumulam: alguém pode enfrentar dois ao mesmo tempo, e forçar uma única resposta esconderia isso.
- P7. Quão provável ou improvável é que você recomende este treinamento a alguém da sua equipe? Avaliação de cinco pontos, mesma escala da P21Muito improvável2345Muito provávelOs mesmos cinco pontos, na mesma direção da P2. Reutilizar uma escala significa que ninguém precisa reaprendê-la, e os dois itens podem ficar lado a lado no mesmo gráfico.
- P8. Em qual turno você costuma trabalhar? Escolha única, colocada no fimPerto do fim, porque é o único item que as pessoas podem não querer responder. Está aqui só porque o plano de análise compara turnos. Se não comparasse, seria cortado.
- P9. Há algo mais que devemos saber antes de escolher o formato? Texto aberto, opcionalOpcionalA caixa de encerramento. Ela pega o que as listas de opções deixaram passar, e é o alerta antecipado mais barato que você terá sobre uma pergunta que deveria ter feito.
As opções de resposta acima são apenas exibidas, não clicáveis. São uma imagem do instrumento, não um formulário funcional. Nada aqui coleta dados. A impressão descarta as notas e entrega só os dez itens, então a opção “salvar como PDF” do seu navegador transforma isto em um documento que você pode distribuir.
Este instrumento foi escrito para o exemplo acima. Se você preferir não começar do zero, pode partir de um modelo existente e adaptar os itens às suas próprias decisões.
Verifique um item que você já escreveu
Cole uma pergunta em que você está trabalhando. Esta ferramenta faz as mesmas verificações descritas nas etapas acima e diz quais delas o item não passa. É um checklist, não um veredito: ela lê padrões nas palavras, não consegue ler a sua intenção, e às vezes um item sinalizado é o item certo.
Pense no arquivo de análise, não no slide
Esta restrição vale para todas as etapas, e por isso não é uma das sete. Um questionário também é uma especificação de dados. Se as respostas não puderem ser contadas de forma limpa, você terá ganhado semanas de arrumação e um número que não consegue defender.
- Um construto por coluna. Se você se importa com rapidez e com precisão, meça-as com dois itens. Construtos misturados não podem ser separados depois.
- Padronize os períodos de referência. Misturar “na semana passada” em um item e “no ano passado” no seguinte torna impossível colocar os dois no mesmo gráfico.
- Pré-codifique tudo pelo que você vai agrupar. Nomes de departamento em texto livre chegam como quarenta grafias de seis departamentos. Ofereça uma lista.
- Decida o que significa “ausente” antes de lançar. Pulado, “prefiro não dizer” e “não se aplica” são três coisas diferentes e precisam de três códigos diferentes.
Planeje as comparações e a precisão ao mesmo tempo. Nem um instrumento perfeito salva um estudo que coletou respostas de menos para distinguir dois grupos, o que é uma questão de tamanho da amostra, e o ponto a partir do qual uma diferença conta como real é uma questão de significância estatística.
Pense no celular, não no notebook em que você o montou
A segunda restrição transversal. Parta do princípio de que será um celular, em uma conexão móvel, com uma interrupção no meio do caminho.
Celulares são mais lentos que computadores para o mesmo instrumento. Em um experimento cruzado em que as mesmas pessoas responderam nos dois aparelhos, o tempo mediano de conclusão foi de 17,7 minutos no smartphone, contra 10,5 minutos no PC.11 São 69% a mais para um conteúdo idêntico, então um questionário cronometrado em um notebook está sendo cronometrado no aparelho errado.
A suposição automática de que as respostas pelo celular são piores é só parcialmente verdadeira, e vale ser preciso sobre isso. Uma comparação direta concluiu que os respondentes no celular escreveram respostas abertas mais curtas e pularam mais itens, mas foram os respondentes no PC que mais praticaram straightlining nas perguntas em grade.12 O problema do celular é esforço e interrupção, não descuido.
- Divida as grades. Uma matriz larga em uma tela pequena é o pior padrão possível, e é nela que o straightlining aparece.
- Mantenha as opções curtas o bastante para não quebrar a linha. Opções que ocupam duas linhas deixam de ser comparáveis num relance.
- Mostre perguntas de acompanhamento só quando se aplicarem. A lógica de salto reduz mais a extensão percebida do que cortar itens.
- Faça áreas de toque generosas. Botões de opção com espaço de verdade entre eles, não uma pilha apertada.
- Use uma barra de progresso só se ela for honesta. Uma barra que volta para trás por causa da lógica de salto é pior do que nenhuma barra.
Um questionário é qualitativo ou quantitativo?
Os dois, dependendo do que você coloca nele. O instrumento não é o método. Um questionário feito de itens fechados com opções fixas produz dados quantitativos. Um feito de perguntas abertas produz dados qualitativos. A maioria dos instrumentos reais faz um pouco de cada, e o erro não é deixar de escolher um lado, é deixar de decidir.
| Escolha de desenho | Objetivo quantitativo | Objetivo qualitativo |
|---|---|---|
| O que você busca | Quanto, quantos, como varia entre grupos | Por quê, nas palavras de quem, e o que você não pensou em perguntar |
| Itens | Na maioria fechados, com formatos definidos de antemão | Na maioria perguntas abertas com aprofundamentos |
| Regra de redação | Idêntica para todos, sem exceções | Consistente, mas uma pergunta pode convidar a desenvolver a resposta |
| Quantas pessoas | O suficiente para as comparações que você planeja fazer | O suficiente para que novas respostas deixem de trazer novos temas |
| O que sai | Contagens, porcentagens, diferenças entre grupos | Temas codificados, citações, hipóteses para testar em seguida |
| O principal risco | Respostas precisas para uma pergunta mal redigida | Respostas ricas que você não tem um jeito consistente de codificar |
Em um projeto de pesquisa, o formato misto costuma ser o certo: um pequeno conjunto de itens fechados que carregam a medição e uma ou duas perguntas abertas que explicam os números. A etapa que mais muda é a etapa 2, porque respostas abertas precisam de um esquema de codificação, e esquemas de codificação precisam de mais de um codificador antes que alguém deva confiar neles.1 Se você está escolhendo o formato do estudo, e não os itens, essa decisão fica um nível acima, no desenho de pesquisa.
Quais regras são comprovadas e quais são apenas repetidas
Os conselhos sobre questionários são copiados de página em página até que toda regra pareça igualmente consolidada. Não é. Algumas destas regras se apoiam em décadas de experimentos com amostra dividida. Outras se apoiam em um único estudo recente, e alguns dos números que mais circulam não se apoiam em nada. Veja onde cada afirmação desta página realmente se situa.
| Afirmação | O número | Grau | Fonte |
|---|---|---|---|
| A redação muda o resultado | 65,2% vs. 19,8% disseram que se gasta “pouco demais” com os mesmos programas, rotulados como “assistance to the poor” (assistência aos pobres) ou “welfare” (assistência social) | A | Rasinski 1989; Smith 19872, 3 |
| O enquadramento muda o resultado | 68% vs. 43% de apoio, com e sem uma oração sobre baixas | A | Pew Research Center8 |
| A ordem muda o resultado | 45% vs. 37% de apoio, mesmo item, posição diferente | A | Pew Research Center 20039 |
| Opções específicas do item superam concordo ou discordo | Confiabilidade de 0,87 a 0,93 vs. 0,36 a 0,73 | A | Saris e colegas 20104 |
| A duração informada muda a participação | A conclusão entre os que começaram caiu de 68,2% para 56,8% e para 46,8% com 10, 20 e 30 minutos informados | A | Galesic e Bosnjak 200910 |
| Um “não sei” oferecido é escolhido | 15% o escolheram; só 3% e 4% deixaram itens comparáveis sem resposta quando ele não existia | A | Gilljam e Granberg 19937 |
| No celular leva mais tempo | 17,7 vs. 10,5 minutos medianos, mesmas pessoas, nos dois aparelhos | A | Antoun e colegas 201711 |
| De cinco a sete pontos na escala | Os índices sobem até cerca de 7 pontos e depois se estabilizam; a confiabilidade volta a cair acima de 10 | B | Preston e Colman 20005, 1 |
| Uma opção “não sei” tira pessoas do ponto central | A escolha do ponto central caiu cerca de 7 a 17 pontos | B | Wetzelhutter 20206 |
| O straightlining é comum onde é plausível | 15% a 40% em blocos plausíveis, menos de 2% nos demais | B | Schonlau e Toepoel 201513 |
| Respostas pelo celular não são simplesmente piores | Respostas abertas mais curtas no celular, mas mais straightlining no PC | B | Mavletova 201312 |
| Separe itens duplos | Nenhuma porcentagem clara; as duas versões não mediram a mesma coisa | B | Menold 202015 |
| O pré-teste não tem um ponto seguro de parada | Os problemas continuaram aparecendo à medida que o número de entrevistas crescia | B | Blair e Conrad 201114 |
O que significam os graus: A experimento replicado ou síntese de toda a literatura. B um estudo sólido. C muito repetido, mas contestado ou sem origem rastreável, e por isso nada nesta página recebe esse grau.
Números que deixamos de fora de propósito
Cada um destes é comum em conselhos sobre questionários. Rastreamos todos até uma fonte e os deixamos de fora.
“A capacidade de atenção agora é de 8 segundos, menor que a de um peixinho-dourado”
Remonta a um relatório de marketing de 2015 que citava um site de conteúdo em massa cujas próprias fontes não puderam ser apresentadas quando jornalistas perguntaram.24 A comparação com o peixinho-dourado também é inventada.
“De cinco a sete entrevistas de pré-teste detectam de 75% a 85% dos problemas”
É um resultado de testes de usabilidade sobre bugs de software22 que foi transplantado para a entrevista cognitiva. O estudo real com pesquisas não encontrou esse patamar.14
“A taxa de resposta média de uma pesquisa é [escolha um número]”
Circulam pelo menos quatro números incompatíveis, cada um com uma definição oculta diferente de quem foi consultado. Em vez disso, existem faixas fundamentadas por tipo de amostra.21
“Mantenha abaixo de 10 minutos ou você perde as pessoas”
A direção está certa; a queda abrupta, não. A curva medida é uma inclinação constante de 10 a 30 minutos informados, sem um limiar.10
“Sete mais ou menos dois, então use uma escala de 7 pontos”
O artigo de Miller de 1956 trata da memória de curto prazo para listas, e não de quantos pontos uma pessoa consegue distinguir em uma escala.23 As evidências reais sobre pontos de escala levam a cinco a sete de qualquer forma.5
“Perguntas duplas arruínam seus dados”
Regra sólida, evidência escassa. Encontramos um único teste randomizado dedicado a ela, contra dezenas sobre efeitos de redação e de ordem.15 Dizemos isso na etapa 3, em vez de exagerar.
Casos-limite que quebram questionários sem ninguém perceber
Itens sensíveis
Renda, saúde, problemas de desempenho e qualquer coisa que um gestor possa ler. Esses itens aumentam tanto os abandonos quanto as respostas falsas quando a confiança é baixa. Coloque-os no fim, diga em uma linha por que você está perguntando e ofereça uma forma real de recusar. “Prefiro não dizer” é um dado. Um campo em branco não é.
“Não se aplica” não é “neutro”
Não deixe que quem não consegue avaliar caia no meio da sua escala. Ofereça uma opção separada, fora da escala, ou desvie essas pessoas do item com lógica de salto. Caso contrário, sua média se desloca por um motivo que não tem nada a ver com opinião.
Efeitos de ordem dentro de uma lista longa
Opções perto do topo de uma lista longa são escolhidas com mais frequência na tela. Randomize a ordem de marcas, motivos e problemas, e mantenha a ordem fixa só onde ela significa algo, como uma escala de frequência ou uma série de datas.
Negações
“Você concorda que o onboarding não é difícil?” obriga o leitor a resolver duas negativas antes de responder. Escreva a versão positiva e deixe a escala indicar a direção.
Tradução
Evite expressões idiomáticas, metáforas esportivas e abreviações locais, porque elas não sobrevivem à tradução e excluem quem lê no seu idioma como segunda língua. Se você traduzir, use a retrotradução e peça a revisão de alguém que conheça o assunto, e não só o idioma.
Ondas repetidas
Se você pretende comparar esta rodada com a próxima, congele a redação agora. Melhorar um item entre as ondas significa que a mudança medida pode ser a sua própria edição. Mantenha a redação antiga, acrescente a melhor ao lado dela por uma onda e só então faça a troca.
O checklist de revisão, antes de enviar qualquer coisa
Checklist de revisão do questionário
- Decisões. Todo item remete a uma decisão que você anotou na etapa 1.
- Formatos. O formato de cada item foi escolhido pelo resultado que ele alimenta, e não por hábito.
- Períodos. Todo item sobre comportamento nomeia um período, e o período combina com o comportamento.
- Termos. O jargão é definido no enunciado. As siglas são escritas por extenso uma vez.
- Uma ideia. Nenhum item esconde dois atributos, dois objetos ou dois períodos.
- Opções. As faixas não se sobrepõem, a lista cobre as respostas realistas e há uma opção de saída.
- Escalas. Mesmos pontos, mesma direção, com rótulos, e “não se aplica” mantido fora da escala.
- Redação neutra. Nenhum adjetivo no enunciado, e as duas direções oferecidas.
- Ordem. Triagem primeiro, itens sensíveis no fim, uma escala por bloco.
- Introdução. Objetivo, tempo honesto, privacidade, participação voluntária, contato. Cinco linhas.
- Celular. Aberto em um celular de verdade, sem grades largas, sem opções que quebram a linha.
- Leitura em voz alta. Alguém de fora do projeto leu todos os itens e entendeu cada um como pretendido.
- Tempo. O número na sua introdução veio dessa leitura em voz alta, e não de um palpite.
- Códigos. Pulado, recusado e não se aplica têm três códigos separados.
Perguntas frequentes
Qual é a primeira etapa na elaboração de um questionário?
Anotar as decisões que os resultados precisam embasar. Não o tema: as decisões. Enquanto você não souber dizer o que fará de diferente dependendo das respostas, não há como distinguir um item necessário de um opcional, e o rascunho cresce até alguém se cansar dele.
Qual é a diferença entre um questionário e uma pesquisa?
O questionário é o instrumento: a lista de itens e suas opções de resposta. A pesquisa é todo o estudo em torno dele, incluindo a quem você pergunta, como chega até essas pessoas, de quantas precisa e o que faz com os resultados. Você pode fazer uma pesquisa com vários questionários, e usar o mesmo questionário em várias pesquisas.
Quantas perguntas um questionário deve ter?
Tão poucas quanto suas decisões exigirem. Perseguir um número-alvo é o caminho errado; mire em um tempo de conclusão e obtenha esse tempo da sua própria leitura em voz alta, e não de uma regra prática. A duração informada afeta quem participa: em um experimento controlado, a conclusão entre as pessoas que começaram caiu de 68,2% com 10 minutos informados para 46,8% com 30 minutos informados.
Quanto tempo um questionário deve levar para ser respondido?
Curto o bastante para que o tempo informado não afaste as pessoas, e honesto o bastante para corresponder à realidade. Não existe uma queda abrupta em um minuto específico. A relação medida é uma queda constante da participação à medida que a duração informada aumenta, então cada item que você mantém custa um pouco de resposta, e você deve saber dizer o que cada um compra.
Um questionário é qualitativo ou quantitativo?
Pode ser qualquer um dos dois, e a maioria tem um pouco de cada. Itens fechados com opções fixas produzem dados quantitativos. Perguntas abertas produzem dados qualitativos. O que importa é decidir para que serve cada item antes de escrevê-lo, porque os dois exigem regras de redação diferentes, quantidades diferentes de respondentes e análises completamente diferentes.
Devo incluir um ponto central neutro em uma escala de avaliação?
Inclua quando “neutro” for uma posição genuína sobre o que você está medindo. Removê-lo não força uma opinião oculta a aparecer; as pessoas escolhem mais ou menos ao acaso entre os pontos mais próximos do meio. Decida também sobre o ponto central e uma opção “não sei” em conjunto, porque oferecer um “não sei” reduz o uso do ponto central em cerca de 7 a 17 pontos percentuais.
Quando devo oferecer uma opção “Não sei”?
Quando o respondente pode realmente não ter a informação, como o nome de um plano, uma data ou um detalhe técnico. Evite em perguntas sobre a própria experiência da pessoa, que quase todos conseguem responder. Uma saída fácil é usada: em um item de atitude, 15% escolheram “não sei” quando a opção foi oferecida, enquanto só 3% a 4% deixaram sem resposta itens comparáveis que não a ofereciam.
Quantas perguntas abertas devo usar?
Uma ou duas, posicionadas onde realmente valham a pena, em geral como acompanhamento de uma resposta fechada específica e como um espaço final para o que sobrar. Respostas abertas são a única forma de ouvir o que a sua lista de opções esqueceu, mas precisam de um esquema de codificação e de mais de um codificador antes que os resultados signifiquem algo, e esse custo é real.
Como testar um questionário antes de enviá-lo?
Em duas passagens. Um pré-teste verifica a compreensão: peça às pessoas que leiam cada item em voz alta e digam o que acham que ele significa e como escolheram a resposta. Um teste piloto é uma pequena aplicação real que verifica os dados: pontos de abandono, cobertura das opções, comportamento da escala e se a análise planejada realmente funciona. Faça primeiro o pré-teste, porque é ele que muda a redação.
Que tipo de desenho de pesquisa usa um questionário?
Um questionário é um instrumento de coleta de dados, não um desenho, então aparece em vários desenhos. Estudos transversais o usam em um único momento. Estudos de tendência e de painel o repetem ao longo do tempo. Experimentos o usam para medir os desfechos depois de uma manipulação. Escolher entre eles é uma decisão de desenho do estudo, que fica um nível acima da redação dos itens.
Como validar um questionário?
Alguns poucos itens novos que medem algo concreto precisam de pré-teste, não de validação psicométrica. Uma escala que pretende medir algo abstrato, e ser comparada entre grupos ou reutilizada por outras pessoas, precisa de mais: revisão do conteúdo por especialistas, um teste piloto grande o bastante para verificar se os itens se sustentam juntos e evidências de que as pontuações se relacionam com algo externo da forma que você previu. Se já existe um instrumento validado para o seu construto, use-o em vez de escrever o seu.
Como este guia foi feito e o que ele não cobre
A sequência de sete etapas segue o processo de desenvolvimento descrito na literatura de metodologia de questionários16, 17, 18, 20, e não o modelo de um fornecedor específico. Todos os números citados nesta página vêm de um experimento publicado ou de um relatório metodológico oficial, listados abaixo. Cada um recebeu um grau antes de ser usado, e o grau aparece ao lado da afirmação na tabela de evidências.
Afirmações que não conseguimos rastrear até uma fonte primária ficaram de fora, e as mais comuns delas são citadas em “números que deixamos de fora de propósito”, para que você possa reconhecê-las em outros lugares. Onde uma regra é sólida, mas a evidência direta é escassa, como separar itens duplos, a página diz isso, em vez de pegar emprestada a confiança de uma conclusão mais forte.
A maior parte das evidências experimentais aqui vem de pesquisas feitas nos Estados Unidos e na Europa Ocidental, em grande parte com amostras da população geral e de painéis on-line. Os tamanhos de efeito da redação e da ordem não se transferem inalterados para todo idioma, assunto ou população, e nada disso foi testado com os seus respondentes. Trate os números como evidência de que esses efeitos são reais e podem ser grandes, e não como constantes que você pode simplesmente aplicar.
O exemplo prático é um caso construído para mostrar as sete etapas em um só lugar. Não é o relato de um estudo real, e o pré-teste descrito nele é ilustrativo.
Esta página trata do instrumento. Ela não trata de a quem perguntar, a quantas pessoas perguntar nem de como analisar o que volta. Essas são tarefas separadas, tratadas em amostragem, tamanho da amostra e significância estatística.
A SuperSurvey faz software de pesquisas, então temos interesse comercial em que as pessoas façam pesquisas. Este guia é gratuito para leitura, e suas recomendações valem para qualquer plataforma de pesquisas. O verificador de itens roda inteiramente no seu navegador e não envia nada a lugar nenhum. Os links para o nosso criador e para a nossa biblioteca de modelos oferecem formas de colocar o questionário em prática.
Referências
- Krosnick, J. A., & Presser, S. (2010). Question and questionnaire design. Em P. V. Marsden & J. D. Wright (Orgs.), Handbook of Survey Research (2ª ed., cap. 9). Emerald.
- Rasinski, K. A. (1989). The effect of question wording on public support for government spending. Public Opinion Quarterly, 53(3), 388-394. doi.org/10.1086/269158
- Smith, T. W. (1987). That which we call welfare by any other name would smell sweeter. Public Opinion Quarterly, 51(1), 75-83. doi.org/10.1086/269015
- Saris, W. E., Revilla, M., Krosnick, J. A., & Shaeffer, E. M. (2010). Comparing questions with agree/disagree response options to questions with item-specific response options. Survey Research Methods, 4(1), 61-79. doi.org/10.18148/srm/2010.v4i1.2682
- Preston, C. C., & Colman, A. M. (2000). Optimal number of response categories in rating scales. Acta Psychologica, 104(1), 1-15. doi.org/10.1016/S0001-6918(99)00050-5
- Wetzelhutter, D. (2020). Scale-sensitive response behavior: consequences of offering versus omitting a "don't know" option and/or a middle category. Survey Practice, 13(1). doi.org/10.29115/SP-2020-0012
- Gilljam, M., & Granberg, D. (1993). Should we take don't know for an answer? Public Opinion Quarterly, 57(3), 348-357. doi.org/10.1086/269380
- Pew Research Center. Writing survey questions. Explicação de métodos. pewresearch.org/writing-survey-questions
- Pew Research Center (2003, 18 de novembro). Religious beliefs underpin opposition to homosexuality, Part 2: Gay marriage. pewresearch.org/politics/2003/11/18/part-2-gay-marriage
- Galesic, M., & Bosnjak, M. (2009). Effects of questionnaire length on participation and indicators of response quality in a web survey. Public Opinion Quarterly, 73(2), 349-360. doi.org/10.1093/poq/nfp031
- Antoun, C., Couper, M. P., & Conrad, F. G. (2017). Effects of mobile versus PC web on survey response quality. Public Opinion Quarterly, 81(S1), 280-306. doi.org/10.1093/poq/nfw088
- Mavletova, A. (2013). Data quality in PC and mobile web surveys. Social Science Computer Review, 31(6), 725-743. doi.org/10.1177/0894439313485201
- Schonlau, M., & Toepoel, V. (2015). Straightlining in web survey panels over time. Survey Research Methods, 9(2), 125-137. doi.org/10.18148/srm/2015.v9i2.6128
- Blair, J., & Conrad, F. G. (2011). Sample size for cognitive interview pretesting. Public Opinion Quarterly, 75(4), 636-658. doi.org/10.1093/poq/nfr035
- Menold, N. (2020). Double barreled questions: an analysis of the similarity of elements and effects on measurement quality. Journal of Official Statistics, 36(4), 855-886. doi.org/10.2478/jos-2020-0041
- Rattray, J., & Jones, M. C. (2007). Essential elements of questionnaire design and development. Journal of Clinical Nursing, 16(2), 234-243. doi.org/10.1111/j.1365-2702.2006.01573.x
- Boparai, J. K., Singh, S., & Kathuria, P. (2019). How to design and validate a questionnaire: a guide. Current Clinical Pharmacology, 13(4), 210-215. doi.org/10.2174/1574884713666180807151328
- Slattery, E. L., Voelker, C. C. J., Nussenbaum, B., Rich, J. T., Paniello, R. C., & Neely, J. G. (2011). A practical guide to surveys and questionnaires. Otolaryngology-Head and Neck Surgery, 144(6), 831-837. doi.org/10.1177/0194599811399724
- Edwards, P. (2010). Questionnaires in clinical trials: guidelines for optimal design and administration. Trials, 11, 2. doi.org/10.1186/1745-6215-11-2
- Stone, D. H. (1993). Design a questionnaire. BMJ, 307(6914), 1264-1266. pmc.ncbi.nlm.nih.gov/articles/PMC1679392
- American Association for Public Opinion Research (2022). Data quality metrics for online samples: considerations for study design and analysis. Relatório de força-tarefa. relatório da força-tarefa em aapor.org (PDF)
- Nielsen, J., & Landauer, T. K. (1993). A mathematical model of the finding of usability problems. Proceedings of ACM INTERCHI '93, 206-213. doi.org/10.1145/169059.169166
- Miller, G. A. (1956). The magical number seven, plus or minus two. Psychological Review, 63(2), 81-97. doi.org/10.1037/h0043158
- Maybin, S. (2017, 10 de março). Busting the attention span myth. BBC News. bbc.com/news/health-38896790
Todos os DOIs acima foram conferidos no resolvedor de DOI, e todos os links foram verificados quanto a uma resposta ativa, em 21 de agosto de 2026.