
O tamanho da amostra de uma pesquisa é o número de envios completos incluídos na sua análise, representado por n. Ele é diferente do número de convites ou de pessoas na sua lista. Dentro das premissas de amostragem da calculadora, uma amostra maior estreita a margem de erro; ela não elimina um recrutamento enviesado nem perguntas mal formuladas.
Calculadora de tamanho da amostra
Nada fica escondido atrás de um cadastro e nada é enviado a lugar nenhum. A calculadora roda no seu navegador, já começa com uma resposta calculada na tela e mostra a fórmula e as contas que usou, para que você possa conferir ou refazer à mão.
De quantos envios eu preciso?
Defina os seis valores. A resposta, a fórmula e as contas são atualizadas enquanto você digita.
Envios completos necessários
370
Após a correção para população finita.
Pessoas a convidar
1,234
Com uma taxa de resposta de 30%.
Fração amostral
3.7%
Parcela da população que você precisa ouvir.
Total, dimensionado por subgrupo
370
As contas, passo a passo
| Margem de erro | Envios completos necessários | Convites necessários |
|---|
Mais precisão custa envios em proporção aproximada ao quadrado da melhora. Reduzir a margem de erro pela metade multiplica a amostra por cerca de quatro.
O botão de copiar gera um parágrafo curto de métodos com seus números, a fórmula e a citação, pronto para colar em um resumo de projeto ou em um capítulo de metodologia.
Cite esta calculadora: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
O resultado é o número de envios completos, não de convites. É a contagem que você precisa ter em mãos no fim do trabalho de campo. O número de convites é esse número dividido pela taxa de resposta que você espera, e é aí que a maioria dos planos amostrais erra. Depois de definir a meta, crie sua pesquisa e faça um teste piloto com o público pretendido. Use o teste piloto para verificar a redação e estimar a taxa de conclusão em relação aos convites no seu próprio projeto.
O que é tamanho da amostra
Tamanho da amostra é o número de pessoas que concluem a sua pesquisa. Ele é representado por n em todas as fórmulas desta página, é a única grandeza que você compra com trabalho de campo em vez de escolher no papel, e é o número a partir do qual sua margem de erro é calculada.
Três contagens costumam ser confundidas com ele, e diferenciá-las é a maior parte do que um plano amostral faz:
- População (N): todos que você quer descrever. Uma lista de clientes, um quadro de funcionários, um país.
- Convites: quantas pessoas você contata. Sempre mais do que n, porque nem todo mundo responde.
- Tamanho da amostra (n): quantos envios completos você tem quando o trabalho de campo termina. Este é o número que a fórmula dimensiona, e o único dos três que muda sua margem de erro.
O tamanho da amostra compra precisão, que é a largura da faixa de mais ou menos em torno de cada resultado. Ele não compra exatidão, que depende de as pessoas que responderam se parecerem com as que não responderam. Uma grande amostra por conveniência pode ficar mais longe da verdade do que uma pequena amostra aleatória, e nenhum valor de n corrige isso. Onde o planejamento do tamanho da amostra erra explica a diferença, e a forma como você extrai a amostra é o que a decide.
A resposta curta, se você só quer um número
Números-chave
- 385 envios completos é a resposta padrão. É o que a fórmula retorna com 95% de confiança, margem de erro de 5 pontos percentuais para mais ou para menos e nenhuma estimativa prévia do resultado.
- Populações pequenas precisam de muito menos. Uma lista de 1.000 pessoas precisa de 278. Uma lista de 100 precisa de 80. É a correção para população finita em ação.
- Precisão custa caro. Reduzir a margem de erro pela metade multiplica a amostra por cerca de quatro. Passar de 5 pontos para mais ou para menos para 1 ponto para mais ou para menos leva você de 385 a 9.604.
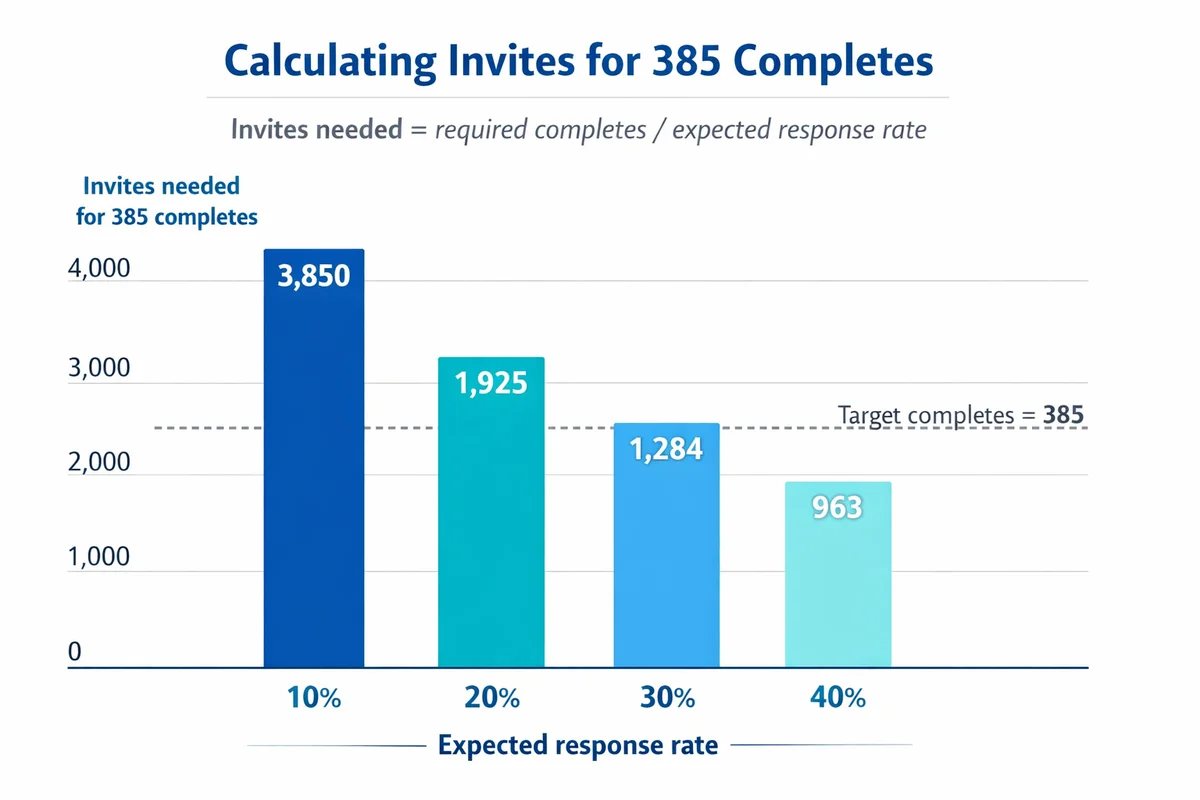
- As fórmulas contam envios completos, não convites. Os convites necessários são iguais aos envios completos divididos pela taxa de resposta esperada. Com 30%, 385 envios completos significam convidar 1.284 pessoas.
- A margem de erro cobre um único tipo de erro. Ela mede o ruído de amostrar algumas pessoas em vez de todas. Não diz nada sobre as pessoas que nunca responderam.
A fórmula do tamanho da amostra e como calculá-la à mão
Para uma pesquisa que reporta uma porcentagem, o ponto de partida padrão é o tamanho da amostra para uma população grande o bastante para ser tratada como ilimitada:
n0 = (z^2 x p x (1 - p)) / E^2
Lendo da esquerda para a direita:
- n0 é o número de envios completos necessários, antes de qualquer correção para a população.
- z é o escore z do seu nível de confiança. Use 1,96 para 95%.
- p é a proporção que você espera medir, em decimal. Use 0,5 se não souber.
- E é a margem de erro em decimal. Cinco pontos percentuais equivalem a 0,05.
O símbolo do tamanho da amostra é n. Algumas fontes escrevem o número sem correção como n0 e o corrigido como n, que é a convenção usada aqui.
| Nível de confiança | z | Quanto custa |
|---|---|---|
| 80% | 1.282 | 165 envios completos com margem de 5 pontos para mais ou para menos |
| 90% | 1.645 | 271 envios completos |
| 95% (padrão) | 1.960 | 385 envios completos |
| 99% | 2.576 | 664 envios completos |
| 99,9% | 3.291 | 1.084 envios completos |
Exemplo resolvido: de 385 a uma lista de convites
Cenário. Você quer saber a porcentagem de clientes que recomendariam sua empresa. Você quer 95% de confiança e margem de 5 pontos para mais ou para menos. Você não tem uma estimativa prévia, então p = 0,5.
Escolha o nível de confiança e a margem de erro
95% de confiança define z = 1,96. Margem de 5 pontos percentuais para mais ou para menos é E = 0,05.
Escolha um resultado esperado
p = 0,5, porque não há estimativa prévia e 0,5 produz a maior amostra. Nada do que você descobrir depois pode deixar você com envios de menos.
Aplique a fórmula do tamanho da amostra
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Arredonde para cima: 385 envios completos. Sempre arredonde para cima. Não dá para coletar uma fração de pesquisa.
Corrija para uma população pequena
Se esses clientes forem uma lista de 1.000, e não um mercado aberto, aplique a correção: n = 384,16 / (1 + 383,16 / 1.000) = 384,16 / 1,38316 = 277,7, portanto 278 envios completos. A correção só faz diferença quando a amostra é uma parcela grande da população.
Converta envios completos em convites
Com uma taxa de resposta de 30%, convites = 278 / 0,30 = 926,7, portanto convide 927 pessoas. Os envios completos são o que a fórmula dimensiona. Os convites são o que você de fato envia, e eles nunca podem ser mais numerosos que a população da qual você está extraindo a amostra.
Com 95% de confiança e p = 0,5, a fórmula inteira se reduz a 0,9604 dividido por E ao quadrado. Esse único atalho responde à maioria das perguntas sobre tamanho da amostra em uma linha, e é por isso que 385 aparece sem parar nas tabelas de tamanho da amostra que você encontra por aí.
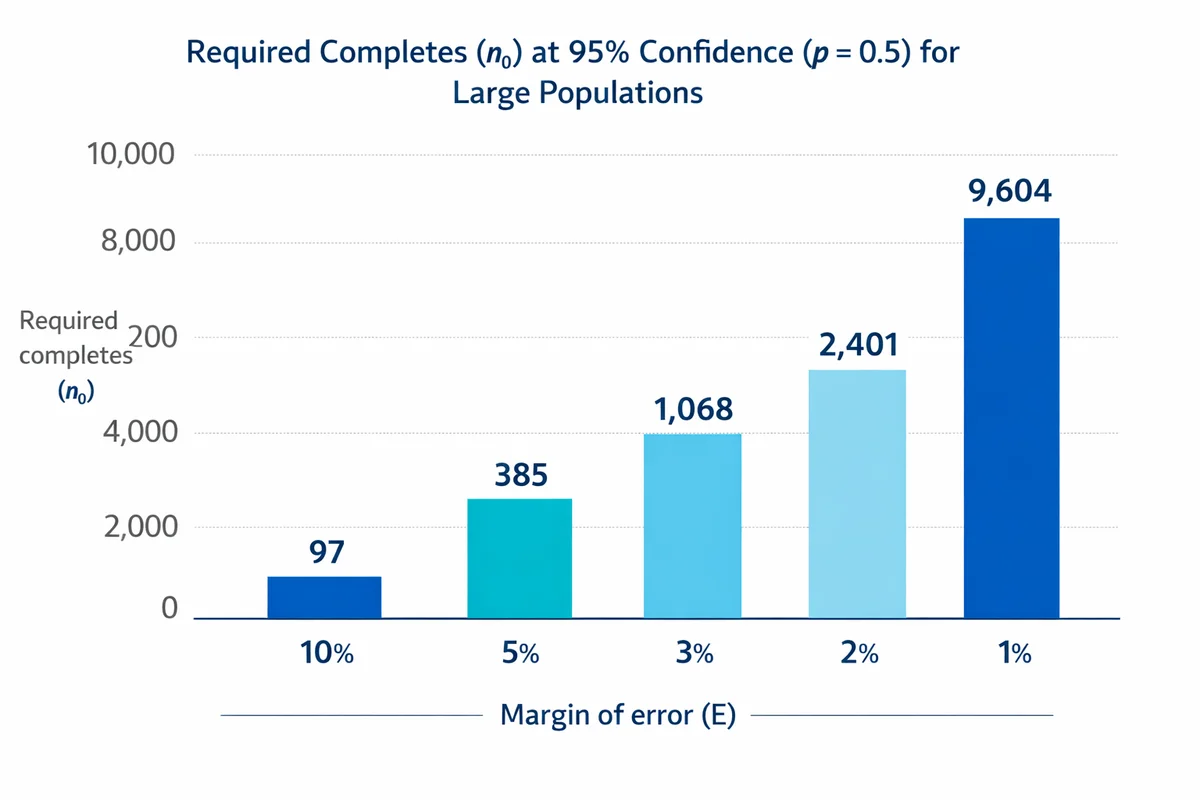
Tabela de tamanho da amostra para tamanhos de população comuns
Estes números foram calculados com a fórmula acima, com 95% de confiança, margem de 5 pontos para mais ou para menos e p = 0,5, e depois corrigidos para a população. As duas últimas colunas são a nossa própria conferência com a tabela publicada por Krejcie e Morgan em 1970, que é a tabela citada na maioria dos capítulos de metodologia.
| População (N) | Envios completos necessários | Krejcie e Morgan (1970) | Diferença |
|---|---|---|---|
| 10 | 10 | 10 | igual |
| 25 | 24 | não consta | |
| 50 | 45 | 44 | 1 a mais |
| 100 | 80 | 80 | igual |
| 200 | 132 | 132 | igual |
| 500 | 218 | 217 | 1 a mais |
| 1,000 | 278 | 278 | igual |
| 2,000 | 323 | 322 | 1 a mais |
| 5,000 | 357 | 357 | igual |
| 10,000 | 370 | 370 | igual |
| 50,000 | 382 | 381 | 1 a mais |
| 100,000 | 383 | 384 | 1 a menos |
Como conferimos. Aplicamos a fórmula a 21 tamanhos de população e comparamos cada resultado com o valor publicado por Krejcie e Morgan. Doze coincidiram exatamente. Os outros nove diferiram em exatamente um envio, o que vem do ponto em que cada método arredonda, e não de uma divergência nas contas. Se um orientador perguntar por que seu número difere da tabela em um, esse é o motivo.
Vale saber, se você for citar essa tabela: Krejcie e Morgan não deduziram uma fórmula própria. O artigo deles de 1970 tem cerca de 400 palavras e uma tabela, e sua única referência atribui a fórmula a um boletim de pesquisa de 1960 da National Education Association. O resumo que os próprios autores fazem do padrão continua sendo a melhor descrição em uma linha: à medida que a população cresce, a amostra necessária aumenta a um ritmo cada vez menor e se estabiliza em pouco mais de 380 casos.
Como escolher os valores, um de cada vez
Quatro números determinam a resposta. Três deles são decisões, não fatos, e cada um tem uma forma defensável de ser escolhido.
Nível de confiança: com que frequência o método acerta
O nível de confiança descreve o método, não esta pesquisa em particular. Com 95% de confiança, os intervalos construídos desta forma contêm o valor verdadeiro 95 vezes em cada 100, no longo prazo. Não é uma chance de 95% de que a sua resposta específica esteja correta.
Use 95%, a menos que tenha um motivo para não usar. Passar para 99% eleva a amostra de 385 para 664 com a mesma precisão, um aumento de custo de 72% para ganhar muito pouco. A ideia relacionada nos testes de hipótese é o alfa, e é por isso que as pessoas confundem os dois. Se essa diferença não estiver clara, leia significância estatística e o que significam os valores-p antes de escolher um número.
Margem de erro: a variável de decisão
É sobre esta que você deve pensar com mais cuidado, porque é o único valor que liga a amostra a uma decisão. Escolha-a perguntando qual diferença mudaria o que você faz.
Se você age de forma diferente quando a satisfação é de 72% em vez de 74%, precisa de uma margem estreita. Se só age diante de 72 contra 82, uma margem de 5 pontos para mais ou para menos é suficiente. Relatórios gerais costumam ficar em 5 pontos para uma sondagem rápida ou em 3 pontos para acompanhamento contínuo. Abaixo de 2 pontos, o custo sobe rapidamente.
Tamanho da população: quase irrelevante, até deixar de ser
Para populações grandes, a amostra necessária quase não muda. Dez mil pessoas precisam de 370 envios. Cem mil precisam de 383. O tamanho da população só faz diferença quando sua amostra é uma parcela significativa dela, como em listas de funcionários, cadastros de associados e turmas escolares. É disso que trata a próxima seção.
Resultado esperado (p): use 0,5 quando não souber
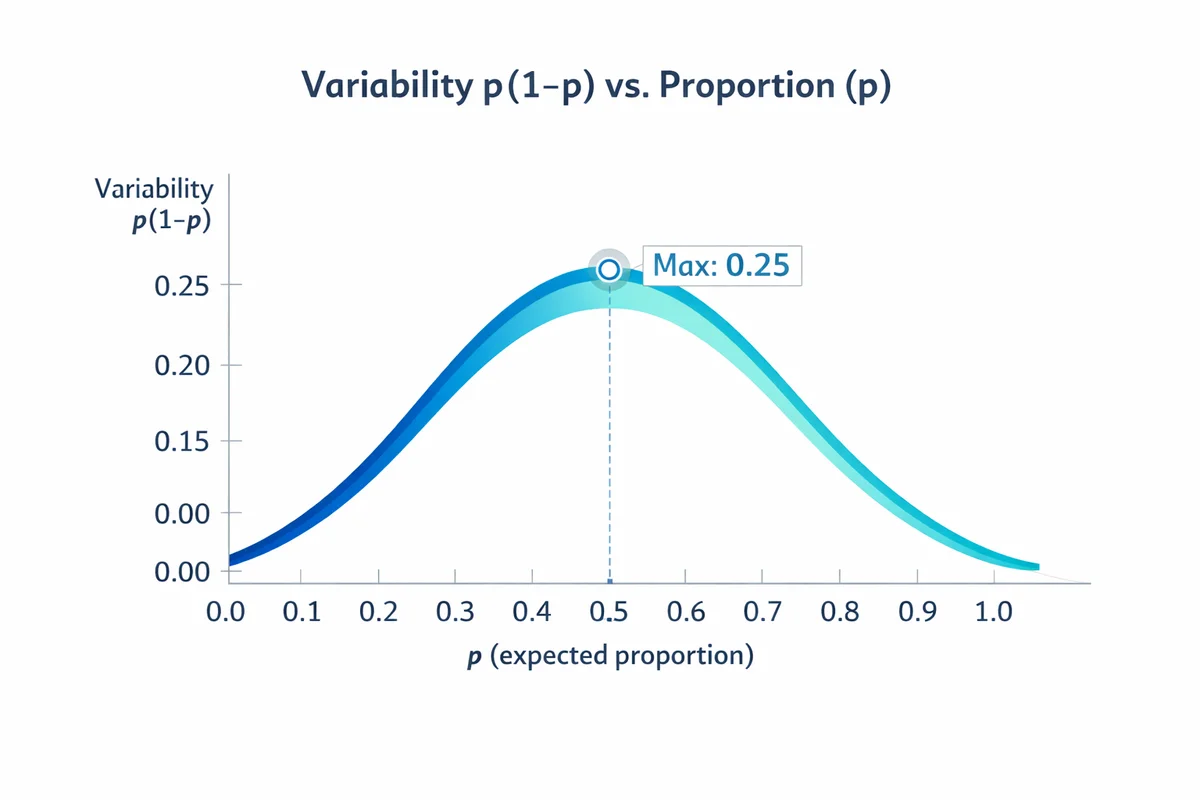
Em uma pergunta de porcentagem, a incerteza é determinada por p vezes (1 menos p). Esse termo é máximo em p = 0,5, então 0,5 é a escolha conservadora e produz a maior amostra. É o padrão certo quando você não tem uma estimativa prévia.
Se você tiver uma, use-a, porque a economia é grande. Com 95% de confiança e margem de 5 pontos para mais ou para menos, p = 0,5 pede 385 envios e p = 0,9 pede 139. Pesquisas anteriores, um teste piloto ou uma referência publicada são fontes válidas para essa estimativa. Perguntas ruidosas também aumentam a dispersão, então uma redação mais clara pode estabilizar um resultado sem nenhum envio extra. Escrever perguntas de pesquisa melhores muitas vezes sai mais barato do que coletar mais envios.
Populações pequenas: a correção para população finita
A fórmula básica pressupõe que você está extraindo a amostra de um conjunto tão grande que retirar pessoas dele não muda nada. Quando sua amostra é uma fatia real da população, essa premissa cobra de você mais do que o necessário. A correção para população finita devolve os envios.
n = n0 / (1 + ((n0 - 1) / N))
- n é o número corrigido de envios completos de que você precisa.
- n0 é o número sem correção da fórmula acima.
- N é o tamanho da população.
O gatilho usual é n0 ser maior que cerca de 5% de N. Abaixo disso, a correção quase não muda nada, então nem vale a pena explicá-la a ninguém.
Exemplo resolvido: uma pesquisa com funcionários
Cenário. Você tem 1.200 funcionários. Quer 95% de confiança e margem de 5 pontos para mais ou para menos, e usa p = 0,5.
- Sem correção, n0 = 384,16.
- Com correção: n = 384,16 / (1 + (383,16 / 1.200)) = 384,16 / 1,3193 = 291,2.
- Arredonde para cima: 292 envios completos.
Sem a correção, você correria atrás de 385 envios em uma lista de 1.200, ou seja, 32% de todo mundo. Com ela, 292 dão a mesma precisão. Em uma lista desse tamanho, isso é um mês de cobranças que você não precisa fazer.
Abaixo de cerca de 200 pessoas, a amostra corrigida é uma parcela tão grande da lista que convidar todos é mais simples e mais defensável. Um censo de 150 pessoas não tem nenhum erro amostral. Seu esforço passa então para a taxa de resposta e para quem está faltando, que é onde ele deve estar.
Margem de erro: a mesma fórmula, ao contrário
A margem de erro é a faixa de mais ou menos em torno do resultado de uma pesquisa que vem de ter consultado algumas pessoas em vez de todas. Se 62% de 385 respondentes escolhem uma opção e a margem de erro é de 5 pontos, você reporta 62% e diz que a faixa plausível vai de 57% a 67%.
Reorganizar a fórmula do tamanho da amostra para isolar E resulta em:
E = z x raiz quadrada de (p x (1 - p) / n)
Com uma população finita, multiplique isso pela raiz quadrada de (N - n) dividido por (N - 1). As duas versões estão na calculadora abaixo, que alterna automaticamente quando você marca ou desmarca a caixa da população.
Qual é a margem de erro dos envios que já tenho?
A mesma fórmula, reorganizada. Informe os envios que você coletou e veja a precisão resultante.
Margem de erro
5.0
Pontos percentuais, para mais ou para menos.
Seu intervalo
45,0 a 55,0
Porcentagem, com 95% de confiança.
As contas, passo a passo
A margem de erro aumenta com o tamanho da amostra?
Ela diminui, e diminui com a raiz quadrada de n. Essa raiz quadrada é toda a economia das pesquisas. Quatrocentos envios dão metade do erro de cem. Para reduzi-lo à metade de novo, você precisa de 1.600. Cada casa decimal a mais de precisão custa cerca de quatro vezes o trabalho de campo, e é por isso que 385 é um ponto de chegada tão comum: é onde custo e precisão param de brigar.
Quatro termos que as pessoas confundem
Erro-padrão, margem de erro, nível de confiança e intervalo de confiança são usados como se fossem intercambiáveis. São quatro coisas diferentes, e a diferença importa quando alguém questiona o seu número.
| Termo | O que é | Com 385 envios e 50% |
|---|---|---|
| Erro-padrão | A dispersão bruta da estimativa. A raiz quadrada de p vezes (1 menos p) dividido por n. | 0,0255, ou 2,55 pontos percentuais |
| Margem de erro | O erro-padrão multiplicado pelo escore z do nível de confiança escolhido. | 5,0 pontos para mais ou para menos, com 95% |
| Nível de confiança | O escore z escolhido, expresso como porcentagem. Uma escolha, não uma medição. | 95%, portanto z = 1,96 |
| Intervalo de confiança | O resultado com a margem de erro aplicada, escrito como uma faixa. | 45,0% a 55,0% |
A versão curta: o erro-padrão é uma propriedade dos seus dados, o nível de confiança é uma escolha que você fez, a margem de erro é os dois multiplicados, e o intervalo de confiança é o que você publica no relatório.
O que a margem de erro não cobre
Ela cobre o erro amostral aleatório e nada mais. Não cobre pessoas que ignoraram o convite, uma lista à qual faltava parte da população nem uma pergunta que metade dos seus respondentes entendeu de um jeito diferente do que você quis dizer. Uma pesquisa pode ter uma margem de erro bem arrumada e ainda assim estar errada. Veja viés de resposta e viés de não resposta para os erros que nenhum tamanho de amostra corrige.
A entidade profissional da pesquisa por amostragem diz isso de forma mais direta do que a maioria dos fornecedores. A AAPOR afirma que não existe uma margem de erro geral mensurável para uma pesquisa eleitoral, porque as pesquisas carregam outros erros que simplesmente não podem ser medidos, desde a forma como as perguntas foram escritas até a forma como as entrevistas foram conduzidas. O que dá para calcular é a parte amostral. É essa parte que a calculadora fornece, e vale deixar claro que ela é só uma parte.
Duas regras de uso da mesma fonte, e a maioria dos textos sobre pesquisas erra as duas:
- São pontos percentuais, não uma porcentagem. Escreva “3 pontos percentuais para mais ou para menos”, e não “3% para mais ou para menos”. Significam coisas diferentes.
- Ela não se aplica de forma alguma a amostras de adesão voluntária. Uma margem de erro pressupõe que cada pessoa tinha uma chance de seleção conhecida e diferente de zero. Um link aberto, um painel de voluntários ou uma publicação em rede social não atendem a isso. Publicar uma margem de erro ao lado de resultados de um link aberto é afirmar uma precisão pela qual você não pagou.
Como converter envios completos em convites
A fórmula dá a você envios concluídos. O trabalho de campo dá a você uma taxa de resposta. A distância entre os dois é onde os planos amostrais costumam falhar, e a conta cabe em uma linha:
Convites = envios completos necessários / taxa de resposta esperada
Use a taxa em decimal, então 30% vira 0,30, e arredonde para cima. Para 292 envios completos com 35%, isso dá 292 dividido por 0,35 = 834,3, portanto convide pelo menos 835 pessoas.
| Envios completos necessários | Taxa de resposta esperada | Convites |
|---|---|---|
| 385 | 60% | 642 |
| 385 | 30% | 1,284 |
| 385 | 15% | 2,567 |
| 292 | 50% | 584 |
| 292 | 35% | 835 |
| 292 | 20% | 1,460 |
Como escolher uma taxa de resposta defensável
Seu próprio histórico vale mais que qualquer referência publicada, desde que seja o mesmo público, o mesmo canal e uma pesquisa de tamanho parecido. Se você não tiver nada em que se basear, planeje três cenários, com 20%, 30% e 40%, e trate a lista de convites como uma alavanca ajustável durante o trabalho de campo. Lembretes, um prazo maior e uma lista mais ampla são coisas que você pode mudar no meio do caminho. A meta de envios completos, não.
A maioria das tabelas de referência na internet cita uma única média, sem fonte. Não existe uma média única. Veja o que as fontes primárias realmente relatam, para que você possa citar a linha que corresponde à sua situação, e não um número que alguém inventou.
| Contexto | Taxa de resposta | Escala e fonte |
|---|---|---|
| Órgãos federais dos EUA com menos de 1.000 funcionários | 71% | 2024 Federal Employee Viewpoint Survey (OPM) |
| Órgãos federais dos EUA com 1.000 a 9.999 funcionários | 60% | Mesma pesquisa, mesmo ano (OPM) |
| Órgãos federais dos EUA com mais de 75.000 funcionários | 37% | Mesma pesquisa, mesmo ano (OPM) |
| Todos os servidores federais dos EUA | 41% | Mais de 1,6 milhão de convidados, mais de 674.000 responderam, 2024 (OPM) |
| Pesquisas online publicadas, de todos os tipos | Média de 44,1% | Metanálise de 1.071 taxas relatadas (Wu e colegas, 2022) |
| Pesquisas organizacionais publicadas | 68% em 2020, contra 48% em 2005 | 1.014 pesquisas em 17 periódicos (Holtom e colegas, 2022) |
| Pesquisas eleitorais por telefone com o público geral | 6% em 2018, contra 36% em 1997 | Taxa acompanhada pelo próprio Pew Research Center (Kennedy e Hartig, 2019) |
| Modo web em comparação com qualquer outro modo | cerca de 12 pontos a menos | Metanálise de 114 comparações experimentais (Daikeler e colegas, 2020) |
Duas conclusões saem dessa tabela. Primeiro, o tamanho do grupo pesquisado prevê a taxa melhor do que quase qualquer outra coisa que você controla. Uma empresa de 300 pessoas e um órgão de 300.000 pessoas não estão fazendo a mesma pesquisa. Segundo, a afirmação muito repetida de que as taxas de resposta estão despencando em toda parte só é verdadeira em alguns lugares. As pesquisas eleitorais por telefone de fato despencaram. As pesquisas organizacionais publicadas foram na direção oposta, de 48% para 68% em quinze anos.
Mais uma conta de planejamento que vale a pena adotar: a orientação padrão de extensão universitária é acrescentar cerca de 10% à lista de convites para as pessoas que você simplesmente não consegue contatar, e cerca de 30% para as que poderiam responder e não respondem.
O que o nosso próprio acervo de modelos diz sobre o tamanho
Uma taxa de resposta emprestada da pesquisa de outra pessoa raramente se aplica bem à sua, e o tamanho é uma das poucas coisas dessa lista que você controla por completo. Aqui está um número que nós conseguimos produzir e um concorrente não, porque ele vem da contagem do nosso próprio acervo publicado, e não de perguntar a profissionais o que eles acham que fazem.
Na nossa auditoria de 21 de agosto de 2026, todos os 87 modelos de pesquisa tinham 14 perguntas ou menos, e 86 tinham 10 perguntas ou menos. Juntos, eles somavam 799 perguntas. A mediana foi de 9 perguntas, e exatamente um modelo passou de 10. Esses números descrevem aquele retrato datado, não a biblioteca atual.
| Perguntas no modelo | Modelos | Parcela do acervo |
|---|---|---|
| 7 perguntas | 4 | 5% |
| 8 perguntas | 17 | 20% |
| 9 perguntas | 29 | 33% |
| 10 perguntas | 36 | 41% |
| 14 perguntas | 1 | 1% |
Por formato de resposta, 355 das 799 perguntas são escalas de avaliação, 281 são listas de escolha única e 163 pedem que a pessoa digite algo. Esse último grupo é o que mais faz você perder envios completos, então nós o lemos à mão, em vez de confiar no campo armazenado. Das 163, 137 são caixas de comentário de várias linhas. As outras 26 são caixas de uma linha, e a leitura mostrou que 22 são campos curtos de identificação ou classificação: um nome, um endereço de e-mail, uma data, um departamento, um cargo. Apenas 4 são respostas curtas de conteúdo. Assim, a contagem honesta de perguntas realmente abertas é 141, ou cerca de uma pergunta em cada seis, e não uma em cada cinco, como o campo bruto teria indicado.
Como contamos e como conferimos. Analisamos a lista de perguntas armazenada de cada modelo de pesquisa publicado neste site em 21 de agosto de 2026, mantivemos as entradas que tinham texto de pergunta e depois buscamos cada página publicada e comparamos os dois conjuntos, em vez de confiar apenas no nosso próprio banco de dados. Todas as 87 páginas retornaram HTTP 200, enquanto um endereço que sabemos estar desativado retornou 410 na mesma execução, então a verificação de fato discriminava, em vez de dar verde para tudo. 785 das 799 perguntas, ou 98%, aparecem na página publicada. Seis dessas correspondências diferem do banco de dados apenas no caractere de apóstrofo usado, e nós as contamos como correspondências, o que preferimos declarar a arredondar silenciosamente. Oitenta e seis dos 87 modelos foram verificados por completo. O único que não foi é o nosso mais longo, com 14 perguntas, e sua página publicada atualmente não exibe nenhuma pergunta de prévia, então suas perguntas não puderam ser confirmadas de fora.
O tamanho do modelo não diz qual será a taxa de resposta aos convites. Nosso benchmark de respostas a pesquisas, que é um estudo separado, examina o comportamento depois que as pessoas interagem com uma pesquisa; ele não conta todos os convidados. Para planejar os convites, use uma taxa documentada de um projeto comparável ou de um teste piloto e mantenha o denominador consistente.
O uso prático é restrito, mas real. Se você está emprestando uma taxa de resposta para calcular os convites na calculadora, empreste-a de uma pesquisa com mais ou menos o mesmo tamanho da que você está prestes a enviar, para um público parecido, por um canal parecido. Nossos próprios instrumentos publicados ficam entre 7 e 10 perguntas, menos do que a maioria dos rascunhos tem no início.
Mais convites não compram menos viés
Uma taxa de resposta baixa cria dois problemas que parecem um só. O primeiro é que você termina abaixo da meta, então sua margem de erro fica maior do que o planejado. O segundo é que as pessoas que responderam podem ser diferentes das que não responderam, de formas que importam para o seu resultado.
Convidar mais pessoas resolve o primeiro problema. Não resolve o segundo de forma confiável. Groves e Peytcheva reuniram 59 estudos que mediram o viés de não resposta real em comparação com valores conhecidos e encontraram apenas uma relação pequena entre a taxa de resposta de uma pesquisa e o quanto ela se mostrou enviesada. O Pew testou a mesma ideia diretamente: aplicou um mesmo questionário duas vezes, uma com métodos padrão, que obteve taxa de resposta de 9%, e outra com um protocolo de alto esforço, que obteve 22%. Das 40 perguntas que as duas pesquisas tinham em comum, 28 voltaram com diferença de até 2 pontos entre si.
O contraponto honesto. Esse achado não se generaliza para todos os temas, e vale saber onde ele falha. Em pesquisas de satisfação, a relação é real e grande. Um estudo de 717 pesquisas de satisfação de pacientes em 164 hospitais suíços encontrou uma correlação de r = 0,61 entre a pontuação média de satisfação e a taxa de resposta, porque as pessoas encantadas e as furiosas respondem, e o meio-termo ambivalente não. Se você aplica CSAT ou NPS, uma taxa de resposta em alta pode, por si só, mudar sua pontuação, e uma taxa baixa provavelmente favorece você.
Então: corra atrás da taxa de resposta quando estiver medindo o que as pessoas sentem em relação a você. Não a trate como um certificado de validade quando estiver medindo qualquer outra coisa.
Tamanho da amostra em pesquisa quantitativa: do que um capítulo de métodos precisa
Não existe um único tamanho de amostra bom para pesquisa quantitativa, e qualquer fonte que dê um sem perguntar o que você está medindo está chutando. O que faz um capítulo de métodos ser aprovado não é um número grande. É um número declarado, com o nível de confiança, a margem de erro, a proporção suposta e a população escritos ao lado, e uma fórmula identificada pelo nome.
Os orientadores costumam esperar uma de quatro abordagens com nome. Elas em geral concordam entre si, e vale saber qual delas estão pedindo a você.
| Abordagem | O que ela pede | Resultado para N = 1.000 com 95% e 5 pontos | Use quando |
|---|---|---|---|
| Cochran (1977) | z, p, E e, depois, a correção para população finita se a população for pequena | 278 | O padrão. É a fórmula desta página, e aquela da qual as outras derivam. |
| Krejcie e Morgan (1970) | Nada. Você lê a resposta em uma tabela publicada, pelo tamanho da população. | 278 | Você quer uma tabela citável em vez de contas. É Cochran com parâmetros fixos. |
| Yamane (1967), muitas vezes chamada de Slovin | Apenas N e a margem de erro | 286 | Somente quando p é realmente desconhecido e você aceita 95% de confiança como um valor fixo. Veja o alerta abaixo. |
| Análise de poder | Tamanho do efeito, poder, alfa e o teste que você vai aplicar | Depende inteiramente do tamanho do efeito | Você está testando uma hipótese, e não estimando uma porcentagem. Use o G*Power ou o OpenEpi, não esta página. |
Cochran, e por que todo o resto é um atalho dele
A fórmula de Cochran é a que está no topo desta página: n0 = z ao quadrado vezes p vezes (1 menos p), dividido por E ao quadrado, seguida da correção para população finita quando a população é pequena. Os outros métodos com nome fixam alguns desses valores para encurtar as contas. Depois que você sabe disso, a família deixa de parecer quatro regras concorrentes e passa a parecer uma regra com três predefinições.
Yamane e Slovin: use de olhos abertos
A fórmula n = N / (1 + N x e^2) aparece em milhares de teses, geralmente atribuída a Slovin. Ela é rápida: para N = 1.000 e e = 0,05, dá 286.
Vale saber três coisas antes de citá-la.
- É Cochran com os parâmetros soldados. Fazendo o caminho inverso, a fórmula é a fórmula de proporções com p fixo em 0,5, confiança fixa em 95% e z arredondado de 1,96 para 2. Ela não consegue responder a uma pergunta com nenhum outro nível de confiança e não tem nenhum valor para o grau de variação da sua população. Duas populações do mesmo tamanho, mas com dispersões muito diferentes, recebem a mesma resposta, o que não pode estar certo.
- Esse arredondamento é o motivo de os números dela saírem altos. Com z = 2, o teto da fórmula para uma população ilimitada é exatamente 1 dividido por e ao quadrado, ou seja, 400. O teto de Cochran é 384,16, porque 1,96 ao quadrado é 3,8416, e não 4. Todo número de Yamane na tabela acima é alguns por cento maior que o número de Cochran exatamente por esse motivo. Se você já se perguntou por que dois livros-texto dão dois tamanhos de amostra diferentes para o mesmo estudo, geralmente a resposta é essa.
- A atribuição não se sustenta. Um periódico de estatística rastreou a história da fórmula e concluiu que não há nenhuma pessoa chamada Slovin por trás dela, e que a fonte mais antiga rastreável é o livro-texto de Taro Yamane de 1967. O Wolfram MathWorld a descreve como uma fórmula ad hoc, sem rigor matemático. Se seu departamento a exige, use-a e cite Yamane em vez de Slovin. Se você puder escolher, use Cochran, porque ela resiste à pergunta sobre de onde vieram os 95%.
Regras práticas, avaliadas com honestidade
Estas circulam amplamente. Algumas são úteis, outras são folclore, e ajuda saber qual é qual.
- Pelo menos 30 por grupo. Razoável como piso para comparações entre grupos, não como meta. Vem do ponto em que as distribuições amostrais começam a se comportar bem, não de nenhuma exigência de precisão.
- Dez casos por variável em uma regressão. Uma heurística de trabalho, muito usada e muito criticada. Apresente-a como heurística, nunca como regra.
- Dez por cento da população. Esta está simplesmente errada, e a tabela acima mostra por quê. Dez por cento de 100.000 são 10.000 envios, quando 383 dão a mesma precisão.
- Sempre 385. Certo apenas para uma população grande, com 95% e 5 pontos. Cite esse número com essas condições, ou ele não significa nada.
- n pequeno para estudos de usabilidade e de produto. O Nielsen Norman Group publica a versão honesta disso: 40 participantes dão uma medida de sim ou não com margem de 15 pontos para mais ou para menos, com 95% de confiança, e 47 dão uma média com a mesma precisão. Esses números são pequenos porque a precisão afirmada é folgada. Declare a precisão abertamente e as amostras pequenas deixam de ser constrangedoras.
Se o seu estudo compara grupos em vez de estimar uma porcentagem, o tamanho da amostra vira uma questão de poder estatístico, e esta não é a calculadora certa. Você precisa de um tamanho de efeito que esteja disposto a defender, além de alfa e poder. O G*Power e o OpenEpi são as ferramentas gratuitas que a maioria dos orientadores espera, e as duas são gratuitas. Dizer onde uma ferramenta para é mais útil do que fingir que ela faz tudo.
O trabalho qualitativo é dimensionado de outra forma
Entrevistas e grupos focais não são dimensionados com margem de erro, porque não estão estimando uma porcentagem da população. O argumento usual é a saturação: você continua até que novos participantes parem de trazer temas novos e depois informa onde isso aconteceu e como você avaliou. Passar um estudo qualitativo por esta calculadora produz um número que parece preciso e não significa nada.
Se você precisa de resultados por subgrupo, dimensione pelo subgrupo
A maioria das pesquisas precisa reportar por região, cargo, tempo de casa ou linha de produto. É aqui que os planos amostrais falham silenciosamente, e a regra é curta.
Sua margem de erro só se aplica a um grupo se esse grupo tiver esse número de envios completos. Se você quer margem de 5 pontos para mais ou para menos em cada uma de seis regiões, precisa de cerca de 385 envios completos em cada região, e não de 385 no total. É uma pesquisa seis vezes maior do que a que você achava que estava planejando.
Duas saídas honestas:
- Sobreamostre os grupos pequenos. Convide deliberadamente uma parcela maior dos segmentos menores, para que cada um atinja a sua própria meta. Depois, você pondera os resultados de volta.
- Aceite faixas mais largas para os recortes. Mantenha um número geral sólido e publique cada subgrupo com a sua própria margem de erro, maior, ao lado. Geralmente esta é a resposta certa.
A calculadora tem um campo para isso. Defina Subgrupos a reportar separadamente como o número de grupos para os quais você deve um resultado, e ela dimensiona cada grupo corretamente e soma o total.
Defina o escopo antes de ir a campo. Liste os segmentos que você precisa reportar, e não os que seria bom ter. Estime quantos envios completos cada um consegue produzir de forma realista, usando perguntas demográficas para identificá-los. Se um segmento só consegue render 80 envios, não prometa margem de 5 pontos para mais ou para menos para ele. Com 80 envios, a faixa é de 11 pontos para mais ou para menos.
A AAPOR usa um exemplo resolvido que vale a pena memorizar. Uma pesquisa com 1.000 adultos tem uma margem de erro geral de cerca de 3 pontos para mais ou para menos. Se 200 dessas pessoas formam o subgrupo sobre o qual você realmente quer falar, a margem de erro desse subgrupo é de 6,9 pontos para mais ou para menos, mais que o dobro. O número de destaque na capa do relatório não é o que vale para o gráfico da página nove.
As orientações publicadas sobre tamanho mínimo de célula são mais antigas e mais frouxas que as fórmulas, e é justo tratá-las como piso, e não como meta: cerca de 100 envios para um subgrupo que você vai reportar de verdade, e de 20 a 50 para um secundário que você vai mencionar de passagem.
Onde o planejamento do tamanho da amostra erra
O tamanho da amostra controla o erro amostral, o ruído aleatório de não perguntar a todos. Pesquisas reais também carregam erro sistemático, que nenhum tamanho de amostra corrige e que uma amostra grande pode disfarçar.
Tratar uma amostra por conveniência como amostra probabilística
Todas as fórmulas aqui pressupõem que cada pessoa tinha uma chance conhecida e diferente de zero de ser selecionada, e que responder não estava fortemente ligado ao que você está medindo. Um link aberto em redes sociais não atende a nenhuma das duas condições. Você ainda pode calcular uma margem de erro a partir dos envios, ela vai parecer tranquilizadora, e não vai significar o que diz. Deixe explícito que tipo de amostra você de fato extraiu.
Entender um n maior como uma medição melhor
Uma amostra grande torna uma medição ruidosa precisamente ruidosa. Se uma pergunta é ambígua, dupla ou tendenciosa, mais envios não vão salvá-la. Taxas altas de questões puladas e respostas inconsistentes são sinais de que é preciso corrigir o instrumento primeiro. Reescrever uma pergunta ruim muitas vezes faz mais do que triplicar a amostra.
Escolher a precisão sem uma decisão por trás
A precisão só tem uma resposta certa quando você sabe para que ela serve. Um tamanho de amostra é fácil de defender quando você consegue completar esta frase: precisamos distinguir resultados que diferem em X pontos. É impossível de defender quando o único motivo é que um número maior parecia mais seguro. Relacione-o ao seu desenho de pesquisa e ao que você vai fazer com o resultado.
Os números desta página e a qualidade de cada um
Todo número citado acima é uma conta que você pode reproduzir na calculadora ou uma citação que você pode verificar. Grau A significa replicado ou diretamente calculável, B significa um único estudo sólido, C significa muito repetido, mas contestado.
| Afirmação | Número | Grau | Fonte |
|---|---|---|---|
| Com 95% de confiança e sem estimativa prévia, uma população grande precisa de 385 envios completos para uma margem de 5 pontos para mais ou para menos. | 385 | A | Conta direta a partir da fórmula padrão de proporções. NIST, seção 3.3.3; Israel (1992). |
| A fórmula desta página reproduz a tabela de tamanho da amostra publicada por Krejcie e Morgan com diferença de no máximo um envio em todos os 21 tamanhos de população que conferimos. | 21 de 21 com diferença de até 1 | A | Nossa própria conferência com Krejcie e Morgan (1970). Método descrito abaixo da tabela. |
| A taxa de resposta é um preditor fraco do viés de não resposta. Uma metanálise de 59 estudos dedicados ao viés encontrou apenas uma relação pequena entre os dois. | 59 estudos | A | Groves e Peytcheva (2008), Public Opinion Quarterly. |
| O Pew aplicou o mesmo questionário com taxas de resposta de 9% e de 22%. Das 40 perguntas em comum, 28 voltaram com diferença de até 2 pontos. | 28 de 40 com diferença de até 2 pontos | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Mas, em pesquisas de satisfação, a relação é real e grande. Em 717 pesquisas hospitalares, a pontuação média de satisfação teve correlação de r = 0,61 com a taxa de resposta. | r = 0.61 | B | Perneger, Peytremann-Bridevaux e Combescure (2020), BMC Health Services Research. |
| A taxa de resposta das pesquisas com funcionários acompanha quase perfeitamente o tamanho da organização. Em 2024, a pesquisa com servidores federais dos EUA obteve 71% em órgãos com menos de 1.000 pessoas e 37% em órgãos com mais de 75.000. | 71% vs. 37% | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, mais de 1,6 milhão de servidores convidados. |
| A taxa média de resposta em 1.071 pesquisas online publicadas foi de 44,1%. Não existe uma única taxa normal. | 44,1% | A | Metanálise de Wu, Zhao e Fils-Aime (2022), Computers in Human Behavior Reports. |
| Pesquisas pela web têm taxa de resposta cerca de 12 pontos percentuais menor que outros modos, em 114 comparações experimentais. | 12 pontos a menos | A | Metanálise de Daikeler, Bosnjak e Lozar Manfreda (2020), JSSAM. |
| Reduzir a margem de erro pela metade multiplica a amostra necessária por cerca de quatro, porque n varia com 1 dividido por E ao quadrado. Dobrar uma amostra de 1.000 para 2.000 rende cerca de um ponto. | cerca de 4x | A | Propriedade algébrica da fórmula; a AAPOR apresenta explicitamente o caso de 1.000 para 2.000. |
| Supor p = 0,5 em vez de um p conhecido de 0,9 quase triplica a amostra que você deve coletar, de 139 para 385. | 139 vs. 385 | A | Conta direta. Reproduzível na calculadora mudando o resultado esperado. |
| Todos os 87 modelos de pesquisa publicados neste site têm 14 perguntas ou menos, e 86 dos 87 têm 10 ou menos. 785 das suas 799 perguntas foram confirmadas nas páginas publicadas. | 87 modelos, 799 perguntas | A | Nossa própria contagem do acervo de modelos publicado, em 21 de agosto de 2026, conferida com todas as 87 páginas publicadas. Método, auditoria manual e taxa de verificação descritos junto com a tabela. |
| Não há nenhuma pessoa rastreável chamada Slovin por trás da fórmula que leva esse nome. A fonte mais antiga rastreável é Yamane (1967). | nenhum autor rastreável | B | Tejada e Punzalan (2012), The Philippine Statistician; o Wolfram MathWorld a chama de ad hoc. |
“Você sempre precisa de 385 envios.” Só com 95% de confiança, margem de 5 pontos para mais ou para menos, p = 0,5 e uma população grande. Citado sem essas condições, está errado para toda população pequena.
“Pesquise 10% da sua população.” Não há base estatística para isso. Sobreamostra demais as populações grandes e subamostra as pequenas.
“Uma taxa de resposta abaixo de 50% ou 60% invalida uma pesquisa.” Nenhum limite faz isso. A escada de 50%, 60% e 70% é uma regra prática de livro-texto, sem nenhuma derivação empírica por trás, e a metanálise de Groves e Peytcheva a contradiz. A taxa de resposta limita o viés no pior caso. Ela não mede o viés real.
“A taxa média de resposta de pesquisas é X%.” Números verificados dos mesmos poucos anos vão de 6% a 71%, dependendo inteiramente de quem está sendo pesquisado. Qualquer média única esconde isso. Cite, em vez disso, a linha da tabela acima que corresponde à sua situação.
A fórmula de Slovin apresentada como uma derivação. É a fórmula de Cochran com 95% de confiança e p = 0,5 embutidos e z arredondado para 2, e a atribuição a Slovin não tem fonte rastreável.
O modelo de justificativa
A maioria dos argumentos sobre tamanho da amostra falha porque as premissas nunca foram registradas por escrito. O botão Copiar a justificativa da calculadora escreve isso já com os seus próprios números. Se preferir montar você mesmo, estes são os nove itens que um parecerista vai procurar.
- População (N): defina a população e informe a contagem. Por exemplo, todos os clientes ativos nos últimos 90 dias, N = 48.200.
- O que você está medindo: uma proporção (uma porcentagem) ou uma média (uma avaliação média). A fórmula aqui dimensiona proporções, o que cobre a maioria dos KPIs reportados.
- Nível de confiança: o nível que você escolheu e por quê. Convenção e tolerância a risco são motivos aceitáveis, desde que você os declare.
- Margem de erro (E): sua precisão-alvo geral e, separadamente, para cada subgrupo que você prometeu reportar.
- Proporção suposta (p): o valor usado e de onde ele veio. Diga claramente se ele é 0,5 porque não havia nada melhor disponível.
- Correção para população finita: se você a aplicou e o que a motivou, como n0 ultrapassar 10% de N.
- Meta de envios completos (n): o número final de envios completos necessários, depois de todos os ajustes.
- Taxa de resposta esperada: a taxa suposta, o histórico de onde ela veio e o número de convites resultante.
- Como você vai selecionar as pessoas: aleatória simples, estratificada, censo ou conveniência, além de qualquer sobreamostragem de segmentos-chave. Dê o nome com honestidade.
Depois que a pesquisa estiver em campo, continue acompanhando os envios completos por segmento, e não o total. Um número geral saudável pode esconder um segmento que nunca vai atingir sua meta, e esse é um problema que você ainda consegue resolver na primeira semana e não consegue mais na quarta. Ao reportar, apresente cada porcentagem junto com a sua margem de erro e leia como analisar dados de pesquisas antes de tratar uma variação de dois pontos como real.
Planilha de planejamento do tamanho da amostra
Uma página que você pode imprimir, preencher à mão e grampear em um resumo de projeto. Preencha a coluna do meio antes de o trabalho de campo começar, não depois. Nada é enviado a lugar nenhum e não é preciso ter conta.
| Decisão | Seu valor | Orientação |
|---|---|---|
| População (N) | Quem exatamente e quantos são. Escreva a definição, não apenas o número. | |
| O que você está medindo | Uma porcentagem ou uma média. Esta página dimensiona porcentagens. | |
| Nível de confiança | 95%, a menos que você tenha um motivo. Escreva o motivo. | |
| Margem de erro (E) | A diferença que você precisa conseguir distinguir, em pontos. | |
| Proporção suposta (p) | 0,5 se não houver nada melhor. Diga de onde veio um valor diferente. | |
| Correção para população finita | Aplicada ou não, e o que a motivou. | |
| Meta de envios completos (n) | O número final depois de todos os ajustes. | |
| Subgrupos reportados separadamente | Quantos são e quantos envios completos cada um precisa ter por conta própria. | |
| Taxa de resposta esperada | A taxa e o histórico por trás dela. Não um número tirado da internet. | |
| Convites a enviar | Envios completos divididos pela taxa, arredondados para cima. Nunca mais do que N. | |
| Como as pessoas são selecionadas | Aleatória, estratificada, censo ou conveniência. Dê o nome com honestidade. | |
| Ponto de controle do trabalho de campo | A data em que você vai conferir os envios completos por segmento, e não só o total. |
Fórmula: n0 = (z^2 x p x (1 - p)) / E^2, depois n = n0 / (1 + (n0 - 1) / N). Fonte: Cochran (1977); NIST/SEMATECH e-Handbook, seção 3.3.3; Israel (1992). Planilha de https://www.supersurvey.com/Sample-Size
Perguntas frequentes
O que é tamanho da amostra?
Tamanho da amostra é o número de envios completos de uma pesquisa, representado por n. Não é o número de pessoas que você convidou, nem o tamanho da população que você está descrevendo. É a contagem com que você termina o trabalho de campo, e é o número a partir do qual sua margem de erro é calculada: 385 envios completos dão cerca de 5 pontos para mais ou para menos, com 95% de confiança, quando a população é grande. O que é tamanho da amostra explica a diferença entre a população, os convites e n.
De quantos envios preciso para uma pesquisa?
Para a maioria das pesquisas, a resposta prática é 385 envios completos. É o que a fórmula retorna com 95% de confiança, margem de erro de 5 pontos percentuais para mais ou para menos e nenhuma estimativa prévia do resultado. Se a sua população for pequena, você precisa de menos: 278 para uma lista de 1.000 pessoas, 80 para uma lista de 100. Coloque seus próprios números na calculadora para ver o número exato e as contas por trás dele.
Qual tamanho de amostra preciso para 95% de confiança e margem de erro de 5%?
385 envios completos, se a população for grande e você usar p = 0,5. A conta é n0 = 1,96 ao quadrado vezes 0,5 vezes 0,5, dividido por 0,05 ao quadrado, ou seja, 0,9604 dividido por 0,0025, que dá 384,16. Arredonde para cima e você chega a 385. Se a sua população for pequena, aplique a correção para população finita e o número cai.
O que é margem de erro?
A margem de erro é a faixa de mais ou menos em torno do resultado de uma pesquisa que vem de ter amostrado algumas pessoas em vez de todas. Um resultado de 62% com margem de erro de 5 pontos significa que o método produziria, na maioria das vezes, um intervalo que contém o valor verdadeiro, e este intervalo em particular vai de 57% a 67%. Ela descreve apenas o erro amostral aleatório. Não diz nada sobre as pessoas que nunca responderam.
Como calcular a margem de erro?
Tire a raiz quadrada de p vezes (1 menos p) dividido por n e depois multiplique pelo escore z do seu nível de confiança. Com 95% de confiança, 385 envios e p = 0,5, isso dá 1,96 vezes a raiz quadrada de 0,25 dividido por 385, ou seja, 1,96 vezes 0,025482, que dá 0,0499. Portanto, a margem de erro é de 5,0 pontos percentuais para mais ou para menos. A calculadora de margem de erro desta página faz isso para você e mostra as contas.
A margem de erro aumenta com o tamanho da amostra?
Não, ela diminui, e diminui com a raiz quadrada da amostra. Passar de 100 envios para 400 reduz a margem de erro pela metade. Passar de 400 para 1.600 a reduz pela metade de novo. Essa relação de raiz quadrada é o motivo de a precisão ficar cara: cada casa decimal a mais de exatidão custa cerca de quatro vezes mais envios.
Margem de erro é a mesma coisa que erro-padrão?
Não. O erro-padrão é a dispersão subjacente da estimativa. A margem de erro é o erro-padrão multiplicado pelo escore z do nível de confiança escolhido. Com 95% de confiança, a margem de erro é de cerca de 1,96 erro-padrão. O erro-padrão é uma propriedade dos dados. A margem de erro é uma escolha de apresentação aplicada sobre ele.
Qual é um bom tamanho de amostra para pesquisa quantitativa?
Não existe um único número bom, e qualquer fonte que dê um sem perguntar o que você está medindo está chutando. Para um estudo que reporta porcentagens de uma população de menos de cerca de 10.000, a resposta defensável é o que a fórmula retornar com 95% de confiança e uma margem de erro que você consiga justificar. Para uma lista de 1.000, isso dá 278. O número que faz um capítulo de métodos ser aprovado não é um número grande; é um número declarado, com o nível de confiança, a margem de erro, a proporção suposta e a população escritos ao lado. Veja tamanho da amostra em pesquisa quantitativa para as fórmulas com nome que seu orientador pode esperar.
Qual é uma taxa de resposta normal para pesquisas?
Não existe uma única taxa normal, e qualquer página que cite um número só está chutando. Números reais, com fonte, da mesma época vão de 6% (pesquisas eleitorais por telefone do Pew em 2018) a 71% (pequenos órgãos federais dos EUA na Federal Employee Viewpoint Survey de 2024). Uma metanálise de 1.071 pesquisas online publicadas encontrou uma média de 44,1%. O tamanho da organização importa muito: a mesma pesquisa federal obteve 71% em órgãos com menos de 1.000 pessoas e 37% em órgãos com mais de 75.000. Use primeiro o seu próprio histórico e veja a tabela de referências para números que você pode citar.
O tamanho da população importa para o tamanho da amostra?
Quase nada, até que sua amostra se torne uma parcela grande da população. Passar de 100.000 pessoas para 1.000.000 muda a exigência de 383 para 385. Passar de 1.000 pessoas para 100 a muda de 278 para 80. O tamanho da população importa na ponta pequena, que é exatamente onde se aplica a correção para população finita.
Quando p = 0,5 é a escolha certa?
Use p = 0,5 sempre que não tiver uma estimativa prévia defensável. O termo p vezes (1 menos p) é máximo em 0,5, então produz a maior amostra necessária. Isso faz dele a premissa segura: você não corre o risco de ficar com envios de menos. Se você tiver um teste piloto, uma referência ou o número do ano passado, use-o. Supor p = 0,9 em vez de 0,5 reduz a amostra necessária de 385 para 139.
Se eu convidar mais pessoas, elimino o viés de não resposta?
Não. Mais convites trazem mais envios completos, o que reduz a margem de erro. O viés é um problema separado: depende de as pessoas que responderam serem diferentes das que não responderam. Uma metanálise de 59 estudos sobre viés de não resposta encontrou apenas uma relação pequena entre a taxa de resposta e o viés real. O Pew aplicou o mesmo questionário duas vezes, com taxas de resposta de 9% e de 22%, e 28 das 40 perguntas em comum voltaram com diferença de até 2 pontos entre si. Veja viés de resposta e viés de não resposta.
Como lidar com o tamanho da amostra se preciso de resultados por departamento ou região?
Dimensione cada subgrupo separadamente. Sua margem de erro só se aplica a um grupo se esse grupo tiver esse número de envios completos. Se você quer margem de 5 pontos para mais ou para menos em cada região, cada região precisa dos seus próprios 385 envios completos, ou do seu próprio número com correção para população finita. Use perguntas demográficas para identificar os grupos e planeje sobreamostrar os pequenos.
De qual tamanho de amostra preciso para um resultado estatisticamente significativo?
Essa pergunta mistura duas ideias. As fórmulas de tamanho da amostra dimensionam uma estimativa para uma precisão escolhida. Os testes de significância comparam dois números e perguntam se a diferença poderia plausivelmente ser obra do acaso. O tamanho necessário depende de quão pequena é a diferença que você quer conseguir detectar, e não de um limite fixo. Dimensione a pesquisa aqui e depois leia sobre significância estatística antes de testar um resultado contra outro.
Essas fórmulas funcionam para pesquisa qualitativa?
Não. Entrevistas, grupos focais e trabalhos com perguntas abertas não são dimensionados com margem de erro, porque não estão estimando uma porcentagem da população. O tamanho da amostra qualitativa é justificado pela saturação, o ponto em que novos participantes param de trazer temas novos, e é relatado como um julgamento com evidências, e não como uma fórmula. Não passe um estudo qualitativo por esta calculadora.
Referências
- National Institute of Standards and Technology (NIST). (s.d.). Selecting Sample Sizes. In: NIST/SEMATECH e-Handbook of Statistical Methods, seção 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.