
Resposta curta
Amostragem é o processo de selecionar um subconjunto de uma população, chamado amostra, e estudar esse subconjunto para tirar conclusões sobre a população inteira. Pesquisadores fazem amostragem porque medir todo mundo costuma ser lento demais, caro demais ou simplesmente impossível. A população é o grupo que você quer descrever, a amostra é a parte dele que você de fato mede e a base de amostragem é a lista da qual você extrai a amostra.
A amostragem probabilística seleciona pessoas por meio de um mecanismo aleatório, de modo que cada unidade tem uma chance conhecida e diferente de zero de ser escolhida. É isso que permite atribuir um número à sua incerteza.
A amostragem não probabilística seleciona por conveniência, cotas ou julgamento. Muitas vezes é mais rápida, mais barata e, às vezes, a única opção ética, mas não sustenta uma estimativa da população com uma precisão declarada.
Vá direto para os 9 métodos comparados | como escolher um | teste seus conhecimentos | como descrever na metodologia
Pontos principais
- Amostragem significa estudar um subconjunto: você mede uma amostra para conhecer uma população quando medir todo mundo não é viável.
- Acerte primeiro cinco termos: população, base de amostragem, unidade de amostragem, desenho amostral e a distância entre a população que você quer e aquela que você consegue de fato alcançar. A maioria das discussões sobre amostragem é, na verdade, uma discussão sobre um desses termos.
- Só os métodos probabilísticos permitem atribuir um número à sua incerteza. Amostras por conveniência, por cotas, intencionais e em bola de neve podem ser úteis e honestas, mas não sustentam uma estimativa da população com uma precisão declarada.
- Sua base define o seu teto: se um grupo não pode aparecer na lista da qual você extrai a amostra, nenhum método e nenhum volume de envios extras vai colocá-lo nos seus resultados.
- Representatividade é uma cadeia, não um rótulo: base, depois seleção, depois recrutamento, depois resposta, depois análise. Um sorteio aleatório é apenas um elo de cinco.
Definição de amostragem (e os 5 termos que você precisa acertar)
Amostragem é o processo de selecionar um grupo menor (uma amostra) de um grupo maior (uma população) para que você possa conhecer a população sem medir todo mundo. Um estudo com a população inteira costuma ser inviável, por isso pesquisadores fazem amostragem para tornar o trabalho viável e, ainda assim, produzir conclusões úteis.
Os cinco termos abaixo fazem a maior parte do trabalho em qualquer capítulo de metodologia. Erre neles e cada decisão posterior herda o erro.
- População: o grupo completo que você quer descrever, definido com limites e uma janela de tempo. “Todos os estudantes do último ano de enfermagem dos três campi, matriculados em 1º de março” é uma população. “Enfermeiros” não é.
- População-alvo vs. população acessível: quem você quer descrever versus quem seu recrutamento e suas ferramentas conseguem de fato alcançar. Nomear a distância entre as duas é um ponto forte na redação, não uma fraqueza.
- Base de amostragem: a lista ou o mecanismo do qual você extrai a amostra. Um cadastro de estudantes, um cadastro de pacientes, um banco de dados de clientes, uma listagem de domicílios de um povoado, um cadastro eleitoral. Problemas na base geram erro de cobertura, e nenhum método os corrige.
- Unidade de amostragem: o que de fato é selecionado. Uma pessoa, um domicílio, uma clínica, uma turma, um turno, um pedido. Em desenhos por conglomerados e em múltiplos estágios, a unidade do primeiro estágio é um grupo, e esse grupo é chamado de unidade primária de amostragem.
- Desenho amostral: o plano completo, por escrito. Base, método, quantas unidades, como elas são contatadas e o que você vai fazer em relação às pessoas que não respondem. “Desenho amostral” é o que uma banca ou um parecerista está de fato pedindo quando pergunta sobre sua amostragem.
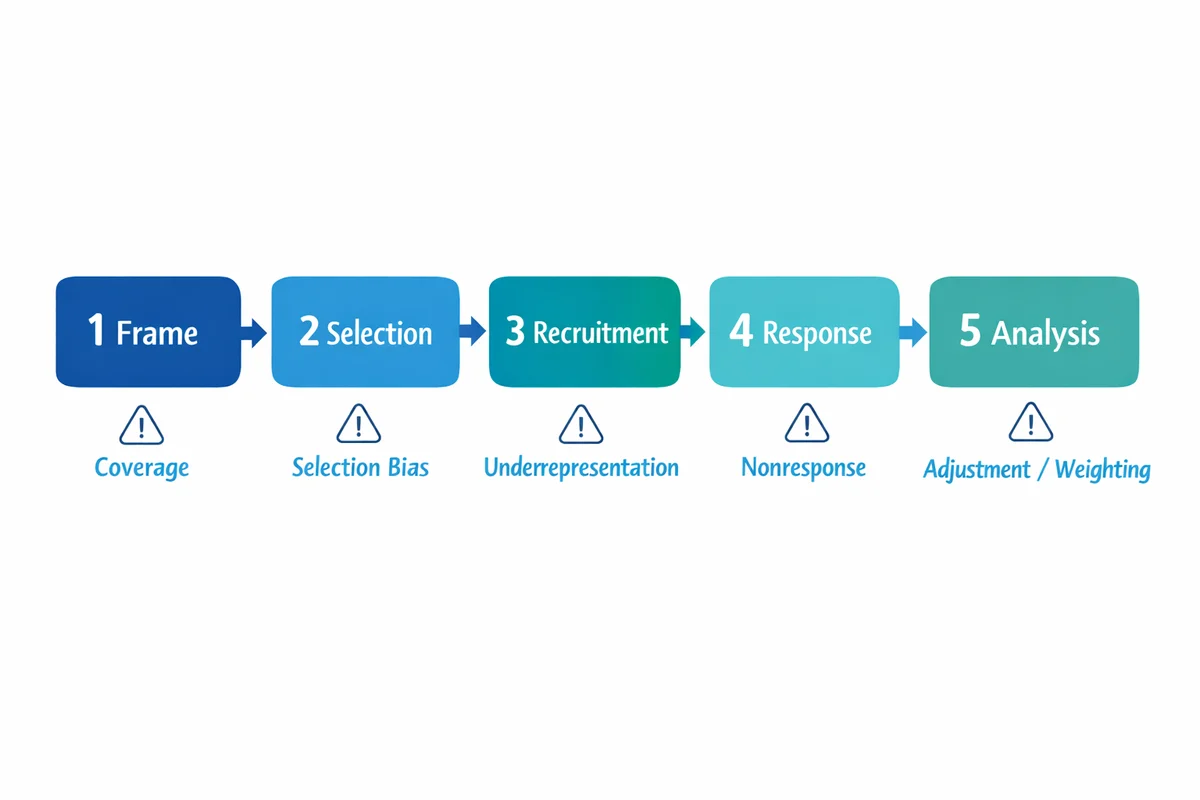
Você pode fazer uma seleção aleatória de manual e, ainda assim, terminar com uma amostra enviesada. Se sua base deixa de fora um segmento, ele nunca pôde ser sorteado. Se um segmento não responde, ele sai depois de ter sido sorteado. Trate a amostragem como uma cadeia: base, depois seleção, depois recrutamento, depois resposta, depois análise.
Para uma definição oficial curta da mesma ideia, veja a nota de treinamento sobre amostragem do U.S. Office of Research Integrity (órgão de integridade em pesquisa dos EUA).1 Se você está inserindo a amostragem em um plano de estudo mais amplo, nosso guia de desenho de pesquisa survey cobre as etapas antes e depois dela.
Por que amostrar, e quando um censo é a melhor resposta
A necessidade de amostragem é prática antes de ser estatística. Quatro motivos aparecem repetidamente.
Custo
Cada respondente a mais custa dinheiro, tempo da equipe ou boa vontade. Uma amostra de 600 bem extraída pode responder à mesma pergunta que uma tentativa mal conduzida com 60.000.
Rapidez
Decisões têm prazo. Uma amostra dá a você uma resposta dentro da janela em que a resposta ainda é útil.
Viabilidade
Algumas populações não podem ser enumeradas de forma alguma: transeuntes em uma feira, pessoas que abandonaram um serviço, comerciantes informais. Outras são, na prática, infinitas, ou medir uma unidade a destrói.
Qualidade
Este motivo surpreende muita gente. Concentrar o esforço em um grupo menor permite ir atrás de quem não respondeu, treinar bem os entrevistadores e checar os dados. Esforço por unidade costuma valer mais do que número de unidades.
Um censo, ao contrário, mede todo mundo. É a melhor escolha quando a população é pequena o bastante para ser alcançada, quando os dados de contato já existem ou quando todo integrante tem o direito de ser consultado. Uma pesquisa com funcionários em uma organização de 200 pessoas é uma questão de censo, não de amostragem. Uma avaliação de turma também. Quando a população é pequena, a amostragem quase não traz ganho e custa a capacidade de reportar resultados por equipe.
Como é, de fato, uma boa amostra
Os livros-texto descrevem uma boa amostra como “representativa”, o que não é um teste operacional. Já estas quatro propriedades são.
- Cobertura: todos na população-alvo poderiam, em princípio, ter sido selecionados.
- Seleção controlada: quem entra na amostra é decidido por uma regra, não por quem se voluntaria ou por quem está mais perto da porta.
- Unidades suficientes no menor grupo que você precisa reportar: um número geral pode parecer saudável enquanto o grupo que realmente importa se apoia em 11 envios.
- Descritível: você consegue registrar exatamente como ela foi extraída, e outra pessoa poderia repetir o processo.
| Se seu objetivo é | Implicação para a amostragem | Armadilha comum |
|---|---|---|
| Estimar uma porcentagem da população | Use um método probabilístico, acompanhe quem responde e reporte a precisão junto com o número. | Tratar uma amostra por conveniência como se ela descrevesse a população. |
| Comparar subgrupos | Planeje o número de envios por subgrupo, geralmente estratificando e sobreamostrando grupos pequenos. | Reportar um subgrupo cujo resultado se apoia em um punhado de pessoas. |
| Explorar experiências e mecanismos | A seleção intencional ou teórica é adequada. Justifique quais perspectivas estão cobertas e quais não estão. | Perseguir um mínimo numérico sem justificativa para ele. |
| Testar uma intervenção | A amostragem determina para quem o resultado pode ser generalizado. A alocação aleatória determina se o efeito é real. | Confundir alocação aleatória com amostragem aleatória. São operações diferentes. |
Para uma explicação em linguagem simples de como as amostras sustentam estimativas da população, a visão geral do U.S. Census Bureau (órgão de censo dos EUA) sobre amostragem e inferência em pesquisas é um bom ponto de partida.2
Sua base de amostragem define o teto
Uma base de amostragem é a lista ou o mecanismo concreto do qual você extrai a amostra. É a parte menos discutida da amostragem e o ponto em que a maioria dos estudos reais dá errado silenciosamente, porque a base decide quem sequer podia ser selecionado.
Bases são objetos comuns. Um cadastro de estudantes, um cadastro de pacientes, uma lista de funcionários do RH, um banco de dados de clientes. Uma lista de povoados com contagem de domicílios, um cadastro eleitoral, uma sequência de pedidos, uma lista de clínicas de um distrito. Note que algumas bases listam pessoas e outras listam lugares. Essa distinção decide quais métodos estão disponíveis para você.
| Problema | Como aparece | O que faz com seus resultados |
|---|---|---|
| Subcobertura | Pessoas da população estão ausentes da lista: funcionários sem e-mail corporativo, clientes que compraram na loja física, domicílios sem endereço registrado. | Segmentos inteiros têm chance zero de seleção. Envios extras não resolvem, porque as pessoas ausentes nunca puderam ser selecionadas. |
| Sobrecobertura | A lista contém unidades fora da sua população: ex-alunos, contas encerradas, pessoas que se mudaram. | Você desperdiça esforço e, se não as excluir na triagem, mede a população errada. |
| Duplicação | A mesma pessoa aparece mais de uma vez: dois endereços de e-mail, dois números de conta. | Essas pessoas têm uma chance de seleção maior que a de todos os outros, o que quebra silenciosamente o pressuposto de chances iguais. |
| Desatualização | A lista estava correta quando foi montada e não está mais. | Contatos com falha na entrega parecem recusas, então sua taxa de resposta e seu diagnóstico de viés saem errados. |
Audite a base antes de sortear, não depois. Conte as linhas. Compare essa contagem com qualquer total independente que você encontrar, como o quadro de funcionários do RH ou um número de matrículas. Procure o segmento que você teria mais vergonha de ter deixado de fora e confira se ele está presente. Remova duplicatas. Registre o que a base exclui, porque essa frase vai para suas limitações de qualquer forma.
Amostragem por conveniência, por cotas, intencional e em bola de neve não precisam de lista nenhuma. A amostragem por conglomerados e em múltiplos estágios precisa apenas de uma lista de grupos (escolas, clínicas, enfermarias, povoados), não de uma lista de pessoas. A amostragem aleatória simples, a sistemática e a estratificada precisam de uma lista completa de indivíduos antes de você começar. Se você não tem uma lista e não consegue montar uma, esse único fato elimina três dos nove métodos desta página. Costuma ser a primeira coisa a resolver.
Os 9 métodos de amostragem comparados
Os métodos de amostragem se dividem em duas famílias. A amostragem probabilística usa um mecanismo aleatório, de modo que cada unidade da base tem uma chance de seleção conhecida e diferente de zero. A amostragem não probabilística não usa, por isso as probabilidades de seleção são desconhecidas. Todo o resto decorre dessa única distinção.
A segunda coluna é a que a maioria dos guias deixa de fora, por isso aqui ela vem primeiro. Só um desenho probabilístico sustenta uma margem de erro, um intervalo de confiança ou a frase “mais ou menos 5 pontos”. Se um método diz não ali, você ainda pode aprender muito com ele. Só não pode publicar um número de precisão junto com o resultado. A precisão em si é outra conversa, tratada no nosso guia de tamanho da amostra.
| Método | Sustenta uma margem de erro? | Como funciona | Escolha certa quando | Quanto custa e qual viés favorece |
|---|---|---|---|---|
| Amostragem aleatória simples Probabilística Exige lista completa |
Sim | Cada unidade da lista tem a mesma chance. Você sorteia o número necessário de forma aleatória. | Você tem uma única lista limpa e sem duplicatas, e nenhum subgrupo que você seja obrigado a reportar separadamente. | CustoVocê precisa ter a lista completa, e grupos pequenos podem sair pequenos demais para reportar.ViésMuito pouco na seleção. Todo o risco restante passa para quem de fato responde. |
| Amostragem sistemática Probabilística Exige lista completa |
Sim, se a ordem da lista não tiver relação com o resultado | Ordene a lista, escolha um ponto de partida aleatório e pegue cada k-ésimo registro. | A lista é longa ou chega como um fluxo, e uma equipe de campo precisa de uma regra simples para seguir. | CustoQuase nenhum, desde que a ordenação não tenha nada a ver com o que você está medindo.ViésPeriodicidade. Se a lista se repete em um ciclo que coincide com o seu intervalo, você continua caindo no mesmo tipo de unidade. |
| Amostragem estratificada Probabilística Exige lista completa |
Sim, e geralmente mais estreita que a aleatória simples | Divida a lista em grupos (estratos) relevantes e depois faça a amostragem dentro de cada grupo. | Você precisa reportar por região, faculdade, departamento ou faixa etária, ou espera que a resposta varie muito entre os grupos. | CustoA variável de agrupamento precisa estar na lista antes do sorteio, e taxas desiguais precisam ser ponderadas na análise.ViésBaixo. O risco real é escolher estratos que não têm nada a ver com o resultado, o que acrescenta trabalho e não traz precisão. |
| Amostragem por conglomerados Probabilística Exige lista de grupos |
Sim, ampliada pelo efeito do desenho | Selecione aleatoriamente grupos inteiros (escolas, clínicas, enfermarias, povoados) e depois aplique a pesquisa a todos dentro dos grupos selecionados. | Você não consegue listar indivíduos, mas consegue listar os lugares onde eles estão, e o custo de deslocamento ou de montagem domina o orçamento. | CustoPrecisão. Pessoas dentro de um mesmo grupo se parecem umas com as outras, então cada envio extra traz menos informação nova.ViésBaixo se os grupos forem escolhidos ao acaso, mas um número pequeno de grupos torna o resultado instável e difícil de defender. |
| Amostragem em múltiplos estágios Probabilística Exige lista de grupos |
Sim, com pesos e um efeito do desenho | Faça primeiro a amostragem de grupos e depois a de unidades dentro dos grupos selecionados, em dois ou mais estágios. | Estudos distritais ou nacionais em que não existe uma lista única de pessoas, mas existem unidades administrativas. | CustoComplexidade. As probabilidades de seleção variam entre as unidades, então a análise precisa de pesos e de alguém que saiba aplicá-los.ViésBaixo em princípio. Na prática, cada estágio é uma nova oportunidade para a equipe de campo se desviar do plano. |
| Amostragem por conveniência Não probabilística Não exige lista |
Não | Você pega quem for mais fácil de alcançar: um pop-up em um site, uma turma para a qual você dá aula, pessoas passando por uma banca. Também chamada de amostragem por disponibilidade. | Você está explorando, fazendo um teste piloto de um questionário, ou precisa de uma direção nesta semana, e não de um número defensável no próximo trimestre. | CustoA afirmação. Você abre mão da capacidade de dizer qualquer coisa sobre a população.ViésAutosseleção. Ela super-representa os alcançáveis, os disponíveis e os já engajados. |
| Amostragem por cotas Não probabilística Não exige lista |
Não. Parece equilibrada sem ser aleatória | Defina metas para os grupos, por exemplo 50 mulheres e 50 homens, ou 40 da zona rural e 60 da zona urbana, e recrute até que todas as metas sejam preenchidas. | Você precisa de uma amostra que pelo menos corresponda à população em características visíveis, rapidamente, sem uma lista da qual sortear. | CustoO controle de quem preenche cada cota. Os recrutadores ainda escolhem, e escolhem os mais abordáveis.ViésViés de seleção dentro da cota. Corresponder em idade e gênero não torna as pessoas típicas em atitudes. |
| Amostragem intencional Não probabilística Não exige lista |
Não, e nem tenta | Você seleciona deliberadamente casos que atendem a critérios declarados: especialistas, casos extremos, casos típicos, casos críticos. Também chamada de amostragem por julgamento. | Trabalho qualitativo, entrevistas com especialistas, estudos de caso e qualquer questão em que a profundidade importe mais do que a contagem. | CustoNenhum, desde que você deixe claro que nunca se tratou de contar.ViésO próprio modelo do pesquisador sobre quem conta como relevante. |
| Amostragem em bola de neve Não probabilística Não exige lista |
Não | Recrute alguns participantes e depois peça a cada um deles que indique outras pessoas que atendam aos critérios. | O grupo é oculto, estigmatizado, raro ou não registrado: trabalhadores migrantes, pessoas que deixaram um serviço, comerciantes informais, pessoas com uma doença rara. | CustoTempo e controle sobre a forma da amostra. Você herda a rede social de quem quer que tenha sido o ponto de partida.ViésHomofilia. As pessoas indicam pessoas parecidas com elas, então um canto da população acaba sobreamostrado. |
Como ler a tabela: os cinco primeiros métodos são desenhos probabilísticos e os quatro últimos não são. É essa única divisão, e não o nome de cada método, que decide se um número de precisão é honesto.
Métodos de amostragem probabilística, um por um
Amostragem probabilística significa que cada unidade da base tem uma chance conhecida e diferente de zero de ser selecionada, e que um mecanismo aleatório faz a seleção. Esse é todo o fundamento para dizer qualquer coisa numérica sobre a população. Cinco desenhos cobrem quase todos os estudos reais. Revisões de pesquisa clínica e em saúde tratam da mesma família com rótulos um pouco diferentes, e vale saber o porquê antes de encontrar os dois: cada uma das duas citadas aqui inclui a amostragem em múltiplos estágios dentro da amostragem por conglomerados, em vez de listá-la separadamente.34
Amostragem aleatória simples
A amostragem aleatória simples dá a cada unidade da lista exatamente a mesma chance de seleção. Você numera a lista, gera números aleatórios e pega as unidades em que eles caem.
Exemplo resolvido. O cadastro de uma universidade tem 12.000 estudantes matriculados e você precisa de 400 envios. Numere o cadastro de 1 a 12.000, gere 400 números aleatórios únicos nesse intervalo com uma planilha ou um software de estatística e convide esses estudantes. Se você espera uma taxa de resposta de 40%, sorteie e convide 1.000, para que 400 envios completos sejam realistas.
Onde falha. Com 400 envios distribuídos em um cadastro de 12.000 estudantes, um departamento de 300 estudantes contribui com cerca de 10 pessoas. Isso não basta para reportar. Se algum subgrupo precisa aparecer nos seus resultados, a amostragem aleatória simples é a ferramenta errada e a amostragem estratificada é a solução.
Registre sua aleatorização. O software usado, a semente, se houve uma, e a data. Essa única frase é o que torna o sorteio reproduzível, e os pareceristas pedem isso, sim.
Amostragem sistemática
A amostragem sistemática pega cada k-ésima unidade de uma lista ordenada a partir de um início aleatório. Divida o tamanho da lista pelo número de que você precisa para obter o intervalo k, escolha um número aleatório entre 1 e k como ponto de partida e conte a partir dali.
Exemplo resolvido. Um hospital distrital registra 9.000 atendimentos ambulatoriais em um trimestre e quer fazer 600 entrevistas de saída. O intervalo é 9.000 dividido por 600, então k é igual a 15. Escolha um início aleatório entre 1 e 15, digamos 7, e entreviste os atendimentos 7, 22, 37, 52 e assim por diante. Uma equipe de campo consegue seguir essa regra sem um notebook, e esse é o verdadeiro motivo de o método sobreviver.
Onde falha. Periodicidade. Se a lista tem um ciclo repetitivo que coincide com k, você amostra a mesma posição toda vez. Uma lista de atendimentos ordenada por dia de clínica, com ciclo de 7 dias e intervalo de 7, daria a você um único dia da semana e nada mais. Verifique a ordenação antes de fixar k e embaralhe a lista se a ordem tiver relação com o que você está medindo.
Amostragem estratificada
A amostragem estratificada divide a população em grupos sem sobreposição, chamados estratos, e depois sorteia uma amostra aleatória dentro de cada estrato. É a melhoria mais útil disponível para a maioria dos estudos, porque garante que cada grupo sobre o qual você precisa reportar de fato apareça.
Exemplo resolvido, com as contas. Uma organização tem 4.200 funcionários em seis províncias e precisa de 600 envios.
- Alocação proporcional. Uma província com 1.400 funcionários tem 1.400 divididos por 4.200, ou seja, um terço da força de trabalho, então recebe um terço de 600, ou seja, 200 envios. Uma província com 210 funcionários recebe 210 divididos por 4.200 vezes 600, ou seja, 30 envios. Cada província fica representada na proporção do seu tamanho, e não é preciso ponderar na análise.
- Alocação desproporcional, também chamada de sobreamostragem. Trinta envios são poucos demais para reportar separadamente sobre aquela província pequena. Então você deliberadamente pega 80 dela e reduz a maior província para compensar. Agora as probabilidades de seleção variam entre as províncias, então você precisa ponderar os dados de volta às proporções reais antes de citar qualquer número da organização como um todo. Pular essa etapa é o erro mais comum na amostragem estratificada.
Como escolher os estratos. Escolha variáveis relacionadas ao resultado ou a quem tende a responder e que já existam na sua base. Região, unidade, cargo, faixa de tempo de casa, curso, tipo de plano e faixa etária são os candidatos usuais. Estratos que não têm nada a ver com o resultado aumentam a administração e não trazem precisão. Se a variável de agrupamento não estiver na sua base, talvez você precise coletá-la no próprio questionário. Nosso guia de perguntas demográficas em pesquisas mostra como pedir essas variáveis sem perder respondentes.
Amostragem por conglomerados
A amostragem por conglomerados seleciona aleatoriamente grupos inteiros que existem naturalmente e depois aplica a pesquisa a todos dentro dos grupos selecionados. Você precisa de uma lista dos grupos, não de uma lista das pessoas, e é por isso que ela existe.
Exemplo resolvido. Um distrito tem 180 escolas de ensino fundamental e nenhuma lista central de alunos. Você seleciona aleatoriamente 24 escolas e aplica a pesquisa a todos os alunos do 8º ano de cada uma. Você fez 24 visitas a escolas em vez de 180 e nunca precisou de um cadastro de alunos para começar.
O preço que você paga. Alunos da mesma escola se parecem mais entre si do que com alunos de todo o distrito. Então cada aluno a mais em uma escola já escolhida acrescenta menos informação nova do que um aluno independente acrescentaria. Seu número efetivo de envios é menor que o seu número real de envios. Essa inflação é o efeito do desenho, e ela precisa entrar no plano, não ser descoberta na análise.
Onde falha. Poucos conglomerados. Seis escolas escolhidas ao acaso podem ser muito diferentes umas das outras, e o resultado oscila conforme as seis que você por acaso sorteou. Mais conglomerados com menos pessoas em cada um é quase sempre melhor do que o contrário.
Amostragem em múltiplos estágios
A amostragem em múltiplos estágios seleciona em dois ou mais estágios: primeiro os grupos, depois as unidades dentro dos grupos selecionados e, às vezes, um terceiro estágio dentro dessas unidades. Quase toda pesquisa domiciliar nacional do mundo é construída assim.
Exemplo resolvido. Selecione 120 setores a partir da lista nacional de setores. Dentro de cada setor selecionado, uma equipe de campo lista os domicílios no local e depois seleciona 20 deles ao acaso. Dentro de cada domicílio selecionado, um adulto é escolhido ao acaso, em vez de deixar a escolha para quem abrir a porta. São três estágios, e o último importa: deixar o domicílio decidir quem responde reintroduz exatamente o viés de seleção que o desenho foi construído para evitar.
O preço que você paga. Pessoas diferentes acabam com probabilidades de seleção diferentes, então a análise precisa de pesos, e o cálculo da variância tem de levar em conta o agrupamento em cada estágio. É um desenho de verdade, que exige alguém capaz de fazer uma análise ponderada. Se ninguém no projeto souber fazer isso, escolha um desenho mais simples em vez de um desenho em múltiplos estágios sem ponderação.
Aprofundamento: probabilidade proporcional ao tamanho, e por que conglomerados grandes são escolhidos com mais frequência
No exemplo das escolas, toda escola tinha a mesma chance de seleção, tivesse 60 alunos ou 900. Isso dá a um aluno de uma escola pequena uma chance muito maior de entrar na amostra do que a um aluno de uma escola grande. A análise então precisa corrigir isso.
A seleção com probabilidade proporcional ao tamanho corrige isso já na etapa do desenho. A chance de seleção de cada conglomerado é definida em proporção ao número de unidades que ele contém. Uma escola de 900 alunos passa a ter quinze vezes mais chance de ser sorteada do que uma escola de 60 alunos. Depois, você pega o mesmo número de alunos de cada escola selecionada. Os dois estágios se compensam, e todo aluno do distrito acaba com aproximadamente a mesma chance geral de seleção. É a abordagem padrão em pesquisas nacionais e exige uma medida de tamanho para cada conglomerado da base antes do sorteio.
Amostragem estratificada vs. por conglomerados: a diferença em uma linha
Essas duas são confundidas o tempo todo, porque ambas começam dividindo a população em grupos. A diferença está no que você faz depois.
| Aspecto | Amostragem estratificada | Amostragem por conglomerados |
|---|---|---|
| Quais grupos você usa | Todos os grupos são amostrados. | Alguns grupos são selecionados; os demais não são usados. |
| Quem você amostra dentro de um grupo | Um subconjunto aleatório do grupo. | Todos do grupo, ou um novo subconjunto aleatório dele, na versão em múltiplos estágios. |
| Os grupos devem ser | Homogêneos internamente e diferentes entre si. Região, cargo, curso. | Variados internamente, cada um uma pequena cópia da população. Escolas, clínicas, enfermarias. |
| Por que você a escolheria | Precisão e representação garantida dos subgrupos. | Custo e acesso quando não existe lista de indivíduos. |
| Efeito na precisão | Geralmente a melhora em comparação com a aleatória simples, com o mesmo número de envios. | Reduz a precisão. Inclua o efeito do desenho no planejamento. |
| O que você precisa antes de começar | Uma lista completa de indivíduos, já com a variável de agrupamento. | Apenas uma lista de grupos. |
Estratificada: todos os grupos, algumas das pessoas. Por conglomerados: alguns dos grupos, todas as pessoas. Estratificar é questão de precisão; conglomerar, de acesso.
Métodos de amostragem não probabilística, um por um
Amostragem não probabilística significa que as probabilidades de seleção são desconhecidas, porque nenhum mecanismo aleatório decidiu quem foi escolhido. É a escolha certa em quatro situações. Você não consegue montar uma base utilizável. O grupo é oculto. A rapidez importa mais que a precisão. Ou a pergunta é sobre significado, e não sobre tamanho.
Esses métodos não são de segunda categoria. Eles respondem a uma pergunta diferente. O erro nunca é usá-los; é usá-los e depois escrever uma frase que só uma amostra probabilística poderia sustentar.
Amostragem por conveniência
A amostragem por conveniência, também chamada de amostragem por disponibilidade, recruta quem for mais fácil de alcançar. Um pop-up em um site, um link em uma newsletter, os alunos da sua própria turma, pessoas passando por uma banca em uma feira.
Exemplo. Uma loja coloca um link de feedback no recibo. Todos que respondem compraram algo, estavam com um celular, tinham tempo e tinham um motivo para se dar ao trabalho. Cada um desses filtros remove uma parte diferente da base de clientes.
Uso honesto. Fazer o teste piloto de um questionário, gerar hipóteses, descobrir que linguagem os clientes usam, verificar se uma pergunta é compreendida. Todos são usos excelentes. Nenhum deles exige uma estimativa da população.
Amostragem por cotas
A amostragem por cotas define metas de recrutamento para grupos nomeados e as preenche. Quarenta da zona rural e sessenta da zona urbana. Cinquenta mulheres e cinquenta homens. Vinte em cada uma de cinco faixas etárias.
Exemplo. Uma equipe de pesquisa de mercado precisa de 500 envios que correspondam à distribuição nacional por idade, gênero e região, e não tem uma lista da população. A equipe recruta até que cada célula esteja cheia.
Por que ainda não é amostragem probabilística. As cotas controlam a forma da amostra, não a seleção das pessoas que estão nela. Quem recruta ainda escolhe, e pessoas fáceis de abordar são sistematicamente diferentes das que não são. Uma amostra pode corresponder perfeitamente à população em idade e gênero e ainda assim errar feio sobre atitudes, porque idade e gênero nunca foram as variáveis que causavam o estrago.
Amostragem intencional
A amostragem intencional, também chamada de amostragem por julgamento, seleciona deliberadamente casos que atendem a critérios declarados. As variantes comuns são a seleção de casos típicos, casos extremos, casos críticos, máxima variação e especialistas.
Exemplo. Um estudo sobre como um novo sistema de pagamento é usado seleciona oito pessoas. Duas que o usam diariamente, duas que desistiram dele, duas que nunca o adotaram e duas pessoas da equipe de suporte que lidam com reclamações. Essa distribuição é escolhida de propósito, e o raciocínio é o método.
Uso honesto. A maior parte da pesquisa qualitativa. O critério aqui não é a aleatoriedade. É se você consegue dizer por que esses casos e não outros, e se a variedade de pontos de vista é ampla o bastante para sustentar suas afirmações.
Amostragem em bola de neve
A amostragem em bola de neve recruta um pequeno número de participantes que depois indicam outras pessoas que atendem aos critérios, e essas indicam outras.
Exemplo. Um estudo sobre comerciantes informais que atuam na fronteira começa com quatro participantes identificados por meio de uma associação local, e cada um apresenta mais dois. Não existe cadastro de comerciantes informais, então nenhum método baseado em base de amostragem está disponível.
O que ela faz com sua amostra. Homofilia. As pessoas indicam pessoas parecidas com elas. A amostra se desloca para uma única rede social e se afasta dos membros isolados da população, que muitas vezes são justamente quem a pesquisa mais precisa ouvir. Começar por várias sementes sem conexão entre si, em vez de uma só, reduz o desvio, mas não o elimina.
Como tornar defensável uma amostra não probabilística
A maioria dos guias para em “não é possível generalizar” e deixa o leitor desamparado, porque a maioria dos leitores está conduzindo exatamente esse tipo de estudo. Aqui está a parte que costuma faltar.
- Descreva o recrutamento, não só o nome do método. Onde o link foi publicado, em quais datas, quem o viu, se houve incentivo e quantas pessoas foram abordadas em comparação com quantas responderam. É isso que permite ao leitor avaliar a amostra em vez de adivinhar.
- Compare a amostra obtida com uma referência conhecida e publique a comparação. Se sua organização tem 60% de equipe de campo e seus respondentes têm 25% de equipe de campo, diga isso em uma tabela. Uma distorção declarada é um achado. Uma distorção escondida é um defeito.
- Saiba o que a ponderação pode e não pode fazer. Ajustar seus dados para que os dados demográficos correspondam aos da população pode corrigir um desequilíbrio visível. Não corrige o efeito de pessoas que diferem dos respondentes em algo que você não mediu, e nunca transforma uma amostra não probabilística em uma que sustente uma afirmação de precisão.
- Mude a frase, não a estatística. Em vez de “38% dos clientes estão insatisfeitos, com margem de 4 pontos para mais ou para menos”, escreva “38% dos 620 clientes que responderam relataram insatisfação. Os respondentes foram recrutados por um aviso no aplicativo durante duas semanas e não são uma amostra aleatória dos clientes.” A segunda frase é mais curta, mais útil e não pode ser atacada.
O trabalho qualitativo tem seu próprio vocabulário para isso. Um protocolo geralmente pede uma justificativa em vez de uma meta numérica. Ela deve cobrir o número pretendido e a variedade de pontos de vista, uma distinção que o guia da University of Bath expõe de forma concisa.5
Associe o método à situação
Seis situações, seis métodos. Decida antes de abrir a resposta. Esta é a forma mais rápida de descobrir se a tabela acima foi realmente assimilada.
1. Você tem um cadastro completo de 4.200 funcionários e precisa publicar resultados para cada uma de seis províncias.
Amostragem estratificada. A lista completa existe, então a amostragem probabilística está disponível para você, e a obrigação de reportar por província é exatamente o motivo de existir a estratificação. A amostragem aleatória simples deixaria a menor província com envios insuficientes para reportar.
2. Você está estudando pessoas que deixaram um serviço há seis meses. Não há lista, e quem saiu mais irritado é mais difícil de encontrar.
Amostragem em bola de neve. Não existe base e a população é difícil de alcançar, o que descarta todos os métodos probabilísticos. Comece por várias sementes sem conexão entre si, em vez de uma só, e declare nas limitações que as cadeias de indicação enviesam a amostra em direção às pessoas mais conectadas.
3. Um hospital quer dados sobre a experiência dos pacientes a partir de um fluxo de 9.000 atendimentos por trimestre, coletados por funcionários sem computador no balcão.
Amostragem sistemática. A população chega como um fluxo ordenado, então uma regra de intervalo é ao mesmo tempo um método probabilístico e algo que um balcão movimentado consegue de fato executar. Verifique antes se a ordem dos atendimentos não segue um ciclo semanal que coincida com o seu intervalo.
4. Você precisa entender por que uma nova ferramenta está sendo abandonada e tem três semanas e nenhum orçamento.
Amostragem intencional. A pergunta é sobre mecanismo, não sobre magnitude. Selecione deliberadamente ao longo de toda a variedade: usuários intensivos, quem abandonou, quem nunca adotou, equipe de suporte. Não reporte porcentagens a partir dela.
5. Um distrito tem 180 escolas, nenhum cadastro de alunos e uma verba de deslocamento que cobre cerca de 25 visitas.
Amostragem por conglomerados. Existe uma lista de escolas, embora não exista uma lista de alunos, e o custo de deslocamento é a restrição decisiva. Amplie o intervalo que você reporta para levar em conta o efeito do desenho, e prefira mais escolas com menos alunos em cada uma, e não o contrário.
6. Você precisa obter 500 envios em cinco dias que correspondam ao perfil nacional de idade e região, e não há lista da população.
Amostragem por cotas. É a forma mais rápida de obter uma amostra que pelo menos corresponda à população em características visíveis. Ainda assim não é uma amostra probabilística, então reporte a composição e deixe de fora a afirmação de precisão.
Como escolher um método de amostragem
A maioria dos estudos não fracassa porque alguém escolheu a técnica errada pelo nome. Fracassa porque a técnica não combinava com a base, com a decisão ou com o que a equipe de campo conseguia fazer de forma realista. Três perguntas resolvem a questão quase sempre.
Qual método se encaixa no seu estudo?
Responda a três perguntas. A recomendação aparece abaixo e as linhas correspondentes ficam destacadas na tabela comparativa.
Comece pela afirmação que você precisa fazer
Escreva a frase que você quer publicar antes de escolher qualquer coisa. “Sessenta e dois por cento dos nossos clientes nos recomendariam” e “clientes que vão embora descrevem três problemas recorrentes” são frases diferentes, que exigem desenhos diferentes. Se ninguém vai tratar o resultado como um número da população, você tem muito mais liberdade do que imagina.
Audite a base antes de se comprometer
Você consegue de fato listar a população, ou algo próximo dela? Se não, consegue listar os grupos aos quais ela pertence? Responder a essa única pergunta elimina na hora a maioria dos nove métodos, e é por isso que ela vem em segundo lugar, e não por último.
Nomeie os subgrupos que você é obrigado a reportar
Se um resultado precisa aparecer para cada região, unidade ou cargo, isso conduz o desenho por meio de estratos ou cotas. Também determina quantos envios você precisa em cada grupo. Decidir isso depois do trabalho de campo não tem conserto.
Confronte o desenho com a realidade do campo
Tempo, orçamento, possibilidade de contato, acesso linguístico, alfabetização, conectividade e política de incentivos decidem o que é executável. Um desenho que a equipe de campo não consegue seguir vira amostragem por conveniência com um nome formal, o que é pior do que escolher a amostragem por conveniência com honestidade. Um planejamento de recrutamento inclusivo reduz a sub-representação sistemática.6 Depois de selecionar a amostra, use um criador de pesquisas online para preparar o questionário e enviá-lo às pessoas escolhidas pelo seu plano de amostragem. Compartilhar um link público sem restrição muda quem pode responder; isso não preserva uma amostra aleatória.
Onde as amostras realmente falham: cobertura, seleção e não resposta
A seleção é a parte com que todo mundo se preocupa e a que menos dá errado. O estrago geralmente acontece antes da seleção, na base, ou depois dela, em quem se dá ao trabalho de responder. Ambos produzem planilhas aparentemente limpas e conclusões erradas.
| Erro | Como aparece | Como reduzi-lo |
|---|---|---|
| Erro de cobertura, um problema da base | Algumas pessoas simplesmente não podem ser selecionadas: sem e-mail corporativo, uma lista de funcionários desatualizada, clientes que só compram na loja física, domicílios sem conectividade. | Melhore ou combine bases. Acrescente modos: papel, presencial, telefone, SMS. Documente exatamente quem fica excluído. |
| Viés de seleção, um problema de procedimento | A regra aleatória é ignorada na prática. Quem chega primeiro é atendido primeiro. Um gestor indica quem participa. | Automatize o sorteio. Separe quem seleciona de quem recruta. Audite cada exceção. |
| Viés de não resposta, um problema de resultado | As pessoas selecionadas não respondem, e as que não respondem diferem das que respondem justamente naquilo que você está medindo. | Melhore a estratégia de contato e a experiência do questionário e depois compare os respondentes com uma referência conhecida. Veja viés de resposta. |
| Erro de medição | Uma amostra impecável ainda assim gera bobagens porque as perguntas são tendenciosas, vagas ou duplas. | Teste o instrumento antes de ir a campo. Nosso guia sobre como escrever perguntas de pesquisa cobre os defeitos mais comuns. |
A falha de amostragem mais famosa teve 2,4 milhões de respondentes
Em 1936, a Literary Digest previu que Alf Landon ficaria com cerca de 55% dos votos. Franklin Roosevelt venceu com cerca de 61%.7 A revista havia enviado 10 milhões de cédulas pelo correio e recebido cerca de 2,4 milhões de volta, uma taxa de resposta de 24% da qual nenhuma pesquisa eleitoral nacional de hoje chega perto.8 A pesquisa colocou Roosevelt vinte pontos abaixo da sua votação real, com uma amostra de dois milhões e meio de pessoas.
O número que deveria estar em toda página sobre amostragem. Uma reanálise posterior calculou a margem de erro amostral das estimativas estaduais da Digest: ela variou de 0,18 a 2,3 pontos percentuais, com mediana de 0,6.8 Um número de precisão de mais ou menos meio ponto, em cima de um erro de vinte pontos. Nada demonstra com mais clareza que uma margem de erro mede apenas uma das várias maneiras pelas quais uma pesquisa pode errar.
E a explicação padrão está só meio certa. Todo mundo aprende que a Digest amostrou donos de carro e assinantes de telefone, que eram ricos e republicanos. Um teste empírico dessa afirmação usou uma pesquisa do Gallup de maio de 1937. Pessoas que tinham carro e telefone ainda assim votaram majoritariamente em Roosevelt, por 55 a 45. Entre todos que disseram ter recebido uma cédula da Digest, Roosevelt liderava por 55 a 44. A base pendia para os republicanos, mas nem de longe o bastante para produzir uma vitória esmagadora de Landon.7
A metade que falta é a não resposta. Entre as pessoas que disseram ter devolvido a cédula, Landon liderava por 51 a 48. Entre as que não a devolveram, Roosevelt liderava por 69 a 30. A decomposição aproximada atribui cerca de onze pontos do erro à base e cerca de sete à não resposta diferencial.7 Ponderar as respostas por uma pergunta que a Digest já tinha feito, em quem a pessoa votou em 1932, teria apontado o vencedor correto usando aritmética disponível em 1936.8
Uma taxa de resposta alta não é a meta que você imagina
As taxas de resposta das próprias pesquisas telefônicas do Pew Research Center caíram de 36% em 1997 para 9% em 2012 e para 6% em 2018.9 Enquanto isso, a National Family Health Survey da Índia (pesquisa nacional de saúde da família), feita presencialmente, selecionou 664.972 domicílios e constatou que 653.144 deles estavam ocupados. Entrevistou 636.699 desses, uma taxa de resposta de 97,5%. Leia esse denominador com atenção, porque é o ponto em que uma taxa de resposta mais costuma dar errado: em relação ao número de selecionados, e não ao de ocupados, o mesmo trabalho de campo aparece como 95,7%. A pesquisa extraiu sua amostra de 30.456 conglomerados em todos os 707 distritos.10
Esses dois fatos são da mesma década. O modo de coleta e o esforço de campo influenciam as taxas de resposta muito mais do que qualquer afirmação geral sobre cansaço de pesquisas. Se um guia diz que a taxa de resposta média é um número único, ele não está descrevendo uma grandeza real.
Agora a constatação mais difícil. Uma metanálise de 235 estimativas de viés de não resposta, extraídas de 30 estudos publicados, encontrou uma correlação de 0,33 entre a taxa de resposta e o tamanho do viés de não resposta. Elevado ao quadrado, isso significa que a taxa de resposta explica cerca de 11% da variação do viés.11 Uma análise posterior de 59 estudos desenhados especificamente para medir o viés de não resposta chegou à mesma conclusão.12
Vale a pena reportar e melhorar a taxa de resposta. Ela não é um certificado de qualidade. O que causa viés é se a tendência a responder está ligada àquilo que você mede. Uma pesquisa sobre voluntariado sofre muito mais com isso do que uma pesquisa sobre velocidade de banda larga. Vá atrás da correlação, não da porcentagem.
Mais envios não consertam uma base defeituosa
Durante a campanha de vacinação de 2021, duas pesquisas muito grandes acompanharam a adesão à vacina nos Estados Unidos. Uma coletou cerca de 250.000 envios por semana e superestimou a adesão à primeira dose em 17 pontos percentuais em relação à referência oficial. A outra coletou cerca de 75.000 a cada duas semanas e a superestimou em 14. Uma terceira pesquisa, com cerca de 1.000 respondentes e conduzida segundo a prática probabilística padrão, produziu estimativas confiáveis.13
O mesmo padrão aparece no trabalho comum com pesquisas. Na comparação de três painéis probabilísticos com três fontes online de adesão voluntária, em 28 referências e 29.937 entrevistas, o erro absoluto médio foi de 5,8 pontos percentuais para as amostras de adesão voluntária e de 2,6 para os painéis probabilísticos. Nas 25 dessas referências disponíveis para subgrupos, a diferença para adultos de 18 a 29 anos foi de 11,2 contra 3,6.14
E um diagnóstico memorável: em uma pesquisa de adesão voluntária, 12% dos adultos com menos de 30 anos disseram ter licença para operar um submarino nuclear.15 O número real é próximo de zero. Se um painel consegue produzir isso, consegue produzir qualquer coisa, e um pedido maior ao mesmo painel só compra mais do mesmo.
Quem sua base deixa de fora, fora dos EUA e do Reino Unido
A maioria dos guias de amostragem pressupõe, sem dizer, uma base ocidental: uma lista de e-mails, um telefone fixo, um cadastro nacional de endereços. Grande parte do mundo não faz amostragem assim, e as lacunas de cobertura têm um formato medido.
- Uma pesquisa online em um país de renda baixa ou média é uma amostra da parte conectada dele, e essa parte é predominantemente masculina. Em países de renda baixa e média, as mulheres têm 14% menos probabilidade que os homens de usar internet móvel, o que corresponde a cerca de 235 milhões de mulheres a menos que homens online.16
- Amostras por telefone super-representam os chefes de domicílio. Em pesquisas telefônicas do Banco Mundial em quatro países africanos, os respondentes eram 52% homens em Uganda e 73% homens na Nigéria, contra cerca de metade da população adulta. Em Uganda, 6% dos respondentes por telefone tinham de 15 a 24 anos, contra 38% da população adulta.17
- O que fazer a respeito. Combine modos em vez de defender apenas um. Liste os domicílios no local onde não houver cadastro. Vá a campo nos idiomas que sua população de fato lê e faça o pré-teste da tradução em vez de apenas retrotraduzi-la. Depois, declare a lacuna residual nas suas limitações, porque ela ainda estará lá.
O que a ponderação pode e não pode corrigir
A ponderação ajusta seus dados para que a composição da amostra corresponda a números conhecidos da população. Ela é realmente poderosa e é rotineiramente superestimada.
O argumento a favor. Em 2016, a última pesquisa da University of New Hampshire dava a Clinton uma vantagem de 11 pontos em uma disputa que ela venceu por 0,4. A pesquisa não havia sido ajustada por escolaridade. O comitê de revisão concluiu que esse único ajuste teria eliminado praticamente todo o erro.18 Uma única variável, correlacionada tanto com a resposta quanto com o resultado, fazendo todo o trabalho.
O argumento contra depender dela. Quando mais de 30.000 entrevistas online de adesão voluntária foram comparadas com 24 referências, o viés médio estimado foi de 8,4 pontos percentuais sem ponderação. Em todos os procedimentos de ponderação testados, incluindo abordagens sofisticadas de pareamento, nenhum reduziu o viés médio para menos de 6 pontos.19 Quadruplicar o tamanho da amostra rendeu mais 0,2 ponto.
A regra que decorre disso é simples. A ponderação corrige o desequilíbrio nas variáveis usadas para ponderar, na medida em que essas variáveis se relacionam com o resultado. Ela não faz nada quanto às diferenças entre respondentes e não respondentes em aspectos que você nunca mediu, e nunca transforma uma amostra não probabilística em uma que sustente uma afirmação de precisão.
Um número de precisão é um piso, não um teto
Uma margem de erro quantifica a variabilidade amostral, e apenas isso. Ela pressupõe que a amostra foi extraída ao acaso da população-alvo e que o viés restante foi eliminado. Erro de cobertura, viés de não resposta, erro de medição e respondentes fraudulentos ficam todos de fora dela.
A evidência é direta. Nas duas últimas semanas de 2020, 348 pesquisas presidenciais estaduais informaram uma margem de erro, e o valor médio informado foi de 3,9 pontos. Em relação a essa média, 55% delas erraram a margem final por mais de uma margem de erro, e 21% erraram por mais do que o dobro dela.20 Eram pesquisas modernas, com métodos modernos. Trate a margem de erro como um piso da sua incerteza, nunca como um teto.
| Afirmação | O número | Grau | Fonte |
|---|---|---|---|
| A taxa de resposta mal prevê o viés de não resposta | r = 0,33, ou seja, cerca de 11% da variação, em 235 estimativas de 30 estudos | A | Groves, 200611 |
| Uma pesquisa muito grande pode errar feio | Superestimou a adesão à vacina em 17 pontos com cerca de 250.000 envios por semana | A | Bradley e outros, 202113 |
| Amostras de adesão voluntária têm cerca do dobro do erro dos painéis probabilísticos | 5,8 vs. 2,6 pontos percentuais de erro médio em 28 referências | A | Mercer e Lau, 202314 |
| A ponderação melhora uma amostra de adesão voluntária, mas não a salva | 8,4 pontos sem ponderação, nenhum método abaixo de 6,0 pontos | A | Mercer, Lau e Kennedy, 201819 |
| A margem de erro subestima o erro real das pesquisas eleitorais | 55% de 348 pesquisas estaduais em 2020 erraram por mais do que a margem de erro média informada, de 3,9 pontos | A | Força-tarefa da AAPOR, 202120 |
| A explicação do fracasso da Literary Digest pela base é incompleta | Donos de carro e telefone ainda assim preferiam Roosevelt, por 55 a 45 | B | Squire, 19887 |
Grau A significa uma estatística oficial, uma metanálise ou um achado replicado. Grau B significa um único estudo sólido cuja conclusão ainda não foi repetida de forma independente.
“Uma taxa de resposta de 50% é adequada, 60 é boa, 70 é muito boa.” Uma regra prática de livro-texto sem nenhum dado que a sustente. Autoridades diferentes do mesmo campo citam 50, 60 e 80. O viés depende da correlação entre responder e a resposta dada, não da taxa.
“Trinta basta, porque é a partir daí que o teorema central do limite entra em ação.” Não existe derivação que produza 30. Para resultados simétricos, a aproximação funciona bem abaixo disso; para resultados assimétricos ou eventos raros, ela falha bem acima disso.
“A taxa média de resposta de pesquisas é de 33%.” Isso circula em blogs de fornecedores com redação quase idêntica e sem nenhuma fonte primária. Modo de coleta, patrocinador, população e incentivo pesam muito mais do que qualquer média geral.
“A capacidade de atenção agora é de oito segundos, menor que a de um peixinho-dourado.” A origem é um relatório de marketing de 2015 que citava uma empresa que não conseguiu apresentar uma fonte. A pesquisa original nunca menciona oito segundos nem peixinhos-dourados.
Efeito do desenho: por que amostras por conglomerados precisam de mais pessoas
Quase todo guia recomenda a amostragem por conglomerados pela economia de custo e para por aí. A economia é real, e a conta também. Pessoas dentro da mesma escola, clínica, enfermaria ou loja se parecem umas com as outras. Elas se parecem mais entre si do que com pessoas escolhidas ao acaso em toda a população. Então cada envio extra de um grupo que você já escolheu traz menos informação nova.
O efeito do desenho é o número que mede isso. Em palavras: o quanto sua incerteza aumenta em comparação com extrair o mesmo número de pessoas de forma independente. Para um desenho com grupos de mesmo tamanho, ele é
efeito do desenho = 1 + (tamanho médio do grupo - 1) x correlação intraclasse
A correlação intraclasse é o quanto as pessoas dentro de um grupo se parecem naquilo que você está medindo. Zero significa que estar na mesma escola não diz nada sobre a resposta de um aluno. Um significa que todos em uma escola respondem de forma idêntica, e a escola poderia muito bem ser uma única pessoa. Os valores reais são pequenos, mas valores pequenos causam muito estrago quando os grupos ficam grandes. Considerando em conjunto 48 pesquisas domiciliares nacionais, a correlação intraclasse média é de cerca de 0,06. Ela varia conforme o que você mede. Itens de fecundidade ficam em cerca de 0,01 a 0,03, uso atual de contraceptivos de 0,03 a 0,05, e partos com assistência médica chegam a 0,22 nos números nacionais.21
Se você não tem uma estimativa própria, adote um valor padrão com cuidado. O manual de amostragem das DHS recorre a 1,5 para o deft quando uma pesquisa não tem um valor próprio.22 O deft não é a mesma grandeza que o efeito do desenho da fórmula acima: ele é a razão entre os dois erros-padrão, enquanto o efeito do desenho é a razão entre as duas variâncias. Você o eleva ao quadrado, então um deft de 1,5 equivale a um efeito do desenho de 2,25. O manual chama esse valor de recurso de último caso, e não de valor típico, e seus próprios exemplos resolvidos usam 1,40 para uso de contraceptivos modernos e 1,22 para vacinação infantil.
| Desenho | Efeito do desenho | Envios efetivos | O que significa na prática |
|---|---|---|---|
| Seleção independente, sem conglomeração | 1.00 | 960 | Cada envio vale um envio completo. |
| 24 grupos de 40, ICC 0,02 | 1.78 | 539 | Você pagou por 960 e consegue defender a precisão de 539. |
| 24 grupos de 40, ICC 0,05 | 2.95 | 325 | Dois terços do trabalho de campo não lhe renderam nenhuma precisão a mais. |
| 24 grupos de 40, ICC 0,10 | 4.90 | 196 | O desenho virou, sem alarde, um estudo pequeno com orçamento de estudo grande. |
A ponderação acrescenta seu próprio componente. Uma pesquisa nacional que sobreamostra uma região e depois a pondera de volta carrega dois efeitos do desenho ao mesmo tempo. Um efeito de ponderação de 1,22 e um efeito de conglomeração de 1,80 resultam em um efeito do desenho geral de 2,20. Assim, 5.000 domicílios entrevistados se comportam como 2.277 independentes.23
A lição para o desenho. Mais grupos com menos pessoas em cada um supera menos grupos com mais pessoas em cada um, quase sempre. Quarenta escolas de 24 alunos e 24 escolas de 40 alunos custam aproximadamente os mesmos 960 envios, mas a primeira opção tem um efeito do desenho menor e um resultado defensável. Se você está planejando de quantos envios precisa no total, calcule isso no nosso guia de tamanho da amostra e depois multiplique pelo efeito do desenho. Fazer isso na ordem inversa é como estudos por conglomerados acabam sem poder estatístico suficiente.
Três exemplos resolvidos, do início ao fim
Nomes de métodos são fáceis. As decisões em torno deles é que fazem os estudos darem errado. Estes três percorrem um desenho real, da definição da população até a frase que você pode publicar.
Exemplo 1: experiência dos pacientes em um distrito
- População. Adultos que fizeram uma consulta ambulatorial em qualquer uma das 46 clínicas públicas do distrito entre 1º de abril e 30 de junho.
- Base. Não existe um cadastro de pacientes de todo o distrito. Existe uma lista das 46 clínicas, com contagens mensais de atendimentos.
- Método. Em múltiplos estágios. Selecione 18 clínicas com probabilidade proporcional aos atendimentos e depois amostre sistematicamente cada 8º paciente que sai, durante dois dias de atendimento escolhidos ao acaso.
- Por que não algo mais simples. Uma lista completa de pacientes permitiria a amostragem estratificada, mas ela não existe e não pode ser montada dentro do prazo. Uma amostra por conveniência nas três maiores clínicas seria mais rápida e descreveria as três maiores clínicas.
- O que precisa ser reportado. As probabilidades de seleção variam conforme o tamanho da clínica, então a análise precisa de pesos, e o intervalo precisa ser ampliado para levar em conta o efeito do desenho.
- A frase publicável. “Entre os adultos atendidos em clínicas ambulatoriais públicas do distrito no segundo trimestre, estima-se que 71% consideraram aceitável o tempo de espera, com base em 1.240 entrevistas de saída em 18 clínicas selecionadas com probabilidade proporcional aos atendimentos.”
Exemplo 2: uma dissertação com uma população de estudantes
- População. Estudantes matriculados na Faculdade de Comércio no ano letivo atual: 3.100 distribuídos em três anos de curso.
- Base. O cadastro de matrículas da faculdade, que traz o ano do curso e o programa.
- Método. Amostragem aleatória estratificada por ano do curso, alocação proporcional, meta de 350 envios completos.
- As contas. O primeiro ano tem 1.300 estudantes, ou seja, 42% de 3.100, então recebe 42% de 350, ou seja, 147 envios. Repita para cada ano. Como a alocação é proporcional, não é preciso ponderar.
- Planejamento das respostas. Com uma taxa de resposta esperada de 35%, você precisa convidar cerca de 1.000 estudantes para chegar a 350 envios completos, e deve convidá-los estrato por estrato, para que uma resposta fraca em um ano fique visível enquanto ainda há tempo de agir.
- Limitações a declarar. Estudantes que trancaram ou abandonaram o curso, mas continuam no cadastro, são sobrecobertura. Estudantes matriculados depois da extração do cadastro são subcobertura. Ambos entram no parágrafo de limitações.
Exemplo 3: feedback de clientes de uma loja online
- População. Clientes que concluíram um pedido nos últimos 90 dias.
- Base. A tabela de pedidos. Ela é completa para pedidos online e para compras sem cadastro, mas um cliente com duas contas aparece duas vezes.
- Método. Remova as duplicatas para ficar com uma linha por cliente e depois faça amostragem sistemática de cada 12º cliente a partir de um início aleatório, de forma contínua, e não em um único lote.
- A armadilha que isso evita. Convidar apenas os assinantes da newsletter é mais rápido e é uma amostra por conveniência dos seus clientes mais engajados. Isso vai fazer a satisfação parecer melhor do que é, de forma consistente, todo trimestre.
- Uma observação sobre funcionários. A mesma organização, ao fazer uma pesquisa com seus próprios 180 funcionários, não deve fazer amostragem. Essa população é pequena, alcançável, e todos têm o direito de ser consultados. Faça um censo e, se a participação for baixa, trate isso como um achado, e não como um problema de amostragem.
Como escrever a parte de amostragem da sua metodologia
Esta é a etapa que a maioria dos guias pula, e é a que um orientador, parecerista ou cliente de fato lê. A descrição da amostragem precisa responder a cinco perguntas, nesta ordem: quem, a partir de qual lista, escolhido como, quantos e o que, portanto, você pode afirmar.
Preencha as lacunas abaixo. O texto é propositalmente simples: aqui a banca não procura uma prosa elegante, e sim um desenho que possa avaliar.
O mesmo estudo, mal escrito e bem escrito
Fraco. “Foi extraída uma amostra aleatória de estudantes e foram coletados 350 envios.”
Nada aqui pode ser verificado. “Aleatória” está fazendo um trabalho que não conquistou: não há base, não há denominador e não há declaração de quem foi excluído.
Forte. “A população-alvo foi formada pelos 3.100 estudantes matriculados na Faculdade de Comércio em 2026. A base de amostragem foi o cadastro de matrículas da faculdade, extraído em 3 de março de 2026. Foi usada amostragem aleatória estratificada por ano do curso, com alocação proporcional, para que cada ano pudesse ser reportado separadamente. Mil estudantes foram convidados e 350 responderam ao questionário completo, uma taxa de resposta de 35%. Não foi aplicada ponderação porque a alocação foi proporcional. Estudantes que trancaram ou abandonaram o curso após a data de extração permaneceram na base e não puderam ser identificados, o que é uma fonte menor de sobrecobertura.”
A segunda versão é mais longa, e cada frase a mais é uma pergunta que o parecerista não precisa mais fazer.
“Os participantes foram recrutados por meio de um aviso no aplicativo exibido a usuários ativos durante duas semanas. Trata-se de uma amostra por conveniência; por isso, os achados descrevem as pessoas que responderam e não podem ser generalizados para toda a base de usuários, e nenhum número de precisão é informado. Os respondentes tinham mais probabilidade do que a base de usuários de serem usuários diários, o que deve ser levado em conta na leitura dos resultados.” Escreva isso e ninguém poderá acusar você de afirmar mais do que pode. Você não afirmou.
Checklist do plano de amostragem
Um plano de amostragem por escrito evita a maioria dos erros evitáveis, porque obriga as decisões a acontecerem antes do trabalho de campo, e não durante a análise. Oito pontos, uma página.
- 1. Objetivo da pesquisa. Que decisão isso apoia e o que exatamente será reportado?
- 2. População-alvo. Quem está dentro e fora do escopo, incluindo a janela de tempo.
- 3. Base de amostragem. Fonte, data da extração, número de linhas, lacunas conhecidas e a regra para remover duplicatas.
- 4. Método e motivo. Qual dos nove e por que este, considerando a base e a afirmação.
- 5. Metas. Envios completos no total e por subgrupo, além da taxa de resposta esperada usada no planejamento.
- 6. Plano de recrutamento. Modos de coleta, cronograma de lembretes, idiomas e recursos de acessibilidade, política de incentivos.
- 7. Monitoramento. O que você vai acompanhar durante o trabalho de campo: resposta por estrato, ponto de abandono, não resposta por item.
- 8. Notas de análise. Ponderação planejada, ajuste pelo efeito do desenho e as limitações que você vai declarar aconteça o que acontecer.
Depois que o plano estiver definido, é o instrumento que decide se valeu a pena extrair a amostra. Uma amostra perfeita não salva uma pergunta tendenciosa ou dupla, por isso vale a pena ler exemplos de perguntas para pesquisas antes de ir a campo.
Perguntas frequentes
O que é amostragem em pesquisa?
Amostragem é o processo de selecionar um subconjunto de uma população, chamado amostra, e estudar esse subconjunto para tirar conclusões sobre a população inteira. Ela é usada porque medir todos os membros de uma população costuma ser lento demais, caro demais ou impossível. O método usado para selecionar a amostra determina quais conclusões os resultados podem sustentar.
Qual é a diferença entre população e amostra?
A população é o grupo completo que você quer descrever. A amostra é o subconjunto menor que você de fato mede. A amostragem é o processo que leva de uma à outra, e o censo é a alternativa em que você mede a população inteira.
O que é uma base de amostragem?
A base de amostragem é a lista ou o mecanismo concreto do qual você extrai a amostra: um cadastro de estudantes, um cadastro de pacientes, um banco de dados de clientes, uma listagem de domicílios, um cadastro eleitoral. Ela importa mais que o nome do método, porque qualquer pessoa ausente da base tem chance zero de ser selecionada, por melhor que seja sua técnica de amostragem.
Qual método de amostragem não exige base de amostragem?
A amostragem por conveniência, por cotas, intencional e em bola de neve não precisam de lista nenhuma. A amostragem por conglomerados e em múltiplos estágios precisa apenas de uma lista de grupos, como escolas, clínicas ou povoados, e não de uma lista de indivíduos. A amostragem aleatória simples, a sistemática e a estratificada exigem uma lista completa de indivíduos antes de você começar.
Qual é a diferença entre amostragem probabilística e não probabilística?
Na amostragem probabilística, um mecanismo aleatório faz a seleção, então cada unidade tem uma chance conhecida e diferente de zero de ser escolhida, e você consegue calcular o grau de incerteza das suas estimativas. Na amostragem não probabilística, essas chances são desconhecidas, porque a seleção depende de conveniência, de cotas ou do julgamento do pesquisador. A consequência prática é que só um desenho probabilístico sustenta um número de precisão declarado para uma estimativa da população.
Qual é a diferença entre amostragem estratificada e por conglomerados?
A amostragem estratificada divide a população em grupos e extrai uma amostra aleatória de cada grupo, o que melhora a precisão e garante que cada grupo apareça. A amostragem por conglomerados seleciona alguns grupos ao acaso e depois aplica a pesquisa a todos dentro dos grupos selecionados, o que economiza custos quando não existe lista de indivíduos. O resumo é: a estratificada usa todos os grupos e algumas das pessoas; a por conglomerados usa alguns dos grupos e todas as pessoas.
O que é uma unidade primária de amostragem?
A unidade primária de amostragem é o que for selecionado no primeiro estágio de um desenho em múltiplos estágios. Em uma pesquisa domiciliar nacional, geralmente é uma área, como um bairro, um povoado ou um setor censitário. Os domicílios são então selecionados dentro dela no segundo estágio. Nomear sua unidade primária de amostragem é uma exigência padrão ao reportar um desenho por conglomerados, porque a conglomeração que ela cria precisa ser refletida na análise.
O que é amostragem aleatória estratificada?
A amostragem aleatória estratificada divide a população em grupos sem sobreposição, chamados estratos, e depois extrai uma amostra aleatória de forma independente dentro de cada estrato. A alocação proporcional dá a cada estrato uma parcela da amostra igual à sua parcela da população e dispensa ponderação. A alocação desproporcional sobreamostra deliberadamente estratos pequenos, mas importantes, e depois exige ponderação antes que qualquer número geral seja reportado.
A amostragem em bola de neve é válida para pesquisa acadêmica?
Sim, quando a população é oculta, rara ou não registrada e nenhuma base de amostragem pode ser montada. É uma abordagem reconhecida para grupos de difícil acesso. O que ela não consegue é sustentar uma estimativa da população, e sua principal fraqueza é que os participantes indicam pessoas parecidas com eles, então a amostra se desloca para uma única rede social. Começar por várias sementes sem conexão entre si reduz esse desvio e deve ser descrito na sua metodologia.
Amostragem aleatória é a mesma coisa que alocação aleatória?
Não. A amostragem aleatória é a forma como você seleciona participantes de uma população, e ela determina para quem seus achados podem ser generalizados. A alocação aleatória é a forma como você distribui os participantes selecionados entre as condições de um experimento, e ela determina se um efeito observado pode ser atribuído ao tratamento. Um estudo pode usar uma sem a outra, e a maioria dos experimentos usa alocação aleatória sem amostragem aleatória.
Posso usar um método de amostragem não probabilística em um estudo quantitativo?
Sim, e muita pesquisa quantitativa publicada faz isso. O que muda é o que você pode afirmar. Você pode reportar contagens, porcentagens e relações dentro da sua amostra, e pode comparar grupos dentro dela. Não pode apresentar essas porcentagens como estimativas da população com uma precisão declarada. Declare o método, descreva o recrutamento, compare seus respondentes com uma referência conhecida, quando houver, e escreva a limitação de forma explícita, em vez de torcer para que ninguém pergunte.
Qual é a diferença entre amostragem e distribuição amostral?
Amostragem é o procedimento para selecionar uma amostra. Distribuição amostral é outra ideia. Imagine repetir o mesmo procedimento de amostragem muitas vezes. A dispersão da estatística resultante, como a média ou a porcentagem, em todas essas amostras imaginadas é a distribuição amostral. É a distribuição amostral que torna possíveis os intervalos de confiança, e ela só se comporta de forma previsível quando a amostra foi extraída por um método probabilístico.
Como saber se minha amostra está enviesada?
Compare a amostra obtida com uma referência conhecida, como sua lista de funcionários, registros de matrícula ou dados administrativos, em variáveis relacionadas ao que você está medindo. Diferenças grandes indicam problemas de cobertura, problemas de seleção ou não resposta diferencial. Compare também entre canais de recrutamento e ondas de lembretes. Saiba que uma taxa de resposta saudável é uma evidência fraca de viés baixo: em 235 estimativas publicadas, a taxa de resposta explicou apenas cerca de 11% da variação do viés de não resposta.
Leituras relacionadas
A amostragem é uma decisão dentro de um estudo maior. Estes guias cobrem as decisões antes e depois dela.
- Desenho de pesquisa survey coloca a amostragem na sequência do restante de um estudo, da definição da população ao lançamento.
- Como determinar o tamanho da amostra cobre as contas de precisão que esta página deliberadamente deixa de lado, incluindo as fórmulas.
- Como escrever perguntas de pesquisa cobre o lado da medição, que nenhum desenho amostral consegue salvar.
- Princípios de elaboração de questionários mostra como um instrumento completo é montado depois que as perguntas existem.
- Viés de resposta aprofunda a diferença entre as pessoas que você selecionou e as que responderam.
- Perguntas demográficas em pesquisas é útil quando sua base não tem a variável de que você precisa para estratificar.
- Significância estatística mostra o que fazer com os números depois que a amostra chega.
- Análise de dados quantitativos cobre as etapas de análise seguintes, incluindo onde entram os pesos.
Como este guia foi escrito e o que ele não cobre
Quem escreveu. Michael Hodge, que trabalha com metodologia de pesquisa, elaboração de perguntas e qualidade de dados na SuperSurvey e escreve os guias práticos da nossa seção Guias e ajuda.
Em que se baseia. As definições seguem a revisão metodológica e as orientações universitárias de pesquisa citadas abaixo, que é onde os termos técnicos são de fato definidos. As páginas oficiais de integridade em pesquisa e de órgãos estatísticos aparecem como pontos de partida curtos e em linguagem simples, não como a fonte dessas definições. As descrições dos métodos seguem as mesmas revisões e orientações. Todos os números da seção de evidências vêm de uma fonte primária identificada, listada abaixo. Cada afirmação também tem um grau de confiança, para que você veja quais achados estão consolidados e quais se apoiam em um único estudo. Os números de efeito do desenho do gráfico e da tabela são contas nossas. Usamos a fórmula padrão, com as premissas indicadas na legenda, para que você possa refazê-las ou contestá-las com os tamanhos dos seus próprios conglomerados.
O que ele não cobre. Este guia trata de amostragem para pesquisas e estudos observacionais. Não cobre o desenho de experimentos nem a alocação aleatória, além de diferenciá-los. Também deixa de fora a amostragem para testes de aceitação, auditoria e processamento de sinais, que usam a mesma palavra para coisas diferentes. A amostragem conduzida pelos respondentes (respondent-driven sampling), a amostragem por tempo e local e a amostragem adaptativa por conglomerados são métodos reais que especialistas usam com populações ocultas, e estão fora do escopo aqui. Os números de correlação intraclasse vêm de pesquisas domiciliares em países de renda baixa e média. Trate-os como ilustrativos, não como valores a serem importados para um contexto diferente.
Onde os números são mais frágeis. A reanálise da Literary Digest se apoia em uma pesquisa de 1937 e em uma reanálise posterior, e os dois autores apontam suas próprias incertezas; por esse motivo, ela recebeu grau B. Os números de erro das pesquisas eleitorais vêm de pesquisas eleitorais dos Estados Unidos, que são excepcionalmente bem estudadas e não necessariamente representativas do erro de pesquisas em geral.
Transparência. A SuperSurvey vende software de pesquisas. Nada nesta página está à venda, nenhuma parte dela exige cadastro, e nenhuma organização patrocinou ou revisou este guia. Quando colocamos links para nossas próprias páginas, é porque elas cobrem a próxima decisão, não porque um link nos rende alguma coisa.
Referências
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., e Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- UK Government (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., e Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., e Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences e ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., e Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., e Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., e Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., e Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, páginas 9 e 15. Os números são da edição de 2025; desde então, a GSMA publicou uma edição de 2026 com uma diferença menor.
- Brubaker, J., Kilic, T., e Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., e outros (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., e Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., e Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, página 9 e Tabela 1.2.
- Kalton, G., Brick, J. M., e Le, T. (2005). Estimating components of design effects for use in sample design. In: Household Sample Surveys in Developing and Transition Countries, capítulo VI. United Nations, Series F No. 96.