
À retenir
- Partez d’une décision, pas d’un sujet. Notez ce que vous ferez différemment selon les réponses. Tout item qui ne peut pas changer une décision est candidat à la suppression.
- Une idée, un item, une période. Si une question en cache deux, vous ne pouvez pas savoir quelle moitié a déterminé la réponse.
- La formulation fait bouger les chiffres. Une expérience à échantillons fractionnés a fait varier de 45 points de pourcentage le soutien aux mêmes programmes publics, simplement en les renommant : une formulation neutre est donc un choix de mesure, pas une politesse.
- Concevez les options de réponse avec autant de soin que la question. Des tranches qui se chevauchent, des catégories manquantes et un point médian sans libellé font plus de dégâts qu’un énoncé maladroit.
- Faites un prétest avec des personnes, puis une enquête pilote avec des données. Une lecture à voix haute avec une poignée de participants révèle les malentendus que vous ne pouvez pas voir depuis votre bureau de rédacteur.
Ce qu’est la conception d’un questionnaire, et ce qu’elle ne peut pas corriger
Concevoir un questionnaire, c’est transformer un objectif de recherche en questions que les gens peuvent comprendre et auxquelles ils peuvent répondre avec exactitude. Cela comprend la formulation, les options de réponse, l’ordre, l’introduction et les tests. Les sept étapes ci-dessous montrent comment ces choix s’articulent dans un questionnaire complet.
Un item est bien conçu lorsque deux personnes ayant vécu la même expérience le lisent de la même façon, peuvent retrouver la réponse en mémoire et choisissent la même option pour la décrire. Tout ce qui suit est une manière de s’en rapprocher.
Deux choses qu’elle ne peut pas corriger. Elle ne peut pas corriger un mauvais public : posez des questions parfaites aux mauvaises personnes et vous obtiendrez des réponses précises à une question que personne n’a posée. C’est un problème d’échantillonnage, pas de formulation. Elle ne peut pas non plus compenser un nombre trop faible de participations, qui est un problème de taille de l’échantillon.
Il vaut aussi la peine de distinguer deux mots souvent employés l’un pour l’autre. Le questionnaire est l’instrument : la liste des items et des options de réponse. L’enquête est l’étude tout entière qui l’entoure : qui vous interrogez, comment vous les joignez et ce que vous faites des données. Si vous avez besoin du processus d’ensemble, il est traité dans notre guide sur la méthodologie d’enquête. Cette page s’en tient à l’instrument.
Les 7 étapes pour rédiger un questionnaire
Les internautes demandent sept étapes plus souvent que tout autre nombre, et les listes qu’ils trouvent sont surtout des copies d’un même billet de blog d’agence de 2006, dont la page d’origine n’existe plus. La séquence ci-dessous n’est donc pas cette liste. C’est le processus d’élaboration que décrit réellement la littérature en méthodologie d’enquête16, 17, 20, découpé aux sept moments où le travail change vraiment de nature, avec les deux choses que ces copies omettent : ce que chaque étape produit, et où chacune échoue le plus souvent.
| Étape | Ce que vous décidez | Ce que vous produisez | Où cela échoue le plus souvent |
|---|---|---|---|
| 1. Les décisions d’abord | Ce que les résultats doivent permettre de décider | Une courte liste de décisions et les comparaisons qui les sous-tendent | Partir d’un sujet, si bien que rien ne vous dit quand arrêter d’ajouter des items |
| 2. Items et formats | Un item par décision, et son format de réponse | Une liste provisoire d’items avec un format en face de chacun | Choisir le format par habitude plutôt qu’en fonction de l’analyse nécessaire |
| 3. Une formulation à laquelle on peut répondre | La façon de formuler chaque énoncé | Des énoncés aux termes définis et à la période précisée | Demander des souvenirs que personne n’a, ou cacher deux questions en une |
| 4. Options et échelles | L’ensemble de réponses de chaque item fermé | Des options qui ne se chevauchent pas et ne laissent personne sans choix | Des tranches qui se chevauchent, pas d’option de sortie, un point médian sans libellé |
| 5. Une formulation neutre | Les mots qui poussent vers une réponse | Des énoncés neutres et des listes d’options équilibrées | Des adjectifs dans l’énoncé, des listes de réponses à sens unique |
| 6. Ordre et introduction | L’ordre, les regroupements et le texte d’ouverture | Un instrument ordonné, avec une courte introduction | Des items sensibles trop tôt, une introduction que personne ne lit |
| 7. Prétest et enquête pilote | Si cela fonctionne avec de vraies personnes | Un instrument révisé et une estimation de durée | Le sauter, ou considérer qu’un seul cycle suffit |
Les étapes 3, 4 et 5 sont séparées ici parce qu’elles échouent de façons différentes et se corrigent par des gestes différents. En pratique, vous les parcourrez plus d’une fois. La ligne en pointillés du schéma est la boucle qui compte le plus : ce que révèle le prétest vous renvoie généralement à l’étape 3.
Étape 1. Notez les décisions avant d’écrire la moindre question
La plupart des questionnaires trop longs partent d’un sujet. Les bons partent d’une décision. Avant de rédiger un item, écrivez la courte liste de ce que vous ferez différemment selon les réponses obtenues.
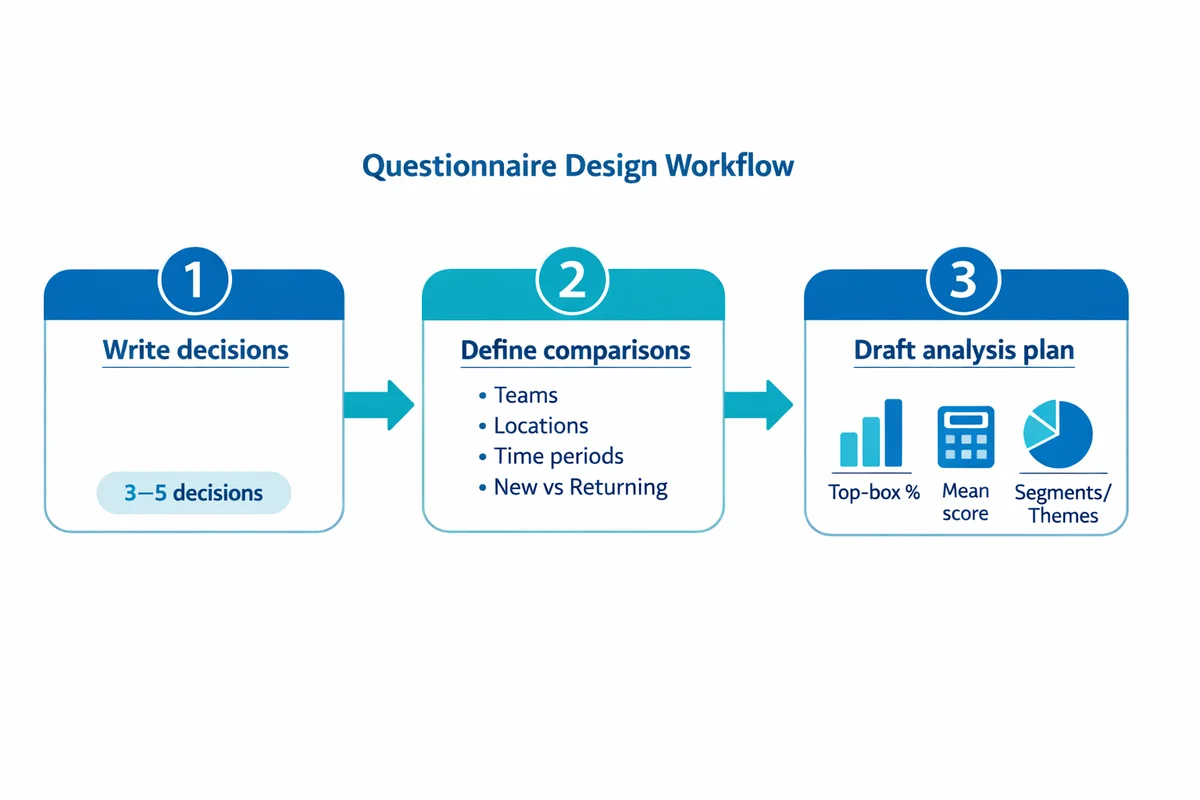
Listez trois à cinq décisions
Formulez-les comme des choix, pas comme des thèmes. « Reconduire le format sur deux jours ou passer à de courtes sessions en ligne » est une décision. « Retours sur la formation » est un thème.
Nommez les comparaisons à faire
Équipes, sites, horaires de travail, périodes, nouveaux venus ou habitués. Les comparaisons déterminent à la fois la formulation et les options de réponse : décidez-les maintenant plutôt que plus tard.
Esquissez les résultats sur une page
Esquissez les tableaux et graphiques que vous comptez réellement produire. Si vous ne pouvez pas dessiner le résultat qu’un item alimente, cet item n’a pas de fonction.
C’est l’étape que les guides de méthodologie placent en premier, et pour la même raison : c’est la seule chose qui vous dit quand arrêter d’ajouter des questions.16, 17
Lisez chaque item provisoire et terminez cette phrase : « Si tout le monde répond B au lieu de A, nous allons... » Si vous ne pouvez pas la terminer, supprimez l’item ou réécrivez-le jusqu’à ce que vous le puissiez.
Étape 2. Transformez chaque décision en un item, et choisissez son format délibérément
Le format d’une question est une décision de mesure, pas une préférence de mise en page. Choisissez le format auquel le lecteur peut répondre et que le résultat prévu peut exploiter.
| Si le résultat est | Utilisez | Exemple d’énoncé |
|---|---|---|
| Un chiffre que vous suivrez dans le temps | Un item d’évaluation fermé, entièrement libellé | « Dans quelle mesure a-t-il été facile ou difficile de terminer la configuration sans aide ? » |
| Une liste hiérarchisée de points à corriger | Un choix unique, puis une question de relance | « Quel changement vous aiderait le plus ? » puis « Pourquoi celui-là ? » |
| Un nombre ou un taux | Des tranches fermées qui ne se chevauchent pas | « Au cours des 30 derniers jours, combien de fois avez-vous contacté l’assistance ? » |
| Des mots que vous n’avez pas encore entendus | Une zone de texte ouverte et ciblée | « Quelle était la principale raison de votre prise de contact aujourd’hui ? » |
| L’éligibilité aux items suivants | Une question filtre et une logique de saut | « Avez-vous utilisé l’onglet des rapports au cours des 30 derniers jours ? » |
Les items fermés coûtent moins cher à analyser et se comparent plus facilement d’une vague à l’autre. Les items ouverts trouvent ce que votre liste d’options a oublié. Si les items fermés dominent, c’est pour une raison pratique, le coût : les réponses ouvertes exigent une grille de codage et plus d’un codeur avant de signifier quoi que ce soit.1 Utilisez un ou deux items ouverts, placés là où ils sont vraiment utiles, et gardez le reste fermé. Nos guides sur les questions à choix multiples et sur les questions ouvertes et fermées approfondissent chaque format.
Une mise en garde sur les échelles d’accord. Si vous pouvez poser la question directement, posez-la directement. Dans une expérience menée sur quatre échantillons, les items dotés d’options de réponse propres au construit ont atteint des coefficients de fidélité de 0,87 à 0,93, alors que le même contenu posé sous forme d’affirmations « d’accord ou pas d’accord » n’a atteint que 0,36 à 0,73.4 C’est un écart important pour un format que la plupart des gens choisissent par habitude. Deux effets de réponse bien identifiés en expliquent une grande part. L’acquiescement est la tendance à approuver quelle que soit l’affirmation, si bien que le format ajoute un penchant que vous ne pouvez pas isoler ensuite. Le satisficing consiste, pour le lecteur, à fournir juste assez d’effort pour donner une réponse acceptable plutôt qu’une réponse exacte, et une colonne d’affirmations « d’accord ou pas d’accord » rend cela très facile. Les deux s’aggravent à mesure que le questionnaire s’allonge. Si vous avez vraiment besoin de ce format, suivez nos conseils sur l’échelle de Likert.
Étape 3. Rédigez un énoncé auquel on peut vraiment répondre
Beaucoup de mauvais items ne sont pas vagues. Il est tout simplement impossible d’y répondre. Ils demandent des souvenirs que personne n’a, ou des connaissances que le participant n’a jamais reçues.
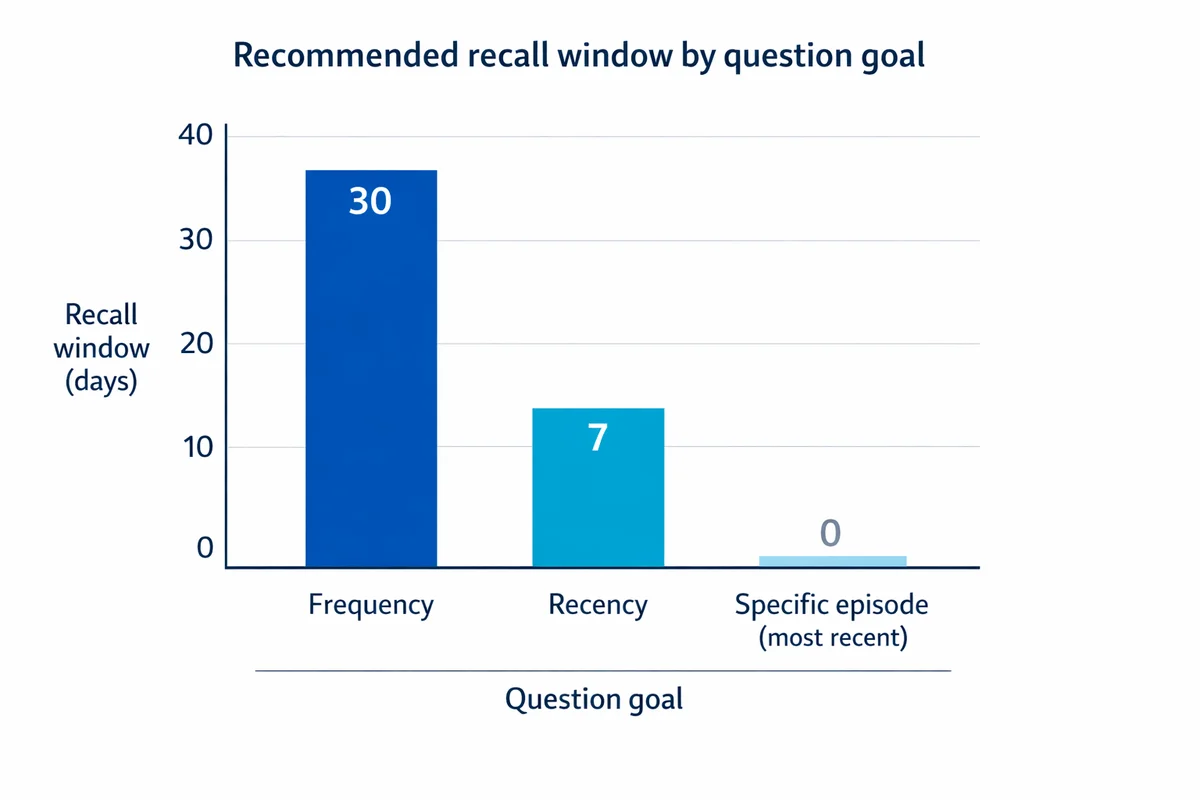
Donnez une période à chaque question de comportement
« À quelle fréquence contactez-vous l’assistance ? » n’a aucun point de repère : deux personnes au comportement identique répondront différemment. Précisez la période, et adaptez-la à la fréquence du comportement.
| Vous voulez | Réponse difficile | Réponse possible |
|---|---|---|
| Une fréquence | « À quelle fréquence contactez-vous l’assistance ? » | « Au cours des 30 derniers jours, combien de fois avez-vous contacté l’assistance ? » |
| Un comportement récent | « Faites-vous régulièrement de l’exercice ? » | « Au cours des 7 derniers jours, combien de jours avez-vous fait au moins 30 minutes d’exercice ? » |
| Un épisode précis | « La prise en main s’est-elle bien passée ? » | « En pensant à votre configuration la plus récente, dans quelle mesure a-t-il été facile ou difficile de la terminer sans aide ? » |
Employez les mots de vos lecteurs
- Choisissez le mot courant. « Aide » vaut mieux qu’« assistance ». « Acheter » vaut mieux qu’« acquérir ». Les mots simples sont aussi plus faciles à traduire.
- Définissez tout terme inévitable. Si l’item repose sur « incident » ou « dossier », précisez dans l’énoncé même ce qui compte.
- Développez un sigle une fois. Puis réutilisez-le. Ne supposez pas que votre jargon interne est partagé.
- Demandez ce qui s’est passé, pas pourquoi. Les gens peuvent rapporter des faits. Ils ne peuvent généralement pas rapporter les causes au sein de votre organisation.
Une idée par item
Un item qui cache deux questions produit une réponse illisible. Une personne qui a adoré le prix et détesté la qualité n’a aucune option honnête, et quel que soit son choix, vous ne saurez pas quelle moitié l’a déterminé.
Dans quelle mesure êtes-vous satisfait du prix et de la qualité ?
Plutôt deux items. « Dans quelle mesure êtes-vous satisfait de la qualité ? » et « Dans quelle mesure êtes-vous satisfait du prix ? »
Soyons honnêtes sur les preuves. Scinder les questions doubles est une règle presque universelle, mais la littérature expérimentale directe qui l’appuie est mince et récente. Le test le plus clair a montré qu’un item double et sa réécriture en une seule idée ne mesuraient pas la même chose, et que la version à une seule idée était plus valide.15 Considérez la règle comme solide et bien fondée, mais pas comme un résultat établi depuis quarante ans, à l’image des effets de formulation de l’étape 5.
Étape 4. Construisez des options de réponse et des échelles exploitables
Bien des questionnaires échouent dans la liste de réponses plutôt que dans l’énoncé. Deux tests repèrent l’essentiel des problèmes. Les options ne doivent pas se chevaucher, et elles ne doivent laisser personne sans choix honnête.
Quel âge avez-vous ? 18 à 30, 30 à 40, 40 à 55, 55 et plus
Quel âge avez-vous ? 18 à 29, 30 à 39, 40 à 54, 55 ou plus, Je préfère ne pas répondre
Échelles d’évaluation
| Choix | Que faire | Pourquoi |
|---|---|---|
| Nombre de points | Cinq à sept pour les attitudes | La fidélité et la validité augmentent nettement jusqu’à environ sept points, puis plafonnent, et la fidélité test-retest diminue de nouveau au-delà de dix.5, 1 |
| Libellés | Libellez chaque point quand vous le pouvez | Les chiffres seuls prêtent à interprétation. Deux personnes lisent « 6 sur 10 » différemment ; toutes deux lisent « Assez facile » de la même façon. |
| Sens | Gardez le même sens du début à la fin | Inverser le sens en cours de questionnaire provoque des erreurs de clic qui ressemblent à de vrais changements d’opinion. |
| Point médian | Prévoyez-en un quand la neutralité est une vraie position | Le supprimer ne révèle pas de penchant caché. Les gens choisissent au hasard autour de l’endroit où il se serait trouvé.1 |
| Sans objet | Séparez-le du point médian | Sinon, les personnes qui ne peuvent pas juger sont comptées comme neutres, ce qui déplace discrètement votre moyenne. |
Le point médian et « Je ne sais pas » ne sont pas des réglages indépendants, contrairement à ce que supposent la plupart des conseils. Proposer une option « Je ne sais pas » en plus d’un point médian a réduit la part de personnes choisissant le point médian d’environ 7 à 17 points de pourcentage selon l’item.6 Autrement dit, une bonne partie de vos réponses neutres vient de personnes qui n’ont pas d’avis, et non de personnes situées au milieu. Décidez des deux options ensemble. Notre guide sur les questions à échelle d’évaluation détaille la mise en page.
Sur un item d’attitude, 15 pour cent des personnes ont choisi l’option « Je ne sais pas » quand elle était proposée. Sur des items proches du même entretien, sans cette option, seuls 3 et 4 pour cent n’ont pas donné de réponse de fond, et ces réponses prédisaient tout de même le vote ultérieur des personnes.7 Quand une porte de sortie facile existe, on s’en sert, et une partie de ce qu’elle recueille était une véritable opinion.
Étape 5. Gardez une formulation neutre et vérifiez les biais
C’est l’étape qui repose sur le plus de preuves, et sur les effets mesurés les plus importants. Des expériences à échantillons fractionnés ont fait varier les résultats de dizaines de points de pourcentage pour une même opinion sous-jacente, uniquement en changeant des mots.
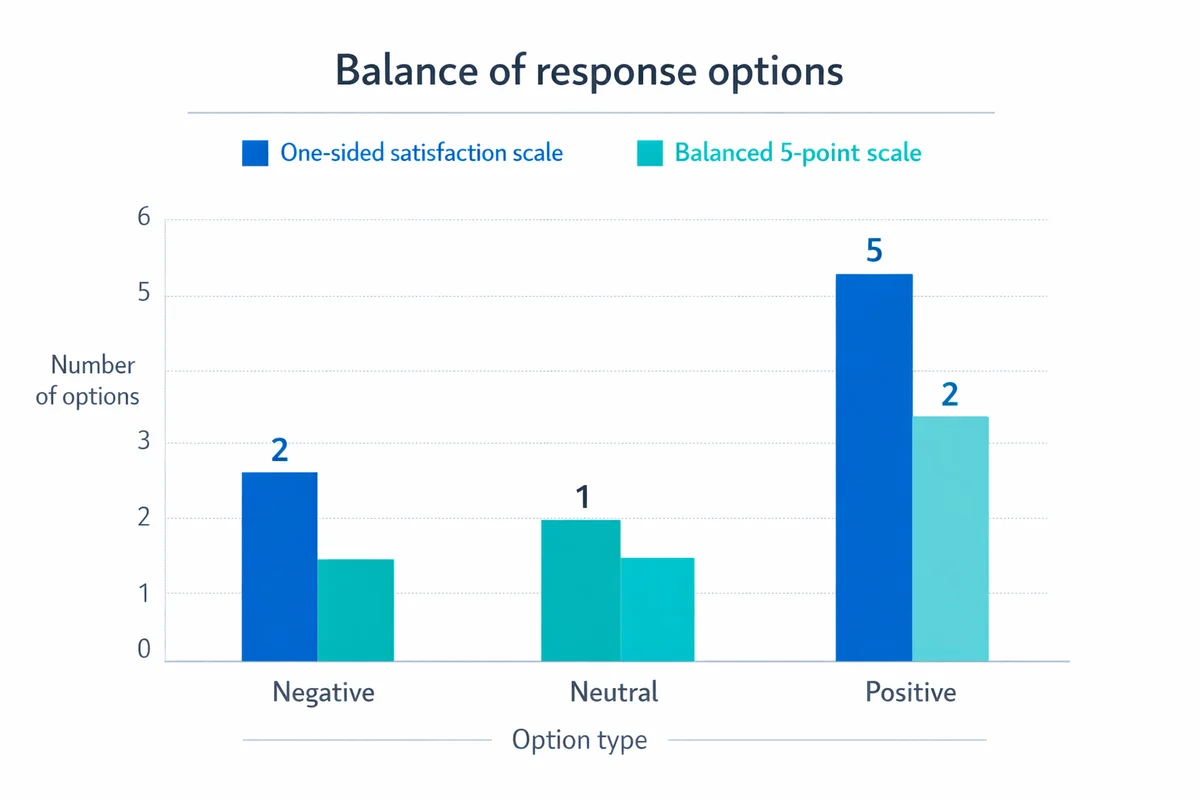
Dans la General Social Survey de 1985, 65,2 pour cent des Américains estimaient que l’on dépensait trop peu pour « l’aide aux pauvres ». Interrogés sur les mêmes programmes sous l’étiquette « welfare » (aide sociale), seuls 19,8 pour cent répondaient trop peu. C’est un écart de 45 points dû à un seul mot, et il s’est reproduit l’année suivante, à 62,8 contre 23,1.2, 3
Le cadrage produit le même effet. Le soutien à une intervention militaire en Irak atteignait 68 pour cent, et tombait à 43 pour cent quand la même question ajoutait « même si cela signifiait que les forces américaines risquaient de subir des milliers de pertes ».8
Il s’agit d’expériences à échantillons fractionnés : deux moitiés aléatoires de la même enquête, chacune avec une formulation. C’est ce dispositif qui fait de « la formulation compte » une mesure plutôt qu’une opinion.
Ce qu’il faut supprimer
| Schéma | Orientée | Neutre |
|---|---|---|
| Adjectif dans l’énoncé | « Dans quelle mesure notre excellente équipe d’assistance vous a-t-elle aidé ? » | « Dans quelle mesure notre équipe d’assistance vous a-t-elle aidé ou non ? » |
| Un seul sens proposé | « À quel point l’inscription a-t-elle été frustrante ? » | « Dans quelle mesure l’inscription a-t-elle été facile ou difficile ? » |
| Liste de réponses à sens unique | « Dans quelle mesure êtes-vous satisfait ? » avec uniquement des options positives | Autant d’options négatives que positives |
| Comportement présumé | « Comment utilisez-vous l’onglet des rapports ? » | « Avez-vous utilisé l’onglet des rapports au cours des 30 derniers jours ? » |
Les biais viennent aussi du participant, pas seulement de la formulation. Trois habitudes causent l’essentiel des dégâts. La désirabilité sociale consiste à répondre de la manière la plus valorisante. L’acquiescement consiste à approuver quelle que soit l’affirmation. Le satisficing consiste à fournir juste assez d’effort pour donner une réponse acceptable plutôt qu’une réponse exacte. Notre guide sur le biais de réponse traite des trois.
Étape 6. Ordonnez les items, puis rédigez une courte introduction
L’ordre n’est pas cosmétique. Une question antérieure peut modifier la réponse à une question ultérieure, et l’effet est mesurable. Le soutien aux unions légales entre couples de même sexe était de 45 pour cent quand l’item suivait une question sur le mariage, et de 37 pour cent quand il était posé seul.9 Rien n’avait changé dans l’item, sauf ce qui le précédait.
Un ordre qui fonctionne
Question filtre
Vérifiez que la personne est éligible avant de lui demander quoi que ce soit d’autre. Faites sortir directement toutes les autres.
Mise en route
Des items simples et factuels qui montrent que le questionnaire porte sur quelque chose que la personne connaît.
Blocs principaux
Regroupez par thème. Gardez la même échelle à l’intérieur d’un bloc pour que personne n’ait à la réapprendre.
Diagnostic
Les raisons et les obstacles qui expliquent les évaluations qui précèdent.
Items sensibles et segments
En dernier, et uniquement ceux que vous utiliserez réellement. Consultez les questions démographiques pour les formulations types.
Clôture
Une zone ouverte « autre chose à ajouter ? », puis un remerciement et la suite prévue.
Une introduction à copier
Limitez-la à cinq lignes. Les gens sont venus pour répondre, pas pour lire.
Objectif : nous recueillons des avis pour améliorer [processus ou service].
Durée : environ [X] minutes.
Confidentialité : vos réponses sont [anonymes ou confidentielles], et [qui] verra les résultats.
Participation volontaire : vous pouvez passer n’importe quelle question.
Contact : des questions ? [nom et e-mail].
Soyez prudent avec l’estimation de durée, car elle modifie le profil des personnes qui participent. Quand le même questionnaire était annoncé comme durant 10, 20 ou 30 minutes, la part de personnes qui l’ont commencé est passée de 75 à 64,9 puis à 62,4 pour cent, et la part de celles qui l’ont terminé après l’avoir commencé est passée de 68,2 à 56,8 puis à 46,8 pour cent.10 Indiquer une durée est la bonne chose à faire. Assurez-vous simplement que ce chiffre vient de votre prétest.
Dites clairement qui voit les réponses brutes et combien de temps vous les conservez, et vérifiez que cela correspond à vos véritables engagements de confidentialité. Le consentement et la clarté sur l’objectif font partie de l’élaboration du questionnaire ; ce ne sont pas des formalités ajoutées après coup.17
Étape 7. Prétest avec des personnes, enquête pilote avec des données, puis lancement
C’est ici que les questionnaires s’améliorent réellement. Un prétest vous dit ce que les gens pensent que l’item signifie. Une enquête pilote vous montre à quoi ressemblent les données quand ils y répondent. Ce sont deux tâches différentes, et il vous faut les deux.16, 19 Construisez l’enquête pilote dans notre créateur d’enquêtes gratuit et testez l’ordre des questions, les options de réponse et les embranchements sur un téléphone avant de l’envoyer à tout votre échantillon.
Lisez-le à voix haute
Demandez à quelqu’un de lire chaque item à voix haute. Tout ce sur quoi la personne bute, qu’elle relit ou reformule est à réécrire.
Sondez le sens
Demandez « que signifie cette question pour vous ? » et « comment êtes-vous arrivé à cette réponse ? ». Vous testez la compréhension, pas l’opinion.
Chronométrez
Notez le temps réellement nécessaire. Ce chiffre va dans votre introduction, et il est généralement plus long que prévu.
Réécrivez et recommencez
Un seul cycle suffit rarement pour un nouvel instrument. Corrigez, puis testez les corrections sur une nouvelle personne.
Combien d’entretiens de prétest
Plus que vous ne le pensez. Une modélisation du prétest par entretiens cognitifs a montré que de vrais problèmes de questions continuaient d’apparaître à mesure que le nombre d’entretiens augmentait, sans palier net où l’on pourrait s’arrêter sans risque.14 Considérez tout nombre fixe comme un budget, pas comme une couverture, et consacrez-le à des personnes qui ressemblent à vos vrais participants.
À quoi sert l’enquête pilote
- Couverture des options. Si « Autre » ou « Je préfère ne pas répondre » est fréquent, il manque quelque chose à votre liste.
- Utilisation de l’échelle. Des réponses entassées à une extrémité signifient généralement que la formulation les y a poussées.
- Réponses en ligne droite. Des réponses identiques sur tout un bloc. Dans les données de panel, cela concerne de 15 à 40 pour cent des personnes sur les blocs où ce schéma est plausible, et moins de 2 pour cent ailleurs.13
- Logique. Vérifiez que chacun ne voit que les questions de relance qui le concernent.
- Point d’abandon. Notez l’item où les gens abandonnent. C’est généralement cet item qui pose problème, pas la longueur.
Ce sont deux nombres différents qui répondent à deux questions différentes, et confondre l’un avec l’autre est une erreur courante et coûteuse. Trente personnes suffisent pour révéler une liste d’options défaillante, un énoncé que personne ne lit de la même façon ou un embranchement logique qui ne se déclenche jamais. C’est tout ce à quoi sert une enquête pilote. C’est très loin de suffire pour estimer un pourcentage, ou pour distinguer deux groupes avec un minimum de certitude. Corrigez l’instrument grâce à l’enquête pilote, puis dimensionnez l’étude réelle séparément avec notre guide sur la taille de l’échantillon.
Prévoyez un taux de réponse modeste au moment du lancement : pour les panels en ligne non probabilistes, des taux de 10 pour cent ou moins sont désormais courants.21
Un exemple commenté : un questionnaire construit à travers les sept étapes
Tous les guides sur ce sujet montrent comment corriger des questions isolées. Presque aucun ne montre la construction d’un questionnaire entier. En voici donc un complet, de la décision de départ jusqu’à l’instrument final, en suivant les étapes ci-dessus dans l’ordre.
Une équipe d’exploitation d’environ 40 personnes a suivi une formation à la sécurité de deux jours en mai. La direction doit choisir le format de la prochaine session, et personne n’a de données. C’est tout le cahier des charges. Appliquez maintenant les étapes.
| Étape | Ce qu’elle a produit ici |
|---|---|
| 1. Les décisions d’abord | Trois décisions : garder le format sur deux jours ou passer à de courtes sessions en ligne ; quel module réécrire en premier ; si le contenu est réellement utilisé dans le travail. Tout ce qui suit se rattache à l’une d’elles. |
| 2. Items et formats | Neuf items. Deux décomptes fermés, deux évaluations libellées, trois listes à choix unique, une zone ouverte ciblée, une zone ouverte de clôture. Une question filtre au début. |
| 3. Une formulation à laquelle on peut répondre | Chaque item de comportement a reçu une période précise (« au cours des 30 jours qui ont suivi la formation »). « La liste de contrôle » est définie dans l’énoncé au lieu d’être supposée connue. |
| 4. Options et échelles | Les décomptes utilisent des tranches qui ne se chevauchent pas. Les deux évaluations utilisent les mêmes cinq points dans le même sens. « Je ne l’ai pas encore utilisée » est séparé du point médian. |
| 5. Supprimer l’orientation | « Dans quelle mesure l’excellente nouvelle liste de contrôle a-t-elle été utile » est devenu « Dans quelle mesure a-t-elle été utile ou non ». L’item sur le format propose les deux options, plus « l’un ou l’autre » et « ni l’un ni l’autre », pour ne pas pousser vers une réponse préférée. |
| 6. Ordre et introduction | Question filtre, puis comportement, puis évaluations, puis la décision sur le format, puis l’obstacle, puis l’horaire de travail, puis la clôture ouverte. L’horaire de travail est vers la fin parce que c’est le seul item auquel les gens pourraient ne pas vouloir répondre. |
| 7. Prétest et enquête pilote | Lecture à voix haute avec quatre personnes. Deux ont compris « la liste de contrôle » comme un autre document, donc la Q2 a reçu les mots « la liste de contrôle d’une page du module 2 ». Cette seule correction suffit à justifier l’étape 7. |
Le questionnaire terminé
Neuf items et une question filtre. Copiez-le, puis changez les noms. Ne copiez pas l’estimation de durée : obtenez-la grâce à votre propre lecture à voix haute.
Questionnaire de fin de formation : 10 items
- Q0. Avez-vous suivi la formation à la sécurité des 12 et 13 mai ? Choix unique, question filtreUne question filtre, pas une mise en route. Toute personne qui répond « Non » doit être envoyée directement à la fin. Sans elle, vous ne pouvez pas distinguer une personne absente d’une personne présente mais mécontente.
- Q1. Au cours des 30 jours qui ont suivi la formation, combien de fois avez-vous utilisé la liste de contrôle d’une page du module 2 sur une vraie intervention ? Choix unique, décomptesUne période précise et un document précis. Les tranches ne se chevauchent pas : une personne qui l’a utilisée trois fois n’a qu’une seule case possible. Cet item répond à lui seul à la troisième décision.
- Q2. Dans quelle mesure la liste de contrôle a-t-elle été facile ou difficile à utiliser sur une vraie intervention ? Évaluation en cinq points, entièrement libellée1Très difficile2345Très facileLes deux sens figurent dans l’énoncé, donc rien n’est suggéré. « Je ne l’ai pas encore utilisée » se trouve en dehors de l’échelle plutôt qu’à l’intérieur, si bien que les personnes qui ne peuvent pas juger ne sont pas comptées comme neutres.
- Q3. Quelle partie de la formation a été la plus difficile à suivre ? Choix unique, avec une option de sortieCelui-ci répond à la deuxième décision. « Rien n’a été difficile à suivre » compte autant que les modules : sans cette option, chacun est obligé de citer un problème qui n’existe peut-être pas.
- Q4. Qu’est-ce qui a rendu cette partie difficile à suivre ? Texte libre, affiché uniquement si un module a été choisi à la Q3Réponse courteLe seul item ouvert qui mérite sa place. Il cible une réponse précise, la plupart des gens ne le voient pas, et c’est le seul élément qui vous dira comment réécrire le module.
- Q5. Si la même formation était reconduite, quel format vous permettrait d’y assister entièrement ? Choix unique, équilibréL’item de décision. Il porte sur la présence, à laquelle les gens peuvent répondre, plutôt que sur la préférence, qui invite à deviner. « L’un ou l’autre » et « ni l’un ni l’autre » sont de vraies réponses, et toutes deux permettent d’agir.
- Q6. Qu’est-ce qui pourrait vous empêcher d’y assister ? Cochez toutes les réponses qui s’appliquent. Choix multiple, avec une option de sortieLes questions « cochez tout ce qui s’applique » demandent un effort : utilisez-les avec parcimonie. C’est justifié ici parce que les obstacles se cumulent : une personne peut en rencontrer deux à la fois, et imposer une seule réponse le masquerait.
- Q7. Dans quelle mesure est-il probable ou improbable que vous recommandiez cette formation à un membre de votre équipe ? Évaluation en cinq points, même échelle que la Q21Très improbable2345Très probableLes mêmes cinq points, dans le même sens que la Q2. Réutiliser une même échelle évite à chacun de la réapprendre, et les deux items peuvent figurer côte à côte dans le même graphique.
- Q8. Dans quelle équipe horaire travaillez-vous habituellement ? Choix unique, placé tardVers la fin, parce que c’est le seul item auquel les gens pourraient ne pas vouloir répondre. Il n’est là que parce que le plan d’analyse compare les équipes horaires. Sinon, il serait supprimé.
- Q9. Y a-t-il autre chose que nous devrions savoir avant de choisir le format ? Texte libre, facultatifFacultatifLa zone de clôture. Elle recueille ce que les listes d’options ont oublié, et c’est l’alerte précoce la moins coûteuse que vous obtiendrez sur une question que vous auriez dû poser.
Les options de réponse ci-dessus sont affichées, pas cliquables. Elles représentent l’instrument ; ce n’est pas un formulaire fonctionnel. Rien ici ne recueille quoi que ce soit. L’impression supprime les notes et ne garde que les dix items, si bien que la fonction « enregistrer en PDF » de votre navigateur en fait un document que vous pouvez distribuer.
Cet instrument a été rédigé pour l’exemple ci-dessus. Si vous préférez ne pas partir d’une page blanche, vous pouvez partir d’un modèle existant et adapter les items à vos propres décisions.
Vérifiez un item déjà rédigé
Collez une question sur laquelle vous travaillez. L’outil effectue les vérifications décrites dans les étapes ci-dessus et vous indique celles qui posent problème. C’est une liste de contrôle, pas un verdict : il repère des schémas dans les mots, il ne peut pas lire votre intention, et un item signalé est parfois le bon item.
Concevez pour le fichier d’analyse, pas pour la diapositive
Cette contrainte s’applique à chaque étape, c’est pourquoi elle ne fait pas partie des sept. Un questionnaire est aussi une spécification de données. Si les réponses ne peuvent pas être comptées proprement, vous vous êtes offert des semaines de nettoyage et un chiffre que vous ne pouvez pas défendre.
- Un construit par colonne. Si la rapidité et la précision vous intéressent, mesurez-les avec deux items. Des construits fusionnés ne peuvent plus être séparés ensuite.
- Uniformisez les périodes. Mélanger « la semaine dernière » dans un item et « l’année dernière » dans le suivant empêche de les placer sur le même graphique.
- Précodez tout ce qui servira à regrouper. Des noms de service saisis librement arrivent sous quarante orthographes pour six services. Proposez une liste.
- Décidez de ce que signifie une donnée manquante avant le lancement. Une question passée, « Je préfère ne pas répondre » et « Sans objet » sont trois choses différentes, qui exigent trois codes différents.
Planifiez les comparaisons et la précision en même temps. Même un instrument parfait ne peut sauver une étude qui a recueilli trop peu de réponses pour distinguer deux groupes, ce qui relève de la taille de l’échantillon, et le seuil à partir duquel une différence est considérée comme réelle relève de la significativité statistique.
Concevez pour le mobile, pas pour l’ordinateur portable sur lequel vous l’avez créé
La deuxième contrainte transversale. Partez du principe d’un téléphone, sur une connexion mobile, avec une interruption à mi-parcours.
Les téléphones sont plus lents que les ordinateurs pour un même instrument. Dans une expérience croisée où les mêmes personnes répondaient sur les deux appareils, la durée médiane était de 17,7 minutes sur smartphone contre 10,5 minutes sur PC.11 C’est 69 pour cent de plus pour un contenu identique : un questionnaire chronométré sur un ordinateur portable l’est sur le mauvais appareil.
L’idée reçue selon laquelle les réponses sur téléphone sont moins bonnes n’est que partiellement vraie, et il vaut la peine d’être précis. Une comparaison directe a montré que les participants sur mobile écrivaient des réponses ouvertes plus courtes et passaient plus d’items, mais que c’étaient les participants sur PC qui répondaient le plus en ligne droite dans les questions en grille.12 Le problème du téléphone, c’est l’effort et les interruptions, pas la négligence.
- Découpez les grilles. Une large matrice sur un petit écran est le pire schéma possible, et c’est là que se concentrent les réponses en ligne droite.
- Gardez des options assez courtes pour tenir sur une ligne. Des options sur deux lignes ne se comparent plus d’un coup d’œil.
- N’affichez les questions de relance que lorsqu’elles s’appliquent. La logique de saut réduit davantage la longueur perçue que la suppression d’items.
- Prévoyez de larges zones tactiles. Des boutons radio bien espacés, pas une pile serrée.
- N’utilisez une barre de progression que si elle est honnête. Une barre qui recule à cause de la logique de saut est pire que pas de barre du tout.
Un questionnaire est-il qualitatif ou quantitatif ?
Les deux, selon ce que vous y mettez. L’instrument n’est pas la méthode. Un questionnaire composé d’items fermés aux options fixes produit des données quantitatives. Un questionnaire composé de questions ouvertes produit des données qualitatives. La plupart des instruments réels font un peu des deux, et l’erreur n’est pas de ne pas choisir, c’est de ne pas décider.
| Choix de conception | Objectif quantitatif | Objectif qualitatif |
|---|---|---|
| Ce que vous cherchez | Combien, en quelle quantité, comment cela varie entre groupes | Pourquoi, avec les mots de qui, et ce que vous n’auriez pas pensé à demander |
| Items | Surtout fermés, formats fixés à l’avance | Surtout des questions ouvertes avec relances |
| Règle de formulation | Identique pour tous, sans exception | Cohérente, mais une question peut inviter à développer |
| Combien de personnes | Assez pour les comparaisons que vous prévoyez | Assez pour que les nouvelles réponses n’apportent plus de nouveaux thèmes |
| Ce qui en ressort | Des décomptes, des pourcentages, des différences entre groupes | Des thèmes codés, des citations, des hypothèses à tester ensuite |
| Le principal risque | Des réponses précises à une question mal formulée | Des réponses riches que vous n’avez aucun moyen cohérent de coder |
Pour un projet de recherche, la forme mixte est généralement la bonne : un petit ensemble d’items fermés qui portent la mesure, et une ou deux questions ouvertes qui expliquent les chiffres. L’étape qui change le plus est l’étape 2, car les réponses ouvertes exigent une grille de codage, et une grille de codage exige plus d’un codeur avant que l’on puisse s’y fier.1 Si vous choisissez la forme de l’étude plutôt que les items, cette décision se prend un niveau plus haut, dans la méthodologie d’enquête.
Quelles règles sont prouvées, et lesquelles sont simplement répétées
Les conseils sur les questionnaires sont recopiés de page en page jusqu’à ce que chaque règle paraisse également établie. Ce n’est pas le cas. Certaines reposent sur des décennies d’expériences à échantillons fractionnés. D’autres reposent sur une seule étude récente, et quelques chiffres très répandus ne reposent sur rien du tout. Voici où en est réellement chaque affirmation de cette page.
| Affirmation | Le chiffre | Niveau de preuve | Source |
|---|---|---|---|
| La formulation modifie le résultat | 65,2 % contre 19,8 % jugent que l’on dépense « trop peu » pour les mêmes programmes, selon qu’ils sont appelés « aide aux pauvres » ou « welfare » | A | Rasinski 1989 ; Smith 19872, 3 |
| Le cadrage modifie le résultat | 68 % contre 43 % de soutien, avec et sans mention des pertes | A | Pew Research Center8 |
| L’ordre modifie le résultat | 45 % contre 37 % de soutien, même item, position différente | A | Pew Research Center 20039 |
| Des options propres à l’item font mieux que « d’accord ou pas d’accord » | Fidélité de 0,87 à 0,93 contre 0,36 à 0,73 | A | Saris et al. 20104 |
| La durée annoncée modifie la participation | Parmi les personnes ayant commencé, l’achèvement est passé de 68,2 % à 56,8 % puis à 46,8 % pour une durée annoncée de 10, 20 et 30 minutes | A | Galesic et Bosnjak 200910 |
| Une option « Je ne sais pas » proposée est choisie | 15 % l’ont choisie ; seuls 3 % et 4 % ont laissé sans réponse des items comparables qui ne la proposaient pas | A | Gilljam et Granberg 19937 |
| Les téléphones prennent plus de temps | 17,7 contre 10,5 minutes médianes, mêmes personnes, deux appareils | A | Antoun et al. 201711 |
| Cinq à sept points d’échelle | Les indices augmentent jusqu’à environ 7 points, puis plafonnent ; la fidélité baisse de nouveau au-delà de 10 | B | Preston et Colman 20005, 1 |
| Une option « Je ne sais pas » détourne les gens du point médian | Le choix du point médian a baissé d’environ 7 à 17 points | B | Wetzelhutter 20206 |
| Les réponses en ligne droite sont fréquentes là où elles sont plausibles | 15 % à 40 % sur les blocs où c’est plausible, moins de 2 % ailleurs | B | Schonlau et Toepoel 201513 |
| Les réponses sur téléphone ne sont pas simplement moins bonnes | Réponses ouvertes plus courtes sur mobile, mais plus de réponses en ligne droite sur PC | B | Mavletova 201312 |
| Scinder les items doubles | Pas de pourcentage net ; les deux versions ne mesuraient pas la même chose | B | Menold 202015 |
| Le prétest n’a pas de point d’arrêt sûr | Des problèmes continuaient d’apparaître à mesure que le nombre d’entretiens augmentait | B | Blair et Conrad 201114 |
Signification des niveaux : A expérience reproduite ou synthèse de l’ensemble de la littérature. B une étude solide. C très répandu mais contesté ou introuvable, c’est pourquoi aucune affirmation de cette page n’a ce niveau.
Les chiffres que nous avons volontairement écartés
Chacun d’eux est courant dans les conseils sur les questionnaires. Nous avons remonté chacun jusqu’à sa source, et nous les avons écartés.
« Notre capacité d’attention n’est plus que de 8 secondes, moins que celle d’un poisson rouge »
Remonte à un rapport marketing de 2015 qui citait un site de contenus produits à la chaîne, dont les propres sources n’ont pas pu être fournies quand des journalistes les ont demandées.24 La comparaison avec le poisson rouge est elle aussi inventée.
« Cinq à sept entretiens de prétest détectent 75 à 85 pour cent des problèmes »
Il s’agit d’un résultat de tests d’utilisabilité portant sur des bugs logiciels22, transposé aux entretiens cognitifs. L’étude réellement consacrée aux enquêtes n’a trouvé aucun palier de ce genre.14
« Le taux de réponse moyen d’une enquête est de [choisissez un chiffre] »
Au moins quatre chiffres incompatibles circulent, chacun avec une définition cachée différente des personnes interrogées. Il existe à la place des fourchettes fondées, selon le type d’échantillon.21
« Restez sous les 10 minutes, sinon vous perdez les gens »
La tendance est juste, pas la chute brutale. La courbe mesurée est une pente régulière de 10 à 30 minutes annoncées, sans aucun seuil.10
« Sept plus ou moins deux, donc utilisez une échelle en 7 points »
L’article de Miller de 1956 porte sur la mémoire à court terme des listes, pas sur le nombre de points qu’une personne peut distinguer sur une échelle.23 Les vraies données sur le nombre de points mènent de toute façon à cinq à sept.5
« Les questions doubles ruinent vos données »
Règle solide, preuves minces. Nous avons trouvé un seul test randomisé qui lui soit consacré, contre des dizaines pour les effets de formulation et d’ordre.15 Nous le disons à l’étape 3 plutôt que d’en affirmer trop.
Les cas particuliers qui cassent discrètement les questionnaires
Items sensibles
Revenus, santé, problèmes de performance, et tout ce qu’un responsable pourrait lire. Ces items augmentent à la fois les abandons et les déclarations inexactes quand la confiance est faible. Placez-les tard, expliquez en une ligne pourquoi vous les posez, et offrez une vraie possibilité de refuser. « Je préfère ne pas répondre » est une donnée. Une case vide ne l’est pas.
« Sans objet » n’est pas « neutre »
Ne laissez pas les personnes qui ne peuvent pas juger atterrir au milieu de votre échelle. Donnez-leur une option distincte en dehors de l’échelle, ou faites-leur sauter l’item grâce à la logique de saut. Sinon, votre moyenne bouge pour une raison qui n’a rien à voir avec l’opinion.
Les effets d’ordre dans une longue liste
À l’écran, les options situées en haut d’une longue liste sont choisies plus souvent. Mélangez l’ordre des marques, des raisons et des sujets, et ne fixez l’ordre que lorsqu’il a un sens, comme pour une échelle de fréquence ou une série de dates.
Négations
« Êtes-vous d’accord pour dire que la prise en main n’est pas difficile ? » oblige le lecteur à démêler deux négations avant de pouvoir répondre. Rédigez la version positive et laissez l’échelle porter le sens.
Traduction
Évitez les expressions idiomatiques, les métaphores sportives et le jargon local : elles ne survivent pas à la traduction et excluent les lecteurs pour qui votre langue est une seconde langue. Si vous traduisez, utilisez la rétrotraduction, et faites-la relire par une personne qui connaît le sujet, pas seulement la langue.
Vagues répétées
Si vous prévoyez de comparer cette vague avec la suivante, figez la formulation dès maintenant. Améliorer un item entre deux vagues signifie que le changement mesuré peut venir de votre propre modification. Gardez l’ancienne formulation, ajoutez la meilleure à côté pendant une vague, puis basculez.
La liste de relecture, avant tout envoi
Liste de relecture du questionnaire
- Décisions. Chaque item se rattache à une décision notée à l’étape 1.
- Formats. Le format de chaque item a été choisi pour le résultat qu’il alimente, pas par habitude.
- Périodes. Chaque item de comportement précise une période, adaptée au comportement.
- Termes. Le jargon est défini dans l’énoncé. Les sigles sont développés une fois.
- Une idée. Aucun item ne cache deux attributs, deux objets ou deux périodes.
- Options. Les tranches ne se chevauchent pas, la liste couvre les réponses réalistes, et il existe une option de sortie.
- Échelles. Mêmes points, même sens, libellées, avec « Sans objet » placé en dehors de l’échelle.
- Formulation neutre. Aucun adjectif dans l’énoncé, et les deux sens sont proposés.
- Ordre. Question filtre en premier, items sensibles à la fin, une échelle par bloc.
- Introduction. Objectif, durée honnête, confidentialité, participation volontaire, contact. Cinq lignes.
- Téléphone. Ouvert sur un vrai téléphone, sans grilles larges ni options sur plusieurs lignes.
- Lecture à voix haute. Une personne extérieure au projet a lu chaque item et l’a compris comme prévu.
- Durée. Le chiffre de votre introduction vient de cette lecture à voix haute, pas d’une supposition.
- Codes. Question passée, refus de répondre et sans objet ont trois codes distincts.
Questions fréquentes
Quelle est la première étape pour rédiger un questionnaire ?
Noter les décisions que les résultats doivent éclairer. Pas le sujet : les décisions. Tant que vous ne pouvez pas dire ce que vous ferez différemment selon les réponses, vous n’avez aucun moyen de distinguer un item nécessaire d’un item facultatif, et le brouillon s’allonge jusqu’à ce que quelqu’un s’en lasse.
Quelle est la différence entre un questionnaire et une enquête ?
Le questionnaire est l’instrument : la liste des items et de leurs options de réponse. L’enquête est l’étude tout entière qui l’entoure : qui vous interrogez, comment vous les joignez, combien il vous en faut et ce que vous faites des résultats. Une même enquête peut utiliser plusieurs questionnaires, et un même questionnaire peut servir dans plusieurs enquêtes.
Combien de questions un questionnaire doit-il comporter ?
Aussi peu que vos décisions l’exigent. Viser un nombre cible est une erreur ; visez plutôt une durée de réponse, et obtenez-la grâce à votre propre lecture à voix haute plutôt qu’à une règle empirique. La durée annoncée influe sur qui participe : dans une expérience contrôlée, l’achèvement parmi les personnes qui avaient commencé est passé de 68,2 pour cent pour 10 minutes annoncées à 46,8 pour cent pour 30 minutes annoncées.
Combien de temps faut-il pour répondre à un questionnaire ?
Assez courte pour que la durée annoncée ne décourage personne, et assez honnête pour correspondre à la réalité. Il n’existe aucun seuil brutal à une minute donnée. La relation mesurée est une baisse régulière de la participation à mesure que la durée annoncée augmente : chaque item que vous gardez vous coûte un peu de réponses, et vous devez pouvoir dire ce que chacun vous apporte.
Un questionnaire est-il qualitatif ou quantitatif ?
Il peut être l’un ou l’autre, et la plupart sont un peu les deux. Les items fermés aux options fixes produisent des données quantitatives. Les questions ouvertes produisent des données qualitatives. L’essentiel est de décider à quoi sert un item avant de le rédiger, car les deux exigent des règles de formulation différentes, des nombres de participants différents et une analyse complètement différente.
Faut-il un point médian neutre sur une échelle d’évaluation ?
Prévoyez-en un quand « neutre » est une position réelle sur ce que vous mesurez. Le supprimer ne fait pas émerger une opinion cachée ; les gens choisissent plus ou moins au hasard parmi les points les plus proches du milieu. Décidez aussi ensemble du point médian et d’une option « Je ne sais pas », car proposer « Je ne sais pas » réduit l’usage du point médian d’environ 7 à 17 points de pourcentage.
Quand proposer une option « Je ne sais pas » ?
Quand le participant peut réellement ne pas disposer de l’information, comme le nom d’une offre, une date ou un détail technique. Évitez-la pour les questions sur sa propre expérience, auxquelles presque tout le monde peut répondre. Quand une porte de sortie facile existe, on s’en sert : sur un item d’attitude, 15 pour cent ont choisi « Je ne sais pas » quand l’option était proposée, alors que seuls 3 à 4 pour cent ont laissé sans réponse des items comparables qui ne la proposaient pas.
Combien de questions ouvertes faut-il utiliser ?
Une ou deux, placées là où elles seront vraiment utiles, généralement en relance d’une réponse fermée précise et en zone de clôture pour tout le reste. Les réponses ouvertes sont le seul moyen d’entendre ce que votre liste d’options a oublié, mais elles exigent une grille de codage et plus d’un codeur avant que les résultats signifient quoi que ce soit, et ce coût est réel.
Comment tester un questionnaire avant de l’envoyer ?
En deux temps. Un prétest vérifie la compréhension : faites lire chaque item à voix haute et demandez aux personnes ce qu’elles pensent qu’il signifie et comment elles ont choisi leur réponse. Une enquête pilote est un petit lancement réel qui vérifie les données : points d’abandon, couverture des options, comportement des échelles et fonctionnement réel de l’analyse prévue. Faites d’abord le prétest, car c’est lui qui modifie la formulation.
Quel type de méthodologie de recherche utilise un questionnaire ?
Un questionnaire est un instrument de collecte de données, pas une méthodologie : on le retrouve donc dans plusieurs types d’études. Les études transversales l’utilisent à un moment donné. Les études de tendance et de panel le répètent dans le temps. Les expériences l’utilisent pour mesurer les effets après une manipulation. Choisir entre elles est une décision de méthodologie qui se situe un niveau au-dessus de la formulation des items.
Comment valider un questionnaire ?
Quelques nouveaux items qui mesurent quelque chose de concret demandent un prétest, pas une validation psychométrique. Une échelle destinée à mesurer quelque chose d’abstrait, et à être comparée entre groupes ou réutilisée par d’autres, demande davantage : une revue du contenu par des experts, une enquête pilote assez grande pour vérifier la cohérence des items, et la preuve que les scores sont liés à un critère externe de la manière prévue. Si un instrument validé existe déjà pour votre construit, utilisez-le plutôt que d’écrire le vôtre.
Comment ce guide a été élaboré, et ce qu’il ne couvre pas
La séquence en sept étapes suit le processus d’élaboration décrit dans la littérature sur la méthodologie des questionnaires16, 17, 18, 20 plutôt que le cadre d’un éditeur en particulier. Chaque chiffre cité sur cette page provient d’une expérience publiée ou d’un rapport méthodologique officiel, listés ci-dessous. Chacun a été évalué avant d’être utilisé, et son niveau figure à côté de l’affirmation dans le tableau des preuves.
Les affirmations que nous n’avons pas pu rattacher à une source primaire ont été écartées, et les plus courantes sont citées dans « les chiffres que nous avons volontairement écartés » pour que vous puissiez les reconnaître ailleurs. Lorsqu’une règle est solide mais que les preuves directes sont minces, comme pour la scission des items doubles, la page le dit au lieu d’emprunter la crédibilité d’un résultat plus solide.
L’essentiel des preuves expérimentales présentées ici provient d’enquêtes menées aux États-Unis et en Europe de l’Ouest, en grande partie sur des échantillons de population générale et de panels en ligne. L’ampleur des effets de formulation et d’ordre ne se transposera pas telle quelle à toutes les langues, à tous les sujets ou à toutes les populations, et rien de tout cela n’a été testé sur vos participants. Considérez ces chiffres comme la preuve que ces effets sont réels et peuvent être importants, pas comme des constantes à appliquer telles quelles.
L’exemple commenté est un cas construit pour montrer les sept étapes en un seul endroit. Ce n’est pas le compte rendu d’une étude réelle, et le prétest qui y est décrit est illustratif.
Cette page porte sur l’instrument. Elle ne traite pas de qui interroger, de combien de personnes interroger ni de la façon d’analyser les réponses. Ce sont des tâches distinctes, traitées dans échantillonnage, taille de l’échantillon et significativité statistique.
SuperSurvey édite un logiciel d’enquête : nous avons donc un intérêt commercial à ce que les gens mènent des enquêtes. Ce guide est en accès libre, et ses conseils s’appliquent à toute plateforme d’enquête. Le vérificateur d’items fonctionne entièrement dans votre navigateur et n’envoie rien nulle part. Les liens vers notre outil de création et notre bibliothèque de modèles proposent des moyens de mettre le questionnaire en pratique.
Références
- Krosnick, J. A., & Presser, S. (2010). Question and questionnaire design. Dans P. V. Marsden & J. D. Wright (dir.), Handbook of Survey Research (2e éd., chap. 9). Emerald.
- Rasinski, K. A. (1989). The effect of question wording on public support for government spending. Public Opinion Quarterly, 53(3), 388-394. doi.org/10.1086/269158
- Smith, T. W. (1987). That which we call welfare by any other name would smell sweeter. Public Opinion Quarterly, 51(1), 75-83. doi.org/10.1086/269015
- Saris, W. E., Revilla, M., Krosnick, J. A., & Shaeffer, E. M. (2010). Comparing questions with agree/disagree response options to questions with item-specific response options. Survey Research Methods, 4(1), 61-79. doi.org/10.18148/srm/2010.v4i1.2682
- Preston, C. C., & Colman, A. M. (2000). Optimal number of response categories in rating scales. Acta Psychologica, 104(1), 1-15. doi.org/10.1016/S0001-6918(99)00050-5
- Wetzelhutter, D. (2020). Scale-sensitive response behavior: consequences of offering versus omitting a "don't know" option and/or a middle category. Survey Practice, 13(1). doi.org/10.29115/SP-2020-0012
- Gilljam, M., & Granberg, D. (1993). Should we take don't know for an answer? Public Opinion Quarterly, 57(3), 348-357. doi.org/10.1086/269380
- Pew Research Center. Writing survey questions. Note méthodologique. pewresearch.org/writing-survey-questions
- Pew Research Center (18 novembre 2003). Religious beliefs underpin opposition to homosexuality, Part 2 : Gay marriage. pewresearch.org/politics/2003/11/18/part-2-gay-marriage
- Galesic, M., & Bosnjak, M. (2009). Effects of questionnaire length on participation and indicators of response quality in a web survey. Public Opinion Quarterly, 73(2), 349-360. doi.org/10.1093/poq/nfp031
- Antoun, C., Couper, M. P., & Conrad, F. G. (2017). Effects of mobile versus PC web on survey response quality. Public Opinion Quarterly, 81(S1), 280-306. doi.org/10.1093/poq/nfw088
- Mavletova, A. (2013). Data quality in PC and mobile web surveys. Social Science Computer Review, 31(6), 725-743. doi.org/10.1177/0894439313485201
- Schonlau, M., & Toepoel, V. (2015). Straightlining in web survey panels over time. Survey Research Methods, 9(2), 125-137. doi.org/10.18148/srm/2015.v9i2.6128
- Blair, J., & Conrad, F. G. (2011). Sample size for cognitive interview pretesting. Public Opinion Quarterly, 75(4), 636-658. doi.org/10.1093/poq/nfr035
- Menold, N. (2020). Double barreled questions: an analysis of the similarity of elements and effects on measurement quality. Journal of Official Statistics, 36(4), 855-886. doi.org/10.2478/jos-2020-0041
- Rattray, J., & Jones, M. C. (2007). Essential elements of questionnaire design and development. Journal of Clinical Nursing, 16(2), 234-243. doi.org/10.1111/j.1365-2702.2006.01573.x
- Boparai, J. K., Singh, S., & Kathuria, P. (2019). How to design and validate a questionnaire: a guide. Current Clinical Pharmacology, 13(4), 210-215. doi.org/10.2174/1574884713666180807151328
- Slattery, E. L., Voelker, C. C. J., Nussenbaum, B., Rich, J. T., Paniello, R. C., & Neely, J. G. (2011). A practical guide to surveys and questionnaires. Otolaryngology-Head and Neck Surgery, 144(6), 831-837. doi.org/10.1177/0194599811399724
- Edwards, P. (2010). Questionnaires in clinical trials: guidelines for optimal design and administration. Trials, 11, 2. doi.org/10.1186/1745-6215-11-2
- Stone, D. H. (1993). Design a questionnaire. BMJ, 307(6914), 1264-1266. pmc.ncbi.nlm.nih.gov/articles/PMC1679392
- American Association for Public Opinion Research (2022). Data quality metrics for online samples : considerations for study design and analysis. Rapport de groupe de travail. rapport du groupe de travail sur aapor.org (PDF)
- Nielsen, J., & Landauer, T. K. (1993). A mathematical model of the finding of usability problems. Proceedings of ACM INTERCHI '93, 206-213. doi.org/10.1145/169059.169166
- Miller, G. A. (1956). The magical number seven, plus or minus two. Psychological Review, 63(2), 81-97. doi.org/10.1037/h0043158
- Maybin, S. (10 mars 2017). Busting the attention span myth. BBC News. bbc.com/news/health-38896790
Chaque DOI ci-dessus a été vérifié auprès du résolveur de DOI, et chaque lien a été testé pour s’assurer qu’il répond, le 21 août 2026.