
Belangrijkste punten
- Begin bij een beslissing, niet bij een onderwerp. Schrijf op wat u anders zult doen afhankelijk van de antwoorden. Elk item dat geen beslissing kan veranderen, komt in aanmerking om te schrappen.
- Eén idee, één item, één tijdsperiode. Als een vraag twee vragen verbergt, kunt u niet zien welke helft het antwoord bepaalde.
- De formulering verschuift de cijfers. In één experiment met een gesplitste steekproef verschoof de steun voor dezelfde overheidsprogramma’s met 45 procentpunten, alleen doordat ze een andere naam kregen. Neutrale formulering is dus een meetkeuze en geen beleefdheid.
- Ontwerp de antwoordopties even zorgvuldig als de vraag. Overlappende bereiken, ontbrekende categorieën en een middelpunt zonder label richten meer schade aan dan een onhandig geformuleerde vraagstam.
- Eerst een pretest met mensen, dan een pilotonderzoek met data. Als een handvol deelnemers de vragen hardop leest, vindt u de misverstanden die u vanuit de stoel van de schrijver niet ziet.
Wat vragenlijstontwerp is, en wat het niet kan oplossen
Vragenlijstontwerp is het proces waarin een onderzoeksdoel wordt omgezet in vragen die mensen begrijpen en nauwkeurig kunnen beantwoorden. Het omvat de formulering, de antwoordopties, de volgorde, de inleiding en het testen. De zeven stappen hieronder laten zien hoe die keuzes in een complete vragenlijst samenwerken.
Een item is goed ontworpen wanneer twee mensen met dezelfde ervaring het op dezelfde manier lezen, het antwoord uit hun geheugen kunnen ophalen en dezelfde optie kiezen om het te beschrijven. Alles hieronder is een manier om daar dichterbij te komen.
Twee dingen kan het niet oplossen. Het verkeerde publiek: stelt u perfecte vragen aan de verkeerde mensen, dan krijgt u precieze antwoorden op een vraag die niemand stelde. Dat is een probleem van steekproeftrekking, geen probleem van formulering. Ook te weinig reacties lost het niet op; dat is een probleem van steekproefgrootte.
Het is ook goed om twee woorden uit elkaar te houden die vaak door elkaar worden gebruikt. De vragenlijst is het instrument: de lijst met items en antwoordopties. De enquête is het hele onderzoek eromheen: wie u ondervraagt, hoe u die mensen bereikt en wat u met de gegevens doet. Het bredere proces komt aan bod in onze gids over de opzet van enquêteonderzoek. Deze pagina gaat alleen over het instrument.
De 7 stappen van vragenlijstontwerp
Wie online zoekt, vraagt vaker om zeven stappen dan om enig ander aantal, en de lijsten die dan verschijnen zijn grotendeels kopieën van één blogbericht van een bureau uit 2006, waarvan de oorspronkelijke pagina niet meer online staat. De volgorde hieronder is dus niet die lijst. Het is het ontwikkelproces dat de literatuur over enquêtemethodologie werkelijk beschrijft16, 17, 20, opgedeeld op de zeven punten waar het werk echt van vorm verandert, met de twee dingen die die kopieën weglaten: wat elke stap oplevert en waar elke stap meestal misgaat.
| Stap | Wat u beslist | Wat het oplevert | Waar het meestal misgaat |
|---|---|---|---|
| 1. Eerst de beslissingen | Wat de resultaten moeten beslissen | Een korte lijst met beslissingen en de vergelijkingen erachter | Beginnen bij een onderwerp, zodat niets aangeeft wanneer u moet stoppen met items toevoegen |
| 2. Items en formaten | Eén item per beslissing, met het antwoordformaat | Een conceptlijst met items, met bij elk item een formaat | Het formaat uit gewoonte kiezen in plaats van op basis van de analyse die u nodig hebt |
| 3. Beantwoordbare formulering | Hoe elke vraagstam is geformuleerd | Vraagstammen met gedefinieerde begrippen en een vermelde tijdsperiode | Vragen naar herinneringen die niemand heeft, of twee vragen in één verstoppen |
| 4. Opties en schalen | De antwoordset voor elk gesloten item | Opties die niet overlappen en niemand zonder passend antwoord laten | Overlappende bereiken, geen uitwijkoptie, een middelpunt zonder label |
| 5. Neutrale formulering | Welke woorden een antwoord uitlokken | Neutrale vraagstammen en evenwichtige optiesets | Bijvoeglijke naamwoorden in de vraagstam, en eenzijdige antwoordlijsten |
| 6. Volgorde en inleiding | Volgorde, groepering en de openingstekst | Een geordend instrument met een korte inleiding | Gevoelige items te vroeg, en een inleiding die niemand leest |
| 7. Pretest en pilotonderzoek | Of het werkt bij echte mensen | Een herzien instrument en een schatting van de invultijd | Het overslaan, of één ronde als genoeg beschouwen |
Stap 3, 4 en 5 staan hier apart omdat ze op verschillende manieren misgaan en met verschillende ingrepen worden hersteld. In de praktijk doorloopt u ze meer dan eens. De stippellijn in het diagram is de lus die het meest telt: wat de pretest vindt, stuurt u meestal terug naar stap 3.
Stap 1. Schrijf de beslissingen op voordat u ook maar één vraag schrijft
De meeste uitgedijde vragenlijsten beginnen bij een onderwerp. Goede vragenlijsten beginnen bij een beslissing. Schrijf, voordat u een item opstelt, de korte lijst op van dingen die u anders zult doen afhankelijk van wat er terugkomt.
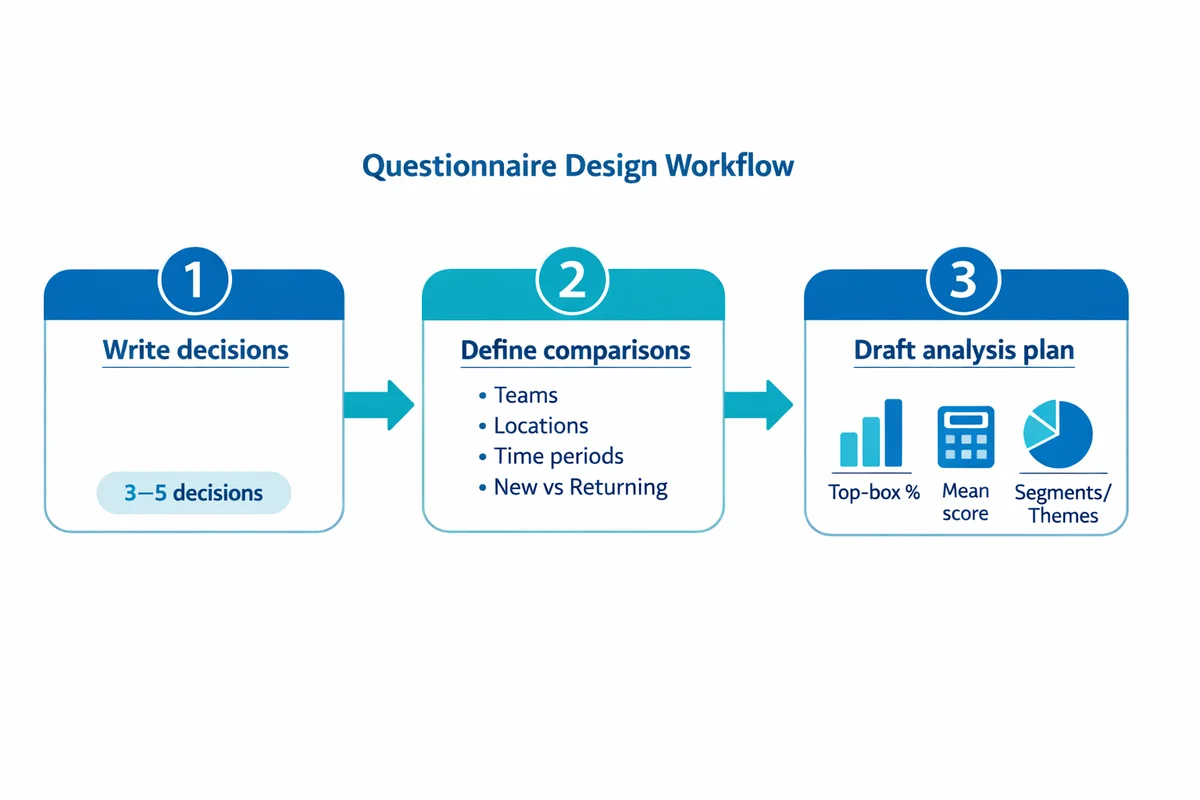
Noteer drie tot vijf beslissingen
Schrijf ze op als keuzes, niet als thema’s. “De tweedaagse opzet herhalen of overstappen op korte online sessies” is een beslissing. “Feedback op de training” is een thema.
Benoem de vergelijkingen die u moet maken
Teams, locaties, diensten, perioden, nieuw versus terugkerend. Vergelijkingen bepalen zowel de formulering als de antwoordopties, dus leg ze nu vast en niet later.
Schets de uitkomsten op één pagina
Schets de tabellen en grafieken die u verwacht te maken. Kunt u de uitkomst die een item voedt niet tekenen, dan heeft dat item geen taak.
Dit is de stap die de methodologische handleidingen vooraan zetten, en om dezelfde reden: het is het enige wat u vertelt wanneer u moet stoppen met vragen toevoegen.16, 17
Lees elk conceptitem en maak deze zin af: “Als iedereen B antwoordt in plaats van A, dan zullen we ...” Lukt dat niet, schrap het item dan of herschrijf het tot het wel lukt.
Stap 2. Maak van elke beslissing één item en kies het formaat bewust
Het vraagformaat is een meetbeslissing, geen kwestie van opmaak. Kies het formaat dat de lezer kan beantwoorden en dat uw geplande uitkomst kan gebruiken.
| Als de uitkomst is | Gebruik | Voorbeeld van een vraagstam |
|---|---|---|
| Een getal dat u in de tijd volgt | Een gesloten beoordelingsitem, volledig gelabeld | “Hoe makkelijk of moeilijk was het om de installatie zonder hulp af te ronden?” |
| Een gerangschikte lijst met verbeterpunten | Eén keuze, daarna één vervolgvraag | “Welke ene verandering zou u het meest helpen?” en dan “Waarom juist die?” |
| Een aantal of een frequentie | Gesloten bereiken die niet overlappen | “Hoe vaak hebt u in de afgelopen 30 dagen contact opgenomen met de klantenservice?” |
| Taal die u nog niet hebt gehoord | Eén gericht open tekstvak | “Wat was de belangrijkste reden dat u vandaag contact opnam?” |
| Geschiktheid voor latere items | Een screeningsvraag plus logica om vragen over te slaan | “Hebt u in de afgelopen 30 dagen het tabblad met rapporten gebruikt?” |
Gesloten items zijn goedkoper om te analyseren en makkelijker te vergelijken tussen meetmomenten. Open items vinden wat uw lijst met opties vergeten is. De praktische reden dat gesloten items overheersen, is de kostprijs: open antwoorden hebben een codeerschema en meer dan één codeur nodig voordat ze iets betekenen.1 Gebruik één of twee open items, op plekken waar ze iets opleveren, en houd de rest gesloten. Onze gidsen over meerkeuzevragen en open en gesloten vragen gaan dieper in op elk formaat.
Eén waarschuwing over instemmingsschalen. Als u iets rechtstreeks kunt vragen, vraag het dan rechtstreeks. In een experiment met vier steekproeven haalden items met constructspecifieke antwoordopties betrouwbaarheidscoëfficiënten van 0,87 tot 0,93, terwijl dezelfde inhoud, gevraagd als stellingen om mee eens of oneens te zijn, slechts 0,36 tot 0,73 haalde.4 Dat is een groot verschil voor een formaat dat de meeste mensen uit gewoonte kiezen. Twee bekende antwoordeffecten verklaren er een groot deel van. Acquiescentie is de neiging om in te stemmen met wat de stelling ook zegt, zodat het formaat een scheefheid toevoegt die u achteraf niet kunt scheiden. Satisficing betekent dat de lezer net genoeg moeite doet voor een antwoord dat ermee door kan, in plaats van een antwoord dat klopt, en een kolom met stellingen om mee eens of oneens te zijn maakt dat heel makkelijk. Beide worden erger naarmate de vragenlijst langer wordt. Hebt u het formaat toch nodig, volg dan onze richtlijnen voor de Likertschaal.
Stap 3. Schrijf een vraagstam die mensen echt kunnen beantwoorden
Veel slechte items zijn niet vaag. Ze zijn onbeantwoordbaar. Ze vragen naar herinneringen die niemand heeft, of naar kennis die de deelnemer nooit heeft gekregen.
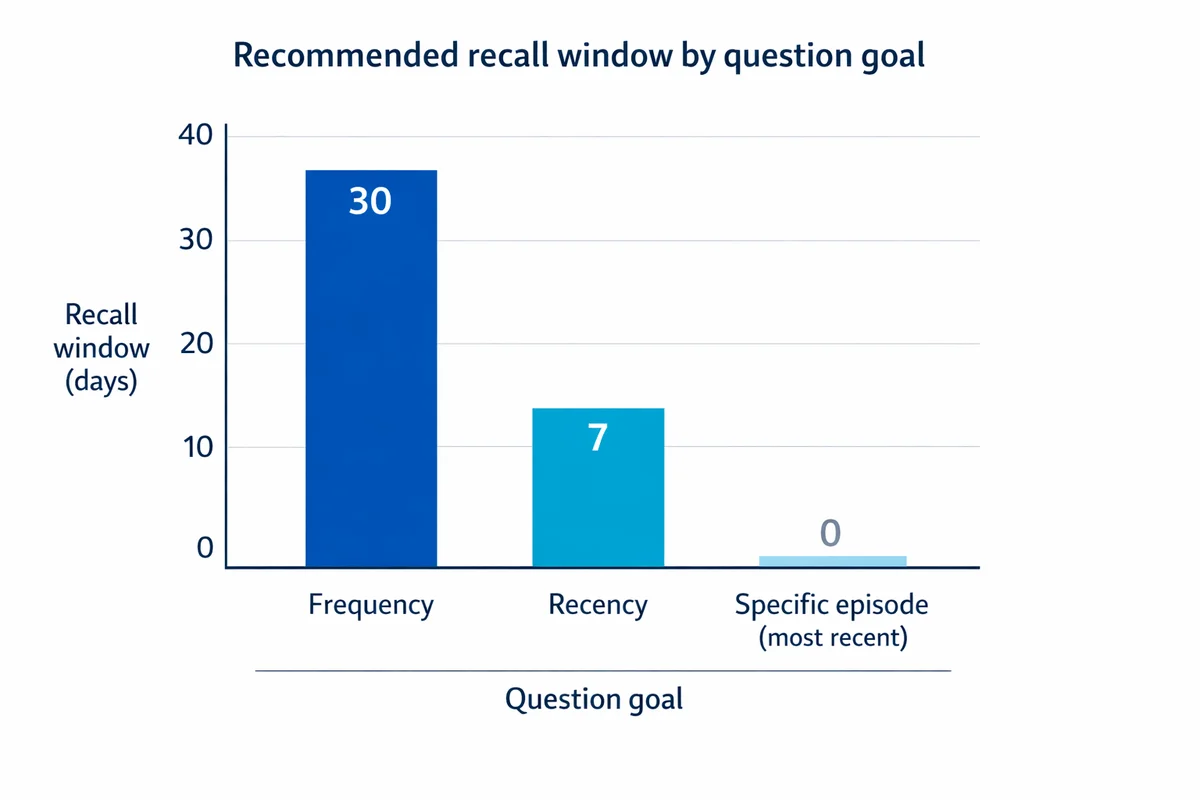
Geef elke vraag over gedrag een periode
“Hoe vaak neemt u contact op met de klantenservice?” heeft geen ankerpunt, dus twee mensen met precies hetzelfde gedrag antwoorden verschillend. Noem de periode en stem die af op hoe vaak het gedrag voorkomt.
| U wilt | Moeilijk te beantwoorden | Beantwoordbaar |
|---|---|---|
| Een frequentie | “Hoe vaak neemt u contact op met de klantenservice?” | “Hoe vaak hebt u in de afgelopen 30 dagen contact opgenomen met de klantenservice?” |
| Recent gedrag | “Sport u regelmatig?” | “Op hoeveel van de afgelopen 7 dagen hebt u minstens 30 minuten gesport?” |
| Eén gebeurtenis | “Verliep de onboarding soepel?” | “Als u terugdenkt aan uw meest recente installatie, hoe makkelijk of moeilijk was het om die zonder hulp af te ronden?” |
Gebruik de woorden van uw lezers
- Kies het gangbare woord. “Hulp” is beter dan “ondersteuning”. “Kopen” is beter dan “aanschaffen”. Eenvoudigere woorden zijn ook makkelijker te vertalen.
- Definieer elk begrip dat u niet kunt vermijden. Draait het item om “incident” of “zaak”, zeg dan in de vraagstam zelf wat daaronder valt.
- Schrijf een afkorting één keer voluit. Gebruik haar daarna opnieuw. Ga er niet van uit dat iedereen uw interne afkortingen kent.
- Vraag wat er gebeurde, niet waarom. Mensen kunnen gebeurtenissen melden. Oorzaken binnen uw organisatie kunnen ze meestal niet melden.
Eén idee per item
Een item dat twee vragen verbergt, levert een antwoord op dat u niet kunt lezen. Iemand die de prijs geweldig vond en de kwaliteit vreselijk, heeft geen eerlijke optie, en wat die persoon ook kiest, u weet niet welke helft de doorslag gaf.
Hoe tevreden bent u over de prijs en de kwaliteit?
Gebruik in plaats daarvan twee items. “Hoe tevreden bent u over de kwaliteit?” en “Hoe tevreden bent u over de prijs?”
Het is goed om hier eerlijk te zijn over het bewijs. Dubbele vragen splitsen is bijna een universele regel, maar de directe experimentele literatuur erachter is mager en recent. De duidelijkste test vond dat een dubbelloops item en de herschreven versie met één idee niet hetzelfde maten, en dat de versie met één idee meer valide was.15 Beschouw de regel als degelijk en goed onderbouwd, niet als een vaststaande bevinding van veertig jaar zoals de formuleringseffecten in stap 5.
Stap 4. Maak antwoordopties en schalen die u kunt analyseren
Veel vragenlijsten gaan mis in de antwoordlijst en niet in de vraagstam. Twee tests vangen het meeste op. Opties mogen niet overlappen, en ze moeten iedereen een eerlijke keuze laten.
Hoe oud bent u? 18 tot 30, 30 tot 40, 40 tot 55, 55 en ouder
Hoe oud bent u? 18 tot en met 29, 30 tot en met 39, 40 tot en met 54, 55 of ouder, Zeg ik liever niet
Beoordelingsschalen
| Keuze | Wat te doen | Waarom |
|---|---|---|
| Aantal punten | Vijf tot zeven voor attitudes | Betrouwbaarheid en validiteit stijgen sterk tot ongeveer zeven punten, vlakken dan af, en de test-hertestbetrouwbaarheid daalt weer boven de tien.5, 1 |
| Labels | Label waar mogelijk elk punt | Kale cijfers worden niet eenduidig gelezen. Twee mensen lezen “6 van 10” verschillend; “Vrij makkelijk” lezen ze allebei hetzelfde. |
| Richting | Houd die overal gelijk | Halverwege de vragenlijst van richting wisselen levert misklikken op die eruitzien als echte meningsveranderingen. |
| Middelpunt | Neem er een op als neutraal een echte positie is | Het weglaten ervan onthult geen verborgen voorkeur. Mensen kiezen dan willekeurig in de buurt van waar het had gestaan.1 |
| Niet van toepassing | Houd dit gescheiden van het middelpunt | Anders worden mensen die het niet kunnen beoordelen als neutraal geteld, wat ongemerkt uw gemiddelde verschuift. |
Middelpunt en “weet niet” zijn geen onafhankelijke schakelaars, al behandelt het meeste advies ze zo. Een optie “weet niet” naast een middelpunt verlaagde het aandeel dat het middelpunt koos met ongeveer 7 tot 17 procentpunten, afhankelijk van het item.6 Met andere woorden: een flink deel van uw neutrale stapel bestaat uit mensen zonder mening, niet uit mensen die in het midden zitten. Beslis over beide opties tegelijk. Onze gids over vragen met een beoordelingsschaal behandelt de details van de opmaak.
Bij één attitude-item koos 15 procent de optie “weet niet” als die werd aangeboden. Bij verwante items in hetzelfde interview zonder die optie gaf maar 3 en 4 procent geen inhoudelijk antwoord, en die antwoorden voorspelden nog steeds hoe mensen later stemden.7 Een makkelijke uitweg wordt gebruikt, en een deel van wat die verzamelt, was een echte mening.
Stap 5. Houd de formulering neutraal en controleer die op bias
Dit is de stap met het meeste bewijs en de grootste gemeten effecten. Experimenten met een gesplitste steekproef hebben resultaten over dezelfde onderliggende mening tientallen procentpunten verschoven, puur door woorden te veranderen.
In de General Social Survey van 1985 zei 65,2 procent van de Amerikanen dat er te weinig werd uitgegeven aan “hulp aan de armen”. Toen dezelfde programma’s het label “welfare” (bijstand) kregen, zei maar 19,8 procent te weinig. Dat is een verschil van 45 punten door één woord, en het werd het jaar erna herhaald met 62,8 tegenover 23,1.2, 3
Framing doet hetzelfde. De steun voor militair ingrijpen in Irak lag op 68 procent en daalde naar 43 procent toen dezelfde vraag eraan toevoegde: “zelfs als dat betekende dat Amerikaanse troepen duizenden slachtoffers zouden kunnen lijden”.8
Dit zijn experimenten met een gesplitste steekproef: twee willekeurige helften van dezelfde enquête, elk met één formulering. Dat ontwerp maakt van “formulering doet ertoe” een meting in plaats van een mening.
Wat u moet schrappen
| Patroon | Sturend | Neutraal |
|---|---|---|
| Bijvoeglijk naamwoord in de vraagstam | “Hoe behulpzaam was onze uitstekende klantenservice?” | “Hoe behulpzaam of onbehulpzaam was onze klantenservice?” |
| Maar één richting aangeboden | “Hoe frustrerend was het aanmelden?” | “Hoe makkelijk of moeilijk was het aanmelden?” |
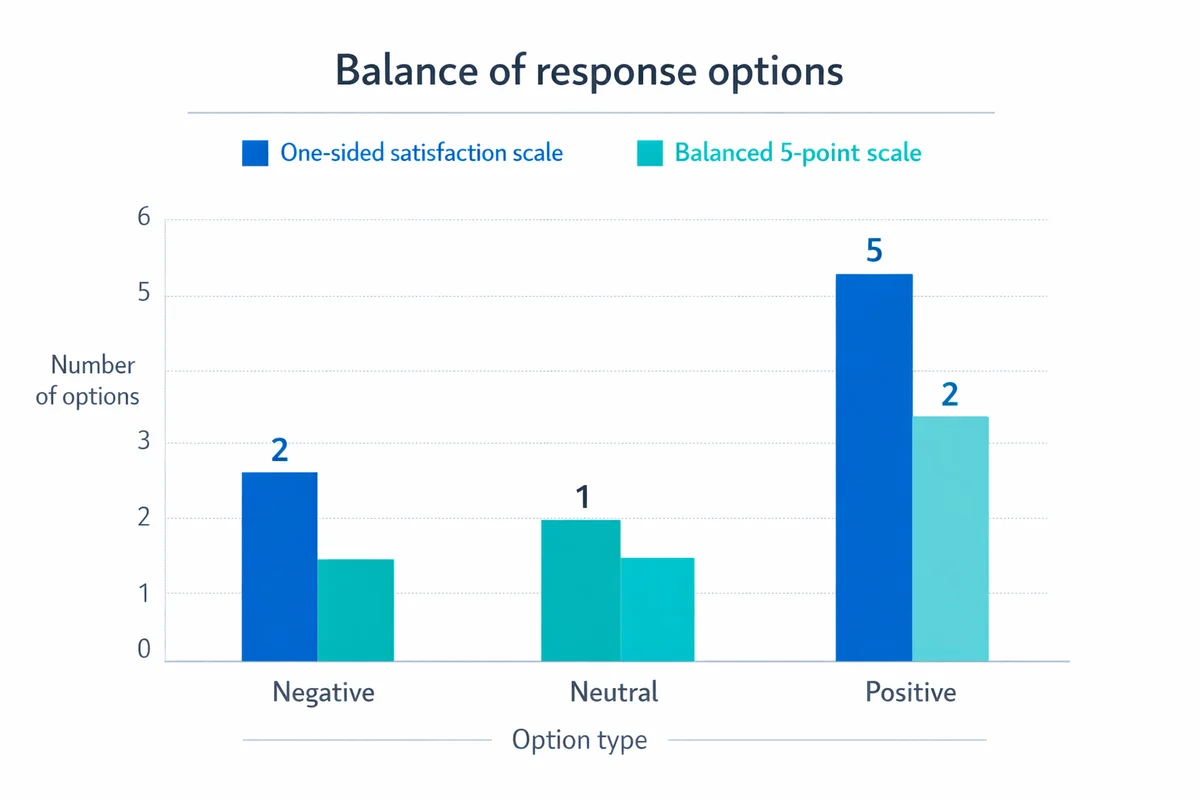
| Eenzijdige antwoordlijst | “Hoe tevreden bent u?” met alleen positieve opties | Evenveel negatieve als positieve opties |
| Verondersteld gedrag | “Hoe gebruikt u het tabblad met rapporten?” | “Hebt u in de afgelopen 30 dagen het tabblad met rapporten gebruikt?” |
Bias komt ook van de deelnemer, niet alleen van de formulering. Drie gewoonten richten de meeste schade aan. Sociale wenselijkheid is antwoorden op de manier die beter overkomt. Acquiescentie is instemmen met wat de stelling ook zegt. Satisficing is net genoeg moeite doen voor een antwoord dat ermee door kan, in plaats van een antwoord dat klopt. Onze gids over responsbias behandelt alle drie.
Stap 6. Bepaal de volgorde van de items en schrijf daarna een korte inleiding
Volgorde is geen cosmetica. Een eerdere vraag kan het antwoord op een latere veranderen, en dat effect is meetbaar. De steun voor wettelijke samenlevingsregelingen voor paren van hetzelfde geslacht was 45 procent wanneer het item volgde op een vraag over het huwelijk, en 37 procent wanneer het op zichzelf stond.9 Aan het item zelf veranderde niets, alleen aan wat ervoor kwam.
Een volgorde die werkt
Screening
Controleer of iemand in aanmerking komt voordat u iets anders vraagt. Stuur alle anderen meteen door naar het einde.
Opwarmvragen
Makkelijke, feitelijke items die laten zien dat de vragenlijst gaat over iets wat de deelnemer herkent.
Kernblokken
Groepeer per onderwerp. Houd de schaal binnen een blok gelijk, zodat niemand die opnieuw hoeft te leren.
Diagnostiek
De redenen en obstakels die de beoordelingen erboven verklaren.
Gevoelige items en segmenten
Als laatste, en alleen de items die u echt gaat gebruiken. Zie demografische vragen voor de formuleringspatronen.
Afsluiting
Eén open vak voor “verder nog iets”, en daarna een bedankje en wat er nu gaat gebeuren.
Een inleiding die u kunt kopiëren
Houd het bij vijf regels. Mensen komen om te antwoorden, niet om te lezen.
Doel: We verzamelen feedback om [proces of dienst] te verbeteren.
Tijd: Ongeveer [X] minuten.
Privacy: Uw antwoorden zijn [anoniem of vertrouwelijk], en [wie] ziet de resultaten.
Vrijwillig: U kunt elke vraag overslaan.
Contact: Vragen? [naam en e-mailadres].
Wees voorzichtig met de tijdsinschatting, want die verandert wie er meedoet. Toen dezelfde vragenlijst werd aangekondigd als 10, 20 of 30 minuten lang, daalde het aandeel mensen dat begon van 75 via 64,9 naar 62,4 procent, en het aandeel van wie begon dat de vragenlijst ook afmaakte van 68,2 via 56,8 naar 46,8 procent.10 Een lengte vermelden is de juiste keuze. Zorg er alleen voor dat het getal uit uw pretest komt.
Zeg duidelijk wie de ruwe antwoorden ziet en hoe lang u ze bewaart, en zorg dat dit overeenkomt met uw werkelijke privacytoezeggingen. Toestemming en duidelijkheid over het doel horen bij het ontwikkelen van een vragenlijst; het is geen papierwerk dat er achteraf aan wordt vastgeschroefd.17
Stap 7. Pretest met mensen, pilotonderzoek met data, en dan lanceren
Hier worden vragenlijsten echt beter. Een pretest vertelt u wat mensen denken dat het item betekent. Een pilotonderzoek vertelt u hoe de data eruitzien wanneer ze het beantwoorden. Het zijn verschillende taken en u hebt ze allebei nodig.16, 19 Bouw het pilotonderzoek in onze gratis enquêtetool en test de vraagvolgorde, de antwoordopties en de vertakkingen op een telefoon voordat u het met uw volledige steekproef deelt.
Lees het hardop
Vraag iemand om elk item hardop voor te lezen. Alles waarover die persoon struikelt, wat opnieuw wordt gelezen of anders wordt verwoord, komt in aanmerking om te herschrijven.
Peil de betekenis
Vraag “wat betekent deze vraag voor u?” en “hoe bent u op dat antwoord gekomen?” U test het begrip, niet de mening.
Neem de tijd op
Noteer hoe lang het echt duurt. Dat getal komt in uw inleiding, en het is meestal langer dan u dacht.
Herschrijf en probeer opnieuw
Bij een nieuw instrument is één ronde zelden genoeg. Herstel, en test de verbeteringen daarna bij iemand nieuws.
Hoeveel pretestinterviews
Meer dan u denkt. Modellering van cognitieve pretestinterviews liet zien dat echte problemen met vragen bleven opduiken naarmate het aantal interviews groeide, zonder een duidelijk plateau waarop u veilig kunt stoppen.14 Zie elk vast aantal als een budget, niet als dekking, en besteed het aan mensen die op uw werkelijke deelnemers lijken.
Waar het pilotonderzoek voor dient
- Dekking van de opties. Als “Anders” of “Zeg ik liever niet” vaak gekozen wordt, mist uw lijst iets.
- Gebruik van de schaal. Antwoorden die zich aan één uiteinde opstapelen, betekenen meestal dat de formulering ze daarheen duwde.
- Straightlining. Overal in een blok hetzelfde antwoord. In paneldata ligt het tussen 15 en 40 procent bij blokken waarin het een aannemelijk patroon is, en onder 2 procent waar dat niet zo is.13
- Logica. Controleer of mensen alleen de vervolgvragen zien die op hen van toepassing zijn.
- Afhaakpunt. Noteer bij welk item mensen afhaken. Meestal is dat item het probleem, niet de lengte.
Dit zijn twee verschillende getallen die twee verschillende vragen beantwoorden, en het ene voor het andere aanzien is een veelgemaakte en dure fout. Dertig mensen is genoeg om een kapotte optielijst bloot te leggen, een vraagstam die niemand op dezelfde manier leest, of een logische vertakking die nooit wordt geactiveerd. Meer hoeft een pilotonderzoek niet te doen. Het is bij lange na niet genoeg om een percentage te schatten of om twee groepen met enige zekerheid van elkaar te onderscheiden. Herstel het instrument met het pilotonderzoek en bepaal daarna apart de omvang van het echte onderzoek met onze gids over steekproefgrootte.
Reken bij de lancering op een bescheiden responspercentage: bij niet-aselecte online panels zijn percentages van 10 procent of lager inmiddels gewoon.21
Een uitgewerkt voorbeeld: één vragenlijst, opgebouwd via alle zeven stappen
Elke gids over dit onderwerp laat zien hoe losse vragen worden verbeterd. Bijna geen enkele laat zien hoe één vragenlijst wordt opgebouwd. Dus hier is een volledige, van de beslissing bovenaan tot het instrument onderaan, met de stappen hierboven op volgorde.
Een operationeel team van ongeveer 40 mensen volgde in mei een tweedaagse veiligheidstraining. Het management moet het formaat voor de volgende ronde kiezen, en niemand heeft data. Dat is de hele opdracht. Doorloop nu de stappen.
| Stap | Wat het hier opleverde |
|---|---|
| 1. Eerst de beslissingen | Drie beslissingen: het tweedaagse formaat houden of overstappen op korte online sessies; welke module als eerste herschrijven; en of het materiaal überhaupt in het werk wordt gebruikt. Alles hieronder is terug te voeren op een van deze drie. |
| 2. Items en formaten | Negen items. Twee gesloten aantallen, twee gelabelde beoordelingen, drie lijsten met één keuze, één gericht open vak, één afsluitend open vak. Eén screeningsvraag bovenaan. |
| 3. Beantwoordbare formulering | Elk item over gedrag kreeg een benoemde periode (“in de 30 dagen sinds de training”). “De checklist” wordt in de vraagstam gedefinieerd in plaats van verondersteld. |
| 4. Opties en schalen | Aantallen gebruiken bereiken die niet overlappen. Beide beoordelingen gebruiken dezelfde vijf punten in dezelfde richting. “Ik heb hem nog niet gebruikt” staat los van het middelpunt. |
| 5. Sturing weghalen | “Hoe nuttig was de uitstekende nieuwe checklist” werd “Hoe nuttig of niet nuttig”. Het item over het formaat biedt beide opties plus “beide” en “geen van beide”, zodat het niet aanstuurt op een voorkeursantwoord. |
| 6. Volgorde en inleiding | Screening, dan gedrag, dan beoordelingen, dan de beslissing over het formaat, dan het obstakel, dan de dienst, dan de open afsluiting. De dienst staat bijna aan het eind omdat het het enige item is dat mensen misschien niet willen beantwoorden. |
| 7. Pretest en pilotonderzoek | Hardop gelezen met vier mensen. Twee lazen “de checklist” als een ander document, dus V2 kreeg de woorden “de checklist van één pagina uit module 2”. Die ene verbetering is het hele argument voor stap 7. |
De afgeronde vragenlijst
Negen items en een screeningsvraag. Kopieer de vragenlijst en verander daarna de zelfstandige naamwoorden. Kopieer niet de tijdsinschatting: die haalt u uit uw eigen hardop-leestest.
Vragenlijst na de training: 10 items
- V0. Hebt u de veiligheidstraining op 12 en 13 mei gevolgd? Eén keuze, screeningEen screeningsvraag, geen opwarmvraag. Wie “Nee” antwoordt, moet meteen naar het einde worden geleid. Zonder deze vraag kunt u een niet-deelnemer niet onderscheiden van een ontevreden deelnemer.
- V1. Hoe vaak hebt u in de 30 dagen sinds de training de checklist van één pagina uit module 2 bij echt werk gebruikt? Eén keuze, aantallenEen benoemde periode en een benoemd document. De bereiken overlappen niet, dus wie hem drie keer gebruikte, kan maar op één plek terecht. Dit item beantwoordt beslissing drie helemaal zelf.
- V2. Hoe makkelijk of moeilijk was de checklist te gebruiken bij echt werk? Beoordeling op vijf punten, volledig gelabeld1Zeer moeilijk2345Zeer makkelijkBeide richtingen staan in de vraagstam, dus er wordt niets gesuggereerd. “Ik heb hem nog niet gebruikt” staat buiten de schaal in plaats van erin, zodat mensen die het niet kunnen beoordelen niet als neutraal worden geteld.
- V3. Welk deel van de training was het moeilijkst te volgen? Eén keuze, met een uitwijkoptieDit item beantwoordt beslissing twee. “Niets was moeilijk te volgen” is net zo belangrijk als de modules: zonder deze optie moet iedereen een probleem noemen dat misschien niet bestaat.
- V4. Waardoor was dat deel moeilijk te volgen? Open tekst, alleen getoond als bij V3 een module is gekozenKort antwoordHet enige open item dat zijn plek verdient. Het richt zich op een specifiek antwoord, de meeste mensen slaan het over, en het is het enige wat u vertelt hoe u de module moet herschrijven.
- V5. Als dezelfde training opnieuw werd gegeven, met welk formaat zou u alles kunnen bijwonen? Eén keuze, evenwichtigHet beslissingsitem. Het vraagt naar aanwezigheid, wat mensen kunnen beantwoorden, in plaats van naar voorkeur, wat uitnodigt tot gokken. “Beide” en “geen van beide” zijn allebei echte antwoorden en allebei bruikbaar.
- V6. Wat zou het voor u moeilijk maken om erbij te zijn? Selecteer alles wat van toepassing is. Meerkeuze, met een uitwijkoptieAlles selecteren kost moeite, dus gebruik het spaarzaam. Hier is het gerechtvaardigd omdat de obstakels zich opstapelen: iemand kan er twee tegelijk hebben, en één antwoord afdwingen zou dat verbergen.
- V7. Hoe waarschijnlijk of onwaarschijnlijk is het dat u deze training aanbeveelt aan iemand in uw team? Beoordeling op vijf punten, dezelfde schaal als V21Zeer onwaarschijnlijk2345Zeer waarschijnlijkDezelfde vijf punten, dezelfde richting als V2. Als u één schaal hergebruikt, hoeft niemand die opnieuw te leren, en kunnen de twee items naast elkaar in dezelfde grafiek staan.
- V8. In welke dienst werkt u meestal? Eén keuze, laat geplaatstBijna aan het eind, omdat het het enige item is dat mensen misschien niet willen beantwoorden. Het staat er alleen omdat het analyseplan diensten vergelijkt. Als dat niet zo was, zou het geschrapt worden.
- V9. Is er nog iets wat we moeten weten voordat we het formaat kiezen? Open tekst, optioneelOptioneelHet afsluitende vak. Het vangt op wat de optielijsten misten, en het is de goedkoopste vroege waarschuwing die u krijgt over een vraag die u had moeten stellen.
De antwoordopties hierboven worden alleen getoond en zijn niet aanklikbaar. Ze zijn een afbeelding van het instrument, geen werkend formulier. Hier wordt niets verzameld. Bij het afdrukken vallen de toelichtingen weg en krijgt u alleen de tien items, zodat “opslaan als PDF” in uw browser er een document van maakt dat u kunt uitdelen.
Dit instrument is geschreven voor het voorbeeld hierboven. Begint u liever niet met een leeg vel, dan kunt u beginnen met een bestaand sjabloon en de items aanpassen aan uw eigen beslissingen.
Een item controleren dat u al hebt geschreven
Plak een vraag waaraan u werkt. Hiermee worden dezelfde controles uitgevoerd die de stappen hierboven beschrijven, en u ziet welke ervan aanslaan. Het is een checklist, geen oordeel: het herkent patronen in de woorden, het kan uw bedoeling niet lezen, en een gemarkeerd item is soms precies het juiste item.
Ontwerp voor het analysebestand, niet voor de presentatie
Deze voorwaarde geldt bij elke stap, en daarom is het niet een van de zeven. Een vragenlijst is ook een dataspecificatie. Als de antwoorden niet zuiver te tellen zijn, hebt u zich weken opschoonwerk op de hals gehaald en een getal dat u niet kunt verdedigen.
- Eén construct per kolom. Als snelheid en nauwkeurigheid u allebei interesseren, meet ze dan met twee items. Samengevoegde constructen zijn later niet meer te scheiden.
- Standaardiseer de perioden. Als u “vorige week” in het ene item en “vorig jaar” in het volgende gebruikt, kunt u de twee onmogelijk in dezelfde grafiek zetten.
- Codeer vooraf alles waarop u gaat groeperen. Afdelingsnamen in vrije tekst komen binnen als veertig spellingen van zes afdelingen. Geef een lijst.
- Bepaal vóór de lancering wat ontbrekend betekent. Overgeslagen, “zeg ik liever niet” en “niet van toepassing” zijn drie verschillende dingen, en ze hebben drie verschillende codes nodig.
Plan de vergelijkingen en de precisie tegelijk. Zelfs een perfect instrument kan geen onderzoek redden dat te weinig antwoorden verzamelde om twee groepen van elkaar te onderscheiden; dat is een kwestie van steekproefgrootte. En het punt waarop een verschil als echt telt, is een kwestie van statistische significantie.
Ontwerp voor mobiel, niet voor de laptop waarop u bouwt
De tweede voorwaarde die voor alle stappen geldt. Ga uit van een telefoon, met een mobiele verbinding, en een onderbreking halverwege.
Telefoons zijn trager dan desktops voor hetzelfde instrument. In een cross-overexperiment waarin dezelfde mensen op beide apparaten antwoordden, was de mediane invultijd 17,7 minuten op een smartphone tegenover 10,5 minuten op een pc.11 Dat is 69 procent langer voor dezelfde inhoud, dus wie een vragenlijst op een laptop timet, timet op het verkeerde apparaat.
De reflexmatige aanname dat antwoorden op een telefoon slechter zijn, klopt maar gedeeltelijk, en het loont om daar precies over te zijn. Eén directe vergelijking vond dat mobiele deelnemers kortere open antwoorden schreven en meer items oversloegen, maar dat juist pc-deelnemers vaker straightlining vertoonden bij rastervragen.12 Het probleem op de telefoon is moeite en onderbreking, geen slordigheid.
- Breek de rasters op. Een brede matrix op een klein scherm is het slechtste patroon dat er bestaat, en daar komt straightlining het meest voor.
- Houd opties kort genoeg om niet af te breken. Opties die twee regels beslaan, zijn niet meer in één oogopslag te vergelijken.
- Toon vervolgvragen alleen als ze van toepassing zijn. Logica om vragen over te slaan haalt meer waargenomen lengte weg dan items schrappen.
- Maak de aanraakvlakken ruim. Keuzerondjes met echte ruimte ertussen, geen dichte stapel.
- Gebruik een voortgangsbalk alleen als die eerlijk is. Een balk die door de logica om vragen over te slaan terugspringt, is erger dan geen balk.
Is een vragenlijst kwalitatief of kwantitatief?
Allebei, afhankelijk van wat u erin zet. Het instrument is niet de methode. Een vragenlijst met gesloten items en vaste opties levert kwantitatieve data op. Een vragenlijst met open vragen levert kwalitatieve data op. De meeste echte instrumenten doen van allebei wat, en de fout is niet de keuze die u maakt, maar dat u geen keuze maakt.
| Ontwerpkeuze | Kwantitatief doel | Kwalitatief doel |
|---|---|---|
| Waar u naar zoekt | Hoeveel, hoe vaak, hoe het verschilt tussen groepen | Waarom, in wiens woorden, en waar u zelf niet aan had gedacht |
| Items | Grotendeels gesloten, formaten vooraf vastgelegd | Grotendeels open vragen met vervolgvragen |
| Regel voor de formulering | Voor iedereen gelijk, zonder uitzonderingen | Consistent, maar een vraag mag uitnodigen tot uitweiden |
| Hoeveel mensen | Genoeg voor de vergelijkingen die u wilt maken | Zoveel dat nieuwe antwoorden geen nieuwe thema’s meer opleveren |
| Wat het oplevert | Aantallen, percentages, verschillen tussen groepen | Gecodeerde thema’s, citaten, hypothesen om hierna te toetsen |
| Het grootste risico | Precieze antwoorden op een slecht geformuleerde vraag | Rijke antwoorden die u niet consequent kunt coderen |
Voor een onderzoeksproject is de gemengde vorm meestal de juiste: een kleine set gesloten items die de meting dragen, en één of twee open vragen die de cijfers verklaren. De stap die het meest verandert, is stap 2, omdat open antwoorden een codeerschema nodig hebben, en codeerschema’s meer dan één codeur nodig hebben voordat iemand ze zou moeten vertrouwen.1 Kiest u de vorm van het onderzoek in plaats van de items, dan hoort die beslissing een niveau hoger thuis, bij de opzet van enquêteonderzoek.
Welke regels bewezen zijn, en welke alleen worden herhaald
Advies over vragenlijsten wordt van pagina naar pagina gekopieerd tot elke regel even vaststaand klinkt. Dat is niet zo. Sommige van deze regels berusten op tientallen jaren experimenten met gesplitste steekproeven. Andere berusten op één recent onderzoek, en een paar van de veelgeciteerde getallen berusten nergens op. Hier ziet u waar elke bewering op deze pagina werkelijk staat.
| Bewering | Het getal | Niveau | Bron |
|---|---|---|---|
| Formulering verandert het resultaat | 65,2% tegenover 19,8% zei dat er “te weinig” werd uitgegeven, voor dezelfde programma’s met het label “hulp aan de armen” of “welfare” | A | Rasinski 1989; Smith 19872, 3 |
| Framing verandert het resultaat | 68% tegenover 43% steun, met en zonder een zinsdeel over slachtoffers | A | Pew Research Center8 |
| Volgorde verandert het resultaat | 45% tegenover 37% steun, hetzelfde item, een andere positie | A | Pew Research Center 20039 |
| Itemspecifieke opties zijn beter dan eens of oneens | Betrouwbaarheid 0,87 tot 0,93 tegenover 0,36 tot 0,73 | A | Saris en collega’s 20104 |
| Opgegeven lengte verandert de deelname | Van wie begon, maakte 68,2%, 56,8% en 46,8% de vragenlijst af bij een opgegeven 10, 20 en 30 minuten | A | Galesic en Bosnjak 200910 |
| Een aangeboden “weet niet” wordt gekozen | 15% koos het; zonder die optie sloeg maar 3% en 4% vergelijkbare items over | A | Gilljam en Granberg 19937 |
| Telefoons kosten meer tijd | 17,7 tegenover 10,5 minuten (mediaan), dezelfde mensen, beide apparaten | A | Antoun en collega’s 201711 |
| Vijf tot zeven schaalpunten | Indices stijgen tot ongeveer 7 punten en vlakken dan af; de betrouwbaarheid daalt weer boven 10 | B | Preston en Colman 20005, 1 |
| Een optie “weet niet” trekt mensen weg van het middelpunt | Het kiezen van het middelpunt daalde met ongeveer 7 tot 17 punten | B | Wetzelhutter 20206 |
| Straightlining komt vaak voor waar het aannemelijk is | 15% tot 40% bij aannemelijke blokken, elders onder 2% | B | Schonlau en Toepoel 201513 |
| Antwoorden op een telefoon zijn niet zomaar slechter | Kortere open antwoorden op mobiel, maar meer straightlining op een pc | B | Mavletova 201312 |
| Dubbelloopse items splitsen | Geen zuiver percentage; de twee versies maten niet hetzelfde | B | Menold 202015 |
| Bij pretesten is er geen veilig punt om te stoppen | Er bleven problemen opduiken naarmate het aantal interviews steeg | B | Blair en Conrad 201114 |
Betekenis van de niveaus: A herhaald experiment of een synthese van de hele literatuur. B één sterk onderzoek. C veel herhaald maar omstreden of niet te herleiden, en daarom heeft niets op deze pagina dat niveau.
Getallen die we bewust niet hebben gebruikt
Elk van deze getallen komt veel voor in advies over vragenlijsten. We hebben ze allemaal tot een bron proberen te herleiden en ze weggelaten.
“De aandachtsspanne is nu 8 seconden, korter dan die van een goudvis”
Gaat terug op een marketingrapport uit 2015 dat een contentfabriek citeerde waarvan de eigen bronnen niet te achterhalen waren toen journalisten ernaar vroegen.24 Ook de vergelijking met de goudvis is verzonnen.
“Vijf tot zeven pretestinterviews vangen 75 tot 85 procent van de problemen”
Dit is een resultaat uit gebruikstests over softwarefouten22 dat is overgeplant op cognitieve interviews. Het echte onderzoek naar enquêtes vond zo’n plateau niet.14
“Het gemiddelde responspercentage van een enquête is [kies een getal]”
Er circuleren minstens vier onverenigbare cijfers, elk met een andere verborgen definitie van wie er werd ondervraagd. Wat wel bestaat, zijn onderbouwde bereiken per type steekproef.21
“Houd het onder de 10 minuten, anders haken mensen af”
De richting klopt, de harde grens niet. De gemeten curve is een gestage helling van 10 tot 30 opgegeven minuten, zonder drempel.10
“Zeven plus of min twee, dus gebruik een 7-puntsschaal”
Het artikel van Miller uit 1956 gaat over het kortetermijngeheugen voor lijsten, niet over hoeveel punten iemand op een schaal kan onderscheiden.23 Het echte bewijs over schaalpunten komt hoe dan ook uit op vijf tot zeven.5
“Dubbelloopse vragen verpesten uw data”
Degelijke regel, mager bewijs. We vonden één gerandomiseerde test die er specifiek over ging, tegenover tientallen voor effecten van formulering en volgorde.15 Dat zeggen we in stap 3 ook, in plaats van te overdrijven.
Randgevallen die vragenlijsten ongemerkt breken
Gevoelige items
Inkomen, gezondheid, prestatieproblemen en alles wat een leidinggevende zou kunnen lezen. Deze items leiden tot meer afhakers en meer onjuiste antwoorden als het vertrouwen laag is. Zet ze laat, zeg in één regel waarom u het vraagt, en bied een echte manier om te weigeren. “Zeg ik liever niet” is data. Een leeg veld niet.
“Niet van toepassing” is niet “neutraal”
Laat mensen die iets niet kunnen beoordelen niet in het midden van uw schaal belanden. Geef ze een aparte optie buiten de schaal, of leid ze met logica om vragen over te slaan langs het item. Anders verschuift uw gemiddelde om een reden die niets met meningen te maken heeft.
Volgorde-effecten binnen een lange lijst
Opties bovenaan een lange lijst worden op een scherm vaker gekozen. Toon merken, redenen en kwesties in willekeurige volgorde, en houd de volgorde alleen vast waar die iets betekent, zoals bij een frequentieladder of een reeks datums.
Ontkenningen
“Bent u het ermee eens dat de onboarding niet moeilijk is?” dwingt de lezer twee ontkenningen te ontrafelen voordat er een antwoord kan komen. Schrijf de positieve versie en laat de schaal de richting dragen.
Vertaling
Vermijd uitdrukkingen, sportmetaforen en lokale afkortingen, want die overleven een vertaling niet en ze sluiten lezers uit voor wie uw taal een tweede taal is. Laat u vertalen, gebruik dan terugvertaling, en laat het nakijken door iemand die het onderwerp kent en niet alleen de taal.
Herhaalde metingen
Wilt u deze ronde vergelijken met de volgende, bevries de formulering dan nu. Als u een item tussen twee metingen verbetert, kan de verandering die u meet uw eigen aanpassing zijn. Houd de oude formulering aan, zet de betere er één meting lang naast, en stap dan over.
De controlechecklist, voordat u iets verstuurt
Checklist voor het controleren van een vragenlijst
- Beslissingen. Elk item is terug te voeren op een beslissing die u in stap 1 hebt opgeschreven.
- Formaten. Het formaat van elk item is gekozen voor de uitkomst die het voedt, niet uit gewoonte.
- Perioden. Elk item over gedrag noemt een periode, en die periode past bij het gedrag.
- Begrippen. Vakjargon wordt in de vraagstam gedefinieerd. Afkortingen worden één keer voluit geschreven.
- Eén idee. Geen item verbergt twee eigenschappen, twee objecten of twee perioden.
- Opties. Bereiken overlappen niet, de lijst dekt de realistische antwoorden en er is een uitwijkoptie.
- Schalen. Dezelfde punten, dezelfde richting, gelabeld, met “niet van toepassing” buiten de schaal.
- Neutrale formulering. Geen bijvoeglijke naamwoorden in de vraagstam, en beide richtingen aangeboden.
- Volgorde. Screening eerst, gevoelige items laat, één schaal per blok.
- Inleiding. Doel, eerlijke tijdsduur, privacy, vrijwillig, contact. Vijf regels.
- Telefoon. Geopend op een echte telefoon, geen brede rasters, geen opties die afbreken.
- Hardop lezen. Iemand buiten het project heeft elk item gelezen en elk item begrepen zoals bedoeld.
- Tijdsduur. Het getal in uw inleiding komt uit die hardop-leestest, niet uit een gok.
- Codes. Overgeslagen, geweigerd en niet van toepassing hebben drie aparte codes.
Veelgestelde vragen
Wat is de eerste stap bij het opstellen van een vragenlijst?
De beslissingen opschrijven die de resultaten moeten onderbouwen. Niet het onderwerp, de beslissingen. Zolang u niet kunt zeggen wat u anders zult doen afhankelijk van de antwoorden, kunt u een noodzakelijk item niet onderscheiden van een optioneel item, en groeit het concept tot iemand er genoeg van heeft.
Wat is het verschil tussen een vragenlijst en een enquête?
De vragenlijst is het instrument: de lijst met items en hun antwoordopties. De enquête is het hele onderzoek eromheen, inclusief wie u ondervraagt, hoe u die mensen bereikt, hoeveel u er nodig hebt en wat u met de resultaten doet. U kunt één enquête houden met meerdere vragenlijsten, en dezelfde vragenlijst in meerdere enquêtes gebruiken.
Hoeveel vragen moet een vragenlijst hebben?
Zo weinig als uw beslissingen vereisen. Op een streefaantal mikken is de verkeerde aanpak; mik in plaats daarvan op een invultijd, en haal die tijd uit uw eigen hardop-leestest in plaats van uit een vuistregel. De opgegeven lengte bepaalt mee wie er meedoet: in een gecontroleerd experiment daalde het aandeel van wie begon dat de vragenlijst ook afmaakte van 68,2 procent bij een opgegeven 10 minuten naar 46,8 procent bij een opgegeven 30 minuten.
Hoe lang mag het invullen van een vragenlijst duren?
Kort genoeg dat de opgegeven tijd mensen niet afschrikt, en eerlijk genoeg dat die met de werkelijkheid overeenkomt. Er is geen minuut waarna de deelname ineens instort. De gemeten relatie is een gestage daling van de deelname naarmate de opgegeven lengte stijgt, dus elk item dat u houdt, kost u een beetje respons, en u moet kunnen zeggen wat elk item oplevert.
Is een vragenlijst kwalitatief of kwantitatief?
Het kan allebei zijn, en de meeste zijn een beetje van beide. Gesloten items met vaste opties leveren kwantitatieve data op. Open vragen leveren kwalitatieve data op. Waar het om gaat, is dat u vóór het schrijven bepaalt waarvoor een item dient, want de twee vragen om andere formuleringsregels, andere aantallen deelnemers en een totaal andere analyse.
Moet ik een neutraal middelpunt opnemen in een beoordelingsschaal?
Neem er een op als “neutraal” een echte positie is ten opzichte van wat u meet. Het weglaten ervan dwingt geen verborgen mening af; mensen kiezen dan min of meer willekeurig tussen de punten die het dichtst bij het midden liggen. Beslis bovendien tegelijk over het middelpunt en een optie “weet niet”, want een aangeboden “weet niet” verlaagt het gebruik van het middelpunt met ongeveer 7 tot 17 procentpunten.
Wanneer bied ik een optie “Weet niet” aan?
Als de deelnemer de informatie misschien echt niet heeft, zoals de naam van een pakket, een datum of een technisch detail. Vermijd het bij vragen over iemands eigen ervaring, waar bijna iedereen kan antwoorden. Een makkelijke uitweg wordt gebruikt: bij één attitude-item koos 15 procent “weet niet” als die optie werd aangeboden, terwijl maar 3 tot 4 procent vergelijkbare items zonder die optie oversloeg.
Hoeveel open vragen moet ik gebruiken?
Eén of twee, op plekken waar ze iets opleveren: meestal als vervolg op een specifiek gesloten antwoord en als afsluitend vangnet. Open antwoorden zijn de enige manier om te horen wat uw optielijst vergat, maar ze hebben een codeerschema en meer dan één codeur nodig voordat de resultaten iets betekenen, en die kosten zijn echt.
Hoe test u een vragenlijst voordat u die verstuurt?
In twee rondes. Een pretest controleert het begrip: laat mensen elk item hardop lezen en u vertellen wat ze denken dat het betekent en hoe ze hun antwoord kozen. Een pilotonderzoek is een kleine echte afname die de data controleert: afhaakpunten, dekking van de opties, gedrag op de schaal en of uw geplande analyse echt werkt. Doe de pretest eerst, want die verandert de formulering.
Welk type onderzoeksopzet gebruikt een vragenlijst?
Een vragenlijst is een instrument voor dataverzameling, geen onderzoeksopzet, dus komt hij in meerdere opzetten voor. Cross-sectioneel onderzoek gebruikt er een op één moment. Trend- en panelonderzoek herhalen er een in de tijd. Experimenten gebruiken er een om uitkomsten na een manipulatie te meten. Daartussen kiezen is een beslissing over de onderzoeksopzet die een niveau boven de formulering van de items ligt.
Hoe valideert u een vragenlijst?
Een paar nieuwe items die iets concreets meten, hebben een pretest nodig, geen psychometrische validatie. Een schaal die iets abstracts moet meten en tussen groepen moet worden vergeleken of door anderen hergebruikt, heeft meer nodig: een inhoudelijke beoordeling door experts, een pilotonderzoek dat groot genoeg is om te controleren of de items samenhangen, en bewijs dat de scores op de voorspelde manier samenhangen met iets externs. Bestaat er al een gevalideerd instrument voor uw construct, gebruik dat dan in plaats van zelf een te schrijven.
Hoe deze gids tot stand kwam, en wat hij niet behandelt
De volgorde in zeven stappen volgt het ontwikkelproces dat de methodologische literatuur over vragenlijsten beschrijft16, 17, 18, 20, en niet het raamwerk van één bepaalde leverancier. Elk getal dat op deze pagina wordt genoemd, komt uit een gepubliceerd experiment of een officieel methodologisch rapport, die hieronder staan. Elk getal kreeg vóór gebruik een niveau, en dat niveau staat naast de bewering in de tabel met bewijs.
Beweringen die we niet tot een primaire bron konden herleiden, zijn weggelaten, en de meest voorkomende daarvan staan onder “getallen die we bewust niet hebben gebruikt”, zodat u ze elders herkent. Waar een regel degelijk is maar het directe bewijs mager, zoals bij het splitsen van dubbelloopse items, zegt de pagina dat in plaats van zekerheid te lenen van een sterkere bevinding.
Het meeste experimentele bewijs hier komt uit enquêtes in de Verenigde Staten en West-Europa, grotendeels bij steekproeven uit de algemene bevolking en uit webpanels. Effectgroottes voor formulering en volgorde gelden niet ongewijzigd voor elke taal, elk onderwerp of elke populatie, en niets ervan is getest bij uw deelnemers. Zie de getallen als bewijs dat deze effecten echt bestaan en groot kunnen zijn, niet als constanten die u kunt invullen.
Het uitgewerkte voorbeeld is een geconstrueerde casus, gemaakt om alle zeven stappen op één plek te laten zien. Het is geen verslag van echt onderzoek, en de beschreven pretest dient ter illustratie.
Deze pagina behandelt het instrument. Ze behandelt niet wie u ondervraagt, hoeveel mensen u ondervraagt of hoe u analyseert wat er terugkomt. Dat zijn aparte taken, die aan bod komen bij steekproeftrekking, steekproefgrootte en statistische significantie.
SuperSurvey maakt enquêtesoftware, dus we hebben er commercieel belang bij dat mensen enquêtes houden. Deze gids is gratis te lezen en het advies geldt voor elk enquêteplatform. De itemcontrole draait volledig in uw browser en verstuurt niets. De links naar onze enquêtetool en sjabloonbibliotheek bieden manieren om de vragenlijst in de praktijk te brengen.
Bronnen
- Krosnick, J. A., & Presser, S. (2010). Question and questionnaire design. In P. V. Marsden & J. D. Wright (red.), Handbook of Survey Research (2e druk, hfst. 9). Emerald.
- Rasinski, K. A. (1989). The effect of question wording on public support for government spending. Public Opinion Quarterly, 53(3), 388-394. doi.org/10.1086/269158
- Smith, T. W. (1987). That which we call welfare by any other name would smell sweeter. Public Opinion Quarterly, 51(1), 75-83. doi.org/10.1086/269015
- Saris, W. E., Revilla, M., Krosnick, J. A., & Shaeffer, E. M. (2010). Comparing questions with agree/disagree response options to questions with item-specific response options. Survey Research Methods, 4(1), 61-79. doi.org/10.18148/srm/2010.v4i1.2682
- Preston, C. C., & Colman, A. M. (2000). Optimal number of response categories in rating scales. Acta Psychologica, 104(1), 1-15. doi.org/10.1016/S0001-6918(99)00050-5
- Wetzelhutter, D. (2020). Scale-sensitive response behavior: consequences of offering versus omitting a "don't know" option and/or a middle category. Survey Practice, 13(1). doi.org/10.29115/SP-2020-0012
- Gilljam, M., & Granberg, D. (1993). Should we take don't know for an answer? Public Opinion Quarterly, 57(3), 348-357. doi.org/10.1086/269380
- Pew Research Center. Writing survey questions. Uitleg over methoden. pewresearch.org/writing-survey-questions
- Pew Research Center (2003, 18 november). Religious beliefs underpin opposition to homosexuality, Part 2: Gay marriage. pewresearch.org/politics/2003/11/18/part-2-gay-marriage
- Galesic, M., & Bosnjak, M. (2009). Effects of questionnaire length on participation and indicators of response quality in a web survey. Public Opinion Quarterly, 73(2), 349-360. doi.org/10.1093/poq/nfp031
- Antoun, C., Couper, M. P., & Conrad, F. G. (2017). Effects of mobile versus PC web on survey response quality. Public Opinion Quarterly, 81(S1), 280-306. doi.org/10.1093/poq/nfw088
- Mavletova, A. (2013). Data quality in PC and mobile web surveys. Social Science Computer Review, 31(6), 725-743. doi.org/10.1177/0894439313485201
- Schonlau, M., & Toepoel, V. (2015). Straightlining in web survey panels over time. Survey Research Methods, 9(2), 125-137. doi.org/10.18148/srm/2015.v9i2.6128
- Blair, J., & Conrad, F. G. (2011). Sample size for cognitive interview pretesting. Public Opinion Quarterly, 75(4), 636-658. doi.org/10.1093/poq/nfr035
- Menold, N. (2020). Double barreled questions: an analysis of the similarity of elements and effects on measurement quality. Journal of Official Statistics, 36(4), 855-886. doi.org/10.2478/jos-2020-0041
- Rattray, J., & Jones, M. C. (2007). Essential elements of questionnaire design and development. Journal of Clinical Nursing, 16(2), 234-243. doi.org/10.1111/j.1365-2702.2006.01573.x
- Boparai, J. K., Singh, S., & Kathuria, P. (2019). How to design and validate a questionnaire: a guide. Current Clinical Pharmacology, 13(4), 210-215. doi.org/10.2174/1574884713666180807151328
- Slattery, E. L., Voelker, C. C. J., Nussenbaum, B., Rich, J. T., Paniello, R. C., & Neely, J. G. (2011). A practical guide to surveys and questionnaires. Otolaryngology-Head and Neck Surgery, 144(6), 831-837. doi.org/10.1177/0194599811399724
- Edwards, P. (2010). Questionnaires in clinical trials: guidelines for optimal design and administration. Trials, 11, 2. doi.org/10.1186/1745-6215-11-2
- Stone, D. H. (1993). Design a questionnaire. BMJ, 307(6914), 1264-1266. pmc.ncbi.nlm.nih.gov/articles/PMC1679392
- American Association for Public Opinion Research (2022). Data quality metrics for online samples: considerations for study design and analysis. Rapport van een taskforce. rapport van de taskforce op aapor.org (PDF)
- Nielsen, J., & Landauer, T. K. (1993). A mathematical model of the finding of usability problems. Proceedings of ACM INTERCHI '93, 206-213. doi.org/10.1145/169059.169166
- Miller, G. A. (1956). The magical number seven, plus or minus two. Psychological Review, 63(2), 81-97. doi.org/10.1037/h0043158
- Maybin, S. (2017, 10 maart). Busting the attention span myth. BBC News. bbc.com/news/health-38896790
Elke DOI hierboven is op 21 augustus 2026 gecontroleerd via de DOI-resolver, en van elke link is gecontroleerd of die nog werkt.