
La taille de l’échantillon d’une enquête est le nombre de participations complètes incluses dans votre analyse, notée n. Elle diffère du nombre d’invitations ou de personnes figurant sur votre liste. Selon les hypothèses d’échantillonnage du calculateur, un échantillon plus grand réduit la marge d’erreur ; il ne supprime ni un recrutement biaisé ni des questions mal formulées.
Calculateur de taille de l’échantillon
Rien n’est soumis à inscription et rien n’est envoyé nulle part. Le calculateur fonctionne dans votre navigateur, s’ouvre avec un exemple déjà calculé à l’écran, et affiche la formule et les calculs utilisés pour que vous puissiez les vérifier ou les refaire à la main.
De combien de participations ai-je besoin ?
Renseignez vos six paramètres. La réponse, la formule et les calculs se mettent à jour pendant la saisie.
Participations complètes nécessaires
370
Après la correction pour population finie.
Personnes à inviter
1,234
Avec un taux de réponse de 30 %.
Taux de sondage
3.7%
Part de la population dont il vous faut la réponse.
Total, calculé par sous-groupe
370
Les calculs, étape par étape
| Marge d’erreur | Participations nécessaires | Invitations nécessaires |
|---|
En participations, le coût d’une précision plus fine croît à peu près comme le carré de l’amélioration. Diviser la marge d’erreur par deux multiplie l’échantillon par quatre environ.
Le bouton de copie rédige un court paragraphe de méthodologie avec vos chiffres, la formule et la référence, prêt à coller dans un cahier des charges ou un chapitre de méthodologie.
Citer ce calculateur : Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Le résultat correspond à des participations complètes, pas à des invitations. C’est le nombre dont vous devez disposer à la fin du terrain. Le nombre d’invitations est ce chiffre divisé par le taux de réponse attendu, et c’est là que la plupart des plans d’échantillonnage se trompent. Une fois l’objectif fixé, créez votre enquête et testez-la dans une enquête pilote auprès du public visé. Servez-vous de l’enquête pilote pour vérifier la formulation et estimer le taux de passage de l’invitation à la participation complète pour votre propre projet.
Ce qu’est la taille de l’échantillon
La taille de l’échantillon est le nombre de personnes qui terminent votre enquête. Elle est notée n dans toutes les formules de cette page ; c’est la seule grandeur que vous achetez par le terrain au lieu de la choisir sur le papier, et c’est le chiffre à partir duquel votre marge d’erreur est calculée.
Trois nombres sont souvent confondus avec elle, et les distinguer constitue l’essentiel d’un plan d’échantillonnage :
- Population (N) : toutes les personnes que vous voulez décrire. Une liste de clients, un effectif, un pays.
- Invitations : le nombre de personnes que vous contactez. Toujours supérieur à n, car tout le monde ne répond pas.
- Taille de l’échantillon (n) : le nombre de participations complètes dont vous disposez à la fin du terrain. C’est le nombre que la formule calcule, et le seul des trois qui modifie votre marge d’erreur.
La taille de l’échantillon vous apporte de la précision, c’est-à-dire la largeur de la fourchette en plus ou en moins autour de chaque résultat. Elle ne vous apporte pas l’exactitude, c’est-à-dire le fait que les personnes qui ont répondu ressemblent à celles qui n’ont pas répondu. Un grand échantillon de commodité peut être plus éloigné de la réalité qu’un petit échantillon aléatoire, et aucune valeur de n n’y remédie. Où la planification de la taille de l’échantillon déraille explique la différence, et la façon dont vous tirez l’échantillon est ce qui en décide.
La réponse courte, si vous voulez seulement un chiffre
Chiffres clés
- 385 participations complètes est la réponse par défaut. C’est ce que donne la formule avec un niveau de confiance de 95 %, une marge d’erreur de plus ou moins 5 points de pourcentage et aucune estimation préalable du résultat.
- Les petites populations en demandent beaucoup moins. Une liste de 1 000 personnes en demande 278. Une liste de 100 en demande 80. C’est l’effet de la correction pour population finie.
- La précision coûte cher. Diviser la marge d’erreur par deux multiplie l’échantillon par quatre environ. Passer de plus ou moins 5 points à plus ou moins 1 point vous fait passer de 385 à 9 604.
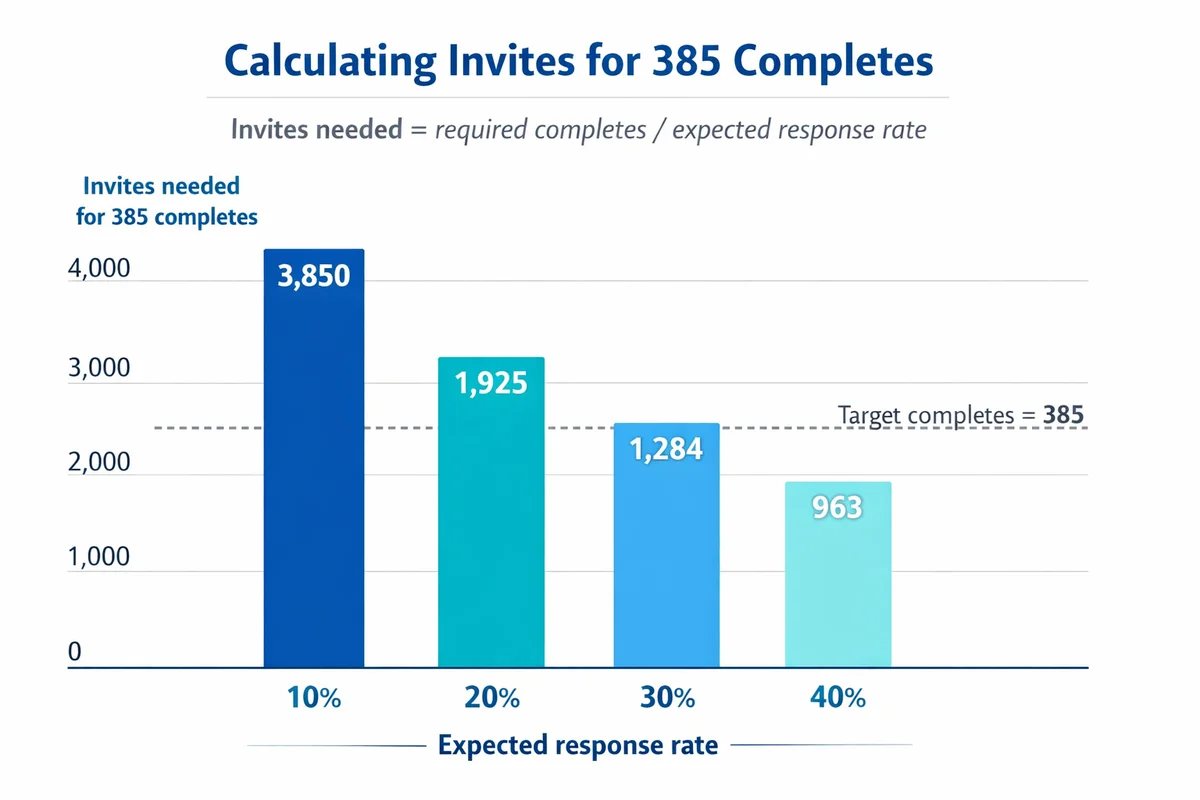
- Les formules comptent les participations complètes, pas les invitations. Le nombre d’invitations nécessaires est égal au nombre de participations complètes divisé par le taux de réponse attendu. À 30 %, 385 participations complètes impliquent d’inviter 1 284 personnes.
- La marge d’erreur ne couvre qu’un type d’erreur. Elle mesure le bruit dû au fait d’interroger certaines personnes plutôt que toutes. Elle ne dit rien des personnes qui n’ont jamais répondu.
La formule de la taille de l’échantillon, et comment la calculer à la main
Pour une enquête qui présente un pourcentage, le point de départ standard est la taille de l’échantillon pour une population assez grande pour être considérée comme illimitée :
n0 = (z^2 x p x (1 - p)) / E^2
De gauche à droite :
- n0 est le nombre de participations complètes nécessaires, avant toute correction pour la population.
- z est le score z correspondant à votre niveau de confiance. Prenez 1,96 pour 95 %.
- p est la proportion que vous vous attendez à mesurer, exprimée en décimal. Prenez 0,5 si vous ne la connaissez pas.
- E est la marge d’erreur exprimée en décimal. Cinq points de pourcentage correspondent à 0,05.
Le symbole de la taille de l’échantillon est n. Certaines sources notent le chiffre non corrigé n0 et le chiffre corrigé n, ce qui est la convention adoptée ici.
| Niveau de confiance | z | Ce qu’il vous coûte |
|---|---|---|
| 80 % | 1.282 | 165 participations complètes à plus ou moins 5 points |
| 90 % | 1.645 | 271 participations complètes |
| 95 % (standard) | 1.960 | 385 participations complètes |
| 99 % | 2.576 | 664 participations complètes |
| 99,9 % | 3.291 | 1 084 participations complètes |
Exemple détaillé : de 385 à une liste d’invitations
Scénario. Vous voulez connaître le pourcentage de clients qui vous recommanderaient. Vous visez un niveau de confiance de 95 % et une marge de plus ou moins 5 points. Vous n’avez pas d’estimation préalable, donc p = 0,5.
Choisissez votre niveau de confiance et votre marge d’erreur
Un niveau de confiance de 95 % donne z = 1,96. Plus ou moins 5 points de pourcentage correspond à E = 0,05.
Choisissez un résultat attendu
p = 0,5, car il n’y a pas d’estimation préalable et 0,5 donne l’échantillon le plus grand. Rien de ce que vous apprendrez ensuite ne pourra vous laisser en deçà.
Appliquez la formule de la taille de l’échantillon
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Arrondissez au supérieur : 385 participations complètes. Arrondissez toujours au supérieur. On ne peut pas recueillir une fraction d’enquête.
Corrigez pour une petite population
Si ces clients forment une liste de 1 000 personnes plutôt qu’un marché ouvert, appliquez la correction : n = 384,16 / (1 + 383,16 / 1 000) = 384,16 / 1,38316 = 277,7, soit 278 participations complètes. La correction ne joue que lorsque l’échantillon représente une part importante de la population.
Convertissez les participations complètes en invitations
Avec un taux de réponse de 30 %, invitations = 278 / 0,30 = 926,7 ; invitez donc 927 personnes. Les participations complètes sont ce que la formule calcule. Les invitations sont ce que vous envoyez réellement, et elles ne peuvent jamais dépasser la population dans laquelle vous tirez.
À un niveau de confiance de 95 % avec p = 0,5, toute la formule se réduit à 0,9604 divisé par E au carré. Ce seul raccourci répond en une ligne à la plupart des questions de taille d’échantillon, et c’est pourquoi 385 revient sans cesse dans les tables de taille d’échantillon que vous trouverez ailleurs.
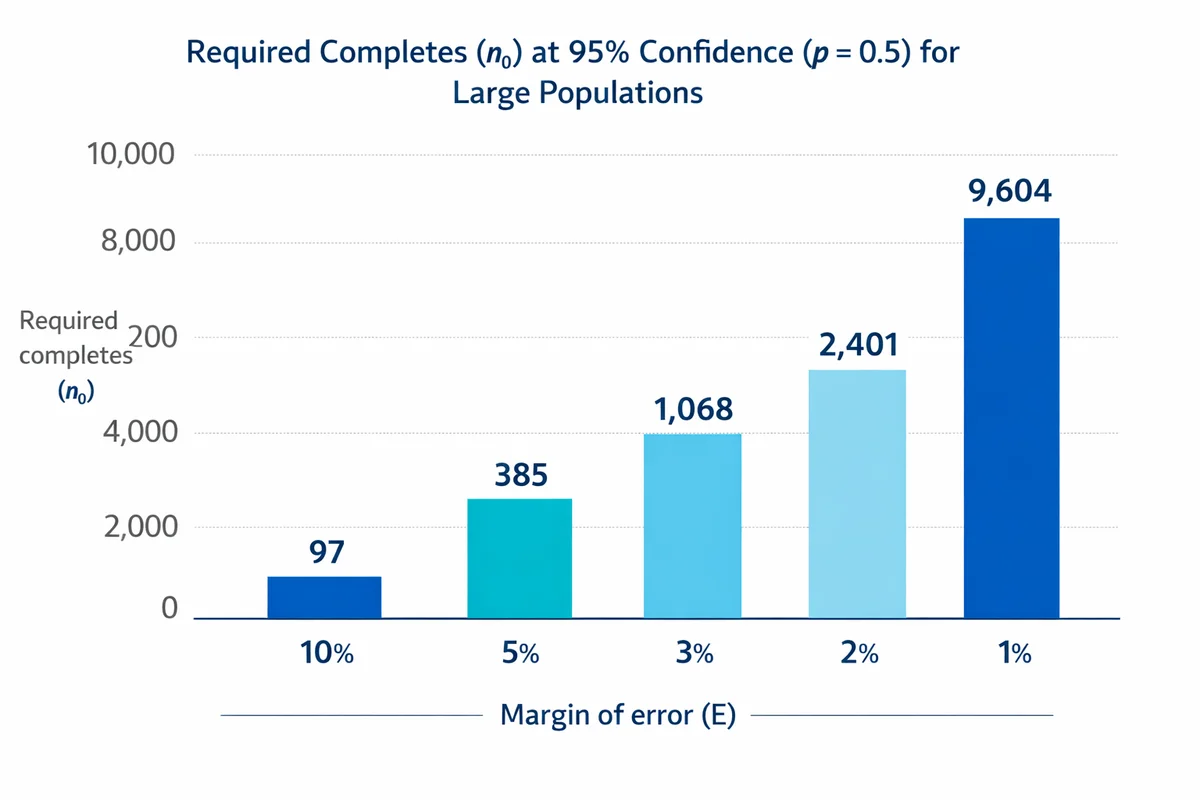
Table de taille de l’échantillon pour les tailles de population courantes
Ces chiffres sont calculés avec la formule ci-dessus à un niveau de confiance de 95 %, plus ou moins 5 points et p = 0,5, puis corrigés pour la population. Les deux dernières colonnes sont notre propre vérification par rapport à la table publiée par Krejcie et Morgan en 1970, celle que citent la plupart des chapitres de méthodologie.
| Population (N) | Participations nécessaires | Krejcie et Morgan (1970) | Écart |
|---|---|---|---|
| 10 | 10 | 10 | identique |
| 25 | 24 | absent | |
| 50 | 45 | 44 | 1 de plus |
| 100 | 80 | 80 | identique |
| 200 | 132 | 132 | identique |
| 500 | 218 | 217 | 1 de plus |
| 1,000 | 278 | 278 | identique |
| 2,000 | 323 | 322 | 1 de plus |
| 5,000 | 357 | 357 | identique |
| 10,000 | 370 | 370 | identique |
| 50,000 | 382 | 381 | 1 de plus |
| 100,000 | 383 | 384 | 1 de moins |
Comment nous avons vérifié. Nous avons appliqué la formule à 21 tailles de population et comparé chaque résultat à la valeur publiée par Krejcie et Morgan. Douze correspondaient exactement. Les neuf autres différaient d’exactement une participation, ce qui tient à l’endroit où chaque méthode arrondit, et non à un désaccord sur le calcul. Si un directeur de recherche vous demande pourquoi votre chiffre diffère d’une unité de la table, voilà la raison.
Bon à savoir si vous citez cette table : Krejcie et Morgan n’ont pas établi leur propre formule. Leur article de 1970 compte environ 400 mots et une table, et son unique référence attribue la formule à un bulletin de recherche de 1960 de la National Education Association. Leur propre résumé du phénomène reste la meilleure description en une ligne : à mesure que la population augmente, l’échantillon nécessaire croît de moins en moins vite et se stabilise à un peu plus de 380 cas.
Choisir vos paramètres, un par un
Quatre nombres déterminent la réponse. Trois d’entre eux sont des décisions, pas des faits, et chacun peut être choisi de façon défendable.
Niveau de confiance : à quelle fréquence la méthode est juste
Le niveau de confiance décrit la méthode, pas cette enquête en particulier. À un niveau de confiance de 95 %, les intervalles construits de cette façon contiennent la vraie valeur 95 fois sur 100 à long terme. Ce n’est pas une probabilité de 95 % que votre réponse précise soit correcte.
Prenez 95 % sauf si vous avez une raison de faire autrement. Passer à 99 % fait monter l’échantillon de 385 à 664 pour la même précision, soit un surcoût de 72 % pour un gain minime. La notion voisine dans les tests d’hypothèse est le seuil alpha, d’où la confusion fréquente entre les deux. Si cette distinction vous paraît floue, lisez la significativité statistique et ce que signifient les valeurs p avant de choisir un chiffre.
Marge d’erreur : la variable de décision
C’est le paramètre auquel il faut le plus réfléchir, car c’est le seul qui relie l’échantillon à une décision. Choisissez-le en vous demandant quel écart changerait ce que vous faites.
Si vous agissez différemment selon que la satisfaction est de 72 % ou de 74 %, il vous faut une marge serrée. Si vous n’agissez qu’entre 72 et 82, plus ou moins 5 points suffit largement. Les résultats globaux s’en tiennent généralement à 5 points pour un baromètre ponctuel ou à 3 points pour un suivi. En dessous de 2 points, le coût grimpe vite.
Taille de la population : presque sans importance, sauf quand elle compte
Pour les grandes populations, l’échantillon nécessaire bouge à peine. Dix mille personnes demandent 370 participations. Cent mille en demandent 383. La taille de la population ne joue que lorsque votre échantillon en représente une part significative, comme pour les listes de salariés, les registres de membres et les promotions scolaires. C’est l’objet de la section suivante.
Résultat attendu (p) : prenez 0,5 si vous ne savez pas
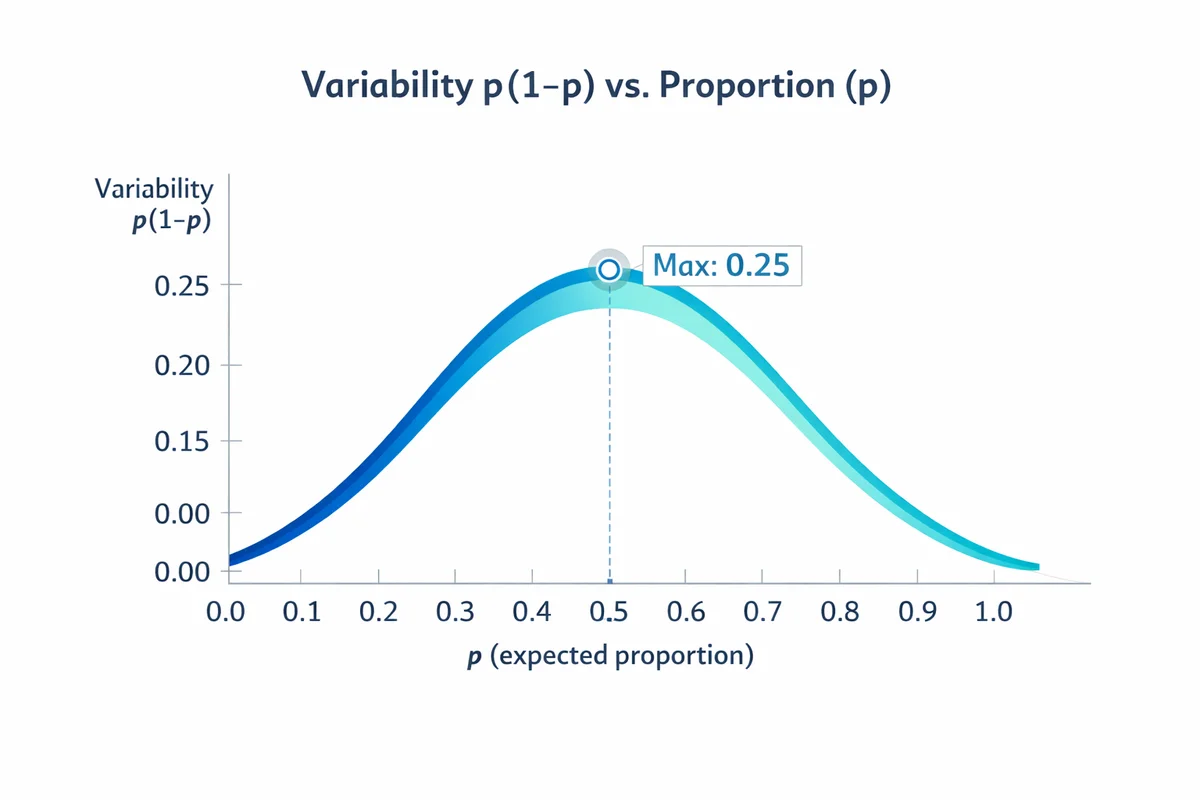
Pour une question en pourcentage, l’incertitude dépend de p multiplié par (1 moins p). Ce terme est maximal pour p = 0,5 ; 0,5 est donc le choix prudent et donne l’échantillon le plus grand. C’est la bonne valeur par défaut lorsque vous n’avez aucune estimation préalable.
Si vous en avez une, utilisez-la, car l’économie est importante. À un niveau de confiance de 95 % et plus ou moins 5 points, p = 0,5 demande 385 participations et p = 0,9 en demande 139. Des enquêtes précédentes, une enquête pilote ou une référence publiée sont autant de sources valables pour cette estimation. Des questions mal comprises élargissent aussi la dispersion ; une formulation plus claire peut donc stabiliser un résultat sans aucune participation supplémentaire. Mieux rédiger vos questions d’enquête coûte souvent moins cher que d’en recueillir davantage.
Petites populations : la correction pour population finie
La formule de base suppose que vous tirez dans un réservoir assez profond pour que le fait d’en retirer des personnes ne change rien. Dès que votre échantillon représente une vraie part de la population, cette hypothèse vous fait payer trop cher. La correction pour population finie vous rend des participations.
n = n0 / (1 + ((n0 - 1) / N))
- n est le nombre corrigé de participations complètes nécessaires.
- n0 est le chiffre non corrigé issu de la formule ci-dessus.
- N est la taille de la population.
Le seuil habituel est que n0 dépasse environ 5 % de N. En dessous, la correction ne change presque rien et ne vaut pas la peine d’être expliquée.
Exemple détaillé : une enquête auprès des salariés
Scénario. Vous avez 1 200 salariés. Vous visez un niveau de confiance de 95 %, plus ou moins 5 points, et vous prenez p = 0,5.
- Sans correction, n0 = 384,16.
- Avec correction : n = 384,16 / (1 + (383,16 / 1 200)) = 384,16 / 1,3193 = 291,2.
- Arrondissez au supérieur : 292 participations complètes.
Sans la correction, vous chercheriez à obtenir 385 participations sur une liste de 1 200 personnes, soit 32 % de l’effectif. Avec elle, 292 suffisent pour la même précision. Sur une liste de cette taille, c’est un mois de relances que vous n’avez pas à faire.
En dessous d’environ 200 personnes, l’échantillon corrigé représente une part si importante de la liste qu’inviter tout le monde est plus simple et plus défendable. Un recensement de 150 personnes n’a aucune erreur d’échantillonnage. Vos efforts portent alors sur le taux de réponse et sur les absents, et c’est là qu’ils doivent porter.
Marge d’erreur : la même formule, prise à l’envers
La marge d’erreur est la fourchette en plus ou en moins autour d’un résultat d’enquête qui vient du fait d’avoir interrogé certaines personnes plutôt que toutes. Si 62 % de 385 participants choisissent une option et que la marge d’erreur est de 5 points, vous indiquez 62 % en précisant que la fourchette plausible va de 57 à 67 %.
En réarrangeant la formule de la taille de l’échantillon pour isoler E, on obtient :
E = z x racine carrée de (p x (1 - p) / n)
Pour une population finie, multipliez ce résultat par la racine carrée de (N - n) divisé par (N - 1). Les deux versions figurent dans le calculateur ci-dessous, qui bascule automatiquement de l’une à l’autre lorsque vous cochez ou décochez la case de la population.
Quelle est la marge d’erreur des participations dont je dispose déjà ?
La même formule, réarrangée. Saisissez les participations recueillies et lisez la précision obtenue.
Marge d’erreur
5.0
Points de pourcentage, en plus ou en moins.
Votre intervalle
45,0 à 55,0
En pourcentage, à un niveau de confiance de 95 %.
Les calculs, étape par étape
La marge d’erreur augmente-t-elle avec la taille de l’échantillon ?
Elle diminue, et elle diminue avec la racine carrée de n. Cette racine carrée résume toute l’économie des enquêtes. Quatre cents participations donnent une erreur deux fois plus faible que cent. Pour la diviser de nouveau par deux, il en faut 1 600. Chaque décimale de précision supplémentaire coûte environ quatre fois plus de terrain, et c’est pourquoi 385 est un point d’arrivée si fréquent : c’est là que coût et précision cessent de s’opposer.
Quatre termes souvent confondus
L’erreur type, la marge d’erreur, le niveau de confiance et l’intervalle de confiance sont employés comme s’ils étaient interchangeables. Ce sont quatre choses différentes, et la différence compte lorsque quelqu’un conteste votre chiffre.
| Terme | Ce que c’est | Avec 385 participations et 50 % |
|---|---|---|
| Erreur type | La dispersion brute de l’estimation. La racine carrée de p multiplié par (1 moins p), divisé par n. | 0,0255, soit 2,55 points de pourcentage |
| Marge d’erreur | L’erreur type multipliée par le score z correspondant au niveau de confiance choisi. | Plus ou moins 5,0 points à 95 % |
| Niveau de confiance | Le score z choisi, exprimé en pourcentage. Un choix, pas une mesure. | 95 %, donc z = 1,96 |
| Intervalle de confiance | Le résultat auquel on applique la marge d’erreur, écrit sous forme de fourchette. | 45,0 % à 55,0 % |
En bref : l’erreur type est une propriété de vos données, le niveau de confiance est un choix que vous avez fait, la marge d’erreur est le produit des deux, et l’intervalle de confiance est ce que vous publiez dans le rapport.
Ce que la marge d’erreur ne couvre pas
Elle couvre l’erreur d’échantillonnage aléatoire et rien d’autre. Elle ne couvre ni les personnes qui ont ignoré l’invitation, ni une liste à laquelle manquait une partie de la population, ni une question que la moitié de vos participants ont comprise autrement que vous ne l’entendiez. Une enquête peut avoir une marge d’erreur impeccable et se tromper quand même. Voir le biais de réponse et le biais de non-réponse pour les erreurs qu’aucune taille d’échantillon ne corrige.
L’organisme professionnel de la recherche par enquête le dit plus crûment que la plupart des éditeurs. L’AAPOR affirme qu’il n’existe pas de marge d’erreur globale mesurable pour un sondage, car les enquêtes comportent d’autres erreurs qui ne peuvent pas du tout être mesurées, de la rédaction des questions à la conduite des entretiens. Ce que vous pouvez calculer, c’est la part due à l’échantillonnage. C’est cette part que le calculateur vous donne, et il vaut mieux dire clairement qu’il ne s’agit que d’une part.
Deux règles d’usage de la même source, que la plupart des textes sur les enquêtes appliquent mal :
- Elle s’exprime en points de pourcentage, pas en pourcentage. Écrivez « plus ou moins 3 points de pourcentage », et non « plus ou moins 3 pour cent ». Les deux n’ont pas le même sens.
- Elle ne s’applique pas du tout aux échantillons à adhésion volontaire. Une marge d’erreur suppose que chaque personne avait une probabilité de sélection connue et non nulle. Un lien ouvert, un panel de volontaires ou une publication sur les réseaux sociaux ne remplit pas cette condition. Publier une marge d’erreur à côté de résultats obtenus par un lien ouvert, c’est revendiquer une précision que vous n’avez pas achetée.
Convertir les participations complètes en invitations
La formule vous donne des participations terminées. Le terrain vous donne un taux de réponse. C’est dans l’écart entre les deux que les plans d’échantillonnage échouent habituellement, et le calcul tient en une ligne :
Invitations = participations complètes nécessaires / taux de réponse attendu
Utilisez le taux en décimal, soit 0,30 pour 30 %, et arrondissez au supérieur. Pour 292 participations complètes à 35 %, cela donne 292 divisé par 0,35 = 834,3 ; invitez donc au moins 835 personnes.
| Participations nécessaires | Taux de réponse attendu | Invitations |
|---|---|---|
| 385 | 60 % | 642 |
| 385 | 30 % | 1,284 |
| 385 | 15 % | 2,567 |
| 292 | 50 % | 584 |
| 292 | 35 % | 835 |
| 292 | 20 % | 1,460 |
Choisir un taux de réponse défendable
Votre propre historique vaut mieux que toute référence publiée, à condition qu’il s’agisse du même public, du même canal et d’une enquête de longueur comparable. Si vous n’avez aucun repère, prévoyez trois scénarios à 20, 30 et 40 % et traitez la liste d’invitations comme un levier ajustable pendant le terrain. Les relances, une période plus longue et une liste élargie peuvent toutes être modifiées en cours de route. L’objectif de participations complètes, non.
La plupart des tables de référence sur internet citent une moyenne unique sans source. Il n’existe pas de moyenne unique. Voici ce que rapportent réellement les sources primaires, pour que vous puissiez citer la ligne qui correspond à votre situation plutôt qu’un chiffre inventé.
| Contexte | Taux de réponse | Échelle et source |
|---|---|---|
| Agences fédérales américaines de moins de 1 000 agents | 71 % | Federal Employee Viewpoint Survey 2024 (OPM) |
| Agences fédérales américaines de 1 000 à 9 999 agents | 60 % | Même enquête, même année (OPM) |
| Agences fédérales américaines de plus de 75 000 agents | 37 % | Même enquête, même année (OPM) |
| Ensemble des agents fédéraux américains | 41 % | Plus de 1,6 million de personnes invitées, plus de 674 000 ont répondu, 2024 (OPM) |
| Enquêtes en ligne publiées, tous types confondus | 44,1 % en moyenne | Méta-analyse de 1 071 taux publiés (Wu et al., 2022) |
| Recherche publiée sur les organisations | 68 % en 2020, contre 48 % en 2005 | 1 014 enquêtes dans 17 revues (Holtom et al., 2022) |
| Sondages téléphoniques auprès du grand public | 6 % en 2018, contre 36 % en 1997 | Taux suivi par le Pew Research Center lui-même (Kennedy et Hartig, 2019) |
| Mode web par rapport à tout autre mode | environ 12 points de moins | Méta-analyse de 114 comparaisons expérimentales (Daikeler et al., 2020) |
Deux enseignements ressortent de ce tableau. D’abord, la taille du groupe interrogé prédit le taux mieux que presque tout ce que vous maîtrisez. Une entreprise de 300 personnes et une administration de 300 000 personnes ne mènent pas la même enquête. Ensuite, l’affirmation largement répétée selon laquelle les taux de réponse s’effondrent partout n’est vraie que dans certains cas. Les sondages téléphoniques se sont effectivement effondrés. La recherche publiée sur les organisations a suivi la tendance inverse, passant de 48 % à 68 % en quinze ans.
Un dernier calcul de planification à retenir : les recommandations habituelles des services de vulgarisation universitaires sont d’ajouter environ 10 % à votre liste d’invitations pour les personnes que vous ne pourrez tout simplement pas joindre, et environ 30 % pour celles qui pourraient répondre et ne le font pas.
Ce que notre propre corpus de modèles dit de la longueur
Un taux de réponse emprunté à l’enquête de quelqu’un d’autre se transpose mal, et la longueur est l’un des rares éléments de cette liste que vous maîtrisez entièrement. Voici un chiffre que nous pouvons produire et qu’un concurrent ne peut pas produire, car il provient du comptage de notre propre corpus publié et non d’un sondage auprès de praticiens sur ce qu’ils pensent faire.
Lors de notre audit du 21 août 2026, les 87 modèles d’enquête comptaient tous 14 questions ou moins, et 86 en comptaient 10 ou moins. Ensemble, ils totalisaient 799 questions. La médiane était de 9 questions et un seul modèle dépassait 10. Ces chiffres décrivent cet instantané daté, pas la bibliothèque actuelle.
| Questions dans le modèle | Modèles | Part du corpus |
|---|---|---|
| 7 questions | 4 | 5 % |
| 8 questions | 17 | 20 % |
| 9 questions | 29 | 33 % |
| 10 questions | 36 | 41 % |
| 14 questions | 1 | 1 % |
Par format de réponse, 355 des 799 questions sont des échelles d’évaluation, 281 des listes à choix unique et 163 demandent de saisir du texte. Ce dernier groupe est celui qui vous coûte des participations complètes ; nous l’avons donc lu à la main au lieu de nous fier au champ enregistré. Sur les 163, 137 sont des zones de commentaire sur plusieurs lignes. Les 26 autres sont des champs d’une seule ligne, et leur lecture a montré que 22 sont de courts champs d’identification ou de classement : un nom, une adresse e-mail, une date, un service, un intitulé de poste. Seuls 4 sont de véritables réponses courtes. Le décompte honnête des questions réellement ouvertes est donc de 141, soit environ une question sur six, et non une sur cinq comme l’aurait indiqué le champ brut.
Comment nous avons compté et vérifié. Nous avons analysé la liste de questions enregistrée de chaque modèle d’enquête en ligne sur ce site le 21 août 2026, conservé les entrées comportant un texte de question, puis récupéré chaque page publiée et comparé les deux ensembles au lieu de nous fier à notre seule base de données. Les 87 pages ont renvoyé HTTP 200, tandis qu’une adresse que nous savons supprimée a renvoyé 410 lors du même passage : la vérification était donc discriminante et ne validait pas tout par défaut. 785 des 799 questions, soit 98 %, figurent sur la page publiée. Six de ces correspondances ne diffèrent de la base de données que par le caractère d’apostrophe utilisé, et nous les avons comptées comme correspondances, ce que nous préférons signaler plutôt que d’arrondir discrètement. Quatre-vingt-six des 87 modèles ont été entièrement vérifiés. Celui qui ne l’a pas été est notre plus long, avec 14 questions, et sa page publiée n’affiche actuellement aucune question d’aperçu ; ses questions n’ont donc pas pu être confirmées de l’extérieur.
La longueur d’un modèle ne vous indique pas le taux de réponse aux invitations. Notre étude de référence sur les participations aux enquêtes, distincte, examine le comportement après qu’une personne a interagi avec une enquête ; elle ne compte pas toutes les personnes invitées. Pour planifier les invitations, utilisez un taux documenté issu d’un projet comparable ou d’une enquête pilote, et gardez un dénominateur cohérent.
L’usage pratique est limité mais réel. Si vous empruntez un taux de réponse pour calculer le nombre d’invitations dans le calculateur, empruntez-le à une enquête de la longueur de celle que vous allez envoyer, à un public comparable et par un canal comparable. Nos propres instruments publiés comptent entre 7 et 10 questions, soit moins que la plupart des premières versions.
Plus d’invitations ne réduisent pas le biais
Un faible taux de réponse crée deux problèmes qui semblent n’en faire qu’un. Le premier est que vous n’atteignez pas votre objectif, si bien que votre marge d’erreur est plus large que prévu. Le second est que les personnes qui ont répondu peuvent différer de celles qui n’ont pas répondu, d’une façon qui compte pour votre résultat.
Inviter plus de personnes règle le premier problème. Cela ne règle pas de façon fiable le second. Groves et Peytcheva ont regroupé 59 études ayant mesuré le biais de non-réponse réel par rapport à une vérité connue, et n’ont trouvé qu’un lien faible entre le taux de réponse d’une enquête et l’ampleur de son biais. Pew a testé directement la même idée : un même questionnaire a été administré deux fois, une fois avec des méthodes standard qui ont obtenu un taux de réponse de 9 %, et une fois avec un protocole renforcé qui a obtenu 22 %. Sur les 40 questions communes aux deux enquêtes, 28 ont donné des résultats à moins de 2 points d’écart.
Le contre-exemple honnête. Ce constat ne se généralise pas à tous les sujets, et il vaut la peine de savoir où il cède. Dans les enquêtes de satisfaction, le lien est réel et fort. Une étude portant sur 717 enquêtes de satisfaction des patients dans 164 hôpitaux suisses a trouvé une corrélation de r = 0,61 entre le score moyen de satisfaction et le taux de réponse, car les personnes ravies et les personnes furieuses répondent, alors que les personnes mitigées ne répondent pas. Si vous mesurez le CSAT ou le NPS, une hausse du taux de réponse peut à elle seule faire bouger votre score, et un taux faible vous flatte probablement.
Donc : visez un bon taux de réponse lorsque vous mesurez ce que les gens pensent de vous. Ne le considérez pas comme un certificat de validité lorsque vous mesurez autre chose.
Taille de l’échantillon en recherche quantitative : ce qu’exige un chapitre de méthodologie
Il n’existe pas de taille d’échantillon idéale unique en recherche quantitative, et toute source qui vous en donne une sans demander ce que vous mesurez devine. Ce qui fait valider un chapitre de méthodologie, ce n’est pas un grand nombre. C’est un nombre énoncé, accompagné du niveau de confiance, de la marge d’erreur, de la proportion supposée et de la population, et associé à une formule nommée.
Les directeurs de recherche attendent généralement l’une de quatre approches nommées. Elles concordent pour l’essentiel, et il vaut la peine de savoir laquelle on vous demande.
| Approche | Ce qu’elle vous demande | Résultat pour N = 1 000 à 95 % et 5 points | À utiliser quand |
|---|---|---|---|
| Cochran (1977) | z, p, E, puis la correction pour population finie si la population est petite | 278 | Par défaut. C’est la formule de cette page, et celle dont les autres découlent. |
| Krejcie et Morgan (1970) | Rien. Vous lisez la réponse dans une table publiée, selon la taille de la population. | 278 | Vous voulez une table citable plutôt qu’un calcul. C’est la formule de Cochran avec des paramètres fixés. |
| Yamane (1967), souvent appelée formule de Slovin | Seulement N et la marge d’erreur | 286 | Seulement lorsque p est vraiment inconnu et que vous acceptez un niveau de confiance de 95 % imposé d’office. Voir la mise en garde ci-dessous. |
| Analyse de puissance | La taille d’effet, la puissance, le seuil alpha et le test que vous allez effectuer | Dépend entièrement de la taille d’effet | Vous testez une hypothèse plutôt que d’estimer un pourcentage. Utilisez G*Power ou OpenEpi, pas cette page. |
Cochran, et pourquoi tout le reste en est un raccourci
La formule de Cochran est celle du haut de cette page : n0 = z au carré multiplié par p multiplié par (1 moins p), divisé par E au carré, suivie de la correction pour population finie lorsque la population est petite. Les autres méthodes nommées fixent certains de ces paramètres pour raccourcir le calcul. Une fois que vous le savez, cette famille cesse de ressembler à quatre règles concurrentes et devient une seule règle avec trois préréglages.
Yamane et Slovin : à utiliser en connaissance de cause
La formule n = N / (1 + N x e^2) apparaît dans des milliers de thèses, généralement attribuée à Slovin. Elle est rapide : pour N = 1 000 et e = 0,05, elle donne 286.
Trois choses sont bonnes à savoir avant de la citer.
- C’est la formule de Cochran avec des paramètres verrouillés. En remontant le calcul, il s’agit de la formule de la proportion avec p fixé à 0,5, un niveau de confiance fixé à 95 % et z arrondi de 1,96 à 2. Elle ne peut répondre à aucune question pour un autre niveau de confiance, et elle n’a aucun paramètre pour la variabilité de votre population. Deux populations de même taille mais de dispersions très différentes obtiennent la même réponse, ce qui ne peut pas être juste.
- C’est cet arrondi qui gonfle ses chiffres. Avec z = 2, le plafond de la formule pour une population illimitée est exactement 1 divisé par e au carré, soit 400. Le plafond de Cochran est 384,16, car 1,96 au carré vaut 3,8416 et non 4. Chaque chiffre de Yamane du tableau ci-dessus est supérieur de quelques pour cent au chiffre de Cochran, exactement pour cette raison. Si vous vous êtes déjà demandé pourquoi deux manuels donnent deux tailles d’échantillon différentes pour la même étude, c’est généralement la réponse.
- L’attribution ne tient pas. Une revue de statistique a retracé l’histoire de la formule et conclu qu’on ne trouve derrière elle aucune personne nommée Slovin, et que la plus ancienne source identifiable est le manuel de Taro Yamane de 1967. Wolfram MathWorld la décrit comme une formule ad hoc dépourvue de rigueur mathématique. Si votre département l’attend, utilisez-la et citez Yamane plutôt que Slovin. Si vous avez le choix, utilisez Cochran, car elle résiste à la question de savoir d’où vient le 95 %.
Les règles empiriques, évaluées honnêtement
Elles circulent largement. Certaines sont utiles, d’autres relèvent du folklore, et il est utile de savoir lesquelles.
- Au moins 30 par groupe. Raisonnable comme plancher pour comparer des groupes, pas comme objectif. Ce chiffre vient du point où les distributions d’échantillonnage commencent à bien se comporter, et non d’une exigence de précision.
- Dix observations par variable dans une régression. Une heuristique de travail, largement utilisée et largement critiquée. Présentez-la comme une heuristique, jamais comme une règle.
- Dix pour cent de la population. Celle-ci est tout simplement fausse, et le tableau ci-dessus montre pourquoi. Dix pour cent de 100 000, c’est 10 000 participations, alors que 383 donnent la même précision.
- Toujours 385. Juste uniquement pour une grande population à 95 % et 5 points. Citez ce chiffre avec ces conditions, sinon il ne veut rien dire.
- Un petit n pour les études d’utilisabilité et de produit. Le Nielsen Norman Group en publie la version honnête : 40 participants vous donnent une mesure oui ou non à plus ou moins 15 points avec un niveau de confiance de 95 %, et 47 vous donnent une moyenne avec la même précision. Ces chiffres sont petits parce que la précision revendiquée est large. Annoncez clairement la précision, et les petits échantillons cessent d’être gênants.
Si votre étude compare des groupes au lieu d’estimer un pourcentage, la taille de l’échantillon devient une question de puissance, et ce calculateur n’est pas le bon. Il vous faut une taille d’effet que vous êtes prêt à défendre, plus le seuil alpha et la puissance. G*Power et OpenEpi sont les outils gratuits qu’attendent la plupart des directeurs de recherche, et tous deux sont gratuits. Dire où un outil s’arrête est plus utile que prétendre qu’il fait tout.
Le travail qualitatif se dimensionne autrement
Les entretiens et les groupes de discussion ne se dimensionnent pas avec une marge d’erreur, car ils n’estiment pas un pourcentage de la population. L’argument habituel est la saturation : vous continuez jusqu’à ce que de nouveaux participants ne fassent plus émerger de nouveaux thèmes, puis vous indiquez à quel moment c’est arrivé et comment vous en avez jugé. Passer une étude qualitative dans ce calculateur produit un chiffre qui a l’air précis et ne veut rien dire.
Si vous avez besoin de résultats par sous-groupe, dimensionnez pour le sous-groupe
La plupart des enquêtes doivent présenter des résultats par région, fonction, ancienneté ou gamme de produits. C’est là que les plans d’échantillonnage se brisent sans bruit, et la règle est courte.
Votre marge d’erreur ne s’applique à un groupe que si ce groupe compte ce nombre de participations complètes. Si vous voulez plus ou moins 5 points pour chacune de six régions, il vous faut environ 385 participations complètes dans chaque région, et non 385 au total. C’est une enquête six fois plus grande que celle que vous pensiez prévoir.
Deux solutions honnêtes :
- Suréchantillonnez les petits groupes. Invitez délibérément une part plus élevée des segments les plus petits pour que chacun atteigne son propre objectif. Vous repondérez ensuite les résultats.
- Acceptez des fourchettes plus larges pour les ventilations. Gardez un chiffre global solide et publiez chaque sous-groupe avec sa propre marge d’erreur, plus large, à côté. C’est généralement la bonne réponse.
Le calculateur comporte un champ à cet effet. Renseignez Sous-groupes à présenter séparément avec le nombre de groupes pour lesquels vous devez un résultat : il dimensionne correctement chaque groupe et en fait le total.
Définissez le périmètre avant le terrain. Listez les segments que vous devez présenter, pas ceux qu’il serait agréable d’avoir. Estimez le nombre de participations complètes que chacun peut réalistement fournir, en utilisant des questions démographiques pour les identifier. Si un segment ne peut fournir que 80 participations, ne lui promettez pas plus ou moins 5 points. Avec 80 participations, la fourchette est de plus ou moins 11 points.
L’AAPOR utilise un exemple qui mérite d’être retenu. Une enquête auprès de 1 000 adultes présente une marge d’erreur globale d’environ plus ou moins 3 points. Si 200 de ces personnes forment le sous-groupe dont vous voulez réellement parler, la marge d’erreur de ce sous-groupe est de plus ou moins 6,9 points, plus du double. Le chiffre mis en avant en première page du rapport n’est pas celui qui régit le graphique de la page neuf.
Les recommandations publiées sur les effectifs minimaux par case sont plus anciennes et plus approximatives que les formules, et il est légitime de les traiter comme un plancher plutôt que comme un objectif : environ 100 participations pour un sous-groupe sur lequel vous présenterez de vrais résultats, et 20 à 50 pour un sous-groupe secondaire que vous mentionnerez en passant.
Où la planification de la taille de l’échantillon déraille
La taille de l’échantillon gère l’erreur d’échantillonnage, le bruit aléatoire dû au fait de ne pas interroger tout le monde. Les enquêtes réelles comportent aussi une erreur systématique, qu’aucune taille d’échantillon ne corrige et qu’un grand échantillon peut masquer.
Traiter un échantillon de commodité comme un échantillon probabiliste
Toutes les formules de cette page supposent que chaque personne avait une probabilité connue et non nulle d’être sélectionnée, et que le fait de répondre n’était pas fortement lié à ce que vous mesurez. Un lien ouvert sur les réseaux sociaux ne remplit aucune de ces conditions. Vous pouvez quand même calculer une marge d’erreur à partir des participations ; elle paraîtra rassurante, et elle ne voudra pas dire ce qu’elle affirme. Précisez clairement quel type d’échantillon vous avez réellement tiré.
Confondre un n plus grand avec une meilleure mesure
Un grand échantillon rend une mesure bruitée précisément bruitée. Si une question est ambiguë, à double objet ou orientée, plus de participations ne la sauveront pas. Des taux d’abandon élevés et des réponses incohérentes sont des signes qu’il faut d’abord corriger l’instrument. Réécrire une seule mauvaise question fait souvent plus que tripler l’échantillon.
Choisir une précision sans décision à la clé
La précision n’a une bonne réponse qu’une fois que vous savez à quoi elle sert. Une taille d’échantillon est facile à défendre lorsque vous pouvez compléter cette phrase : nous devons distinguer des résultats qui diffèrent de X points. Elle est impossible à défendre lorsque la seule justification est qu’un nombre plus grand semblait plus sûr. Rattachez-la à votre méthodologie d’enquête et à ce que vous ferez du résultat.
Les chiffres de cette page, et ce qu’ils valent
Chaque chiffre cité ci-dessus est soit un calcul que vous pouvez reproduire dans le calculateur, soit une référence que vous pouvez vérifier. Le niveau A signifie répliqué ou directement calculable, le niveau B une seule étude solide, le niveau C largement répété mais contesté.
| Affirmation | Chiffre | Niveau de preuve | Source |
|---|---|---|---|
| À un niveau de confiance de 95 % et sans estimation préalable, une grande population nécessite 385 participations complètes pour plus ou moins 5 points. | 385 | A | Calcul direct à partir de la formule standard de la proportion. NIST, section 3.3.3 ; Israel (1992). |
| La formule de cette page reproduit la table de taille d’échantillon publiée par Krejcie et Morgan à une participation près pour chacune des 21 tailles de population vérifiées. | 21 sur 21 à 1 près | A | Notre propre vérification par rapport à Krejcie et Morgan (1970). Méthode indiquée sous la table. |
| Le taux de réponse prédit mal le biais de non-réponse. Une méta-analyse de 59 études consacrées au biais n’a trouvé qu’un lien faible entre les deux. | 59 études | A | Groves et Peytcheva (2008), Public Opinion Quarterly. |
| Pew a administré le même questionnaire avec un taux de réponse de 9 % et de 22 %. Sur 40 questions communes, 28 ont donné des résultats à moins de 2 points d’écart. | 28 sur 40 à moins de 2 points | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Mais dans les enquêtes de satisfaction, le lien est réel et fort. Sur 717 enquêtes hospitalières, le score moyen de satisfaction était corrélé au taux de réponse à r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux et Combescure (2020), BMC Health Services Research. |
| Le taux de réponse aux enquêtes auprès des salariés suit presque parfaitement la taille de l’organisation. En 2024, l’enquête auprès des agents fédéraux américains a obtenu 71 % dans les agences de moins de 1 000 personnes et 37 % dans celles de plus de 75 000. | 71 % contre 37 % | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, plus de 1,6 million d’agents invités. |
| Le taux de réponse moyen de 1 071 enquêtes en ligne publiées était de 44,1 %. Il n’existe pas de taux normal unique. | 44,1 % | A | Méta-analyse de Wu, Zhao et Fils-Aime (2022), Computers in Human Behavior Reports. |
| Les enquêtes web obtiennent un taux de réponse inférieur d’environ 12 points de pourcentage à celui des autres modes, sur 114 comparaisons expérimentales. | 12 points de moins | A | Méta-analyse de Daikeler, Bosnjak et Lozar Manfreda (2020), JSSAM. |
| Diviser la marge d’erreur par deux multiplie l’échantillon nécessaire par quatre environ, car n varie comme 1 sur E au carré. Doubler un échantillon de 1 000 à 2 000 fait gagner environ un point. | environ x4 | A | Propriété algébrique de la formule ; l’AAPOR expose explicitement le cas de 1 000 à 2 000. |
| Supposer p = 0,5 au lieu d’un p connu de 0,9 multiplie presque par trois l’échantillon qu’on vous dit de recueillir, de 139 à 385. | 139 contre 385 | A | Calcul direct. Reproductible dans le calculateur en modifiant le résultat attendu. |
| Les 87 modèles d’enquête publiés sur ce site comptent tous 14 questions ou moins, et 86 sur 87 en comptent 10 ou moins. 785 de leurs 799 questions ont été confirmées sur les pages publiées. | 87 modèles, 799 questions | A | Notre propre décompte du corpus de modèles en ligne, au 21 août 2026, vérifié sur les 87 pages publiées. La méthode, l’audit manuel et le taux de vérification sont indiqués avec la table. |
| On ne trouve aucune personne nommée Slovin derrière la formule qui porte ce nom. La plus ancienne source identifiable est Yamane (1967). | aucun auteur identifiable | B | Tejada et Punzalan (2012), The Philippine Statistician ; Wolfram MathWorld la qualifie d’ad hoc. |
« Il faut toujours 385 participations. » Seulement à un niveau de confiance de 95 %, plus ou moins 5 points, p = 0,5 et pour une grande population. Cité seul, ce chiffre est faux pour toute petite population.
« Interrogez 10 % de votre population. » Cette règle n’a aucun fondement statistique. Elle suréchantillonne largement les grandes populations et sous-échantillonne les petites.
« Un taux de réponse inférieur à 50 ou 60 % invalide une enquête. » Aucun seuil ne fait cela. L’échelle 50, 60 et 70 % est une règle empirique de manuel qui ne repose sur aucune donnée, et la méta-analyse de Groves et Peytcheva la contredit. Le taux de réponse borne le biais dans le pire des cas. Il ne mesure pas le biais réel.
« Le taux de réponse moyen d’une enquête est de X %. » Les chiffres vérifiés d’une même période vont de 6 % à 71 % selon les personnes interrogées. Toute moyenne unique masque cet écart. Citez plutôt la ligne du tableau ci-dessus qui correspond à votre situation.
La formule de Slovin présentée comme une démonstration. C’est la formule de Cochran avec un niveau de confiance de 95 % et p = 0,5 imposés d’office et z arrondi à 2, et l’attribution à Slovin n’a aucune source identifiable.
Le modèle de justification
La plupart des argumentaires sur la taille de l’échantillon échouent parce que les hypothèses n’ont jamais été écrites. Le bouton Copier la justification du calculateur rédige ce texte avec vos propres chiffres déjà insérés. Si vous préférez le composer vous-même, voici les neuf éléments qu’un relecteur recherchera.
- Population (N) : définissez la population et indiquez son effectif. Par exemple, tous les clients actifs au cours des 90 derniers jours, N = 48 200.
- Ce que vous mesurez : une proportion (un pourcentage) ou une moyenne (une note moyenne). La formule présentée ici dimensionne des proportions, ce qui couvre la plupart des indicateurs publiés.
- Niveau de confiance : le niveau choisi et pourquoi. L’usage et la tolérance au risque sont deux raisons acceptables, à condition de les indiquer.
- Marge d’erreur (E) : la précision visée au global, et séparément pour chaque sous-groupe dont vous avez promis les résultats.
- Proportion supposée (p) : la valeur utilisée et sa provenance. Indiquez clairement s’il s’agit de 0,5 faute de mieux.
- Correction pour population finie : si vous l’avez appliquée et ce qui l’a déclenchée, par exemple n0 dépassant 10 % de N.
- Objectif de participations complètes (n) : le nombre final de participations complètes nécessaires après tous les ajustements.
- Taux de réponse attendu : le taux supposé, l’historique dont il provient et le nombre d’invitations qui en découle.
- Comment vous sélectionnerez les personnes : aléatoire simple, stratifié, recensement ou commodité, plus tout suréchantillonnage des segments clés. Nommez-le honnêtement.
Une fois l’enquête sur le terrain, surveillez les participations complètes par segment plutôt que le total. Un chiffre global satisfaisant peut cacher un segment qui n’atteindra jamais son objectif, et c’est un problème que vous pouvez encore corriger la première semaine mais plus la quatrième. Dans votre rapport, associez chaque pourcentage à sa marge d’erreur, et lisez comment analyser les données d’une enquête avant de considérer comme réel un écart de deux points.
Fiche de planification de la taille de l’échantillon
Une page à imprimer, à remplir à la main et à agrafer à un cahier des charges. Remplissez la colonne du milieu avant le début du terrain, pas après. Rien n’est envoyé nulle part et aucun compte n’est nécessaire.
| Décision | Votre valeur | Consigne |
|---|---|---|
| Population (N) | Qui exactement, et combien. Écrivez la définition, pas seulement le nombre. | |
| Ce que vous mesurez | Un pourcentage ou une moyenne. Cette page dimensionne des pourcentages. | |
| Niveau de confiance | 95 % sauf raison contraire. Écrivez la raison. | |
| Marge d’erreur (E) | L’écart que vous devez pouvoir distinguer, en points. | |
| Proportion supposée (p) | 0,5 faute de mieux. Indiquez la provenance de toute autre valeur. | |
| Correction pour population finie | Appliquée ou non, et ce qui l’a déclenchée. | |
| Objectif de participations complètes (n) | Le chiffre final après tous les ajustements. | |
| Sous-groupes présentés séparément | Combien, et les participations complètes que chacun doit fournir à lui seul. | |
| Taux de réponse attendu | Le taux, et l’historique qui le justifie. Pas un chiffre trouvé sur internet. | |
| Invitations à envoyer | Participations complètes divisées par le taux, arrondies au supérieur. Jamais plus que N. | |
| Mode de sélection des personnes | Aléatoire, stratifié, recensement ou commodité. Nommez-le honnêtement. | |
| Point de contrôle du terrain | La date à laquelle vous vérifierez les participations complètes par segment, pas seulement le total. |
Formule : n0 = (z^2 x p x (1 - p)) / E^2, puis n = n0 / (1 + (n0 - 1) / N). Source : Cochran (1977) ; NIST/SEMATECH e-Handbook, section 3.3.3 ; Israel (1992). Fiche issue de https://www.supersurvey.com/Sample-Size
Questions fréquentes
Qu’est-ce que la taille de l’échantillon ?
La taille de l’échantillon est le nombre de participations complètes à une enquête, notée n. Ce n’est ni le nombre de personnes invitées, ni la taille de la population que vous décrivez. C’est le nombre dont vous disposez à la fin du terrain, et c’est le chiffre à partir duquel votre marge d’erreur est calculée : 385 participations complètes donnent environ plus ou moins 5 points à un niveau de confiance de 95 % lorsque la population est grande. Ce qu’est la taille de l’échantillon expose la différence entre la population, les invitations et n.
De combien de participations ai-je besoin pour une enquête ?
Pour la plupart des enquêtes, la réponse pratique est 385 participations complètes. C’est ce que donne la formule avec un niveau de confiance de 95 %, une marge d’erreur de plus ou moins 5 points de pourcentage et aucune estimation préalable du résultat. Si votre population est petite, il vous en faut moins : 278 pour une liste de 1 000 personnes, 80 pour une liste de 100. Saisissez vos propres chiffres dans le calculateur pour obtenir le chiffre exact et les calculs qui le justifient.
Quelle taille d’échantillon faut-il pour un niveau de confiance de 95 % et une marge d’erreur de 5 % ?
385 participations complètes, si la population est grande et que vous prenez p = 0,5. Le calcul est n0 = 1,96 au carré multiplié par 0,5 multiplié par 0,5, divisé par 0,05 au carré, soit 0,9604 divisé par 0,0025, soit 384,16. En arrondissant au supérieur, on obtient 385. Si votre population est petite, appliquez la correction pour population finie et le nombre diminue.
Qu’est-ce que la marge d’erreur ?
La marge d’erreur est la fourchette en plus ou en moins autour d’un résultat d’enquête qui vient du fait d’avoir échantillonné certaines personnes plutôt que toutes. Un résultat de 62 % avec une marge d’erreur de 5 points signifie que la méthode produirait la plupart du temps un intervalle contenant la vraie valeur, et que cet intervalle précis va de 57 à 67 %. Elle ne décrit que l’erreur d’échantillonnage aléatoire. Elle ne dit rien des personnes qui n’ont jamais répondu.
Comment calculer la marge d’erreur ?
Prenez la racine carrée de p multiplié par (1 moins p), divisé par n, puis multipliez par le score z correspondant à votre niveau de confiance. À un niveau de confiance de 95 %, avec 385 participations et p = 0,5, cela donne 1,96 multiplié par la racine carrée de 0,25 divisé par 385, soit 1,96 multiplié par 0,025482, soit 0,0499. La marge d’erreur est donc de plus ou moins 5,0 points de pourcentage. Le calculateur de marge d’erreur de cette page fait le calcul pour vous et en affiche le détail.
La marge d’erreur augmente-t-elle avec la taille de l’échantillon ?
Non, elle diminue, et elle diminue avec la racine carrée de l’échantillon. Passer de 100 à 400 participations divise la marge d’erreur par deux. Passer de 400 à 1 600 la divise de nouveau par deux. Cette relation en racine carrée explique pourquoi la précision coûte cher : chaque décimale d’exactitude supplémentaire coûte environ quatre fois plus de participations.
La marge d’erreur est-elle la même chose que l’erreur type ?
Non. L’erreur type est la dispersion sous-jacente de l’estimation. La marge d’erreur est l’erreur type multipliée par le score z correspondant au niveau de confiance choisi. À un niveau de confiance de 95 %, la marge d’erreur vaut environ 1,96 erreur type. L’erreur type est une propriété des données. La marge d’erreur est un choix de présentation qui s’y ajoute.
Quelle est une bonne taille d’échantillon en recherche quantitative ?
Il n’existe pas de bon chiffre unique, et toute source qui vous en donne un sans demander ce que vous mesurez devine. Pour une étude qui présente des pourcentages sur une population de moins de 10 000 personnes environ, la réponse défendable est celle que donne la formule avec un niveau de confiance de 95 % et une marge d’erreur que vous pouvez justifier. Pour une liste de 1 000 personnes, c’est 278. Le chiffre qui fait valider un chapitre de méthodologie n’est pas un grand nombre : c’est un nombre énoncé, accompagné du niveau de confiance, de la marge d’erreur, de la proportion supposée et de la population. Voir la taille de l’échantillon en recherche quantitative pour les formules nommées que votre directeur de recherche peut attendre.
Quel est un taux de réponse normal pour une enquête ?
Il n’existe pas de taux normal unique, et toute page qui cite un seul chiffre devine. Les chiffres réels et sourcés d’une même époque vont de 6 % (sondages téléphoniques du Pew en 2018) à 71 % (petites agences fédérales américaines dans le Federal Employee Viewpoint Survey 2024). Une méta-analyse de 1 071 enquêtes en ligne publiées a trouvé une moyenne de 44,1 %. La taille de l’organisation compte énormément : la même enquête fédérale a obtenu 71 % dans les agences de moins de 1 000 personnes et 37 % dans celles de plus de 75 000. Partez d’abord de votre propre historique, et consultez le tableau de référence pour des chiffres que vous pouvez citer.
La taille de la population compte-t-elle pour la taille de l’échantillon ?
À peine, jusqu’à ce que votre échantillon représente une part importante de la population. Passer de 100 000 à 1 000 000 personnes fait passer le besoin de 383 à 385. Passer de 1 000 à 100 personnes le fait passer de 278 à 80. La taille de la population compte pour les petites populations, et c’est exactement là que s’applique la correction pour population finie.
Quand p = 0,5 est-il le bon choix ?
Prenez p = 0,5 chaque fois que vous n’avez pas d’estimation préalable défendable. Le terme p multiplié par (1 moins p) est maximal à 0,5 et donne donc l’échantillon nécessaire le plus grand. C’est l’hypothèse prudente : vous ne pouvez pas vous retrouver à court. Si vous disposez d’une enquête pilote, d’une référence ou du chiffre de l’an dernier, utilisez-le. Supposer p = 0,9 au lieu de 0,5 fait passer l’échantillon nécessaire de 385 à 139.
Si j’invite plus de personnes, est-ce que j’élimine le biais de non-réponse ?
Non. Plus d’invitations vous donnent plus de participations complètes, ce qui réduit la marge d’erreur. Le biais est un problème distinct : il dépend de la différence éventuelle entre les personnes qui ont répondu et celles qui n’ont pas répondu. Une méta-analyse de 59 études sur le biais de non-réponse n’a trouvé qu’un lien faible entre le taux de réponse et le biais réel. Pew a administré deux fois le même questionnaire, avec un taux de réponse de 9 % puis de 22 %, et 28 des 40 questions communes ont donné des résultats à moins de 2 points d’écart. Voir le biais de réponse et le biais de non-réponse.
Comment gérer la taille de l’échantillon si j’ai besoin de résultats par service ou par région ?
Dimensionnez chaque sous-groupe séparément. Votre marge d’erreur ne s’applique à un groupe que si ce groupe compte ce nombre de participations complètes. Si vous voulez plus ou moins 5 points pour chaque région, chaque région a besoin de ses propres 385 participations complètes, ou de son propre chiffre corrigé pour population finie. Utilisez des questions démographiques pour identifier les groupes et prévoyez de suréchantillonner les plus petits.
Quelle taille d’échantillon faut-il pour obtenir un résultat statistiquement significatif ?
Cette question mélange deux notions. Les formules de taille d’échantillon dimensionnent une estimation pour une précision choisie. Un test de significativité compare deux chiffres et se demande si l’écart pourrait plausiblement être dû au hasard. La taille nécessaire dépend du plus petit écart que vous voulez pouvoir détecter, et non d’un seuil fixe. Dimensionnez l’enquête ici, puis lisez la significativité statistique avant de comparer un résultat à un autre.
Ces formules fonctionnent-elles pour la recherche qualitative ?
Non. Les entretiens, les groupes de discussion et les travaux à questions ouvertes ne se dimensionnent pas avec une marge d’erreur, car ils n’estiment pas un pourcentage de la population. La taille d’un échantillon qualitatif se justifie par la saturation, le moment où de nouveaux participants ne font plus émerger de nouveaux thèmes, et elle se présente comme un jugement étayé par des preuves plutôt que comme une formule. Ne passez pas une étude qualitative dans ce calculateur.
Références
- National Institute of Standards and Technology (NIST). (s. d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, section 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.