
要点
- テーマではなく意思決定から始めましょう。回答に応じて何を変えるのかを書き出します。意思決定を変えられない項目は、削除の候補です。
- 1つの内容に1つの項目、1つの期間。1つの質問に2つの質問が隠れていると、回答がどちらの部分によるものか判断できません。
- 表現が数値を動かします。あるスプリットサンプル実験では、同じ政府施策の名称を変えただけで支持が45パーセントポイント変動しました。中立的な表現は礼儀ではなく、測定上の選択です。
- 回答選択肢は質問と同じくらい丁寧に設計しましょう。範囲の重複、カテゴリーの欠落、ラベルのない中間点は、ぎこちない質問文よりも大きな害をもたらします。
- まず人でプリテストし、次にデータでパイロット調査を行いましょう。少数の回答者に音読してもらうだけで、書き手の立場からは見えない読み違いが見つかります。
調査票設計とは何か、そして何を解決できないか
調査票設計とは、調査の目的を、人が理解して正確に答えられる質問に落とし込むプロセスです。表現、回答選択肢、順序、導入文、テストが含まれます。以下の7つのステップでは、これらの選択が1つの調査票の中でどう組み合わさるかを示します。
よく設計された項目とは、同じ経験を持つ2人が同じように読み、記憶から答えを引き出せ、それを表すのに同じ選択肢を選べる項目です。以下の内容はすべて、そこに近づくための方法です。
解決できないことが2つあります。1つは対象者の誤りです。間違った人に完璧な質問をしても、誰も問うていない質問への正確な回答が得られるだけです。これは表現の問題ではなくサンプリングの問題です。もう1つは回答結果が少なすぎることで、これはサンプルサイズの問題です。
混同して使われがちな2つの言葉も区別しておきましょう。調査票は測定の道具であり、項目と回答選択肢のリストです。アンケートはそれを取り巻く調査全体で、誰に尋ねるか、どう届けるか、データをどう扱うかを含みます。より広いプロセスについては、調査設計のガイドで解説しています。このページでは道具である調査票に絞って説明します。
調査票設計の7つのステップ
検索では「7つのステップ」が他のどの数よりも多く求められていますが、出てくるリストの多くは、元のページがすでに存在しない2006年のある代理店のブログ記事の写しです。そのため、以下の手順はそのリストではありません。調査方法論の文献が実際に記述している開発プロセス16, 17, 20を、作業の性質が本当に変わる7つの地点で区切ったものです。さらに、それらの写しが省いている2つの点、つまり各ステップで何が生まれるか、そして各ステップがどこでつまずきやすいかを加えています。
| ステップ | 決めること | 生まれるもの | つまずきやすい点 |
|---|---|---|---|
| 1. まず意思決定から | 結果をもとに何を決めるか | 意思決定の短いリストと、その裏にある比較 | テーマから始めるため、項目の追加をいつやめるべきか分からない |
| 2. 項目と形式 | 意思決定ごとに1つの項目と、その回答形式 | 各項目の横に形式を書いた項目リストの草案 | 必要な分析ではなく、習慣で形式を選んでしまう |
| 3. 答えられる表現 | 各質問文の言い回し | 用語を定義し、期間を明示した質問文 | 誰も覚えていないことを尋ねる、または1つの質問に2つの質問を隠す |
| 4. 選択肢と尺度 | すべての選択回答形式の項目の回答セット | 重複せず、誰も取り残さない選択肢 | 範囲の重複、逃げ道となる選択肢がない、ラベルのない中間点 |
| 5. 中立的な表現 | どの言葉が回答を誘導しているか | 中立的な質問文と、バランスの取れた選択肢セット | 質問文の中の形容詞、一方に偏った回答リスト |
| 6. 順序と導入文 | 順番、グループ分け、冒頭の文章 | 順序を整え、短い導入文を付けた調査票 | デリケートな項目を早く出しすぎる、誰も読まない導入文 |
| 7. プリテストとパイロット調査 | 実際の人に対して機能するかどうか | 修正した調査票と所要時間の見積もり | 省略してしまう、または1回で十分だと考える |
ステップ3、4、5を分けているのは、つまずき方が異なり、直し方も異なるためです。実際には、これらを何度か行き来することになります。図の破線が最も重要なループです。プリテストで見つかったことにより、たいていステップ3に戻ることになります。
ステップ1. 質問を1つ書く前に、意思決定を書き出す
膨れ上がった調査票の多くはテーマから始まっています。良い調査票は意思決定から始まります。項目の草案を書く前に、返ってきた結果に応じて何を変えるのかを短いリストにしましょう。
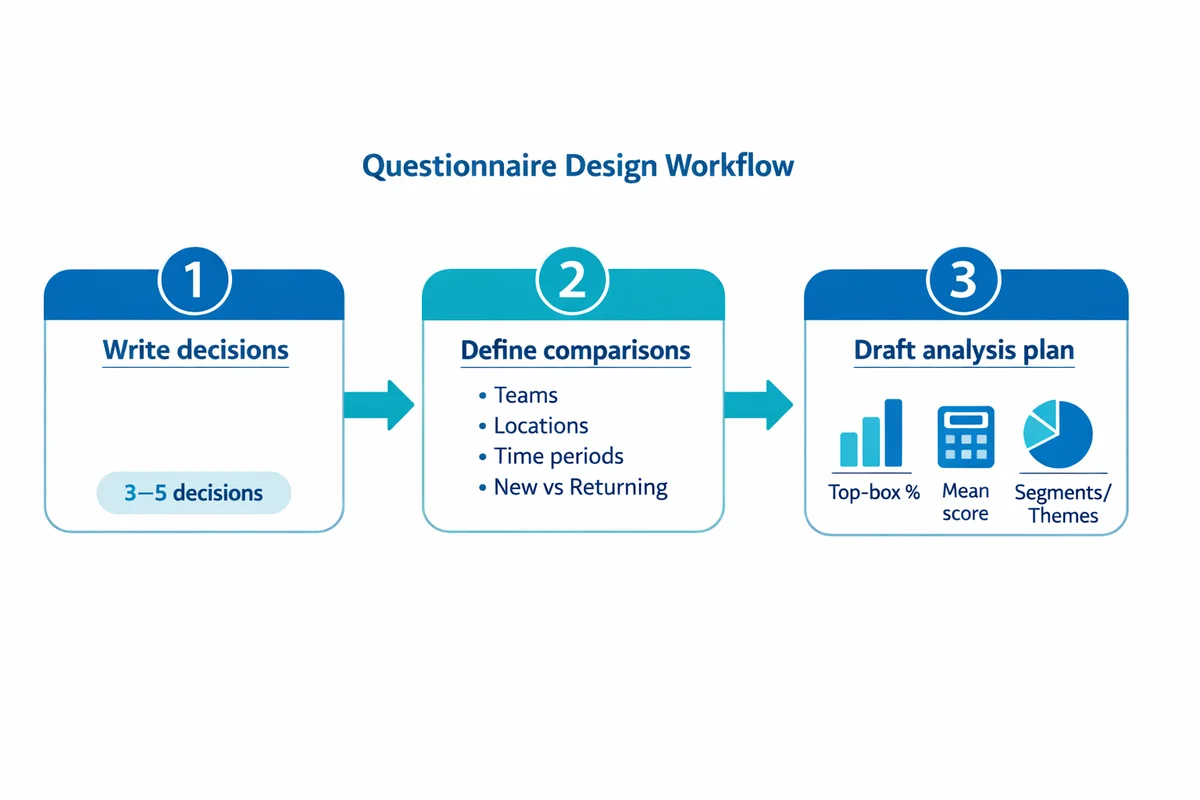
意思決定を3〜5つ挙げる
テーマではなく、選択肢として書きましょう。「2日間の形式を続けるか、短いオンラインセッションに切り替えるか」は意思決定です。「研修へのフィードバック」はテーマです。
必要な比較を明確にする
チーム、拠点、シフト、期間、初回と再訪の比較など。比較は表現と回答選択肢の両方を左右するため、後回しにせず今決めておきましょう。
アウトプットを1ページに下書きする
作成する予定の表やグラフを実際にスケッチしましょう。ある項目がどのアウトプットにつながるのかを描けないなら、その項目には役割がありません。
方法論のガイドがこのステップを最初に置いているのも同じ理由です。質問の追加をいつやめるべきかを教えてくれるのは、これだけだからです。16, 17
各項目の草案を読み、「全員がAではなくBと答えたら、……する」という文を完成させてください。完成させられない場合は、その項目を削除するか、完成させられるまで書き直しましょう。
ステップ2. 意思決定ごとに1つの項目にし、形式を意図して選ぶ
質問の形式は、レイアウトの好みではなく測定上の判断です。読み手が答えられ、予定しているアウトプットに使える形式を選びましょう。
| アウトプットが次の場合 | 使う形式 | 質問文の例 |
|---|---|---|
| 時系列で追跡する数値 | 全ポイントにラベルを付けた選択回答形式の評価項目 | 「サポートなしで設定を完了するのは、どのくらい簡単でしたか、それとも難しかったですか?」 |
| 改善すべき点の優先順位リスト | 単一回答と、1つのフォローアップ質問 | 「最も役立つ変更を1つ選ぶとしたら、どれですか?」の後に「なぜそれを選びましたか?」 |
| 件数または割合 | 重複しない範囲の選択肢 | 「過去30日間に、サポートに何回問い合わせましたか?」 |
| まだ聞いたことのない言葉 | 的を絞った自由回答の入力欄を1つ | 「本日お問い合わせいただいた主な理由は何でしたか?」 |
| 後続の項目の対象となるかどうか | スクリーニング質問とスキップロジック | 「過去30日間に、レポートタブを使用しましたか?」 |
選択回答形式の項目は分析のコストが低く、調査の回をまたいだ比較も容易です。自由回答形式の項目は、選択肢のリストで見落としていたことを見つけてくれます。選択回答形式の項目が主流である実際的な理由はコストです。自由回答は、意味を持たせるまでにコーディング体系と複数のコーダーが必要になります。1自由回答形式の項目は、効果を発揮する場所に1〜2個だけ置き、残りは選択回答形式にしましょう。各形式の詳細は、選択式の質問と自由回答形式の質問と選択回答形式の質問のガイドで解説しています。
同意尺度について1つ注意があります。直接尋ねられることは、直接尋ねましょう。4つのサンプルを用いた実験では、構成概念に即した回答選択肢を持つ項目の信頼性係数が0.87〜0.93に達したのに対し、同じ内容を「同意する/同意しない」の文として尋ねた場合は0.36〜0.73にとどまりました。4多くの人が習慣で選んでいる形式としては、大きな差です。その大部分は、名前の付いた2つの回答効果で説明できます。黙従傾向とは、文の内容にかかわらず同意してしまう傾向のことで、この形式には後から切り分けられない偏りが加わります。最小限化(サティスファイシング)とは、読み手が正確な回答ではなく、通用しそうな回答を出すのに必要な最低限の労力しかかけないことで、「同意する/同意しない」の文が並んでいると、それがとても簡単にできてしまいます。どちらも調査票が長くなるほど悪化します。この形式がどうしても必要な場合は、リッカート尺度のガイドに従ってください。
ステップ3. 回答者が実際に答えられる質問文を書く
悪い項目の多くは、あいまいなのではありません。答えられないのです。誰も覚えていないことや、回答者が知らされたことのない知識を尋ねています。
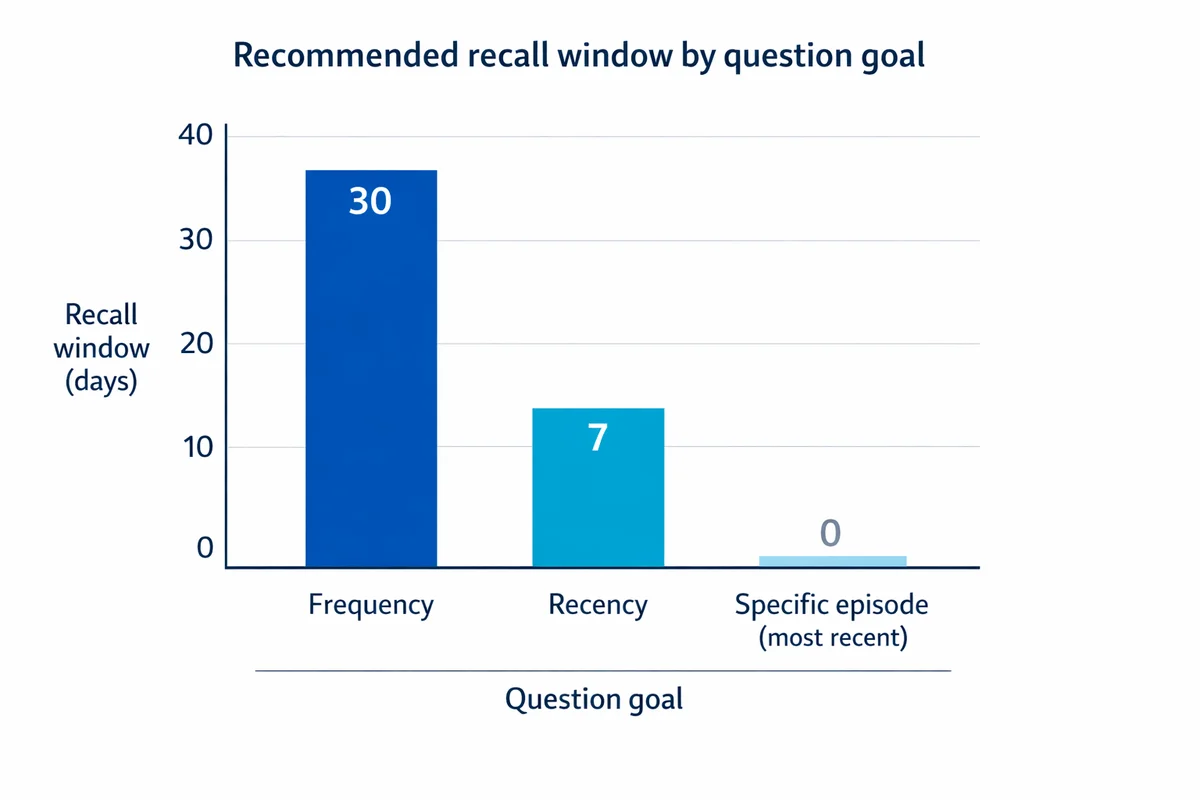
行動に関するすべての質問に期間を設ける
「サポートにはどのくらいの頻度で問い合わせますか?」には基準がないため、まったく同じ行動をとる2人でも答えが異なります。期間を明示し、その行動が起こる頻度に合わせましょう。
| 知りたいこと | 答えにくい | 答えられる |
|---|---|---|
| 頻度 | 「サポートにはどのくらいの頻度で問い合わせますか?」 | 「過去30日間に、サポートに何回問い合わせましたか?」 |
| 最近の行動 | 「定期的に運動していますか?」 | 「過去7日間のうち、30分以上の運動をした日は何日ありましたか?」 |
| 1回の出来事 | 「オンボーディングはスムーズでしたか?」 | 「直近の設定を振り返って、サポートなしで完了するのはどのくらい簡単でしたか、それとも難しかったですか?」 |
読み手が使う言葉を使う
- 一般的な言葉を選びましょう。「援助」より「手助け」、「購入」より「買う」。平易な言葉は翻訳もしやすくなります。
- 避けられない用語は定義しましょう。項目が「インシデント」や「ケース」に左右されるなら、何が該当するのかを質問文の中で示します。
- 略語は一度正式名称で書きましょう。その後は略語を使って構いません。社内の略語が共有されていると思い込まないでください。
- 理由ではなく、何が起きたかを尋ねましょう。人は出来事なら報告できます。組織内の原因については、たいてい報告できません。
1項目に1つの内容
2つの質問が隠れた項目からは、読み取れない回答しか得られません。価格には大満足で品質には大いに不満な人には正直な選択肢がなく、どれを選んでも、どちらの部分がその回答を左右したのか分かりません。
価格と品質にどのくらい満足していますか?
代わりに2つの項目にします。「品質にどのくらい満足していますか?」と「価格にどのくらい満足していますか?」
ここでのエビデンスについては正直に述べておく価値があります。二重質問を分けることはほぼ普遍的なルールですが、それを裏付ける直接的な実験研究は少なく、新しいものです。最も明確な検証では、ダブルバーレル質問の項目と、それを1つの内容に書き直した項目は同じものを測定しておらず、1つの内容に絞った版のほうが妥当性が高いことが分かりました。15このルールは、ステップ5の表現効果のような40年来の確立した知見としてではなく、根拠のある妥当なルールとして扱いましょう。
ステップ4. 分析できる回答選択肢と尺度を作る
多くの調査票は、質問文ではなく回答リストでつまずいています。2つのテストでほとんどを見つけられます。選択肢は重複してはならず、誰もが正直に選べる選択肢がなければなりません。
年齢はおいくつですか? 18〜30歳、30〜40歳、40〜55歳、55歳以上
年齢はおいくつですか? 18〜29歳、30〜39歳、40〜54歳、55歳以上、回答しない
評価スケール
| 選択 | すべきこと | 理由 |
|---|---|---|
| ポイント数 | 態度については5〜7 | 信頼性と妥当性は約7ポイントまで急激に上がり、その後は横ばいになります。10ポイントを超えると再検査信頼性は再び低下します。5, 1 |
| ラベル | 可能な限りすべてのポイントにラベルを付ける | 数字だけでは解釈がぶれます。「10点中6点」の受け取り方は人によって異なりますが、「やや簡単」は誰もが同じように受け取ります。 |
| 方向 | 最初から最後まで同じにする | 調査票の途中で方向を逆にすると、本当の意見の変化のように見える押し間違いが生じます。 |
| 中間点 | 中立が実際にありうる立場なら入れる | 中間点をなくしても、隠れた傾向が明らかになるわけではありません。本来中間点があった付近で、無作為に選ばれるだけです。1 |
| 該当なし | 中間点とは分けておく | そうしないと、判断できない人が中立として集計され、平均値が知らないうちにずれてしまいます。 |
中間点と「わからない」は、多くのアドバイスが扱っているような独立したスイッチではありません。中間点と並べて「わからない」の選択肢を提示すると、項目によって中間点を選ぶ人の割合がおよそ7〜17パーセントポイント減少しました。6つまり、中立の回答のかなりの部分は、中間の立場の人ではなく、意見を持っていない人なのです。2つの選択肢はまとめて検討しましょう。レイアウトの詳細は評価スケールの質問のガイドで解説しています。
ある態度に関する項目では、「わからない」の選択肢を提示すると15パーセントがそれを選びました。同じ面接でその選択肢がない関連項目では、実質的な回答をしなかったのは3パーセントと4パーセントだけで、しかもそれらの回答は、その後の投票行動を予測していました。7簡単な逃げ道は使われてしまい、そこに集まる回答の一部は本当の意見だったのです。
ステップ5. 表現を中立に保ち、偏りがないか確認する
このステップは最も多くのエビデンスに裏付けられ、測定された効果も最大です。スプリットサンプル実験では、根底にある意見が同じでも、言葉を変えただけで結果が数十パーセントポイント動いています。
1985年の総合的社会調査(General Social Survey)では、アメリカ人の65.2パーセントが「貧困層への援助」への支出が少なすぎると答えました。同じ施策を「福祉」という名称で尋ねると、少なすぎると答えたのはわずか19.8パーセントでした。1つの言葉による45ポイントの差であり、翌年にも62.8対23.1で再現されました。2, 3
フレーミングも同じ働きをします。イラクでの軍事行動への支持は68パーセントでしたが、同じ質問に「たとえ米軍に数千人規模の死傷者が出る可能性があるとしても」と加えると、43パーセントに下がりました。8
これらはスプリットサンプル実験です。同じ調査を無作為に2つに分け、それぞれに1つの表現を使います。この設計によって、「表現が重要だ」という主張が意見から測定結果に変わるのです。
取り除くべきもの
| パターン | 誘導あり | 中立 |
|---|---|---|
| 質問文の中の形容詞 | 「当社の優秀なサポートチームは、どのくらい役に立ちましたか?」 | 「当社のサポートチームは、どのくらい役に立ちましたか、それとも役に立ちませんでしたか?」 |
| 一方向しか示していない | 「登録はどのくらい面倒でしたか?」 | 「登録はどのくらい簡単でしたか、それとも難しかったですか?」 |
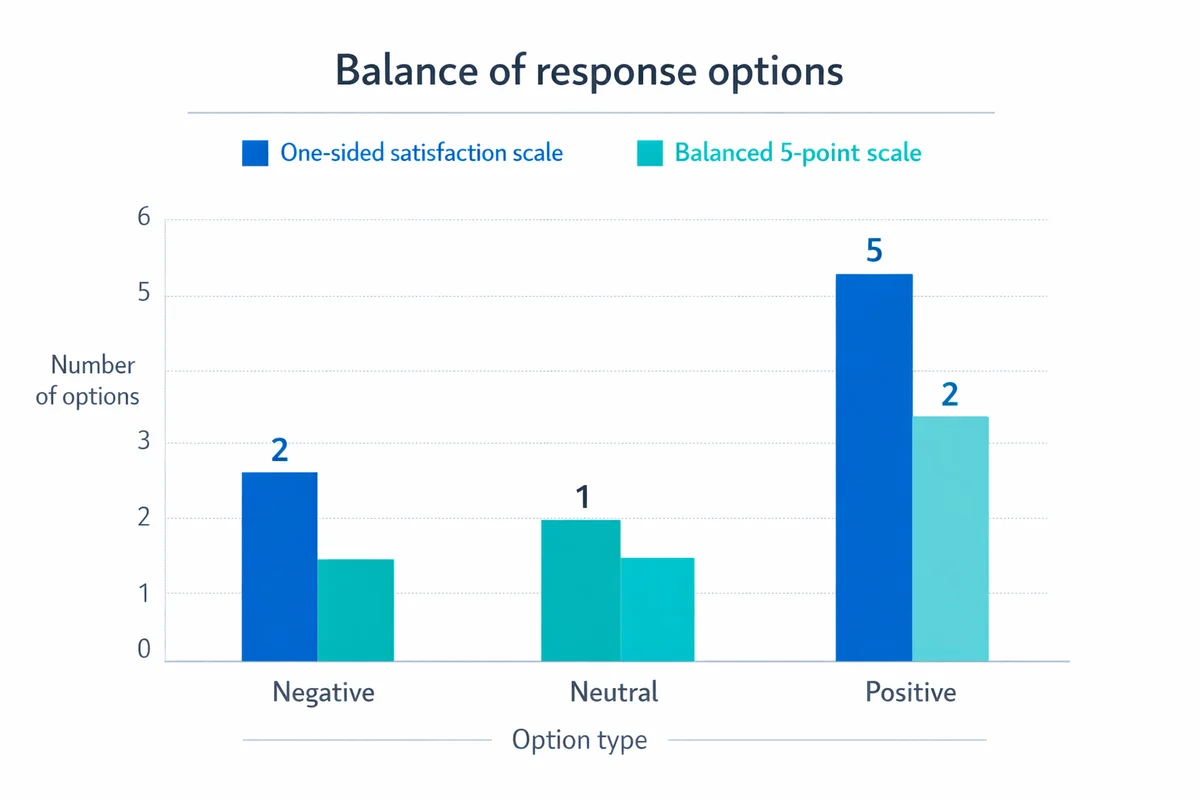
| 一方に偏った回答リスト | 肯定的な選択肢しかない「どのくらい満足していますか?」 | 否定的な選択肢と肯定的な選択肢を同じ数だけ用意する |
| 行動を前提にしている | 「レポートタブをどのように使っていますか?」 | 「過去30日間に、レポートタブを使用しましたか?」 |
偏りは表現だけでなく、回答者の側からも生じます。悪影響の大部分は3つの癖によるものです。社会的望ましさとは、よく見える方向に答えることです。黙従傾向とは、文の内容にかかわらず同意してしまうことです。最小限化(サティスファイシング)とは、正確な回答ではなく、通用しそうな回答を出すのに必要な最低限の労力しかかけないことです。3つすべてを回答バイアスのガイドで解説しています。
ステップ6. 項目を並べ、短い導入文を書く
順序は見た目の問題ではありません。前の質問が後の質問への回答を変えることがあり、その効果は測定できます。同性カップルの法的なパートナー契約への支持は、結婚に関する質問の後に置いた場合は45パーセント、単独で尋ねた場合は37パーセントでした。9変わったのは、その項目の前に何があったかだけです。
うまくいく順序
スクリーニング
ほかの質問をする前に、その人が対象者であることを確認します。それ以外の人は、すぐに終了へ進めます。
ウォームアップ
答えやすい事実に関する項目で、回答者に馴染みのあるテーマの調査票であることを示します。
中心となるブロック
トピックごとにまとめます。ブロック内では尺度を統一し、誰も覚え直さなくて済むようにします。
原因の把握
その上の評価を説明する理由や障害を尋ねます。
デリケートな項目と属性
最後に置き、実際に使うものだけにします。表現のパターンは属性質問をご覧ください。
締めくくり
「その他何かあれば」という自由回答欄を1つ置き、その後にお礼と今後の流れを伝えます。
そのまま使える導入文
5行以内に収めましょう。回答者は読むためではなく、答えるために来ています。
目的:[プロセスまたはサービス]の改善のため、ご意見を集めています。
所要時間:約[X]分です。
プライバシー:ご回答は[匿名/機密]として扱われ、結果は[誰]が閲覧します。
任意回答:どの質問もスキップできます。
お問い合わせ:ご質問は[氏名とメールアドレス]までお寄せください。
所要時間の見積もりには注意が必要です。誰が参加するかが変わるからです。同じ調査票の長さを10分、20分、30分と告知したところ、回答を開始した人の割合は75パーセント、64.9パーセント、62.4パーセントと下がり、開始した人のうち最後まで回答した人の割合は68.2パーセント、56.8パーセント、46.8パーセントと下がりました。10所要時間を明記するのは正しいことです。ただし、その数字はプリテストで得られたものにしてください。
生の回答を誰が見るのか、どのくらいの期間保管するのかをはっきり伝え、それが実際のプライバシーに関する約束と一致していることを確認しましょう。同意と目的の明確さは調査票作成の一部であり、後から付け足す事務手続きではありません。17
ステップ7. 人でプリテストし、データでパイロット調査を行ってから実施する
調査票が実際に良くなるのはこの段階です。プリテストでは、人々がその項目をどういう意味だと考えているかが分かります。パイロット調査では、人々が回答したときにデータがどう見えるかが分かります。両者は別の役割であり、どちらも必要です。16, 19当社の無料アンケート作成ツールでパイロット調査を作成し、サンプル全体に共有する前に、質問の順序、回答選択肢、分岐をスマートフォンでテストしましょう。
音読してもらう
各項目を声に出して読んでもらいます。つかえたり、読み返したり、言い換えたりした箇所は、書き直しの候補です。
意味を掘り下げる
「この質問はあなたにとってどういう意味ですか?」「どのようにしてその回答に至りましたか?」と尋ねます。テストしているのは意見ではなく理解です。
時間を計る
実際にかかる時間を記録します。その数字は導入文に載せるもので、たいてい予想より長くなります。
書き直して再度行う
新しい調査票では、1回で十分なことはまずありません。修正したら、別の人でその修正をテストしましょう。
プリテストの面接は何回必要か
思っているより多く必要です。認知面接によるプリテストのモデル分析では、面接の回数が増えるにつれて本当の質問の問題が見つかり続け、安心して打ち切れる明確な頭打ちはありませんでした。14決まった回数は網羅の目安ではなく予算として扱い、実際の回答者に近い人に使いましょう。
パイロット調査の目的
- 選択肢の網羅性。「その他」や「回答しない」が多い場合、リストに何かが欠けています。
- 尺度の使われ方。回答が一方の端に集中している場合、たいていは表現がそちらへ押しやっています。
- ストレートライニング。ブロック全体で同じ回答が続くことです。パネルデータでは、それがありうるパターンのブロックで15〜40パーセント、そうでないブロックでは2パーセント未満です。13
- ロジック。回答者に、その人に該当するフォローアップ質問だけが表示されることを確認します。
- 離脱ポイント。回答者が離脱する項目を記録しましょう。問題はたいてい長さではなく、その項目です。
これは2つの異なる問いに答える2つの異なる数字であり、一方を他方として扱うのはよくある、そして代償の大きい間違いです。30人いれば、不備のある選択肢リスト、人によって読み方が異なる質問文、一度も作動しないロジックの分岐を見つけるには十分です。パイロット調査の目的はそれだけです。割合を推定したり、2つのグループをある程度の確信をもって区別したりするには、まったく足りません。パイロット調査で調査票を直し、本調査の規模はサンプルサイズのガイドを使って別に決めましょう。
実施時には、控えめな回答率を想定しておきましょう。非確率抽出法のオンラインパネルでは、10パーセント以下の回答率が今では珍しくありません。21
実例:7つのステップすべてを通して作る1つの調査票
このテーマのガイドはどれも、個々の質問を直す例を示しています。1つの調査票を作り上げる例を示しているものはほとんどありません。そこで、冒頭の意思決定から最後の調査票まで、上記のステップを順に使った完全な例を紹介します。
約40人の業務チームが、5月に2日間の安全研修を受けました。経営陣は次回の形式を決めなければなりませんが、データは誰も持っていません。依頼内容はこれだけです。では、ステップを進めましょう。
| ステップ | この例で生まれたもの |
|---|---|
| 1. まず意思決定から | 3つの意思決定:2日間の形式を続けるか短いオンラインセッションに移行するか、どのモジュールを最初に書き直すか、研修内容がそもそも業務で使われているか。以下のすべてが、このいずれかにつながっています。 |
| 2. 項目と形式 | 9つの項目。件数を尋ねる選択回答形式の項目2つ、ラベル付きの評価項目2つ、単一回答のリスト3つ、的を絞った自由回答欄1つ、締めくくりの自由回答欄1つ。冒頭にスクリーニング質問が1つ。 |
| 3. 答えられる表現 | 行動に関するすべての項目に、明示した期間(「研修後の30日間に」)を設けました。「チェックリスト」は前提とせず、質問文の中で定義しています。 |
| 4. 選択肢と尺度 | 件数には重複しない範囲を使用。2つの評価はどちらも同じ5ポイントを同じ方向で使用。「まだ使ったことがない」は中間点とは別に設置。 |
| 5. 誘導を取り除く | 「優れた新しいチェックリストはどのくらい役に立ちましたか」を「どのくらい役に立ちましたか、それとも役に立ちませんでしたか」に変更。形式に関する項目では、両方の選択肢に加えて「どちらでも参加できる」と「どちらも参加できない」を用意し、望ましい回答に誘導しないようにしています。 |
| 6. 順序と導入文 | スクリーニング、行動、評価、形式の決定、障害、シフト、最後に自由回答の順。シフトを終盤に置いているのは、回答者が答えたくない可能性がある唯一の項目だからです。 |
| 7. プリテストとパイロット調査 | 4人に音読してもらいました。2人が「チェックリスト」を別の文書だと解釈したため、Q2に「モジュール2の1ページのチェックリスト」という言葉を加えました。この1つの修正こそが、ステップ7が必要な理由のすべてです。 |
完成した調査票
9つの項目とスクリーニング質問です。コピーして、名詞を差し替えてください。所要時間の見積もりはコピーせず、ご自身の音読で確かめてください。
研修後の調査票:10項目
- Q0. 5月12日・13日の安全研修に参加しましたか? 単一回答、スクリーニングウォームアップではなく、スクリーニングです。「いいえ」と答えた人は、すぐに最後へ進めます。これがないと、参加しなかった人と不満を持った参加者を区別できません。
- Q1. 研修後の30日間に、モジュール2の1ページのチェックリストを実際の業務で何回使いましたか? 単一回答、件数期間と文書を明示しています。範囲が重複しないため、3回使った人が選べる場所はちょうど1つです。この項目だけで3つ目の意思決定に答えられます。
- Q2. 実際の業務でチェックリストを使うのは、どのくらい簡単でしたか、それとも難しかったですか? 5段階評価、全ポイントにラベル1とても難しい2345とても簡単質問文に両方の方向が入っているため、何も示唆していません。「まだ使ったことがない」を尺度の中ではなく外に置いているので、判断できない人が中立として集計されません。
- Q3. 研修のどの部分が最も分かりにくかったですか? 単一回答、逃げ道となる選択肢ありこの項目は2つ目の意思決定に答えます。「分かりにくい部分はなかった」はモジュールと同じくらい重要です。これがないと、全員が存在しないかもしれない問題を挙げざるを得なくなります。
- Q4. その部分が分かりにくかったのはなぜですか? 自由回答、Q3でモジュールを選んだ場合のみ表示簡単に言うと置く価値のある唯一の自由回答形式の項目です。特定の回答に的を絞っており、ほとんどの人はスキップし、モジュールの書き直し方を教えてくれる唯一の手がかりになります。
- Q5. 同じ研修をもう一度行う場合、どの形式なら全日程に参加できますか? 単一回答、バランスを考慮意思決定のための項目です。推測を招く好みではなく、回答者が答えられる参加可否を尋ねています。「どちらでも参加できる」と「どちらも参加できない」はどちらも本当の回答であり、どちらも行動につなげられます。
- Q6. 参加の妨げになりそうなことは何ですか? 当てはまるものをすべて選んでください。 選択式(複数回答)、逃げ道となる選択肢あり「当てはまるものをすべて選ぶ」形式は回答の負担が大きいため、控えめに使いましょう。ここで使うのが妥当なのは、障害が重なりうるからです。2つの障害を同時に抱える人もいるため、1つの回答を強いるとそれが見えなくなります。
- Q7. この研修をチームの誰かに勧める可能性は、どのくらい高いですか、それとも低いですか? 5段階評価、Q2と同じ尺度1非常に可能性が低い2345非常に可能性が高いQ2と同じ5ポイント、同じ方向です。1つの尺度を使い回せば誰も覚え直す必要がなく、2つの項目を同じグラフに並べられます。
- Q8. 普段はどのシフトで勤務していますか? 単一回答、後半に配置回答者が答えたくない可能性がある唯一の項目なので、終盤に置いています。分析計画でシフト間を比較するからこそ入れている項目で、比較しないのであれば削除します。
- Q9. 形式を決める前に、ほかに知っておくべきことはありますか? 自由回答、任意任意締めくくりの回答欄です。選択肢のリストで漏れたことを拾い、尋ねるべきだった質問について最も低コストで得られる早期警告になります。
上の回答選択肢は表示用で、クリックはできません。調査票の見本であって、実際に機能するフォームではありません。ここでは何も収集されません。印刷するとメモが省かれて10項目だけになるため、ブラウザの「PDFとして保存」を使えば、配布できる文書になります。
この調査票は上の例のために作成したものです。白紙から始めたくない場合は、既存のテンプレートから始めて、ご自身の意思決定に合わせて項目を変更できます。
すでに書いた項目をチェックする
作成中の質問を貼り付けてください。上のステップで説明したものと同じチェックを行い、どのチェックに引っかかるかを表示します。これはチェックリストであって判定ではありません。言葉のパターンを読み取るだけで意図までは読み取れず、指摘された項目が正しい場合もあります。
スライドではなく分析用ファイルを見据えて設計する
この制約はすべてのステップに当てはまるため、7つのステップには含めていません。調査票はデータ仕様書でもあります。回答をきれいに集計できなければ、何週間もの整理作業と、根拠を説明できない数字を抱えることになります。
- 1列に1つの構成概念。スピードと正確さの両方が気になるなら、2つの項目で測定しましょう。一緒にした構成概念を後から分けることはできません。
- 期間を統一しましょう。ある項目で「先週」、次の項目で「昨年」と混在させると、2つを同じグラフに載せられなくなります。
- グループ分けに使うものは、事前にコード化しましょう。部署名を自由記述にすると、6つの部署が40通りの書き方で返ってきます。リストを用意しましょう。
- 欠測が何を意味するかを、実施前に決めましょう。スキップ、「回答しない」、「該当なし」は3つの異なるもので、3つの異なるコードが必要です。
比較と精度は同時に計画しましょう。完璧な調査票でも、2つのグループを区別するには回答が少なすぎる調査を救うことはできません。それはサンプルサイズの問題であり、差がどの時点で本物とみなされるかは統計的有意性の問題です。
作成に使ったノートパソコンではなく、スマートフォン向けに設計する
すべてのステップに共通する2つ目の制約です。モバイル回線のスマートフォンで、途中で中断が入る状況を想定しましょう。
同じ調査票でも、スマートフォンはパソコンより時間がかかります。同じ人が両方の端末で回答したクロスオーバー実験では、回答時間の中央値はスマートフォンで17.7分、PCで10.5分でした。11同じ内容で69パーセント長いということは、ノートパソコンで時間を計った調査票は、間違った端末で計られていることになります。
スマートフォンの回答は質が低いという反射的な思い込みは、部分的にしか正しくありません。ここは正確に理解しておく価値があります。ある直接比較では、モバイルの回答者は自由回答が短く、スキップする項目も多かった一方で、グリッド形式の質問でストレートライニングが多かったのはPCの回答者でした。12スマートフォンの問題は不注意ではなく、負担と中断なのです。
- グリッドを分割しましょう。小さな画面での横に広いマトリックスは考えうる最悪のパターンであり、ストレートライニングの温床です。
- 選択肢は折り返さない長さにしましょう。2行にわたる選択肢は、ひと目で比較できなくなります。
- フォローアップ質問は該当する場合にだけ表示しましょう。スキップロジックは、項目を削るよりも体感の長さを短くします。
- タップ領域は広く取りましょう。ラジオボタンは密集させず、十分な間隔を空けます。
- 進行状況バーは正確な場合にだけ使いましょう。スキップロジックのせいで後戻りするバーは、バーがないよりも悪い結果になります。
調査票は定性的ですか、定量的ですか?
何を入れるかによって、どちらにもなります。調査票は方法そのものではありません。固定された選択肢を持つ選択回答形式の項目で構成された調査票からは定量データが得られ、自由回答の問いかけで構成された調査票からは定性データが得られます。実際の調査票の多くは両方を含んでいます。間違いは、どちらかを選ばないことではなく、意図して決めないことです。
| 設計上の選択 | 定量的な目的 | 定性的な目的 |
|---|---|---|
| 知りたいこと | どのくらい、何人、グループ間でどう違うか | なぜか、誰の言葉でか、そして尋ねようと思いつかなかったこと |
| 項目 | 主に選択回答形式で、形式は事前に固定 | 主に自由回答の問いかけと深掘りの質問 |
| 表現のルール | 全員に同一、例外なし | 一貫させるが、問いかけで詳しい説明を促してもよい |
| 必要な人数 | 予定している比較に十分な人数 | 新しい回答から新しいテーマが出なくなるまでの人数 |
| 得られるもの | 件数、割合、グループ間の差 | コード化したテーマ、引用、次に検証する仮説 |
| 主なリスク | 表現の悪い質問への正確な回答 | 一貫した方法でコード化できない豊富な回答 |
研究プロジェクトでは、通常は混合型が適切です。測定を担う少数の選択回答形式の項目と、数値を説明する1〜2個の自由回答の問いかけです。最も変わるのはステップ2です。自由回答にはコーディング体系が必要で、コーディング体系は信頼できるようになるまでに複数のコーダーが必要だからです。1項目ではなく調査の形を選んでいるのであれば、その判断は1段階上の調査設計で行うものです。
証明されたルールと、繰り返されているだけのルール
調査票のアドバイスはページからページへと写され、どのルールも同じくらい確立しているように聞こえるようになります。しかし実際はそうではありません。数十年にわたるスプリットサンプル実験に基づくルールもあれば、最近の研究1件だけに基づくものもあり、広く出回っている数字の中にはまったく根拠のないものもあります。このページの各主張が実際にどの位置にあるかを示します。
| 主張 | 数値 | 等級 | 出典 |
|---|---|---|---|
| 表現が結果を変える | 同じ施策を「貧困層への援助」と呼んだ場合と「福祉」と呼んだ場合で、支出が「少なすぎる」と答えた人は65.2%対19.8% | A | Rasinski 1989、Smith 19872, 3 |
| フレーミングが結果を変える | 死傷者に関する一文の有無で、支持は68%対43% | A | Pew Research Center8 |
| 順序が結果を変える | 同じ項目で位置を変えると、支持は45%対37% | A | Pew Research Center 20039 |
| 項目に即した選択肢は「同意する/同意しない」に勝る | 信頼性0.87〜0.93対0.36〜0.73 | A | Saris ほか 20104 |
| 告知した長さが参加を変える | 告知時間が10分、20分、30分のとき、開始者のうち完了した割合は68.2%、56.8%、46.8%と低下 | A | Galesic and Bosnjak 200910 |
| 「わからない」を提示すると選ばれる | 15%が選択。それがない同等の項目でスキップしたのは3%と4%のみ | A | Gilljam and Granberg 19937 |
| スマートフォンは時間がかかる | 同じ人が両方の端末で回答し、中央値は17.7分対10.5分 | A | Antoun ほか 201711 |
| 尺度は5〜7ポイント | 指標は約7ポイントまで上昇した後は横ばい。10ポイントを超えると信頼性は再び低下 | B | Preston and Colman 20005, 1 |
| 「わからない」の選択肢が中間点から人を引き離す | 中間点の選択が約7〜17ポイント減少 | B | Wetzelhutter 20206 |
| ありうる場面ではストレートライニングはよく起こる | ありうるブロックで15%〜40%、それ以外では2%未満 | B | Schonlau and Toepoel 201513 |
| スマートフォンの回答が単純に劣るわけではない | モバイルでは自由回答が短いが、ストレートライニングはPCのほうが多い | B | Mavletova 201312 |
| ダブルバーレル質問の項目は分ける | 明確な割合はなし。2つの版は同じものを測定していなかった | B | Menold 202015 |
| プリテストに安全な打ち切り点はない | 面接の回数が増えても問題が見つかり続けた | B | Blair and Conrad 201114 |
等級の意味:A 再現された実験、または文献全体の統合。B 1件の強力な研究。C 広く繰り返されているが異論がある、または出典をたどれないもの。このページにCが1つもないのはそのためです。
あえて使わなかった数字
いずれも調査票のアドバイスでよく見かけるものです。すべての出典をたどったうえで、掲載を見送りました。
「集中力の持続時間は今や8秒で、金魚より短い」
たどると2015年のマーケティングレポートに行き着きます。そのレポートはコンテンツファームのサイトを引用しており、記者が問い合わせても、そのサイト自身の出典は示されませんでした。24金魚との比較も作り話です。
「プリテストの面接を5〜7回行えば、問題の75〜85パーセントが見つかる」
これはソフトウェアの不具合に関するユーザビリティテストの結果22が、認知面接に持ち込まれたものです。実際の調査研究では、そのような頭打ちは見られませんでした。14
「アンケートの平均回答率は[好きな数字]です」
互いに矛盾する数字が少なくとも4つ出回っており、それぞれ誰に尋ねたかの定義が隠れています。代わりに、サンプルの種類別の根拠ある範囲があります。21
「10分以内に収めないと回答者を失う」
方向性は正しいものの、急激な落ち込みはありません。測定された曲線は、告知時間10分から30分にかけてなだらかに下がる坂であり、境目はありません。10
「7±2だから7ポイントの尺度を使う」
Millerの1956年の論文はリストの短期記憶に関するもので、人が尺度上で何ポイントを区別できるかについてのものではありません。23実際の尺度ポイント数に関するエビデンスでも、いずれにせよ5〜7という結論になります。5
「ダブルバーレル質問はデータを台無しにする」
ルールは妥当ですが、エビデンスは乏しいものです。表現効果や順序効果については数十件あるのに対し、これを専門に扱ったランダム化検証は1件しか見つかりませんでした。15誇張せず、ステップ3でそのように述べています。
調査票を知らないうちに壊す例外的なケース
デリケートな項目
収入、健康、業績上の問題、そして上司が読む可能性のあるもの全般です。信頼が低いと、これらは途中離脱と虚偽の報告の両方を増やします。終盤に置き、なぜ尋ねるのかを1行で伝え、本当に断れる方法を用意しましょう。「回答しない」はデータです。空欄はデータではありません。
「該当なし」は「中立」ではない
判断できない人を尺度の真ん中に入れないようにしましょう。尺度の外に別の選択肢を用意するか、スキップロジックでその項目を飛ばします。そうしないと、意見とは関係のない理由で平均値が動いてしまいます。
長いリストの中の順序効果
画面上では、長いリストの上のほうにある選択肢ほど選ばれやすくなります。ブランド、理由、課題の順序はランダムにし、頻度の段階や日付のように順序に意味がある場合にだけ固定しましょう。
否定表現
「オンボーディングは難しくないということに同意しますか?」では、読み手は答える前に2つの否定を解かなければなりません。肯定形で書き、方向は尺度に任せましょう。
翻訳
慣用句、スポーツの比喩、地域特有の略語は避けましょう。翻訳するとうまく伝わらないうえ、その言語を第二言語として使う読み手を締め出してしまいます。翻訳する場合は逆翻訳を行い、言語だけでなくテーマにも詳しい人に確認してもらいましょう。
繰り返し調査
今回の結果を次回と比較する予定なら、今の時点で表現を固定しましょう。調査の回の間に項目を改善すると、測定された変化が自分の編集によるものかもしれなくなります。古い表現を残したまま、1回分だけ改善した表現を並べて使い、その後に切り替えましょう。
配信前の見直しチェックリスト
調査票の見直しチェックリスト
- 意思決定。すべての項目が、ステップ1で書き出した意思決定につながっている。
- 形式。各項目の形式を、習慣ではなく、つながるアウトプットに合わせて選んでいる。
- 期間。行動に関するすべての項目で期間を明示し、その期間が行動に合っている。
- 用語。専門用語は質問文の中で定義している。略語は一度正式名称で書いている。
- 1つの内容。2つの属性、2つの対象、2つの期間を隠した項目がない。
- 選択肢。範囲が重複せず、現実的な回答を網羅し、逃げ道となる選択肢がある。
- 尺度。同じポイント数、同じ方向で、ラベルを付け、「該当なし」を尺度の外に置いている。
- 中立的な表現。質問文に形容詞がなく、両方の方向を示している。
- 順序。スクリーニングが最初、デリケートな項目は後半、1ブロックに1つの尺度。
- 導入文。目的、正直な所要時間、プライバシー、任意であること、連絡先。5行。
- スマートフォン。実際のスマートフォンで開いて確認し、横に広いグリッドや折り返す選択肢がない。
- 音読。プロジェクト外の人がすべての項目を読み、それぞれを意図どおりに理解した。
- 所要時間。導入文の数字は、推測ではなくその音読から得たものである。
- コード。スキップ、回答拒否、該当なしに3つの別々のコードがある。
よくある質問
調査票設計の最初のステップは何ですか?
結果をもとに下すべき意思決定を書き出すことです。テーマではなく、意思決定です。回答に応じて何を変えるのかを言えるようになるまで、必要な項目と任意の項目を見分ける方法はなく、誰かが飽きるまで草案は膨らみ続けます。
調査票とアンケートの違いは何ですか?
調査票は道具であり、項目とその回答選択肢のリストです。アンケートはそれを取り巻く調査全体で、誰に尋ねるか、どう届けるか、何人必要か、結果をどう扱うかを含みます。1つのアンケートで複数の調査票を使うことも、同じ調査票を複数のアンケートで使うこともできます。
調査票には質問をいくつ入れるべきですか?
意思決定に必要な最小限の数です。目標の数を追いかけるのは間違いです。代わりに回答時間を目標にし、その時間は経験則ではなくご自身の音読から求めましょう。告知した長さは誰が参加するかに影響します。対照実験では、回答を開始した人のうち完了した割合は、告知時間10分で68.2パーセント、30分で46.8パーセントまで低下しました。
調査票の回答にはどのくらいの時間をかけるべきですか?
告知した時間で人が敬遠しない程度に短く、実際と一致する程度に正直であるべきです。特定の分数で急激に落ち込むわけではありません。測定された関係は、告知時間が長くなるにつれて参加がなだらかに減るというものです。残す項目はすべて回答を少しずつ減らすため、それぞれが何をもたらすのかを説明できるようにしておきましょう。
調査票は定性的ですか、定量的ですか?
どちらにもなり得ますし、ほとんどは両方を少しずつ含んでいます。固定された選択肢を持つ選択回答形式の項目からは定量データが、自由回答の問いかけからは定性データが得られます。大切なのは、項目を書く前にその項目がどちらのためのものかを決めることです。両者では表現のルールも、必要な回答者数も、分析もまったく異なるからです。
評価スケールに中立の中間点を入れるべきですか?
測定している対象について「中立」が本当にありうる立場なら入れましょう。中間点をなくしても、隠れた意見が引き出されるわけではなく、真ん中に近いポイントの中からおおむね無作為に選ばれるだけです。また、中間点と「わからない」の選択肢はまとめて決めましょう。「わからない」を提示すると、中間点の使用がおよそ7〜17パーセントポイント減るからです。
「わからない」の選択肢はどのような場合に用意すべきですか?
プラン名、日付、技術的な詳細など、回答者が本当にその情報を持っていない可能性がある場合です。ほぼ全員が答えられる、本人の経験に関する質問では避けましょう。簡単な逃げ道は選ばれてしまいます。ある態度に関する項目では、「わからない」を提示すると15パーセントがそれを選び、提示しなかった同等の項目でスキップしたのは3〜4パーセントだけでした。
自由回答形式の質問はいくつ使うべきですか?
1〜2個を、効果を発揮する場所に置きましょう。通常は、特定の選択回答へのフォローアップと、最後の受け皿として使います。自由回答は、選択肢のリストで見落としていたことを知る唯一の方法ですが、結果に意味を持たせるにはコーディング体系と複数のコーダーが必要で、そのコストは現実的なものです。
配信前に調査票をテストするにはどうすればよいですか?
2段階で行います。プリテストでは理解度を確認します。各項目を音読してもらい、どういう意味だと思うか、どのように回答を選んだかを話してもらいます。パイロット調査は小規模な本番実施で、データを確認します。離脱ポイント、選択肢の網羅性、尺度の使われ方、予定している分析が実際に機能するかどうかです。表現を変えるのはプリテストなので、プリテストを先に行いましょう。
調査票を使うのはどのような調査設計ですか?
調査票は設計ではなくデータ収集の道具なので、いくつもの設計で使われます。横断研究では1時点で1回使います。トレンド研究やパネル研究では、時間をおいて繰り返し使います。実験では、操作の後の結果を測定するために使います。これらの中から選ぶのは調査設計上の判断であり、項目の表現より1段階上の話です。
調査票の妥当性はどのように検証しますか?
具体的なことを測定する少数の新しい項目に必要なのは、心理測定学的な妥当性検証ではなくプリテストです。抽象的なものを測定し、グループ間で比較したり他の人が再利用したりすることを想定した尺度には、さらに多くのことが必要です。専門家による内容の確認、項目のまとまりを確認できる規模のパイロット調査、そしてスコアが予測どおりに外部の何かと関係していることを示すエビデンスです。ご自身の構成概念について妥当性が検証された調査票がすでにあるなら、自分で作らずにそれを使いましょう。
このガイドの作成方法と、扱っていない範囲
7つのステップの順序は、特定のベンダーのフレームワークではなく、調査票の方法論の文献で説明されている開発プロセス16, 17, 18, 20に従っています。このページで引用しているすべての数字は、以下に挙げる公表された実験または公式の方法論レポートによるものです。いずれも使用前に等級を付けており、エビデンスの表で各主張の横にその等級を示しています。
一次資料までたどれなかった主張は掲載せず、その中でもよく見かけるものは、ほかの場所で見かけたときに気付けるよう「あえて使わなかった数字」で挙げています。ダブルバーレル質問の項目を分けることのように、ルールは妥当でも直接的なエビデンスが乏しい場合は、より強い知見から確信を借りるのではなく、そのように明記しています。
ここで紹介している実験的エビデンスの多くは、米国と西ヨーロッパで実施された調査によるもので、主に一般の人々やウェブパネルのサンプルを対象としています。表現や順序の効果の大きさは、あらゆる言語、テーマ、母集団にそのまま当てはまるわけではなく、いずれもお客様の回答者で検証されたものではありません。これらの数字は、こうした効果が実在し、大きくなりうることを示すエビデンスとして扱い、そのまま当てはめられる定数とは考えないでください。
実例は、7つのステップすべてを1か所で示すために作成した架空の事例です。実際の研究の報告ではなく、その中で説明しているプリテストも例示です。
このページで扱うのは調査票そのものです。誰に尋ねるか、何人に尋ねるか、返ってきたものをどう分析するかは扱っていません。それらは別の作業であり、サンプリング、サンプルサイズ、統計的有意性で解説しています。
SuperSurveyはアンケートソフトウェアを提供しているため、人々がアンケートを実施することに商業的な利害関係があります。このガイドは無料でお読みいただけ、そのアドバイスはどのアンケートプラットフォームにも当てはまります。項目チェッカーはすべてブラウザ内で動作し、どこにも何も送信しません。当社の作成ツールとテンプレートライブラリへのリンクは、調査票を実践に移すための手段として紹介しています。
参考文献
- Krosnick, J. A., & Presser, S. (2010). Question and questionnaire design. In P. V. Marsden & J. D. Wright (Eds.), Handbook of Survey Research (2nd ed., ch. 9). Emerald.
- Rasinski, K. A. (1989). The effect of question wording on public support for government spending. Public Opinion Quarterly, 53(3), 388-394. doi.org/10.1086/269158
- Smith, T. W. (1987). That which we call welfare by any other name would smell sweeter. Public Opinion Quarterly, 51(1), 75-83. doi.org/10.1086/269015
- Saris, W. E., Revilla, M., Krosnick, J. A., & Shaeffer, E. M. (2010). Comparing questions with agree/disagree response options to questions with item-specific response options. Survey Research Methods, 4(1), 61-79. doi.org/10.18148/srm/2010.v4i1.2682
- Preston, C. C., & Colman, A. M. (2000). Optimal number of response categories in rating scales. Acta Psychologica, 104(1), 1-15. doi.org/10.1016/S0001-6918(99)00050-5
- Wetzelhutter, D. (2020). Scale-sensitive response behavior: consequences of offering versus omitting a "don't know" option and/or a middle category. Survey Practice, 13(1). doi.org/10.29115/SP-2020-0012
- Gilljam, M., & Granberg, D. (1993). Should we take don't know for an answer? Public Opinion Quarterly, 57(3), 348-357. doi.org/10.1086/269380
- Pew Research Center. Writing survey questions. Methods explainer. pewresearch.org/writing-survey-questions
- Pew Research Center (2003, November 18). Religious beliefs underpin opposition to homosexuality, Part 2: Gay marriage. pewresearch.org/politics/2003/11/18/part-2-gay-marriage
- Galesic, M., & Bosnjak, M. (2009). Effects of questionnaire length on participation and indicators of response quality in a web survey. Public Opinion Quarterly, 73(2), 349-360. doi.org/10.1093/poq/nfp031
- Antoun, C., Couper, M. P., & Conrad, F. G. (2017). Effects of mobile versus PC web on survey response quality. Public Opinion Quarterly, 81(S1), 280-306. doi.org/10.1093/poq/nfw088
- Mavletova, A. (2013). Data quality in PC and mobile web surveys. Social Science Computer Review, 31(6), 725-743. doi.org/10.1177/0894439313485201
- Schonlau, M., & Toepoel, V. (2015). Straightlining in web survey panels over time. Survey Research Methods, 9(2), 125-137. doi.org/10.18148/srm/2015.v9i2.6128
- Blair, J., & Conrad, F. G. (2011). Sample size for cognitive interview pretesting. Public Opinion Quarterly, 75(4), 636-658. doi.org/10.1093/poq/nfr035
- Menold, N. (2020). Double barreled questions: an analysis of the similarity of elements and effects on measurement quality. Journal of Official Statistics, 36(4), 855-886. doi.org/10.2478/jos-2020-0041
- Rattray, J., & Jones, M. C. (2007). Essential elements of questionnaire design and development. Journal of Clinical Nursing, 16(2), 234-243. doi.org/10.1111/j.1365-2702.2006.01573.x
- Boparai, J. K., Singh, S., & Kathuria, P. (2019). How to design and validate a questionnaire: a guide. Current Clinical Pharmacology, 13(4), 210-215. doi.org/10.2174/1574884713666180807151328
- Slattery, E. L., Voelker, C. C. J., Nussenbaum, B., Rich, J. T., Paniello, R. C., & Neely, J. G. (2011). A practical guide to surveys and questionnaires. Otolaryngology-Head and Neck Surgery, 144(6), 831-837. doi.org/10.1177/0194599811399724
- Edwards, P. (2010). Questionnaires in clinical trials: guidelines for optimal design and administration. Trials, 11, 2. doi.org/10.1186/1745-6215-11-2
- Stone, D. H. (1993). Design a questionnaire. BMJ, 307(6914), 1264-1266. pmc.ncbi.nlm.nih.gov/articles/PMC1679392
- American Association for Public Opinion Research (2022). Data quality metrics for online samples: considerations for study design and analysis. Task force report. aapor.org タスクフォース報告書(PDF)
- Nielsen, J., & Landauer, T. K. (1993). A mathematical model of the finding of usability problems. Proceedings of ACM INTERCHI '93, 206-213. doi.org/10.1145/169059.169166
- Miller, G. A. (1956). The magical number seven, plus or minus two. Psychological Review, 63(2), 81-97. doi.org/10.1037/h0043158
- Maybin, S. (2017, March 10). Busting the attention span myth. BBC News. bbc.com/news/health-38896790
2026年8月21日に、上記のすべてのDOIをDOIリゾルバーで照合し、すべてのリンクが応答することを確認しました。