
Réponse courte
L’échantillonnage consiste à sélectionner un sous-ensemble d’une population, appelé échantillon, et à étudier ce sous-ensemble pour tirer des conclusions sur l’ensemble de la population. Les chercheurs échantillonnent parce que mesurer tout le monde est généralement trop lent, trop coûteux, ou tout simplement impossible. La population est le groupe que vous voulez décrire, l’échantillon la partie de ce groupe que vous mesurez réellement, et la base de sondage la liste dans laquelle vous tirez l’échantillon.
L’échantillonnage probabiliste sélectionne les personnes au moyen d’un mécanisme aléatoire, de sorte que chaque unité a une probabilité connue et non nulle d’être choisie. C’est ce qui vous permet de chiffrer votre incertitude.
L’échantillonnage non probabiliste sélectionne selon la commodité, des quotas ou le jugement. Il est souvent plus rapide, moins coûteux et parfois la seule option éthique, mais il ne permet pas une estimation de la population assortie d’une précision annoncée.
Accédez directement aux 9 méthodes comparées | comment en choisir une | testez-vous | comment la décrire dans votre rapport
À retenir
- Échantillonner, c’est étudier un sous-ensemble : vous mesurez un échantillon pour connaître une population lorsqu’il n’est pas possible de mesurer tout le monde.
- Maîtrisez d’abord cinq termes : la population, la base de sondage, l’unité d’échantillonnage, le plan d’échantillonnage, et l’écart entre la population que vous visez et celle que vous pouvez réellement atteindre. La plupart des débats sur l’échantillonnage portent en réalité sur l’un d’eux.
- Seules les méthodes probabilistes vous permettent de chiffrer votre incertitude. Les échantillons de commodité, par quotas, raisonnés et en boule de neige peuvent être utiles et honnêtes, mais ils ne permettent pas une estimation de la population assortie d’une précision annoncée.
- Votre base fixe votre plafond : si un groupe ne peut pas figurer sur la liste dans laquelle vous tirez, aucune méthode ni aucun volume de participations supplémentaires ne le fera entrer dans vos résultats.
- La représentativité est une chaîne, pas une étiquette : la base, puis la sélection, puis le recrutement, puis la réponse, puis l’analyse. Un tirage aléatoire n’est qu’un maillon sur cinq.
Définition de l’échantillonnage (et les 5 termes à maîtriser)
L’échantillonnage consiste à sélectionner un groupe plus petit (un échantillon) dans un groupe plus large (une population) afin de connaître la population sans mesurer tout le monde. Une étude de toute la population est souvent irréaliste ; les chercheurs échantillonnent donc pour rendre le travail faisable tout en obtenant des conclusions utiles.
Les cinq termes ci-dessous font l’essentiel du travail dans tout chapitre de méthodologie. Si vous vous trompez sur l’un d’eux, toutes les décisions suivantes héritent de l’erreur.
- Population : le groupe complet que vous voulez décrire, défini avec des limites et une période. « Tous les étudiants infirmiers de dernière année des trois campus, inscrits au 1er mars » est une population. « Les infirmiers » n’en est pas une.
- Population cible ou population accessible : qui vous voulez décrire, par opposition à qui votre recrutement et vos outils peuvent réellement atteindre. Nommer l’écart entre les deux est une force dans un rapport, pas une faiblesse.
- Base de sondage : la liste ou le mécanisme dans lequel vous tirez. Un registre d’étudiants, un registre de patients, une base de données clients, un recensement des ménages d’un village, une liste électorale. Les problèmes de base créent une erreur de couverture, et aucune méthode ne les corrige.
- Unité d’échantillonnage : ce qui est réellement sélectionné. Une personne, un ménage, une clinique, une classe, une équipe de travail, une commande. Dans les plans par grappes et à plusieurs degrés, l’unité du premier degré est un groupe, appelé unité primaire d’échantillonnage.
- Plan d’échantillonnage : l’ensemble du plan, mis par écrit. La base, la méthode, le nombre d’unités, la façon de les contacter et ce que vous ferez des personnes qui ne répondent pas. Le « plan d’échantillonnage » est ce qu’un examinateur ou un relecteur demande réellement lorsqu’il vous interroge sur votre échantillonnage.
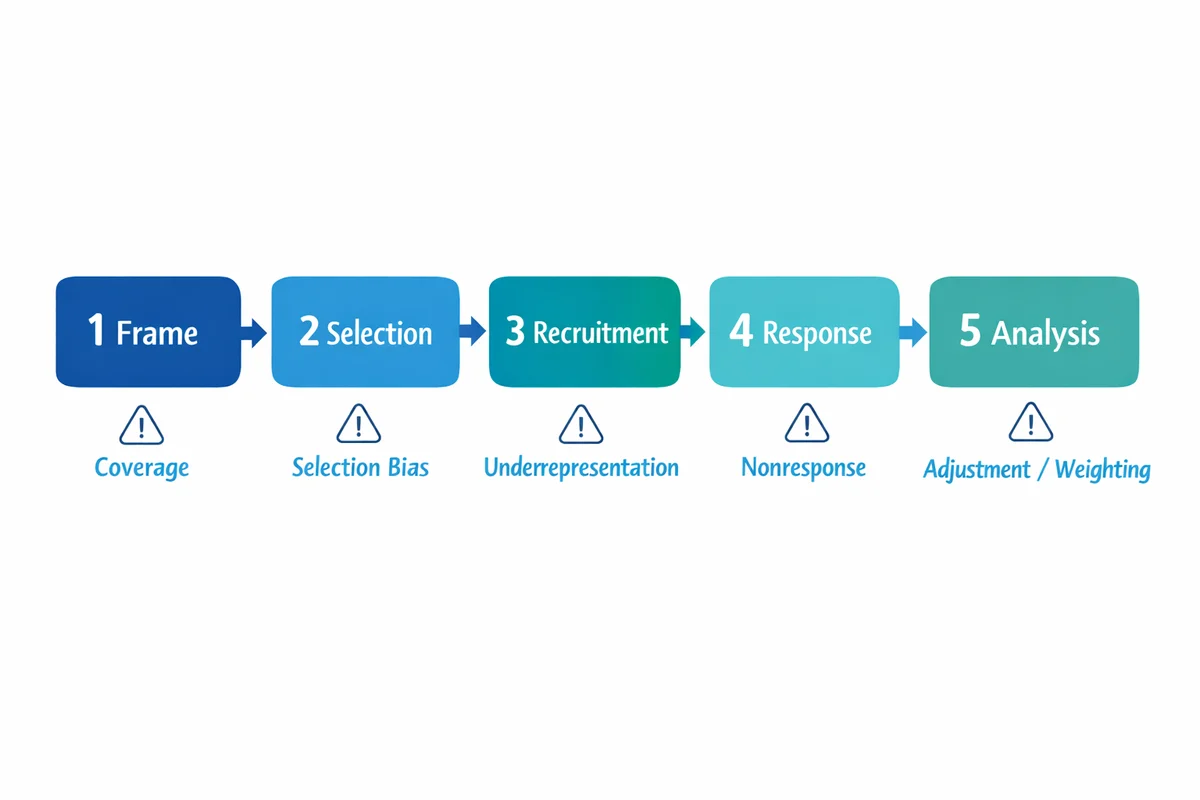
Vous pouvez effectuer une sélection aléatoire digne d’un manuel et obtenir malgré tout un échantillon biaisé. Si votre base omet un segment, ces personnes n’ont jamais pu être tirées. Si un segment ne répond pas, il disparaît après le tirage. Considérez l’échantillonnage comme une chaîne : la base, puis la sélection, puis le recrutement, puis la réponse, puis l’analyse.
Pour une définition officielle et brève de la même idée, consultez la note de formation sur l’échantillonnage de l’U.S. Office of Research Integrity.1 Si vous situez l’échantillonnage dans un plan d’étude plus large, notre guide de méthodologie d’enquête couvre les étapes qui l’encadrent.
Pourquoi échantillonner, et quand un recensement est la meilleure réponse
Le besoin d’échantillonner est pratique avant d’être statistique. Quatre raisons reviennent sans cesse.
Coût
Chaque participant supplémentaire coûte de l’argent, du temps de travail ou de la bonne volonté. Un échantillon de 600 bien tiré peut répondre à la même question qu’une tentative mal menée auprès de 60 000 personnes.
Rapidité
Les décisions ont des échéances. Un échantillon vous donne une réponse dans la période où cette réponse est encore utile.
Faisabilité
Certaines populations ne peuvent pas du tout être dénombrées : les passants d’un marché, les personnes qui ont abandonné un service, les commerçants informels. D’autres sont pratiquement infinies, ou bien mesurer une unité la détruit.
Qualité
Celle-ci surprend. Concentrer les efforts sur un groupe plus petit vous permet de relancer les non-répondants, de bien former les enquêteurs et de vérifier les données. L’effort par unité vaut généralement plus que le nombre d’unités.
Un recensement, au contraire, mesure tout le monde. C’est le meilleur choix lorsque la population est assez petite pour être atteinte, lorsque les coordonnées existent déjà ou lorsque chaque membre a le droit d’être interrogé. Une enquête auprès des salariés d’une organisation de 200 personnes relève du recensement, pas de l’échantillonnage. Une évaluation de cours aussi. Lorsque la population est petite, l’échantillonnage ne vous apporte presque rien et vous coûte la possibilité de présenter les résultats par équipe.
À quoi ressemble vraiment un bon échantillon
Les manuels décrivent un bon échantillon comme « représentatif », ce qui n’est pas un critère opérationnel. Les quatre propriétés suivantes en sont un.
- Couverture : chaque membre de la population cible aurait pu, en principe, être sélectionné.
- Sélection maîtrisée : qui se retrouve dans l’échantillon est décidé par une règle, et non par qui se porte volontaire ou qui se trouve le plus près de la porte.
- Assez d’unités dans le plus petit groupe à présenter : un chiffre global peut paraître solide alors que le groupe qui vous intéresse vraiment repose sur 11 participations.
- Descriptible : vous pouvez décrire exactement comment il a été tiré, et quelqu’un d’autre pourrait le refaire.
| Si votre objectif est de | Conséquence pour l’échantillonnage | Piège courant |
|---|---|---|
| Estimer un pourcentage dans la population | Utilisez une méthode probabiliste, suivez qui répond et indiquez la précision à côté du chiffre. | Traiter un échantillon de commodité comme s’il décrivait la population. |
| Comparer des sous-groupes | Prévoyez le nombre de participations par sous-groupe, généralement en stratifiant et en suréchantillonnant les petits groupes. | Présenter un sous-groupe dont le résultat repose sur une poignée de personnes. |
| Explorer des expériences et des mécanismes | Une sélection raisonnée ou théorique est appropriée. Justifiez quels points de vue sont couverts et lesquels ne le sont pas. | Viser un minimum chiffré sans aucune justification. |
| Tester une intervention | L’échantillonnage détermine à qui le résultat se généralise. L’affectation aléatoire détermine si l’effet est réel. | Confondre affectation aléatoire et échantillonnage aléatoire. Ce sont deux opérations différentes. |
Pour une présentation accessible de la façon dont les échantillons permettent d’estimer une population, la présentation de l’échantillonnage et de l’inférence par l’U.S. Census Bureau est un bon point de départ.2
Votre base de sondage fixe le plafond
Une base de sondage est la liste ou le mécanisme concret dans lequel vous tirez. C’est la partie la moins discutée de l’échantillonnage, et l’endroit où la plupart des études réelles déraillent sans bruit, car c’est la base qui décide qui pouvait même être sélectionné.
Les bases sont des objets ordinaires. Un registre d’étudiants, un registre de patients, un fichier du personnel, une base de données clients. Une liste de villages avec le nombre de ménages, une liste électorale, une série de commandes, une liste des cliniques d’un district. Remarquez que certaines bases listent des personnes et d’autres des lieux. Cette distinction décide des méthodes qui vous sont ouvertes.
| Problème | À quoi il ressemble | Ce qu’il fait à vos résultats |
|---|---|---|
| Sous-couverture | Des membres de la population manquent sur la liste : le personnel sans e-mail professionnel, les clients qui ont acheté en magasin, les ménages sans adresse enregistrée. | Des segments entiers ont une probabilité de sélection nulle. Des participations supplémentaires ne peuvent pas y remédier, car les personnes manquantes n’ont jamais pu être sélectionnées. |
| Surcouverture | La liste contient des unités hors de votre population : anciens étudiants, comptes clôturés, personnes qui ont déménagé. | Vous gaspillez des efforts et, si vous ne les écartez pas, vous mesurez la mauvaise population. |
| Doublons | La même personne apparaît plusieurs fois : deux adresses e-mail, deux numéros de compte. | Ces personnes ont une probabilité de sélection plus élevée que les autres, ce qui rompt discrètement l’hypothèse de probabilités égales. |
| Obsolescence | La liste était exacte lors de sa création et ne l’est plus. | Les contacts injoignables ressemblent à des refus, si bien que votre taux de réponse et votre diagnostic de biais sont tous deux faussés. |
Auditez la base avant le tirage, pas après. Comptez les lignes. Comparez ce nombre à tout total indépendant que vous pouvez trouver, comme l’effectif des ressources humaines ou un chiffre d’inscriptions. Cherchez le segment que vous seriez le plus gêné d’avoir oublié et vérifiez qu’il est présent. Supprimez les doublons. Notez ce que la base exclut, car cette phrase a sa place dans vos limites de toute façon.
L’échantillonnage de commodité, par quotas, raisonné et en boule de neige ne nécessite aucune liste. L’échantillonnage par grappes et à plusieurs degrés ne nécessite qu’une liste de groupes (écoles, cliniques, services hospitaliers, villages), et non une liste de personnes. L’échantillonnage aléatoire simple, systématique et stratifié nécessite tous une liste complète des individus avant de commencer. Si vous n’avez pas de liste et ne pouvez pas en constituer une, ce seul fait exclut trois des neuf méthodes de cette page. C’est généralement la première chose à régler.
Les 9 méthodes d’échantillonnage comparées
Les méthodes d’échantillonnage se répartissent en deux familles. L’échantillonnage probabiliste utilise un mécanisme aléatoire, de sorte que chaque unité de la base a une probabilité de sélection connue et non nulle. L’échantillonnage non probabiliste ne le fait pas, si bien que les probabilités de sélection sont inconnues. Tout le reste découle de cette seule distinction.
La deuxième colonne est celle que la plupart des guides omettent ; elle vient donc en premier ici. Seul un plan probabiliste permet d’annoncer une marge d’erreur, un intervalle de confiance ou la phrase « à plus ou moins 5 points ». Si une méthode indique non à cet endroit, vous pouvez quand même en apprendre beaucoup. Vous ne pouvez simplement pas publier un chiffre de précision à côté du résultat. La précision elle-même relève d’une autre discussion, traitée dans notre guide sur la taille de l’échantillon.
| Méthode | Permet une marge d’erreur ? | Fonctionnement | Le bon choix quand | Ce qu’elle coûte, et le biais qu’elle favorise |
|---|---|---|---|---|
| Échantillonnage aléatoire simple Probabiliste Liste complète requise |
Oui | Chaque unité de la liste a la même probabilité. Vous tirez au hasard le nombre requis. | Vous disposez d’une liste propre et sans doublons, et d’aucun sous-groupe à présenter séparément. | CoûtVous devez disposer de la liste complète, et les petits groupes peuvent être trop réduits pour être présentés.BiaisTrès faible à la sélection. Tout le risque restant se reporte sur qui répond réellement. |
| Échantillonnage systématique Probabiliste Liste complète requise |
Oui, si l’ordre de la liste est sans rapport avec le résultat | Triez la liste, choisissez un point de départ aléatoire, puis prenez chaque k-ième enregistrement. | La liste est longue ou arrive en flux, et une équipe de terrain a besoin d’une règle simple à suivre. | CoûtPresque rien, tant que l’ordre n’a aucun rapport avec ce que vous mesurez.BiaisLa périodicité. Si la liste se répète selon un cycle qui coïncide avec votre intervalle, vous tombez sans cesse sur le même type d’unité. |
| Échantillonnage stratifié Probabiliste Liste complète requise |
Oui, et généralement plus précise qu’avec l’aléatoire simple | Divisez la liste en groupes pertinents (strates), puis échantillonnez à l’intérieur de chaque groupe. | Vous devez présenter les résultats par région, faculté, service ou tranche d’âge, ou vous vous attendez à des taux de réponse très différents selon les groupes. | CoûtLa variable de regroupement doit figurer sur la liste avant le tirage, et les taux inégaux doivent être pondérés à l’analyse.BiaisFaible. Le vrai risque est de choisir des strates sans rapport avec le résultat, ce qui ajoute du travail sans apporter de précision. |
| Échantillonnage par grappes Probabiliste Liste de groupes requise |
Oui, élargie en fonction de l’effet de plan | Sélectionnez au hasard des groupes entiers (écoles, cliniques, services hospitaliers, villages), puis interrogez toutes les personnes des groupes sélectionnés. | Vous ne pouvez pas lister les individus mais vous pouvez lister les lieux où ils se trouvent, et les frais de déplacement ou de mise en place pèsent le plus dans le budget. | CoûtLa précision. Les personnes d’un même groupe se ressemblent, si bien que chaque participation supplémentaire apporte moins d’information nouvelle.BiaisFaible si les groupes sont choisis au hasard, mais un petit nombre de groupes rend le résultat instable et difficile à défendre. |
| Échantillonnage à plusieurs degrés Probabiliste Liste de groupes requise |
Oui, avec des pondérations et un effet de plan | Échantillonnez d’abord des groupes, puis des unités à l’intérieur des groupes sélectionnés, en deux degrés ou plus. | Études à l’échelle d’un district ou d’un pays, lorsqu’il n’existe aucune liste unique de personnes mais qu’il existe des unités administratives. | CoûtLa complexité. Les probabilités de sélection diffèrent d’une unité à l’autre ; l’analyse nécessite donc des pondérations, et quelqu’un capable de les appliquer.BiaisFaible en principe. En pratique, chaque degré est une nouvelle occasion pour l’équipe de terrain de s’écarter du plan. |
| Échantillonnage de commodité Non probabiliste Aucune liste requise |
Non | Vous prenez les personnes les plus faciles à atteindre : une fenêtre contextuelle sur un site web, une classe où vous enseignez, des passants devant un stand. On parle aussi d’échantillonnage accidentel. | Vous êtes en phase exploratoire, vous testez un questionnaire dans une enquête pilote, ou il vous faut une orientation cette semaine plutôt qu’un chiffre défendable au prochain trimestre. | CoûtL’affirmation. Vous renoncez à pouvoir dire quoi que ce soit sur la population.BiaisL’autosélection. Il surreprésente les personnes joignables, disponibles et déjà impliquées. |
| Échantillonnage par quotas Non probabiliste Aucune liste requise |
Non. Il paraît équilibré sans être aléatoire | Fixez des objectifs par groupe, par exemple 50 femmes et 50 hommes, ou 40 ruraux et 60 urbains, puis recrutez jusqu’à ce que chaque objectif soit atteint. | Il vous faut rapidement un échantillon qui corresponde au moins à la population sur des caractéristiques visibles, sans liste dans laquelle tirer. | CoûtLa maîtrise de qui remplit chaque quota. Les recruteurs choisissent toujours, et ils choisissent les personnes abordables.BiaisUn biais de sélection au sein des quotas. Respecter la répartition par âge et par genre ne rend pas les personnes représentatives dans leurs opinions. |
| Échantillonnage raisonné Non probabiliste Aucune liste requise |
Non, et ce n’est pas son but | Vous sélectionnez délibérément des cas qui répondent à des critères énoncés : experts, cas extrêmes, cas typiques, cas critiques. On parle aussi d’échantillonnage par choix raisonné. | Travaux qualitatifs, entretiens d’experts, études de cas, et toute question où la profondeur compte plus que le dénombrement. | CoûtRien, à condition d’indiquer clairement que vous n’avez jamais cherché à dénombrer.BiaisLa propre idée du chercheur sur qui est pertinent. |
| Échantillonnage en boule de neige Non probabiliste Aucune liste requise |
Non | Recrutez quelques participants, puis demandez à chacun d’en recommander d’autres qui répondent aux critères. | Le groupe est caché, stigmatisé, rare ou non enregistré : travailleurs migrants, personnes ayant quitté un service, commerçants informels, personnes atteintes d’une maladie rare. | CoûtDu temps, et la maîtrise de la composition de l’échantillon. Vous héritez du réseau social des personnes de départ.BiaisL’homophilie. Les gens recommandent des gens qui leur ressemblent, si bien qu’un coin de la population est suréchantillonné. |
Lecture du tableau : les cinq premières méthodes sont des plans probabilistes et les quatre dernières ne le sont pas. C’est cette seule division, et non le nom de chaque méthode, qui décide si un chiffre de précision est honnête.
Les méthodes d’échantillonnage probabiliste, une par une
L’échantillonnage probabiliste signifie que chaque unité de la base a une probabilité connue et non nulle d’être sélectionnée, et qu’un mécanisme aléatoire effectue la sélection. C’est tout le fondement de toute affirmation chiffrée sur la population. Cinq plans couvrent presque toutes les études réelles. Les revues de recherche clinique et en santé couvrent la même famille sous des noms légèrement différents, et il vaut mieux savoir pourquoi avant de rencontrer les deux : chacune des deux revues citées ici range l’échantillonnage à plusieurs degrés dans l’échantillonnage par grappes au lieu de le présenter séparément.34
Échantillonnage aléatoire simple
L’échantillonnage aléatoire simple donne à chaque unité de la liste exactement la même probabilité de sélection. Vous numérotez la liste, générez des nombres aléatoires et prenez les unités sur lesquelles ils tombent.
Exemple détaillé. Le registre d’une université compte 12 000 étudiants inscrits et il vous faut 400 participations. Numérotez le registre de 1 à 12 000, générez 400 nombres aléatoires distincts dans cet intervalle avec un tableur ou un logiciel de statistique, et invitez ces étudiants. Si vous prévoyez un taux de réponse de 40 %, tirez et invitez 1 000 personnes pour que 400 participations complètes soient réalistes.
Où elle échoue. Avec 400 participations réparties sur un registre de 12 000 étudiants, un département de 300 étudiants fournit environ 10 personnes. C’est insuffisant pour présenter un résultat. Si un sous-groupe doit figurer dans vos résultats, l’échantillonnage aléatoire simple n’est pas le bon outil et l’échantillonnage stratifié est la solution.
Consignez votre randomisation. Le logiciel utilisé, la graine s’il y en avait une, et la date. Cette seule phrase rend le tirage reproductible, et les relecteurs la demandent.
Échantillonnage systématique
L’échantillonnage systématique prend chaque k-ième unité d’une liste ordonnée après un départ aléatoire. Divisez la taille de la liste par le nombre requis pour obtenir l’intervalle k, choisissez un nombre aléatoire entre 1 et k comme point de départ, puis comptez à partir de là.
Exemple détaillé. Un hôpital de district enregistre 9 000 consultations externes par trimestre et souhaite 600 entretiens de sortie. L’intervalle est 9 000 divisé par 600, donc k est égal à 15. Choisissez un départ aléatoire entre 1 et 15, par exemple 7, puis interrogez les consultations 7, 22, 37, 52 et ainsi de suite. Une équipe de terrain peut suivre cette règle sans ordinateur portable, et c’est la vraie raison pour laquelle cette méthode perdure.
Où elle échoue. La périodicité. Si la liste suit un cycle répétitif qui coïncide avec k, vous échantillonnez toujours le même créneau. Une liste de consultations triée par jour de clinique, avec un cycle de 7 jours et un intervalle de 7, ne vous donnerait qu’un seul jour de la semaine. Vérifiez l’ordre avant de fixer k, et mélangez la liste si l’ordre est lié à ce que vous mesurez.
Échantillonnage stratifié
L’échantillonnage stratifié divise la population en groupes sans chevauchement, appelés strates, puis tire un échantillon aléatoire à l’intérieur de chaque strate. C’est l’amélioration la plus utile à la portée de la plupart des études, car elle garantit que chaque groupe sur lequel vous devez présenter des résultats apparaît bien.
Exemple détaillé, calculs à l’appui. Une organisation compte 4 200 salariés répartis dans six provinces et a besoin de 600 participations.
- Allocation proportionnelle. Une province de 1 400 salariés représente 1 400 divisé par 4 200, soit un tiers de l’effectif ; elle reçoit donc un tiers de 600, soit 200 participations. Une province de 210 salariés reçoit 210 divisé par 4 200, multiplié par 600, soit 30 participations. Chaque province est représentée en proportion de sa taille, et aucune pondération n’est nécessaire à l’analyse.
- Allocation non proportionnelle, aussi appelée suréchantillonnage. Trente participations, c’est trop peu pour présenter séparément les résultats de cette petite province. Vous en prenez donc délibérément 80, et vous réduisez la plus grande province pour compenser. Les probabilités de sélection diffèrent alors d’une province à l’autre ; vous devez donc pondérer les données pour revenir aux proportions réelles avant de citer tout chiffre à l’échelle de l’organisation. Sauter cette étape est l’erreur d’échantillonnage stratifié la plus courante.
Choisir les strates. Choisissez des variables liées au résultat ou à la probabilité de répondre, et qui figurent déjà dans votre base. La région, le site, la fonction, la tranche d’ancienneté, la formation suivie, le type d’offre et la tranche d’âge sont les candidats habituels. Des strates sans rapport avec le résultat ajoutent de la gestion et n’apportent aucune précision. Si la variable de regroupement manque dans votre base, vous devrez peut-être la recueillir dans le questionnaire. Notre guide des questions démographiques explique comment demander ces variables sans perdre de participants.
Échantillonnage par grappes
L’échantillonnage par grappes sélectionne au hasard des groupes naturels entiers, puis interroge toutes les personnes des groupes sélectionnés. Il vous faut une liste des groupes, pas une liste des personnes : c’est sa raison d’être.
Exemple détaillé. Un district compte 180 écoles primaires et aucune liste centrale des élèves. Vous sélectionnez au hasard 24 écoles et interrogez chaque élève du niveau 8 dans chacune d’elles. Vous avez effectué 24 visites d’écoles au lieu de 180, et vous n’avez jamais eu besoin d’un registre des élèves pour commencer.
Ce que cela vous coûte. Les élèves d’une même école se ressemblent davantage qu’ils ne ressemblent aux élèves de tout le district. Chaque élève supplémentaire dans une école déjà choisie apporte donc moins d’information nouvelle qu’un élève indépendant. Votre nombre effectif de participations est inférieur à votre nombre réel de participations. Cette inflation est l’effet de plan, et elle doit être intégrée au plan plutôt que découverte à l’analyse.
Où elle échoue. Trop peu de grappes. Six écoles choisies au hasard peuvent être très différentes les unes des autres, et le résultat varie selon les six que vous avez tirées. Davantage de grappes comptant moins de personnes chacune vaut presque toujours mieux que l’inverse.
Échantillonnage à plusieurs degrés
L’échantillonnage à plusieurs degrés sélectionne en deux degrés ou plus : d’abord des groupes, puis des unités à l’intérieur des groupes sélectionnés, et parfois un troisième degré à l’intérieur de celles-ci. Presque toutes les enquêtes nationales auprès des ménages dans le monde sont construites ainsi.
Exemple détaillé. Sélectionnez 120 circonscriptions dans la liste nationale des circonscriptions. Dans chaque circonscription sélectionnée, une équipe de terrain recense les ménages sur place, puis en sélectionne 20 au hasard. Dans chaque ménage sélectionné, un adulte est choisi au hasard au lieu de laisser répondre la personne qui ouvre la porte. Cela fait trois degrés, et le dernier compte : laisser le ménage décider qui répond réintroduit exactement le biais de sélection que le plan devait éviter.
Ce que cela vous coûte. Les personnes n’ont pas toutes la même probabilité de sélection ; l’analyse nécessite donc des pondérations, et le calcul de la variance doit tenir compte de l’effet de grappe à chaque degré. C’est un vrai plan qui demande quelqu’un capable de mener une analyse pondérée. Si personne dans le projet n’en est capable, choisissez un plan plus simple plutôt qu’un plan à plusieurs degrés non pondéré.
Pour aller plus loin : la probabilité proportionnelle à la taille, et pourquoi les grandes grappes sont tirées plus souvent
Dans l’exemple des écoles, chaque école avait la même probabilité de sélection, qu’elle compte 60 élèves ou 900. Un élève d’une petite école a alors beaucoup plus de chances d’entrer dans l’échantillon qu’un élève d’une grande école. L’analyse doit ensuite corriger cet écart.
La sélection avec probabilité proportionnelle à la taille règle ce problème dès la conception. La probabilité de sélection de chaque grappe est fixée en proportion du nombre d’unités qu’elle contient. Une école de 900 élèves a alors quinze fois plus de chances d’être tirée qu’une école de 60 élèves. Vous prenez ensuite le même nombre d’élèves dans chaque école sélectionnée. Les deux degrés se compensent, et chaque élève du district finit avec à peu près la même probabilité globale de sélection. C’est l’approche standard des enquêtes nationales, et elle exige une mesure de taille pour chaque grappe de la base avant le tirage.
Échantillonnage stratifié ou par grappes : la différence en une ligne
Ces deux méthodes sont sans cesse confondues, car toutes deux commencent par diviser la population en groupes. La différence tient à ce que vous faites ensuite.
| Aspect | Échantillonnage stratifié | Échantillonnage par grappes |
|---|---|---|
| Quels groupes vous utilisez | Chaque groupe est échantillonné. | Certains groupes sont sélectionnés, les autres ne sont pas du tout utilisés. |
| Qui vous échantillonnez dans un groupe | Un sous-ensemble aléatoire du groupe. | Tout le groupe, ou un nouveau sous-ensemble aléatoire dans une version à plusieurs degrés. |
| Les groupes doivent être | Homogènes à l’intérieur, et différents les uns des autres. Région, fonction, formation. | Variés à l’intérieur, chacun étant une petite copie de la population. Écoles, cliniques, circonscriptions. |
| Pourquoi la choisir | La précision, et une représentation garantie des sous-groupes. | Le coût et l’accessibilité lorsqu’il n’existe aucune liste d’individus. |
| Effet sur la précision | L’améliore généralement par rapport à l’aléatoire simple, à nombre de participations égal. | La réduit. Prévoyez l’effet de plan dans votre budget. |
| Ce qu’il vous faut avant de commencer | Une liste complète des individus, sur laquelle figure déjà la variable de regroupement. | Une simple liste de groupes. |
Stratifié : tous les groupes, une partie des personnes. Par grappes : une partie des groupes, toutes les personnes. Le stratifié vise l’exactitude, les grappes visent l’accès.
Les méthodes d’échantillonnage non probabiliste, une par une
L’échantillonnage non probabiliste signifie que les probabilités de sélection sont inconnues, parce qu’aucun mécanisme aléatoire n’a décidé qui était choisi. C’est le bon choix dans quatre situations. Vous ne pouvez pas constituer de base exploitable. Le groupe est caché. La rapidité compte plus que la précision. Ou la question porte sur le sens plutôt que sur l’ampleur.
Ces méthodes ne sont pas de second ordre. Elles répondent à une autre question. L’erreur n’est jamais de les utiliser, c’est de les utiliser puis d’écrire une phrase que seul un échantillon probabiliste pourrait étayer.
Échantillonnage de commodité
L’échantillonnage de commodité, aussi appelé échantillonnage accidentel, recrute les personnes les plus faciles à atteindre. Une fenêtre contextuelle sur un site web, un lien dans une newsletter, les étudiants de votre propre classe, les passants devant un stand au marché.
Exemple. Un magasin place un lien d’avis sur le ticket de caisse. Toutes les personnes qui répondent ont acheté quelque chose, avaient un téléphone sur elles, avaient le temps et une raison de s’en donner la peine. Chacun de ces filtres retire une partie différente de la clientèle.
Usage honnête. Tester un questionnaire dans une enquête pilote, formuler des hypothèses, découvrir les mots qu’emploient les clients, vérifier qu’une question est comprise. Autant d’excellents usages. Aucun ne nécessite d’estimation de la population.
Échantillonnage par quotas
L’échantillonnage par quotas fixe des objectifs de recrutement pour des groupes nommés et les remplit. Quarante ruraux et soixante urbains. Cinquante femmes et cinquante hommes. Vingt dans chacune de cinq tranches d’âge.
Exemple. Une équipe d’études de marché a besoin de 500 participations correspondant à la répartition nationale par âge, genre et région, et ne dispose d’aucune liste de la population. Elle recrute jusqu’à ce que chaque case soit pleine.
Pourquoi ce n’est toujours pas un échantillonnage probabiliste. Les quotas contrôlent la forme de l’échantillon, pas la sélection des personnes qui le composent. Le recruteur choisit toujours, et les personnes faciles à aborder diffèrent systématiquement de celles qui ne le sont pas. Un échantillon peut correspondre parfaitement à la population en âge et en genre et se tromper lourdement sur les opinions, car l’âge et le genre n’ont jamais été les variables à l’origine du problème.
Échantillonnage raisonné
L’échantillonnage raisonné, aussi appelé échantillonnage par choix raisonné, sélectionne délibérément des cas qui répondent à des critères énoncés. Les variantes courantes sont la sélection de cas typiques, de cas extrêmes, de cas critiques, à variation maximale et d’experts.
Exemple. Une étude sur l’usage d’un nouveau système de paiement sélectionne huit personnes. Deux qui l’utilisent tous les jours, deux qui l’ont abandonné, deux qui ne l’ont jamais adopté, et deux membres du support qui traitent les réclamations. Cette répartition est choisie à dessein, et le raisonnement constitue la méthode.
Usage honnête. La plupart des recherches qualitatives. Le critère n’est pas ici le hasard. Il s’agit de savoir si vous pouvez dire pourquoi ces cas et pas d’autres, et si l’éventail des points de vue est assez large pour étayer vos affirmations.
Échantillonnage en boule de neige
L’échantillonnage en boule de neige recrute un petit nombre de participants qui en recommandent ensuite d’autres répondant aux critères, lesquels en recommandent d’autres à leur tour.
Exemple. Une étude sur les commerçants transfrontaliers informels commence par quatre participants identifiés par une association locale, et chacun en présente deux autres. Il n’existe aucun registre des commerçants informels ; aucune méthode fondée sur une base de sondage n’est donc possible.
Ce qu’elle fait à votre échantillon. L’homophilie. Les gens recommandent des gens qui leur ressemblent. L’échantillon dérive vers un seul réseau social et s’éloigne des membres isolés de la population, qui sont souvent ceux que la recherche a le plus besoin d’entendre. Partir de plusieurs points de départ sans lien entre eux plutôt que d’un seul réduit cette dérive sans la supprimer.
Comment rendre défendable un échantillon non probabiliste
La plupart des guides s’arrêtent à « vous ne pouvez pas généraliser » et laissent le lecteur en plan, alors que la plupart des lecteurs mènent justement ce type d’étude. Voici la partie qui manque généralement.
- Décrivez le recrutement, pas seulement le nom de la méthode. Où le lien a été publié, à quelles dates, qui l’a vu, si une incitation a été proposée, et combien de personnes ont été sollicitées par rapport au nombre de répondants. C’est ce qui permet au lecteur de juger l’échantillon au lieu de deviner.
- Comparez l’échantillon obtenu à une référence connue et publiez la comparaison. Si votre organisation compte 60 % de personnel de terrain et vos participants 25 %, indiquez-le dans un tableau. Un déséquilibre déclaré est un résultat. Un déséquilibre caché est un défaut.
- Sachez ce que la pondération peut faire ou non. Ajuster vos données pour que la démographie corresponde à la population peut corriger un déséquilibre visible. Cela ne corrige pas les différences entre les participants et les autres sur un aspect que vous n’avez pas mesuré, et cela ne transforme jamais un échantillon non probabiliste en échantillon permettant d’annoncer une précision.
- Changez la phrase, pas les statistiques. Au lieu de « 38 % des clients sont insatisfaits, à plus ou moins 4 points », écrivez « 38 % des 620 clients qui ont répondu se sont déclarés insatisfaits. Les participants ont été recrutés par une invite dans l’application pendant deux semaines et ne constituent pas un échantillon aléatoire de la clientèle. » La seconde formulation est plus courte, plus utile et inattaquable.
Le travail qualitatif a son propre vocabulaire en la matière. Un protocole demande généralement une justification plutôt qu’un objectif chiffré. Il doit couvrir le nombre prévu et l’éventail des points de vue, une distinction que le guide de l’University of Bath énonce de façon concise.5
Associer la méthode à la situation
Six situations, six méthodes. Décidez avant d’ouvrir la réponse. C’est le moyen le plus rapide de savoir si le tableau ci-dessus a vraiment porté ses fruits.
1. Vous disposez d’un registre complet du personnel de 4 200 personnes et devez publier des résultats pour chacune de six provinces.
Échantillonnage stratifié. La liste complète existe, l’échantillonnage probabiliste vous est donc ouvert, et l’obligation de présenter les résultats par province correspond exactement à ce pour quoi la stratification existe. Un échantillonnage aléatoire simple laisserait la plus petite province avec trop peu de participations pour présenter un résultat.
2. Vous étudiez des personnes qui ont quitté un service il y a six mois. Il n’existe aucune liste, et les plus mécontents sont les plus difficiles à trouver.
Échantillonnage en boule de neige. Il n’existe aucune base et la population est difficile à atteindre, ce qui exclut toutes les méthodes probabilistes. Partez de plusieurs points de départ sans lien entre eux plutôt que d’un seul, et indiquez dans vos limites que les chaînes de recommandation biaisent l’échantillon en faveur des personnes bien connectées.
3. Un hôpital veut des données sur l’expérience des patients à partir d’un flux de 9 000 consultations par trimestre, recueillies par un personnel qui n’a pas d’ordinateur à l’accueil.
Échantillonnage systématique. La population arrive sous forme de flux ordonné ; une règle d’intervalle est donc à la fois une méthode probabiliste et une consigne qu’un accueil débordé peut réellement appliquer. Vérifiez d’abord que l’ordre des consultations ne suit pas un cycle hebdomadaire qui coïncide avec votre intervalle.
4. Vous devez comprendre pourquoi un nouvel outil est abandonné, et vous avez trois semaines et aucun budget.
Échantillonnage raisonné. La question porte sur le mécanisme, pas sur l’ampleur. Sélectionnez délibérément sur tout l’éventail : grands utilisateurs, personnes qui ont abandonné, non-adoptants, personnel du support. N’en tirez pas de pourcentages.
5. Un district compte 180 écoles, aucun registre des élèves, et un budget de déplacement d’environ 25 visites sur place.
Échantillonnage par grappes. Une liste des écoles existe même s’il n’y a pas de liste des élèves, et le coût des déplacements est la contrainte déterminante. Élargissez l’intervalle que vous publiez en fonction de l’effet de plan, et préférez plus d’écoles avec moins d’élèves chacune plutôt que l’inverse.
6. Vous devez recueillir en cinq jours 500 participations correspondant au profil national par âge et par région, et il n’existe aucune liste de la population.
Échantillonnage par quotas. C’est le moyen le plus rapide d’obtenir un échantillon qui corresponde au moins à la population sur des caractéristiques visibles. Ce n’est toujours pas un échantillon probabiliste : présentez la composition et renoncez à annoncer une précision.
Comment choisir une méthode d’échantillonnage
La plupart des études n’échouent pas parce que quelqu’un a choisi la mauvaise technique. Elles échouent parce que la technique ne correspondait pas à la base, à la décision ou à ce que l’équipe de terrain pouvait réellement faire. Trois questions règlent la question presque à chaque fois.
Quelle méthode convient à votre étude ?
Répondez à trois questions. La recommandation apparaît ci-dessous et les lignes correspondantes sont mises en évidence dans le tableau comparatif.
Partez de l’affirmation que vous devez faire
Rédigez la phrase que vous voulez publier avant de choisir quoi que ce soit. « Soixante-deux pour cent de nos clients nous recommanderaient » et « les clients qui partent décrivent trois problèmes récurrents » sont deux phrases différentes qui exigent des plans différents. Si personne ne traitera le résultat comme un chiffre de population, vous avez bien plus de liberté que vous ne le pensez.
Auditez la base avant de vous engager
Pouvez-vous réellement lister la population, ou un équivalent proche ? Sinon, pouvez-vous lister les groupes auxquels elle appartient ? Répondre à cette seule question élimine immédiatement la plupart des neuf méthodes ; c’est pourquoi elle vient en deuxième position et non en dernier.
Nommez les sous-groupes que vous devez obligatoirement présenter
Si un résultat doit apparaître pour chaque région, site ou fonction, cela détermine le plan, par des strates ou des quotas. Cela détermine aussi le nombre de participations nécessaires dans chaque groupe. Décider de cela après le terrain est irrattrapable.
Confrontez le plan à la réalité du terrain
Le temps, le budget, la possibilité de joindre les personnes, l’accès linguistique, l’alphabétisation, la connectivité et la politique d’incitation décident de ce qui est réalisable. Un plan qu’une équipe de terrain ne peut pas suivre devient un échantillonnage de commodité affublé d’un nom savant, ce qui est pire que de choisir honnêtement l’échantillonnage de commodité. Une planification inclusive du recrutement réduit la sous-représentation systématique.6 Une fois l’échantillon sélectionné, utilisez un créateur d’enquêtes en ligne pour préparer le questionnaire et l’envoyer aux personnes retenues par votre plan d’échantillonnage. Partager un lien public sans restriction change qui peut répondre ; cela ne préserve pas un échantillon aléatoire.
Où les échantillons pèchent réellement : couverture, sélection et non-réponse
La sélection est l’étape qui inquiète tout le monde, et celle qui pose le moins souvent problème. Les dégâts surviennent généralement avant la sélection, dans la base, ou après, dans le fait que les gens prennent ou non la peine de répondre. Les deux produisent des tableurs d’apparence impeccable et des conclusions fausses.
| Erreur | À quoi elle ressemble | Comment la réduire |
|---|---|---|
| Erreur de couverture, un problème de base | Certaines personnes ne peuvent pas du tout être sélectionnées : pas d’e-mail professionnel, un fichier obsolète, des clients qui n’achètent qu’en magasin, des ménages sans connexion. | Améliorez ou combinez les bases. Ajoutez des modes de collecte : papier, en personne, téléphone, SMS. Documentez précisément qui est exclu. |
| Biais de sélection, un problème de procédure | La règle aléatoire est contournée en pratique. Premier arrivé, premier servi. Un responsable désigne qui participe. | Automatisez le tirage. Séparez la personne qui sélectionne de celle qui recrute. Contrôlez chaque exception. |
| Biais de non-réponse, un problème de résultat | Les personnes sélectionnées ne répondent pas, et celles qui ne répondent pas diffèrent de celles qui répondent sur ce que vous mesurez. | Améliorez la stratégie de contact et l’expérience du questionnaire, puis comparez les participants à une référence connue. Voir biais de réponse. |
| Erreur de mesure | Un échantillon irréprochable donne quand même des résultats absurdes parce que les questions sont orientées, vagues ou à double objet. | Testez l’instrument avant le terrain. Notre guide pour rédiger des questions d’enquête couvre les défauts courants. |
Le plus célèbre échec d’échantillonnage comptait 2,4 millions de participants
En 1936, le Literary Digest prédisait qu’Alf Landon obtiendrait environ 55 % des voix. Franklin Roosevelt en a obtenu environ 61 %.7 Le magazine avait envoyé 10 millions de bulletins par la poste et en avait reçu environ 2,4 millions en retour, un taux de réponse de 24 % dont aucun sondage national actuel n’approche.8 Le sondage plaçait Roosevelt vingt points en dessous de son score réel, sur un échantillon de deux millions et demi de personnes.
Le chiffre qui devrait figurer sur toute page consacrée à l’échantillonnage. Une réanalyse ultérieure a calculé la marge d’erreur d’échantillonnage des estimations du Digest par État : elle allait de 0,18 à 2,3 points de pourcentage, avec une médiane de 0,6.8 Un chiffre de précision de plus ou moins un demi-point, posé sur une erreur de vingt points. Rien ne montre plus clairement qu’une marge d’erreur ne mesure qu’une seule des nombreuses façons dont une enquête peut se tromper.
Et l’explication habituelle n’est qu’à moitié juste. On apprend à tout le monde que le Digest avait échantillonné des propriétaires de voitures et des abonnés au téléphone, riches et républicains. Un test empirique de cette affirmation a utilisé une enquête Gallup de mai 1937. Les personnes qui possédaient à la fois une voiture et un téléphone votaient tout de même pour Roosevelt, à 55 contre 45. Parmi toutes celles qui déclaraient avoir reçu un bulletin du Digest, Roosevelt menait 55 à 44. La base penchait du côté républicain, mais pas assez pour produire un raz-de-marée en faveur de Landon.7
La moitié manquante, c’est la non-réponse. Parmi les personnes qui déclaraient avoir renvoyé leur bulletin, Landon menait 51 à 48. Parmi celles qui ne l’avaient pas renvoyé, Roosevelt menait 69 à 30. La décomposition approximative attribue environ onze points de l’erreur à la base et environ sept à la non-réponse différentielle.7 Pondérer les retours sur une question que le Digest avait déjà posée, le vote de 1932, aurait désigné le bon vainqueur avec des calculs disponibles en 1936.8
Un taux de réponse élevé n’est pas l’objectif que vous croyez
Les taux de réponse des sondages téléphoniques du Pew Research Center sont passés de 36 % en 1997 à 9 % en 2012, puis à 6 % en 2018.9 Dans le même temps, l’enquête nationale indienne sur la santé des familles (National Family Health Survey), menée en face à face, a sélectionné 664 972 ménages, dont 653 144 étaient occupés. Elle en a interrogé 636 699, soit un taux de réponse de 97,5 %. Lisez attentivement ce dénominateur, car c’est là qu’un taux de réponse se trompe le plus souvent : rapporté au nombre de ménages sélectionnés plutôt qu’au nombre de ménages occupés, le même terrain donne 95,7 %. L’enquête a tiré son échantillon dans 30 456 grappes réparties dans les 707 districts.10
Ces deux faits appartiennent à la même décennie. Le mode de collecte et l’effort de terrain influencent les taux de réponse bien plus que n’importe quelle affirmation générale sur la lassitude face aux enquêtes. Si un guide vous dit que le taux de réponse moyen est un chiffre unique, il ne décrit pas une grandeur réelle.
Vient maintenant le constat le plus dérangeant. Une méta-analyse de 235 estimations du biais de non-réponse tirées de 30 études publiées a trouvé une corrélation de 0,33 entre le taux de réponse et l’ampleur du biais de non-réponse. Au carré, cela signifie que le taux de réponse explique environ 11 % de la variation du biais.11 Un suivi portant sur 59 études conçues spécifiquement pour mesurer le biais de non-réponse est parvenu à la même conclusion.12
Le taux de réponse mérite d’être publié et amélioré. Ce n’est pas un certificat. Ce qui crée le biais, c’est le lien entre la propension à répondre et ce que vous mesurez. Une enquête sur le bénévolat en souffre bien plus qu’une enquête sur le débit internet. Traquez la corrélation, pas le pourcentage.
Plus de participations ne réparent pas une base défaillante
Lors de la campagne de vaccination de 2021, deux très grandes enquêtes ont suivi le taux de vaccination aux États-Unis. L’une recueillait environ 250 000 participations par semaine et surestimait la couverture en première dose de 17 points de pourcentage par rapport à la référence officielle. L’autre en recueillait environ 75 000 toutes les deux semaines et la surestimait de 14 points. Une troisième enquête, auprès d’environ 1 000 participants et menée selon les pratiques probabilistes standard, a produit des estimations fiables.13
Le même schéma se retrouve dans les enquêtes ordinaires. En comparant trois panels probabilistes à trois sources en ligne à adhésion volontaire sur 28 références et 29 937 entretiens, l’erreur absolue moyenne était de 5,8 points de pourcentage pour les échantillons à adhésion volontaire et de 2,6 pour les panels probabilistes. Sur les 25 de ces références disponibles par sous-groupe, l’écart pour les adultes de 18 à 29 ans était de 11,2 contre 3,6.14
Et un diagnostic mémorable : dans une enquête à adhésion volontaire, 12 % des adultes de moins de 30 ans ont déclaré être habilités à piloter un sous-marin nucléaire.15 Le chiffre réel est proche de zéro. Si un panel peut produire cela, il peut produire n’importe quoi, et une commande plus importante auprès du même panel ne fait qu’en acheter davantage.
Qui votre base oublie, hors des États-Unis et du Royaume-Uni
La plupart des guides d’échantillonnage supposent implicitement une base occidentale : une liste d’e-mails, une ligne fixe, un registre national des adresses. Une grande partie du monde n’échantillonne pas ainsi, et les lacunes de couverture ont une forme mesurée.
- Une enquête en ligne dans un pays à revenu faible ou intermédiaire est un échantillon de sa partie connectée, et cette partie est majoritairement masculine. Dans les pays à revenu faible ou intermédiaire, les femmes ont 14 % de chances de moins que les hommes d’utiliser l’internet mobile, soit environ 235 millions de femmes de moins que d’hommes en ligne.16
- Les échantillons téléphoniques surreprésentent les chefs de ménage. Dans les enquêtes téléphoniques de la Banque mondiale menées dans quatre pays africains, les participants étaient à 52 % des hommes en Ouganda et à 73 % au Nigeria, alors que les hommes représentent environ la moitié de la population adulte. En Ouganda, 6 % des participants par téléphone avaient de 15 à 24 ans, contre 38 % de la population adulte.17
- Que faire. Combinez les modes de collecte plutôt que d’en défendre un seul. Recensez les ménages sur le terrain là où il n’existe aucun registre. Menez l’enquête dans les langues que votre population lit réellement, et prétestez la traduction plutôt que de la rétrotraduire. Indiquez ensuite l’écart résiduel dans vos limites, car il sera toujours là.
Ce que la pondération peut corriger, et ce qu’elle ne peut pas corriger
La pondération ajuste vos données pour que la composition de l’échantillon corresponde à des chiffres connus de la population. Elle est réellement puissante, et on en surestime couramment les vertus.
Les arguments pour. En 2016, le dernier sondage de l’University of New Hampshire donnait Clinton en tête de 11 points dans une élection qu’elle a remportée avec 0,4 point d’avance. Il n’avait pas été redressé selon le niveau d’études. Le comité d’examen a conclu que ce seul ajustement aurait supprimé l’essentiel de l’erreur.18 Une seule variable, corrélée à la fois à la réponse et au résultat, faisait tout le travail.
Les arguments contre le fait de s’y fier. Lorsque plus de 30 000 entretiens en ligne à adhésion volontaire ont été évalués par rapport à 24 références, le biais moyen estimé était de 8,4 points de pourcentage sans pondération. Aucune des procédures de pondération testées, y compris des approches d’appariement sophistiquées, n’a ramené le biais moyen sous 6 points.19 Quadrupler la taille de l’échantillon n’a fait gagner que 0,2 point de plus.
La règle qui en découle est simple. La pondération corrige le déséquilibre sur les variables utilisées pour pondérer, dans la mesure où ces variables sont liées au résultat. Elle ne fait rien contre les différences entre participants et non-participants sur ce que vous n’avez jamais mesuré, et elle ne transforme jamais un échantillon non probabiliste en échantillon permettant d’annoncer une précision.
Un chiffre de précision est un plancher, pas un plafond
Une marge d’erreur quantifie la variabilité d’échantillonnage, et seulement elle. Elle suppose que l’échantillon a été tiré au hasard dans la population cible et que le biais restant a été éliminé. L’erreur de couverture, le biais de non-réponse, l’erreur de mesure et les participants frauduleux sont tous hors de son champ.
Les données sont sans appel. Au cours des deux dernières semaines de 2020, 348 sondages présidentiels par État ont publié une marge d’erreur, et le chiffre moyen publié était de 3,9 points. Rapportés à cette moyenne, 55 % d’entre eux ont manqué l’écart final de plus d’une marge d’erreur, et 21 % de plus du double.20 C’étaient des sondages modernes, aux méthodes modernes. Considérez la marge d’erreur comme un plancher de votre incertitude, jamais comme un plafond.
| Affirmation | Le chiffre | Niveau de preuve | Source |
|---|---|---|---|
| Le taux de réponse prédit à peine le biais de non-réponse | r = 0,33, soit environ 11 % de la variation, sur 235 estimations issues de 30 études | A | Groves, 200611 |
| Une très grande enquête peut se tromper lourdement | A surestimé la vaccination de 17 points sur environ 250 000 participations par semaine | A | Bradley et al., 202113 |
| Les échantillons à adhésion volontaire sont environ deux fois moins exacts que les panels probabilistes | 5,8 contre 2,6 points de pourcentage d’erreur moyenne sur 28 références | A | Mercer et Lau, 202314 |
| La pondération améliore un échantillon à adhésion volontaire sans le sauver | 8,4 points sans pondération, aucune méthode sous 6,0 points | A | Mercer, Lau et Kennedy, 201819 |
| Une marge d’erreur sous-estime l’erreur réelle des sondages | 55 % des 348 sondages par État de 2020 se sont trompés de plus que la marge d’erreur moyenne publiée de 3,9 points | A | Groupe de travail de l’AAPOR, 202120 |
| L’explication du Literary Digest par la base est incomplète | Les propriétaires de voitures et de téléphones préféraient tout de même Roosevelt, à 55 contre 45 | B | Squire, 19887 |
Le niveau A désigne une statistique officielle, une méta-analyse ou un résultat répliqué. Le niveau B désigne une seule étude solide dont la conclusion n’a pas encore été reproduite de façon indépendante.
« Un taux de réponse de 50 % est suffisant, 60 est bon, 70 est très bon. » Une règle empirique de manuel sans aucune donnée à l’appui. Différentes autorités du même domaine avancent 50, 60 et 80. Le biais dépend de la corrélation entre le fait de répondre et la réponse, pas du taux.
« Trente suffit, car c’est là que le théorème central limite entre en jeu. » Aucune démonstration ne donne 30. Pour des résultats symétriques, l’approximation fonctionne bien en dessous, et pour des résultats asymétriques ou des événements rares, elle échoue bien au-dessus.
« Le taux de réponse moyen d’une enquête est de 33 %. » Ce chiffre circule sur les blogs d’éditeurs dans des formulations presque identiques, sans aucune source primaire. Le mode de collecte, le commanditaire, la population et l’incitation écrasent toute moyenne globale.
« La capacité d’attention n’est plus que de huit secondes, moins que celle d’un poisson rouge. » Remonte à un rapport marketing de 2015 qui citait une entreprise incapable de fournir une source. Les recherches d’origine ne mentionnent jamais huit secondes ni poisson rouge.
Effet de plan : pourquoi les échantillons en grappes nécessitent plus de personnes
Presque tous les guides recommandent l’échantillonnage par grappes pour l’économie qu’il permet, et s’arrêtent là. L’économie est réelle, la facture aussi. Les personnes d’une même école, clinique, circonscription ou d’un même magasin se ressemblent. Elles se ressemblent davantage qu’elles ne ressemblent à des personnes tirées au hasard dans toute la population. Chaque participation supplémentaire issue d’un groupe déjà choisi apporte donc moins d’information nouvelle.
L’effet de plan est le chiffre qui mesure ce phénomène. Autrement dit : de combien votre incertitude s’élargit par rapport au tirage indépendant du même nombre de personnes. Pour un plan à groupes de taille égale, il vaut
effet de plan = 1 + (taille moyenne des groupes - 1) x corrélation intraclasse
La corrélation intraclasse mesure à quel point les personnes d’un même groupe se ressemblent sur ce que vous mesurez. Zéro signifie qu’être dans la même école ne dit rien de la réponse d’un élève. Un signifie que tous les élèves d’une école répondent de façon identique, et que l’école équivaut à une seule personne. Les valeurs réelles sont faibles, mais de faibles valeurs font beaucoup de dégâts dès que les groupes deviennent grands. Sur l’ensemble de 48 enquêtes nationales auprès des ménages, la corrélation intraclasse moyenne est d’environ 0,06. Elle varie selon ce que vous mesurez. Les items sur la fécondité se situent entre 0,01 et 0,03 environ, l’usage actuel de la contraception entre 0,03 et 0,05, et les accouchements assistés par du personnel médical atteignent 0,22 dans les chiffres nationaux.21
Si vous n’avez pas votre propre estimation, empruntez une valeur par défaut avec prudence. Le manuel d’échantillonnage des enquêtes DHS se replie sur 1,5 pour le deft lorsqu’une enquête n’a pas de chiffre propre.22 Le deft n’est pas la même grandeur que l’effet de plan de la formule ci-dessus : c’est le rapport des deux erreurs types, alors que l’effet de plan est le rapport des deux variances. Il faut l’élever au carré : un deft de 1,5 correspond à un effet de plan de 2,25. Le manuel présente cette valeur comme une solution de repli plutôt que comme une valeur typique, et ses propres exemples utilisent 1,40 pour l’usage de la contraception moderne et 1,22 pour la vaccination des enfants.
| Plan | Effet de plan | Participations effectives | Ce que cela signifie en pratique |
|---|---|---|---|
| Sélection indépendante, sans effet de grappe | 1.00 | 960 | Chaque participation compte pleinement. |
| 24 groupes de 40, CIC 0,02 | 1.78 | 539 | Vous en avez payé 960 et vous pouvez défendre la précision de 539. |
| 24 groupes de 40, CIC 0,05 | 2.95 | 325 | Les deux tiers du terrain ne vous ont rien rapporté de plus en précision. |
| 24 groupes de 40, CIC 0,10 | 4.90 | 196 | Le plan est discrètement devenu une petite étude dotée du budget d’une grande. |
La pondération ajoute sa propre composante. Une enquête nationale qui suréchantillonne une région puis la repondère porte deux effets de plan à la fois. Un effet de pondération de 1,22 et un effet de grappe de 1,80 donnent un effet de plan global de 2,20. Ainsi, 5 000 ménages interrogés se comportent comme 2 277 ménages indépendants.23
La leçon pour le plan. Davantage de groupes comptant moins de personnes chacun l’emporte sur moins de groupes comptant plus de personnes, presque à chaque fois. Quarante écoles de 24 élèves et 24 écoles de 40 élèves coûtent à peu près les mêmes 960 participations, mais la première option a un effet de plan plus faible et un résultat défendable. Si vous prévoyez le nombre total de participations nécessaires, calculez-le avec notre guide sur la taille de l’échantillon, puis multipliez par l’effet de plan. C’est en procédant dans l’autre sens que les études en grappes finissent par manquer de puissance.
Trois exemples détaillés, du début à la fin
Les noms de méthodes sont faciles. Ce sont les décisions qui les entourent qui font réellement échouer les études. Ces trois exemples suivent un plan réel, de la définition de la population jusqu’à la phrase que vous pouvez publier.
Exemple 1 : l’expérience des patients dans un district
- Population. Les adultes ayant eu une consultation externe dans l’une des 46 cliniques publiques du district entre le 1er avril et le 30 juin.
- Base. Il n’existe aucun registre des patients à l’échelle du district. Il existe une liste des 46 cliniques, avec leur fréquentation mensuelle.
- Méthode. À plusieurs degrés. Sélectionner 18 cliniques avec une probabilité proportionnelle à la fréquentation, puis échantillonner de façon systématique chaque 8e patient sortant au cours de deux jours de consultation tirés au hasard.
- Pourquoi pas plus simple. Une liste complète des patients permettrait un échantillonnage stratifié, mais elle n’existe pas et ne peut pas être constituée dans les délais. Un échantillon de commodité dans les trois plus grandes cliniques serait plus rapide et décrirait les trois plus grandes cliniques.
- Ce qu’il faut indiquer. Les probabilités de sélection varient selon la taille des cliniques ; l’analyse nécessite donc des pondérations, et l’intervalle doit être élargi en fonction de l’effet de plan.
- La phrase publiable. « Parmi les adultes ayant consulté dans les cliniques publiques du district au deuxième trimestre, on estime que 71 % ont jugé leur attente acceptable, d’après 1 240 entretiens de sortie dans 18 cliniques sélectionnées avec une probabilité proportionnelle à la fréquentation. »
Exemple 2 : un mémoire portant sur une population d’étudiants
- Population. Les étudiants inscrits à la faculté de commerce pendant l’année universitaire en cours : 3 100 répartis sur trois années d’études.
- Base. Le registre des inscriptions de la faculté, qui indique l’année d’études et le cursus.
- Méthode. Échantillonnage aléatoire stratifié par année d’études, allocation proportionnelle, objectif de 350 participations complètes.
- Le calcul. La première année compte 1 300 étudiants, soit 42 % de 3 100 ; elle reçoit donc 42 % de 350, soit 147 participations. Recommencez pour chaque année. L’allocation étant proportionnelle, aucune pondération n’est nécessaire.
- Prévoir les réponses. Avec un taux de réponse attendu de 35 %, vous devez inviter environ 1 000 étudiants pour obtenir 350 participations complètes, et les inviter strate par strate afin qu’une réponse faible dans une année soit visible tant qu’il est encore temps d’agir.
- Limites à indiquer. Les étudiants qui ont abandonné mais figurent encore dans le registre relèvent de la surcouverture. Les étudiants inscrits après l’extraction du registre relèvent de la sous-couverture. Les deux ont leur place dans le paragraphe sur les limites.
Exemple 3 : les avis clients d’une boutique en ligne
- Population. Les clients ayant finalisé une commande au cours des 90 derniers jours.
- Base. La table des commandes. Elle est complète pour les commandes en ligne et pour les commandes sans compte, mais un client possédant deux comptes y apparaît deux fois.
- Méthode. Dédoublonner pour obtenir une ligne par client, puis échantillonner de façon systématique chaque 12e client après un départ aléatoire, en continu plutôt qu’en un seul lot.
- Le piège ainsi évité. N’inviter que les abonnés à la newsletter est plus rapide, mais c’est un échantillon de commodité de vos clients les plus engagés. La satisfaction paraîtra meilleure qu’elle ne l’est, à coup sûr, chaque trimestre.
- Une remarque sur les salariés. La même organisation interrogeant ses 180 salariés ne devrait pas du tout échantillonner. Cette population est petite, joignable, et chacun a le droit d’être interrogé. Réalisez un recensement et, si la participation est faible, traitez-la comme un résultat plutôt que comme un problème d’échantillonnage.
Comment rédiger la partie échantillonnage de votre méthodologie
C’est l’étape que la plupart des guides sautent, et c’est celle que lit réellement un directeur de recherche, un relecteur ou un client. La description de l’échantillonnage doit répondre à cinq questions, dans l’ordre : qui, à partir de quelle liste, choisi comment, combien, et ce que vous êtes donc autorisé à affirmer.
Complétez les blancs ci-dessous. Le texte est volontairement sobre : les examinateurs ne cherchent pas ici une prose élégante, ils cherchent un plan qu’ils peuvent évaluer.
La même étude, mal rédigée et bien rédigée
Faible. « Un échantillon aléatoire d’étudiants a été constitué et 350 participations ont été recueillies. »
Rien ici ne peut être vérifié. « Aléatoire » joue un rôle qu’il n’a pas mérité ; il n’y a ni base, ni dénominateur, ni mention de qui a été exclu.
Solide. « La population cible était constituée des 3 100 étudiants inscrits à la faculté de commerce en 2026. La base de sondage était le registre des inscriptions de la faculté, extrait le 3 mars 2026. Un échantillonnage aléatoire stratifié par année d’études, avec allocation proportionnelle, a été utilisé afin que chaque année puisse faire l’objet de résultats distincts. Mille étudiants ont été invités et 350 ont rempli le questionnaire, soit un taux de réponse de 35 %. Aucune pondération n’a été appliquée, l’allocation étant proportionnelle. Les étudiants ayant abandonné après la date d’extraction sont restés dans la base et n’ont pas pu être identifiés, ce qui constitue une source mineure de surcouverture. »
La seconde version est plus longue, et chaque phrase supplémentaire est une question qu’un relecteur n’a plus à poser.
« Les participants ont été recrutés par une invite affichée aux utilisateurs actifs de l’application pendant deux semaines. Il s’agit d’un échantillon de commodité : les résultats décrivent les personnes qui ont répondu et ne peuvent pas être généralisés à l’ensemble des utilisateurs, et aucun chiffre de précision n’est indiqué. Les participants étaient plus susceptibles que l’ensemble des utilisateurs d’être des utilisateurs quotidiens, ce dont il faut tenir compte à la lecture des résultats. » Écrivez cela, et personne ne pourra vous accuser d’en affirmer trop. Et pour cause : vous ne l’avez pas fait.
Liste de contrôle du plan d’échantillonnage
Un plan d’échantillonnage écrit évite la plupart des erreurs évitables, car il oblige à prendre les décisions avant le terrain plutôt que pendant l’analyse. Huit points, une page.
- 1. Objectif de recherche. Quelle décision cela éclaire-t-il, et qu’est-ce qui sera présenté exactement ?
- 2. Population cible. Qui est inclus et qui est exclu, période comprise.
- 3. Base de sondage. Source, date d’extraction, nombre de lignes, lacunes connues et règle de dédoublonnage.
- 4. Méthode et justification. Laquelle des neuf, et pourquoi celle-ci compte tenu de la base et de l’affirmation visée.
- 5. Objectifs. Participations complètes au total et par sous-groupe, ainsi que le taux de réponse attendu sur lequel vous vous basez.
- 6. Plan de recrutement. Modes de collecte, calendrier des relances, dispositions linguistiques et d’accessibilité, politique d’incitation.
- 7. Suivi. Ce que vous surveillerez pendant le terrain : réponse par strate, point d’abandon, non-réponse partielle.
- 8. Notes d’analyse. Pondération prévue, ajustement pour l’effet de plan, et limites que vous indiquerez quoi qu’il arrive.
Une fois le plan arrêté, c’est l’instrument qui décide si l’échantillon valait la peine d’être tiré. Un échantillon parfait ne peut pas sauver une question orientée ou à double objet ; il vaut donc la peine de parcourir des exemples de questions d’enquête avant de lancer quoi que ce soit.
Questions fréquentes
Qu’est-ce que l’échantillonnage en recherche ?
L’échantillonnage consiste à sélectionner un sous-ensemble d’une population, appelé échantillon, et à étudier ce sous-ensemble pour tirer des conclusions sur l’ensemble de la population. On y recourt parce que mesurer chaque membre d’une population est généralement trop lent, trop coûteux ou impossible. La méthode de sélection de l’échantillon détermine les conclusions que les résultats peuvent étayer.
Quelle est la différence entre une population et un échantillon ?
La population est le groupe complet que vous voulez décrire. L’échantillon est le sous-ensemble plus petit que vous mesurez réellement. L’échantillonnage est le processus qui mène de l’un à l’autre, et le recensement est l’alternative dans laquelle vous mesurez toute la population.
Qu’est-ce qu’une base de sondage ?
Une base de sondage est la liste ou le mécanisme concret dans lequel vous tirez votre échantillon : un registre d’étudiants, un registre de patients, une base de données clients, un recensement des ménages, une liste électorale. Elle compte davantage que le nom de la méthode, car toute personne absente de la base a une probabilité nulle d’être sélectionnée, quelle que soit la qualité de votre technique d’échantillonnage.
Quelle méthode d’échantillonnage ne nécessite pas de base de sondage ?
L’échantillonnage de commodité, par quotas, raisonné et en boule de neige ne nécessite aucune liste. L’échantillonnage par grappes et à plusieurs degrés ne nécessite qu’une liste de groupes, comme des écoles, des cliniques ou des villages, et non une liste d’individus. L’échantillonnage aléatoire simple, systématique et stratifié nécessite tous une liste complète des individus avant de commencer.
Quelle est la différence entre échantillonnage probabiliste et non probabiliste ?
Dans l’échantillonnage probabiliste, un mécanisme aléatoire effectue la sélection : chaque unité a donc une probabilité connue et non nulle d’être choisie, et vous pouvez calculer l’incertitude de vos estimations. Dans l’échantillonnage non probabiliste, ces probabilités sont inconnues, car la sélection dépend de la commodité, de quotas ou du jugement du chercheur. Conséquence pratique : seul un plan probabiliste permet d’annoncer un chiffre de précision pour une estimation de la population.
Quelle est la différence entre échantillonnage stratifié et par grappes ?
L’échantillonnage stratifié divise la population en groupes et tire un échantillon aléatoire dans chaque groupe, ce qui améliore la précision et garantit la présence de chaque groupe. L’échantillonnage par grappes sélectionne au hasard certains groupes, puis interroge toutes les personnes des groupes sélectionnés, ce qui réduit les coûts lorsqu’il n’existe aucune liste d’individus. En résumé : le stratifié utilise tous les groupes et une partie des personnes, les grappes une partie des groupes et toutes les personnes.
Qu’est-ce qu’une unité primaire d’échantillonnage ?
L’unité primaire d’échantillonnage est ce qui est sélectionné au premier degré d’un plan à plusieurs degrés. Dans une enquête nationale auprès des ménages, il s’agit généralement d’une zone, comme une circonscription, un village ou un îlot de recensement. Les ménages y sont ensuite sélectionnés au second degré. Nommer votre unité primaire d’échantillonnage est une exigence standard lorsque vous présentez un plan en grappes, car l’effet de grappe qu’elle crée doit être pris en compte dans l’analyse.
Qu’est-ce que l’échantillonnage aléatoire stratifié ?
L’échantillonnage aléatoire stratifié divise la population en groupes sans chevauchement, appelés strates, puis tire un échantillon aléatoire de façon indépendante dans chaque strate. L’allocation proportionnelle donne à chaque strate une part de l’échantillon égale à sa part de la population et ne nécessite aucune pondération. L’allocation non proportionnelle suréchantillonne délibérément des strates petites mais importantes, puis exige une pondération avant de présenter tout chiffre global.
L’échantillonnage en boule de neige est-il valable pour la recherche universitaire ?
Oui, lorsque la population est cachée, rare ou non enregistrée et qu’aucune base de sondage ne peut être constituée. C’est une approche reconnue pour les groupes difficiles à atteindre. Elle ne permet pas, en revanche, d’estimer une population, et sa principale faiblesse est que les participants recommandent des personnes qui leur ressemblent, si bien que l’échantillon dérive vers un seul réseau social. Partir de plusieurs points de départ sans lien entre eux réduit cette dérive et doit être décrit dans votre méthodologie.
L’échantillonnage aléatoire est-il la même chose que l’affectation aléatoire ?
Non. L’échantillonnage aléatoire est la façon dont vous sélectionnez les participants dans une population, et il détermine à qui vos résultats se généralisent. L’affectation aléatoire est la façon dont vous répartissez les participants sélectionnés entre les conditions d’une expérience, et elle détermine si un effet observé peut être attribué au traitement. Une étude peut utiliser l’une sans l’autre, et la plupart des expériences utilisent l’affectation aléatoire sans échantillonnage aléatoire.
Puis-je utiliser une méthode d’échantillonnage non probabiliste dans une étude quantitative ?
Oui, et une grande partie de la recherche quantitative publiée le fait. Ce qui change, c’est ce que vous pouvez affirmer. Vous pouvez présenter des effectifs, des pourcentages et des relations au sein de votre échantillon, et comparer des groupes en son sein. Vous ne pouvez pas présenter ces pourcentages comme des estimations de la population assorties d’une précision annoncée. Indiquez la méthode, décrivez le recrutement, comparez vos participants à une référence connue lorsqu’elle existe, et énoncez explicitement la limite au lieu d’espérer que personne ne pose la question.
Quelle est la différence entre l’échantillonnage et une distribution d’échantillonnage ?
L’échantillonnage est la procédure de sélection d’un échantillon. Une distribution d’échantillonnage est une autre notion. Imaginez que vous répétiez de nombreuses fois la même procédure d’échantillonnage. La dispersion de la statistique obtenue, comme la moyenne ou le pourcentage, sur l’ensemble de ces échantillons imaginaires constitue la distribution d’échantillonnage. C’est elle qui rend possibles les intervalles de confiance, et elle ne se comporte de façon prévisible que si l’échantillon a été tiré par une méthode probabiliste.
Comment savoir si mon échantillon est biaisé ?
Comparez l’échantillon obtenu à une référence connue, comme votre fichier du personnel, vos registres d’inscription ou des données administratives, sur des variables liées à ce que vous mesurez. Des écarts importants signalent des problèmes de couverture, de sélection ou une non-réponse différentielle. Comparez aussi les canaux de recrutement et les vagues de relance. Sachez qu’un bon taux de réponse est une preuve faible d’un biais réduit : sur 235 estimations publiées, le taux de réponse n’expliquait qu’environ 11 % de la variation du biais de non-réponse.
À lire aussi
L’échantillonnage est une décision parmi d’autres dans une étude plus large. Ces guides couvrent les décisions qui l’encadrent.
- La méthodologie d’enquête situe l’échantillonnage dans la suite d’une étude, de la définition de la population jusqu’au lancement.
- Comment déterminer la taille de l’échantillon couvre les calculs de précision que cette page laisse volontairement de côté, formules comprises.
- Comment rédiger des questions d’enquête couvre le volet de la mesure, qu’aucun plan d’échantillonnage ne peut sauver.
- Les principes de conception d’un questionnaire expliquent comment assembler un instrument complet une fois les questions écrites.
- Le biais de réponse approfondit la différence entre les personnes sélectionnées et celles qui ont répondu.
- Les questions démographiques sont utiles lorsque votre base ne contient pas la variable sur laquelle vous devez stratifier.
- La significativité statistique explique quoi faire des chiffres une fois l’échantillon constitué.
- L’analyse de données quantitatives couvre les étapes d’analyse suivantes, y compris la place des pondérations.
Comment ce guide a été rédigé, et ce qu’il ne couvre pas
Qui l’a rédigé. Michael Hodge, qui travaille sur la méthodologie d’enquête, la formulation des questions et la qualité des données chez SuperSurvey, et rédige les guides pratiques de notre rubrique Guides et aide.
Sur quoi il s’appuie. Les définitions suivent la revue méthodologique et les recommandations universitaires citées ci-dessous, là où les termes techniques sont réellement définis. Les pages officielles sur l’intégrité de la recherche et des instituts statistiques sont citées comme points de départ courts et accessibles, et non comme la source de ces définitions. Les descriptions des méthodes suivent les mêmes revues et recommandations. Chaque chiffre de la section sur les données provient d’une source primaire nommée, listée ci-dessous. Chaque affirmation porte aussi un niveau de preuve, pour que vous voyiez quels résultats sont établis et lesquels reposent sur une seule étude. Les chiffres d’effet de plan du graphique et du tableau sont nos propres calculs. Nous avons utilisé la formule standard, avec les hypothèses indiquées dans la légende, pour que vous puissiez les refaire ou les contester avec vos propres tailles de grappes.
Ce qu’il ne couvre pas. Ce guide porte sur l’échantillonnage pour les enquêtes et les études observationnelles. Il ne couvre pas les plans expérimentaux ni l’affectation aléatoire, au-delà de la distinction entre les deux. Il laisse aussi de côté l’échantillonnage pour les contrôles de réception, l’audit et le traitement du signal, qui emploient le même mot pour d’autres choses. L’échantillonnage déterminé par les répondants, l’échantillonnage temps-lieu et l’échantillonnage adaptatif par grappes sont de vraies méthodes utilisées par des spécialistes pour les populations cachées, et elles sortent du cadre de ce guide. Les chiffres de corrélation intraclasse proviennent d’enquêtes auprès des ménages dans des pays à revenu faible ou intermédiaire. Considérez-les comme illustratifs, et non comme des valeurs à transposer dans un autre contexte.
Là où les chiffres sont les plus fragiles. La réanalyse du Literary Digest repose sur une seule enquête de 1937 et une seule réanalyse ultérieure, et les deux auteurs signalent leur propre incertitude ; c’est pourquoi elle est classée au niveau B. Les chiffres d’erreur des sondages proviennent de sondages électoraux américains, exceptionnellement bien étudiés et pas forcément représentatifs de l’erreur d’enquête en général.
Transparence. SuperSurvey vend un logiciel d’enquête. Rien sur cette page n’est à vendre, aucune partie n’exige d’inscription, et aucune organisation n’a financé ni relu ce guide. Lorsque nous renvoyons vers nos propres pages, c’est parce qu’elles traitent la décision suivante, et non parce qu’un lien nous rapporte quoi que ce soit.
Références
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., et Negida, A. (2017). Sampling Methods in Clinical Research : an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- UK Government (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., et Brick, J. M. (2017). Roosevelt Predicted to Win : Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., et Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences et ICF (2022). National Family Health Survey (NFHS-5), 2019-21 : India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., et Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias : A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., et Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., et Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., et Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, pages 9 et 15. Les chiffres proviennent de l’édition 2025 ; la GSMA a depuis publié une édition 2026 faisant état d’un écart plus réduit.
- Brubaker, J., Kilic, T., et Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys : Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., et al. (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., et Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most ? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., et Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, page 9 et tableau 1.2.
- Kalton, G., Brick, J. M., et Le, T. (2005). Estimating components of design effects for use in sample design. In Household Sample Surveys in Developing and Transition Countries, Chapter VI. United Nations, Series F No. 96.