
アンケートのサンプルサイズとは、分析に含める完了回答の数で、nと表記します。招待数やリストに載っている人数とは異なります。この計算ツールのサンプリングの前提のもとでは、サンプルが大きいほど許容誤差は狭くなりますが、偏った募集や言葉づかいのまずい質問の影響はなくなりません。
サンプルサイズ計算ツール
登録しないと使えない部分はなく、データがどこかに送信されることもありません。計算ツールはブラウザ上で動作し、最初から計算例の答えが表示されています。使用した式と計算過程も表示するので、確認したり手計算で再現したりできます。
必要な回答数は?
6つの値を入力してください。入力に合わせて、答え、式、計算過程がすべて更新されます。
必要な完了回答数
370
有限母集団修正の適用後。
招待する人数
1,234
回答率30パーセントの場合。
抽出率
3.7%
回答を得る必要がある母集団の割合。
合計(サブグループごとに算出)
370
計算過程(ステップごと)
| 許容誤差 | 必要な完了回答数 | 必要な招待数 |
|---|
精度を高めるには、改善の度合いのおよそ2乗に比例して回答が必要になります。許容誤差を半分にすると、サンプルは約4倍になります。
コピーボタンを押すと、入力した数値、式、引用を含む短い方法の段落が作成され、プロジェクトの概要書や研究方法の章にそのまま貼り付けられます。
この計算ツールの引用:Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
結果は招待数ではなく完了回答数です。実査の終了時に手元に必要な件数です。招待数はその数を見込みの回答率で割ったもので、ほとんどのサンプル計画がつまずくのはここです。目標が決まったら、アンケートを作成し、想定する対象者でパイロット調査を行いましょう。パイロット調査で言葉づかいを確認し、自分のプロジェクトでの招待から回答完了までの割合を見積もります。
サンプルサイズの意味
サンプルサイズとは、アンケートに回答を完了した人の数です。このページのどの式でもnと表記します。机上で選ぶのではなく実査によって手に入れる唯一の量であり、許容誤差の計算の元になる数値です。
これと取り違えられやすい数が3つあり、それらを区別することがサンプル計画の大部分です。
- 母集団(N):記述したい全員。顧客リスト、従業員数、国など。
- 招待数:連絡を取る人数。全員が回答するわけではないため、常にnより大きくなります。
- サンプルサイズ(n):実査の終了時に手元にある完了回答の数。式が求めるのはこの数であり、3つのうち許容誤差を変えるのはこれだけです。
サンプルサイズで得られるのは精度、つまり各結果の周りのプラスマイナスの幅です。正確さ、つまり回答した人が回答しなかった人に似ているかどうかは得られません。大きな便宜的サンプルが小さな無作為サンプルより真実から遠いこともあり、nをいくつにしてもそれは直りません。違いについてはサンプルサイズの計画がつまずくところで解説しており、それを決めるのはサンプルの抽出方法です。
数値だけ知りたい場合の簡単な答え
重要な数値
- 完了回答385件が既定の答えです。信頼水準95パーセント、許容誤差プラスマイナス5パーセントポイント、結果の事前推定なしで式が返す値です。
- 小さな母集団では、はるかに少なくて済みます。1,000人のリストなら278件。100人のリストなら80件です。これが有限母集団修正の働きです。
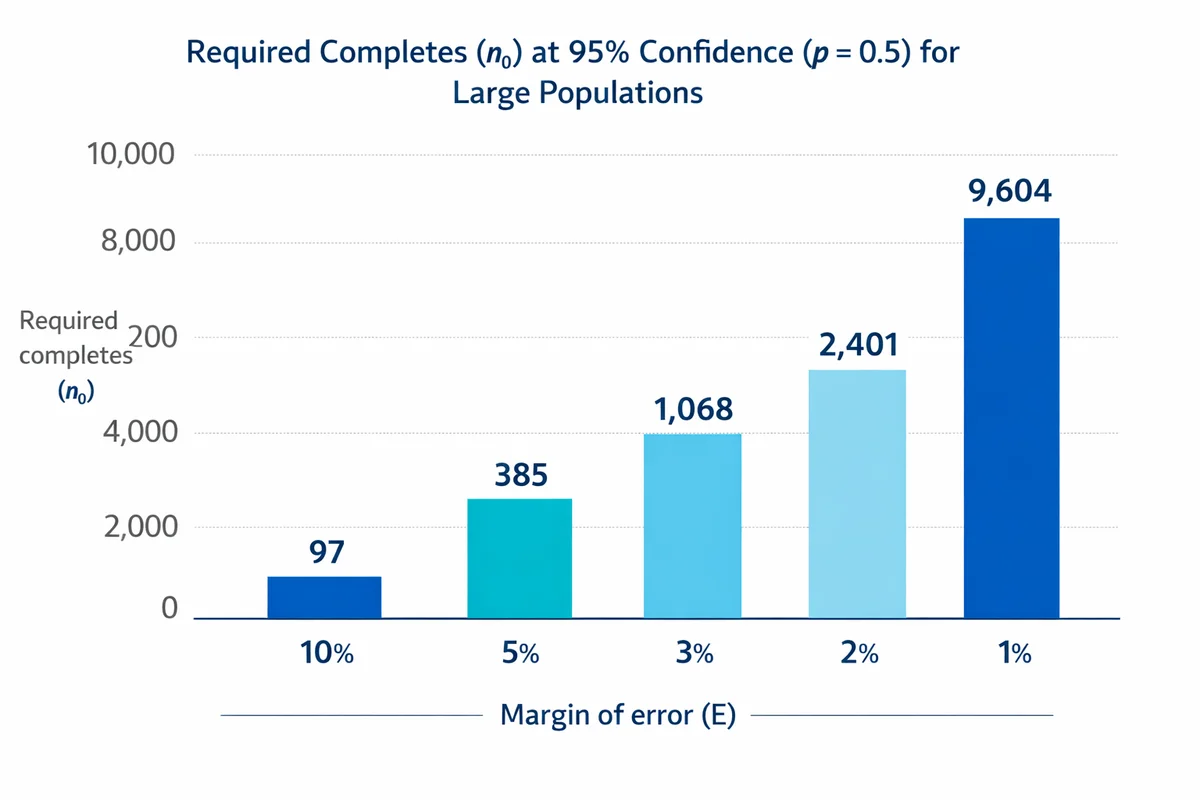
- 精度は高くつきます。許容誤差を半分にすると、サンプルは約4倍になります。プラスマイナス5ポイントからプラスマイナス1ポイントにすると、385件から9,604件になります。
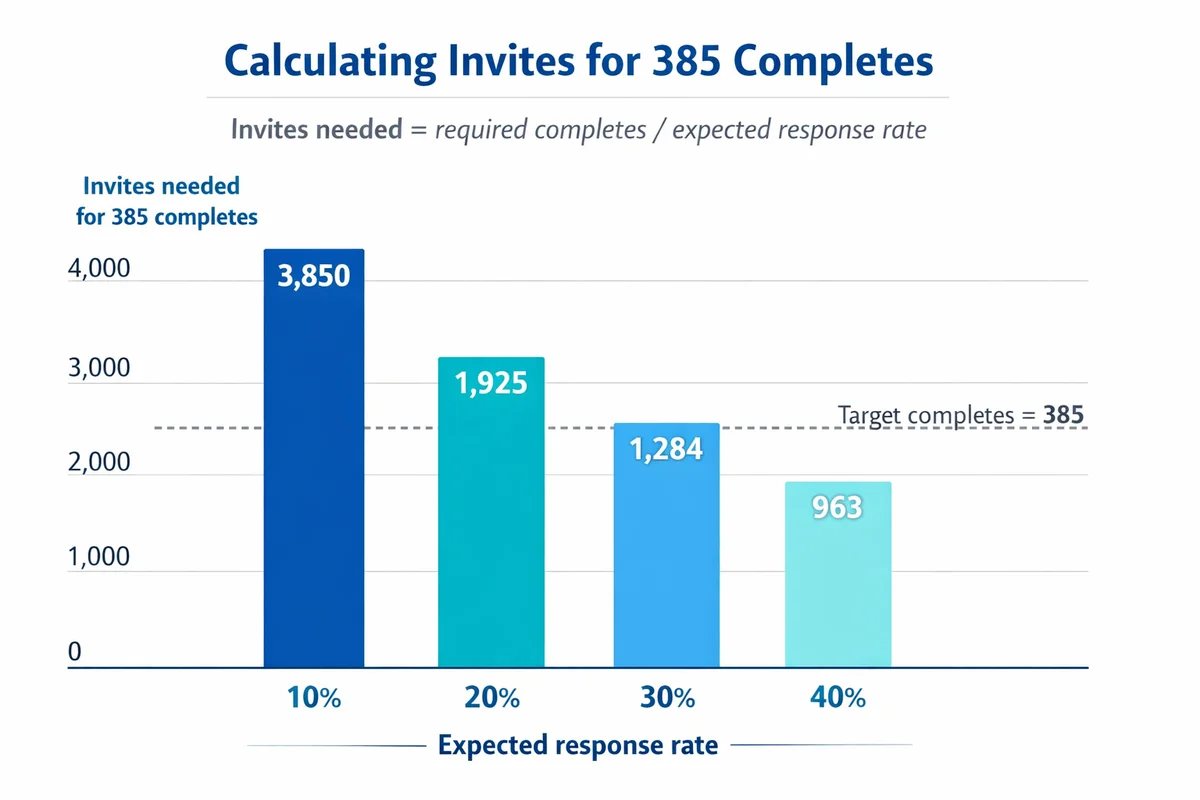
- 式が数えるのは招待数ではなく完了回答数です。必要な招待数は、完了回答数を見込みの回答率で割った値です。回答率30パーセントなら、完了回答385件には1,284人の招待が必要です。
- 許容誤差が対象とするのは1種類の誤差だけです。全員ではなく一部の人を抽出することによるノイズを測るものです。回答しなかった人については何も示しません。
サンプルサイズの計算式と、手計算のやり方
パーセンテージを報告するアンケートでは、無限とみなせるほど大きな母集団のサンプルサイズが標準的な出発点です。
n0 = (z^2 x p x (1 - p)) / E^2
左から順に読むと:
- n0は、母集団による修正の前の、必要な完了回答数です。
- zは、信頼水準に対応するzスコアです。95パーセントなら1.96を使います。
- pは、測定すると予想する割合を小数で表したものです。わからない場合は0.5を使います。
- Eは、許容誤差を小数で表したものです。5パーセントポイントなら0.05です。
サンプルサイズの記号はnです。修正前の数値をn0、修正後の数値をnと書く資料もあり、ここではその表記に従っています。
| 信頼水準 | z | 必要なコスト |
|---|---|---|
| 80パーセント | 1.282 | プラスマイナス5ポイントで完了回答165件 |
| 90パーセント | 1.645 | 完了回答271件 |
| 95パーセント(標準) | 1.960 | 完了回答385件 |
| 99パーセント | 2.576 | 完了回答664件 |
| 99.9パーセント | 3.291 | 完了回答1,084件 |
計算例:385件から招待リストまで
状況。自社を推薦する顧客の割合を知りたいとします。信頼水準95パーセント、プラスマイナス5ポイントを求めます。事前の推定値はないので、p = 0.5です。
信頼水準と許容誤差を選ぶ
信頼水準95パーセントでz = 1.96となります。プラスマイナス5パーセントポイントはE = 0.05です。
予想される結果を選ぶ
事前の推定値がなく、0.5で最大のサンプルになるため、p = 0.5とします。後で何がわかっても、不足することはありません。
サンプルサイズの計算式を当てはめる
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
切り上げて完了回答385件。必ず切り上げます。アンケートを端数の分だけ集めることはできません。
小さな母集団の場合に修正する
その顧客が開かれた市場ではなく1,000人のリストなら、修正を適用します:n = 384.16 / (1 + 383.16 / 1,000) = 384.16 / 1.38316 = 277.7、つまり完了回答278件です。修正が効いてくるのは、サンプルが母集団の大きな割合を占める場合だけです。
完了回答数を招待数に換算する
回答率30パーセントなら、招待数 = 278 / 0.30 = 926.7、つまり927人を招待します。式が求めるのは完了回答数です。招待数は実際に送る数であり、抽出元の母集団を超えることはありません。
信頼水準95パーセント、p = 0.5なら、式全体は0.9604をEの2乗で割るという形にまとまります。この1つの近道で、サンプルサイズに関する質問のほとんどに1行で答えられます。ほかで見かけるサンプルサイズの表に385が繰り返し出てくるのもこのためです。
一般的な母集団の大きさごとのサンプルサイズ表
これらの数値は、上の式を信頼水準95パーセント、プラスマイナス5ポイント、p = 0.5で計算し、母集団に応じて修正したものです。最後の2列は、研究方法の章で最もよく引用される、1970年にKrejcieとMorganが公表した表と当社が照合した結果です。
| 母集団(N) | 必要な完了回答数 | KrejcieとMorgan(1970) | 差 |
|---|---|---|---|
| 10 | 10 | 10 | 同じ |
| 25 | 24 | 記載なし | |
| 50 | 45 | 44 | 1件多い |
| 100 | 80 | 80 | 同じ |
| 200 | 132 | 132 | 同じ |
| 500 | 218 | 217 | 1件多い |
| 1,000 | 278 | 278 | 同じ |
| 2,000 | 323 | 322 | 1件多い |
| 5,000 | 357 | 357 | 同じ |
| 10,000 | 370 | 370 | 同じ |
| 50,000 | 382 | 381 | 1件多い |
| 100,000 | 383 | 384 | 1件少ない |
照合の方法。21通りの母集団の大きさで式を計算し、それぞれの結果を公表されているKrejcieとMorganの値と比較しました。12件は完全に一致しました。残りの9件はちょうど1件の回答だけ異なっていましたが、これは計算についての見解の違いではなく、各方法が端数をどこで丸めるかによるものです。あなたの数値が表と1件違う理由を指導教員に尋ねられたら、これが答えです。
その表を引用する場合に知っておく価値があること:KrejcieとMorganは独自の式を導いたわけではありません。1970年の論文は約400語と表1つからなり、唯一の参考文献は、式の出典を全米教育協会(National Education Association)の1960年の研究報告としています。それでも、このパターンについての彼ら自身の要約は、今でも最もよい一行の説明です。母集団が大きくなるにつれて必要なサンプルは増えますが、その増え方は次第に小さくなり、380件をわずかに超えたところで落ち着く、というものです。
入力値を一つずつ選ぶ
答えを決めるのは4つの数値です。そのうち3つは事実ではなく判断であり、どれにも根拠のある選び方があります。
信頼水準:方法がどれだけの頻度で正しいか
信頼水準が表すのは方法であって、この特定のアンケートではありません。信頼水準95パーセントとは、この方法で作った区間が、長い目で見て100回中95回は真の値を含むということです。あなたの特定の答えが正しい確率が95パーセントという意味ではありません。
特に理由がなければ95パーセントを使いましょう。99パーセントにすると、同じ精度でサンプルが385件から664件に増えます。ごくわずかな改善のために、コストが72パーセント増えることになります。仮説検定で関連する考え方はアルファで、そのため両者はよく混同されます。この区別があいまいなら、数値を選ぶ前に統計的有意性とp値の意味をお読みください。
許容誤差:判断のための変数
最もよく考えるべきなのはこれです。サンプルを意思決定と結びつける唯一の入力値だからです。どれだけの差があれば行動が変わるかを考えて選びましょう。
満足度が74パーセントではなく72パーセントのときに行動を変えるなら、狭い許容誤差が必要です。72と82の違いでしか行動しないなら、プラスマイナス5ポイントで十分です。大まかな全体の報告なら、現状把握のための調査では通常5ポイント、継続的な追跡では3ポイントに落ち着きます。2ポイントを下回ると、コストは急に上がります。
母集団の大きさ:ほとんど関係ないが、関係するときもある
大きな母集団では、必要なサンプルはほとんど変わりません。1万人なら370件、10万人なら383件です。母集団の大きさが効いてくるのは、サンプルが母集団のかなりの割合を占める場合だけで、従業員リスト、会員名簿、学校の学年などがそれにあたります。それを扱うのが次のセクションです。
予想される結果(p):わからない場合は0.5を使う
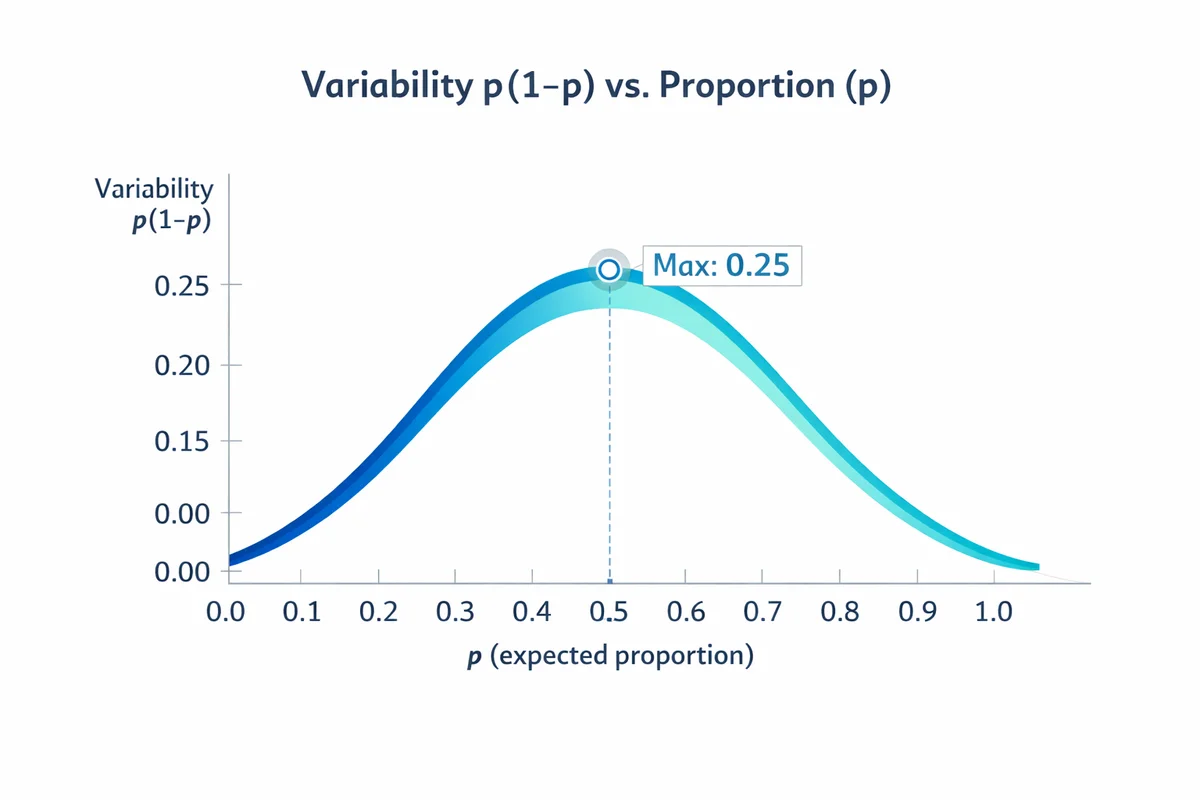
パーセンテージを尋ねる質問では、不確実性はp×(1 - p)で決まります。この項はp = 0.5のときに最大になるので、0.5は保守的な選択であり、最大のサンプルになります。事前の推定値がない場合の正しい既定値です。
推定値があるなら使いましょう。節約できる分が大きいからです。信頼水準95パーセント、プラスマイナス5ポイントでは、p = 0.5なら385件、p = 0.9なら139件の回答が必要です。過去のアンケート、パイロット調査、公表された基準値は、いずれもその推定値の正当な情報源です。わかりにくい質問もばらつきを大きくするので、言葉づかいを明確にすれば、回答を増やさなくても結果を安定させられます。よりよいアンケートの質問を書くほうが、回答を増やすより安上がりなことがよくあります。
小さな母集団:有限母集団修正
基本の式は、何人か抜き出しても何も変わらないほど大きな集団から抽出することを前提にしています。サンプルが母集団のかなりの部分を占めるようになると、その前提では必要数を多く見積もりすぎます。有限母集団修正によって、その分の回答数が戻ってきます。
n = n0 / (1 + ((n0 - 1) / N))
- nは、修正後の必要な完了回答数です。
- n0は、上の式で求めた修正前の数値です。
- Nは、母集団の大きさです。
通常の目安は、n0がNの約5パーセントを超える場合です。それ未満では修正してもほとんど何も変わらないので、誰かに説明するほどの価値はありません。
計算例:従業員アンケート
状況。従業員が1,200人います。信頼水準95パーセント、プラスマイナス5ポイントを求め、p = 0.5を使います。
- 修正前:n0 = 384.16。
- 修正後:n = 384.16 / (1 + (383.16 / 1,200)) = 384.16 / 1.3193 = 291.2。
- 切り上げて完了回答292件。
修正しなければ、1,200人のリストから385件の回答、つまり全員の32パーセントを追い求めることになります。修正すれば、292件で同じ精度が得られます。この規模のリストなら、しなくて済む1か月分の督促にあたります。
およそ200人未満では、修正後のサンプルがリストの大部分を占めるため、全員を招待するほうが簡単で、根拠も示しやすくなります。150人の全数調査には、サンプリング誤差がまったくありません。そうすれば労力は回答率と、誰が欠けているかに向けられます。労力を向けるべきなのは本来そこです。
許容誤差:同じ式を逆向きに使う
許容誤差とは、全員ではなく一部の人に尋ねたことによって生じる、アンケート結果の周りのプラスマイナスの幅です。385人の回答者の62パーセントがある選択肢を選び、許容誤差が5ポイントなら、62パーセントと報告し、妥当な範囲は57から67パーセントであると述べます。
サンプルサイズの式をEについて解くように変形すると、次のようになります。
E = z x (p x (1 - p) / n)の平方根
有限母集団の場合は、これに(N - n)を(N - 1)で割った値の平方根を掛けます。下の計算ツールには両方の式が入っており、母集団のチェックボックスをオンまたはオフにすると自動的に切り替わります。
すでに集めた回答の許容誤差は?
同じ式を変形したものです。集めた回答数を入力すると、精度がわかります。
許容誤差
5.0
プラスマイナスのパーセントポイント。
区間
45.0~55.0
パーセント(信頼水準95パーセント)。
計算過程(ステップごと)
サンプルサイズが大きくなると許容誤差は大きくなる?
小さくなります。しかも、nの平方根に応じて小さくなります。この平方根が、アンケートの経済性のすべてです。回答400件なら、100件の半分の誤差になります。さらに半分にするには1,600件必要です。精度の桁を1つ上げるごとに、およそ4倍の実査が必要になります。385件がよく落ち着く数値なのはこのためです。コストと精度の綱引きがそこで止まるのです。
混同されやすい4つの用語
標準誤差、許容誤差、信頼水準、信頼区間は、まるで同じものであるかのように使われます。これらは4つの異なるものであり、誰かに数値を問われたときにその違いが重要になります。
| 用語 | 意味 | 回答385件、50パーセントの場合 |
|---|---|---|
| 標準誤差 | 推定値のそのままのばらつき。p×(1 - p)をnで割った値の平方根。 | 0.0255、つまり2.55パーセントポイント |
| 許容誤差 | 標準誤差に、選んだ信頼水準のzスコアを掛けたもの。 | 95パーセントでプラスマイナス5.0ポイント |
| 信頼水準 | 選んだzスコアをパーセントで表したもの。測定値ではなく、選択です。 | 95パーセント、つまりz = 1.96 |
| 信頼区間 | 結果に許容誤差を適用し、範囲として表したもの。 | 45.0パーセント~55.0パーセント |
要するに、標準誤差はデータの性質、信頼水準は自分で選んだもの、許容誤差はその2つを掛け合わせたもの、そして信頼区間は報告書に載せるものです。
許容誤差が対象としないもの
許容誤差が対象とするのは無作為なサンプリング誤差だけで、それ以外は含みません。招待を無視した人、母集団の一部が欠けたリスト、回答者の半数が意図と違う意味に受け取った質問は対象外です。アンケートは、整った許容誤差を示しながら間違っていることがあります。どのサンプルサイズでも直せない誤差については、回答バイアスと非回答バイアスをご覧ください。
アンケート調査の専門団体は、多くのベンダーよりもはっきりとこう述べています。AAPORによれば、世論調査に測定可能な全体の許容誤差などというものは存在しません。アンケートには、質問の書き方からインタビューの進め方まで、まったく測定できないほかの誤差があるからです。計算できるのはサンプリングの部分です。計算ツールが示すのはその部分であり、それが一部分にすぎないことをはっきりさせておく価値があります。
同じ出典による2つの使い方のルール。アンケートに関する文章の多くは、どちらも誤っています。
- 単位はパーセントではなく、パーセントポイントです。「プラスマイナス3パーセント」ではなく「プラスマイナス3パーセントポイント」と書きましょう。意味が異なります。
- 公募型サンプルにはまったく当てはまりません。許容誤差は、すべての人が既知でゼロではない確率で選ばれ得たことを前提としています。誰でも開けるリンク、ボランティアのパネル、ソーシャルメディアの投稿はこれを満たしません。誰でも開けるリンクで集めた結果の横に許容誤差を載せるのは、手に入れていない精度を主張することです。
完了回答数を招待数に換算する
式が示すのは完了した回答の数です。実査で得られるのは回答率です。その差こそサンプル計画がたいていつまずくところで、計算は1行です。
招待数 = 必要な完了回答数 / 見込みの回答率
回答率は小数で使い(30パーセントなら0.30)、切り上げます。回答率35パーセントで完了回答292件なら、292を0.35で割って834.3、つまり少なくとも835人を招待します。
| 必要な完了回答数 | 見込みの回答率 | 招待数 |
|---|---|---|
| 385 | 60パーセント | 642 |
| 385 | 30パーセント | 1,284 |
| 385 | 15パーセント | 2,567 |
| 292 | 50パーセント | 584 |
| 292 | 35パーセント | 835 |
| 292 | 20パーセント | 1,460 |
根拠を示せる回答率の選び方
同じ対象者、同じ経路、同程度の長さのアンケートであれば、自分たちの過去の実績はどんな公表された基準値にも勝ります。手がかりが何もなければ、20、30、40パーセントの3つのシナリオで計画し、招待リストを実査中に調整できる手段として扱いましょう。リマインダー、期間の延長、リストの拡大は、どれも途中で変えられます。完了回答数の目標は変えられません。
インターネット上の基準値の表の多くは、出典のない平均値を1つ示しています。単一の平均値というものはありません。ここでは一次資料が実際に報告している数値を示すので、誰かが作った数字ではなく、自分の状況に合う行を引用できます。
| 状況 | 回答率 | 規模と出典 |
|---|---|---|
| 職員1,000人未満の米国連邦機関 | 71パーセント | 2024 Federal Employee Viewpoint Survey (OPM) |
| 職員1,000~9,999人の米国連邦機関 | 60パーセント | 同じ調査、同じ年 (OPM) |
| 職員75,000人超の米国連邦機関 | 37パーセント | 同じ調査、同じ年 (OPM) |
| 米国連邦職員全体 | 41パーセント | 160万人超を招待し、674,000人超が回答(2024年) (OPM) |
| 公表されたオンラインアンケート(全種類) | 平均44.1パーセント | 報告された1,071件の回答率のメタ分析 (Wuほか, 2022) |
| 公表された組織研究 | 2020年に68パーセント(2005年の48パーセントから上昇) | 17誌の1,014件のアンケート (Holtomほか, 2022) |
| 一般市民を対象とした電話世論調査 | 2018年に6パーセント(1997年の36パーセントから低下) | Pew Research Center自身が追跡した回答率 (KennedyとHartig, 2019) |
| ウェブとほかの調査方法の比較 | 約12ポイント低い | 114件の実験的比較のメタ分析 (Daikelerほか, 2020) |
この表から2つのことがわかります。第一に、調査対象の集団の大きさは、自分で管理できるほかのほとんどの要素よりも、回答率をよく予測します。300人の会社と300,000人の機関とでは、同じアンケートを行っているとは言えません。第二に、回答率がどこでも急落しているという広く繰り返される主張は、一部にしか当てはまりません。電話世論調査は確かに急落しました。公表された組織研究は逆の方向に進み、15年間で48パーセントから68パーセントに上がりました。
もう1つ、借りておく価値のある計画の計算があります。大学のエクステンション(普及事業)で標準とされる指針では、どうしても連絡がつかない人の分として招待リストに約10パーセントを、回答できるのに回答しない人の分として約30パーセントを上乗せします。
当社のテンプレート集が長さについて示すこと
ほかの人のアンケートから借りた回答率は、うまく当てはまらないものです。そして長さは、その要因の中で完全に自分で管理できる数少ないものの1つです。ここでは、実務家に自分のやり方を尋ねるのではなく、当社が公開しているテンプレート集を数えて得た、競合他社には出せない数値を示します。
2026年8月21日の監査では、87件のアンケートテンプレートはすべて14問以下で、86件は10問以下でした。合計で799問ありました。中央値は9問で、10問を超えるテンプレートはちょうど1件でした。これらの数値はその日付時点のスナップショットを表すもので、現在のライブラリを表すものではありません。
| テンプレートの質問数 | テンプレート数 | 全体に占める割合 |
|---|---|---|
| 7問 | 4 | 5パーセント |
| 8問 | 17 | 20パーセント |
| 9問 | 29 | 33パーセント |
| 10問 | 36 | 41パーセント |
| 14問 | 1 | 1パーセント |
回答形式別では、799問のうち355問が評価スケール、281問が単一選択のリスト、163問が文字入力を求めるものです。完了率を下げるのは最後のグループなので、保存されたフィールドを信用せず、手作業で読みました。163問のうち、137問は複数行のコメント欄です。残りの26問は1行の入力欄で、読んでみると、そのうち22問は氏名、メールアドレス、日付、部署、役職といった短い識別・分類用のフィールドでした。実質的な短答式の質問は4問だけです。したがって、本当の意味で自由回答形式の質問を正直に数えると141問、つまりおよそ6問に1問であり、元のフィールドが示していたであろう5問に1問ではありません。
集計と確認の方法。2026年8月21日にこのサイトで公開されていたすべてのアンケートテンプレートについて、保存されている質問リストを解析し、質問文のある項目を残しました。そのうえで、自社のデータベースだけを信用するのではなく、公開ページを1件ずつ取得して2つの集合を比較しました。87ページはすべてHTTP 200を返し、同じ実行で、存在しないとわかっているスラッグは410を返したので、この確認は一律に合格を出すものではなく、正しく判別できていました。799問のうち785問、つまり98パーセントが公開ページに表示されています。そのうち6件の一致は、データベースとの違いがアポストロフィの文字の種類だけで、一致として数えました。黙って丸めてしまうより、開示しておきたいと考えています。87件のテンプレートのうち86件は完全に確認できました。確認できなかった1件は14問ある最も長いテンプレートで、その公開ページには現在プレビューの質問がまったく表示されないため、外部から質問を確認できませんでした。
テンプレートの長さから、招待に対する回答率はわかりません。当社の別のアンケート回答ベンチマークは、人がアンケートに触れた後の行動を調べたもので、招待した全員を数えたものではありません。招待の計画には、比較可能なプロジェクトやパイロット調査で記録された回答率を使い、分母をそろえてください。
実際の使い道は限られていますが、確かなものです。計算ツールの招待数のために回答率を借りるなら、これから送るアンケートと同じくらいの長さで、似た対象者に似た経路で送ったアンケートから借りましょう。当社が公開している調査票は7問から10問で、多くの下書きの最初の長さより短くなっています。
招待を増やしても、バイアスは減らない
回答率が低いと、1つに見えて実は2つの問題が生じます。1つ目は、目標に届かずに終わるため、許容誤差が計画より広くなることです。2つ目は、回答した人が回答しなかった人と、結果にとって重要な点で異なる可能性があることです。
招待を増やせば1つ目の問題は解決します。2つ目の問題は確実には解決しません。GrovesとPeytchevaは、既知の真の値に対して実際の非回答バイアスを測定した59件の研究をまとめ、アンケートの回答率とバイアスの大きさの間にはわずかな関係しかないことを見いだしました。Pewは同じ考えを直接検証しました。1つの調査票を2回実施し、1回は回答率9パーセントだった標準的な方法で、もう1回は回答率22パーセントだった手厚い手順で行いました。2つの調査に共通する40問のうち、28問は互いに2ポイント以内の結果でした。
誠実に示すべき反例。この知見はすべてのテーマに一般化できるわけではなく、どこで当てはまらなくなるかを知っておく価値があります。満足度調査では、この関係は本物で、しかも大きいのです。スイスの164病院で行われた717件の入院患者満足度調査の研究では、平均満足度スコアと回答率の相関はr = 0.61でした。大満足の人と激怒している人は回答し、どちらでもない中間の人は回答しないからです。CSATやNPSを実施しているなら、回答率が上がるだけでスコアが動くことがあり、回答率が低いとおそらくスコアは実際より良く見えます。
つまり、人々が自分たちをどう感じているかを測るときは回答率を追いましょう。それ以外のものを測るときは、回答率を妥当性の証明書として扱ってはいけません。
量的研究のサンプルサイズ:研究方法の章に必要なこと
量的研究に唯一の適切なサンプルサイズはありません。何を測定するのかを尋ねずに1つの数値を示す情報源は、推測で言っているにすぎません。研究方法の章が承認されるのに必要なのは、大きな数値ではありません。信頼水準、許容誤差、想定する割合、母集団を併記し、名前のある式を添えて明示した数値です。
指導教員が期待するのは、たいてい名前のある4つの方法のいずれかです。それらはおおむね一致しますが、どれを求められているかを知っておく価値があります。
| 方法の名前 | 必要な情報 | N = 1,000、95パーセント、5ポイントでの結果 | 使う場面 |
|---|---|---|---|
| Cochran(1977) | z、p、E、そして母集団が小さい場合は有限母集団修正 | 278 | 既定の方法。このページの式であり、ほかの方法はここから導かれています。 |
| KrejcieとMorgan(1970) | なし。公表された表から母集団の大きさで答えを読み取ります。 | 278 | 計算ではなく引用できる表が欲しいとき。設定を固定したCochranの方法です。 |
| Yamane(1967)、よくSlovinと呼ばれる | Nと許容誤差だけ | 286 | pが本当にわからず、信頼水準95パーセントが組み込まれていることを受け入れる場合のみ。下の注意をご覧ください。 |
| 検出力分析 | 効果量、検出力、アルファ、実施する検定 | 効果量に完全に依存 | パーセンテージを推定するのではなく、仮説を検定するとき。このページではなく、G*PowerやOpenEpiを使います。 |
Cochranの式と、ほかの方法がすべてその近道である理由
Cochranの式は、このページの冒頭にある式です。n0 = zの2乗×p×(1 - p)をEの2乗で割ったもので、母集団が小さい場合はその後に有限母集団修正を行います。ほかの名前のある方法は、計算を短くするためにこれらの入力値の一部を固定しています。それがわかれば、この一群は競合する4つのルールではなく、3つのプリセットを持つ1つのルールに見えてきます。
YamaneとSlovin:わかったうえで使う
n = N / (1 + N x e^2)という式は数多くの学位論文に登場し、たいていSlovinの式とされています。手軽で、N = 1,000、e = 0.05なら286になります。
引用する前に知っておく価値があることが3つあります。
- 設定を固定したCochranの式です。逆算すると、この式は、pを0.5に、信頼水準を95パーセントに固定し、zを1.96から2に丸めた割合の式です。ほかの信頼水準での問いには答えられず、母集団のばらつきを入力する項目もまったくありません。大きさが同じでもばらつきが大きく異なる2つの母集団が同じ答えになり、それが正しいはずはありません。
- その丸めのせいで、数値が高めに出ます。z = 2では、無限の母集団に対するこの式の上限はちょうど1をeの2乗で割った値、つまり400です。Cochranの上限は384.16です。1.96の2乗は3.8416であって4ではないからです。上の表のYamaneの数値がすべてCochranの数値より数パーセント大きいのは、まさにこの理由によります。同じ研究なのに2冊の教科書で異なるサンプルサイズが示される理由を不思議に思ったことがあるなら、たいていはこれが答えです。
- 名前の由来は成り立ちません。ある統計学の学術誌がこの式の歴史をたどり、Slovinという人物はその背後に見当たらず、たどれる最古の出典はタロウ・ヤマネ(Taro Yamane)の1967年の教科書だと結論づけました。Wolfram MathWorldは、数学的な厳密さを欠くその場しのぎの式だと説明しています。所属する学部がこれを求めるなら、使ったうえでSlovinではなくYamaneを引用しましょう。選べるならCochranを使いましょう。95パーセントはどこから来たのかという問いにも耐えられるからです。
経験則を正直に評価する
これらは広く出回っています。有用なものもあれば俗説もあり、どれがどれかを知っておくと役立ちます。
- 1グループあたり最低30。集団比較の下限としては妥当ですが、目標ではありません。これは標本分布が安定し始める点に由来するもので、精度の要件から来たものではありません。
- 回帰分析では変数1つにつき10件。広く使われ、広く批判されている実用上の目安です。ルールではなく、目安として示しましょう。
- 母集団の10パーセント。これは単純に誤りで、上の表がその理由を示しています。100,000人の10パーセントは10,000件の回答ですが、383件で同じ精度が得られます。
- 常に385件。大きな母集団で、95パーセント、5ポイントの場合にだけ正しい値です。その条件を添えて示さなければ意味がありません。
- ユーザビリティ調査や製品調査では小さなn。Nielsen Norman Groupは、これを正直な形で公表しています。参加者40人で、はい・いいえの指標を信頼水準95パーセントでプラスマイナス15ポイントの精度で得られ、47人で平均値を同じ精度で得られます。これらの数値が小さいのは、主張する精度がゆるいからです。精度をはっきり示せば、小さなサンプルは恥ずかしいものではなくなります。
1つのパーセンテージを推定するのではなく集団を比較する研究なら、サンプルサイズは検出力の問題になり、この計算ツールは適していません。根拠を示せる効果量と、アルファ、検出力が必要です。多くの指導教員が想定するのはG*PowerとOpenEpiで、どちらも無料です。ツールがどこまで使えるかを示すほうが、何でもできるふりをするより役に立ちます。
質的研究は別の方法で規模を決める
インタビューやフォーカスグループは、母集団のパーセンテージを推定するものではないため、許容誤差で規模を決めません。通常の考え方は飽和です。新しい参加者から新しいテーマが出なくなるまで続け、それがどこで起きたか、どのように判断したかを報告します。質的研究をこの計算ツールにかけると、正確そうに見えて何の意味もない数値が出てきます。
サブグループ別の結果が必要なら、サブグループに合わせて規模を決める
ほとんどのアンケートは、地域、役職、勤続年数、製品ラインごとの報告を求められます。サンプル計画が気づかないうちに崩れるのはここで、ルールは簡単です。
許容誤差が集団に当てはまるのは、その集団にその数の完了回答がある場合だけです。6つの地域それぞれでプラスマイナス5ポイントを求めるなら、合計385件ではなく、各地域でおよそ385件の完了回答が必要です。計画していると思っていたアンケートの6倍の規模になります。
誠実な解決策は2つあります。
- 小さな集団をオーバーサンプリングする。小さなセグメントほど招待する割合を意図的に高くし、それぞれが自分の目標に届くようにします。後で結果にウェイトを付けて元に戻します。
- 内訳については幅が広くなることを受け入れる。全体の数値は1つしっかりと出し、各サブグループには、それぞれのより大きな許容誤差を添えて公表します。通常はこれが正しい答えです。
計算ツールには、このための項目があります。別々に報告するサブグループに、結果を出す必要がある集団の数を入力すると、各集団の規模を適切に算出し、合計します。
実施する前に範囲を決めましょう。あれば便利なセグメントではなく、報告しなければならないセグメントを挙げます。属性質問でそれらを識別するとして、それぞれから現実に得られる完了回答数を見積もります。あるセグメントから80件しか得られないなら、そこでプラスマイナス5ポイントを約束してはいけません。80件では幅はプラスマイナス11ポイントになります。
AAPORは、覚えておく価値のある計算例を示しています。成人1,000人のアンケートの全体の許容誤差は約プラスマイナス3ポイントです。そのうち200人が本当に話題にしたいサブグループなら、そのサブグループの許容誤差はプラスマイナス6.9ポイントで、2倍以上になります。報告書の表紙に載る見出しの数値は、9ページ目のグラフを左右する数値ではないのです。
最小セルサイズについて公表されている指針は、式よりも古くゆるやかなもので、目標ではなく下限として扱うのが妥当です。きちんと報告するサブグループならおよそ100件、軽く触れるだけの小さなサブグループなら20から50件です。
サンプルサイズの計画がつまずくところ
サンプルサイズで管理できるのはサンプリング誤差、つまり全員に尋ねないことによる無作為なノイズです。実際のアンケートには系統誤差もあり、これはどのサンプルサイズでも直せず、大きなサンプルによって覆い隠されることさえあります。
便宜的サンプルを確率サンプルのように扱う
ここにある式はすべて、一人ひとりが既知でゼロではない確率で選ばれ得たこと、そして回答するかどうかが測定する事柄と強く結びついていないことを前提としています。ソーシャルメディア上の誰でも開けるリンクは、どちらの条件も満たしません。それでも回答から許容誤差を計算することはでき、その数値は安心できるように見えますが、示している意味は成り立ちません。実際に抽出したのがどの種類のサンプルなのかを明示しましょう。
nが大きいことを、よりよい測定と受け取る
大きなサンプルは、ノイズの多い測定を、ノイズの多いまま精密にするだけです。質問が曖昧、ダブルバーレル、または誘導的なら、回答を増やしても救えません。スキップ率が高いことや回答に矛盾があることは、まず調査票を直すべきサインです。まずい質問を1つ書き直すほうが、サンプルを3倍にするより効果的なことがよくあります。
判断の裏づけなしに精度を選ぶ
精度に正しい答えがあるのは、それが何のためかがわかったときだけです。「Xポイント異なる結果を区別する必要がある」という文を完成させられるなら、サンプルサイズの根拠は簡単に示せます。大きな数値のほうが安心だと感じた、というのが唯一の理由なら、根拠を示すことはできません。調査設計と、結果をどう使うかに結びつけましょう。
このページの数値と、その信頼性
上で示した数値はすべて、計算ツールで再現できる計算か、確認できる引用のどちらかです。等級Aは再現されたもの、または直接計算できるもの、Bは1件の有力な研究、Cは広く繰り返されているが異論のあるものを意味します。
| 主張 | 数値 | 等級 | 出典 |
|---|---|---|---|
| 信頼水準95パーセントで事前の推定値がない場合、大きな母集団でプラスマイナス5ポイントを得るには385件の完了回答が必要です。 | 385 | A | 標準的な割合の式からの直接の計算。NIST 3.3.3節、Israel(1992)。 |
| このページの式は、確認した21通りの母集団の大きさのすべてで、公表されているKrejcieとMorganのサンプルサイズ表を回答1件以内の差で再現します。 | 21件中21件が1件以内 | A | KrejcieとMorgan(1970)との当社による照合。方法は表の下に記載。 |
| 回答率は非回答バイアスの弱い予測因子にすぎません。バイアスを専門に扱った59件の研究のメタ分析では、両者の間にわずかな関係しか見られませんでした。 | 59件の研究 | A | GrovesとPeytcheva(2008), Public Opinion Quarterly. |
| Pewは同じ調査票を回答率9パーセントと22パーセントで実施しました。共通する40問のうち、28問は2ポイント以内の結果でした。 | 40問中28問が2ポイント以内 | B | Pew Research Center(2012), Assessing the Representativeness of Public Opinion Surveys. |
| ただし満足度調査では、この関係は本物で、しかも大きいのです。717件の病院調査で、平均満足度スコアと回答率の相関はr = 0.61でした。 | r = 0.61 | B | Perneger、Peytremann-Bridevaux、Combescure(2020), BMC Health Services Research. |
| 従業員アンケートの回答率は、組織の規模とほぼ完全に連動します。2024年の米国連邦職員調査では、職員1,000人未満の機関で71パーセント、75,000人超の機関で37パーセントでした。 | 71パーセント対37パーセント | A | US Office of Personnel Management(2024), FEVS Governmentwide Management Report(160万人超の職員を招待). |
| 公表された1,071件のオンラインアンケートの平均回答率は44.1パーセントでした。標準的な回答率というものは1つではありません。 | 44.1パーセント | A | Wu、Zhao、Fils-Aime(2022)メタ分析, Computers in Human Behavior Reports. |
| 114件の実験的比較で、ウェブアンケートの回答率はほかの調査方法より約12パーセントポイント低くなっています。 | 12ポイント低い | A | Daikeler、Bosnjak、Lozar Manfreda(2020)メタ分析, JSSAM. |
| nは1をEの2乗で割った値に比例するため、許容誤差を半分にすると必要なサンプルは約4倍になります。サンプルを1,000件から2,000件に倍増しても、改善は約1ポイントです。 | 約4倍 | A | 式の代数的な性質。AAPORは1,000件から2,000件の場合を明示しています。 |
| 既知のp = 0.9ではなくp = 0.5を想定すると、集めるべきとされるサンプルは139件から385件へと、ほぼ3倍になります。 | 139件対385件 | A | 直接の計算。計算ツールで予想される結果を変えれば再現できます。 |
| このサイトで公開している87件のアンケートテンプレートはすべて14問以下で、87件中86件は10問以下です。799問のうち785問が公開ページで確認されました。 | テンプレート87件、799問 | A | 2026年8月21日時点で公開中のテンプレート集を当社が集計し、87件の公開ページすべてと照合したもの。方法、手作業での監査、確認率は表とあわせて記載。 |
| その名を冠した式の背後に、Slovinという人物はたどれません。たどれる最古の出典はYamane(1967)です。 | たどれる著者なし | B | TejadaとPunzalan(2012), The Philippine Statistician。Wolfram MathWorldはその場しのぎの式としています。 |
「常に385件の回答が必要」信頼水準95パーセント、プラスマイナス5ポイント、p = 0.5、大きな母集団の場合だけです。条件なしで示すと、小さな母集団ではすべて誤りになります。
「母集団の10パーセントを調査する」統計的な根拠はありません。大きな母集団では過剰に、小さな母集団では過少に抽出することになります。
「回答率が50または60パーセント未満だとアンケートは無効」そのような閾値はありません。50、60、70パーセントという段階は、実証的な根拠のない教科書的な経験則であり、GrovesとPeytchevaのメタ分析はこれと矛盾しています。回答率が示すのは最悪の場合のバイアスの上限です。実際のバイアスを測るものではありません。
「アンケートの平均回答率はXパーセント」同じ数年間の検証済みの数値でも、誰を調査するかによって6パーセントから71パーセントまで開きがあります。単一の平均値はそれを隠しています。代わりに、上の表から自分の状況に合う行を引用しましょう。
Slovinの式を導出されたもののように示すこと。これは信頼水準95パーセントとp = 0.5を組み込み、zを2に丸めたCochranの式であり、Slovinという名前の由来にはたどれる出典がありません。
根拠説明のテンプレート
サンプルサイズの論拠の多くは、前提が書き出されていないために通りません。計算ツールの根拠説明をコピーボタンを押すと、入力した数値を入れた状態でこれを書き出します。自分でまとめたい場合は、査読者が確認する9つの項目は次のとおりです。
- 母集団(N):母集団を定義し、その数を示します。例:過去90日間のアクティブな顧客全員、N = 48,200。
- 測定するもの:割合(パーセンテージ)か、平均値(評価の平均)か。ここでの式は割合の規模を決めるもので、報告されるKPIのほとんどはこれに当たります。
- 信頼水準:選んだ水準とその理由。慣例もリスク許容度も、そう明記すれば正当な理由になります。
- 許容誤差(E):全体の目標精度と、報告を約束したサブグループごとの目標精度。
- 想定する割合(p):使った値と、その出所。ほかに適切な値がなかったために0.5を使った場合は、はっきりそう書きます。
- 有限母集団修正:適用したかどうかと、適用したきっかけ。例えば、n0がNの10パーセントを超えたなど。
- 完了回答数の目標(n):すべての調整を行った後の、最終的に必要な完了回答数。
- 見込みの回答率:想定した回答率、その根拠となった実績、そこから求めた招待数。
- 人の選び方:単純無作為抽出、層化抽出、全数調査、便宜的抽出のいずれか、そして主要なセグメントのオーバーサンプリングの有無。正直に明記します。
アンケートの実施中は、合計ではなくセグメントごとの完了回答数を見続けましょう。全体の数値が順調でも、目標に届かないセグメントが隠れていることがあります。それは1週目ならまだ直せますが、4週目には直せません。報告する際は、すべてのパーセンテージに許容誤差を添え、2ポイントの変化を本物とみなす前にアンケートデータの分析方法をお読みください。
サンプルサイズ計画ワークシート
印刷して手書きで記入し、プロジェクトの概要書にホチキスで留められる1ページです。真ん中の列は実査の後ではなく、始まる前に記入してください。データはどこにも送信されず、アカウントも不要です。
| 決めること | 記入欄 | 記入のヒント |
|---|---|---|
| 母集団(N) | 正確には誰で、何人いるか。数だけでなく定義を書きます。 | |
| 測定するもの | パーセンテージか平均値か。このページで規模を決めるのはパーセンテージです。 | |
| 信頼水準 | 理由がなければ95パーセント。理由があれば書きます。 | |
| 許容誤差(E) | 区別できる必要がある差(ポイント)。 | |
| 想定する割合(p) | ほかに適切な値がなければ0.5。別の値ならその出所を書きます。 | |
| 有限母集団修正 | 適用したかどうかと、そのきっかけ。 | |
| 完了回答数の目標(n) | すべての調整後の最終的な数値。 | |
| 別々に報告するサブグループ | いくつあるか、それぞれ単独で必要な完了回答数。 | |
| 見込みの回答率 | 回答率と、その裏づけとなる実績。インターネットで拾った数値ではなく。 | |
| 送る招待数 | 完了回答数を回答率で割り、切り上げた数。Nを超えることはありません。 | |
| 人の選び方 | 無作為、層化、全数調査、便宜的のいずれか。正直に明記します。 | |
| 実査中の確認時点 | 合計だけでなく、セグメントごとの完了回答数を確認する日付。 |
式:n0 = (z^2 x p x (1 - p)) / E^2、続いてn = n0 / (1 + (n0 - 1) / N)。出典:Cochran (1977)、NIST/SEMATECH e-Handbook 3.3.3節、Israel (1992)。ワークシートの出典:https://www.supersurvey.com/Sample-Size
よくある質問
サンプルサイズとは?
サンプルサイズとは、アンケートの完了回答の数で、nと表記します。招待した人数でも、記述する母集団の大きさでもありません。実査を終えたときの件数であり、許容誤差の計算の元になる数値です。母集団が大きい場合、完了回答385件で、信頼水準95パーセントにおいて約プラスマイナス5ポイントになります。母集団、招待数、nの違いについてはサンプルサイズの意味で説明しています。
アンケートに必要な回答数は?
ほとんどのアンケートでは、実用上の答えは完了回答385件です。信頼水準95パーセント、許容誤差プラスマイナス5パーセントポイント、結果の事前推定なしで式が返す値です。母集団が小さければ、必要な数は少なくなります。1,000人のリストなら278件、100人のリストなら80件です。正確な数値とその計算過程を見るには、計算ツールにご自身の数値を入力してください。
信頼水準95パーセント、許容誤差5パーセントに必要なサンプルサイズは?
母集団が大きく、p = 0.5を使う場合は、完了回答385件です。計算はn0 = 1.96の2乗×0.5×0.5を0.05の2乗で割ったもので、0.9604を0.0025で割って384.16です。切り上げると385になります。母集団が小さい場合は有限母集団修正を適用すると、数は減ります。
許容誤差とは?
許容誤差とは、全員ではなく一部の人を抽出したことによって生じる、アンケート結果の周りのプラスマイナスの幅です。結果が62パーセントで許容誤差が5ポイントなら、その方法はほとんどの場合に真の値を含む区間を作り、この特定の区間は57から67パーセントであることを意味します。表しているのは無作為なサンプリング誤差だけです。回答しなかった人については何も示しません。
許容誤差の求め方は?
p×(1 - p)をnで割った値の平方根を求め、信頼水準のzスコアを掛けます。信頼水準95パーセント、回答385件、p = 0.5なら、1.96×(0.25を385で割った値の平方根)、つまり1.96×0.025482で0.0499です。したがって許容誤差はプラスマイナス5.0パーセントポイントです。このページの許容誤差計算ツールなら、計算を代わりに行い、途中の式も表示します。
サンプルサイズが大きくなると許容誤差は大きくなる?
いいえ、小さくなります。しかも、サンプルの平方根に応じて小さくなります。回答を100件から400件にすると、許容誤差は半分になります。400件から1,600件にすると、さらに半分になります。この平方根の関係があるから精度は高くつくのです。正確さの桁を1つ上げるごとに、およそ4倍の回答が必要になります。
許容誤差と標準誤差は同じですか?
いいえ。標準誤差は推定値のもともとのばらつきです。許容誤差は、標準誤差に、選んだ信頼水準のzスコアを掛けたものです。信頼水準95パーセントでは、許容誤差は標準誤差の約1.96倍です。標準誤差はデータの性質です。許容誤差は、その上に重ねる報告上の選択です。
量的研究に適したサンプルサイズは?
唯一の適切な数はありません。何を測定するのかを尋ねずに1つの数を示す情報源は、推測で言っているにすぎません。母集団が約10,000人未満でパーセンテージを報告する研究なら、根拠を示せる答えは、信頼水準95パーセントと根拠を示せる許容誤差で式が返す値です。1,000人のリストなら278件です。研究方法の章が承認されるのに必要なのは、大きな数ではなく、信頼水準、許容誤差、想定する割合、母集団を併記して明示した数です。指導教員が想定しそうな名前のある式については、量的研究のサンプルサイズをご覧ください。
アンケートの標準的な回答率は?
単一の標準的な回答率はなく、1つの数値を示すページは推測で言っているにすぎません。同時期の出典のある実際の数値は、6パーセント(2018年のPewの電話世論調査)から71パーセント(2024年のFederal Employee Viewpoint Surveyにおける小規模な米国連邦機関)まで開きがあります。公表された1,071件のオンラインアンケートのメタ分析では、平均は44.1パーセントでした。組織の規模は非常に大きく影響します。同じ連邦職員調査で、職員1,000人未満の機関では71パーセント、75,000人超の機関では37パーセントでした。まず自分たちの実績を使い、引用できる数値についてはベンチマークの表をご覧ください。
母集団の大きさはサンプルサイズに影響しますか?
サンプルが母集団の大きな割合を占めるようになるまでは、ほとんど影響しません。100,000人から1,000,000人になっても、必要数は383件から385件に変わるだけです。1,000人から100人になると、278件から80件に変わります。母集団の大きさが効くのは小さい側であり、まさにそこで有限母集団修正が適用されます。
p = 0.5が正しい選択なのはどんなとき?
根拠を示せる事前の推定値がないときは、いつでもp = 0.5を使います。p×(1 - p)の項は0.5で最大になるため、必要なサンプルが最も大きくなります。だからこそ安全な前提であり、不足することがありません。パイロット調査、基準値、前年の数値があれば、それを使いましょう。0.5ではなくp = 0.9を想定すると、必要なサンプルは385件から139件に減ります。
招待する人を増やせば、非回答バイアスはなくなりますか?
いいえ。招待を増やせば完了回答が増え、許容誤差は小さくなります。バイアスは別の問題で、回答した人が回答しなかった人と異なるかどうかで決まります。59件の非回答バイアス研究のメタ分析では、回答率と実際のバイアスの間にわずかな関係しか見られませんでした。Pewは同じ調査票を回答率9パーセントと22パーセントで2回実施し、共通する40問のうち28問は互いに2ポイント以内の結果でした。回答バイアスと非回答バイアスをご覧ください。
部署や地域ごとの結果が必要な場合、サンプルサイズはどう扱えばよいですか?
サブグループごとに別々に規模を決めます。許容誤差が集団に当てはまるのは、その集団にその数の完了回答がある場合だけです。すべての地域でプラスマイナス5ポイントを求めるなら、各地域にそれぞれ385件、または有限母集団修正を適用したそれぞれの数の完了回答が必要です。属性質問で集団を識別し、小さな集団はオーバーサンプリングする計画を立てましょう。
統計的に有意な結果を得るには、どれくらいのサンプルサイズが必要ですか?
この質問は2つの考え方を混ぜています。サンプルサイズの式は、推定値を選んだ精度に合わせて規模を決めるものです。有意性検定は2つの数値を比較し、その差が偶然で十分説明できるかを問うものです。必要な規模は、決まった閾値ではなく、どれだけ小さな差を検出したいかで決まります。ここでアンケートの規模を決め、ある結果を別の結果と比べて検定する前に統計的有意性をお読みください。
これらの式は質的研究にも使えますか?
いいえ。インタビュー、フォーカスグループ、自由回答形式の調査は、母集団のパーセンテージを推定するものではないため、許容誤差で規模を決めません。質的研究のサンプルサイズは飽和、つまり新しい参加者から新しいテーマが出なくなる時点を根拠に論じ、式ではなく証拠を伴う判断として報告します。質的研究をこの計算ツールにかけないでください。
参考文献
- National Institute of Standards and Technology (NIST). (n.d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, section 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.