
簡単に言うと
サンプリングとは、母集団の一部(サンプル)を選び出し、その一部を調べることで母集団全体について結論を導く手続きです。研究者がサンプリングを行うのは、全員を測定するのは多くの場合、時間がかかりすぎる、費用がかかりすぎる、あるいは単純に不可能だからです。母集団は記述したい集団、サンプルはそのうち実際に測定する部分、サンプリングフレームはサンプルを抽出する元のリストです。
確率抽出法は無作為な仕組みで人を選ぶため、すべての単位が選ばれる確率は既知で、ゼロではありません。だからこそ、不確実性を数値で示せるのです。
非確率抽出法は、手近さ、割当、または判断に基づいて選びます。多くの場合より速く安価で、倫理的に唯一可能な選択肢であることもありますが、精度を明示した母集団推定の根拠にはなりません。
要点
- サンプリングとは一部を調べること:全員を測定できないとき、サンプルを測定して母集団について知ります。
- まず5つの用語を正しく押さえる:母集団、サンプリングフレーム、抽出単位、サンプリング設計、そして記述したい母集団と実際に到達できる母集団とのずれです。サンプリングをめぐる議論の多くは、実はこのどれかをめぐる議論です。
- 不確実性を数値で示せるのは確率抽出法だけです。便宜的サンプル、割当サンプル、目的的サンプル、スノーボールサンプルは有用で誠実なものになり得ますが、精度を明示した母集団推定の根拠にはなりません。
- フレームが上限を決める:抽出元のリストに載り得ない集団は、どの方法を使っても、回答をどれだけ増やしても、結果に含まれることはありません。
- 代表性はラベルではなく連鎖です:フレーム、選定、募集、回答、分析の順につながっています。無作為抽出は5つの輪のうちの1つにすぎません。
サンプリングの定義(と正しく押さえるべき5つの用語)
サンプリングとは、より小さな集団(サンプル)を、より大きな集団(母集団)から選び出し、全員を測定しなくても母集団について知ることができるようにする手続きです。母集団全体を調べる研究は多くの場合現実的ではないため、研究者はサンプリングによって作業を実行可能にしつつ、有用な結論を導きます。
以下の5つの用語は、どの研究方法の章でも中心的な役割を果たします。これを誤ると、その後のすべての判断に誤りが引き継がれます。
- 母集団:記述したい集団全体で、範囲と期間を明記したもの。「3つのキャンパスに在籍する最終学年の看護学生全員(3月1日時点の在籍者)」は母集団です。「看護師」はそうではありません。
- 目標母集団と到達可能な母集団:記述したい対象と、募集方法やツールで実際に到達できる対象の違いです。両者のずれを明記することは、報告書の弱点ではなく強みになります。
- サンプリングフレーム:抽出の元になるリストや仕組み。学生名簿、患者名簿、顧客データベース、村の世帯リスト、選挙人名簿などです。フレームの問題はカバレッジ誤差を生み、どの方法でもそれを修復することはできません。
- 抽出単位:実際に選ばれるもの。人、世帯、診療所、クラス、勤務シフト、注文などです。クラスター抽出や多段抽出の設計では、第1段階の単位は集団であり、その集団は第一次抽出単位と呼ばれます。
- サンプリング設計:書き出した計画の全体。フレーム、方法、単位の数、連絡の取り方、そして回答しない人への対応です。審査員や査読者がサンプリングについて尋ねるとき、実際に求めているのはこの「サンプリング設計」です。
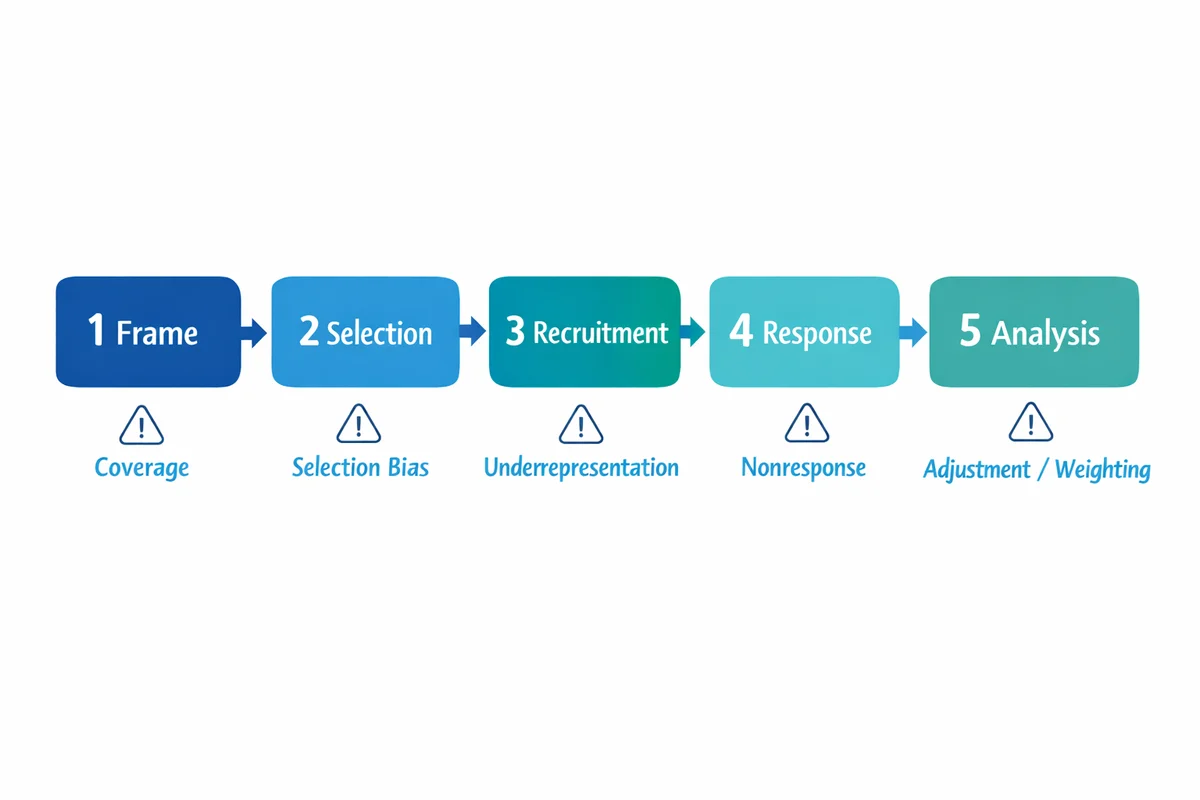
教科書どおりの無作為抽出を行っても、偏ったサンプルに終わることがあります。フレームからある層が漏れていれば、その人たちはそもそも抽出される資格がありませんでした。ある層が回答しなければ、その人たちは抽出された後に脱落します。サンプリングは連鎖として扱いましょう。フレーム、選定、募集、回答、分析の順です。
同じ考え方を短く公式に定義したものとしては、米国研究公正局(U.S. Office of Research Integrity)のサンプリングに関する研修資料をご覧ください。1サンプリングをより大きな研究計画の中に位置づける場合は、アンケート調査の設計のガイドでその前後の手順を解説しています。
そもそもなぜサンプリングするのか、全数調査のほうがよいのはどんなときか
サンプリングが必要な理由は、統計的である前に実務的なものです。繰り返し挙がる理由が4つあります。
コスト
回答者が1人増えるごとに、費用、スタッフの時間、あるいは相手の好意が消費されます。適切に抽出した600人のサンプルは、まずい進め方をした60,000人規模の調査と同じ問いに答えられます。
スピード
意思決定には期限があります。サンプルなら、答えがまだ役に立つ期間内に答えが得られます。
実現可能性
そもそも数え上げられない母集団もあります。市場の通行人、サービスの利用をやめた人、インフォーマルな商人などです。事実上無限の母集団や、単位を測定するとその単位が壊れてしまう場合もあります。
品質
これは意外に思われるかもしれません。より小さな集団に労力を集中すれば、非回答者への働きかけ、調査員の十分な訓練、データの点検ができます。通常は、単位の数よりも単位あたりの労力のほうが価値があります。
一方、全数調査は全員を測定します。母集団が到達できるほど小さい場合、連絡先がすでにそろっている場合、あるいは全員に尋ねられる権利がある場合には、全数調査のほうが適しています。200人規模の組織での従業員アンケートは、サンプリングではなく全数調査の問題です。授業評価も同様です。母集団が小さいとき、サンプリングで得られるものはほとんどなく、チーム別に報告する能力を失うことになります。
よいサンプルとは実際にどのようなものか
教科書はよいサンプルを「代表的」と表現しますが、これは実務で使える判定基準ではありません。判定基準になるのは次の4つの性質です。
- カバレッジ:目標母集団の全員が、原理的には選ばれ得たこと。
- 管理された選定:誰がサンプルに入るかを、自ら名乗り出た人や入口の近くにいた人ではなく、ルールで決めていること。
- 報告が必要な最小の集団に十分な単位があること:全体の数字が十分に見えても、本当に関心のある集団の結果がわずか11件の回答に基づいていることがあります。
- 記述できること:どのように抽出したかを正確に書き出せて、ほかの人が再現できること。
| 目的 | サンプリングへの影響 | よくある落とし穴 |
|---|---|---|
| 母集団の割合を推定する | 確率抽出法を使い、誰が回答したかを記録し、数値とあわせて精度を報告します。 | 便宜的サンプルを、母集団を表すものとして扱うこと。 |
| サブグループを比較する | サブグループごとの回答数を計画します。通常は層化し、小さな集団をオーバーサンプリングします。 | ごく少数の人に基づく結果をサブグループの結果として報告すること。 |
| 経験やメカニズムを探る | 目的的な選定や理論的な選定が適しています。どの視点を含め、どの視点を含めていないかの根拠を示します。 | 根拠のない数値上の最低ラインを追い求めること。 |
| 介入の効果を検証する | サンプリングは、結果を誰に一般化できるかを左右します。無作為割付は、効果が本物かどうかを左右します。 | 無作為割付と無作為抽出を混同すること。この2つは別の操作です。 |
サンプルがどのように母集団推定を支えるかをわかりやすく説明したものとしては、米国国勢調査局(U.S. Census Bureau)による調査サンプリングと推論の概説が出発点として適しています。2
サンプリングフレームが上限を決める
サンプリングフレームとは、抽出の元になる具体的なリストや仕組みです。サンプリングの中で最も議論されることが少なく、実際の研究の多くが気づかないうちにつまずく箇所でもあります。そもそも誰が選ばれる資格を持つかを、フレームが決めるからです。
フレームはありふれたものです。学生名簿、患者名簿、人事の名簿、顧客データベース。世帯数つきの村のリスト、選挙人名簿、一連の注文、地区内の診療所のリスト。人を並べたフレームもあれば、場所を並べたフレームもあることに注目してください。この違いによって、使える方法が決まります。
| 問題 | どのように現れるか | 結果への影響 |
|---|---|---|
| カバレッジ不足 | 母集団の人がリストから漏れている:業務用メールアドレスを持たないスタッフ、店頭で購入した顧客、住所が登録されていない世帯など。 | ある層全体が選ばれる確率がゼロになります。漏れている人はそもそも抽出の対象外だったため、回答を増やしても解決できません。 |
| 過剰カバレッジ | リストに母集団外の単位が含まれている:卒業生や退学者、閉鎖済みのアカウント、転居した人など。 | 労力が無駄になり、除外しなければ、間違った母集団を測定することになります。 |
| 重複 | 同じ人が複数回載っている:メールアドレスが2つある、アカウント番号が2つあるなど。 | その人たちはほかの全員より選ばれる確率が高くなり、等確率の前提が気づかないうちに崩れます。 |
| 情報の古さ | リストは作成時には正確でしたが、今はそうではありません。 | 届かなかった連絡が回答拒否のように見えるため、回答率とバイアスの診断の両方が誤ったものになります。 |
フレームの点検は抽出の後ではなく、前に行いましょう。行数を数えます。その数を、人事の在籍者数や在籍学生数など、入手できる独立した合計と比べます。漏れていたら最も困る層を探し、含まれていることを確認します。重複を除きます。フレームから除外されるものを書き出しておきましょう。その一文は、いずれにしても研究の限界の項に入るものだからです。
便宜的抽出法、割当抽出法、目的的抽出法、スノーボール・サンプリングには、リストがまったく必要ありません。クラスター抽出法と多段抽出法に必要なのは、人のリストではなく集団(学校、診療所、病棟、村)のリストだけです。単純無作為抽出法、系統抽出法、層化抽出法は、いずれも始める前に個人の完全なリストが必要です。リストがなく作ることもできないなら、その事実だけで、このページの9つの方法のうち3つが使えなくなります。通常、最初に決着をつけるべきなのはこの点です。
9つのサンプリング方法の比較
サンプリング方法は2つの系統に分かれます。確率抽出法は無作為な仕組みを使うため、フレーム内のすべての単位が選ばれる確率は既知で、ゼロではありません。非確率抽出法はそうではないため、選ばれる確率は不明です。それ以外のことはすべて、この1つの違いから導かれます。
2列目は多くのガイドが省いている列なので、ここでは最初に置いています。許容誤差、信頼区間、あるいは「プラスマイナス5ポイント」という一文の根拠になるのは、確率的な設計だけです。そこで「いいえ」となっている方法からも多くを学べます。ただ、結果とあわせて精度の数値を公表することはできません。精度そのものは別の話題であり、サンプルサイズのガイドで取り上げています。
| 方法 | 許容誤差を示せるか | 仕組み | 適しているとき | コストと招きやすいバイアス |
|---|---|---|---|---|
| 単純無作為抽出法 確率 完全なリストが必要 |
はい | リスト上のすべての単位が等しい確率を持ちます。必要な数を無作為に抽出します。 | 重複を除いた整ったリストが1つあり、別々に報告しなければならないサブグループがないとき。 | コスト完全なリストが必要で、小さな集団は報告できないほど少なくなることがあります。バイアス選定の段階ではごくわずかです。残るリスクはすべて、実際に誰が回答するかに移ります。 |
| 系統抽出法 確率 完全なリストが必要 |
はい(リストの並び順が結果と無関係な場合) | リストを並べ替え、無作為に開始点を選び、そこからk件ごとに記録を取ります。 | リストが長い、または順次届く形式で、現場のチームが従う単純なルールが1つ必要なとき。 | コスト並び順が測定内容と無関係である限り、ほぼかかりません。バイアス周期性。リストが抽出間隔と重なる周期で繰り返していると、同じ種類の単位ばかりを引き続けます。 |
| 層化抽出法 確率 完全なリストが必要 |
はい。通常は単純無作為抽出法より精度が高くなります | リストを重要な集団(層)に分け、各集団の中で抽出します。 | 地域、学部、部署、年齢層ごとに報告する必要があるとき、または集団間で回答が大きく異なると予想されるとき。 | コスト抽出前に、グループ分けに使う変数がリストに載っている必要があり、抽出率が異なる場合は分析時にウェイト付けが必要です。バイアス低い。本当のリスクは結果と無関係な層を選ぶことで、手間が増えるだけで精度は上がりません。 |
| クラスター抽出法 確率 集団のリストが必要 |
はい。デザイン効果の分だけ広がります | 集団(学校、診療所、病棟、村)を丸ごと無作為に選び、選ばれた集団の中の全員を調査します。 | 個人のリストは作れないが、その人たちがいる場所のリストは作れるとき、そして移動費や準備費が予算の大半を占めるとき。 | コスト精度。同じ集団の中の人は互いに似ているため、回答が1件増えても新しい情報は少なくなります。バイアス集団を無作為に選べば低くなりますが、集団の数が少ないと結果が不安定になり、根拠を示しにくくなります。 |
| 多段抽出法 確率 集団のリストが必要 |
はい。ウェイトとデザイン効果を用います | まず集団を抽出し、次に選ばれた集団の中で単位を抽出します。これを2段階以上で行います。 | 人の統一リストは存在しないが行政単位はある、地区全体や全国規模の調査。 | コスト複雑さ。単位ごとに選ばれる確率が異なるため、分析にはウェイトと、それを適用できる人が必要です。バイアス原理的には低い。実際には、各段階が現場のチームが計画からずれる新たな機会になります。 |
| 便宜的抽出法 非確率 リスト不要 |
いいえ | 最も到達しやすい人を対象にします。ウェブサイトのポップアップ、自分が教えているクラス、売り場の前を通る人などです。機会抽出法とも呼ばれます。 | 探索的な段階にあるとき、調査票のパイロット調査を行うとき、あるいは来四半期に根拠ある数値を出すより今週中に方向性が欲しいとき。 | コスト主張できること。母集団について何かを述べる能力を手放すことになります。バイアス自己選択。到達しやすい人、都合のつく人、すでに関心の高い人が過大に代表されます。 |
| 割当抽出法 非確率 リスト不要 |
いいえ。無作為ではないのに、バランスが取れているように見えます | 集団ごとに目標数を決め(例えば女性50人と男性50人、農村部40人と都市部60人)、すべての目標数が埋まるまで募集します。 | 抽出元のリストがない中で、少なくとも目に見える特性では母集団と一致するサンプルを素早く必要とするとき。 | コスト各割当枠を誰が埋めるかの管理。募集担当者が選ぶことに変わりはなく、声をかけやすい人を選びます。バイアス割当枠内の選択バイアス。年齢と性別を合わせても、態度の面で典型的な人になるわけではありません。 |
| 目的的抽出法 非確率 リスト不要 |
いいえ。そもそもそれを目指していません | 明示した基準に合うケースを意図的に選びます。専門家、極端なケース、典型的なケース、決定的なケースなどです。判断抽出法とも呼ばれます。 | 質的研究、専門家インタビュー、事例研究など、数えることより深さが重要なあらゆる問い。 | コストなし。ただし、最初から数えることを目的としていなかったと明確にしておくことが条件です。バイアス誰が関連性のある対象かについての、研究者自身の考え方。 |
| スノーボール・サンプリング 非確率 リスト不要 |
いいえ | 少数の参加者を募集し、それぞれに基準に合うほかの人を紹介してもらいます。 | 対象集団が見えにくい、偏見の対象になっている、まれである、または登録されていないとき:移民労働者、サービスの利用をやめた人、インフォーマルな商人、まれな疾患を持つ人など。 | コスト時間と、サンプルの構成に対する管理。最初に選んだ人の人間関係のネットワークをそのまま引き継ぐことになります。バイアス同類性。人は自分に似た人を紹介するため、母集団の一角が過大に抽出されます。 |
表の読み方:最初の5つの方法は確率的な設計で、最後の4つはそうではありません。精度の数値が誠実かどうかを決めるのは、個々の方法の名前ではなく、この1つの区分です。
確率抽出法を一つずつ解説
確率抽出法とは、フレーム内のすべての単位が選ばれる確率が既知でゼロではなく、無作為な仕組みによって選定が行われることを意味します。母集団について数値で何かを述べるための根拠は、すべてここにあります。実際の研究のほとんどは5つの設計でカバーできます。臨床研究や保健研究のレビューも同じ系統を少し異なる名前で扱っており、両方に出会う前にその理由を知っておく価値があります。ここで引用している2つのレビューはいずれも、多段抽出法を別項目として挙げず、クラスター抽出法の中に含めています。34
単純無作為抽出法
単純無作為抽出法では、リスト上のすべての単位が選ばれる確率がまったく同じになります。リストに番号を振り、乱数を生成し、その番号に当たった単位を選びます。
具体例。ある大学の学籍簿に在籍学生が12,000人いて、400件の回答が必要だとします。学籍簿に1から12,000まで番号を振り、表計算ソフトや統計パッケージでその範囲から重複しない乱数を400個生成し、該当する学生を招待します。回答率を40パーセントと見込むなら、1,000人を抽出して招待すれば、400件の完了回答が現実的になります。
うまくいかない場合。学生数12,000人の学籍簿から400件の回答を得る場合、学生数300人の学部からは約10人しか含まれません。これでは報告できません。結果にいずれかのサブグループを示す必要があるなら、単純無作為抽出法は適さず、層化抽出法で解決します。
無作為化の手順を記録しましょう。使用したソフトウェア、シード値(あれば)、日付です。この一文で抽出が再現可能になり、査読者は実際にこれを求めます。
系統抽出法
系統抽出法では、並べたリストから無作為な開始点の後、k件ごとに単位を取ります。リストの件数を必要な数で割って間隔kを求め、1からkまでの間で無作為に開始点を選び、そこから数え進めます。
具体例。ある地区病院では四半期に9,000件の外来受診があり、600件の退出時インタビューを行いたいとします。間隔は9,000を600で割ったもので、kは15になります。1から15の間で無作為に開始点を選び、例えば7なら、7件目、22件目、37件目、52件目…とインタビューします。現場のチームはノートパソコンなしでこのルールに従えます。この方法が今も使われている本当の理由はそこにあります。
うまくいかない場合。周期性です。リストにkと重なる繰り返しの周期があると、毎回同じ位置を抽出してしまいます。診療日順に並んだ受診リストに7日周期があり、間隔が7なら、特定の1曜日だけが選ばれ、ほかは何も選ばれません。kを決める前に並び順を確認し、並び順が測定内容と関係している場合はリストをシャッフルしましょう。
層化抽出法
層化抽出法では、母集団を層と呼ばれる重なりのない集団に分け、各層の中で無作為サンプルを抽出します。報告が必要な各集団が確実にサンプルに含まれるため、ほとんどの研究にとって最も役立つ改善策です。
計算過程つきの具体例。ある組織には6つの州にまたがって4,200人のスタッフがおり、600件の回答が必要です。
- 比例配分。スタッフ1,400人の州は、1,400を4,200で割った値、つまり全従業員の3分の1を占めるので、600の3分の1にあたる200件の回答を割り当てます。スタッフ210人の州には、210を4,200で割って600を掛けた30件を割り当てます。どの州も規模に比例して代表され、分析時のウェイト付けは不要です。
- 非比例配分(オーバーサンプリングとも呼ばれます)。30件の回答では、その小さな州を個別に報告するには少なすぎます。そこで、代わりにその州から意図的に80件を取り、埋め合わせとして最大の州の件数を減らします。これで州ごとに選ばれる確率が異なるため、組織全体の数値を示す前に、データにウェイトを付けて実際の比率に戻す必要があります。この手順を省くことが、層化抽出法で最もよくある誤りです。
層の選び方。結果や回答しそうな人と関係があり、すでにフレームに含まれている変数を選びます。地域、拠点、役職、勤続年数の区分、コース、プランの種類、年齢層がよくある候補です。結果と無関係な層は事務作業を増やすだけで、精度は上がりません。グループ分けに使う変数がフレームにない場合は、代わりに調査票の中で収集する必要があるかもしれません。回答者を失わずにそうした変数を尋ねる方法は、属性質問のガイドで解説しています。
クラスター抽出法
クラスター抽出法では、自然に存在する集団を丸ごと無作為に選び、選ばれた集団の中の全員を調査します。必要なのは人のリストではなく集団のリストであり、この方法が存在する理由はそこにあります。
具体例。ある地区には小学校が180校あり、児童の統一リストはありません。無作為に24校を選び、各校の8年生の児童全員を調査します。学校訪問は180校ではなく24校で済み、始めるにあたって児童の名簿は一度も必要ありませんでした。
その代償。同じ学校の児童は、地区全体の児童よりも互いに似ています。そのため、すでに選んだ学校の児童が1人増えても、独立した児童1人ほどの新しい情報は加わりません。実質的な回答数は、実際の回答数より少なくなります。この膨らみがデザイン効果であり、分析の段階で気づくのではなく、計画に組み込んでおく必要があります。
うまくいかない場合。クラスターが少なすぎることです。無作為に選んだ6校は互いに大きく異なることがあり、結果はたまたまどの6校を引いたかで大きく揺れます。1つあたりの人数を減らしてクラスターを増やすほうが、その逆よりほぼ常によい結果になります。
多段抽出法
多段抽出法では、2段階以上で選びます。まず集団を、次に選ばれた集団の中の単位を、場合によってはさらにその中で3段階目を選びます。世界のほぼすべての全国世帯調査がこの方法で設計されています。
具体例。全国の区のリストから120区を選びます。選ばれた各区で、現場のチームが現地で世帯をリスト化し、その中から20世帯を無作為に選びます。選ばれた各世帯では、玄関に出た人に任せるのではなく、成人1人を無作為に選びます。これで3段階になり、最後の段階が重要です。誰が回答するかを世帯に決めさせると、この設計が避けようとしていた選択バイアスがそのまま戻ってしまいます。
その代償。人によって選ばれる確率が異なるため、分析にはウェイトが必要であり、分散の計算では各段階のクラスター化を考慮しなければなりません。これは本格的な設計であり、ウェイト付き分析を実行できる人が必要です。プロジェクトにそれができる人がいないなら、ウェイトなしの多段抽出ではなく、より単純な設計を選びましょう。
専門的な解説:確率比例抽出と、大きなクラスターが選ばれやすい理由
学校の例では、児童が60人でも900人でも、どの学校も選ばれる確率は同じでした。そのため、小さな学校の児童は大きな学校の児童よりもサンプルに入る確率がはるかに高くなります。その場合、分析でそれを補正しなければなりません。
確率比例抽出は、これを設計の段階で解決します。各クラスターが選ばれる確率を、そのクラスターに含まれる単位の数に比例させます。すると、児童900人の学校は児童60人の学校より15倍選ばれやすくなります。そのうえで、選ばれたすべての学校から同じ人数の児童を選びます。2つの段階が相殺し合い、地区内のすべての児童が全体としてほぼ同じ確率で選ばれることになります。全国調査では標準的な方法であり、抽出前にフレーム上のすべてのクラスターについて規模の尺度が必要です。
層化抽出法とクラスター抽出法:違いをひと言で
この2つはどちらも母集団を集団に分けることから始まるため、いつも混同されます。違いはその次に何をするかです。
| 観点 | 層化抽出法 | クラスター抽出法 |
|---|---|---|
| どの集団を使うか | すべての集団から抽出します。 | 一部の集団を選び、残りはまったく使いません。 |
| 集団の中で誰を抽出するか | 集団の中から無作為に選んだ一部。 | 集団の全員。多段抽出の場合は、さらに無作為に選んだ一部。 |
| 集団に求められる性質 | 内部は似ていて、集団同士は異なること。地域、役職、コースなど。 | 内部が多様で、それぞれが母集団の縮図であること。学校、診療所、病棟など。 |
| 選ぶ理由 | 精度と、サブグループが確実に代表されること。 | 個人のリストがないときのコストと到達しやすさ。 |
| 精度への影響 | 同じ回答数なら、通常は単純無作為抽出法より精度が上がります。 | 精度が下がります。デザイン効果を見込んでおきましょう。 |
| 始める前に必要なもの | グループ分けに使う変数がすでに載っている、個人の完全なリスト。 | 集団のリストだけ。 |
層化抽出:すべての集団から、一部の人を。クラスター抽出:一部の集団から、すべての人を。層化抽出は正確さのため、クラスター抽出は到達しやすさのためです。
非確率抽出法を一つずつ解説
非確率抽出法とは、誰が選ばれるかを無作為な仕組みが決めていないため、選ばれる確率が不明であることを意味します。これが正しい選択となる状況は4つあります。使えるフレームが作れないとき。対象集団が見えにくいとき。精度よりスピードが重要なとき。あるいは、問いが規模ではなく意味に関するものであるときです。
これらの方法は二流ではありません。別の問いに答えているのです。失敗とは、これらを使うことではなく、使ったうえで確率サンプルでなければ裏づけられない一文を書いてしまうことです。
便宜的抽出法
便宜的抽出法は機会抽出法とも呼ばれ、最も到達しやすい人を募集します。ウェブサイトのポップアップ、ニュースレターのリンク、自分のクラスの学生、市場の売り場の前を通る人などです。
例。ある店がレシートにフィードバック用のリンクを載せたとします。回答する人は全員、何かを購入し、スマートフォンを持っていて、時間があり、わざわざ答える理由があった人です。こうしたふるいの一つひとつが、顧客層の異なる部分を取り除いています。
誠実な使い方。調査票のパイロット調査、仮説の生成、顧客が使う言葉の把握、質問が理解されるかの確認。どれも優れた使い方です。いずれも母集団推定を必要としません。
割当抽出法
割当抽出法では、指定した集団ごとに募集の目標数を決め、それを埋めます。農村部40人と都市部60人。女性50人と男性50人。5つの年齢層それぞれに20人などです。
例。ある市場調査チームが、年齢、性別、地域の構成が全国と一致する500件の回答を必要としていますが、母集団のリストはありません。チームは各セルが埋まるまで募集します。
それでも確率抽出法ではない理由。割当が管理するのはサンプルの構成であって、その中の人の選定ではありません。募集する人が選ぶことに変わりはなく、声をかけやすい人とそうでない人は系統的に異なります。サンプルが年齢と性別で母集団と完全に一致していても、態度については大きく外れることがあります。結果をゆがめていたのは、そもそも年齢と性別ではなかったからです。
目的的抽出法
目的的抽出法は判断抽出法とも呼ばれ、明示した基準を満たすケースを意図的に選びます。よくある種類として、典型ケース、極端ケース、決定的ケース、最大多様性、専門家の選定があります。
例。新しい決済システムの使われ方を調べる研究で8人を選びます。毎日使う人2人、使うのをやめた人2人、一度も使い始めなかった人2人、苦情に対応するサポートスタッフ2人です。この広がりは意図して選んだものであり、その理由づけこそが方法です。
誠実な使い方。ほとんどの質的研究です。ここでの基準は無作為性ではありません。ほかのケースではなくなぜこのケースなのかを説明できるか、そして主張を裏づけるのに十分なほど幅広い見方を含んでいるかです。
スノーボール・サンプリング
スノーボール・サンプリングでは、少数の参加者を募集し、その人たちに基準に合うほかの人を紹介してもらい、紹介された人がさらに別の人を紹介します。
例。国境を越えて取引するインフォーマルな商人の研究で、地元の協会を通じて特定した4人の参加者から始め、それぞれが2人ずつ紹介します。インフォーマルな商人の名簿は存在しないため、フレームに基づく方法は使えません。
サンプルへの影響。同類性です。人は自分に似た人を紹介します。サンプルは1つの人間関係のネットワークに偏り、母集団の中で孤立した人から離れていきます。研究が最も声を聞く必要があるのは、多くの場合そうした人たちです。1人ではなく、互いにつながりのない複数の起点から始めれば偏りは減りますが、なくなりはしません。
非確率サンプルの妥当性を説明できるようにするには
多くのガイドは「一般化はできません」で終わり、読者を置き去りにします。しかし読者の多くが行っているのは、まさにこの種の研究です。ここでは、たいてい抜け落ちている部分を説明します。
- 方法の名前だけでなく、募集の方法を記述しましょう。リンクをどこに掲載したか、どの期間か、誰が見たか、謝礼を提示したか、何人に声をかけ何人が回答したか。これがあれば、読者は推測ではなくサンプルを評価できます。
- 得られたサンプルを既知の基準値と比較し、その比較を公表しましょう。組織の60パーセントが現場スタッフなのに回答者の25パーセントしか現場スタッフでないなら、表にしてそう書きます。明示された偏りは知見です。隠れた偏りは欠陥です。
- ウェイト付けでできることとできないことを知っておきましょう。属性が母集団と一致するようにデータを調整すれば、目に見える偏りは補正できます。しかし、測定しなかった何かの点で回答者と異なる人については補正できず、非確率サンプルを精度の主張を裏づけるサンプルに変えることも決してできません。
- 統計ではなく、文章を変えましょう。「顧客の38パーセントが不満を持っている(プラスマイナス4ポイント)」ではなく、「回答した顧客620人のうち38パーセントが不満を報告しました。回答者はアプリ内の案内で2週間にわたって募集したもので、顧客の無作為サンプルではありません」と書きます。2つ目の文章のほうが短く、役に立ち、反論の余地がありません。
質的研究には、このための独自の用語があります。研究計画書では通常、数値目標ではなく根拠が求められます。そこでは想定する人数と見方の幅の両方に触れるべきであり、その区別はバース大学(University of Bath)のガイドが簡潔に述べています。5
状況に方法を当てはめる
6つの状況と6つの方法。答えを開く前に決めてください。上の表が本当に理解できたかを確かめる最も早い方法です。
1. 4,200人の完全なスタッフ名簿があり、6つの州それぞれについて結果を公表しなければならない。
層化抽出法。完全なリストがあるので確率抽出法が使え、州ごとに報告する義務こそ層化の目的そのものです。単純無作為抽出法では、最も小さな州の回答が少なすぎて報告できなくなります。
2. 6か月前にサービスの利用をやめた人を調査する。リストはなく、最も強い不満を抱いてやめた人ほど見つけにくい。
スノーボール・サンプリング。フレームが存在せず、母集団に到達しにくいため、確率抽出法はすべて使えません。1人ではなく、互いにつながりのない複数の起点から始め、紹介の連鎖によってサンプルがつながりのある人に偏ることを研究の限界に明記しましょう。
3. ある病院が、四半期に9,000件ある受診の流れから患者体験のデータを集めたい。収集するのは、受付にコンピューターのないスタッフ。
系統抽出法。母集団が順番に流れてくるため、間隔のルールは確率抽出法であると同時に、忙しい受付でも実際に実行できるものです。まず、受診の順番が抽出間隔と一致する週単位の周期に従っていないかを確認しましょう。
4. 新しいツールが使われなくなっている理由を理解する必要があり、期間は3週間、予算はない。
目的的抽出法。問いは規模ではなく、メカニズムに関するものです。ヘビーユーザー、使うのをやめた人、使い始めなかった人、サポートスタッフと、範囲全体から意図的に選びます。ここからパーセンテージを報告してはいけません。
5. ある地区に学校が180校あり、児童名簿はなく、移動予算でまかなえる訪問は約25校分。
クラスター抽出法。児童のリストはなくても学校のリストはあり、移動費が決定的な制約です。報告する区間をデザイン効果の分だけ広げ、1校あたりの児童を減らして学校を増やすほうを、その逆より優先しましょう。
6. 全国の年齢・地域の構成に合った500件の回答を5日間で集めなければならず、母集団のリストはない。
割当抽出法。少なくとも目に見える特性で母集団と一致するサンプルを得る最も早い方法です。それでも確率サンプルではないので、構成を報告し、精度の主張はしないでおきましょう。
サンプリング方法の選び方
多くの研究が失敗するのは、名前のついた手法の選択を誤ったからではありません。手法がフレーム、意思決定、または現場のチームが現実に実行できることに合っていなかったからです。ほぼ毎回、3つの問いで決着がつきます。
あなたの研究に合う方法は?
3つの問いに答えてください。おすすめが下に表示され、比較表の該当する行が強調表示されます。
示すべき主張から始める
何かを選ぶ前に、公表したい文章を書きましょう。「当社の顧客の62パーセントが当社を推薦する」と「離れていく顧客は3つの繰り返し起こる問題を挙げている」は、異なる設計を必要とする異なる文章です。結果を母集団の数値として扱う人がいないなら、思っているよりはるかに自由に選べます。
確定する前にフレームを点検する
母集団、またはそれに近い代わりのものを実際にリスト化できますか?できないなら、その人たちが属する集団をリスト化できますか?この1つの問いに答えるだけで、9つの方法のほとんどがすぐに除外されます。だからこれは最後ではなく2番目に置いています。
報告が必要なサブグループを明示する
地域、拠点、役職ごとに結果を示す必要があるなら、それが層や割当を通じて設計を左右します。各集団で必要な回答数も左右します。これを実査の後に決めても、取り返しはつきません。
設計を現場の現実と照らし合わせる
時間、予算、連絡の取りやすさ、言語面のアクセス、読み書きの能力、通信環境、謝礼の方針によって、何が実行可能かが決まります。現場のチームが従えない設計は、正式な名前がついただけの便宜的抽出法になり、正直に便宜的抽出法を選ぶより悪い結果になります。誰も取り残さない募集計画を立てれば、系統的な過少代表を減らせます。6サンプルを選んだら、オンラインアンケート作成ツールで調査票を準備し、サンプリング計画で選んだ人に送りましょう。誰でも開ける公開リンクを共有すると、回答できる人が変わってしまいます。無作為サンプルは保たれません。
サンプルが実際にゆがむポイント:カバレッジ、選定、非回答
選定は誰もが心配する部分ですが、最も問題が起こりにくい部分です。問題が生じるのはたいてい選定の前、つまりフレームの段階か、選定の後、つまり誰がわざわざ回答するかの段階です。どちらも、きれいに見える表計算シートと誤った結論を生み出します。
| 誤差 | どのように現れるか | 減らし方 |
|---|---|---|
| カバレッジ誤差(フレームの問題) | 一部の人がまったく選ばれ得ない:業務用メールアドレスがない、名簿が古い、店頭でしか購入しない顧客、通信環境のない世帯など。 | フレームを改善するか、組み合わせます。紙、対面、電話、SMSと調査方法を追加します。誰が除外されているかを正確に記録します。 |
| 選択バイアス(手順の問題) | 無作為のルールが実際には守られない。先着順にする。管理職が参加者を指名する。 | 抽出を自動化します。選ぶ人と募集する人を分けます。すべての例外を点検します。 |
| 非回答バイアス(結果の問題) | 選ばれた人が回答せず、回答しない人と回答する人とで、測定している事柄が異なる。 | 連絡の方法と調査票の体験を改善したうえで、回答者を既知の基準値と比較します。回答バイアスをご覧ください。 |
| 測定誤差 | 質問が誘導的、曖昧、またはダブルバーレル(一度に2つを尋ねる)であるため、完璧なサンプルでも無意味な結果になる。 | 実施前に調査票をテストします。よくある欠点はアンケートの質問の書き方のガイドで解説しています。 |
最も有名なサンプリングの失敗は、回答者が240万人いた
1936年、Literary Digest誌は、アルフ・ランドンが約55パーセントの票を獲得すると予測しました。実際にはフランクリン・ルーズベルトが約61パーセントを得て勝ちました。7同誌は1,000万枚の投票用紙を郵送し、約240万枚の返送を得ていました。回答率24パーセントは、今日の全国世論調査のどれも遠く及ばない水準です。8250万人というサンプルに基づきながら、この調査はルーズベルトの得票率を実際より20ポイント低く見積もりました。
サンプリングを扱うすべてのページに載せるべき数字。後年の再分析で、Digest誌の州別推定値のサンプリングによる許容誤差が計算されました。その範囲は0.18から2.3パーセントポイントで、中央値は0.6でした。8プラスマイナス0.5ポイントという精度の数値が、20ポイントの誤差の上に乗っていたのです。許容誤差が測っているのは、アンケートが間違い得るいくつもの道筋のうちの1つにすぎないことを、これほど明快に示す例はありません。
しかも、定番の説明は半分しか正しくありません。Digest誌は裕福で共和党寄りの自動車所有者と電話加入者を抽出した、と誰もが教わります。この主張を実証的に検証した研究の1つは、1937年5月のギャラップ調査を用いました。自動車と電話の両方を所有する人でさえ、55対45でルーズベルト支持でした。Digest誌の投票用紙を受け取ったと答えた人全体では、ルーズベルトが55対44でリードしていました。フレームは共和党寄りでしたが、ランドンの圧勝を生むほどではまったくありませんでした。7
欠けている半分は非回答です。投票用紙を返送したと答えた人の中では、ランドンが51対48でリードしていました。返送しなかった人の中では、ルーズベルトが69対30でリードしていました。大まかに分解すると、誤差のうち約11ポイントがフレームに、約7ポイントが回答傾向の差による非回答に帰せられます。7Digest誌がすでに尋ねていた質問、つまり1932年にどう投票したかで返送分にウェイトを付けていれば、1936年当時に使えた計算だけで正しい勝者を導けたはずです。8
高い回答率は、思っているほど目指すべき目標ではない
ピュー・リサーチ・センター(Pew Research Center)自身の電話調査の回答率は、1997年の36パーセントから2012年には9パーセントに、2018年には6パーセントに低下しました。9一方、対面で実施されたインドの全国家族健康調査(National Family Health Survey)では、664,972世帯を選び、そのうち653,144世帯に人が住んでいることを確認しました。そのうち636,699世帯にインタビューし、回答率は97.5パーセントでした。この分母は注意して読んでください。回答率が誤りやすいのは、まさにここだからです。居住世帯数ではなく選んだ世帯数を分母にすると、同じ実査が95.7パーセントになります。この調査は、全707県にわたる30,456のクラスターからサンプルを抽出しました。10
この2つの事実は同じ10年の間のことです。回答率を左右するのは、アンケート疲れについての全般的な主張よりも、調査方法と実査にかける労力のほうがはるかに大きいのです。平均回答率は何パーセントだと1つの数字で示すガイドがあれば、それは実在する量を説明していません。
ここからが、より厳しい知見です。30の公表研究から得た235件の非回答バイアス推定値のメタ分析では、回答率と非回答バイアスの大きさの相関は0.33でした。これを2乗すると、回答率で説明できるのはバイアスのばらつきの約11パーセントということになります。11非回答バイアスを測るために特に設計された59件の研究を対象とした追跡研究も、同じ結論に達しました。12
回答率は報告する価値があり、改善する価値もあります。しかし、品質の証明書ではありません。バイアスの原因になるのは、回答する傾向が測定する事柄と結びついているかどうかです。ボランティア活動についてのアンケートは、ブロードバンドの速度についてのアンケートよりはるかにその影響を受けます。追うべきはパーセンテージではなく、相関です。
回答を増やしても、壊れたフレームは修復できない
2021年のワクチン接種の展開期に、2つの非常に大規模なアンケートが米国のワクチン接種率を追跡しました。1つは毎週約250,000件の回答を集め、1回目の接種率を公式の基準値より17パーセントポイント高く見積もりました。もう1つは2週間ごとに約75,000件を集め、14パーセントポイント高く見積もりました。標準的な確率抽出の手法で実施された約1,000人の3つ目のアンケートは、信頼できる推定値を出しました。13
同じパターンは、通常のアンケート業務にも現れます。3つの確率パネルと3つのオンライン公募型の情報源を、28の基準値と29,937件のインタビューで比較したところ、平均絶対誤差は公募型サンプルで5.8パーセントポイント、確率パネルで2.6パーセントポイントでした。そのうちサブグループについて利用できた25の基準値では、18歳から29歳の成人での差は11.2対3.6でした。14
そして印象的な診断例があります。ある公募型アンケートでは、30歳未満の成人の12パーセントが、原子力潜水艦を操縦する資格を持っていると答えました。15実際の数値はほぼゼロです。パネルがこのような結果を出せるなら、どんな結果でも出せます。同じパネルに大量に発注しても、同じものをより多く買うだけです。
米国と英国以外で、フレームから漏れる人
サンプリングのガイドの多くは、暗黙のうちに欧米型のフレーム、つまりメールリスト、固定電話、全国住所登録を前提にしています。世界の多くの地域ではそのようにサンプリングしておらず、カバレッジの欠落には測定された形があります。
- 低・中所得国でのオンラインアンケートは、その国のネットにつながっている部分のサンプルであり、その部分は男性に偏っています。低・中所得国の女性がモバイルインターネットを利用する割合は男性より14パーセント低く、オンラインの女性は男性より約2億3,500万人少ない計算になります。16
- 電話サンプルでは世帯主が過大に代表されます。アフリカ4か国での世界銀行の電話調査では、回答者の男性比率はウガンダで52パーセント、ナイジェリアで73パーセントでした。成人人口ではおよそ半分です。ウガンダでは電話回答者のうち15歳から24歳は6パーセントでしたが、成人人口では38パーセントでした。17
- その対策。1つの調査方法に固執せず、複数を組み合わせます。登録簿がない地域では現地で世帯をリスト化します。母集団が実際に読む言語で実施し、翻訳は逆翻訳で済ませずにプリテストで確認します。そのうえで残る欠落を研究の限界に明記しましょう。それでも欠落は残るからです。
ウェイト付けで直せること、直せないこと
ウェイト付けは、サンプルの構成が既知の母集団の数値と一致するようにデータを調整します。本当に強力な手法ですが、日常的に過大評価されています。
有効だという根拠。2016年、ニューハンプシャー大学(University of New Hampshire)の最終世論調査では、クリントンが11ポイントリードしていましたが、実際の差は0.4ポイントでした。この調査は学歴による調整をしていませんでした。検証委員会は、この1つの調整だけで誤差は実質的にすべてなくなっていたと結論づけました。18回答と結果の両方に相関する1つの変数が、すべてを担っていたのです。
頼りすぎてはいけない根拠。30,000件を超えるオンライン公募型インタビューを24の基準値で評価したところ、ウェイトなしの平均推定バイアスは8.4パーセントポイントでした。高度なマッチング手法を含め、検証したどのウェイト付けの手順でも、平均バイアスを6ポイント未満に下げることはできませんでした。19サンプルサイズを4倍にしても、改善はさらに0.2ポイントにとどまりました。
ここから導かれるルールは単純です。ウェイト付けは、ウェイトに使った変数の偏りを、その変数が結果と関係している範囲で補正します。測定しなかった事柄で回答者と非回答者が異なる点には何の効果もなく、非確率サンプルを精度の主張を裏づけるサンプルに変えることも決してありません。
精度の数値は上限ではなく下限
許容誤差が数値化するのはサンプリングによるばらつきだけです。サンプルが目標母集団から無作為に抽出され、残るバイアスが取り除かれていることを前提としています。カバレッジ誤差、非回答バイアス、測定誤差、不正な回答者は、すべてその範囲外です。
証拠は明白です。2020年の最後の2週間に、州レベルの大統領選世論調査348件が許容誤差を報告しており、報告された数値の平均は3.9ポイントでした。その平均を基準にすると、55パーセントが最終的な得票差を許容誤差1つ分以上外し、21パーセントが2つ分以上外していました。20いずれも最新の手法を使った最近の世論調査です。許容誤差は不確実性の上限ではなく、常に下限として扱いましょう。
| 主張 | 数値 | 等級 | 出典 |
|---|---|---|---|
| 回答率は非回答バイアスをほとんど予測しない | r = 0.33、つまりばらつきの約11%(30研究の235件の推定値) | A | Groves, 200611 |
| 非常に大規模なアンケートでも大きく外れることがある | 毎週約250,000件の回答に基づき、ワクチン接種率を17ポイント高く見積もった | A | Bradleyほか, 202113 |
| 公募型サンプルは確率パネルのおよそ2倍不正確 | 28の基準値での平均誤差は5.8対2.6パーセントポイント | A | MercerとLau, 202314 |
| ウェイト付けは公募型サンプルを改善するが、救いはしない | ウェイトなしで8.4ポイント、6.0ポイント未満になった手法はなし | A | Mercer、Lau、Kennedy, 201819 |
| 許容誤差は実際の世論調査の誤差を過小に示す | 2020年の州レベル世論調査348件の55%が、報告された許容誤差の平均3.9ポイントを超えて外れた | A | AAPORタスクフォース, 202120 |
| Literary Digest誌のフレームによる説明は不完全 | 自動車と電話の所有者でも、55対45でルーズベルト支持だった | B | Squire, 19887 |
等級Aは、公的統計、メタ分析、または再現された知見を意味します。等級Bは、結論がまだ独立に再現されていない1件の有力な研究を意味します。
「回答率50パーセントで十分、60で良好、70で非常に良好」裏づけるデータのない教科書的な経験則です。同じ分野でも権威によって50、60、80と異なります。バイアスは率ではなく、回答することと回答内容との相関で決まります。
「中心極限定理が働き始めるので、30あれば十分」30という数字を導く根拠はありません。対称的な結果なら近似ははるかに少ない数でも成り立ち、偏った結果やまれな事象なら30を大きく上回っても成り立ちません。
「アンケートの平均回答率は33パーセント」ほぼ同じ文言でベンダーのブログに出回っていますが、一次資料はありません。調査方法、実施主体、母集団、謝礼の影響は、全体の平均をはるかに上回ります。
「人間の集中力の持続時間は今や8秒で、金魚より短い」出典をたどると2015年のマーケティング報告書に行き着き、その報告書が引用した企業は出典を示せませんでした。元の研究は8秒にも金魚にも一切触れていません。
デザイン効果:クラスターサンプルにより多くの人が必要な理由
ほとんどのガイドは、コスト削減を理由にクラスター抽出法を勧めてそこで終わります。削減は本物ですが、その代償も本物です。同じ学校、診療所、病棟、店舗の中の人は互いに似ています。母集団全体から無作為に選んだ人同士よりも似ているのです。そのため、すでに選んだ集団からの回答が1件増えても、新しい情報は少なくなります。
これを測る数値がデザイン効果です。言葉で言えば、同じ人数を独立に抽出した場合と比べて、不確実性がどれだけ広がるかを示します。集団の大きさがそろった設計では、次のとおりです。
デザイン効果 = 1 + (集団の平均サイズ - 1) x 級内相関
級内相関とは、測定している事柄について、集団の中の人がどれだけ似ているかを示す値です。0なら、同じ学校にいることは児童の回答について何も教えてくれません。1なら、学校の全員がまったく同じ回答をし、その学校は1人の人間と変わりません。実際の値は小さいものの、集団の大きさが大きくなると、小さな値でも結果に大きく影響します。48の全国世帯調査をまとめると、級内相関の平均は約0.06です。値は測定する内容によって異なります。全国の数値では、出生力の項目は約0.01から0.03、現在の避妊法の使用は0.03から0.05、医療者の介助による出産は0.22にも達します。21
自前の推定値がない場合は、既定値を慎重に借りましょう。DHSのサンプリングマニュアルでは、調査に独自の数値がない場合、deftの代替値として1.5を用います。22deftは上の式のデザイン効果と同じ量ではありません。deftは2つの標準誤差の比であり、デザイン効果は2つの分散の比です。deftを2乗するので、deftが1.5ならデザイン効果は2.25になります。マニュアルはこの値を典型的な値ではなく代替値と呼んでおり、マニュアル自身の計算例では、近代的避妊法の使用に1.40、子どものワクチン接種に1.22を用いています。
| 設計 | デザイン効果 | 実質的な回答数 | 実際の意味 |
|---|---|---|---|
| 独立した選定、クラスター化なし | 1.00 | 960 | すべての回答が1件分の価値を持ちます。 |
| 40人ずつの24集団、ICC 0.02 | 1.78 | 539 | 960件分の費用を払い、主張できる精度は539件分です。 |
| 40人ずつの24集団、ICC 0.05 | 2.95 | 325 | 実査の3分の2は、精度を何も上乗せしませんでした。 |
| 40人ずつの24集団、ICC 0.10 | 4.90 | 196 | この設計は、大規模研究の予算をまとった小規模研究に、いつの間にかなってしまっています。 |
ウェイト付けにも独自の効果があります。ある地域をオーバーサンプリングし、その後ウェイトで元に戻す全国調査には、2つのデザイン効果が同時に生じます。ウェイト付けの効果1.22とクラスター化の効果1.80で、全体のデザイン効果は2.20になります。つまり、インタビューした5,000世帯は独立した2,277世帯と同じ働きしかしません。23
設計上の教訓。1つあたりの人数を減らして集団を増やすほうが、集団を減らして1つあたりの人数を増やすより、ほぼ毎回優れています。児童24人ずつの40校と児童40人ずつの24校は、どちらもほぼ同じ960件の回答の費用がかかりますが、前者のほうがデザイン効果が小さく、根拠のある結果になります。全体で必要な回答数を計画する場合は、サンプルサイズのガイドで計算してから、デザイン効果を掛けましょう。逆の順序で進めると、クラスター化した研究は検出力不足に陥ります。
最初から最後まで追う3つの具体例
方法の名前は簡単です。研究が実際につまずくのは、その周辺の判断です。この3つの例では、母集団の定義から公表できる文章まで、実際の設計を一通り追います。
例1:地区全体の患者体験
- 母集団。4月1日から6月30日までの間に、地区内の公立診療所46か所のいずれかで外来診察を受けた成人。
- フレーム。地区全体の患者名簿は存在しません。46か所の診療所のリストは月ごとの受診者数つきで存在します。
- 方法。多段抽出。受診者数に比例した確率で18か所の診療所を選び、無作為に選んだ2日間の診療日に、診療所を出る患者を8人目ごとに系統抽出します。
- もっと単純な方法にしない理由。患者の完全なリストがあれば層化抽出法が使えますが、リストは存在せず、期限内に作ることもできません。最大の3か所の診療所で便宜的サンプルを取ればより早く済みますが、それが表すのは最大の3か所の診療所だけです。
- 報告が必要なこと。診療所の規模によって選ばれる確率が異なるため、分析にはウェイトが必要であり、区間はデザイン効果の分だけ広げる必要があります。
- 公表できる文章。「第2四半期に地区の公立外来診療所を受診した成人のうち、推定71パーセントが待ち時間を許容範囲と評価しました。受診者数に比例した確率で選んだ18か所の診療所での1,240件の退出時インタビューに基づきます。」
例2:学生の母集団を対象とした学位論文の研究
- 母集団。今年度に商学部に在籍する学生:3学年で3,100人。
- フレーム。学年と課程が記載された学部の在籍者名簿。
- 方法。学年による層化無作為抽出、比例配分、目標は完了回答350件。
- 計算。1年生は1,300人で、3,100人の42パーセントなので、350件の42パーセントにあたる147件の回答を割り当てます。各学年で同様に計算します。比例配分なので、ウェイト付けは不要です。
- 回答の計画。回答率を35パーセントと見込むなら、350件の完了回答を得るにはおよそ1,000人の学生を招待する必要があります。また、層ごとに招待しましょう。そうすれば、ある学年の回答が低調なとき、まだ手を打てる時間のうちに気づけます。
- 明記すべき限界。退学したのに名簿に残っている学生は過剰カバレッジです。名簿を抽出した後に入学した学生はカバレッジ不足です。どちらも限界の段落に記載します。
例3:オンラインストアの顧客フィードバック
- 母集団。過去90日間に注文を完了した顧客。
- フレーム。注文テーブル。オンライン注文についても、ゲスト購入についても完全ですが、アカウントを2つ持つ顧客は2回載っています。
- 方法。顧客1人につき1行になるよう重複を除き、無作為な開始点の後、12人目ごとの顧客を系統抽出します。1回にまとめてではなく、継続的に実施します。
- これで避けられる落とし穴。ニュースレターの購読者だけを招待するほうが早いですが、それは最も熱心な顧客の便宜的サンプルです。満足度は実際より高く見え、それは毎四半期、確実にそうなります。
- 従業員についての注意。同じ組織が自社のスタッフ180人を調査する場合は、サンプリングすべきではありません。その母集団は小さく、到達可能で、全員に尋ねられる権利があります。全数調査を行い、参加が少なければ、それをサンプリングの問題ではなく知見として扱いましょう。
研究方法のサンプリングの部分の書き方
これは多くのガイドが省く手順ですが、指導教員、査読者、クライアントが実際に読むのはここです。サンプリングの記述では、5つの問いに順番に答える必要があります。誰を、どのリストから、どのように選び、何件で、その結果何を主張してよいのか、です。
下の空欄を埋めてください。あえて平易にしています。審査員がここで求めているのは美しい文章ではなく、評価できる設計です。
同じ研究の、弱い書き方とよい書き方
弱い例。「学生の無作為サンプルを抽出し、350件の回答を集めた。」
ここには確認できることが何もありません。「無作為」という言葉が根拠なしに重みを担わされており、フレームも、分母も、誰が除外されたかの記述もありません。
よい例。「目標母集団は、2026年に商学部に在籍する学生3,100人とした。サンプリングフレームは、2026年3月3日に抽出した学部の在籍者名簿である。各学年を別々に報告できるよう、学年による比例配分の層化無作為抽出を用いた。1,000人の学生を招待し、350人が調査票に回答を完了した。回答率は35パーセントである。比例配分のため、ウェイト付けは行っていない。抽出日以降に退学した学生はフレームに残り、特定できなかったが、これは過剰カバレッジの軽微な原因である。」
2つ目のほうが長いですが、追加した一文一文が、査読者がもう尋ねなくてよい一文になっています。
「参加者は2週間にわたりアクティブユーザーに表示したアプリ内の案内によって募集した。これは便宜的サンプルであるため、知見は回答した人を表すものであってユーザー全体に一般化することはできず、精度の数値は報告していない。回答者はユーザー全体と比べて毎日利用するユーザーである割合が高く、結果を読む際にはこの点を考慮すべきである。」こう書けば、誰もあなたが過大な主張をしているとは言えません。実際、していないのですから。
サンプリング計画チェックリスト
サンプリング計画を書面にしておけば、避けられる誤りのほとんどを防げます。判断を分析中ではなく実査の前に下さざるを得なくなるからです。8項目、1ページです。
- 1. 研究の目的。どのような意思決定を支えるのか、そして正確には何を報告するのか。
- 2. 目標母集団。期間を含め、誰が対象で誰が対象外か。
- 3. サンプリングフレーム。出所、抽出日、行数、既知の欠落、重複除去のルール。
- 4. 方法と理由。9つのうちどれか、そしてフレームと主張を踏まえてなぜそれなのか。
- 5. 目標数。全体とサブグループごとの完了回答数、そして計画の前提とする見込み回答率。
- 6. 募集計画。調査方法、リマインダーの予定、言語とアクセシビリティへの配慮、謝礼の方針。
- 7. モニタリング。実査中に注視すること:層ごとの回答、離脱箇所、項目無回答。
- 8. 分析の注意点。予定しているウェイト付け、デザイン効果による調整、そして何があっても開示する限界。
計画が固まったら、サンプルを抽出した価値があったかどうかは調査票で決まります。完璧なサンプルでも、誘導的な質問やダブルバーレル質問は救えません。実施する前にアンケートの質問例に目を通しておく価値があります。
よくある質問
調査におけるサンプリングとは?
サンプリングとは、母集団の一部(サンプル)を選び出し、その一部を調べることで母集団全体について結論を導く手続きです。母集団の全員を測定するのは多くの場合、時間がかかりすぎる、費用がかかりすぎる、または不可能であるために用いられます。サンプルを選ぶ方法によって、結果がどのような結論を裏づけられるかが決まります。
母集団とサンプルの違いは?
母集団は記述したい集団全体です。サンプルは実際に測定する、より小さな一部です。サンプリングは一方から他方へ移る手続きであり、全数調査は、その代わりに母集団全体を測定する方法です。
サンプリングフレームとは?
サンプリングフレームとは、サンプルを抽出する元になる実際のリストや仕組みです。学生名簿、患者名簿、顧客データベース、世帯リスト、選挙人名簿などです。フレームは方法の名前より重要です。フレームから漏れている人は、サンプリングの手法がどれほど優れていても、選ばれる確率がゼロだからです。
サンプリングフレームが不要なサンプリング方法は?
便宜的抽出法、割当抽出法、目的的抽出法、スノーボール・サンプリングには、リストがまったく必要ありません。クラスター抽出法と多段抽出法に必要なのは、個人のリストではなく、学校、診療所、村などの集団のリストだけです。単純無作為抽出法、系統抽出法、層化抽出法は、いずれも始める前に個人の完全なリストが必要です。
確率抽出法と非確率抽出法の違いは?
確率抽出法では無作為な仕組みが選定を行うため、すべての単位が選ばれる確率は既知でゼロではなく、推定値がどれだけ不確実かを計算できます。非確率抽出法では、選定が手近さ、割当、または研究者の判断に左右されるため、その確率は不明です。実務上の帰結として、母集団推定について精度の数値を示せるのは確率的な設計だけです。
層化抽出法とクラスター抽出法の違いは?
層化抽出法は、母集団を集団に分け、すべての集団から無作為サンプルを取ります。これにより精度が上がり、各集団が確実に含まれます。クラスター抽出法は、一部の集団を無作為に選び、選ばれた集団の中の全員を調査します。個人のリストがない場合にコストを抑えられます。要するに、層化抽出はすべての集団から一部の人を、クラスター抽出は一部の集団からすべての人を使います。
第一次抽出単位とは?
第一次抽出単位とは、多段抽出の設計の第1段階で選ばれるもののことです。全国世帯調査では、通常は区、村、国勢調査の調査区などの地域です。その後、第2段階でその中から世帯を選びます。クラスター化した設計を報告する際には、第一次抽出単位を明記するのが標準的な要件です。それによって生じるクラスター化を分析に反映させる必要があるからです。
層化無作為抽出法とは?
層化無作為抽出法は、母集団を層と呼ばれる重なりのない集団に分け、各層の中で独立に無作為サンプルを抽出します。比例配分では、各層に母集団での割合と一致する割合のサンプルを割り当て、ウェイト付けは不要です。非比例配分では、小さいが重要な層を意図的にオーバーサンプリングし、その後、全体の数値を報告する前にウェイト付けが必要になります。
スノーボール・サンプリングは学術研究で妥当ですか?
はい。母集団が見えにくい、まれである、または登録されておらず、サンプリングフレームを作れない場合には妥当です。到達しにくい集団に対して認められた手法です。ただし、母集団推定の根拠にはなりません。主な弱点は、参加者が自分に似た人を紹介するため、サンプルが1つの人間関係のネットワークに偏ることです。互いにつながりのない複数の起点から始めればその偏りは減るので、研究方法の中で記述すべきです。
無作為抽出と無作為割付は同じですか?
いいえ。無作為抽出は母集団から参加者を選ぶ方法であり、知見を誰に一般化できるかを左右します。無作為割付は、選ばれた参加者を実験の条件に割り振る方法であり、観察された効果を処置によるものとみなせるかどうかを左右します。研究では一方だけを使うこともでき、ほとんどの実験は無作為抽出なしで無作為割付を用いています。
量的研究で非確率抽出法を使えますか?
はい。公表されている量的研究の多くがそうしています。変わるのは、主張してよいことです。サンプル内の件数、パーセンテージ、関係を報告でき、サンプル内の集団を比較することもできます。しかし、そうしたパーセンテージを、精度を明示した母集団の推定値として示すことはできません。方法を明記し、募集の方法を記述し、既知の基準値があれば回答者と比較し、誰にも尋ねられないことを期待するのではなく、限界をはっきり書きましょう。
サンプリングと標本分布の違いは?
サンプリングはサンプルを選ぶ手続きです。標本分布は別の考え方です。同じサンプリングの手続きを何度も繰り返すことを想像してください。そうして想像したすべてのサンプルにわたって、平均値やパーセンテージなどの統計量がどう散らばるか、それが標本分布です。標本分布があるからこそ信頼区間が成り立ち、それが予測どおりにふるまうのは、サンプルが確率抽出法で抽出された場合だけです。
サンプルが偏っているかどうかは、どうすればわかりますか?
得られたサンプルを、名簿、在籍記録、行政データなどの既知の基準値と、測定している事柄に関係する変数で比較します。大きな差があれば、カバレッジの問題、選定の問題、または回答傾向の差による非回答が考えられます。募集経路やリマインダーの回ごとにも比較しましょう。十分な回答率は、バイアスが低いことの弱い証拠にしかならない点に注意してください。公表された235件の推定値では、回答率で説明できたのは非回答バイアスのばらつきの約11パーセントにすぎませんでした。
関連記事
サンプリングは、より大きな研究の中の1つの判断です。以下のガイドでは、その前後の判断を取り上げています。
- アンケート調査の設計では、母集団の定義から実施まで、サンプリングを研究のほかの部分とつなげて順に解説しています。
- サンプルサイズの決め方では、このページがあえて扱わなかった精度の計算を、式も含めて解説しています。
- アンケートの質問の書き方では、どのようなサンプリング設計でも救えない測定の側面を解説しています。
- 調査票設計の原則では、質問ができた後に調査票全体をどう組み立てるかを解説しています。
- 回答バイアスでは、選んだ人と回答した人の違いをさらに詳しく解説しています。
- 属性質問は、層化に必要な変数がフレームにない場合に役立ちます。
- 統計的有意性では、サンプルが集まった後に数値をどう扱うかを解説しています。
- 量的データ分析では、ウェイトをどこで使うかを含め、その後の分析の手順を解説しています。
このガイドの作成方法と、扱っていない内容
執筆者。Michael Hodge。SuperSurveyでアンケートの方法論、質問設計、データ品質に携わり、ガイドとヘルプの実用ガイドを執筆しています。
根拠。定義は、下記に引用した方法論のレビューと大学の研究ガイダンスに従っています。専門用語が実際に定義されているのはそこです。公的な研究公正機関や統計局のページは、平易な入門資料として挙げているものであり、定義の出典ではありません。方法の説明も同じレビューとガイダンスに従っています。根拠のセクションの数値はすべて、下記に名前を挙げた一次資料に基づいています。各主張には確度の等級も付けているので、どの知見が確立されていて、どれが1件の研究に基づくものかがわかります。グラフと表のデザイン効果の数値は当社による計算です。標準的な式を用い、前提はキャプションに記載しているので、ご自身のクラスターの大きさで計算し直したり、検討し直したりできます。
扱っていない内容。このガイドは、アンケートと観察研究のためのサンプリングを扱っています。実験計画や無作為割付については、区別を示す以上には扱っていません。同じ言葉を別の意味で使う、受入検査、監査、信号処理のためのサンプリングも扱っていません。回答者駆動型サンプリング、時間・場所サンプリング、適応型クラスター抽出法は、専門家が見えにくい母集団に用いる実在の手法ですが、ここでは範囲外です。級内相関の数値は、低・中所得国の世帯調査によるものです。別の状況にそのまま持ち込む値ではなく、説明用の例として扱ってください。
数値の根拠が最も弱いところ。Literary Digest誌の再分析は、1937年の1件の調査と後年の1件の再分析に基づいており、どちらの著者も自らの不確実性を指摘しています。そのため等級Bとしています。世論調査の誤差の数値は米国の選挙世論調査によるもので、これは異例なほどよく研究されており、アンケートの誤差全般を必ずしも代表するものではありません。
開示事項。SuperSurveyはアンケートソフトウェアを販売しています。このページで販売しているものはなく、どの部分にも登録は不要です。また、このガイドはどの組織からも資金提供やレビューを受けていません。当社のページにリンクしているのは、次の判断を扱っているからであって、リンクによって何かを得るためではありません。
参考文献
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., and Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- UK Government (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., and Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., and Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences and ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., and Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., and Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., and Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., and Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, pages 9 and 15.(数値は2025年版によるものです。GSMAはその後、差が縮小した2026年版を公表しています。)
- Brubaker, J., Kilic, T., and Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., and others (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., and Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., and Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, page 9 and Table 1.2.
- Kalton, G., Brick, J. M., and Le, T. (2005). Estimating components of design effects for use in sample design. In Household Sample Surveys in Developing and Transition Countries, Chapter VI. United Nations, Series F No. 96.