
De steekproefgrootte van een enquête is het aantal volledige reacties dat in uw analyse wordt meegenomen, geschreven als n. Dat is iets anders dan het aantal uitnodigingen of het aantal mensen op uw lijst. Onder de steekproefaannames van de calculator maakt een grotere steekproef de foutmarge kleiner; ze neemt geen vertekende werving of slecht geformuleerde vragen weg.
Calculator voor de steekproefgrootte
Er zit niets achter een registratie en er wordt niets verstuurd. De calculator draait in uw browser, begint met een uitgewerkt antwoord dat al op het scherm staat, en toont de formule en de berekening die hij gebruikte, zodat u die kunt controleren of met de hand kunt nadoen.
Hoeveel reacties heb ik nodig?
Stel uw zes invoerwaarden in. Het antwoord, de formule en de berekening worden bijgewerkt terwijl u typt.
Volledige reacties die u nodig hebt
370
Na de eindigepopulatiecorrectie.
Uit te nodigen mensen
1,234
Bij een responspercentage van 30 procent.
Steekproeffractie
3.7%
Aandeel van de populatie van wie u een reactie nodig hebt.
Totaal, berekend per subgroep
370
De berekening, stap voor stap
| Foutmarge | Benodigde reacties | Benodigde uitnodigingen |
|---|
Meer precisie kost reacties met ongeveer het kwadraat van de verbetering. Een halvering van de foutmarge maakt de steekproef ongeveer vier keer zo groot.
De kopieerknop schrijft een korte methodeparagraaf met uw getallen, de formule en de bronvermelding, klaar om in een projectplan of methodologiehoofdstuk te plakken.
Deze calculator citeren: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Het resultaat is het aantal volledige reacties, niet het aantal uitnodigingen. Het is het aantal dat u aan het eind van het veldwerk binnen moet hebben. Het aantal uitnodigingen is dat getal gedeeld door het responspercentage dat u verwacht, en daar gaan de meeste steekproefplannen mis. Zodra het doel vastligt, maakt u uw enquête en test u die in een pilotonderzoek bij de beoogde doelgroep. Gebruik het pilotonderzoek om de formulering te controleren en de verhouding tussen uitnodigingen en voltooide enquêtes voor uw eigen project te schatten.
Wat steekproefgrootte betekent
De steekproefgrootte is het aantal mensen dat uw enquête invult. Ze wordt in elke formule op deze pagina geschreven als n, ze is de enige grootheid die u met veldwerk koopt in plaats van op papier kiest, en ze is het getal waaruit uw foutmarge wordt berekend.
Drie aantallen worden ermee verward, en die uit elkaar houden is het grootste deel van wat een steekproefplan doet:
- Populatie (N): iedereen die u wilt beschrijven. Een klantenlijst, een personeelsbestand, een land.
- Uitnodigingen: hoeveel mensen u benadert. Altijd meer dan n, omdat niet iedereen antwoordt.
- Steekproefgrootte (n): hoeveel volledige reacties u hebt wanneer het veldwerk eindigt. Dit is het getal dat de formule berekent, en het enige van de drie dat uw foutmarge verandert.
Steekproefgrootte koopt precisie: de breedte van de band van plus of min rond elk resultaat. Ze koopt geen juistheid: of de mensen die antwoordden lijken op de mensen die dat niet deden. Een grote gemakssteekproef kan verder van de waarheid liggen dan een kleine aselecte steekproef, en geen enkele waarde van n herstelt dat. Waar het plannen van de steekproefgrootte misgaat behandelt het verschil, en hoe u de steekproef trekt geeft de doorslag.
Het korte antwoord, als u alleen een getal wilt
Kerncijfers
- 385 volledige reacties is het standaardantwoord. Dat geeft de formule bij een betrouwbaarheidsniveau van 95 procent, een foutmarge van plus of min 5 procentpunt en geen eerdere schatting van het resultaat.
- Kleine populaties hebben veel minder nodig. Een lijst van 1.000 mensen heeft er 278 nodig. Een lijst van 100 heeft er 80 nodig. Dat is het effect van de eindigepopulatiecorrectie.
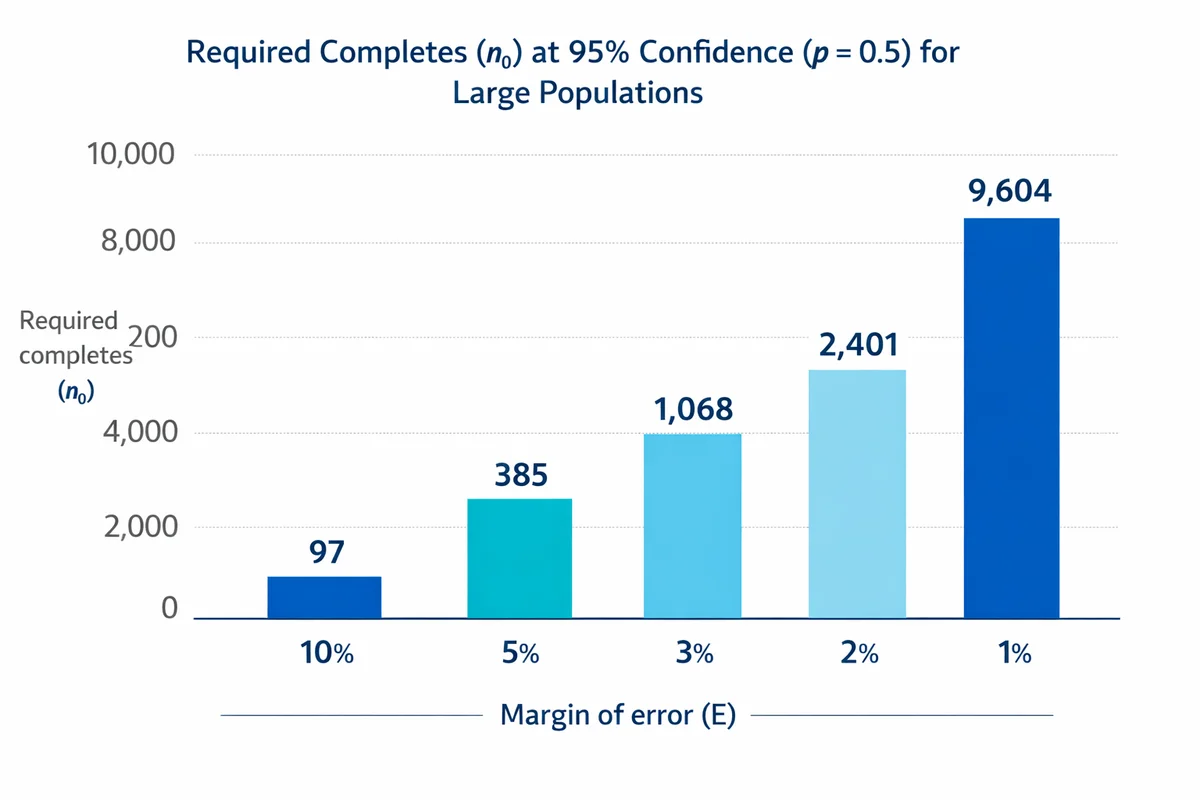
- Precisie is duur. Een halvering van de foutmarge maakt de steekproef ongeveer vier keer zo groot. Wie van plus of min 5 punten naar plus of min 1 punt gaat, komt van 385 op 9.604 uit.
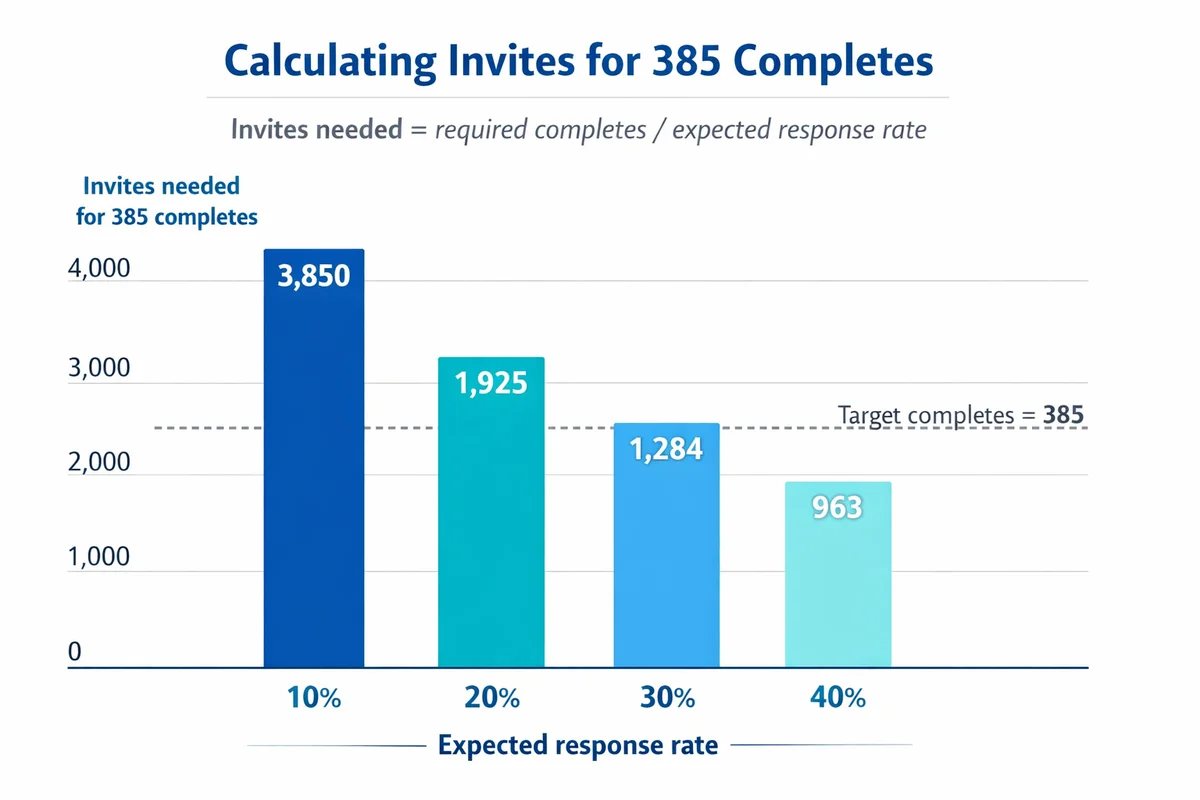
- Formules tellen volledige reacties, geen uitnodigingen. Het aantal benodigde uitnodigingen is het aantal volledige reacties gedeeld door uw verwachte responspercentage. Bij 30 procent betekenen 385 volledige reacties dat u 1.284 mensen uitnodigt.
- De foutmarge dekt één soort fout. Ze meet de ruis die ontstaat doordat u een deel van de mensen bevraagt in plaats van iedereen. Ze zegt niets over de mensen die nooit hebben geantwoord.
De formule voor de steekproefgrootte, en hoe u die met de hand uitrekent
Voor een enquête die een percentage rapporteert, is het standaardvertrekpunt de steekproefgrootte voor een populatie die groot genoeg is om als onbeperkt te behandelen:
n0 = (z^2 x p x (1 - p)) / E^2
Van links naar rechts gelezen:
- n0 is het benodigde aantal volledige reacties, vóór een populatiecorrectie.
- z is de z-score voor uw betrouwbaarheidsniveau. Gebruik 1,96 voor 95 procent.
- p is de proportie die u verwacht te meten, als decimaal getal. Gebruik 0,5 als u het niet weet.
- E is de foutmarge als decimaal getal. Vijf procentpunt is 0,05.
Het symbool voor de steekproefgrootte is n. Sommige bronnen schrijven het ongecorrigeerde getal als n0 en het gecorrigeerde als n; die notatie wordt hier gebruikt.
| Betrouwbaarheidsniveau | z | Wat het u kost |
|---|---|---|
| 80 procent | 1.282 | 165 volledige reacties bij plus of min 5 punten |
| 90 procent | 1.645 | 271 volledige reacties |
| 95 procent (standaard) | 1.960 | 385 volledige reacties |
| 99 procent | 2.576 | 664 volledige reacties |
| 99,9 procent | 3.291 | 1.084 volledige reacties |
Uitgewerkt voorbeeld: van 385 naar een uitnodigingslijst
Scenario. U wilt weten welk percentage van uw klanten u bij anderen zou aanbevelen. U wilt een betrouwbaarheidsniveau van 95 procent en plus of min 5 punten. U hebt geen eerdere schatting, dus p = 0,5.
Kies uw betrouwbaarheidsniveau en foutmarge
Een betrouwbaarheidsniveau van 95 procent geeft z = 1,96. Plus of min 5 procentpunt is E = 0,05.
Kies een verwacht resultaat
p = 0,5, omdat er geen eerdere schatting is en 0,5 de grootste steekproef oplevert. Niets wat u later te weten komt, kan u dan tekort laten komen.
Pas de formule voor de steekproefgrootte toe
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Rond naar boven af: 385 volledige reacties. Rond altijd naar boven af. U kunt geen deel van een enquête verzamelen.
Corrigeer voor een kleine populatie
Als die klanten een lijst van 1.000 vormen in plaats van een open markt, pas dan de correctie toe: n = 384,16 / (1 + 383,16 / 1.000) = 384,16 / 1,38316 = 277,7, dus 278 volledige reacties. De correctie maakt pas verschil zodra de steekproef een groot deel van de populatie is.
Zet volledige reacties om in uitnodigingen
Bij een responspercentage van 30 procent is het aantal uitnodigingen = 278 / 0,30 = 926,7, dus nodig 927 mensen uit. Volledige reacties zijn wat de formule berekent. Uitnodigingen zijn wat u daadwerkelijk verstuurt, en dat aantal kan nooit groter zijn dan de populatie waaruit u trekt.
Bij een betrouwbaarheidsniveau van 95 procent en p = 0,5 komt de hele formule neer op 0,9604 gedeeld door E in het kwadraat. Die ene vuistregel beantwoordt de meeste vragen over steekproefgrootte in één regel, en daarom duikt 385 steeds op in steekproeftabellen die u elders vindt.
Tabel met steekproefgroottes voor gangbare populatiegroottes
Deze cijfers zijn berekend met de formule hierboven bij een betrouwbaarheidsniveau van 95 procent, plus of min 5 punten en p = 0,5, en daarna gecorrigeerd voor de populatie. De laatste twee kolommen zijn onze eigen controle tegen de tabel die Krejcie en Morgan in 1970 publiceerden, de tabel die de meeste methodologiehoofdstukken citeren.
| Populatie (N) | Benodigde reacties | Krejcie en Morgan (1970) | Verschil |
|---|---|---|---|
| 10 | 10 | 10 | gelijk |
| 25 | 24 | niet vermeld | |
| 50 | 45 | 44 | 1 meer |
| 100 | 80 | 80 | gelijk |
| 200 | 132 | 132 | gelijk |
| 500 | 218 | 217 | 1 meer |
| 1,000 | 278 | 278 | gelijk |
| 2,000 | 323 | 322 | 1 meer |
| 5,000 | 357 | 357 | gelijk |
| 10,000 | 370 | 370 | gelijk |
| 50,000 | 382 | 381 | 1 meer |
| 100,000 | 383 | 384 | 1 minder |
Hoe we het hebben gecontroleerd. We hebben de formule toegepast op 21 populatiegroottes en elk resultaat vergeleken met de gepubliceerde waarde van Krejcie en Morgan. Twaalf kwamen precies overeen. De andere negen verschilden met precies één reactie, wat komt door de plek waar elke methode afrondt, niet door onenigheid over de berekening. Als een begeleider vraagt waarom uw getal één afwijkt van de tabel, is dit de reden.
Goed om te weten als u die tabel citeert: Krejcie en Morgan hebben hun formule niet zelf afgeleid. Hun artikel uit 1970 telt ongeveer 400 woorden plus één tabel, en de enige bronvermelding schrijft de formule toe aan een onderzoeksbulletin uit 1960 van de National Education Association. Hun eigen samenvatting van het patroon is nog steeds de beste beschrijving in één regel: naarmate de populatie groeit, neemt de benodigde steekproef steeds minder snel toe en stabiliseert ze op iets meer dan 380 gevallen.
Uw invoer kiezen, één voor één
Vier getallen bepalen het antwoord. Drie daarvan zijn beslissingen, geen feiten, en voor elk ervan is er een verdedigbare manier om het te kiezen.
Betrouwbaarheidsniveau: hoe vaak de methode klopt
Het betrouwbaarheidsniveau beschrijft de methode, niet deze specifieke enquête. Bij een betrouwbaarheidsniveau van 95 procent bevatten intervallen die op deze manier zijn opgebouwd op de lange termijn 95 van de 100 keer de werkelijke waarde. Het is geen kans van 95 procent dat uw specifieke antwoord juist is.
Gebruik 95 procent, tenzij u een reden hebt om dat niet te doen. Naar 99 procent gaan verhoogt de steekproef van 385 naar 664 bij dezelfde precisie: een kostenstijging van 72 procent voor heel weinig winst. Het verwante begrip bij het toetsen van hypothesen is alfa, en daarom halen mensen de twee door elkaar. Als dat onderscheid vaag is, lees dan statistische significantie en wat p-waarden betekenen voordat u een getal kiest.
Foutmarge: de beslisvariabele
Hier moet u het langst over nadenken, want dit is de enige invoer die de steekproef aan een beslissing koppelt. Kies haar door u af te vragen welk verschil zou veranderen wat u doet.
Als u anders handelt wanneer de tevredenheid 72 procent is in plaats van 74 procent, hebt u een kleine marge nodig. Als u pas handelt bij 72 tegenover 82, is plus of min 5 punten ruim voldoende. Brede hoofdrapportages komen meestal uit op 5 punten voor een snelle pulsmeting of 3 punten voor een trendmeting. Onder de 2 punten lopen de kosten snel op.
Populatiegrootte: meestal onbelangrijk, tot ze dat niet meer is
Bij grote populaties verandert de benodigde steekproef nauwelijks. Tienduizend mensen hebben 370 reacties nodig. Honderdduizend hebben er 383 nodig. De populatiegrootte maakt pas verschil wanneer uw steekproef er een flink deel van is, zoals bij personeelslijsten, ledenregisters en schooljaargangen. Dat behandelt het volgende onderdeel.
Verwacht resultaat (p): gebruik 0,5 als u het niet weet
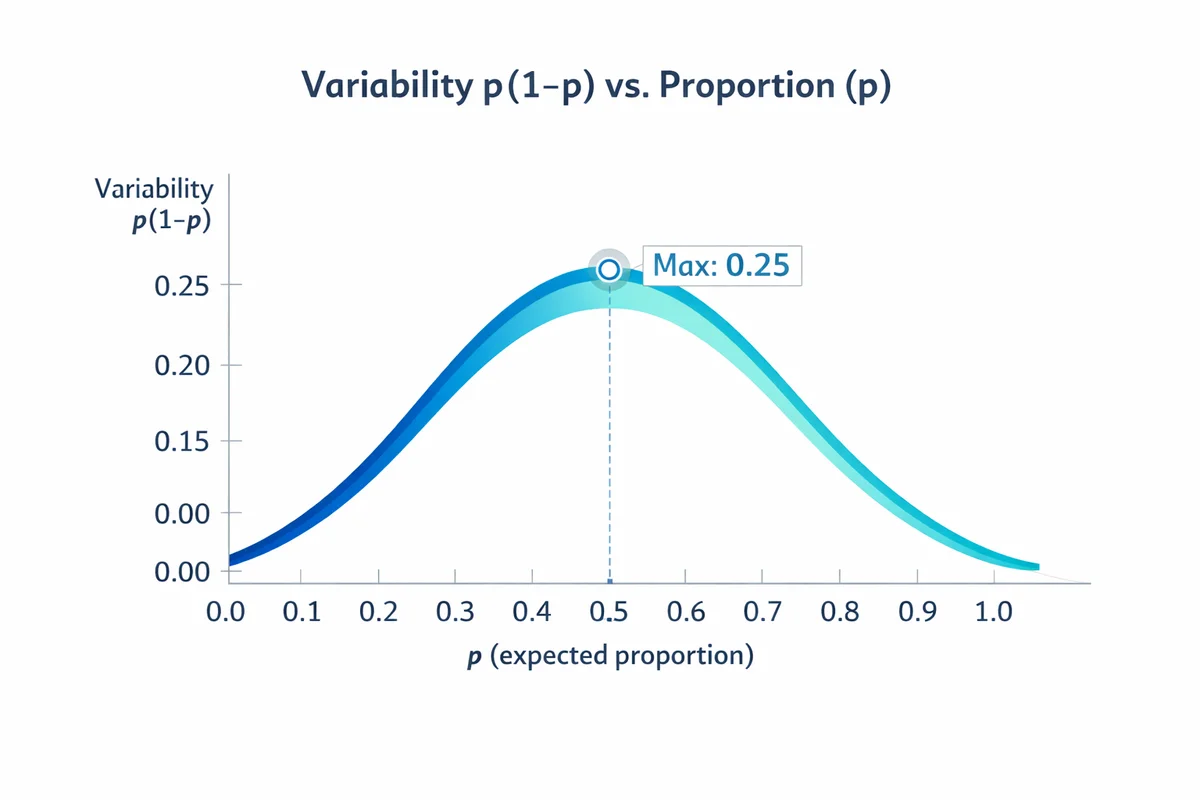
Bij een vraag naar een percentage wordt de onzekerheid bepaald door p maal (1 min p). Die term is het grootst bij p = 0,5, dus 0,5 is de voorzichtige keuze en levert de grootste steekproef op. Het is de juiste standaardwaarde als u geen eerdere schatting hebt.
Hebt u er wel een, gebruik die dan, want de besparing is groot. Bij een betrouwbaarheidsniveau van 95 procent en plus of min 5 punten vraagt p = 0,5 om 385 reacties en p = 0,9 om 139. Eerdere enquêtes, een pilotonderzoek of een gepubliceerde maatstaf zijn allemaal redelijke bronnen voor die schatting. Onduidelijke vragen vergroten ook de spreiding, dus een heldere formulering kan een resultaat stabiliseren zonder extra reacties. Betere enquêtevragen schrijven is vaak goedkoper dan er meer reacties op verzamelen.
Kleine populaties: de eindigepopulatiecorrectie
De basisformule gaat ervan uit dat u vist in een vijver die zo groot is dat het weghalen van mensen niets verandert. Zodra uw steekproef een echt deel van de populatie is, rekent die aanname u te veel aan. De eindigepopulatiecorrectie geeft u die reacties terug.
n = n0 / (1 + ((n0 - 1) / N))
- n is het gecorrigeerde aantal volledige reacties dat u nodig hebt.
- n0 is het ongecorrigeerde getal uit de formule hierboven.
- N is de populatiegrootte.
De gebruikelijke drempel is dat n0 meer dan ongeveer 5 procent van N is. Daaronder verandert de correctie bijna niets, dus is ze het uitleggen niet waard.
Uitgewerkt voorbeeld: een medewerkersenquête
Scenario. U hebt 1.200 medewerkers. U wilt een betrouwbaarheidsniveau van 95 procent en plus of min 5 punten, en u gebruikt p = 0,5.
- Ongecorrigeerd: n0 = 384,16.
- Gecorrigeerd: n = 384,16 / (1 + (383,16 / 1.200)) = 384,16 / 1,3193 = 291,2.
- Naar boven afgerond: 292 volledige reacties.
Zonder de correctie zou u achter 385 reacties aanzitten uit een lijst van 1.200, oftewel 32 procent van iedereen. Met de correctie levert 292 dezelfde precisie. Bij een lijst van die omvang scheelt dat een maand nabellen.
Onder ongeveer 200 mensen is de gecorrigeerde steekproef zo’n groot deel van de lijst dat iedereen uitnodigen eenvoudiger en beter te verdedigen is. Een volledige telling van 150 mensen heeft helemaal geen steekproeffout. Uw inspanning gaat dan naar het responspercentage en naar wie er ontbreekt, en daar hoort ze ook.
Foutmarge: dezelfde formule, achterstevoren
De foutmarge is de band van plus of min rond een enquêteresultaat die ontstaat doordat u een deel van de mensen hebt gevraagd in plaats van iedereen. Als 62 procent van 385 deelnemers een optie kiest en de foutmarge 5 punten is, rapporteert u 62 procent en zegt u dat het aannemelijke bereik loopt van 57 tot 67 procent.
Als u de formule voor de steekproefgrootte omschrijft naar E, krijgt u:
E = z x wortel uit (p x (1 - p) / n)
Bij een eindige populatie vermenigvuldigt u dat met de wortel uit (N - n) gedeeld door (N - 1). Beide versies zitten in de calculator hieronder, die automatisch omschakelt wanneer u het vakje voor de populatie aan- of uitvinkt.
Wat is de foutmarge van de reacties die ik al heb?
Dezelfde formule, omgeschreven. Vul de reacties in die u hebt verzameld en lees de precisie af.
Foutmarge
5.0
Procentpunten, plus of min.
Uw interval
45,0 tot 55,0
Procent, bij een betrouwbaarheidsniveau van 95 procent.
De berekening, stap voor stap
Wordt de foutmarge groter met de steekproefgrootte?
Ze wordt kleiner, en wel met de wortel uit n. Die wortel is de hele economie van enquêtes. Vierhonderd reacties geven u de helft van de fout van honderd. Om die nog eens te halveren, hebt u er 1.600 nodig. Elke volgende decimaal precisie kost ongeveer vier keer zoveel veldwerk, en daarom komt men zo vaak uit op 385: daar houden kosten en precisie op met elkaar te strijden.
Vier begrippen die mensen door elkaar halen
Standaardfout, foutmarge, betrouwbaarheidsniveau en betrouwbaarheidsinterval worden gebruikt alsof ze uitwisselbaar zijn. Het zijn vier verschillende dingen, en het verschil doet ertoe wanneer iemand uw getal ter discussie stelt.
| Begrip | Wat het is | Bij 385 reacties en 50 procent |
|---|---|---|
| Standaardfout | De ruwe spreiding van de schatting. De wortel uit p maal (1 min p) gedeeld door n. | 0,0255, oftewel 2,55 procentpunt |
| Foutmarge | De standaardfout vermenigvuldigd met een z-score voor het betrouwbaarheidsniveau dat u hebt gekozen. | Plus of min 5,0 punten bij 95 procent |
| Betrouwbaarheidsniveau | De z-score die u hebt gekozen, uitgedrukt als percentage. Een keuze, geen meting. | 95 procent, dus z = 1,96 |
| Betrouwbaarheidsinterval | Het resultaat met de foutmarge toegepast, geschreven als bereik. | 45,0 procent tot 55,0 procent |
Kort gezegd: de standaardfout is een eigenschap van uw gegevens, het betrouwbaarheidsniveau is een keuze die u hebt gemaakt, de foutmarge is die twee met elkaar vermenigvuldigd, en het betrouwbaarheidsinterval is wat u in het rapport zet.
Wat de foutmarge niet dekt
Ze dekt de toevallige steekproeffout en verder niets. Ze dekt geen mensen die de uitnodiging negeerden, geen lijst waarop een deel van de populatie ontbrak, en geen vraag die de helft van uw deelnemers anders las dan u bedoelde. Een enquête kan een keurige foutmarge hebben en toch ernaast zitten. Zie responsbias en non-responsvertekening voor de fouten die geen enkele steekproefgrootte oplost.
De beroepsorganisatie voor enquêteonderzoek zegt het botter dan de meeste leveranciers. AAPOR stelt dat er niet zoiets bestaat als een meetbare totale foutmarge voor een peiling, omdat enquêtes andere fouten bevatten die helemaal niet te meten zijn, van hoe de vragen zijn geschreven tot hoe de interviews zijn afgenomen. Wat u kunt berekenen, is het steekproefdeel. Dat deel geeft de calculator u, en het is goed om duidelijk te zijn dat het een deel is.
Twee gebruiksregels uit dezelfde bron, die in de meeste teksten over enquêtes allebei fout gaan:
- Het zijn procentpunten, geen procenten. Schrijf “plus of min 3 procentpunt”, niet “plus of min 3 procent”. Dat betekent iets anders.
- Ze is helemaal niet van toepassing op opt-insteekproeven. Een foutmarge gaat ervan uit dat iedereen een bekende kans groter dan nul had om geselecteerd te worden. Een open link, een panel van vrijwilligers of een bericht op sociale media voldoet daar niet aan. Een foutmarge publiceren naast resultaten van een open link is een precisie claimen die u niet hebt gekocht.
Volledige reacties omzetten in uitnodigingen
De formule geeft u voltooide reacties. Het veldwerk geeft u een responspercentage. Het gat daartussen is waar steekproefplannen meestal mislukken, en de berekening is één regel:
Uitnodigingen = benodigde volledige reacties / verwacht responspercentage
Gebruik het percentage als decimaal getal, dus 30 procent is 0,30, en rond naar boven af. Voor 292 volledige reacties bij 35 procent is dat 292 gedeeld door 0,35 = 834,3, dus nodig minstens 835 mensen uit.
| Benodigde reacties | Verwacht responspercentage | Uitnodigingen |
|---|---|---|
| 385 | 60 procent | 642 |
| 385 | 30 procent | 1,284 |
| 385 | 15 procent | 2,567 |
| 292 | 50 procent | 584 |
| 292 | 35 procent | 835 |
| 292 | 20 procent | 1,460 |
Een responspercentage kiezen dat u kunt verdedigen
Uw eigen ervaring wint van elke gepubliceerde maatstaf, zolang het om dezelfde doelgroep, hetzelfde kanaal en een enquête van vergelijkbare lengte gaat. Als u nergens op kunt bouwen, plan dan drie scenario’s met 20, 30 en 40 procent en zie de uitnodigingslijst als iets waaraan u tijdens het veldwerk nog kunt draaien. Herinneringen, een langere looptijd en een bredere lijst kunt u allemaal halverwege veranderen. Het doel voor volledige reacties niet.
De meeste maatstaftabellen op internet noemen één gemiddelde zonder bron. Er bestaat geen enkel gemiddelde. Dit is wat de primaire bronnen werkelijk rapporteren, zodat u de rij kunt citeren die bij uw situatie past in plaats van een getal dat iemand heeft verzonnen.
| Context | Responspercentage | Omvang en bron |
|---|---|---|
| Amerikaanse federale instanties met minder dan 1.000 medewerkers | 71 procent | Federal Employee Viewpoint Survey 2024 (OPM) |
| Amerikaanse federale instanties met 1.000 tot 9.999 medewerkers | 60 procent | Zelfde enquête, zelfde jaar (OPM) |
| Amerikaanse federale instanties met meer dan 75.000 medewerkers | 37 procent | Zelfde enquête, zelfde jaar (OPM) |
| Alle Amerikaanse federale medewerkers | 41 procent | Ruim 1,6 miljoen uitgenodigd, ruim 674.000 gereageerd, 2024 (OPM) |
| Gepubliceerde online enquêtes, alle soorten | 44,1 procent gemiddeld | Meta-analyse van 1.071 gerapporteerde percentages (Wu e.a., 2022) |
| Gepubliceerd organisatieonderzoek | 68 procent in 2020, tegenover 48 procent in 2005 | 1.014 enquêtes in 17 tijdschriften (Holtom e.a., 2022) |
| Telefonische peilingen onder het algemene publiek | 6 procent in 2018, tegenover 36 procent in 1997 | Het eigen bijgehouden percentage van het Pew Research Center (Kennedy en Hartig, 2019) |
| Online afname tegenover elke andere afnamemethode | ongeveer 12 punten lager | Meta-analyse van 114 experimentele vergelijkingen (Daikeler e.a., 2020) |
Uit die tabel volgen twee dingen. Ten eerste: de omvang van de groep die u ondervraagt, voorspelt het percentage beter dan bijna alles wat u zelf in de hand hebt. Een bedrijf van 300 personen en een instantie van 300.000 personen voeren niet dezelfde enquête uit. Ten tweede klopt de vaak herhaalde bewering dat responspercentages overal instorten maar op sommige plekken. Telefonische peilingen zijn inderdaad ingestort. Gepubliceerd organisatieonderzoek ging de andere kant op, van 48 procent naar 68 procent in vijftien jaar.
Nog een stukje planningsrekenwerk dat de moeite van het overnemen waard is: de gangbare richtlijn uit de voorlichtingspraktijk is om ongeveer 10 procent aan uw uitnodigingslijst toe te voegen voor mensen die u eenvoudigweg niet bereikt, en ongeveer 30 procent voor mensen die zouden kunnen antwoorden maar dat niet doen.
Wat onze eigen verzameling sjablonen zegt over lengte
Een responspercentage dat u van de enquête van een ander leent, laat zich slecht overzetten, en lengte is een van de weinige dingen op die lijst die u volledig in de hand hebt. Hier is een cijfer dat wij kunnen geven en een concurrent niet, omdat het komt uit het tellen van onze eigen gepubliceerde verzameling in plaats van uit het vragen aan professionals wat ze denken te doen.
In onze controle van 21 augustus 2026 hadden alle 87 enquêtesjablonen 14 vragen of minder, en 86 ervan 10 vragen of minder. Samen bevatten ze 799 vragen. De mediaan was 9 vragen en precies één sjabloon kwam boven de 10 uit. Deze cijfers beschrijven die gedateerde momentopname, niet de huidige bibliotheek.
| Vragen in het sjabloon | Sjablonen | Aandeel van de verzameling |
|---|---|---|
| 7 vragen | 4 | 5 procent |
| 8 vragen | 17 | 20 procent |
| 9 vragen | 29 | 33 procent |
| 10 vragen | 36 | 41 procent |
| 14 vragen | 1 | 1 procent |
Naar antwoordvorm zijn 355 van de 799 vragen beoordelingsschalen, 281 lijsten met één keuze en 163 vragen de lezer iets te typen. Die laatste groep kost u voltooide enquêtes, dus hebben we die met de hand doorgelezen in plaats van op het opgeslagen veld te vertrouwen. Van de 163 zijn er 137 tekstvakken voor opmerkingen over meerdere regels. De andere 26 zijn vakken van één regel, en bij het lezen bleek dat 22 daarvan korte velden voor identificatie of indeling zijn: een naam, een e-mailadres, een datum, een afdeling, een functietitel. Slechts 4 zijn inhoudelijke korte antwoorden. Het eerlijke aantal echt open vragen is dus 141, oftewel ongeveer één vraag op zes, niet de één op vijf die het ruwe veld ons zou hebben gegeven.
Hoe we hebben geteld en gecontroleerd. We hebben op 21 augustus 2026 de opgeslagen vragenlijst van elk enquêtesjabloon dat live op deze site stond uitgelezen, de items met vraagtekst behouden, daarna elke gepubliceerde pagina opgehaald en de twee sets vergeleken, in plaats van alleen op onze eigen database te vertrouwen. Alle 87 pagina’s gaven HTTP 200 terug, terwijl een slug waarvan we weten dat hij niet meer bestaat in dezelfde run 410 teruggaf, dus de controle maakte echt onderscheid in plaats van overal groen te geven. 785 van de 799 vragen, oftewel 98 procent, staan op de gepubliceerde pagina. Zes van die overeenkomsten verschillen van de database alleen in het gebruikte apostrofteken, en die hebben we als overeenkomst geteld; dat vermelden we liever dan het stilletjes weg te ronden. Zesentachtig van de 87 sjablonen zijn volledig geverifieerd. Het sjabloon dat dat niet is, is ons langste, met 14 vragen, en de gepubliceerde pagina ervan toont momenteel helemaal geen voorbeeldvragen, dus de vragen ervan konden niet van buitenaf worden bevestigd.
De lengte van een sjabloon vertelt u niet het responspercentage op uitnodigingen. Onze afzonderlijke maatstaf voor enquêtereacties onderzoekt gedrag nadat mensen met een enquête aan de slag zijn gegaan; ze telt niet iedereen die is uitgenodigd. Gebruik voor het plannen van uitnodigingen een gedocumenteerd percentage uit een vergelijkbaar project of een pilotonderzoek, en houd de noemer consistent.
Het praktische nut is beperkt maar reëel. Als u een responspercentage leent voor het aantal uitnodigingen in de calculator, leen het dan van een enquête van ongeveer dezelfde lengte als de enquête die u gaat versturen, aan een vergelijkbare doelgroep via een vergelijkbaar kanaal. Onze eigen gepubliceerde vragenlijsten hebben tussen de 7 en 10 vragen, wat korter is dan de meeste eerste versies.
Meer uitnodigingen leveren niet minder vertekening op
Een laag responspercentage veroorzaakt twee problemen die op één probleem lijken. Het eerste is dat u uw doel niet haalt, zodat uw foutmarge breder is dan gepland. Het tweede is dat de mensen die antwoordden kunnen verschillen van de mensen die dat niet deden, op manieren die voor uw resultaat uitmaken.
Meer mensen uitnodigen lost het eerste probleem op. Het tweede lost het niet zonder meer op. Groves en Peytcheva bundelden 59 onderzoeken die de werkelijke non-responsvertekening afzetten tegen een bekende waarheid, en vonden slechts een klein verband tussen het responspercentage van een enquête en hoe vertekend die bleek te zijn. Pew toetste hetzelfde idee rechtstreeks: ze namen één vragenlijst twee keer af, eenmaal met standaardmethoden die een responspercentage van 9 procent opleverden en eenmaal met een intensief protocol dat 22 procent opleverde. Van de 40 vragen die beide enquêtes gemeen hadden, lagen er 28 binnen 2 punten van elkaar.
Het eerlijke tegenvoorbeeld. Die bevinding geldt niet voor elk onderwerp, en het is goed om te weten waar ze ophoudt. Bij tevredenheidsenquêtes is het verband echt en groot. Een onderzoek naar 717 tevredenheidsenquêtes onder patiënten in 164 Zwitserse ziekenhuizen vond een correlatie van r = 0,61 tussen de gemiddelde tevredenheidsscore en het responspercentage, omdat wie heel tevreden of woedend is antwoordt en het onverschillige midden niet. Als u CSAT of NPS meet, kan een stijgend responspercentage uw score vanzelf verschuiven, en een laag percentage geeft waarschijnlijk een te rooskleurig beeld.
Dus: jaag op het responspercentage als u meet hoe mensen over u denken. Zie het niet als bewijs van geldigheid als u iets anders meet.
Steekproefgrootte voor kwantitatief onderzoek: wat een methodehoofdstuk nodig heeft
Er bestaat niet één goede steekproefgrootte voor kwantitatief onderzoek, en elke bron die u er een geeft zonder te vragen wat u meet, gokt. Wat een methodehoofdstuk goedgekeurd krijgt, is geen groot getal. Het is een vermeld getal, met het betrouwbaarheidsniveau, de foutmarge, de aangenomen proportie en de populatie ernaast, en een benoemde formule erbij.
Begeleiders verwachten meestal een van vier benoemde methoden. Die komen grotendeels met elkaar overeen, en het is goed om te weten om welke er van u wordt gevraagd.
| Benoemde methode | Wat ze van u vraagt | Resultaat voor N = 1.000 bij 95 procent en 5 punten | Gebruik ze als |
|---|---|---|---|
| Cochran (1977) | z, p, E, en daarna de eindigepopulatiecorrectie als de populatie klein is | 278 | De standaard. Het is de formule op deze pagina, en de formule waarvan de andere zijn afgeleid. |
| Krejcie en Morgan (1970) | Niets. U leest het antwoord af uit een gepubliceerde tabel per populatiegrootte. | 278 | U wilt een citeerbare tabel in plaats van rekenwerk. Het is Cochran met vaste instellingen. |
| Yamane (1967), vaak Slovin genoemd | Alleen N en de foutmarge | 286 | Alleen als p echt onbekend is en u accepteert dat een betrouwbaarheidsniveau van 95 procent vastligt. Zie de waarschuwing hieronder. |
| Poweranalyse | Effectgrootte, power, alfa en de toets die u gaat uitvoeren | Hangt volledig af van de effectgrootte | U toetst een hypothese in plaats van een percentage te schatten. Gebruik G*Power of OpenEpi, niet deze pagina. |
Cochran, en waarom al het andere daar een verkorting van is
De formule van Cochran is de formule bovenaan deze pagina: n0 = z in het kwadraat maal p maal (1 min p), gedeeld door E in het kwadraat, gevolgd door de eindigepopulatiecorrectie als de populatie klein is. De andere benoemde methoden zetten een deel van die invoer vast om het rekenwerk korter te maken. Als u dat weet, ziet de familie er niet meer uit als vier concurrerende regels, maar als één regel met drie voorinstellingen.
Yamane en Slovin: gebruik ze met open ogen
De formule n = N / (1 + N x e^2) staat in duizenden scripties, meestal toegeschreven aan Slovin. Ze is snel: voor N = 1.000 en e = 0,05 geeft ze 286.
Drie dingen zijn goed om te weten voordat u haar citeert.
- Het is Cochran met de instellingen vastgelast. Terugrekenend is de formule de proportieformule met p vast op 0,5, het betrouwbaarheidsniveau vast op 95 procent en z afgerond van 1,96 naar 2. Ze kan geen vraag beantwoorden bij een ander betrouwbaarheidsniveau, en ze heeft helemaal geen invoer voor hoe variabel uw populatie is. Twee even grote populaties met een totaal verschillende spreiding krijgen hetzelfde antwoord, en dat kan niet kloppen.
- Door die afronding vallen haar getallen hoog uit. Met z = 2 is het plafond van de formule voor een onbeperkte populatie precies 1 gedeeld door e in het kwadraat, oftewel 400. Het plafond van Cochran is 384,16, omdat 1,96 in het kwadraat 3,8416 is en niet 4. Elk getal van Yamane in de tabel hierboven is precies om die reden een paar procent groter dan het getal van Cochran. Als u zich ooit hebt afgevraagd waarom twee studieboeken u twee verschillende steekproefgroottes voor hetzelfde onderzoek geven, is dit meestal het antwoord.
- De toeschrijving houdt geen stand. Een statistisch tijdschrift ging de geschiedenis van de formule na en concludeerde dat er geen persoon met de naam Slovin achter te vinden is, en dat de oudste herleidbare bron het studieboek van Taro Yamane uit 1967 is. Wolfram MathWorld beschrijft haar als een ad-hocformule zonder wiskundige onderbouwing. Als uw opleiding haar verwacht, gebruik haar dan en citeer Yamane in plaats van Slovin. Als u de keuze hebt, gebruik dan Cochran, want die doorstaat de vraag waar de 95 procent vandaan kwam.
Vuistregels, eerlijk beoordeeld
Deze circuleren veel. Sommige zijn nuttig, sommige zijn folklore, en het helpt om te weten welke welke is.
- Minstens 30 per groep. Redelijk als ondergrens voor groepsvergelijkingen, niet als doel. Het komt voort uit het punt waarop steekproevenverdelingen zich netjes gaan gedragen, niet uit een eis voor precisie.
- Tien gevallen per variabele in een regressie. Een werkbare vuistregel, veel gebruikt en veel bekritiseerd. Presenteer haar als vuistregel, nooit als regel.
- Tien procent van de populatie. Deze is gewoon fout, en de tabel hierboven laat zien waarom. Tien procent van 100.000 is 10.000 reacties, terwijl 383 u dezelfde precisie geeft.
- Altijd 385. Alleen juist voor een grote populatie bij 95 procent en 5 punten. Noem het getal met die voorwaarden erbij, anders betekent het niets.
- Een kleine n voor usability- en productonderzoek. Nielsen Norman Group publiceert de eerlijke versie hiervan: met 40 deelnemers meet u een ja-of-nee-uitkomst tot op plus of min 15 punten bij een betrouwbaarheidsniveau van 95 procent, en met 47 een gemiddelde met dezelfde precisie. Die getallen zijn klein omdat de geclaimde precisie ruim is. Spreek de precisie hardop uit en kleine steekproeven zijn niet langer gênant.
Als uw onderzoek groepen vergelijkt in plaats van één percentage te schatten, wordt de steekproefgrootte een vraag van power en is dit niet de juiste calculator. U hebt een effectgrootte nodig die u wilt verdedigen, plus alfa en power. G*Power en OpenEpi zijn de gratis hulpmiddelen die de meeste begeleiders verwachten. Zeggen waar een hulpmiddel ophoudt, is nuttiger dan doen alsof het alles kan.
Kwalitatief werk wordt anders bepaald
Interviews en focusgroepen worden niet bepaald met een foutmarge, omdat ze geen percentage in een populatie schatten. Het gebruikelijke argument is verzadiging: u gaat door tot nieuwe deelnemers geen nieuwe thema’s meer opleveren, en rapporteert daarna waar dat gebeurde en hoe u dat hebt beoordeeld. Een kwalitatief onderzoek door deze calculator halen levert een getal op dat precies lijkt en niets betekent.
Hebt u resultaten per subgroep nodig, bereken dan voor de subgroep
De meeste enquêtes moeten rapporteren per regio, functie, dienstjaren of productlijn. Hier lopen steekproefplannen ongemerkt stuk, en de regel is kort.
Uw foutmarge geldt alleen voor een groep als die groep zoveel volledige reacties heeft. Als u plus of min 5 punten wilt voor elk van zes regio’s, hebt u ongeveer 385 volledige reacties per regio nodig, niet 385 in totaal. Dat is een enquête die zes keer zo groot is als u dacht te plannen.
Twee eerlijke uitwegen:
- Overbemonster de kleine groepen. Nodig bewust een groter deel van de kleinere segmenten uit, zodat elk ervan zijn eigen doel haalt. Achteraf weegt u de resultaten terug.
- Accepteer bredere banden voor de uitsplitsingen. Houd één sterk totaalcijfer en publiceer elke subgroep met een eigen, grotere foutmarge ernaast. Dit is meestal het juiste antwoord.
De calculator heeft hier een veld voor. Zet Subgroepen om apart te rapporteren op het aantal groepen waarvoor u een resultaat moet leveren, en hij berekent elke groep correct en telt ze op.
Baken het af voordat u het veld in gaat. Noem de segmenten waarover u moet rapporteren, niet de segmenten die leuk zouden zijn. Schat hoeveel volledige reacties elk segment realistisch kan opleveren, en gebruik demografische vragen om ze te herkennen. Als een segment maar 80 reacties kan opleveren, beloof er dan geen plus of min 5 punten voor. Bij 80 reacties is de band plus of min 11 punten.
AAPOR gebruikt een uitgewerkt voorbeeld dat het onthouden waard is. Een enquête onder 1.000 volwassenen heeft een totale foutmarge van ongeveer plus of min 3 punten. Als 200 van die mensen de subgroep zijn waar u het eigenlijk over wilt hebben, is de foutmarge van die subgroep plus of min 6,9 punten, ruim het dubbele. Het hoofdcijfer op de voorkant van het rapport is niet het cijfer dat de grafiek op pagina negen bepaalt.
Gepubliceerde richtlijnen voor minimale celgroottes zijn ouder en ruimer dan de formules, en het is redelijk om ze als ondergrens te zien in plaats van als doel: ongeveer 100 reacties voor een subgroep waarover u serieus rapporteert, en 20 tot 50 voor een kleine groep die u terloops noemt.
Waar het plannen van de steekproefgrootte misgaat
De steekproefgrootte beheerst de steekproeffout, de toevallige ruis doordat u niet iedereen vraagt. Echte enquêtes bevatten ook systematische fouten, die geen enkele steekproefgrootte oplost en die een grote steekproef kan verhullen.
Een gemakssteekproef behandelen als een aselecte steekproef
Elke formule hier gaat ervan uit dat iedereen een bekende kans groter dan nul had om geselecteerd te worden, en dat het antwoorden niet sterk samenhing met wat u meet. Een open link op sociale media voldoet aan geen van beide voorwaarden. U kunt uit de reacties nog steeds een foutmarge berekenen, die zal er geruststellend uitzien, en die zal niet betekenen wat ze zegt. Wees expliciet over welk soort steekproef u werkelijk hebt getrokken.
Een grotere n zien als een betere meting
Een grote steekproef maakt een rommelige meting alleen nauwkeurig rommelig. Als een vraag dubbelzinnig, dubbelloops of sturend is, redden meer reacties die niet. Veel overgeslagen vragen en tegenstrijdige antwoorden zijn signalen om eerst het instrument te verbeteren. Eén slechte vraag herschrijven doet vaak meer dan de steekproef verdrievoudigen.
Precisie kiezen zonder beslissing erachter
Precisie heeft pas een juist antwoord als u weet waarvoor ze dient. Een steekproefgrootte is makkelijk te verdedigen als u deze zin kunt afmaken: we moeten uitkomsten kunnen onderscheiden die X punten verschillen. Ze is onmogelijk te verdedigen als de enige reden is dat een groter getal veiliger voelde. Koppel haar terug aan uw onderzoeksopzet en aan wat u met het resultaat gaat doen.
De getallen op deze pagina, en hoe goed ze zijn
Elk cijfer hierboven is ofwel rekenwerk dat u in de calculator kunt nadoen, ofwel een bronvermelding die u kunt controleren. Graad A betekent gerepliceerd of direct te berekenen, B betekent één sterk onderzoek, C betekent vaak herhaald maar omstreden.
| Bewering | Getal | Niveau | Bron |
|---|---|---|---|
| Bij een betrouwbaarheidsniveau van 95 procent zonder eerdere schatting heeft een grote populatie 385 volledige reacties nodig voor plus of min 5 punten. | 385 | A | Rechtstreeks rekenwerk met de standaardformule voor proporties. NIST paragraaf 3.3.3; Israel (1992). |
| De formule op deze pagina reproduceert de gepubliceerde tabel met steekproefgroottes van Krejcie en Morgan tot op één reactie nauwkeurig bij elk van de 21 populatiegroottes die we hebben gecontroleerd. | 21 van 21 binnen 1 | A | Onze eigen controle tegen Krejcie en Morgan (1970). Methode beschreven onder de tabel. |
| Het responspercentage is een zwakke voorspeller van non-responsvertekening. Een meta-analyse van 59 onderzoeken die speciaal naar vertekening keken, vond slechts een klein verband tussen de twee. | 59 onderzoeken | A | Groves en Peytcheva (2008), Public Opinion Quarterly. |
| Pew nam dezelfde vragenlijst af bij een responspercentage van 9 procent en van 22 procent. Van 40 gedeelde vragen lagen er 28 binnen 2 punten. | 28 van 40 binnen 2 punten | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Maar bij tevredenheidsenquêtes is het verband echt en groot. Over 717 ziekenhuisenquêtes correleerde de gemiddelde tevredenheidsscore met het responspercentage met r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux en Combescure (2020), BMC Health Services Research. |
| Het responspercentage van medewerkersenquêtes volgt de omvang van de organisatie bijna perfect. In 2024 haalde de Amerikaanse federale medewerkersenquête 71 procent bij instanties met minder dan 1.000 mensen en 37 procent bij instanties met meer dan 75.000. | 71 tegenover 37 procent | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, ruim 1,6 miljoen medewerkers uitgenodigd. |
| Het gemiddelde responspercentage over 1.071 gepubliceerde online enquêtes was 44,1 procent. Er bestaat niet één normaal percentage. | 44,1 procent | A | Meta-analyse van Wu, Zhao en Fils-Aime (2022), Computers in Human Behavior Reports. |
| Online enquêtes halen een responspercentage dat ongeveer 12 procentpunt lager ligt dan bij andere afnamemethoden, over 114 experimentele vergelijkingen. | 12 punten lager | A | Meta-analyse van Daikeler, Bosnjak en Lozar Manfreda (2020), JSSAM. |
| Een halvering van de foutmarge maakt de benodigde steekproef ongeveer vier keer zo groot, omdat n meeschaalt met 1 gedeeld door E in het kwadraat. Een steekproef verdubbelen van 1.000 naar 2.000 levert ongeveer één punt op. | ongeveer 4x | A | Algebraïsche eigenschap van de formule; AAPOR noemt het geval van 1.000 naar 2.000 expliciet. |
| Als u p = 0,5 aanneemt in plaats van een bekende p = 0,9, wordt de steekproef die u moet verzamelen bijna drie keer zo groot, van 139 naar 385. | 139 tegenover 385 | A | Rechtstreeks rekenwerk. Na te doen in de calculator door het verwachte resultaat te wijzigen. |
| Alle 87 enquêtesjablonen die op deze site zijn gepubliceerd, hebben 14 vragen of minder, en 86 van de 87 hebben er 10 of minder. 785 van hun 799 vragen zijn op de gepubliceerde pagina’s bevestigd. | 87 sjablonen, 799 vragen | A | Onze eigen telling van de live verzameling sjablonen, 21 augustus 2026, gecontroleerd tegen alle 87 gepubliceerde pagina’s. Methode, handmatige controle en verificatiegraad staan bij de tabel. |
| Er is geen herleidbare persoon met de naam Slovin achter de formule die die naam draagt. De oudste herleidbare bron is Yamane (1967). | geen herleidbare auteur | B | Tejada en Punzalan (2012), The Philippine Statistician; Wolfram MathWorld noemt haar ad hoc. |
“U hebt altijd 385 reacties nodig.” Alleen bij een betrouwbaarheidsniveau van 95 procent, plus of min 5 punten, p = 0,5 en een grote populatie. Wie het getal zonder die voorwaarden noemt, zit er bij elke kleine populatie naast.
“Ondervraag 10 procent van uw populatie.” Daar is geen statistische basis voor. Het overbemonstert grote populaties enorm en onderbemonstert kleine.
“Een responspercentage onder 50 of 60 procent maakt een enquête ongeldig.” Geen enkele drempel doet dat. De ladder van 50, 60 en 70 procent is een vuistregel uit studieboeken zonder empirische afleiding, en de meta-analyse van Groves en Peytcheva spreekt haar tegen. Het responspercentage begrenst de vertekening in het ergste geval. Het meet niet de werkelijke vertekening.
“Het gemiddelde responspercentage van enquêtes is X procent.” Geverifieerde cijfers uit dezelfde paar jaar lopen van 6 procent tot 71 procent, volledig afhankelijk van wie er wordt ondervraagd. Elk afzonderlijk gemiddelde verbergt dat. Citeer in plaats daarvan de rij uit de tabel hierboven die bij uw situatie past.
De formule van Slovin gepresenteerd als afleiding. Het is de formule van Cochran met een betrouwbaarheidsniveau van 95 procent en p = 0,5 ingebakken en z afgerond op 2, en de toeschrijving aan Slovin heeft geen herleidbare bron.
Het sjabloon voor de onderbouwing
De meeste onderbouwingen van een steekproefgrootte mislukken omdat de aannames nooit zijn opgeschreven. De knop Onderbouwing kopiëren in de calculator schrijft dit uit met uw eigen getallen er al in. Als u het liever zelf samenstelt, zijn dit de negen dingen waar een beoordelaar naar kijkt.
- Populatie (N): definieer de populatie en vermeld het aantal. Bijvoorbeeld alle actieve klanten in de afgelopen 90 dagen, N = 48.200.
- Wat u meet: een proportie (een percentage) of een gemiddelde (een gemiddelde beoordeling). De formule hier berekent proporties, en daarmee zijn de meeste gerapporteerde kpi’s gedekt.
- Betrouwbaarheidsniveau: het niveau dat u hebt gekozen en waarom. Gangbare praktijk en risicobereidheid zijn allebei aanvaardbare redenen, als u dat vermeldt.
- Foutmarge (E): de beoogde precisie in totaal, en apart voor elke subgroep waarover u hebt beloofd te rapporteren.
- Aangenomen proportie (p): de gebruikte waarde en waar die vandaan kwam. Vermeld gewoon als het 0,5 is omdat er niets beters beschikbaar was.
- Eindigepopulatiecorrectie: of u die hebt toegepast en waarom, bijvoorbeeld omdat n0 meer dan 10 procent van N was.
- Doel voor volledige reacties (n): het uiteindelijk benodigde aantal volledige reacties na elke correctie.
- Verwacht responspercentage: het aangenomen percentage, de ervaring waarop het is gebaseerd en het aantal uitnodigingen dat daaruit volgt.
- Hoe u mensen selecteert: enkelvoudig aselect, gestratificeerd, volledige telling of gemakssteekproef, plus eventuele overbemonstering van belangrijke segmenten. Noem het eerlijk.
Zodra de enquête in het veld is, houdt u de volledige reacties per segment in de gaten in plaats van het totaal. Een gezond totaal kan een segment verbergen dat zijn doel nooit zal halen, en dat is een probleem dat u in week één nog kunt oplossen en in week vier niet meer. Zet bij het rapporteren elk percentage naast zijn foutmarge, en lees hoe u enquêtegegevens analyseert voordat u een verschuiving van twee punten als echt beschouwt.
Planningswerkblad steekproefgrootte
Eén pagina die u kunt afdrukken, met de hand kunt invullen en aan een projectplan kunt nieten. Vul de middelste kolom in voordat het veldwerk begint, niet erna. Er wordt niets verstuurd en er is geen account nodig.
| Beslissing | Uw waarde | Toelichting |
|---|---|---|
| Populatie (N) | Wie precies, en hoeveel. Schrijf de definitie op, niet alleen het getal. | |
| Wat u meet | Een percentage of een gemiddelde. Deze pagina berekent percentages. | |
| Betrouwbaarheidsniveau | 95 procent, tenzij u een reden hebt. Schrijf de reden op. | |
| Foutmarge (E) | Het verschil dat u moet kunnen onderscheiden, in punten. | |
| Aangenomen proportie (p) | 0,5 als er niets beters is. Vermeld waar een andere waarde vandaan kwam. | |
| Eindigepopulatiecorrectie | Toegepast of niet, en waarom. | |
| Doel voor volledige reacties (n) | Het uiteindelijke getal na elke correctie. | |
| Apart gerapporteerde subgroepen | Hoeveel, en de volledige reacties die elk ervan zelf moet opleveren. | |
| Verwacht responspercentage | Het percentage en de ervaring erachter. Geen getal van internet. | |
| Te versturen uitnodigingen | Volledige reacties gedeeld door het percentage, naar boven afgerond. Nooit meer dan N. | |
| Hoe mensen worden geselecteerd | Aselect, gestratificeerd, volledige telling of gemakssteekproef. Noem het eerlijk. | |
| Controlemoment tijdens het veldwerk | De datum waarop u de volledige reacties per segment controleert, niet alleen het totaal. |
Formule: n0 = (z^2 x p x (1 - p)) / E^2, daarna n = n0 / (1 + (n0 - 1) / N). Bron: Cochran (1977); NIST/SEMATECH e-Handbook paragraaf 3.3.3; Israel (1992). Werkblad van https://www.supersurvey.com/Sample-Size
Veelgestelde vragen
Wat is steekproefgrootte?
De steekproefgrootte is het aantal volledige reacties in een enquête, geschreven als n. Het is niet het aantal mensen dat u hebt uitgenodigd, en niet de omvang van de populatie die u beschrijft. Het is het aantal waarmee u het veldwerk afsluit, en het getal waaruit uw foutmarge wordt berekend: 385 volledige reacties geven ongeveer plus of min 5 punten bij een betrouwbaarheidsniveau van 95 procent als de populatie groot is. Wat steekproefgrootte betekent zet het verschil uiteen tussen de populatie, de uitnodigingen en n.
Hoeveel reacties heb ik nodig voor een enquête?
Voor de meeste enquêtes is het werkbare antwoord 385 volledige reacties. Dat geeft de formule bij een betrouwbaarheidsniveau van 95 procent, een foutmarge van plus of min 5 procentpunt en geen eerdere schatting van het resultaat. Als uw populatie klein is, hebt u er minder nodig: 278 voor een lijst van 1.000 mensen, 80 voor een lijst van 100. Vul uw eigen getallen in de calculator in om het precieze getal en de berekening erachter te zien.
Welke steekproefgrootte heb ik nodig voor een betrouwbaarheidsniveau van 95 procent en een foutmarge van 5 procent?
385 volledige reacties, als de populatie groot is en u p = 0,5 gebruikt. De berekening is n0 = 1,96 in het kwadraat maal 0,5 maal 0,5, gedeeld door 0,05 in het kwadraat, oftewel 0,9604 gedeeld door 0,0025, oftewel 384,16. Naar boven afgerond krijgt u 385. Als uw populatie klein is, past u de eindigepopulatiecorrectie toe en wordt het getal lager.
Wat is een foutmarge?
De foutmarge is de band van plus of min rond een enquêteresultaat die ontstaat doordat u een steekproef van de mensen hebt genomen in plaats van iedereen te vragen. Een resultaat van 62 procent met een foutmarge van 5 punten betekent dat de methode meestal een interval zou opleveren dat de werkelijke waarde bevat, en dat dit specifieke interval loopt van 57 tot 67 procent. Ze beschrijft alleen de toevallige steekproeffout. Ze zegt niets over mensen die nooit hebben geantwoord.
Hoe bepaalt u de foutmarge?
Neem de wortel uit p maal (1 min p) gedeeld door n, en vermenigvuldig die met de z-score voor uw betrouwbaarheidsniveau. Bij een betrouwbaarheidsniveau van 95 procent, 385 reacties en p = 0,5 is dat 1,96 maal de wortel uit 0,25 gedeeld door 385, oftewel 1,96 maal 0,025482, oftewel 0,0499. De foutmarge is dus plus of min 5,0 procentpunt. De foutmargecalculator op deze pagina rekent het voor u uit en toont de berekening.
Wordt de foutmarge groter met de steekproefgrootte?
Nee, ze wordt kleiner, en wel met de wortel uit de steekproef. Van 100 naar 400 reacties gaan halveert de foutmarge. Van 400 naar 1.600 gaan halveert haar opnieuw. Door dat wortelverband wordt precisie duur: elke extra decimaal nauwkeurigheid kost ongeveer vier keer zoveel reacties.
Is de foutmarge hetzelfde als de standaardfout?
Nee. De standaardfout is de onderliggende spreiding van de schatting. De foutmarge is de standaardfout vermenigvuldigd met een z-score voor het betrouwbaarheidsniveau dat u hebt gekozen. Bij een betrouwbaarheidsniveau van 95 procent is de foutmarge ongeveer 1,96 standaardfouten. De standaardfout is een eigenschap van de gegevens. De foutmarge is een rapportagekeuze die daarbovenop komt.
Wat is een goede steekproefgrootte voor kwantitatief onderzoek?
Er bestaat niet één goed getal, en elke bron die u er een geeft zonder te vragen wat u meet, gokt. Voor een onderzoek dat percentages rapporteert uit een populatie van minder dan ongeveer 10.000, is het verdedigbare antwoord wat de formule geeft bij een betrouwbaarheidsniveau van 95 procent en een foutmarge die u kunt onderbouwen. Voor een lijst van 1.000 is dat 278. Het getal waarmee een methodehoofdstuk wordt goedgekeurd, is geen groot getal, maar een vermeld getal met het betrouwbaarheidsniveau, de foutmarge, de aangenomen proportie en de populatie ernaast. Zie steekproefgrootte voor kwantitatief onderzoek voor de benoemde formules die uw begeleider kan verwachten.
Wat is een normaal responspercentage voor een enquête?
Er bestaat niet één normaal percentage, en elke pagina die één getal noemt, gokt. Echte cijfers met bron uit dezelfde periode lopen van 6 procent (telefonische peilingen van Pew in 2018) tot 71 procent (kleine Amerikaanse federale instanties in de Federal Employee Viewpoint Survey 2024). Een meta-analyse van 1.071 gepubliceerde online enquêtes vond een gemiddelde van 44,1 procent. De omvang van de organisatie maakt enorm uit: dezelfde federale enquête haalde 71 procent bij instanties met minder dan 1.000 mensen en 37 procent bij instanties met meer dan 75.000. Gebruik eerst uw eigen ervaring, en zie de tabel met maatstaven voor cijfers die u kunt citeren.
Maakt de populatiegrootte uit voor de steekproefgrootte?
Nauwelijks, tot uw steekproef een groot deel van de populatie wordt. Van 100.000 naar 1.000.000 mensen gaan verandert de eis van 383 naar 385. Van 1.000 naar 100 mensen gaan verandert haar van 278 naar 80. De populatiegrootte doet ertoe aan de kleine kant, en dat is precies waar de eindigepopulatiecorrectie geldt.
Wanneer is p = 0,5 de juiste keuze?
Gebruik p = 0,5 als u geen verdedigbare eerdere schatting hebt. De term p maal (1 min p) is het grootst bij 0,5, dus levert die de grootste benodigde steekproef op. Daarmee is het de veilige aanname: u kunt niet tekortkomen. Hebt u een pilotonderzoek, een maatstaf of het cijfer van vorig jaar, gebruik dat dan. Als u p = 0,9 aanneemt in plaats van 0,5, daalt de benodigde steekproef van 385 naar 139.
Neem ik non-responsvertekening weg als ik meer mensen uitnodig?
Nee. Meer uitnodigingen leveren meer volledige reacties op, waardoor de foutmarge kleiner wordt. Vertekening is een apart probleem: die hangt af van of de mensen die antwoordden verschillen van de mensen die dat niet deden. Een meta-analyse van 59 onderzoeken naar non-responsvertekening vond slechts een klein verband tussen het responspercentage en de werkelijke vertekening. Pew nam dezelfde vragenlijst twee keer af, bij een responspercentage van 9 procent en van 22 procent, en 28 van de 40 gedeelde vragen lagen binnen 2 punten van elkaar. Zie responsbias en non-responsvertekening.
Hoe ga ik om met de steekproefgrootte als ik resultaten per afdeling of regio nodig heb?
Bereken elke subgroep apart. Uw foutmarge geldt alleen voor een groep als die groep zoveel volledige reacties heeft. Als u voor elke regio plus of min 5 punten wilt, heeft elke regio haar eigen 385 volledige reacties nodig, of haar eigen getal na de eindigepopulatiecorrectie. Gebruik demografische vragen om de groepen te herkennen en plan om de kleine groepen te overbemonsteren.
Welke steekproefgrootte heb ik nodig voor een statistisch significant resultaat?
Die vraag haalt twee ideeën door elkaar. Formules voor de steekproefgrootte berekenen een schatting met een gekozen precisie. Bij toetsing op statistische significantie worden twee getallen vergeleken en wordt gevraagd of het verschil aannemelijk op toeval kan berusten. De grootte die u nodig hebt, hangt af van hoe klein een verschil u wilt kunnen opsporen, niet van een vaste drempel. Bepaal de omvang van de enquête hier, en lees daarna statistische significantie voordat u het ene resultaat tegen het andere toetst.
Werken deze formules voor kwalitatief onderzoek?
Nee. Interviews, focusgroepen en werk met open vragen worden niet bepaald met een foutmarge, omdat ze geen percentage in een populatie schatten. De steekproefgrootte bij kwalitatief onderzoek wordt onderbouwd met verzadiging, het punt waarop nieuwe deelnemers geen nieuwe thema’s meer opleveren, en wordt gerapporteerd als een oordeel met bewijs in plaats van als formule. Haal een kwalitatief onderzoek niet door deze calculator.
Bronnen
- National Institute of Standards and Technology (NIST). (z.d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, paragraaf 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.