
Kurz gesagt
Stichprobenziehung ist der Vorgang, eine Teilmenge einer Grundgesamtheit – die Stichprobe – auszuwählen und diese Teilmenge zu untersuchen, um Schlüsse über die gesamte Grundgesamtheit zu ziehen. Forschende ziehen Stichproben, weil es meist zu langsam, zu teuer oder schlicht unmöglich ist, alle zu befragen. Die Grundgesamtheit ist die Gruppe, die Sie beschreiben möchten, die Stichprobe ist der Teil davon, den Sie tatsächlich messen, und der Stichprobenrahmen ist die Liste, aus der Sie die Stichprobe ziehen.
Probabilistische Stichprobenziehung wählt Personen über einen Zufallsmechanismus aus, sodass jede Einheit eine bekannte Auswahlwahrscheinlichkeit größer als null hat. Genau das erlaubt es Ihnen, Ihre Unsicherheit zu beziffern.
Nicht-probabilistische Stichprobenziehung wählt nach Erreichbarkeit, Quoten oder Urteil aus. Sie ist oft schneller, günstiger und manchmal die einzige ethisch vertretbare Option, kann aber keine Schätzung für die Grundgesamtheit mit angegebener Genauigkeit stützen.
Direkt zu: die 9 Verfahren im Vergleich | so wählen Sie eines | testen Sie Ihr Wissen | so beschreiben Sie es
Das Wichtigste in Kürze
- Stichprobenziehung heißt, eine Teilmenge zu untersuchen: Sie messen eine Stichprobe, um etwas über eine Grundgesamtheit zu erfahren, wenn es nicht machbar ist, alle zu messen.
- Klären Sie zuerst fünf Begriffe: Grundgesamtheit, Stichprobenrahmen, Auswahleinheit, Stichprobendesign und die Lücke zwischen der Grundgesamtheit, die Sie wollen, und der, die Sie tatsächlich erreichen. Die meisten Diskussionen über Stichproben drehen sich in Wahrheit um einen dieser Begriffe.
- Nur probabilistische Verfahren erlauben es, Ihre Unsicherheit zu beziffern. Gelegenheits-, Quoten-, bewusste und Schneeballstichproben können nützlich und ehrlich sein, aber sie können keine Schätzung für die Grundgesamtheit mit angegebener Genauigkeit stützen.
- Ihr Rahmen setzt die Obergrenze: Wenn eine Gruppe auf der Liste, aus der Sie ziehen, nicht vorkommen kann, bringt kein Verfahren und keine Menge zusätzlicher Beantwortungen sie in Ihre Ergebnisse.
- Repräsentativität ist eine Kette, kein Etikett: Rahmen, dann Auswahl, dann Rekrutierung, dann Beantwortung, dann Auswertung. Eine Zufallsziehung ist eines von fünf Gliedern.
Definition der Stichprobenziehung (und die 5 Begriffe, die sitzen müssen)
Stichprobenziehung ist der Vorgang, eine kleinere Gruppe (eine Stichprobe) aus einer größeren Gruppe (einer Grundgesamtheit) auszuwählen, damit Sie etwas über die Grundgesamtheit erfahren, ohne alle zu messen. Eine Vollerhebung ist oft nicht praktikabel, deshalb ziehen Forschende Stichproben, um die Arbeit machbar zu halten und trotzdem brauchbare Schlüsse zu gewinnen.
Die fünf Begriffe unten tragen den Großteil jedes Methodenkapitels. Liegen Sie hier falsch, zieht sich der Fehler durch jede spätere Entscheidung.
- Grundgesamtheit: die gesamte Gruppe, die Sie beschreiben möchten, mit klaren Grenzen und einem Zeitfenster formuliert. „Alle Pflegestudierenden im letzten Studienjahr an den drei Standorten, eingeschrieben zum 1. März“ ist eine Grundgesamtheit. „Pflegekräfte“ ist keine.
- Zielgrundgesamtheit vs. erreichbare Grundgesamtheit: wen Sie beschreiben wollen und wen Ihre Rekrutierung und Ihre Werkzeuge tatsächlich erreichen. Die Lücke zwischen beiden zu benennen, ist in einer Arbeit eine Stärke, keine Schwäche.
- Stichprobenrahmen: die Liste oder der Mechanismus, aus dem Sie ziehen. Ein Studierendenverzeichnis, ein Patientenregister, eine Kundendatenbank, ein Haushaltsverzeichnis eines Dorfes, ein Wählerverzeichnis. Probleme im Rahmen erzeugen Abdeckungsfehler, und kein Verfahren behebt sie.
- Auswahleinheit: das, was tatsächlich ausgewählt wird. Eine Person, ein Haushalt, eine Klinik, eine Klasse, eine Schicht, eine Bestellung. Bei Klumpen- und mehrstufigen Designs ist die Einheit der ersten Stufe eine Gruppe, und diese Gruppe heißt primäre Auswahleinheit.
- Stichprobendesign: der gesamte Plan, schriftlich festgehalten. Rahmen, Verfahren, wie viele Einheiten, wie sie kontaktiert werden und was Sie mit den Personen tun, die nicht antworten. Nach dem „Stichprobendesign“ fragen Prüfende oder Gutachtende eigentlich, wenn sie nach Ihrer Stichprobe fragen.
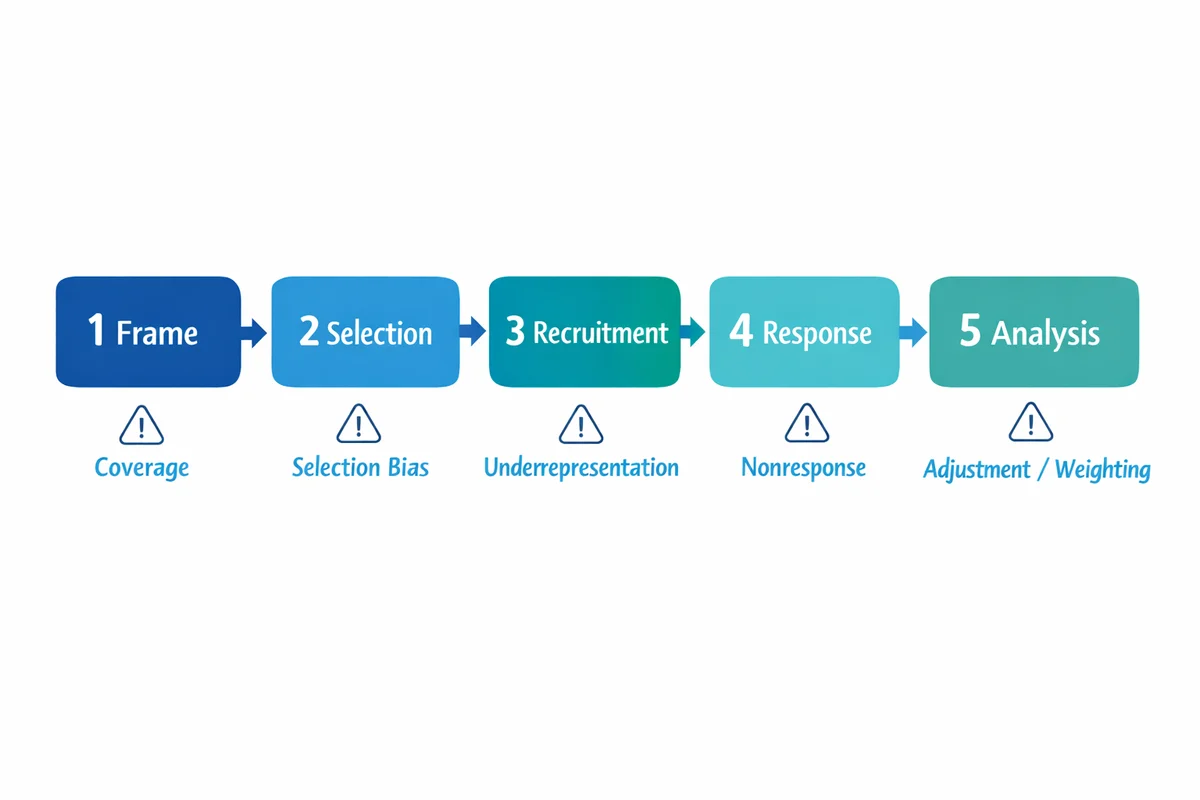
Sie können eine Zufallsauswahl wie aus dem Lehrbuch durchführen und trotzdem mit einer verzerrten Stichprobe enden. Fehlt Ihrem Rahmen ein Segment, konnte es nie gezogen werden. Antwortet ein Segment nicht, fällt es nach der Ziehung heraus. Betrachten Sie Stichprobenziehung als Kette: Rahmen, dann Auswahl, dann Rekrutierung, dann Beantwortung, dann Auswertung.
Eine kurze offizielle Definition desselben Gedankens finden Sie im Schulungshinweis des U.S. Office of Research Integrity zur Stichprobenziehung.1 Wenn Sie die Stichprobenziehung in einen größeren Studienplan einordnen, behandelt unser Leitfaden zum Forschungsdesign für Umfragen die Schritte davor und danach.
Warum überhaupt eine Stichprobe – und wann eine Vollerhebung besser ist
Der Bedarf an Stichproben ist erst praktischer, dann statistischer Natur. Vier Gründe tauchen immer wieder auf.
Kosten
Jeder zusätzliche Teilnehmer kostet Geld, Arbeitszeit oder Wohlwollen. Eine gut gezogene Stichprobe von 600 kann dieselbe Frage beantworten wie ein schlecht durchgeführter Versuch mit 60.000.
Geschwindigkeit
Entscheidungen haben Fristen. Eine Stichprobe liefert Ihnen eine Antwort innerhalb des Zeitfensters, in dem die Antwort noch nützlich ist.
Machbarkeit
Manche Grundgesamtheiten lassen sich gar nicht auflisten: Passanten auf einem Markt, Menschen, die einen Dienst abgebrochen haben, informelle Händler. Andere sind praktisch unendlich, oder das Messen einer Einheit zerstört sie.
Qualität
Dieser Punkt überrascht viele. Wenn Sie Ihren Aufwand auf eine kleinere Gruppe konzentrieren, können Sie Nichtantwortenden nachgehen, Interviewende richtig schulen und die Daten prüfen. Aufwand pro Einheit ist meist mehr wert als viele Einheiten.
Eine Vollerhebung misst dagegen alle. Sie ist die bessere Wahl, wenn die Grundgesamtheit klein genug ist, um sie zu erreichen, wenn Kontaktdaten bereits vorliegen oder wenn jedes Mitglied ein Recht darauf hat, gefragt zu werden. Eine Mitarbeiterbefragung in einer Organisation mit 200 Personen ist eine Frage der Vollerhebung, nicht der Stichprobenziehung. Eine Lehrveranstaltungsevaluation ebenso. Bei einer kleinen Grundgesamtheit bringt eine Stichprobe fast nichts und kostet Sie die Möglichkeit, nach Teams auszuwerten.
Woran man eine gute Stichprobe wirklich erkennt
Lehrbücher nennen eine gute Stichprobe „repräsentativ“, doch das ist kein überprüfbarer Test. Diese vier Eigenschaften sind es.
- Abdeckung: Jede Person der Zielgrundgesamtheit hätte grundsätzlich ausgewählt werden können.
- Kontrollierte Auswahl: Wer in der Stichprobe landet, entscheidet eine Regel, nicht wer sich freiwillig meldet oder wer der Tür am nächsten steht.
- Genug Einheiten in der kleinsten Gruppe, über die Sie berichten müssen: Eine Gesamtzahl kann gut aussehen, während die Gruppe, um die es Ihnen eigentlich geht, auf 11 Beantwortungen beruht.
- Beschreibbar: Sie können genau aufschreiben, wie sie gezogen wurde, und jemand anderes könnte es wiederholen.
| Wenn Ihr Ziel ist | Folge für die Stichprobe | Typische Falle |
|---|---|---|
| Einen Anteil in der Grundgesamtheit schätzen | Nutzen Sie ein probabilistisches Verfahren, verfolgen Sie, wer antwortet, und geben Sie die Genauigkeit zusammen mit dem Wert an. | Eine Gelegenheitsstichprobe so behandeln, als beschreibe sie die Grundgesamtheit. |
| Untergruppen vergleichen | Planen Sie die Zahl der Beantwortungen je Untergruppe, meist durch Schichtung und Überrepräsentation kleiner Gruppen. | Über eine Untergruppe berichten, deren Ergebnis auf einer Handvoll Personen beruht. |
| Erfahrungen und Mechanismen erkunden | Eine bewusste oder theoretische Auswahl ist angemessen. Begründen Sie, welche Perspektiven abgedeckt sind und welche nicht. | Einer Mindestzahl nachjagen, ohne sie begründen zu können. |
| Eine Intervention testen | Die Stichprobenziehung bestimmt, auf wen sich das Ergebnis verallgemeinern lässt. Die Zufallszuteilung bestimmt, ob der Effekt echt ist. | Zufallszuteilung mit Zufallsauswahl verwechseln. Das sind verschiedene Vorgänge. |
Eine allgemeinverständliche Darstellung, wie Stichproben Schätzungen für die Grundgesamtheit stützen, bietet als guter Einstieg der Überblick des U.S. Census Bureau zu Stichproben und Inferenz bei Umfragen.2
Ihr Stichprobenrahmen setzt die Obergrenze
Ein Stichprobenrahmen ist die konkrete Liste oder der Mechanismus, aus dem Sie ziehen. Er ist der am wenigsten diskutierte Teil der Stichprobenziehung und die Stelle, an der die meisten echten Studien still und leise scheitern, denn der Rahmen entscheidet, wer überhaupt ausgewählt werden konnte.
Rahmen sind ganz gewöhnliche Dinge. Ein Studierendenverzeichnis, ein Patientenregister, eine Personalliste, eine Kundendatenbank. Eine Liste von Dörfern mit Haushaltszahlen, ein Wählerverzeichnis, eine Reihe von Bestellungen, eine Liste der Kliniken in einem Bezirk. Beachten Sie, dass manche Rahmen Personen auflisten und manche Orte. Dieser Unterschied entscheidet, welche Verfahren Ihnen offenstehen.
| Problem | Woran man es erkennt | Was es mit Ihren Ergebnissen macht |
|---|---|---|
| Untererfassung | Personen der Grundgesamtheit fehlen auf der Liste: Beschäftigte ohne dienstliche E-Mail, Kunden, die vor Ort gekauft haben, Haushalte ohne gemeldete Adresse. | Ganze Segmente haben keine Chance, ausgewählt zu werden. Zusätzliche Beantwortungen können das nicht beheben, weil die fehlenden Personen nie auswählbar waren. |
| Übererfassung | Die Liste enthält Einheiten außerhalb Ihrer Grundgesamtheit: ehemalige Studierende, geschlossene Konten, weggezogene Personen. | Sie verschwenden Aufwand und messen, wenn Sie diese Einheiten nicht aussortieren, die falsche Grundgesamtheit. |
| Doppelungen | Dieselbe Person erscheint mehrfach: zwei E-Mail-Adressen, zwei Kontonummern. | Diese Personen haben eine höhere Auswahlchance als alle anderen, was die Annahme gleicher Chancen unbemerkt verletzt. |
| Veraltete Einträge | Die Liste war bei ihrer Erstellung korrekt und ist es heute nicht mehr. | Unzustellbare Kontakte sehen wie Verweigerungen aus, sodass sowohl Ihre Rücklaufquote als auch Ihre Diagnose der Verzerrung falsch ausfallen. |
Prüfen Sie den Rahmen vor der Ziehung, nicht danach. Zählen Sie die Zeilen. Vergleichen Sie diese Zahl mit jeder unabhängigen Gesamtzahl, die Sie finden können, etwa der Mitarbeiterzahl laut Personalabteilung oder einer Einschreibungszahl. Suchen Sie das Segment, dessen Fehlen Ihnen am peinlichsten wäre, und prüfen Sie, ob es vorhanden ist. Entfernen Sie Doppelungen. Schreiben Sie auf, was der Rahmen ausschließt, denn dieser Satz gehört so oder so in Ihre Limitationen.
Gelegenheits-, Quoten-, bewusste und Schneeballstichproben brauchen überhaupt keine Liste. Klumpen- und mehrstufige Stichproben brauchen nur eine Liste von Gruppen (Schulen, Kliniken, Stationen, Dörfer), keine Liste von Personen. Einfache Zufallsstichproben, systematische und geschichtete Stichproben brauchen alle eine vollständige Liste der Einzelpersonen, bevor Sie beginnen können. Haben Sie keine Liste und können auch keine erstellen, schließt allein diese Tatsache drei der neun Verfahren auf dieser Seite aus. Meist ist das der erste Punkt, den Sie klären sollten.
Die 9 Stichprobenverfahren im Vergleich
Stichprobenverfahren teilen sich in zwei Familien. Probabilistische Stichprobenziehung nutzt einen Zufallsmechanismus, sodass jede Einheit im Rahmen eine bekannte Auswahlwahrscheinlichkeit größer als null hat. Nicht-probabilistische Stichprobenziehung tut das nicht, daher sind die Auswahlwahrscheinlichkeiten unbekannt. Alles andere folgt aus dieser einen Unterscheidung.
Die zweite Spalte lassen die meisten Leitfäden weg, deshalb steht sie hier vorn. Nur ein probabilistisches Design stützt eine Fehlerspanne, ein Konfidenzintervall oder den Satz „plus/minus 5 Punkte“. Steht bei einem Verfahren dort „Nein“, können Sie trotzdem viel daraus lernen. Sie können nur keine Genauigkeitsangabe zusammen mit dem Ergebnis veröffentlichen. Die Genauigkeit selbst ist ein eigenes Thema, das unser Leitfaden zur Stichprobengröße behandelt.
| Verfahren | Stützt eine Fehlerspanne? | So funktioniert es | Richtige Wahl, wenn | Was es kostet und welche Verzerrung es begünstigt |
|---|---|---|---|---|
| Einfache Zufallsstichprobe Probabilistisch Braucht eine vollständige Liste |
Ja | Jede Einheit auf der Liste hat die gleiche Chance. Sie ziehen die benötigte Anzahl zufällig. | Sie haben eine saubere Liste ohne Doppelungen und keine Untergruppe, über die Sie gesondert berichten müssen. | KostenSie brauchen die vollständige Liste, und kleine Gruppen können zu klein für eine Auswertung ausfallen.VerzerrungBei der Auswahl kaum. Das gesamte verbleibende Risiko verlagert sich darauf, wer tatsächlich antwortet. |
| Systematische Stichprobe Probabilistisch Braucht eine vollständige Liste |
Ja, wenn die Reihenfolge der Liste nichts mit dem Ergebnis zu tun hat | Sortieren Sie die Liste, wählen Sie einen zufälligen Startpunkt und nehmen Sie dann jeden k-ten Eintrag. | Die Liste ist lang oder kommt als laufender Strom, und ein Feldteam braucht eine einzige einfache Regel. | KostenFast keine, solange die Reihenfolge nichts mit dem zu tun hat, was Sie messen.VerzerrungPeriodizität. Wiederholt sich die Liste in einem Zyklus, der zu Ihrem Intervall passt, treffen Sie immer wieder dieselbe Art von Einheit. |
| Geschichtete Stichprobe Probabilistisch Braucht eine vollständige Liste |
Ja, und meist enger als bei der einfachen Zufallsstichprobe | Teilen Sie die Liste in relevante Gruppen (Schichten) und ziehen Sie innerhalb jeder Gruppe eine Stichprobe. | Sie müssen nach Region, Fakultät, Abteilung oder Altersgruppe berichten, oder Sie erwarten, dass sich das Antwortverhalten zwischen Gruppen stark unterscheidet. | KostenDas Schichtungsmerkmal muss vor der Ziehung auf der Liste stehen, und ungleiche Auswahlquoten müssen bei der Auswertung gewichtet werden.VerzerrungGering. Das eigentliche Risiko sind Schichten, die nichts mit dem Ergebnis zu tun haben – das macht Arbeit und bringt keine Genauigkeit. |
| Klumpenstichprobe Probabilistisch Braucht eine Liste von Gruppen |
Ja, erweitert um den Designeffekt | Wählen Sie ganze Gruppen zufällig aus (Schulen, Kliniken, Stationen, Dörfer) und befragen Sie dann alle in den ausgewählten Gruppen. | Sie können keine Einzelpersonen auflisten, wohl aber die Orte, an denen sie zu finden sind, und Reise- oder Einrichtungskosten bestimmen das Budget. | KostenGenauigkeit. Personen innerhalb einer Gruppe ähneln einander, daher bringt jede zusätzliche Beantwortung weniger neue Information.VerzerrungGering, wenn die Gruppen zufällig gewählt werden, aber wenige Gruppen machen das Ergebnis instabil und schwer zu verteidigen. |
| Mehrstufige Stichprobe Probabilistisch Braucht eine Liste von Gruppen |
Ja, mit Gewichten und einem Designeffekt | Ziehen Sie zuerst Gruppen und dann Einheiten innerhalb der ausgewählten Gruppen, in zwei oder mehr Stufen. | Bezirksweite oder landesweite Studien, bei denen es keine einzelne Personenliste gibt, wohl aber Verwaltungseinheiten. | KostenKomplexität. Die Auswahlwahrscheinlichkeiten unterscheiden sich zwischen den Einheiten, daher braucht die Auswertung Gewichte und jemanden, der sie anwenden kann.VerzerrungIm Prinzip gering. In der Praxis ist jede Stufe eine neue Gelegenheit für das Feldteam, vom Plan abzuweichen. |
| Gelegenheitsstichprobe Nicht-probabilistisch Keine Liste nötig |
Nein | Sie nehmen, wen Sie am leichtesten erreichen: ein Pop-up auf einer Website, eine Klasse, die Sie unterrichten, Menschen, die an einem Stand vorbeigehen. Auch Ad-hoc-Stichprobe genannt. | Sie erkunden ein Thema, testen einen Fragebogen in einer Pilotstudie oder brauchen diese Woche eine Richtung statt im nächsten Quartal einer belastbaren Zahl. | KostenDie Aussagekraft. Sie verzichten darauf, irgendetwas über die Grundgesamtheit zu sagen.VerzerrungSelbstselektion. Erreichbare, verfügbare und bereits engagierte Personen sind überrepräsentiert. |
| Quotenstichprobe Nicht-probabilistisch Keine Liste nötig |
Nein. Sie wirkt ausgewogen, ohne zufällig zu sein | Legen Sie Zielzahlen für Gruppen fest, zum Beispiel 50 Frauen und 50 Männer oder 40 ländlich und 60 städtisch, und rekrutieren Sie, bis jede Quote erfüllt ist. | Sie brauchen schnell eine Stichprobe, die der Grundgesamtheit zumindest in sichtbaren Merkmalen entspricht, ohne Liste, aus der Sie ziehen könnten. | KostenDie Kontrolle darüber, wer jede Quote füllt. Rekrutierende wählen weiterhin aus, und sie wählen die Zugänglichen.VerzerrungAuswahlverzerrung innerhalb der Quoten. Übereinstimmung bei Alter und Geschlecht macht Menschen in ihren Einstellungen nicht typisch. |
| Bewusste Auswahl Nicht-probabilistisch Keine Liste nötig |
Nein, und das ist auch nicht das Ziel | Sie wählen gezielt Fälle aus, die festgelegte Kriterien erfüllen: Fachleute, Extremfälle, typische Fälle, kritische Fälle. Auch urteilsbasierte Auswahl genannt. | Qualitative Forschung, Experteninterviews, Fallstudien und jede Frage, bei der Tiefe wichtiger ist als Zählen. | KostenKeine, sofern Sie klarstellen, dass Sie nie gezählt haben.VerzerrungDie eigene Vorstellung der Forschenden davon, wer als relevant gilt. |
| Schneeballverfahren Nicht-probabilistisch Keine Liste nötig |
Nein | Rekrutieren Sie einige Teilnehmende und bitten Sie dann jede Person, weitere zu empfehlen, die die Kriterien erfüllen. | Die Gruppe ist verborgen, stigmatisiert, selten oder nirgends erfasst: Wanderarbeiter, Menschen, die einen Dienst verlassen haben, informelle Händler, Menschen mit einer seltenen Erkrankung. | KostenZeit und die Kontrolle über die Zusammensetzung der Stichprobe. Sie übernehmen das soziale Netzwerk derjenigen, mit denen Sie begonnen haben.VerzerrungHomophilie. Menschen empfehlen Menschen, die ihnen ähneln, sodass ein Winkel der Grundgesamtheit überrepräsentiert wird. |
So lesen Sie die Tabelle: Die ersten fünf Verfahren sind probabilistische Designs, die letzten vier nicht. Diese eine Trennung, nicht die einzelnen Verfahrensnamen, entscheidet, ob eine Genauigkeitsangabe ehrlich ist.
Probabilistische Stichprobenverfahren im Einzelnen
Probabilistische Stichprobenziehung bedeutet, dass jede Einheit im Rahmen eine bekannte Auswahlwahrscheinlichkeit größer als null hat und ein Zufallsmechanismus die Auswahl trifft. Das ist die gesamte Grundlage dafür, überhaupt etwas Zahlenmäßiges über die Grundgesamtheit zu sagen. Fünf Designs decken fast jede reale Studie ab. Übersichtsarbeiten aus der klinischen und der Gesundheitsforschung behandeln dieselbe Familie unter leicht anderen Bezeichnungen, und es lohnt sich, den Grund zu kennen, bevor Sie beiden begegnen: Beide hier zitierten Arbeiten fassen die mehrstufige Stichprobe unter die Klumpenstichprobe, statt sie gesondert aufzuführen.34
Einfache Zufallsstichprobe
Die einfache Zufallsstichprobe gibt jeder Einheit auf der Liste genau die gleiche Auswahlchance. Sie nummerieren die Liste, erzeugen Zufallszahlen und nehmen die Einheiten, auf die sie fallen.
Durchgerechnetes Beispiel. Ein Hochschulverzeichnis enthält 12.000 eingeschriebene Studierende, und Sie brauchen 400 Beantwortungen. Nummerieren Sie das Verzeichnis von 1 bis 12.000, erzeugen Sie mit einer Tabellenkalkulation oder einem Statistikprogramm 400 eindeutige Zufallszahlen in diesem Bereich und laden Sie diese Studierenden ein. Erwarten Sie eine Rücklaufquote von 40 Prozent, ziehen Sie 1.000 und laden Sie sie ein, damit 400 vollständige Beantwortungen realistisch sind.
Wo sie versagt. Bei 400 Beantwortungen aus einem Verzeichnis mit 12.000 Studierenden steuert ein Fachbereich mit 300 Studierenden etwa 10 Personen bei. Das reicht nicht für eine Auswertung. Muss irgendeine Untergruppe in Ihren Ergebnissen erscheinen, ist die einfache Zufallsstichprobe das falsche Werkzeug, und die geschichtete Stichprobe ist die Lösung.
Dokumentieren Sie Ihre Zufallsauswahl. Verwendete Software, den Startwert (Seed), falls es einen gab, und das Datum. Genau dieser eine Satz macht die Ziehung reproduzierbar, und Gutachtende fragen tatsächlich danach.
Systematische Stichprobe
Die systematische Stichprobe nimmt nach einem zufälligen Start jede k-te Einheit aus einer geordneten Liste. Teilen Sie die Listengröße durch die benötigte Anzahl, um das Intervall k zu erhalten, wählen Sie eine Zufallszahl zwischen 1 und k als Startpunkt und zählen Sie dann weiter.
Durchgerechnetes Beispiel. Ein Kreiskrankenhaus verzeichnet 9.000 ambulante Besuche pro Quartal und möchte 600 Patienten beim Verlassen befragen. Das Intervall ist 9.000 geteilt durch 600, also k gleich 15. Wählen Sie einen zufälligen Start zwischen 1 und 15, etwa 7, und befragen Sie dann Besuch 7, 22, 37, 52 und so weiter. Ein Feldteam kann diese Regel ohne Laptop befolgen – der eigentliche Grund, warum sich dieses Verfahren hält.
Wo sie versagt. Periodizität. Hat die Liste einen wiederkehrenden Zyklus, der zu k passt, erwischen Sie jedes Mal denselben Platz. Eine nach Sprechstundentag sortierte Besuchsliste mit einem 7-Tage-Zyklus und einem Intervall von 7 würde Ihnen nur einen einzigen Wochentag liefern. Prüfen Sie die Reihenfolge, bevor Sie k festlegen, und mischen Sie die Liste, wenn die Reihenfolge mit dem zusammenhängt, was Sie messen.
Geschichtete Stichprobe
Die geschichtete Stichprobe teilt die Grundgesamtheit in sich nicht überschneidende Gruppen, sogenannte Schichten, und zieht dann innerhalb jeder Schicht eine Zufallsstichprobe. Sie ist für die meisten Studien die nützlichste verfügbare Verbesserung, weil sie garantiert, dass jede Gruppe, über die Sie berichten müssen, tatsächlich vorkommt.
Durchgerechnetes Beispiel mit Rechenweg. Eine Organisation hat 4.200 Beschäftigte in sechs Provinzen und braucht 600 Beantwortungen.
- Proportionale Aufteilung. Eine Provinz mit 1.400 Beschäftigten umfasst 1.400 geteilt durch 4.200, also ein Drittel der Belegschaft, und erhält daher ein Drittel von 600, also 200 Beantwortungen. Eine Provinz mit 210 Beschäftigten erhält 210 geteilt durch 4.200 mal 600, also 30 Beantwortungen. Jede Provinz ist im Verhältnis zu ihrer Größe vertreten, und bei der Auswertung ist keine Gewichtung nötig.
- Disproportionale Aufteilung, auch Oversampling genannt. Dreißig Beantwortungen sind zu wenig, um über diese kleine Provinz gesondert zu berichten. Also nehmen Sie bewusst 80 aus ihr und verkleinern zum Ausgleich die größte Provinz. Nun unterscheiden sich die Auswahlwahrscheinlichkeiten zwischen den Provinzen, daher müssen Sie die Daten auf die wahren Anteile zurückgewichten, bevor Sie eine organisationsweite Zahl nennen. Diesen Schritt auszulassen, ist der häufigste Fehler bei geschichteten Stichproben.
Schichten wählen. Wählen Sie Merkmale, die mit dem Ergebnis oder mit der Antwortbereitschaft zusammenhängen und die bereits in Ihrem Rahmen stehen. Region, Standort, Funktion, Betriebszugehörigkeit, Studiengang, Tariftyp und Altersgruppe sind die üblichen Kandidaten. Schichten, die nichts mit dem Ergebnis zu tun haben, erhöhen den Verwaltungsaufwand und bringen keine Genauigkeit. Fehlt das Schichtungsmerkmal in Ihrem Rahmen, müssen Sie es eventuell stattdessen im Fragebogen erheben. Unser Leitfaden zu demografischen Fragen in Umfragen zeigt, wie Sie diese Merkmale abfragen, ohne Teilnehmer zu verlieren.
Klumpenstichprobe
Die Klumpenstichprobe wählt ganze, natürlich vorkommende Gruppen zufällig aus und befragt dann alle in den ausgewählten Gruppen. Sie brauchen eine Liste der Gruppen, keine Liste der Personen – genau dafür gibt es dieses Verfahren.
Durchgerechnetes Beispiel. Ein Bezirk hat 180 Grundschulen und keine zentrale Schülerliste. Sie wählen zufällig 24 Schulen aus und befragen in jeder alle Schüler der Jahrgangsstufe 8. Sie haben 24 statt 180 Schulbesuche gemacht und zu Beginn nie ein Schülerverzeichnis gebraucht.
Was Sie dafür bezahlen. Schüler derselben Schule ähneln einander stärker als Schülern im übrigen Bezirk. Daher bringt jeder zusätzliche Schüler in einer bereits gewählten Schule weniger neue Information als ein unabhängiger Schüler. Ihre effektive Zahl an Beantwortungen ist kleiner als Ihre tatsächliche. Diese Aufblähung ist der Designeffekt, und er muss in den Plan eingebaut werden, statt erst bei der Auswertung entdeckt zu werden.
Wo sie versagt. Zu wenige Klumpen. Sechs zufällig gewählte Schulen können sich stark voneinander unterscheiden, und das Ergebnis hängt davon ab, welche sechs Sie zufällig gezogen haben. Mehr Klumpen mit weniger Personen in jedem sind fast immer besser als umgekehrt.
Mehrstufige Stichprobe
Die mehrstufige Stichprobe wählt in zwei oder mehr Stufen aus: zuerst Gruppen, dann Einheiten innerhalb der ausgewählten Gruppen und manchmal eine dritte Stufe innerhalb dieser. Fast jede nationale Haushaltsbefragung der Welt ist so aufgebaut.
Durchgerechnetes Beispiel. Wählen Sie 120 Wahlbezirke aus der nationalen Liste der Wahlbezirke aus. In jedem ausgewählten Bezirk erfasst ein Feldteam die Haushalte vor Ort und wählt dann zufällig 20 davon aus. In jedem ausgewählten Haushalt wird eine erwachsene Person zufällig bestimmt, statt es der Person zu überlassen, die die Tür öffnet. Das sind drei Stufen, und die letzte zählt: Wenn der Haushalt entscheidet, wer antwortet, kehrt genau die Auswahlverzerrung zurück, die das Design vermeiden sollte.
Was Sie dafür bezahlen. Verschiedene Personen haben am Ende unterschiedliche Auswahlwahrscheinlichkeiten, daher braucht die Auswertung Gewichte, und die Varianzberechnung muss die Klumpung auf jeder Stufe berücksichtigen. Das ist ein anspruchsvolles Design, für das jemand eine gewichtete Auswertung durchführen können muss. Kann das niemand im Projekt, wählen Sie lieber ein einfacheres Design als ein ungewichtetes mehrstufiges.
Für Fortgeschrittene: größenproportionale Auswahl und warum große Klumpen öfter gezogen werden
Im Schulbeispiel hatte jede Schule dieselbe Auswahlchance, ob sie 60 oder 900 Schüler hatte. Dadurch hat ein Schüler einer kleinen Schule eine viel höhere Chance, in die Stichprobe zu gelangen, als ein Schüler einer großen. Die Auswertung muss das dann korrigieren.
Die größenproportionale Auswahl (PPS) behebt das schon im Design. Die Auswahlchance jedes Klumpens wird proportional zur Zahl seiner Einheiten festgelegt. Eine Schule mit 900 Schülern wird dann fünfzehnmal so wahrscheinlich gezogen wie eine Schule mit 60 Schülern. Anschließend nehmen Sie aus jeder ausgewählten Schule dieselbe Zahl von Schülern. Die beiden Stufen gleichen sich aus, und jeder Schüler im Bezirk hat am Ende ungefähr dieselbe Gesamtchance, ausgewählt zu werden. Das ist das Standardvorgehen bei nationalen Erhebungen, und es setzt vor der Ziehung für jeden Klumpen im Rahmen eine Größenangabe voraus.
Geschichtete Stichprobe vs. Klumpenstichprobe: der Unterschied in einem Satz
Diese beiden werden ständig verwechselt, weil beide damit beginnen, die Grundgesamtheit in Gruppen zu teilen. Der Unterschied liegt im nächsten Schritt.
| Aspekt | Geschichtete Stichprobe | Klumpenstichprobe |
|---|---|---|
| Welche Gruppen Sie nutzen | Aus jeder Gruppe wird gezogen. | Einige Gruppen werden ausgewählt, die übrigen gar nicht genutzt. |
| Wen Sie innerhalb einer Gruppe ziehen | Eine zufällige Teilmenge der Gruppe. | Alle in der Gruppe oder, in der mehrstufigen Variante, eine weitere zufällige Teilmenge. |
| Die Gruppen sollten sein | In sich ähnlich und untereinander verschieden. Region, Funktion, Studiengang. | In sich vielfältig, jede ein kleines Abbild der Grundgesamtheit. Schulen, Kliniken, Stationen. |
| Warum Sie es wählen würden | Genauigkeit und garantierte Vertretung der Untergruppen. | Kosten und Erreichbarkeit, wenn es keine Liste der Einzelpersonen gibt. |
| Wirkung auf die Genauigkeit | Verbessert sie meist gegenüber der einfachen Zufallsstichprobe bei gleicher Zahl an Beantwortungen. | Verringert sie. Planen Sie den Designeffekt ein. |
| Was Sie vor dem Start brauchen | Eine vollständige Liste der Einzelpersonen, in der das Schichtungsmerkmal bereits steht. | Nur eine Liste der Gruppen. |
Geschichtet: alle Gruppen, einige der Personen. Klumpen: einige der Gruppen, alle Personen. Bei der Schichtung geht es um Genauigkeit, bei der Klumpenstichprobe um Zugang.
Nicht-probabilistische Stichprobenverfahren im Einzelnen
Nicht-probabilistische Stichprobenziehung bedeutet, dass die Auswahlwahrscheinlichkeiten unbekannt sind, weil kein Zufallsmechanismus entschieden hat, wer ausgewählt wurde. In vier Situationen ist sie die richtige Wahl. Sie können keinen brauchbaren Rahmen erstellen. Die Gruppe ist verborgen. Geschwindigkeit zählt mehr als Genauigkeit. Oder es geht um Bedeutung statt um Größenordnung.
Diese Verfahren sind nicht zweitklassig. Sie beantworten eine andere Frage. Der Fehler ist nie, sie zu verwenden, sondern sie zu verwenden und dann einen Satz zu schreiben, den nur eine probabilistische Stichprobe stützen könnte.
Gelegenheitsstichprobe
Die Gelegenheitsstichprobe, auch Ad-hoc-Stichprobe genannt, rekrutiert, wen man am leichtesten erreicht. Ein Pop-up auf einer Website, ein Link in einem Newsletter, Studierende in Ihrem eigenen Kurs, Menschen, die auf einem Markt an einem Stand vorbeigehen.
Beispiel. Ein Geschäft druckt einen Feedback-Link auf den Kassenbon. Alle, die antworten, haben etwas gekauft, hatten ein Telefon dabei, hatten Zeit und einen Grund, sich die Mühe zu machen. Jeder dieser Filter entfernt einen anderen Teil der Kundschaft.
Ehrlicher Einsatz. Einen Fragebogen in einer Pilotstudie testen, Hypothesen entwickeln, herausfinden, welche Sprache Kunden verwenden, prüfen, ob eine Frage verstanden wird. Alles hervorragende Einsatzzwecke. Keiner davon erfordert eine Schätzung für die Grundgesamtheit.
Quotenstichprobe
Die Quotenstichprobe legt Rekrutierungsziele für benannte Gruppen fest und füllt sie. Vierzig ländlich und sechzig städtisch. Fünfzig Frauen und fünfzig Männer. Zwanzig in jeder von fünf Altersgruppen.
Beispiel. Ein Marktforschungsteam braucht 500 Beantwortungen, die der landesweiten Verteilung nach Alter, Geschlecht und Region entsprechen, und hat keine Liste der Grundgesamtheit. Es rekrutiert, bis jede Zelle gefüllt ist.
Warum es trotzdem keine probabilistische Stichprobenziehung ist. Die Quoten steuern die Zusammensetzung der Stichprobe, nicht die Auswahl der Personen darin. Wer rekrutiert, wählt weiterhin aus, und leicht ansprechbare Menschen unterscheiden sich systematisch von schwer ansprechbaren. Eine Stichprobe kann der Grundgesamtheit bei Alter und Geschlecht perfekt entsprechen und bei Einstellungen trotzdem weit danebenliegen, weil Alter und Geschlecht nie die Merkmale waren, die den Schaden anrichten.
Bewusste Auswahl
Die bewusste Auswahl, auch urteilsbasierte Auswahl genannt, wählt gezielt Fälle aus, die festgelegte Kriterien erfüllen. Übliche Varianten sind die Auswahl typischer Fälle, extremer Fälle, kritischer Fälle, maximaler Variation und von Fachleuten.
Beispiel. Eine Studie dazu, wie ein neues Zahlungssystem genutzt wird, wählt acht Personen aus. Zwei, die es täglich nutzen, zwei, die es aufgegeben haben, zwei, die es nie übernommen haben, und zwei Support-Mitarbeitende, die Beschwerden bearbeiten. Diese Streuung ist bewusst gewählt, und die Begründung ist die Methode.
Ehrlicher Einsatz. Der Großteil qualitativer Forschung. Der Maßstab ist hier nicht der Zufall. Er lautet, ob Sie sagen können, warum diese Fälle und keine anderen, und ob die Bandbreite der Sichtweisen groß genug ist, um Ihre Aussagen zu stützen.
Schneeballverfahren
Das Schneeballverfahren rekrutiert eine kleine Zahl von Teilnehmenden, die dann weitere Personen empfehlen, die die Kriterien erfüllen, und diese empfehlen wiederum weitere.
Beispiel. Eine Studie über informelle grenzüberschreitende Händler beginnt mit vier Teilnehmenden, die über einen lokalen Verband gefunden wurden, und jede Person stellt zwei weitere vor. Es gibt kein Register informeller Händler, daher steht kein rahmenbasiertes Verfahren zur Verfügung.
Was es mit Ihrer Stichprobe macht. Homophilie. Menschen empfehlen Menschen, die ihnen ähneln. Die Stichprobe driftet in ein soziales Netzwerk und weg von isolierten Mitgliedern der Grundgesamtheit, die oft genau diejenigen sind, die die Forschung am dringendsten hören müsste. Mit mehreren unverbundenen Startpersonen statt einer zu beginnen, verringert die Drift, beseitigt sie aber nicht.
So machen Sie eine nicht-probabilistische Stichprobe belastbar
Die meisten Leitfäden hören bei „Sie können nicht verallgemeinern“ auf und lassen die Lesenden im Stich, denn die meisten führen genau diese Art von Studie durch. Hier ist der Teil, der normalerweise fehlt.
- Beschreiben Sie die Rekrutierung, nicht nur den Namen des Verfahrens. Wo der Link veröffentlicht wurde, in welchem Zeitraum, wer ihn gesehen hat, ob ein Anreiz angeboten wurde und wie viele angesprochen wurden im Vergleich dazu, wie viele geantwortet haben. Erst so können Lesende die Stichprobe beurteilen, statt zu raten.
- Vergleichen Sie Ihre erreichte Stichprobe mit einem bekannten Referenzwert und veröffentlichen Sie den Vergleich. Besteht Ihre Organisation zu 60 Prozent aus Außendienstpersonal und Ihre Teilnehmer nur zu 25 Prozent, zeigen Sie das in einer Tabelle. Eine offengelegte Schieflage ist ein Befund. Eine verborgene ist ein Mangel.
- Wissen Sie, was Gewichtung leisten kann und was nicht. Die Daten so anzupassen, dass die Demografie der Grundgesamtheit entspricht, kann ein sichtbares Ungleichgewicht korrigieren. Sie kann nicht ausgleichen, dass sich Menschen von den Teilnehmern in etwas unterscheiden, das Sie nicht gemessen haben, und sie macht eine nicht-probabilistische Stichprobe nie zu einer, die eine Genauigkeitsaussage stützt.
- Ändern Sie den Satz, nicht die Statistik. Statt „38 Prozent der Kunden sind unzufrieden, plus/minus 4 Punkte“ schreiben Sie: „38 Prozent der 620 Kunden, die geantwortet haben, gaben an, unzufrieden zu sein. Die Teilnehmer wurden über zwei Wochen per In-App-Hinweis gewonnen und sind keine Zufallsstichprobe der Kunden.“ Der zweite Satz ist kürzer, nützlicher und unangreifbar.
Qualitative Forschung hat dafür ihr eigenes Vokabular. Ein Protokoll verlangt meist eine Begründung statt einer Zielzahl. Es sollte die geplante Anzahl und die Bandbreite der Sichtweisen abdecken – eine Unterscheidung, die der Leitfaden der University of Bath knapp formuliert.5
Das passende Verfahren für jede Situation
Sechs Situationen, sechs Verfahren. Entscheiden Sie sich, bevor Sie die Antwort aufklappen. So finden Sie am schnellsten heraus, ob die Tabelle oben wirklich angekommen ist.
1. Sie haben ein vollständiges Personalverzeichnis mit 4.200 Personen und müssen Ergebnisse für jede von sechs Provinzen veröffentlichen.
Geschichtete Stichprobe. Die vollständige Liste existiert, also steht Ihnen die probabilistische Stichprobenziehung offen, und die Pflicht, nach Provinzen zu berichten, ist genau das, wofür Schichtung da ist. Eine einfache Zufallsstichprobe würde der kleinsten Provinz zu wenige Beantwortungen für eine Auswertung lassen.
2. Sie untersuchen Menschen, die einen Dienst vor sechs Monaten verlassen haben. Es gibt keine Liste, und die, die am verärgertsten gegangen sind, sind am schwersten zu finden.
Schneeballverfahren. Es gibt keinen Rahmen und die Grundgesamtheit ist schwer erreichbar, was jedes probabilistische Verfahren ausschließt. Beginnen Sie mit mehreren unverbundenen Startpersonen statt einer und halten Sie in Ihren Limitationen fest, dass Empfehlungsketten die Stichprobe zugunsten gut vernetzter Menschen verzerren.
3. Ein Krankenhaus möchte Daten zur Patientenerfahrung aus einem Strom von 9.000 Besuchen pro Quartal, erhoben von Personal ohne Computer am Empfang.
Systematische Stichprobe. Die Grundgesamtheit kommt als geordneter Strom, daher ist eine Intervallregel sowohl ein probabilistisches Verfahren als auch etwas, das ein voll ausgelasteter Empfang tatsächlich umsetzen kann. Prüfen Sie zuerst, dass die Besuchsreihenfolge keinem Wochenzyklus folgt, der zu Ihrem Intervall passt.
4. Sie müssen verstehen, warum ein neues Tool aufgegeben wird, und haben drei Wochen und kein Budget.
Bewusste Auswahl. Es geht um den Mechanismus, nicht um die Größenordnung. Wählen Sie gezielt über die ganze Bandbreite aus: Intensivnutzer, Abbrecher, Nichtnutzer, Support-Personal. Berichten Sie daraus keine Prozentwerte.
5. Ein Bezirk hat 180 Schulen, kein Schülerverzeichnis und ein Reisebudget für etwa 25 Besuche vor Ort.
Klumpenstichprobe. Eine Liste der Schulen existiert, auch wenn es keine Schülerliste gibt, und die Reisekosten sind die entscheidende Einschränkung. Erweitern Sie Ihr angegebenes Intervall um den Designeffekt und wählen Sie lieber mehr Schulen mit jeweils weniger Schülern als umgekehrt.
6. Sie müssen in fünf Tagen 500 Beantwortungen erheben, die dem landesweiten Profil nach Alter und Region entsprechen, und es gibt keine Liste der Grundgesamtheit.
Quotenstichprobe. Sie ist der schnellste Weg zu einer Stichprobe, die der Grundgesamtheit zumindest in sichtbaren Merkmalen entspricht. Sie ist trotzdem keine probabilistische Stichprobe, also berichten Sie die Zusammensetzung und verzichten Sie auf die Genauigkeitsaussage.
So wählen Sie ein Stichprobenverfahren
Die meisten Studien scheitern nicht daran, dass jemand die falsche benannte Technik gewählt hat. Sie scheitern, weil die Technik nicht zum Rahmen, zur Entscheidung oder zu dem passte, was das Feldteam realistisch leisten konnte. Drei Fragen klären es fast immer.
Welches Verfahren passt zu Ihrer Studie?
Beantworten Sie drei Fragen. Die Empfehlung erscheint unten, und die passenden Zeilen werden in der Vergleichstabelle hervorgehoben.
Beginnen Sie mit der Aussage, die Sie treffen müssen
Schreiben Sie den Satz auf, den Sie veröffentlichen möchten, bevor Sie irgendetwas wählen. „Zweiundsechzig Prozent unserer Kunden würden uns weiterempfehlen“ und „Kunden, die abwandern, beschreiben drei wiederkehrende Probleme“ sind verschiedene Sätze, die verschiedene Designs brauchen. Wenn niemand das Ergebnis als Zahl für die Grundgesamtheit behandeln wird, haben Sie weit mehr Freiheit, als Sie denken.
Prüfen Sie den Rahmen, bevor Sie sich festlegen
Können Sie die Grundgesamtheit oder eine gute Annäherung tatsächlich auflisten? Falls nicht, können Sie die Gruppen auflisten, denen sie angehört? Diese eine Frage zu beantworten, scheidet die meisten der neun Verfahren sofort aus – deshalb steht sie an zweiter Stelle und nicht zuletzt.
Benennen Sie die Untergruppen, über die Sie berichten müssen
Muss ein Ergebnis für jede Region, jeden Standort oder jede Funktion erscheinen, bestimmt das das Design über Schichten oder Quoten. Es bestimmt auch, wie viele Beantwortungen Sie in jeder Gruppe brauchen. Das erst nach der Feldphase zu entscheiden, lässt sich nicht mehr retten.
Gleichen Sie das Design mit der Realität im Feld ab
Zeit, Budget, Erreichbarkeit, sprachlicher Zugang, Lesefähigkeit, Internetanbindung und Anreizregeln entscheiden, was umsetzbar ist. Ein Design, dem ein Feldteam nicht folgen kann, wird zu einer Gelegenheitsstichprobe mit förmlichem Namen – schlimmer, als ehrlich eine Gelegenheitsstichprobe zu wählen. Eine inklusive Planung der Rekrutierung verringert systematische Unterrepräsentation.6 Sobald Sie die Stichprobe ausgewählt haben, erstellen Sie den Fragebogen mit einem Online-Umfrage-Tool und senden ihn an die Personen, die Ihr Stichprobenplan bestimmt hat. Ein frei zugänglicher öffentlicher Link verändert, wer antworten kann; er erhält keine Zufallsstichprobe.
Wo Stichproben wirklich scheitern: Abdeckung, Auswahl und Nonresponse
Die Auswahl ist der Teil, um den sich alle sorgen, und der Teil, der am seltensten schiefgeht. Der Schaden entsteht meist vor der Auswahl, im Rahmen, oder danach, bei der Frage, wer sich die Mühe macht zu antworten. Beides erzeugt sauber aussehende Tabellen und falsche Schlüsse.
| Fehler | Woran man ihn erkennt | So verringern Sie ihn |
|---|---|---|
| Abdeckungsfehler, ein Problem des Rahmens | Manche Personen können gar nicht ausgewählt werden: keine dienstliche E-Mail, eine veraltete Liste, Kunden, die nur vor Ort kaufen, Haushalte ohne Internetanschluss. | Verbessern oder kombinieren Sie Rahmen. Ergänzen Sie Erhebungswege: Papier, persönlich, Telefon, SMS. Dokumentieren Sie genau, wer ausgeschlossen ist. |
| Auswahlverzerrung, ein Problem des Vorgehens | Die Zufallsregel wird in der Praxis ausgehebelt. Wer zuerst kommt, ist dabei. Eine Führungskraft bestimmt, wer teilnimmt. | Automatisieren Sie die Ziehung. Trennen Sie die Person, die auswählt, von der Person, die rekrutiert. Prüfen Sie jede Ausnahme. |
| Nonresponse-Verzerrung, ein Problem des Ergebnisses | Ausgewählte Personen antworten nicht, und wer nicht antwortet, unterscheidet sich in dem, was Sie messen, von denen, die antworten. | Verbessern Sie die Kontaktstrategie und das Erlebnis beim Ausfüllen des Fragebogens und vergleichen Sie die Teilnehmer dann mit einem bekannten Referenzwert. Siehe Antwortverzerrung. |
| Messfehler | Eine einwandfreie Stichprobe liefert trotzdem Unsinn, weil die Fragen suggestiv oder vage sind oder zwei Dinge auf einmal abfragen. | Testen Sie das Instrument vor der Feldphase. Unser Leitfaden zum Formulieren von Umfragefragen behandelt die häufigen Fehler. |
Das berühmteste Stichprobenversagen hatte 2,4 Millionen Teilnehmer
1936 sagte der Literary Digest voraus, dass Alf Landon rund 55 Prozent der Stimmen erhalten würde. Franklin Roosevelt gewann etwa 61 Prozent.7 Die Zeitschrift hatte 10 Millionen Stimmzettel verschickt und etwa 2,4 Millionen zurückerhalten – eine Rücklaufquote von 24 Prozent, an die heute keine landesweite Umfrage auch nur herankommt.8 Die Umfrage sah Roosevelt zwanzig Punkte unter seinem tatsächlichen Anteil, bei einer Stichprobe von zweieinhalb Millionen Menschen.
Die Zahl, die auf jeder Seite über Stichproben stehen sollte. Eine spätere Neuauswertung berechnete die stichprobenbedingte Fehlerspanne für die Schätzungen des Digest auf Ebene der Bundesstaaten: Sie lag zwischen 0,18 und 2,3 Prozentpunkten, mit einem Median von 0,6.8 Eine Genauigkeitsangabe von plus/minus einem halben Punkt, aufgesetzt auf einen Fehler von zwanzig Punkten. Nichts zeigt deutlicher, dass eine Fehlerspanne nur eine von mehreren Arten misst, auf die eine Umfrage falschliegen kann.
Und die übliche Erklärung stimmt nur zur Hälfte. Allen wird beigebracht, dass der Digest Autobesitzer und Telefonkunden befragte, die wohlhabend und republikanisch waren. Eine empirische Prüfung dieser Behauptung nutzte eine Gallup-Umfrage vom Mai 1937. Menschen, die sowohl ein Auto als auch ein Telefon besaßen, stimmten trotzdem mehrheitlich für Roosevelt, 55 zu 45. Unter allen, die angaben, einen Stimmzettel des Digest erhalten zu haben, lag Roosevelt mit 55 zu 44 vorn. Der Rahmen neigte zu den Republikanern, aber bei Weitem nicht genug, um einen Erdrutschsieg Landons zu erzeugen.7
Die fehlende Hälfte ist Nonresponse. Unter denen, die angaben, ihren Stimmzettel zurückgeschickt zu haben, lag Landon mit 51 zu 48 vorn. Unter denen, die ihn nicht zurückgeschickt hatten, führte Roosevelt mit 69 zu 30. Die grobe Zerlegung schreibt etwa elf Punkte des Fehlers dem Rahmen zu und etwa sieben der unterschiedlichen Nonresponse.7 Hätte man die Rückläufe nach einer Frage gewichtet, die der Digest bereits gestellt hatte – wie man 1932 gewählt hatte –, wäre mit der Rechenkunst von 1936 der richtige Sieger herausgekommen.8
Eine hohe Rücklaufquote ist nicht das Ziel, für das Sie sie halten
Die Rücklaufquoten der eigenen Telefonumfragen des Pew Research Center fielen von 36 Prozent im Jahr 1997 auf 9 Prozent bis 2012 und auf 6 Prozent bis 2018.9 Gleichzeitig wählte Indiens National Family Health Survey, persönlich durchgeführt, 664.972 Haushalte aus und fand 653.144 davon bewohnt. Sie befragte 636.699 davon, eine Rücklaufquote von 97,5 Prozent. Lesen Sie diesen Nenner genau, denn hier geht eine Rücklaufquote am häufigsten schief: Bezogen auf die Zahl der ausgewählten statt der bewohnten Haushalte ergibt dieselbe Feldarbeit 95,7 Prozent. Die Erhebung zog ihre Stichprobe aus 30.456 Klumpen in allen 707 Distrikten.10
Beide Tatsachen stammen aus demselben Jahrzehnt. Erhebungsweg und Aufwand in der Feldarbeit bestimmen Rücklaufquoten weit stärker als jede pauschale Behauptung über Umfragemüdigkeit. Wenn Ihnen ein Leitfaden sagt, die durchschnittliche Rücklaufquote sei eine bestimmte Zahl, beschreibt er keine reale Größe.
Nun der unbequemere Befund. Eine Metaanalyse von 235 Schätzungen der Nonresponse-Verzerrung aus 30 veröffentlichten Studien ergab eine Korrelation von 0,33 zwischen Rücklaufquote und Größe der Nonresponse-Verzerrung. Quadriert bedeutet das, dass die Rücklaufquote etwa 11 Prozent der Variation der Verzerrung erklärt.11 Eine Folgeuntersuchung über 59 Studien, die eigens zur Messung der Nonresponse-Verzerrung angelegt waren, kam zum selben Schluss.12
Es lohnt sich, die Rücklaufquote zu berichten und zu verbessern. Sie ist kein Gütesiegel. Verzerrung entsteht dann, wenn die Antwortbereitschaft mit dem zusammenhängt, was Sie messen. Eine Umfrage zum Ehrenamt leidet darunter weit mehr als eine Umfrage zur Breitbandgeschwindigkeit. Achten Sie auf den Zusammenhang, nicht auf den Prozentsatz.
Mehr Beantwortungen können einen kaputten Rahmen nicht reparieren
Während der Impfkampagne 2021 verfolgten zwei sehr große Umfragen die Impfquote in den Vereinigten Staaten. Eine sammelte etwa 250.000 Beantwortungen pro Woche und überschätzte die Erstimpfungsquote gegenüber dem amtlichen Referenzwert um 17 Prozentpunkte. Die andere sammelte etwa 75.000 alle zwei Wochen und überschätzte sie um 14. Eine dritte Umfrage mit rund 1.000 Teilnehmern, nach üblicher probabilistischer Praxis durchgeführt, lieferte verlässliche Schätzungen.13
Dasselbe Muster zeigt sich in der gewöhnlichen Umfragearbeit. Beim Vergleich von drei probabilistischen Panels mit drei Online-Opt-in-Quellen über 28 Referenzwerte und 29.937 Interviews lag der mittlere absolute Fehler bei 5,8 Prozentpunkten für die Opt-in-Stichproben und bei 2,6 für die probabilistischen Panels. Bei den 25 dieser Referenzwerte, die für Untergruppen verfügbar waren, betrug die Abweichung bei Erwachsenen von 18 bis 29 Jahren 11,2 gegenüber 3,6.14
Und ein einprägsamer Diagnosetest: In einer Opt-in-Umfrage gaben 12 Prozent der Erwachsenen unter 30 an, eine Lizenz zum Führen eines Atom-U-Boots zu besitzen.15 Der wahre Wert liegt nahe null. Wenn ein Panel das hervorbringen kann, kann es alles hervorbringen, und eine größere Bestellung beim selben Panel kauft einfach mehr davon.
Wen Ihr Rahmen außerhalb der USA und Großbritanniens verfehlt
Die meisten Leitfäden zur Stichprobenziehung setzen stillschweigend einen westlichen Rahmen voraus: eine E-Mail-Liste, einen Festnetzanschluss, ein nationales Adressregister. Ein Großteil der Welt zieht Stichproben nicht so, und die Abdeckungslücken haben eine gemessene Form.
- Eine Online-Umfrage in einem Land mit niedrigem oder mittlerem Einkommen ist eine Stichprobe seines vernetzten Teils, und dieser Teil ist überproportional männlich. Frauen in Ländern mit niedrigem und mittlerem Einkommen nutzen mobiles Internet mit 14 Prozent geringerer Wahrscheinlichkeit als Männer, was rund 235 Millionen weniger Frauen als Männer online entspricht.16
- Telefonstichproben überrepräsentieren Haushaltsvorstände. In Telefonumfragen der Weltbank in vier afrikanischen Ländern waren in Uganda 52 Prozent und in Nigeria 73 Prozent der Teilnehmer männlich, gegenüber rund der Hälfte in der erwachsenen Bevölkerung. In Uganda waren 6 Prozent der Telefonteilnehmer 15 bis 24 Jahre alt, gegenüber 38 Prozent der erwachsenen Bevölkerung.17
- Was Sie dagegen tun können. Kombinieren Sie Erhebungswege, statt einen zu verteidigen. Erfassen Sie Haushalte vor Ort, wo es kein Register gibt. Erheben Sie in den Sprachen, die Ihre Grundgesamtheit tatsächlich liest, und unterziehen Sie die Übersetzung einem Pretest, statt sie nur rückzuübersetzen. Halten Sie dann die verbleibende Lücke in Ihren Limitationen fest, denn sie wird noch da sein.
Was Gewichtung beheben kann und was nicht
Gewichtung passt Ihre Daten so an, dass die Zusammensetzung der Stichprobe bekannten Zahlen der Grundgesamtheit entspricht. Sie ist wirklich wirkungsvoll und wird regelmäßig überschätzt.
Was dafür spricht. 2016 sah die letzte Umfrage der University of New Hampshire Clinton mit 11 Punkten vorn – in einem Rennen, das sie mit 0,4 Punkten gewann. Die Umfrage war nicht nach Bildung gewichtet. Die Prüfkommission kam zu dem Schluss, dass allein diese Anpassung praktisch den gesamten Fehler beseitigt hätte.18 Ein einziges Merkmal, das sowohl mit der Antwortbereitschaft als auch mit dem Ergebnis zusammenhängt, leistet die ganze Arbeit.
Was dagegen spricht, sich darauf zu verlassen. Als mehr als 30.000 Online-Opt-in-Interviews an 24 Referenzwerten gemessen wurden, lag die durchschnittliche geschätzte Verzerrung ungewichtet bei 8,4 Prozentpunkten. Keines der getesteten Gewichtungsverfahren, auch ausgefeilte Matching-Ansätze, drückte die durchschnittliche Verzerrung unter 6 Punkte.19 Die Stichprobengröße zu vervierfachen, brachte weitere 0,2 Punkte.
Die Regel, die daraus folgt, ist einfach. Gewichtung korrigiert Ungleichgewichte bei den Merkmalen, nach denen Sie gewichten, soweit diese Merkmale mit dem Ergebnis zusammenhängen. Gegen Unterschiede zwischen Antwortenden und Nichtantwortenden bei Dingen, die Sie nie gemessen haben, hilft sie nicht, und sie macht eine nicht-probabilistische Stichprobe nie zu einer, die eine Genauigkeitsaussage stützt.
Eine Genauigkeitsangabe ist eine Untergrenze, keine Obergrenze
Eine Fehlerspanne beziffert die zufällige Stichprobenschwankung und nur diese. Sie setzt voraus, dass die Stichprobe zufällig aus der Zielgrundgesamtheit gezogen wurde und dass die verbleibende Verzerrung beseitigt ist. Abdeckungsfehler, Nonresponse-Verzerrung, Messfehler und betrügerische Teilnehmer liegen alle außerhalb davon.
Die Belege sind eindeutig. In den letzten beiden Wochen vor der Wahl 2020 gaben 348 Präsidentschaftsumfragen auf Ebene der Bundesstaaten eine Fehlerspanne an, im Durchschnitt 3,9 Punkte. Gemessen an diesem Durchschnitt verfehlten 55 Prozent von ihnen den endgültigen Vorsprung um mehr als eine Fehlerspanne und 21 Prozent um mehr als das Doppelte.20 Das waren moderne Umfragen mit modernen Methoden. Behandeln Sie die Fehlerspanne als Untergrenze Ihrer Unsicherheit, nie als Obergrenze.
| Aussage | Die Zahl | Evidenzgrad | Quelle |
|---|---|---|---|
| Die Rücklaufquote sagt Nonresponse-Verzerrung kaum voraus | r = 0,33, also etwa 11 % der Variation, über 235 Schätzungen aus 30 Studien | A | Groves, 200611 |
| Eine sehr große Umfrage kann weit danebenliegen | Impfquote um 17 Punkte überschätzt, bei etwa 250.000 Beantwortungen pro Woche | A | Bradley u. a., 202113 |
| Opt-in-Stichproben sind etwa doppelt so ungenau wie probabilistische Panels | 5,8 vs. 2,6 Prozentpunkte durchschnittlicher Fehler über 28 Referenzwerte | A | Mercer und Lau, 202314 |
| Gewichtung verbessert eine Opt-in-Stichprobe, rettet sie aber nicht | 8,4 Punkte ungewichtet, kein Verfahren unter 6,0 Punkten | A | Mercer, Lau und Kennedy, 201819 |
| Eine Fehlerspanne unterschätzt den tatsächlichen Umfragefehler | 55 % von 348 Umfragen in Bundesstaaten lagen 2020 weiter daneben als die durchschnittlich angegebene Fehlerspanne von 3,9 Punkten | A | AAPOR-Arbeitsgruppe, 202120 |
| Die Rahmen-Erklärung zum Literary Digest ist unvollständig | Auto- und Telefonbesitzer bevorzugten trotzdem Roosevelt, 55 zu 45 | B | Squire, 19887 |
Evidenzgrad A steht für eine amtliche Statistik, eine Metaanalyse oder einen replizierten Befund. Evidenzgrad B steht für eine starke Einzelstudie, deren Ergebnis noch nicht unabhängig wiederholt wurde.
„Eine Rücklaufquote von 50 Prozent ist ausreichend, 60 ist gut, 70 ist sehr gut.“ Eine Lehrbuch-Faustregel ohne Daten dahinter. Verschiedene Fachautoritäten desselben Gebiets nennen 50, 60 und 80. Verzerrung hängt vom Zusammenhang zwischen Antwortbereitschaft und Antwort ab, nicht von der Quote.
„Dreißig reichen, weil ab da der zentrale Grenzwertsatz greift.“ Es gibt keine Herleitung, die 30 ergibt. Bei symmetrischen Ergebnissen funktioniert die Näherung weit darunter, bei schiefen Ergebnissen oder seltenen Ereignissen versagt sie weit darüber.
„Die durchschnittliche Rücklaufquote von Umfragen liegt bei 33 Prozent.“ Diese Zahl kursiert in fast gleichem Wortlaut durch Anbieter-Blogs, ohne Primärquelle. Erhebungsweg, Auftraggeber, Grundgesamtheit und Anreiz überlagern jeden globalen Durchschnitt.
„Die Aufmerksamkeitsspanne beträgt heute acht Sekunden, kürzer als die eines Goldfischs.“ Zurückverfolgt auf einen Marketingbericht von 2015, der eine Firma zitierte, die keine Quelle vorlegen konnte. Die zugrunde liegende Forschung erwähnt weder acht Sekunden noch Goldfische.
Designeffekt: Warum Klumpenstichproben mehr Personen brauchen
Fast jeder Leitfaden empfiehlt die Klumpenstichprobe wegen der Kostenersparnis und hört dort auf. Die Ersparnis ist real, die Rechnung aber auch. Menschen in derselben Schule, Klinik, Station oder Filiale ähneln einander. Sie ähneln einander stärker als zufällig aus der gesamten Grundgesamtheit gewählten Personen. Daher bringt jede zusätzliche Beantwortung aus einer bereits gewählten Gruppe weniger neue Information.
Der Designeffekt ist die Zahl, die das misst. In Worten: um wie viel größer Ihre Unsicherheit wird im Vergleich dazu, dieselbe Zahl von Personen unabhängig zu ziehen. Bei einem Design mit gleich großen Gruppen gilt
Designeffekt = 1 + (durchschnittliche Gruppengröße - 1) x Intraklassenkorrelation
Die Intraklassenkorrelation gibt an, wie ähnlich sich Personen innerhalb einer Gruppe in dem sind, was Sie messen. Null bedeutet, dass die Zugehörigkeit zur selben Schule nichts über die Antwort eines Schülers verrät. Eins bedeutet, dass alle in einer Schule identisch antworten und die Schule ebenso gut eine einzige Person sein könnte. Reale Werte sind klein, aber kleine Werte richten viel Schaden an, sobald die Gruppen groß werden. Über 48 nationale Haushaltsbefragungen gemittelt liegt die durchschnittliche Intraklassenkorrelation bei etwa 0,06. Sie hängt davon ab, was Sie messen. Items zur Fertilität liegen bei etwa 0,01 bis 0,03, die aktuelle Verhütungsmittelnutzung bei 0,03 bis 0,05 und medizinisch begleitete Geburten in den landesweiten Werten bei bis zu 0,22.21
Wenn Sie keine eigene Schätzung haben, übernehmen Sie einen Standardwert mit Bedacht. Das DHS-Stichprobenhandbuch greift auf 1,5 für deft zurück, wenn eine Erhebung keinen eigenen Wert hat.22 Deft ist nicht dieselbe Größe wie der Designeffekt in der Formel oben: Es ist das Verhältnis der beiden Standardfehler, während der Designeffekt das Verhältnis der beiden Varianzen ist. Sie quadrieren es, also entspricht ein deft von 1,5 einem Designeffekt von 2,25. Das Handbuch nennt den Wert eine Notlösung, keinen typischen Wert, und seine eigenen Rechenbeispiele verwenden 1,40 für die Nutzung moderner Verhütungsmittel und 1,22 für Kinderimpfungen.
| Design | Designeffekt | Effektive Beantwortungen | Was es in der Praxis bedeutet |
|---|---|---|---|
| Unabhängige Auswahl, keine Klumpung | 1.00 | 960 | Jede Beantwortung zählt voll. |
| 24 Gruppen zu 40, ICC 0,02 | 1.78 | 539 | Sie haben für 960 bezahlt und können die Genauigkeit von 539 vertreten. |
| 24 Gruppen zu 40, ICC 0,05 | 2.95 | 325 | Zwei Drittel der Feldarbeit haben Ihnen keine zusätzliche Genauigkeit gebracht. |
| 24 Gruppen zu 40, ICC 0,10 | 4.90 | 196 | Das Design ist unbemerkt zu einer kleinen Studie mit dem Budget einer großen geworden. |
Gewichtung bringt eine eigene Komponente mit. Eine nationale Erhebung, die eine Region überrepräsentiert und dann zurückgewichtet, trägt zwei Designeffekte zugleich. Ein Gewichtungseffekt von 1,22 und ein Klumpungseffekt von 1,80 ergeben einen Gesamtdesigneffekt von 2,20. So verhalten sich 5.000 befragte Haushalte wie 2.277 unabhängige.23
Die Lehre für das Design. Mehr Gruppen mit weniger Personen schlagen weniger Gruppen mit mehr Personen fast immer. Vierzig Schulen mit je 24 Schülern und 24 Schulen mit je 40 Schülern kosten ungefähr dieselben 960 Beantwortungen, aber die erste Variante hat einen kleineren Designeffekt und ein belastbares Ergebnis. Wenn Sie planen, wie viele Beantwortungen Sie insgesamt brauchen, berechnen Sie das mit unserem Leitfaden zur Stichprobengröße und multiplizieren Sie dann mit dem Designeffekt. Umgekehrt vorzugehen ist der Grund, warum Klumpenstudien am Ende eine zu geringe Teststärke haben.
Drei durchgerechnete Beispiele von Anfang bis Ende
Verfahrensnamen sind einfach. Die Entscheidungen drumherum sind es, an denen Studien tatsächlich scheitern. Diese drei führen ein reales Design von der Beschreibung der Grundgesamtheit bis zu dem Satz, den Sie veröffentlichen können.
Beispiel 1: Patientenerfahrung in einem Bezirk
- Grundgesamtheit. Erwachsene, die zwischen dem 1. April und dem 30. Juni eine ambulante Sprechstunde in einer der 46 öffentlichen Kliniken des Bezirks besucht haben.
- Rahmen. Es gibt kein bezirksweites Patientenregister. Es gibt aber eine Liste der 46 Kliniken mit monatlichen Besuchszahlen.
- Verfahren. Mehrstufig. Wählen Sie 18 Kliniken mit einer Wahrscheinlichkeit proportional zur Besucherzahl aus und ziehen Sie dann an zwei zufällig gewählten Sprechstundentagen systematisch jeden 8. Patienten beim Verlassen der Klinik.
- Warum nicht etwas Einfacheres. Eine vollständige Patientenliste würde eine geschichtete Stichprobe ermöglichen, aber sie existiert nicht und lässt sich im Zeitplan nicht erstellen. Eine Gelegenheitsstichprobe in den drei größten Kliniken wäre schneller und würde die drei größten Kliniken beschreiben.
- Was berichtet werden muss. Die Auswahlwahrscheinlichkeiten unterscheiden sich nach Klinikgröße, daher braucht die Auswertung Gewichte, und das Intervall muss um den Designeffekt erweitert werden.
- Der veröffentlichbare Satz. „Unter Erwachsenen, die im zweiten Quartal öffentliche ambulante Kliniken im Bezirk besuchten, bewerteten schätzungsweise 71 Prozent ihre Wartezeit als akzeptabel, basierend auf 1.240 Befragungen am Klinikausgang in 18 Kliniken, die mit einer Wahrscheinlichkeit proportional zur Besucherzahl ausgewählt wurden.“
Beispiel 2: eine Abschlussarbeit mit Studierenden als Grundgesamtheit
- Grundgesamtheit. Im laufenden Studienjahr an der Wirtschaftsfakultät eingeschriebene Studierende: 3.100 über drei Studienjahre.
- Rahmen. Das Einschreibungsverzeichnis der Fakultät, das Studienjahr und Studiengang enthält.
- Verfahren. Geschichtete Zufallsstichprobe nach Studienjahr, proportionale Aufteilung, Ziel 350 vollständige Beantwortungen.
- Die Rechnung. Das erste Studienjahr umfasst 1.300 Studierende, also 42 Prozent von 3.100, und erhält daher 42 Prozent von 350, also 147 Beantwortungen. Wiederholen Sie das für jedes Studienjahr. Da die Aufteilung proportional ist, ist keine Gewichtung erforderlich.
- Planung der Beantwortungen. Bei einer erwarteten Rücklaufquote von 35 Prozent müssen Sie rund 1.000 Studierende einladen, um 350 vollständige Beantwortungen zu erhalten, und Sie sollten Schicht für Schicht einladen, damit ein schwacher Rücklauf in einem Jahrgang sichtbar wird, solange noch Zeit zum Handeln ist.
- Zu nennende Grenzen. Studierende, die sich exmatrikuliert haben, aber noch im Verzeichnis stehen, sind Übererfassung. Studierende, die sich nach dem Abruf des Verzeichnisses eingeschrieben haben, sind Untererfassung. Beides gehört in den Absatz zu den Limitationen.
Beispiel 3: Kundenfeedback für einen Onlineshop
- Grundgesamtheit. Kunden, die in den letzten 90 Tagen eine Bestellung abgeschlossen haben.
- Rahmen. Die Bestelltabelle. Sie ist vollständig für Onlinebestellungen und für Gastbestellungen, aber ein Kunde mit zwei Konten erscheint doppelt.
- Verfahren. Doppelungen auf eine Zeile pro Kunde bereinigen, dann systematisch jeden 12. Kunden nach einem zufälligen Start ziehen, fortlaufend statt in einem einzigen Durchgang.
- Die Falle, die das vermeidet. Nur Newsletter-Abonnenten einzuladen, ist schneller und ergibt eine Gelegenheitsstichprobe Ihrer engagiertesten Kunden. Die Zufriedenheit wird dadurch zuverlässig in jedem Quartal besser aussehen, als sie ist.
- Ein Hinweis zu Beschäftigten. Befragt dieselbe Organisation ihre eigenen 180 Beschäftigten, sollte sie gar keine Stichprobe ziehen. Diese Grundgesamtheit ist klein, erreichbar, und alle haben ein Recht darauf, gefragt zu werden. Führen Sie eine Vollerhebung durch, und wenn die Beteiligung gering ist, behandeln Sie das als Befund statt als Stichprobenproblem.
So beschreiben Sie die Stichprobe in Ihrem Methodenteil
Diesen Schritt überspringen die meisten Leitfäden, und genau ihn lesen Betreuende, Gutachtende oder Auftraggeber tatsächlich. Eine Beschreibung der Stichprobe muss fünf Fragen in dieser Reihenfolge beantworten: wer, aus welcher Liste, wie ausgewählt, wie viele und was Sie folglich behaupten dürfen.
Füllen Sie die Lücken unten aus. Die Vorlage ist bewusst schlicht: Prüfende suchen hier keine elegante Prosa, sondern ein Design, das sie bewerten können.
Dieselbe Studie, schwach und gut beschrieben
Schwach. „Es wurde eine Zufallsstichprobe von Studierenden gezogen, und es gingen 350 Beantwortungen ein.“
Nichts davon lässt sich überprüfen. „Zufällig“ leistet hier Arbeit, die es sich nicht verdient hat, es gibt keinen Rahmen, keinen Nenner und keine Angabe, wer ausgeschlossen war.
Stark. „Die Zielgrundgesamtheit waren die 3.100 im Jahr 2026 an der Wirtschaftsfakultät eingeschriebenen Studierenden. Der Stichprobenrahmen war das am 3. März 2026 abgerufene Einschreibungsverzeichnis der Fakultät. Verwendet wurde eine geschichtete Zufallsstichprobe nach Studienjahr mit proportionaler Aufteilung, damit über jedes Studienjahr gesondert berichtet werden konnte. Eintausend Studierende wurden eingeladen, und 350 füllten den Fragebogen vollständig aus, eine Rücklaufquote von 35 Prozent. Es wurde keine Gewichtung angewandt, da die Aufteilung proportional war. Studierende, die sich nach dem Abrufdatum exmatrikuliert hatten, blieben im Rahmen und ließen sich nicht identifizieren, was eine geringfügige Quelle der Übererfassung ist.“
Die zweite Fassung ist länger, und jeder zusätzliche Satz ist ein Satz, nach dem Gutachtende nicht mehr fragen müssen.
„Die Teilnehmenden wurden über einen In-App-Hinweis gewonnen, der aktiven Nutzern zwei Wochen lang angezeigt wurde. Es handelt sich um eine Gelegenheitsstichprobe, daher beschreiben die Ergebnisse die Personen, die geantwortet haben, und lassen sich nicht auf die gesamte Nutzerbasis verallgemeinern; eine Genauigkeitsangabe wird nicht berichtet. Die Teilnehmer waren mit höherer Wahrscheinlichkeit als die Nutzerbasis tägliche Nutzer, was beim Lesen der Ergebnisse berücksichtigt werden sollte.“ Schreiben Sie das, und niemand kann Ihnen vorwerfen, zu viel zu behaupten. Sie haben es nicht getan.
Checkliste für den Stichprobenplan
Ein schriftlicher Stichprobenplan verhindert die meisten vermeidbaren Fehler, weil er die Entscheidungen vor die Feldphase zwingt statt in die Auswertung. Acht Punkte, eine Seite.
- 1. Forschungsziel. Welche Entscheidung unterstützt die Studie, und was genau wird berichtet?
- 2. Zielgrundgesamtheit. Wer dazugehört und wer nicht, einschließlich des Zeitfensters.
- 3. Stichprobenrahmen. Quelle, Abrufdatum, Zeilenzahl, bekannte Lücken und die Regel zur Bereinigung von Doppelungen.
- 4. Verfahren und Begründung. Welches der neun und warum gerade dieses, angesichts von Rahmen und Aussage.
- 5. Zielwerte. Vollständige Beantwortungen insgesamt und je Untergruppe sowie die erwartete Rücklaufquote, mit der Sie planen.
- 6. Rekrutierungsplan. Erhebungswege, Erinnerungsplan, Sprach- und Barrierefreiheitsangebote, Anreizregeln.
- 7. Überwachung. Was Sie während der Feldphase beobachten: Rücklauf je Schicht, Abbruchstelle, Item-Nonresponse.
- 8. Hinweise zur Auswertung. Geplante Gewichtung, Anpassung an den Designeffekt und die Limitationen, die Sie in jedem Fall offenlegen.
Steht der Plan, entscheidet das Instrument, ob sich die Ziehung der Stichprobe gelohnt hat. Eine perfekte Stichprobe kann keine suggestive Frage und keine Doppelfrage retten, daher lohnt es sich, Beispiele für Umfragefragen durchzusehen, bevor Sie etwas ins Feld schicken.
Häufig gestellte Fragen
Was ist eine Stichprobe in der Forschung?
Stichprobenziehung ist der Vorgang, eine Teilmenge einer Grundgesamtheit – die Stichprobe – auszuwählen und diese Teilmenge zu untersuchen, um Schlüsse über die gesamte Grundgesamtheit zu ziehen. Man nutzt sie, weil es meist zu langsam, zu teuer oder unmöglich ist, jedes Mitglied einer Grundgesamtheit zu messen. Das Verfahren, mit dem die Stichprobe ausgewählt wird, bestimmt, welche Schlüsse die Ergebnisse stützen können.
Was ist der Unterschied zwischen Grundgesamtheit und Stichprobe?
Die Grundgesamtheit ist die gesamte Gruppe, die Sie beschreiben möchten. Die Stichprobe ist die kleinere Teilmenge, die Sie tatsächlich messen. Stichprobenziehung ist der Vorgang, der Sie vom einen zum anderen bringt, und die Vollerhebung ist die Alternative, bei der Sie stattdessen die gesamte Grundgesamtheit messen.
Was ist ein Stichprobenrahmen?
Ein Stichprobenrahmen ist die tatsächliche Liste oder der Mechanismus, aus dem Sie Ihre Stichprobe ziehen: ein Studierendenverzeichnis, ein Patientenregister, eine Kundendatenbank, ein Haushaltsverzeichnis, ein Wählerverzeichnis. Er ist wichtiger als der Name des Verfahrens, denn wer im Rahmen fehlt, hat keine Chance, ausgewählt zu werden, ganz gleich, wie gut Ihre Technik ist.
Welches Stichprobenverfahren braucht keinen Stichprobenrahmen?
Gelegenheits-, Quoten-, bewusste und Schneeballstichproben brauchen überhaupt keine Liste. Klumpen- und mehrstufige Stichproben brauchen nur eine Liste von Gruppen wie Schulen, Kliniken oder Dörfern, keine Liste von Einzelpersonen. Einfache Zufallsstichproben, systematische und geschichtete Stichproben erfordern alle eine vollständige Liste der Einzelpersonen, bevor Sie beginnen können.
Was ist der Unterschied zwischen probabilistischer und nicht-probabilistischer Stichprobenziehung?
Bei der probabilistischen Stichprobenziehung trifft ein Zufallsmechanismus die Auswahl, sodass jede Einheit eine bekannte Auswahlwahrscheinlichkeit größer als null hat und Sie berechnen können, wie unsicher Ihre Schätzungen sind. Bei der nicht-probabilistischen Stichprobenziehung sind diese Wahrscheinlichkeiten unbekannt, weil die Auswahl von Erreichbarkeit, Quoten oder dem Urteil der Forschenden abhängt. Die praktische Folge: Nur ein probabilistisches Design stützt eine angegebene Genauigkeit für eine Schätzung der Grundgesamtheit.
Was ist der Unterschied zwischen geschichteter Stichprobe und Klumpenstichprobe?
Die geschichtete Stichprobe teilt die Grundgesamtheit in Gruppen und zieht aus jeder Gruppe eine Zufallsstichprobe, was die Genauigkeit verbessert und garantiert, dass jede Gruppe vorkommt. Die Klumpenstichprobe wählt einige Gruppen zufällig aus und befragt dann alle in den ausgewählten Gruppen, was Kosten spart, wenn es keine Liste der Einzelpersonen gibt. Die Kurzformel lautet: Geschichtet nutzt alle Gruppen und einige der Personen, Klumpen nutzt einige der Gruppen und alle Personen.
Was ist eine primäre Auswahleinheit?
Die primäre Auswahleinheit ist das, was in der ersten Stufe eines mehrstufigen Designs ausgewählt wird. In einer nationalen Haushaltsbefragung ist das meist ein Gebiet wie ein Wahlbezirk, ein Dorf oder ein Zählbezirk. Darin werden in der zweiten Stufe Haushalte ausgewählt. Die primäre Auswahleinheit zu benennen, ist bei der Beschreibung eines Klumpendesigns Standard, weil die dadurch entstehende Klumpung in der Auswertung berücksichtigt werden muss.
Was ist eine geschichtete Zufallsstichprobe?
Die geschichtete Zufallsstichprobe teilt die Grundgesamtheit in sich nicht überschneidende Gruppen, sogenannte Schichten, und zieht dann innerhalb jeder Schicht unabhängig eine Zufallsstichprobe. Bei proportionaler Aufteilung erhält jede Schicht einen Anteil an der Stichprobe, der ihrem Anteil an der Grundgesamtheit entspricht, und es ist keine Gewichtung nötig. Bei disproportionaler Aufteilung werden kleine, aber wichtige Schichten bewusst überrepräsentiert, was dann eine Gewichtung erfordert, bevor eine Gesamtzahl berichtet wird.
Ist das Schneeballverfahren für wissenschaftliche Forschung zulässig?
Ja, wenn die Grundgesamtheit verborgen, selten oder nirgends erfasst ist und sich kein Stichprobenrahmen erstellen lässt. Es ist ein anerkannter Ansatz für schwer erreichbare Gruppen. Eine Schätzung für die Grundgesamtheit kann es nicht stützen, und seine größte Schwäche ist, dass Teilnehmende Menschen empfehlen, die ihnen ähneln, sodass die Stichprobe in ein soziales Netzwerk driftet. Mit mehreren unverbundenen Startpersonen zu beginnen, verringert diese Drift und sollte in Ihrem Methodenteil beschrieben werden.
Ist Zufallsauswahl dasselbe wie Zufallszuteilung?
Nein. Die Zufallsauswahl ist die Art, wie Sie Teilnehmende aus einer Grundgesamtheit auswählen, und sie bestimmt, auf wen sich Ihre Ergebnisse verallgemeinern lassen. Die Zufallszuteilung ist die Art, wie Sie ausgewählte Teilnehmende in einem Experiment den Bedingungen zuweisen, und sie bestimmt, ob sich ein beobachteter Effekt auf die Intervention zurückführen lässt. Eine Studie kann das eine ohne das andere nutzen, und die meisten Experimente nutzen Zufallszuteilung ohne Zufallsauswahl.
Kann ich ein nicht-probabilistisches Stichprobenverfahren in einer quantitativen Studie verwenden?
Ja, und ein großer Teil der veröffentlichten quantitativen Forschung tut das. Was sich ändert, ist, was Sie behaupten dürfen. Sie können Häufigkeiten, Prozentwerte und Zusammenhänge innerhalb Ihrer Stichprobe berichten und Gruppen darin vergleichen. Sie können diese Prozentwerte nicht als Schätzungen für die Grundgesamtheit mit angegebener Genauigkeit darstellen. Nennen Sie das Verfahren, beschreiben Sie die Rekrutierung, vergleichen Sie Ihre Teilnehmer mit einem bekannten Referenzwert, sofern es einen gibt, und benennen Sie die Limitation ausdrücklich, statt zu hoffen, dass niemand danach fragt.
Was ist der Unterschied zwischen Stichprobenziehung und Stichprobenverteilung?
Stichprobenziehung ist das Vorgehen, mit dem eine Stichprobe ausgewählt wird. Eine Stichprobenverteilung ist etwas anderes. Stellen Sie sich vor, dasselbe Auswahlverfahren würde viele Male wiederholt. Die Streuung der resultierenden Kennzahl, etwa des Mittelwerts oder des Prozentwerts, über all diese gedachten Stichproben ist die Stichprobenverteilung. Sie macht Konfidenzintervalle überhaupt erst möglich und verhält sich nur dann vorhersagbar, wenn die Stichprobe mit einem probabilistischen Verfahren gezogen wurde.
Woran erkenne ich, ob meine Stichprobe verzerrt ist?
Vergleichen Sie Ihre erreichte Stichprobe mit einem bekannten Referenzwert wie Ihrer Personalliste, Einschreibungsdaten oder Verwaltungsdaten, und zwar bei Merkmalen, die mit dem zusammenhängen, was Sie messen. Große Abweichungen deuten auf Abdeckungsprobleme, Auswahlprobleme oder unterschiedliche Nonresponse hin. Vergleichen Sie auch zwischen Rekrutierungskanälen und Erinnerungswellen. Bedenken Sie, dass eine gute Rücklaufquote nur ein schwacher Beleg für geringe Verzerrung ist: Über 235 veröffentlichte Schätzungen erklärte die Rücklaufquote nur etwa 11 Prozent der Variation der Nonresponse-Verzerrung.
Weiterführende Artikel
Stichprobenziehung ist eine Entscheidung innerhalb einer größeren Studie. Diese Leitfäden behandeln die Entscheidungen davor und danach.
- Forschungsdesign für Umfragen ordnet die Stichprobenziehung in den Ablauf der übrigen Studie ein, von der Definition der Grundgesamtheit bis zum Start.
- So bestimmen Sie die Stichprobengröße behandelt die Genauigkeitsrechnung, die diese Seite bewusst abgibt, einschließlich der Formeln.
- So formulieren Sie Umfragefragen behandelt die Messseite, die kein Stichprobendesign retten kann.
- Grundsätze der Fragebogengestaltung zeigt, wie ein ganzes Instrument zusammengesetzt wird, sobald die Fragen stehen.
- Antwortverzerrung geht tiefer auf den Unterschied zwischen den ausgewählten Personen und denen ein, die geantwortet haben.
- Demografische Fragen in Umfragen helfen, wenn Ihrem Rahmen das Merkmal fehlt, nach dem Sie schichten müssen.
- Statistische Signifikanz zeigt, was Sie mit den Zahlen tun, sobald die Stichprobe vorliegt.
- Quantitative Datenanalyse behandelt die folgenden Auswertungsschritte, einschließlich der Frage, wo Gewichte hingehören.
Wie dieser Leitfaden entstand und was er nicht abdeckt
Wer ihn geschrieben hat. Michael Hodge, der bei SuperSurvey an Umfragemethodik, Fragengestaltung und Datenqualität arbeitet und die Praxisleitfäden in unserem Bereich „Anleitungen und Hilfe“ schreibt.
Worauf er beruht. Die Definitionen folgen der unten zitierten methodischen Übersichtsarbeit und den Forschungsleitfäden der Universitäten, in denen die Fachbegriffe tatsächlich definiert werden. Die offiziellen Seiten der Behörde für Forschungsintegrität und des Statistikamts sind als kurze, allgemeinverständliche Einstiege aufgeführt, nicht als Quelle dieser Definitionen. Die Beschreibungen der Verfahren folgen denselben Übersichten und Leitfäden. Jede Zahl im Abschnitt mit den Belegen stammt aus einer benannten Primärquelle, die unten aufgeführt ist. Jede Aussage trägt außerdem einen Evidenzgrad, damit Sie sehen, welche Befunde gesichert sind und welche auf einer einzelnen Studie beruhen. Die Zahlen zum Designeffekt in Diagramm und Tabelle sind unsere eigene Rechnung. Wir haben die Standardformel verwendet, mit den in der Bildunterschrift genannten Annahmen, damit Sie sie mit Ihren eigenen Klumpengrößen nachrechnen oder anfechten können.
Was er nicht abdeckt. Dieser Leitfaden behandelt Stichproben für Umfragen und Beobachtungsstudien. Versuchsplanung und Zufallszuteilung behandelt er nur so weit, dass man sie unterscheiden kann. Ebenfalls ausgeklammert sind Stichproben für Abnahmeprüfungen, Revision und Signalverarbeitung, die dasselbe Wort für andere Dinge verwenden. Respondent-Driven Sampling, Time-Location Sampling und adaptive Klumpenstichproben sind echte Verfahren, die Fachleute für verborgene Grundgesamtheiten nutzen; sie gehören hier nicht zum Umfang. Die Werte zur Intraklassenkorrelation stammen aus Haushaltsbefragungen in Ländern mit niedrigem und mittlerem Einkommen. Behandeln Sie sie als Veranschaulichung, nicht als Werte, die sich auf einen anderen Kontext übertragen lassen.
Wo die Zahlen am schwächsten sind. Die Neuauswertung zum Literary Digest beruht auf einer Umfrage von 1937 und einer späteren Neuauswertung, und beide Autoren weisen selbst auf ihre Unsicherheit hin; aus diesem Grund hat sie Evidenzgrad B. Die Zahlen zum Umfragefehler stammen aus US-Wahlumfragen, die ungewöhnlich gut untersucht und nicht unbedingt repräsentativ für Umfragefehler im Allgemeinen sind.
Offenlegung. SuperSurvey verkauft Umfragesoftware. Nichts auf dieser Seite steht zum Verkauf, kein Teil davon erfordert eine Registrierung, und keine Organisation hat diesen Leitfaden gesponsert oder geprüft. Wo wir auf eigene Seiten verlinken, tun wir das, weil sie die nächste Entscheidung behandeln, nicht weil uns ein Link etwas einbringt.
Quellen
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., und Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- UK Government (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., und Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., und Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences und ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., und Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., und Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., und Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., und Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, Seiten 9 und 15. Die Zahlen stammen aus der Ausgabe 2025; die GSMA hat inzwischen eine Ausgabe 2026 mit einer kleineren Lücke veröffentlicht.
- Brubaker, J., Kilic, T., und Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., u. a. (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., und Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., und Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, Seite 9 und Tabelle 1.2.
- Kalton, G., Brick, J. M., und Le, T. (2005). Estimating components of design effects for use in sample design. In: Household Sample Surveys in Developing and Transition Countries, Kapitel VI. United Nations, Series F No. 96.