
Jawaban singkat
Pengambilan sampel adalah proses memilih sebagian dari suatu populasi, yang disebut sampel, lalu mempelajari bagian itu untuk menarik kesimpulan tentang seluruh populasi. Peneliti mengambil sampel karena mengukur semua orang biasanya terlalu lama, terlalu mahal, atau memang mustahil. Populasi adalah kelompok yang ingin Anda gambarkan, sampel adalah bagian darinya yang benar-benar Anda ukur, dan kerangka sampel adalah daftar tempat Anda menarik sampel.
Pengambilan sampel probabilitas memilih orang dengan mekanisme acak, sehingga setiap unit memiliki peluang terpilih yang diketahui dan tidak nol. Itulah yang memungkinkan Anda menyatakan ketidakpastian dengan angka.
Pengambilan sampel nonprobabilitas memilih berdasarkan kemudahan, kuota, atau pertimbangan peneliti. Cara ini sering lebih cepat, lebih murah, dan kadang satu-satunya pilihan yang etis, tetapi tidak dapat mendukung estimasi populasi dengan presisi yang dinyatakan.
Langsung ke perbandingan 9 metode | cara memilih metode | uji pemahaman Anda | cara menuliskannya
Poin-poin utama
- Pengambilan sampel berarti mempelajari sebagian: Anda mengukur sampel untuk mempelajari populasi ketika mengukur semua orang tidak memungkinkan.
- Pahami lima istilah ini lebih dulu: populasi, kerangka sampel, unit sampel, desain sampel, dan selisih antara populasi yang Anda inginkan dan populasi yang benar-benar dapat Anda jangkau. Sebagian besar perdebatan tentang pengambilan sampel sebenarnya adalah perdebatan tentang salah satu istilah ini.
- Hanya metode probabilitas yang memungkinkan Anda menyatakan ketidakpastian dengan angka. Sampel convenience, kuota, purposive, dan snowball bisa berguna dan jujur, tetapi tidak dapat mendukung estimasi populasi dengan presisi yang dinyatakan.
- Kerangka sampel menentukan batas atas Anda: jika suatu kelompok tidak mungkin muncul di daftar tempat Anda menarik sampel, tidak ada metode dan tidak ada tambahan respons sebanyak apa pun yang akan memasukkan mereka ke dalam hasil Anda.
- Keterwakilan adalah sebuah rantai, bukan label: kerangka sampel, lalu seleksi, lalu perekrutan, lalu respons, lalu analisis. Penarikan acak hanyalah satu dari lima mata rantai.
Definisi pengambilan sampel (dan 5 istilah yang harus Anda pahami dengan benar)
Pengambilan sampel adalah proses memilih kelompok yang lebih kecil (sampel) dari kelompok yang lebih besar (populasi) agar Anda dapat mempelajari populasi tanpa mengukur semua orang. Studi terhadap seluruh populasi sering tidak praktis, sehingga peneliti mengambil sampel agar pekerjaan dapat dilakukan dan tetap menghasilkan kesimpulan yang berguna.
Lima istilah di bawah ini memikul sebagian besar beban dalam bab metodologi mana pun. Jika salah memahaminya, setiap keputusan sesudahnya ikut mewarisi kesalahan itu.
- Populasi: seluruh kelompok yang ingin Anda gambarkan, ditulis dengan batasan dan rentang waktu. "Semua mahasiswa keperawatan tingkat akhir di ketiga kampus, yang terdaftar per 1 Maret" adalah populasi. "Perawat" bukan populasi.
- Populasi sasaran vs populasi terjangkau: siapa yang ingin Anda gambarkan dibandingkan siapa yang benar-benar dapat dijangkau oleh perekrutan dan alat Anda. Menyebutkan selisih keduanya adalah kekuatan dalam sebuah laporan, bukan kelemahan.
- Kerangka sampel: daftar atau mekanisme tempat Anda menarik sampel. Daftar mahasiswa, daftar pasien, basis data pelanggan, daftar rumah tangga di desa, daftar pemilih. Masalah pada kerangka sampel menimbulkan kesalahan cakupan (coverage error), dan tidak ada metode yang dapat memperbaikinya.
- Unit sampel: apa yang sebenarnya dipilih. Seseorang, rumah tangga, klinik, kelas, satu giliran kerja, satu pesanan. Dalam desain cluster dan multistage, unit pada tahap pertama berupa kelompok, dan kelompok itu disebut unit sampel primer.
- Desain sampel: seluruh rencana yang dituliskan. Kerangka sampel, metode, berapa banyak unit, cara menghubungi mereka, dan apa yang akan Anda lakukan terhadap orang yang tidak menjawab. "Desain sampel" adalah hal yang sebenarnya ditanyakan penguji atau penelaah ketika mereka bertanya tentang pengambilan sampel Anda.
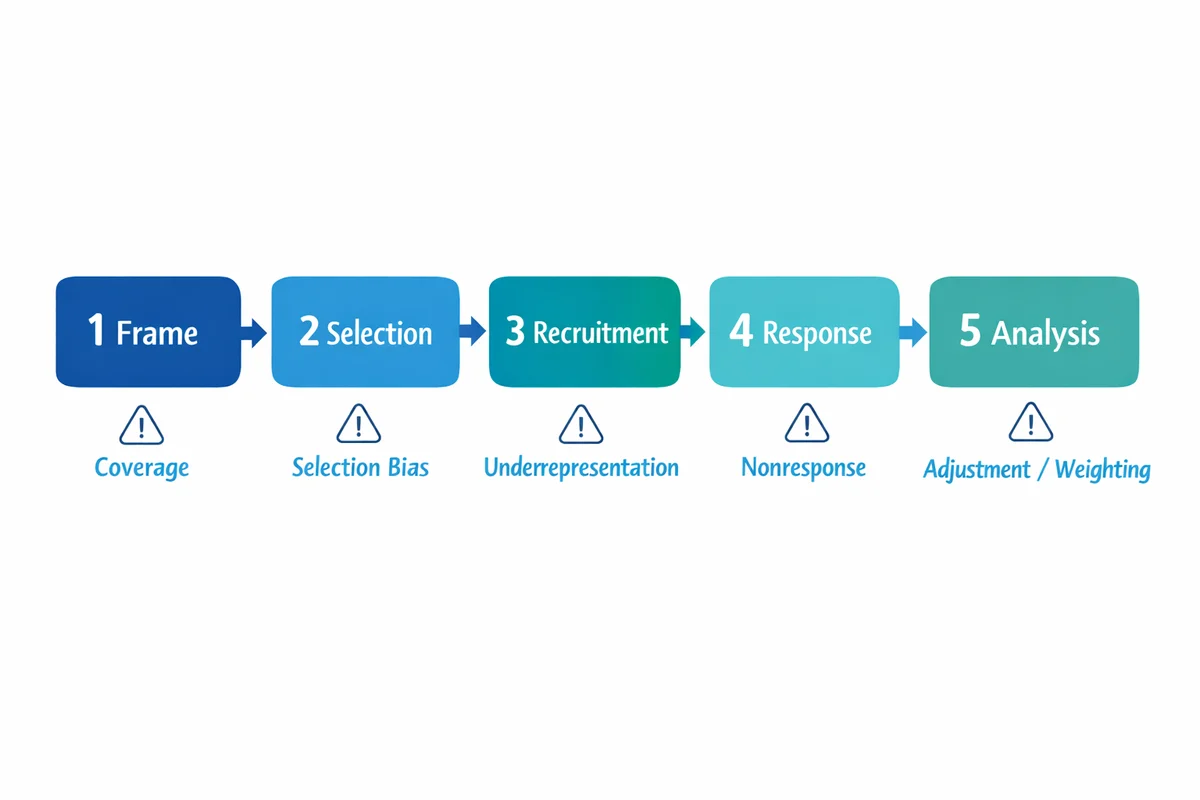
Anda bisa menjalankan seleksi acak persis seperti di buku teks dan tetap berakhir dengan sampel yang bias. Jika kerangka sampel Anda melewatkan suatu segmen, mereka tidak pernah berpeluang untuk ditarik. Jika suatu segmen tidak menjawab, mereka keluar setelah ditarik. Perlakukan pengambilan sampel sebagai rantai: kerangka sampel, lalu seleksi, lalu perekrutan, lalu respons, lalu analisis.
Untuk definisi resmi singkat dari gagasan yang sama, lihat catatan pelatihan U.S. Office of Research Integrity tentang pengambilan sampel.1 Jika Anda menempatkan pengambilan sampel dalam rencana studi yang lebih luas, panduan kami tentang desain penelitian survei membahas langkah-langkah sebelum dan sesudahnya.
Mengapa perlu mengambil sampel, dan kapan sensus adalah jawaban yang lebih baik
Kebutuhan akan pengambilan sampel bersifat praktis sebelum bersifat statistik. Empat alasan muncul berulang kali.
Biaya
Setiap responden tambahan memakan uang, waktu staf, atau niat baik. Sampel 600 orang yang ditarik dengan baik dapat menjawab pertanyaan yang sama dengan upaya yang dijalankan dengan buruk terhadap 60.000 orang.
Kecepatan
Keputusan punya tenggat waktu. Sampel memberi Anda jawaban dalam rentang waktu ketika jawaban itu masih berguna.
Kelayakan
Sebagian populasi sama sekali tidak dapat didata: orang yang lewat di pasar, orang yang berhenti memakai suatu layanan, pedagang informal. Populasi lain praktis tidak terhingga, atau mengukur satu unit justru merusaknya.
Kualitas
Alasan ini mengejutkan banyak orang. Memusatkan upaya pada kelompok yang lebih kecil memungkinkan Anda mengejar orang yang belum menjawab, melatih pewawancara dengan benar, dan memeriksa data. Upaya per unit biasanya lebih berharga daripada jumlah unit.
Sensus justru mengukur semua orang. Sensus menjadi pilihan yang lebih baik ketika populasinya cukup kecil untuk dijangkau, ketika detail kontak sudah tersedia, atau ketika setiap anggota berhak untuk ditanya. Survei karyawan di organisasi berisi 200 orang adalah persoalan sensus, bukan persoalan pengambilan sampel. Begitu pula evaluasi kelas. Ketika populasinya kecil, pengambilan sampel hampir tidak memberi Anda apa pun dan justru membuat Anda kehilangan kemampuan melaporkan per tim.
Seperti apa sampel yang baik sebenarnya
Buku teks menggambarkan sampel yang baik sebagai "representatif", padahal itu bukan uji yang dapat dijalankan. Keempat sifat berikut dapat diuji.
- Cakupan: setiap orang dalam populasi sasaran pada prinsipnya dapat terpilih.
- Seleksi yang terkendali: siapa yang masuk ke sampel diputuskan oleh suatu aturan, bukan oleh siapa yang menawarkan diri atau siapa yang paling dekat dengan pintu.
- Unit yang cukup pada kelompok terkecil yang wajib Anda laporkan: angka keseluruhan bisa tampak sehat, sementara kelompok yang benar-benar Anda pedulikan hanya bertumpu pada 11 respons.
- Dapat dijelaskan: Anda dapat menuliskan dengan tepat bagaimana sampel ditarik, dan orang lain dapat mengulanginya.
| Jika tujuan Anda | Implikasi bagi pengambilan sampel | Jebakan umum |
|---|---|---|
| Mengestimasi persentase populasi | Gunakan metode probabilitas, pantau siapa yang menjawab, dan laporkan presisi bersama angkanya. | Memperlakukan sampel convenience seolah-olah menggambarkan populasi. |
| Membandingkan subkelompok | Rencanakan jumlah respons per subkelompok, biasanya dengan stratifikasi dan oversampling kelompok kecil. | Melaporkan subkelompok yang hasilnya hanya bertumpu pada segelintir orang. |
| Menggali pengalaman dan mekanisme | Seleksi purposive atau teoretis sudah tepat. Jelaskan alasan perspektif mana yang tercakup dan mana yang tidak. | Mengejar jumlah minimum tanpa alasan yang jelas. |
| Menguji suatu intervensi | Pengambilan sampel menentukan kepada siapa hasilnya dapat digeneralisasi. Penugasan acak menentukan apakah efeknya nyata. | Mengacaukan penugasan acak dengan pengambilan sampel acak. Keduanya operasi yang berbeda. |
Untuk penjelasan dengan bahasa sederhana tentang bagaimana sampel mendukung estimasi populasi, ikhtisar U.S. Census Bureau tentang pengambilan sampel survei dan inferensi adalah titik awal yang baik.2
Kerangka sampel menentukan batas atas
Kerangka sampel adalah daftar atau mekanisme konkret tempat Anda menarik sampel. Inilah bagian pengambilan sampel yang paling jarang dibahas dan tempat sebagian besar studi nyata diam-diam keliru, karena kerangka sampel menentukan siapa yang bahkan berhak untuk dipilih.
Kerangka sampel adalah benda biasa. Daftar mahasiswa, daftar pasien, daftar karyawan HR, basis data pelanggan. Daftar desa beserta jumlah rumah tangganya, daftar pemilih, serangkaian pesanan, daftar klinik di suatu kabupaten. Perhatikan bahwa sebagian kerangka sampel mendaftar orang dan sebagian mendaftar tempat. Perbedaan itulah yang menentukan metode mana yang tersedia bagi Anda.
| Masalah | Seperti apa wujudnya | Dampaknya pada hasil Anda |
|---|---|---|
| Undercoverage | Orang dalam populasi tidak ada di daftar: staf tanpa email kantor, pelanggan yang membeli langsung di toko, rumah tangga tanpa alamat terdaftar. | Seluruh segmen memiliki peluang terpilih nol. Respons tambahan tidak dapat memperbaikinya, karena orang yang hilang itu memang tidak pernah berpeluang terpilih. |
| Overcoverage | Daftar berisi unit di luar populasi Anda: mantan mahasiswa, akun yang sudah ditutup, orang yang sudah pindah. | Anda membuang tenaga dan, jika tidak menyaring mereka, Anda mengukur populasi yang salah. |
| Duplikasi | Orang yang sama muncul lebih dari sekali: dua alamat email, dua nomor akun. | Orang-orang itu mendapat peluang terpilih yang lebih tinggi daripada orang lain, yang diam-diam merusak asumsi peluang yang sama. |
| Data usang | Daftar itu akurat saat dibuat, tetapi tidak lagi sekarang. | Kontak yang tidak terkirim tampak seperti penolakan, sehingga tingkat respons dan diagnosis bias Anda sama-sama keliru. |
Audit kerangka sampel sebelum Anda menarik sampel, bukan sesudahnya. Hitung jumlah barisnya. Bandingkan jumlah itu dengan total independen yang dapat Anda temukan, misalnya jumlah karyawan menurut HR atau angka pendaftaran. Cari segmen yang paling memalukan jika sampai terlewat, lalu pastikan segmen itu ada. Hapus duplikat. Tuliskan apa yang dikecualikan oleh kerangka sampel, karena kalimat itu tetap harus masuk ke bagian keterbatasan Anda.
Convenience sampling, quota sampling, purposive sampling, dan snowball sampling sama sekali tidak memerlukan daftar. Cluster sampling dan multistage sampling hanya memerlukan daftar kelompok (sekolah, klinik, bangsal, desa), bukan daftar orang. Simple random sampling, systematic sampling, dan stratified sampling semuanya memerlukan daftar lengkap individu sebelum Anda dapat memulai. Jika Anda tidak punya daftar dan tidak dapat membuatnya, satu fakta itu saja sudah menyingkirkan tiga dari sembilan metode di halaman ini. Biasanya inilah hal pertama yang perlu dipastikan.
Perbandingan 9 metode pengambilan sampel
Metode pengambilan sampel terbagi menjadi dua keluarga. Pengambilan sampel probabilitas menggunakan mekanisme acak, sehingga setiap unit dalam kerangka sampel memiliki peluang terpilih yang diketahui dan tidak nol. Pengambilan sampel nonprobabilitas tidak demikian, sehingga peluang terpilihnya tidak diketahui. Semua hal lain mengikuti satu perbedaan itu.
Kolom kedua adalah kolom yang dilewatkan sebagian besar panduan, jadi di sini kolom itu didahulukan. Hanya desain probabilitas yang mendukung margin kesalahan, interval kepercayaan, atau kalimat "plus minus 5 poin". Jika suatu metode menjawab tidak di kolom itu, Anda tetap dapat belajar banyak darinya. Anda hanya tidak dapat memublikasikan angka presisi bersama hasilnya. Presisi itu sendiri termasuk pembahasan lain, yang diulas di panduan ukuran sampel kami.
| Metode | Mendukung margin kesalahan? | Cara kerjanya | Pilihan yang tepat bila | Biayanya, dan bias yang ditimbulkannya |
|---|---|---|---|---|
| Simple random sampling Probabilitas Perlu daftar lengkap |
Ya | Setiap unit dalam daftar memiliki peluang yang sama. Anda menarik jumlah yang diperlukan secara acak. | Anda memiliki satu daftar yang bersih dan bebas duplikat, serta tidak ada subkelompok yang wajib Anda laporkan secara terpisah. | BiayaAnda harus memiliki daftar lengkap, dan kelompok kecil bisa terlalu kecil untuk dilaporkan.BiasSangat sedikit pada tahap seleksi. Seluruh risiko yang tersisa berpindah ke siapa yang benar-benar menjawab. |
| Systematic sampling Probabilitas Perlu daftar lengkap |
Ya, jika urutan daftar tidak berkaitan dengan hasil yang diukur | Urutkan daftar, pilih titik awal secara acak, lalu ambil setiap catatan ke-k. | Daftarnya panjang atau datang sebagai aliran data, dan tim lapangan memerlukan satu aturan sederhana untuk diikuti. | BiayaHampir nol, selama urutannya tidak berkaitan dengan apa yang Anda ukur.BiasPeriodisitas. Jika daftar berulang dalam siklus yang sejajar dengan interval Anda, Anda terus mengenai jenis unit yang sama. |
| Stratified sampling Probabilitas Perlu daftar lengkap |
Ya, dan biasanya lebih sempit daripada simple random sampling | Bagi daftar ke dalam kelompok penting (strata), lalu ambil sampel di dalam setiap kelompok. | Anda harus melaporkan per wilayah, fakultas, departemen, atau kelompok usia, atau Anda memperkirakan respons akan sangat berbeda antarkelompok. | BiayaVariabel pengelompokan harus sudah ada di daftar sebelum Anda menarik sampel, dan proporsi yang tidak sama harus diberi bobot saat analisis.BiasRendah. Risiko sebenarnya adalah memilih strata yang tidak berkaitan dengan hasil yang diukur, yang menambah pekerjaan tanpa menambah presisi. |
| Cluster sampling Probabilitas Perlu daftar kelompok |
Ya, diperlebar sesuai design effect | Pilih seluruh kelompok secara acak (sekolah, klinik, bangsal, desa), lalu survei semua orang di dalam kelompok yang terpilih. | Anda tidak dapat mendaftar individu, tetapi dapat mendaftar tempat mereka berada, dan biaya perjalanan atau persiapan mendominasi anggaran. | BiayaPresisi. Orang-orang di dalam satu kelompok mirip satu sama lain, sehingga setiap respons tambahan membawa lebih sedikit informasi baru.BiasRendah jika kelompok dipilih secara acak, tetapi jumlah kelompok yang sedikit membuat hasilnya tidak stabil dan sulit dipertahankan. |
| Multistage sampling Probabilitas Perlu daftar kelompok |
Ya, dengan pembobotan dan design effect | Ambil sampel kelompok terlebih dahulu, lalu ambil sampel unit di dalam kelompok yang terpilih, dalam dua tahap atau lebih. | Studi tingkat kabupaten atau nasional ketika tidak ada satu daftar orang, tetapi ada daftar unit administratif. | BiayaKerumitan. Peluang terpilih berbeda antarunit, sehingga analisis memerlukan pembobotan dan seseorang yang mampu menerapkannya.BiasRendah secara prinsip. Dalam praktiknya, setiap tahap adalah peluang baru bagi tim lapangan untuk menyimpang dari rencana. |
| Convenience sampling Nonprobabilitas Tanpa perlu daftar |
Tidak | Anda mengambil siapa pun yang paling mudah dijangkau: pop-up di situs web, kelas yang Anda ajar, orang yang lewat di depan stan. Disebut juga availability sampling. | Anda sedang menjajaki, melakukan studi pilot atas kuesioner, atau membutuhkan arah minggu ini, bukan angka yang dapat dipertanggungjawabkan pada kuartal berikutnya. | BiayaKlaimnya. Anda kehilangan kemampuan untuk menyatakan apa pun tentang populasi.BiasSeleksi diri. Metode ini terlalu mewakili mereka yang mudah dijangkau, yang sedang senggang, dan yang sudah terlibat. |
| Quota sampling Nonprobabilitas Tanpa perlu daftar |
Tidak. Tampak seimbang tanpa benar-benar acak | Tetapkan target untuk tiap kelompok, misalnya 50 perempuan dan 50 laki-laki, atau 40 dari perdesaan dan 60 dari perkotaan, lalu rekrut sampai setiap target terpenuhi. | Anda memerlukan sampel yang setidaknya sesuai dengan populasi pada karakteristik yang terlihat, dengan cepat, tanpa daftar untuk menarik sampel. | BiayaKendali atas siapa yang mengisi setiap kuota. Perekrut tetap memilih, dan mereka memilih orang yang mudah didekati.BiasBias seleksi di dalam kuota. Menyamakan usia dan jenis kelamin tidak membuat orang menjadi tipikal dalam hal sikap. |
| Purposive sampling Nonprobabilitas Tanpa perlu daftar |
Tidak, dan memang tidak bermaksud demikian | Anda dengan sengaja memilih kasus yang memenuhi kriteria yang dinyatakan: pakar, kasus ekstrem, kasus tipikal, kasus kritis. Disebut juga judgement sampling. | Penelitian kualitatif, wawancara pakar, studi kasus, dan setiap pertanyaan yang lebih mementingkan kedalaman daripada hitungan. | BiayaTidak ada, asalkan Anda jelas menyatakan bahwa Anda memang tidak pernah menghitung.BiasModel peneliti sendiri tentang siapa yang dianggap relevan. |
| Snowball sampling Nonprobabilitas Tanpa perlu daftar |
Tidak | Rekrut beberapa partisipan, lalu minta masing-masing dari mereka merujuk orang lain yang memenuhi kriteria. | Kelompoknya tersembunyi, terstigma, langka, atau tidak terdaftar: pekerja migran, orang yang berhenti memakai suatu layanan, pedagang informal, orang dengan kondisi langka. | BiayaWaktu, dan kendali atas bentuk sampel. Anda mewarisi jaringan sosial orang-orang yang menjadi titik awal Anda.BiasHomofili. Orang merujuk orang yang mirip dengan diri mereka, sehingga satu sudut populasi terlalu banyak terambil. |
Cara membaca tabel: lima metode pertama adalah desain probabilitas dan empat terakhir bukan. Satu pemisahan itulah, bukan nama masing-masing metode, yang menentukan apakah angka presisi itu jujur.
Metode pengambilan sampel probabilitas, satu per satu
Pengambilan sampel probabilitas berarti setiap unit dalam kerangka sampel memiliki peluang terpilih yang diketahui dan tidak nol, dan mekanisme acaklah yang melakukan pemilihan. Itulah seluruh dasar untuk menyatakan apa pun secara numerik tentang populasi. Lima desain mencakup hampir setiap studi nyata. Tinjauan penelitian klinis dan kesehatan membahas keluarga yang sama dengan label yang sedikit berbeda, dan ada baiknya Anda tahu sebabnya sebelum menemui keduanya: masing-masing dari dua tinjauan yang dikutip di sini memasukkan multistage sampling ke dalam cluster sampling alih-alih mencantumkannya secara terpisah.34
Simple random sampling
Simple random sampling memberi setiap unit dalam daftar peluang terpilih yang persis sama. Anda memberi nomor pada daftar, membangkitkan angka acak, dan mengambil unit yang terkena angka itu.
Contoh penerapan. Daftar mahasiswa sebuah universitas memuat 12.000 mahasiswa terdaftar dan Anda memerlukan 400 respons. Beri nomor 1 sampai 12.000 pada daftar, bangkitkan 400 angka acak unik dalam rentang itu dengan spreadsheet atau paket statistik, lalu undang mahasiswa tersebut. Jika Anda memperkirakan tingkat respons 40 persen, tarik dan undang 1.000 orang agar 400 respons lengkap menjadi realistis.
Di mana metode ini gagal. Dengan 400 respons yang tersebar di daftar berisi 12.000 mahasiswa, sebuah departemen berisi 300 mahasiswa hanya menyumbang sekitar 10 orang. Itu tidak cukup untuk dilaporkan. Jika ada subkelompok yang harus muncul dalam hasil Anda, simple random sampling adalah alat yang salah dan stratified sampling adalah solusinya.
Catat proses pengacakan Anda. Perangkat lunak yang dipakai, seed jika ada, dan tanggalnya. Satu kalimat itulah yang membuat penarikan dapat diulang, dan penelaah memang memintanya.
Systematic sampling
Systematic sampling mengambil setiap unit ke-k dari daftar yang berurutan setelah titik awal acak. Bagi ukuran daftar dengan jumlah yang Anda perlukan untuk mendapatkan interval k, pilih angka acak antara 1 dan k sebagai titik awal, lalu hitung maju.
Contoh penerapan. Sebuah rumah sakit daerah mencatat 9.000 kunjungan rawat jalan dalam satu kuartal dan menginginkan 600 wawancara saat pasien keluar. Intervalnya adalah 9.000 dibagi 600, jadi k sama dengan 15. Pilih titik awal acak antara 1 dan 15, misalnya 7, lalu wawancarai kunjungan ke-7, 22, 37, 52, dan seterusnya. Tim lapangan dapat mengikuti aturan itu tanpa laptop, dan itulah alasan sebenarnya metode ini tetap bertahan.
Di mana metode ini gagal. Periodisitas. Jika daftar memiliki siklus berulang yang sejajar dengan k, Anda mengambil sampel dari slot yang sama setiap kali. Daftar kunjungan yang diurutkan menurut hari klinik dengan siklus 7 hari dan interval 7 hanya akan memberi Anda satu hari kerja dan tidak ada yang lain. Periksa urutannya sebelum Anda menetapkan k, dan acak ulang daftar jika urutannya berkaitan dengan apa yang Anda ukur.
Stratified sampling
Stratified sampling membagi populasi ke dalam kelompok yang tidak saling tumpang tindih, yang disebut strata, lalu menarik sampel acak di dalam setiap stratum. Inilah peningkatan paling berguna yang tersedia bagi sebagian besar studi, karena metode ini menjamin bahwa setiap kelompok yang wajib Anda laporkan benar-benar muncul.
Contoh penerapan beserta perhitungannya. Sebuah organisasi memiliki 4.200 staf di enam provinsi dan memerlukan 600 respons.
- Alokasi proporsional. Provinsi dengan 1.400 staf memuat 1.400 dibagi 4.200, yaitu sepertiga tenaga kerja, sehingga mendapat sepertiga dari 600, yaitu 200 respons. Provinsi dengan 210 staf mendapat 210 dibagi 4.200 dikali 600, yaitu 30 respons. Setiap provinsi terwakili sebanding dengan ukurannya, dan tidak diperlukan pembobotan saat analisis.
- Alokasi tidak proporsional, disebut juga oversampling. Tiga puluh respons terlalu sedikit untuk melaporkan provinsi kecil itu secara terpisah. Jadi Anda dengan sengaja mengambil 80 respons dari provinsi itu, dan mengurangi jatah provinsi terbesar sebagai gantinya. Sekarang peluang terpilih berbeda antarprovinsi, sehingga Anda harus membobot data kembali ke proporsi sebenarnya sebelum mengutip angka apa pun untuk seluruh organisasi. Melewatkan langkah itu adalah kesalahan stratified sampling yang paling umum.
Memilih strata. Pilih variabel yang berkaitan dengan hasil yang diukur atau dengan siapa yang cenderung menjawab, dan yang sudah ada di kerangka sampel Anda. Wilayah, lokasi, jabatan, kelompok masa kerja, mata kuliah, jenis paket, dan kelompok usia adalah kandidat yang biasa. Strata yang tidak berkaitan dengan hasil yang diukur menambah urusan administrasi tanpa menambah presisi. Jika variabel pengelompokan tidak ada di kerangka sampel Anda, Anda mungkin perlu mengumpulkannya di dalam kuesioner. Panduan kami tentang pertanyaan demografis dalam survei membahas cara menanyakan variabel tersebut tanpa kehilangan responden.
Cluster sampling
Cluster sampling memilih secara acak seluruh kelompok yang terbentuk secara alami, lalu menyurvei semua orang di dalam kelompok yang terpilih. Anda memerlukan daftar kelompok, bukan daftar orang, dan itulah alasan metode ini ada.
Contoh penerapan. Sebuah kabupaten memiliki 180 sekolah dasar dan tidak memiliki daftar murid terpusat. Anda memilih 24 sekolah secara acak dan menyurvei setiap murid kelas 8 di masing-masing sekolah. Anda melakukan 24 kunjungan sekolah, bukan 180, dan Anda tidak pernah memerlukan daftar murid untuk memulai.
Harga yang Anda bayar. Murid di sekolah yang sama lebih mirip satu sama lain daripada dengan murid di seluruh kabupaten. Jadi setiap murid tambahan di sekolah yang sudah Anda pilih menambahkan lebih sedikit informasi baru dibandingkan murid yang independen. Jumlah respons efektif Anda lebih kecil daripada jumlah respons yang sebenarnya. Penggelembungan itu adalah design effect, dan harus dimasukkan ke dalam rencana, bukan baru ditemukan saat analisis.
Di mana metode ini gagal. Terlalu sedikit klaster. Enam sekolah yang dipilih secara acak bisa sangat berbeda satu sama lain, dan hasilnya berayun tergantung enam sekolah mana yang kebetulan Anda tarik. Lebih banyak klaster dengan lebih sedikit orang di masing-masing hampir selalu lebih baik daripada sebaliknya.
Multistage sampling
Multistage sampling memilih dalam dua tahap atau lebih: kelompok terlebih dahulu, lalu unit di dalam kelompok yang terpilih, dan kadang tahap ketiga di dalamnya. Hampir setiap survei rumah tangga nasional di dunia dibangun dengan cara ini.
Contoh penerapan. Pilih 120 kelurahan dari daftar kelurahan nasional. Di dalam setiap kelurahan terpilih, tim lapangan mendaftar rumah tangga langsung di lapangan, lalu memilih 20 di antaranya secara acak. Di dalam setiap rumah tangga terpilih, satu orang dewasa dipilih secara acak, bukan diserahkan kepada siapa pun yang membuka pintu. Itu tiga tahap, dan tahap terakhir penting: membiarkan rumah tangga menentukan siapa yang menjawab memunculkan kembali bias seleksi yang justru hendak dihindari oleh desain ini.
Harga yang Anda bayar. Orang yang berbeda akhirnya memiliki peluang terpilih yang berbeda, sehingga analisis memerlukan pembobotan, dan perhitungan varians harus memperhitungkan pengklasteran di setiap tahap. Ini adalah desain sungguhan yang memerlukan seseorang yang mampu melakukan analisis berbobot. Jika tidak ada seorang pun dalam proyek yang mampu, pilih desain yang lebih sederhana daripada desain multistage tanpa pembobotan.
Pendalaman untuk pakar: probability proportional to size, dan mengapa klaster besar lebih sering terpilih
Dalam contoh sekolah, setiap sekolah memiliki peluang terpilih yang sama, baik sekolah itu memuat 60 murid maupun 900. Akibatnya, murid di sekolah kecil memiliki peluang jauh lebih tinggi untuk masuk ke sampel daripada murid di sekolah besar. Analisis kemudian harus mengoreksinya.
Seleksi probability proportional to size memperbaiki hal ini pada tahap desain. Peluang terpilih setiap klaster ditetapkan sebanding dengan banyaknya unit yang dimuatnya. Sekolah berisi 900 murid kemudian lima belas kali lebih mungkin ditarik daripada sekolah berisi 60 murid. Lalu Anda mengambil jumlah murid yang sama dari setiap sekolah terpilih. Kedua tahap saling meniadakan, dan setiap murid di kabupaten itu akhirnya memiliki peluang terpilih keseluruhan yang kurang lebih sama. Ini adalah pendekatan standar dalam survei nasional, dan memerlukan data ukuran (jumlah unit) setiap klaster dalam kerangka sampel sebelum Anda menarik sampel.
Stratified vs cluster sampling: perbedaannya dalam satu kalimat
Keduanya terus-menerus tertukar, karena sama-sama dimulai dengan membagi populasi ke dalam kelompok. Perbedaannya ada pada apa yang Anda lakukan sesudahnya.
| Aspek | Stratified sampling | Cluster sampling |
|---|---|---|
| Kelompok mana yang Anda gunakan | Sampel diambil dari setiap kelompok. | Sebagian kelompok dipilih, sisanya sama sekali tidak dipakai. |
| Siapa yang diambil sampelnya di dalam kelompok | Subset acak dari kelompok itu. | Semua orang dalam kelompok, atau subset acak lanjutan dalam versi multistage. |
| Kelompok sebaiknya | Seragam di dalamnya, dan berbeda satu sama lain. Wilayah, jabatan, mata kuliah. | Beragam di dalamnya, masing-masing menjadi salinan kecil populasi. Sekolah, klinik, bangsal. |
| Mengapa Anda memilihnya | Presisi, dan keterwakilan subkelompok yang terjamin. | Biaya dan keterjangkauan ketika tidak ada daftar individu. |
| Pengaruh pada presisi | Biasanya meningkatkannya dibandingkan simple random sampling pada jumlah respons yang sama. | Menurunkannya. Anggarkan design effect. |
| Yang Anda perlukan sebelum memulai | Daftar lengkap individu, dengan variabel pengelompokan sudah tercantum di dalamnya. | Daftar kelompok saja. |
Stratified: semua kelompok, sebagian orang. Cluster: sebagian kelompok, semua orang. Stratified soal ketepatan, cluster soal keterjangkauan.
Metode pengambilan sampel nonprobabilitas, satu per satu
Pengambilan sampel nonprobabilitas berarti peluang terpilih tidak diketahui, karena tidak ada mekanisme acak yang menentukan siapa yang dipilih. Ini pilihan yang tepat dalam empat situasi. Anda tidak dapat membuat kerangka sampel yang layak pakai. Kelompoknya tersembunyi. Kecepatan lebih penting daripada presisi. Atau pertanyaannya menyangkut makna, bukan besaran.
Metode-metode ini bukan kelas dua. Metode ini menjawab pertanyaan yang berbeda. Kesalahannya bukan pada memakainya, melainkan memakainya lalu menulis kalimat yang hanya dapat didukung oleh sampel probabilitas.
Convenience sampling
Convenience sampling, disebut juga availability sampling, merekrut siapa pun yang paling mudah dijangkau. Pop-up di situs web, tautan di buletin, mahasiswa di kelas Anda sendiri, orang yang lewat di depan stan di pasar.
Contoh. Sebuah toko mencantumkan tautan umpan balik di struk. Setiap orang yang menjawab sudah membeli sesuatu, membawa ponsel, punya waktu, dan punya alasan untuk repot-repot menjawab. Setiap saringan itu menghilangkan bagian basis pelanggan yang berbeda.
Penggunaan yang jujur. Studi pilot atas kuesioner, menyusun hipotesis, mengetahui bahasa yang dipakai pelanggan, memeriksa apakah suatu pertanyaan dipahami. Semuanya kegunaan yang sangat baik. Tidak satu pun memerlukan estimasi populasi.
Quota sampling
Quota sampling menetapkan target perekrutan untuk kelompok-kelompok tertentu lalu memenuhinya. Empat puluh dari perdesaan dan enam puluh dari perkotaan. Lima puluh perempuan dan lima puluh laki-laki. Dua puluh di masing-masing dari lima kelompok usia.
Contoh. Sebuah tim riset pasar memerlukan 500 respons yang sesuai dengan komposisi nasional menurut usia, jenis kelamin, dan wilayah, dan tidak memiliki daftar populasi. Mereka merekrut sampai setiap sel terisi penuh.
Mengapa ini tetap bukan pengambilan sampel probabilitas. Kuota mengendalikan bentuk sampel, bukan pemilihan orang di dalamnya. Siapa pun yang merekrut tetap memilih, dan orang yang mudah didekati berbeda secara sistematis dari orang yang tidak mudah didekati. Sebuah sampel dapat sesuai sempurna dengan populasi dalam hal usia dan jenis kelamin, tetapi tetap sangat keliru tentang sikap, karena usia dan jenis kelamin memang tidak pernah menjadi variabel penyebab kekeliruannya.
Purposive sampling
Purposive sampling, disebut juga judgement sampling, dengan sengaja memilih kasus yang memenuhi kriteria yang dinyatakan. Varian yang umum adalah pemilihan kasus tipikal, kasus ekstrem, kasus kritis, variasi maksimum, dan pakar.
Contoh. Sebuah studi tentang cara sistem pembayaran baru digunakan memilih delapan orang. Dua orang yang memakainya setiap hari, dua orang yang berhenti memakainya, dua orang yang tidak pernah mulai memakainya, dan dua staf dukungan yang menangani keluhan. Sebaran itu dipilih dengan sengaja, dan penalaran itulah metodenya.
Penggunaan yang jujur. Sebagian besar penelitian kualitatif. Standarnya di sini bukan keacakan, melainkan apakah Anda dapat menjelaskan mengapa kasus-kasus ini dan bukan yang lain, serta apakah rentang pandangannya cukup luas untuk mendukung klaim Anda.
Snowball sampling
Snowball sampling merekrut sejumlah kecil partisipan yang kemudian merujuk orang lain yang memenuhi kriteria, dan mereka merujuk lebih banyak lagi.
Contoh. Sebuah studi tentang pedagang lintas batas informal dimulai dengan empat partisipan yang dikenali melalui asosiasi setempat, dan masing-masing memperkenalkan dua orang lagi. Tidak ada daftar resmi pedagang informal, sehingga tidak ada metode berbasis kerangka sampel yang dapat dipakai.
Dampaknya pada sampel Anda. Homofili. Orang merujuk orang yang mirip dengan diri mereka. Sampel bergeser ke satu jaringan sosial dan menjauh dari anggota populasi yang terisolasi, padahal sering kali merekalah yang paling perlu didengar oleh penelitian. Memulai dari beberapa titik awal yang tidak saling terhubung, bukan satu, mengurangi pergeseran itu tetapi tidak menghilangkannya.
Cara membuat sampel nonprobabilitas dapat dipertanggungjawabkan
Sebagian besar panduan berhenti pada "Anda tidak dapat menggeneralisasi" lalu membiarkan pembaca kebingungan, padahal sebagian besar pembaca menjalankan studi persis seperti ini. Inilah bagian yang biasanya terlewat.
- Jelaskan proses perekrutan, bukan hanya nama metodenya. Di mana tautan dipasang, pada rentang tanggal berapa, siapa yang melihatnya, apakah insentif ditawarkan, dan berapa banyak yang didekati dibandingkan berapa banyak yang menjawab. Inilah yang memungkinkan pembaca menilai sampel alih-alih menebak.
- Bandingkan sampel yang Anda peroleh dengan tolok ukur yang diketahui dan publikasikan perbandingannya. Jika organisasi Anda terdiri dari 60 persen staf lapangan dan responden Anda hanya 25 persen staf lapangan, nyatakan hal itu dalam tabel. Ketimpangan yang dinyatakan adalah sebuah temuan. Ketimpangan yang disembunyikan adalah sebuah cacat.
- Pahami apa yang dapat dan tidak dapat dilakukan pembobotan. Menyesuaikan data agar demografinya cocok dengan populasi dapat mengoreksi ketidakseimbangan yang terlihat. Pembobotan tidak dapat mengoreksi orang yang berbeda dari responden dalam hal yang tidak Anda ukur, dan tidak pernah mengubah sampel nonprobabilitas menjadi sampel yang mendukung klaim presisi.
- Ubah kalimatnya, bukan statistiknya. Alih-alih "38 persen pelanggan tidak puas, plus minus 4 poin", tulis "38 persen dari 620 pelanggan yang menjawab melaporkan ketidakpuasan. Responden direkrut melalui notifikasi di dalam aplikasi selama dua minggu dan bukan sampel acak dari pelanggan." Kalimat kedua lebih pendek, lebih berguna, dan tidak dapat diserang.
Penelitian kualitatif punya kosakata sendiri untuk hal ini. Protokol biasanya meminta alasan, bukan target angka. Protokol itu sebaiknya mencakup jumlah yang direncanakan dan rentang pandangan, perbedaan yang dinyatakan secara ringkas oleh panduan University of Bath.5
Cocokkan metode dengan situasinya
Enam situasi, enam metode. Putuskan sebelum Anda membuka jawabannya. Inilah cara tercepat untuk mengetahui apakah tabel di atas benar-benar Anda pahami.
1. Anda memiliki daftar staf lengkap berisi 4.200 orang dan wajib memublikasikan hasil untuk masing-masing dari enam provinsi.
Stratified sampling. Daftar lengkapnya ada, sehingga pengambilan sampel probabilitas terbuka bagi Anda, dan kewajiban melaporkan per provinsi adalah persis tujuan stratifikasi. Simple random sampling akan membuat provinsi terkecil memiliki terlalu sedikit respons untuk dilaporkan.
2. Anda meneliti orang yang berhenti memakai suatu layanan enam bulan lalu. Tidak ada daftar, dan mereka yang berhenti dengan paling marah adalah yang paling sulit ditemukan.
Snowball sampling. Tidak ada kerangka sampel dan populasinya sulit dijangkau, sehingga semua metode probabilitas tersingkir. Mulailah dari beberapa titik awal yang tidak saling terhubung, bukan satu, dan nyatakan dalam bagian keterbatasan bahwa rantai rujukan membuat sampel condong ke orang-orang yang saling terhubung.
3. Sebuah rumah sakit menginginkan data pengalaman pasien dari aliran 9.000 kunjungan per kuartal, yang dikumpulkan oleh staf tanpa komputer di meja layanan.
Systematic sampling. Populasinya datang sebagai aliran yang berurutan, sehingga aturan interval adalah metode probabilitas sekaligus sesuatu yang benar-benar dapat dijalankan oleh meja layanan yang sibuk. Periksa terlebih dahulu bahwa urutan kunjungan tidak mengikuti siklus mingguan yang sejajar dengan interval Anda.
4. Anda perlu memahami mengapa sebuah alat baru ditinggalkan, dan Anda hanya punya tiga minggu tanpa anggaran.
Purposive sampling. Pertanyaannya menyangkut mekanisme, bukan besaran. Pilih dengan sengaja di seluruh rentang: pengguna berat, yang berhenti memakai, yang tidak pernah mengadopsi, staf dukungan. Jangan melaporkan persentase dari sampel ini.
5. Sebuah kabupaten memiliki 180 sekolah, tidak ada daftar murid, dan anggaran perjalanan yang cukup untuk sekitar 25 kunjungan lokasi.
Cluster sampling. Daftar sekolah tersedia meskipun daftar murid tidak, dan biaya perjalanan adalah kendala yang mengikat. Perlebar interval yang Anda laporkan sesuai design effect, dan utamakan lebih banyak sekolah dengan lebih sedikit murid di masing-masing daripada sebaliknya.
6. Anda harus mengumpulkan 500 respons dalam lima hari yang sesuai dengan profil usia dan wilayah nasional, dan tidak ada daftar populasi.
Quota sampling. Inilah cara tercepat untuk mendapatkan sampel yang setidaknya sesuai dengan populasi pada karakteristik yang terlihat. Ini tetap bukan sampel probabilitas, jadi laporkan komposisinya dan lewati klaim presisi.
Cara memilih metode pengambilan sampel
Sebagian besar studi gagal bukan karena seseorang memilih teknik bernama yang salah. Studi gagal karena tekniknya tidak sesuai dengan kerangka sampel, keputusan yang hendak diambil, atau apa yang secara realistis dapat dilakukan tim lapangan. Tiga pertanyaan hampir selalu menyelesaikannya.
Metode mana yang cocok untuk studi Anda?
Jawab tiga pertanyaan. Rekomendasi muncul di bawah dan baris yang sesuai disorot di tabel perbandingan.
Mulailah dari klaim yang perlu Anda buat
Tulis kalimat yang ingin Anda publikasikan, sebelum Anda memilih apa pun. "Enam puluh dua persen pelanggan kami akan merekomendasikan kami" dan "pelanggan yang berhenti menggambarkan tiga masalah yang berulang" adalah kalimat berbeda yang memerlukan desain berbeda. Jika tidak ada yang akan memperlakukan hasilnya sebagai angka populasi, Anda punya keleluasaan jauh lebih besar daripada yang Anda kira.
Audit kerangka sampel sebelum Anda berkomitmen
Dapatkah Anda benar-benar mendaftar populasi, atau proksi yang mendekatinya? Jika tidak, dapatkah Anda mendaftar kelompok tempat mereka berada? Menjawab satu pertanyaan ini langsung menyingkirkan sebagian besar dari sembilan metode, itulah sebabnya pertanyaan ini berada di urutan kedua, bukan terakhir.
Sebutkan subkelompok yang wajib Anda laporkan
Jika suatu hasil harus muncul untuk setiap wilayah, lokasi, atau jabatan, hal itu menentukan desain melalui strata atau kuota. Hal itu juga menentukan berapa banyak respons yang Anda perlukan di setiap kelompok. Memutuskan hal ini setelah kerja lapangan tidak dapat dipulihkan.
Periksa desain terhadap kenyataan di lapangan
Waktu, anggaran, kemudahan dihubungi, akses bahasa, literasi, konektivitas, dan kebijakan insentif menentukan apa yang dapat dijalankan. Desain yang tidak dapat diikuti tim lapangan berubah menjadi convenience sampling dengan nama resmi yang ditempelkan, dan itu lebih buruk daripada memilih convenience sampling secara jujur. Perencanaan perekrutan yang inklusif mengurangi kurangnya keterwakilan yang sistematis.6 Setelah Anda memilih sampel, gunakan pembuat survei online untuk menyiapkan kuesioner dan mengirimkannya kepada orang-orang yang dipilih oleh rencana pengambilan sampel Anda. Membagikan tautan publik tanpa batasan mengubah siapa yang dapat menjawab; cara itu tidak mempertahankan sampel acak.
Di mana sampel benar-benar gagal: cakupan, seleksi, dan nonrespons
Seleksi adalah bagian yang dikhawatirkan semua orang sekaligus bagian yang paling jarang salah. Kerusakan biasanya terjadi sebelum seleksi, di kerangka sampel, atau sesudahnya, pada siapa yang mau repot menjawab. Keduanya menghasilkan spreadsheet yang tampak rapi dan kesimpulan yang salah.
| Kesalahan | Seperti apa wujudnya | Cara menguranginya |
|---|---|---|
| Kesalahan cakupan, masalah kerangka sampel | Sebagian orang sama sekali tidak dapat terpilih: tidak punya email kantor, daftar karyawan yang usang, pelanggan yang hanya membeli langsung di toko, rumah tangga tanpa konektivitas. | Perbaiki atau gabungkan kerangka sampel. Tambahkan moda: kertas, tatap muka, telepon, SMS. Dokumentasikan dengan tepat siapa yang dikecualikan. |
| Bias seleksi, masalah prosedur | Aturan acak dikesampingkan dalam praktik. Siapa cepat dia dapat. Seorang manajer menunjuk siapa yang ikut serta. | Otomatiskan penarikan sampel. Pisahkan orang yang memilih dari orang yang merekrut. Audit setiap pengecualian. |
| Bias nonrespons, masalah hasil | Orang yang terpilih tidak menjawab, dan mereka yang tidak menjawab berbeda dari mereka yang menjawab dalam hal yang sedang Anda ukur. | Perbaiki strategi kontak dan pengalaman mengisi kuesioner, lalu bandingkan responden dengan tolok ukur yang diketahui. Lihat bias respons. |
| Kesalahan pengukuran | Sampel yang sempurna tetap memberi Anda hasil yang tidak masuk akal karena pertanyaannya menggiring, samar, atau bermakna ganda (double-barrelled). | Uji instrumen sebelum turun ke lapangan. Panduan kami tentang menulis pertanyaan survei membahas kesalahan yang umum. |
Kegagalan pengambilan sampel paling terkenal memiliki 2,4 juta responden
Pada 1936, Literary Digest memprediksi Alf Landon akan meraih sekitar 55 persen suara. Franklin Roosevelt menang dengan sekitar 61 persen.7 Majalah itu telah mengirimkan 10 juta surat suara dan menerima sekitar 2,4 juta kembali, tingkat respons 24 persen yang tidak dapat didekati oleh jajak pendapat nasional mana pun saat ini.8 Jajak pendapat itu menempatkan Roosevelt dua puluh poin di bawah perolehan sebenarnya, dengan sampel dua setengah juta orang.
Angka yang seharusnya ada di setiap halaman tentang pengambilan sampel. Sebuah analisis ulang di kemudian hari menghitung margin kesalahan sampel untuk estimasi tingkat negara bagian dari Digest: rentangnya 0,18 hingga 2,3 poin persentase, dengan median 0,6.8 Angka presisi plus minus setengah poin, di atas kesalahan sebesar dua puluh poin. Tidak ada yang menunjukkan dengan lebih gamblang bahwa margin kesalahan hanya mengukur satu dari sekian cara sebuah survei bisa keliru.
Dan penjelasan bakunya hanya separuh benar. Semua orang diajari bahwa Digest mengambil sampel dari pemilik mobil dan pelanggan telepon, yang kaya dan pendukung Partai Republik. Satu uji empiris atas klaim itu menggunakan survei Gallup dari Mei 1937. Orang yang memiliki mobil sekaligus telepon tetap condong ke Roosevelt, 55 berbanding 45. Di antara semua orang yang mengaku menerima surat suara Digest, Roosevelt unggul 55 berbanding 44. Kerangka sampelnya memang condong ke Partai Republik, tetapi jauh dari cukup untuk menghasilkan kemenangan telak Landon.7
Separuh yang hilang adalah nonrespons. Di antara orang yang mengaku mengembalikan surat suaranya, Landon unggul 51 berbanding 48. Di antara mereka yang tidak mengembalikannya, Roosevelt unggul 69 berbanding 30. Dekomposisi kasarnya menempatkan sekitar sebelas poin kesalahan pada kerangka sampel dan sekitar tujuh poin pada nonrespons diferensial.7 Membobot surat suara yang kembali berdasarkan pertanyaan yang sudah diajukan Digest, yaitu pilihan responden pada 1932, akan menghasilkan pemenang yang benar dengan aritmetika yang sudah tersedia pada 1936.8
Tingkat respons yang tinggi bukanlah target seperti yang Anda kira
Tingkat respons jajak pendapat telepon milik Pew Research Center sendiri turun dari 36 persen pada 1997 menjadi 9 persen pada 2012, dan menjadi 6 persen pada 2018.9 Sementara itu, National Family Health Survey India, yang dilakukan secara tatap muka, memilih 664.972 rumah tangga dan mendapati 653.144 di antaranya berpenghuni. Survei itu mewawancarai 636.699 di antaranya, tingkat respons 97,5 persen. Bacalah penyebutnya dengan cermat, karena di situlah tingkat respons paling sering keliru: jika dihitung terhadap jumlah yang dipilih alih-alih jumlah yang berpenghuni, kerja lapangan yang sama terbaca 95,7 persen. Survei itu menarik sampelnya dari 30.456 klaster di seluruh 707 distrik.10
Kedua fakta itu berada dalam dekade yang sama. Moda dan upaya kerja lapangan jauh lebih menentukan tingkat respons daripada klaim umum apa pun tentang kejenuhan survei. Jika sebuah panduan mengatakan bahwa rata-rata tingkat respons adalah satu angka tertentu, panduan itu tidak sedang menggambarkan besaran yang nyata.
Sekarang temuan yang lebih sulit. Sebuah meta-analisis atas 235 estimasi bias nonrespons dari 30 studi yang dipublikasikan menemukan bahwa korelasi antara tingkat respons dan besarnya bias nonrespons adalah 0,33. Jika dikuadratkan, artinya tingkat respons menjelaskan sekitar 11 persen variasi bias.11 Studi lanjutan atas 59 studi yang dirancang khusus untuk mengukur bias nonrespons sampai pada kesimpulan yang sama.12
Tingkat respons layak dilaporkan dan layak ditingkatkan. Tingkat respons bukan sertifikat. Yang menyebabkan bias adalah apakah kecenderungan untuk menjawab berkaitan dengan hal yang Anda ukur. Survei tentang kegiatan sukarela jauh lebih menderita karena hal itu daripada survei tentang kecepatan internet. Kejarlah korelasinya, bukan persentasenya.
Lebih banyak respons tidak dapat memperbaiki kerangka sampel yang rusak
Selama peluncuran vaksinasi 2021, dua survei yang sangat besar memantau cakupan vaksin di Amerika Serikat. Survei pertama mengumpulkan sekitar 250.000 respons per minggu dan melebih-lebihkan cakupan dosis pertama sebesar 17 poin persentase dibandingkan tolok ukur resmi. Survei kedua mengumpulkan sekitar 75.000 respons setiap dua minggu dan melebih-lebihkannya sebesar 14 poin. Survei ketiga dengan sekitar 1.000 responden, yang dijalankan sesuai praktik standar probabilitas, menghasilkan estimasi yang andal.13
Pola yang sama muncul dalam pekerjaan survei sehari-hari. Dalam perbandingan tiga panel probabilitas dengan tiga sumber online berbasis opt-in pada 28 tolok ukur dan 29.937 wawancara, rata-rata kesalahan absolut adalah 5,8 poin persentase untuk sampel opt-in dan 2,6 untuk panel probabilitas. Pada 25 tolok ukur yang tersedia untuk subkelompok, selisih untuk orang dewasa berusia 18 sampai 29 tahun adalah 11,2 berbanding 3,6.14
Dan satu diagnostik yang mudah diingat: dalam satu survei opt-in, 12 persen orang dewasa di bawah 30 tahun mengaku memiliki izin mengoperasikan kapal selam nuklir.15 Angka sebenarnya mendekati nol. Jika sebuah panel dapat menghasilkan angka itu, panel itu dapat menghasilkan apa saja, dan pesanan yang lebih besar dari panel yang sama hanya membeli lebih banyak hal serupa.
Siapa yang terlewat oleh kerangka sampel Anda, di luar AS dan Inggris
Sebagian besar panduan pengambilan sampel diam-diam mengasumsikan kerangka sampel ala Barat: daftar email, telepon rumah, daftar alamat nasional. Sebagian besar dunia tidak mengambil sampel dengan cara itu, dan celah cakupannya memiliki pola yang terukur.
- Survei online di negara berpendapatan rendah atau menengah adalah sampel dari bagian negara itu yang terhubung ke internet, dan bagian itu condong ke laki-laki. Perempuan di negara berpendapatan rendah dan menengah 14 persen lebih kecil kemungkinannya dibandingkan laki-laki untuk menggunakan internet seluler, yang kira-kira setara dengan 235 juta lebih sedikit perempuan daripada laki-laki yang online.16
- Sampel telepon terlalu mewakili kepala rumah tangga. Dalam survei telepon Bank Dunia di empat negara Afrika, responden 52 persen laki-laki di Uganda dan 73 persen laki-laki di Nigeria, padahal laki-laki kira-kira separuh populasi dewasa. Di Uganda, 6 persen responden telepon berusia 15 sampai 24 tahun, padahal kelompok usia itu 38 persen dari populasi dewasa.17
- Apa yang perlu dilakukan. Gabungkan moda alih-alih mempertahankan satu moda. Daftar rumah tangga langsung di lapangan jika tidak ada daftar resmi. Jalankan survei dalam bahasa yang benar-benar dibaca populasi Anda, dan lakukan pretest atas terjemahannya alih-alih menerjemahkannya balik. Lalu nyatakan celah yang tersisa dalam bagian keterbatasan, karena celah itu akan tetap ada.
Apa yang dapat dan tidak dapat diperbaiki oleh pembobotan
Pembobotan menyesuaikan data Anda agar komposisi sampel cocok dengan angka populasi yang diketahui. Pembobotan benar-benar ampuh, dan sudah biasa dilebih-lebihkan.
Alasan untuk memakainya. Pada 2016, jajak pendapat terakhir University of New Hampshire menempatkan Clinton unggul 11 poin dalam pemilihan yang dimenangkannya dengan selisih 0,4. Jajak pendapat itu tidak menyesuaikan menurut pendidikan. Komite peninjau menyimpulkan bahwa satu penyesuaian itu saja pada dasarnya akan menghilangkan seluruh kesalahan.18 Satu variabel, yang berkorelasi dengan respons sekaligus hasil, melakukan seluruh pekerjaan.
Alasan untuk tidak bergantung padanya. Ketika lebih dari 30.000 wawancara online berbasis opt-in dinilai terhadap 24 tolok ukur, rata-rata estimasi bias tanpa pembobotan adalah 8,4 poin persentase. Dari semua prosedur pembobotan yang diuji, termasuk pendekatan pencocokan yang canggih, tidak satu pun menurunkan rata-rata bias di bawah 6 poin.19 Melipatempatkan ukuran sampel hanya menghasilkan perbaikan 0,2 poin lagi.
Aturan yang mengikutinya sederhana. Pembobotan mengoreksi ketidakseimbangan pada variabel yang Anda pakai untuk membobot, sejauh variabel itu berkaitan dengan hasil yang diukur. Pembobotan tidak berbuat apa pun terhadap perbedaan responden dari bukan responden dalam hal-hal yang tidak pernah Anda ukur, dan tidak pernah mengubah sampel nonprobabilitas menjadi sampel yang mendukung klaim presisi.
Angka presisi adalah batas bawah, bukan batas atas
Margin kesalahan mengukur variabilitas sampel, dan hanya itu. Margin kesalahan mengasumsikan sampel ditarik secara acak dari populasi sasaran dan bias yang tersisa sudah dihilangkan. Kesalahan cakupan, bias nonrespons, kesalahan pengukuran, dan responden palsu semuanya berada di luarnya.
Buktinya gamblang. Dalam dua minggu terakhir 2020, 348 jajak pendapat presiden tingkat negara bagian melaporkan margin kesalahan, dan rata-rata angka yang dilaporkan adalah 3,9 poin. Diukur terhadap rata-rata itu, 55 persen di antaranya meleset dari selisih akhir lebih dari satu margin kesalahan, dan 21 persen meleset lebih dari dua kalinya.20 Ini adalah jajak pendapat modern dengan metode modern. Perlakukan margin kesalahan sebagai batas bawah ketidakpastian Anda, jangan pernah sebagai batas atasnya.
| Klaim | Angkanya | Tingkat | Sumber |
|---|---|---|---|
| Tingkat respons nyaris tidak memprediksi bias nonrespons | r = 0,33, jadi sekitar 11% variasi, dari 235 estimasi dalam 30 studi | A | Groves, 200611 |
| Survei yang sangat besar bisa sangat keliru | Melebih-lebihkan cakupan vaksin sebesar 17 poin dengan sekitar 250.000 respons per minggu | A | Bradley dan kawan-kawan, 202113 |
| Sampel opt-in kira-kira dua kali lebih tidak akurat daripada panel probabilitas | Rata-rata kesalahan 5,8 vs 2,6 poin persentase pada 28 tolok ukur | A | Mercer dan Lau, 202314 |
| Pembobotan memperbaiki sampel opt-in tetapi tidak menyelamatkannya | 8,4 poin tanpa pembobotan, tidak ada metode yang di bawah 6,0 poin | A | Mercer, Lau, dan Kennedy, 201819 |
| Margin kesalahan meremehkan kesalahan jajak pendapat yang sebenarnya | 55% dari 348 jajak pendapat negara bagian pada 2020 meleset lebih dari rata-rata margin kesalahan yang dilaporkan, yaitu 3,9 poin | A | Gugus tugas AAPOR, 202120 |
| Penjelasan kerangka sampel Literary Digest tidak lengkap | Pemilik mobil dan telepon tetap mendukung Roosevelt, 55 berbanding 45 | B | Squire, 19887 |
Tingkat A berarti statistik resmi, meta-analisis, atau temuan yang telah direplikasi. Tingkat B berarti satu studi kuat yang kesimpulannya belum diulang secara independen.
"Tingkat respons 50 persen sudah memadai, 60 baik, 70 sangat baik." Patokan kasar buku teks tanpa data pendukung. Otoritas yang berbeda di bidang yang sama menyebut 50, 60, dan 80. Bias bergantung pada korelasi antara kesediaan menjawab dan jawabannya, bukan pada tingkatnya.
"Tiga puluh sudah cukup, karena pada titik itulah teorema limit pusat mulai berlaku." Tidak ada penurunan rumus yang menghasilkan 30. Untuk hasil yang distribusinya simetris, pendekatan itu bekerja jauh di bawahnya, dan untuk hasil yang distribusinya menceng atau peristiwa langka, pendekatan itu gagal jauh di atasnya.
"Rata-rata tingkat respons survei adalah 33 persen." Angka ini beredar di berbagai blog vendor dengan kata-kata yang nyaris identik tanpa sumber primer. Moda, sponsor, populasi, dan insentif jauh mengalahkan rata-rata global mana pun.
"Rentang perhatian kini delapan detik, lebih pendek daripada ikan mas." Ditelusuri kembali ke laporan pemasaran tahun 2015 yang mengutip sebuah perusahaan yang tidak dapat menunjukkan sumbernya. Penelitian yang mendasarinya tidak pernah menyebut delapan detik atau ikan mas.
Design effect: mengapa sampel klaster memerlukan lebih banyak orang
Hampir setiap panduan merekomendasikan cluster sampling karena penghematan biayanya dan berhenti di situ. Penghematannya nyata, begitu pula tagihannya. Orang-orang di sekolah, klinik, bangsal, atau toko yang sama mirip satu sama lain. Mereka lebih mirip satu sama lain daripada dengan orang yang dipilih secara acak dari seluruh populasi. Jadi setiap respons tambahan dari kelompok yang sudah Anda pilih membawa lebih sedikit informasi baru.
Design effect adalah angka yang mengukur hal ini. Dengan kata lain: seberapa jauh ketidakpastian Anda melebar dibandingkan dengan menarik jumlah orang yang sama secara independen. Untuk desain dengan kelompok berukuran sama, rumusnya adalah
design effect = 1 + (rata-rata ukuran kelompok - 1) x korelasi intrakelas
Korelasi intrakelas adalah seberapa mirip orang-orang di dalam satu kelompok dalam hal yang sedang Anda ukur. Nol berarti berada di sekolah yang sama tidak memberi tahu apa pun tentang jawaban seorang murid. Satu berarti semua orang di satu sekolah menjawab persis sama, dan sekolah itu seolah-olah hanya satu orang. Nilai sebenarnya kecil, tetapi nilai kecil menimbulkan banyak kerusakan begitu ukuran kelompok menjadi besar. Jika digabungkan dari 48 survei rumah tangga nasional, rata-rata korelasi intrakelas sekitar 0,06. Nilainya bervariasi menurut apa yang Anda ukur. Butir fertilitas sekitar 0,01 hingga 0,03, penggunaan kontrasepsi saat ini 0,03 hingga 0,05, dan persalinan dengan bantuan tenaga medis bahkan setinggi 0,22 pada angka nasional.21
Jika Anda tidak punya estimasi sendiri, pinjam nilai bawaan dengan hati-hati. Manual pengambilan sampel DHS memakai 1,5 untuk deft sebagai nilai cadangan ketika sebuah survei tidak punya angka sendiri.22 Deft bukan besaran yang sama dengan design effect dalam rumus di atas: deft adalah rasio dua galat baku, sedangkan design effect adalah rasio dua varians. Anda mengkuadratkannya, sehingga deft 1,5 setara dengan design effect 2,25. Manual itu menyebut nilai tersebut sebagai cadangan, bukan nilai yang tipikal, dan contoh perhitungannya sendiri memakai 1,40 untuk penggunaan kontrasepsi modern dan 1,22 untuk vaksinasi anak.
| Desain | Design effect | Respons efektif | Artinya dalam praktik |
|---|---|---|---|
| Seleksi independen, tanpa pengklasteran | 1.00 | 960 | Setiap respons bernilai satu respons penuh. |
| 24 kelompok berisi 40, ICC 0,02 | 1.78 | 539 | Anda membayar untuk 960 dan dapat mempertanggungjawabkan presisi setara 539. |
| 24 kelompok berisi 40, ICC 0,05 | 2.95 | 325 | Dua pertiga kerja lapangan tidak menambah presisi sedikit pun. |
| 24 kelompok berisi 40, ICC 0,10 | 4.90 | 196 | Desain ini diam-diam telah menjadi studi kecil yang memakai anggaran studi besar. |
Pembobotan menambahkan komponennya sendiri. Survei nasional yang melakukan oversampling di satu wilayah lalu membobotnya kembali membawa dua design effect sekaligus. Efek pembobotan 1,22 dan efek pengklasteran 1,80 menghasilkan design effect keseluruhan 2,20. Jadi 5.000 rumah tangga yang diwawancarai berperilaku seperti 2.277 rumah tangga independen.23
Pelajaran desainnya. Lebih banyak kelompok dengan lebih sedikit orang di masing-masing mengalahkan lebih sedikit kelompok dengan lebih banyak orang di masing-masing, hampir setiap kali. Empat puluh sekolah berisi 24 murid dan 24 sekolah berisi 40 murid sama-sama menghasilkan kira-kira 960 respons, tetapi yang pertama memiliki design effect lebih kecil dan hasil yang dapat dipertanggungjawabkan. Jika Anda sedang merencanakan berapa banyak respons yang diperlukan secara total, hitunglah di panduan ukuran sampel kami lalu kalikan dengan design effect. Melakukannya dengan urutan terbalik adalah penyebab studi klaster berakhir dengan kekuatan statistik yang kurang.
Tiga contoh penerapan, dari awal sampai akhir
Nama metode itu mudah. Keputusan di sekitarnyalah tempat studi benar-benar keliru. Ketiga contoh ini membawa satu desain nyata dari pernyataan populasi sampai kalimat yang dapat Anda publikasikan.
Contoh 1: pengalaman pasien di satu kabupaten
- Populasi. Orang dewasa yang menjalani konsultasi rawat jalan di salah satu dari 46 klinik pemerintah di kabupaten itu antara 1 April dan 30 Juni.
- Kerangka sampel. Tidak ada daftar pasien untuk seluruh kabupaten. Yang ada adalah daftar 46 klinik, beserta jumlah kunjungan bulanannya.
- Metode. Multistage. Pilih 18 klinik dengan peluang sebanding dengan jumlah kunjungan, lalu ambil sampel secara sistematis setiap pasien ke-8 yang keluar selama dua hari klinik yang dipilih secara acak.
- Mengapa tidak yang lebih sederhana. Daftar pasien lengkap akan memungkinkan stratified sampling, tetapi daftar itu tidak ada dan tidak dapat dibuat dalam tenggat waktu. Sampel convenience di tiga klinik terbesar akan lebih cepat dan hanya akan menggambarkan tiga klinik terbesar itu.
- Apa yang wajib dilaporkan. Peluang terpilih berbeda menurut ukuran klinik, sehingga analisis memerlukan pembobotan, dan intervalnya perlu diperlebar sesuai design effect.
- Kalimat yang dapat dipublikasikan. "Di antara orang dewasa yang berkunjung ke klinik rawat jalan pemerintah di kabupaten itu selama kuartal kedua, diperkirakan 71 persen menilai waktu tunggunya dapat diterima, berdasarkan 1.240 wawancara saat keluar di 18 klinik yang dipilih dengan peluang sebanding dengan jumlah kunjungan."
Contoh 2: studi skripsi pada populasi mahasiswa
- Populasi. Mahasiswa yang terdaftar di Fakultas Perdagangan pada tahun akademik berjalan: 3.100 orang di tiga tingkat studi.
- Kerangka sampel. Daftar registrasi fakultas, yang memuat tingkat studi dan program studi.
- Metode. Stratified random sampling menurut tingkat studi, alokasi proporsional, target 350 respons lengkap.
- Aritmetikanya. Tingkat pertama berisi 1.300 mahasiswa, yaitu 42 persen dari 3.100, sehingga mendapat 42 persen dari 350, yaitu 147 respons. Ulangi untuk setiap tingkat. Karena alokasinya proporsional, tidak diperlukan pembobotan.
- Perencanaan respons. Dengan perkiraan tingkat respons 35 persen, Anda perlu mengundang sekitar 1.000 mahasiswa untuk mendapatkan 350 respons lengkap, dan sebaiknya Anda mengundang mereka stratum demi stratum agar respons yang lemah di satu tingkat terlihat selagi masih ada waktu untuk bertindak.
- Batasan yang perlu dinyatakan. Mahasiswa yang sudah mengundurkan diri tetapi masih tercantum di daftar termasuk overcoverage. Mahasiswa yang terdaftar setelah daftar itu diambil termasuk undercoverage. Keduanya harus masuk ke paragraf keterbatasan.
Contoh 3: umpan balik pelanggan untuk toko online
- Populasi. Pelanggan yang menyelesaikan pesanan dalam 90 hari terakhir.
- Kerangka sampel. Tabel pesanan. Tabel itu lengkap untuk pesanan online dan lengkap untuk checkout tamu, tetapi pelanggan dengan dua akun muncul dua kali.
- Metode. Hapus duplikat hingga satu baris per pelanggan, lalu lakukan systematic sampling setiap pelanggan ke-12 setelah titik awal acak, berjalan terus-menerus, bukan sebagai satu kelompok sekaligus.
- Jebakan yang dihindari. Hanya mengundang pelanggan buletin memang lebih cepat, tetapi itu adalah sampel convenience dari pelanggan Anda yang paling terlibat. Hasilnya akan membuat kepuasan tampak lebih baik daripada kenyataannya, secara konsisten, setiap kuartal.
- Catatan tentang karyawan. Organisasi yang sama yang menyurvei 180 stafnya sendiri sama sekali tidak perlu mengambil sampel. Populasi itu kecil, mudah dijangkau, dan setiap orang berhak untuk ditanya. Lakukan sensus, dan jika partisipasinya rendah, perlakukan hal itu sebagai temuan, bukan sebagai masalah pengambilan sampel.
Cara menulis bagian pengambilan sampel dalam metodologi Anda
Inilah langkah yang dilewatkan sebagian besar panduan, padahal inilah yang benar-benar dibaca oleh pembimbing, penelaah, atau klien. Uraian pengambilan sampel harus menjawab lima pertanyaan secara berurutan: siapa, dari daftar apa, dipilih dengan cara apa, berapa banyak, dan karena itu klaim apa yang boleh Anda buat.
Isi bagian yang kosong di bawah ini. Templat ini sengaja dibuat sederhana: penguji tidak mencari prosa yang indah di sini, mereka mencari desain yang dapat mereka nilai.
Studi yang sama, ditulis dengan lemah dan ditulis dengan baik
Lemah. "Sampel acak mahasiswa diambil dan 350 respons dikumpulkan."
Tidak ada yang dapat diperiksa di sini. Kata "acak" melakukan pekerjaan yang tidak layak disandangnya, tidak ada kerangka sampel, tidak ada penyebut, dan tidak ada pernyataan tentang siapa yang dikecualikan.
Kuat. "Populasi sasaran adalah 3.100 mahasiswa yang terdaftar di Fakultas Perdagangan pada 2026. Kerangka sampel adalah daftar registrasi fakultas yang diambil pada 3 Maret 2026. Stratified random sampling menurut tingkat studi dengan alokasi proporsional digunakan agar setiap tingkat dapat dilaporkan secara terpisah. Seribu mahasiswa diundang dan 350 mengisi kuesioner hingga selesai, dengan tingkat respons 35 persen. Tidak diterapkan pembobotan karena alokasinya proporsional. Mahasiswa yang mengundurkan diri setelah tanggal pengambilan data tetap tercantum dalam kerangka sampel dan tidak dapat diidentifikasi, yang merupakan sumber kecil overcoverage."
Versi kedua lebih panjang, dan setiap kalimat tambahan adalah kalimat yang tidak perlu lagi ditanyakan oleh penelaah.
"Partisipan direkrut melalui notifikasi di dalam aplikasi yang ditampilkan kepada pengguna aktif selama dua minggu. Ini adalah sampel convenience, sehingga temuan ini menggambarkan orang-orang yang menjawab dan tidak dapat digeneralisasi ke seluruh basis pengguna, dan tidak ada angka presisi yang dilaporkan. Dibandingkan basis pengguna, responden lebih cenderung merupakan pengguna harian, dan hal ini perlu dipertimbangkan saat membaca hasilnya." Tulis itu, dan tidak ada yang dapat menuduh Anda membuat klaim berlebihan. Anda memang tidak melakukannya.
Daftar periksa rencana pengambilan sampel
Rencana pengambilan sampel yang tertulis mencegah sebagian besar kesalahan yang dapat dihindari, karena rencana itu memaksa keputusan diambil sebelum kerja lapangan, bukan saat analisis. Delapan poin, satu halaman.
- 1. Tujuan penelitian. Keputusan apa yang didukung, dan apa tepatnya yang akan dilaporkan?
- 2. Populasi sasaran. Siapa yang termasuk dan siapa yang tidak termasuk, termasuk rentang waktunya.
- 3. Kerangka sampel. Sumber, tanggal pengambilan, jumlah baris, celah yang diketahui, dan aturan penghapusan duplikat.
- 4. Metode dan alasan. Yang mana dari sembilan metode, dan mengapa metode ini dengan mempertimbangkan kerangka sampel dan klaimnya.
- 5. Target. Respons lengkap secara keseluruhan dan per subkelompok, ditambah perkiraan tingkat respons yang menjadi dasar perencanaan Anda.
- 6. Rencana perekrutan. Moda, jadwal pengingat, penyediaan bahasa dan aksesibilitas, kebijakan insentif.
- 7. Pemantauan. Apa yang akan Anda pantau selama kerja lapangan: respons per stratum, titik responden berhenti mengisi, butir yang tidak dijawab.
- 8. Catatan analisis. Rencana pembobotan, penyesuaian design effect, dan keterbatasan yang akan Anda ungkapkan apa pun yang terjadi.
Setelah rencananya pasti, instrumenlah yang menentukan apakah sampel itu layak ditarik. Sampel yang sempurna tidak dapat menyelamatkan pertanyaan yang menggiring atau bermakna ganda, jadi ada baiknya Anda membaca contoh pertanyaan survei sebelum menjalankan survei apa pun.
Pertanyaan yang sering diajukan
Apa itu pengambilan sampel dalam penelitian?
Pengambilan sampel adalah proses memilih sebagian dari suatu populasi, yang disebut sampel, lalu mempelajari bagian itu untuk menarik kesimpulan tentang seluruh populasi. Cara ini digunakan karena mengukur setiap anggota populasi biasanya terlalu lama, terlalu mahal, atau mustahil. Metode yang digunakan untuk memilih sampel menentukan kesimpulan apa yang dapat didukung oleh hasilnya.
Apa perbedaan antara populasi dan sampel?
Populasi adalah seluruh kelompok yang ingin Anda gambarkan. Sampel adalah bagian lebih kecil yang benar-benar Anda ukur. Pengambilan sampel adalah proses yang membawa Anda dari yang satu ke yang lain, dan sensus adalah alternatifnya, yaitu Anda mengukur seluruh populasi.
Apa itu kerangka sampel?
Kerangka sampel adalah daftar atau mekanisme nyata tempat Anda menarik sampel: daftar mahasiswa, daftar pasien, basis data pelanggan, daftar rumah tangga, daftar pemilih. Kerangka sampel lebih penting daripada nama metodenya, karena siapa pun yang tidak ada dalam kerangka sampel memiliki peluang terpilih nol, sebaik apa pun teknik pengambilan sampel Anda.
Metode pengambilan sampel mana yang tidak memerlukan kerangka sampel?
Convenience sampling, quota sampling, purposive sampling, dan snowball sampling sama sekali tidak memerlukan daftar. Cluster sampling dan multistage sampling hanya memerlukan daftar kelompok seperti sekolah, klinik, atau desa, bukan daftar individu. Simple random sampling, systematic sampling, dan stratified sampling semuanya memerlukan daftar lengkap individu sebelum Anda dapat memulai.
Apa perbedaan antara pengambilan sampel probabilitas dan nonprobabilitas?
Dalam pengambilan sampel probabilitas, mekanisme acak yang melakukan pemilihan, sehingga setiap unit memiliki peluang terpilih yang diketahui dan tidak nol, dan Anda dapat menghitung seberapa tidak pasti estimasi Anda. Dalam pengambilan sampel nonprobabilitas, peluang itu tidak diketahui karena pemilihan bergantung pada kemudahan, kuota, atau pertimbangan peneliti. Akibat praktisnya, hanya desain probabilitas yang mendukung angka presisi yang dinyatakan untuk estimasi populasi.
Apa perbedaan antara stratified sampling dan cluster sampling?
Stratified sampling membagi populasi ke dalam kelompok dan mengambil sampel acak dari setiap kelompok, yang meningkatkan presisi dan menjamin setiap kelompok muncul. Cluster sampling memilih sebagian kelompok secara acak lalu menyurvei semua orang di dalam kelompok yang terpilih, yang menghemat biaya ketika tidak ada daftar individu. Ringkasnya: stratified memakai semua kelompok dan sebagian orang, cluster memakai sebagian kelompok dan semua orang.
Apa itu unit sampel primer?
Unit sampel primer adalah apa pun yang dipilih pada tahap pertama desain multistage. Dalam survei rumah tangga nasional, unit ini biasanya berupa wilayah seperti kelurahan, desa, atau blok sensus. Rumah tangga kemudian dipilih di dalamnya pada tahap kedua. Menyebutkan unit sampel primer adalah syarat standar saat melaporkan desain klaster, karena pengklasteran yang ditimbulkannya harus tercermin dalam analisis.
Apa itu stratified random sampling?
Stratified random sampling membagi populasi ke dalam kelompok yang tidak saling tumpang tindih yang disebut strata, lalu menarik sampel acak secara independen di dalam setiap stratum. Alokasi proporsional memberi setiap stratum bagian sampel yang sesuai dengan bagiannya dalam populasi dan tidak memerlukan pembobotan. Alokasi tidak proporsional dengan sengaja melakukan oversampling pada strata yang kecil tetapi penting, dan kemudian memerlukan pembobotan sebelum angka keseluruhan apa pun dilaporkan.
Apakah snowball sampling sah untuk penelitian akademik?
Ya, ketika populasinya tersembunyi, langka, atau tidak terdaftar dan tidak ada kerangka sampel yang dapat dibuat. Ini adalah pendekatan yang diakui untuk kelompok yang sulit dijangkau. Yang tidak dapat dilakukannya adalah mendukung estimasi populasi, dan kelemahan utamanya adalah partisipan merujuk orang yang mirip dengan diri mereka, sehingga sampel bergeser ke satu jaringan sosial. Memulai dari beberapa titik awal yang tidak saling terhubung mengurangi pergeseran itu dan sebaiknya dijelaskan dalam metodologi Anda.
Apakah pengambilan sampel acak sama dengan penugasan acak?
Tidak. Pengambilan sampel acak adalah cara Anda memilih partisipan dari suatu populasi, dan menentukan kepada siapa temuan Anda dapat digeneralisasi. Penugasan acak adalah cara Anda membagi partisipan yang terpilih ke dalam kondisi-kondisi dalam sebuah eksperimen, dan menentukan apakah efek yang teramati dapat dikaitkan dengan perlakuan. Sebuah studi dapat memakai salah satunya tanpa yang lain, dan sebagian besar eksperimen memakai penugasan acak tanpa pengambilan sampel acak.
Bolehkah saya memakai metode pengambilan sampel nonprobabilitas dalam studi kuantitatif?
Boleh, dan banyak penelitian kuantitatif yang dipublikasikan melakukannya. Yang berubah adalah apa yang boleh Anda klaim. Anda dapat melaporkan jumlah, persentase, dan hubungan di dalam sampel Anda, dan Anda dapat membandingkan kelompok di dalamnya. Anda tidak dapat menyajikan persentase itu sebagai estimasi populasi dengan presisi yang dinyatakan. Sebutkan metodenya, jelaskan proses perekrutannya, bandingkan responden Anda dengan tolok ukur yang diketahui jika ada, dan tuliskan keterbatasannya secara eksplisit alih-alih berharap tidak ada yang bertanya.
Apa perbedaan antara pengambilan sampel dan distribusi sampling?
Pengambilan sampel adalah prosedur untuk memilih sampel. Distribusi sampling adalah gagasan yang berbeda. Bayangkan Anda mengulangi prosedur pengambilan sampel yang sama berkali-kali. Sebaran statistik yang dihasilkan, misalnya rata-rata atau persentase, di seluruh sampel yang dibayangkan itu adalah distribusi sampling. Distribusi sampling itulah yang memungkinkan adanya interval kepercayaan, dan distribusi itu hanya berperilaku dapat diprediksi bila sampel ditarik dengan metode probabilitas.
Bagaimana saya tahu apakah sampel saya bias?
Bandingkan sampel yang Anda peroleh dengan tolok ukur yang diketahui, seperti daftar karyawan, data pendaftaran, atau data administratif, pada variabel yang berkaitan dengan apa yang Anda ukur. Selisih yang besar menunjukkan masalah cakupan, masalah seleksi, atau nonrespons diferensial. Bandingkan juga antarsaluran perekrutan dan antargelombang pengingat. Perlu diingat bahwa tingkat respons yang sehat adalah bukti lemah bahwa biasnya rendah: dari 235 estimasi yang dipublikasikan, tingkat respons hanya menjelaskan sekitar 11 persen variasi bias nonrespons.
Bacaan terkait
Pengambilan sampel adalah satu keputusan di dalam studi yang lebih besar. Panduan berikut membahas keputusan sebelum dan sesudahnya.
- Desain penelitian survei menempatkan pengambilan sampel dalam urutan bersama bagian studi lainnya, mulai dari mendefinisikan populasi hingga peluncuran.
- Cara menentukan ukuran sampel membahas aritmetika presisi yang sengaja diserahkan oleh halaman ini, termasuk rumus-rumusnya.
- Cara menulis pertanyaan survei membahas sisi pengukuran, yang tidak dapat diselamatkan oleh desain pengambilan sampel apa pun.
- Prinsip desain kuesioner membahas cara menyusun seluruh instrumen setelah pertanyaan-pertanyaannya ada.
- Bias respons membahas lebih dalam perbedaan antara orang yang Anda pilih dan orang yang menjawab.
- Pertanyaan demografis dalam survei berguna ketika kerangka sampel Anda tidak memuat variabel yang Anda perlukan untuk stratifikasi.
- Signifikansi statistik membahas apa yang perlu dilakukan dengan angka-angka setelah sampel terkumpul.
- Analisis data kuantitatif membahas langkah-langkah analisis berikutnya, termasuk di mana pembobotan diterapkan.
Cara panduan ini ditulis, dan apa yang tidak dibahasnya
Siapa penulisnya. Michael Hodge, yang menangani metodologi survei, desain pertanyaan, dan kualitas data di SuperSurvey, serta menulis panduan praktis di bagian Panduan dan bantuan kami.
Dasar penulisannya. Definisi mengikuti tinjauan metodologis dan pedoman penelitian universitas yang dikutip di bawah ini, tempat istilah-istilah teknis itu benar-benar didefinisikan. Halaman resmi tentang integritas penelitian dan kantor statistik dicantumkan sebagai titik awal singkat dengan bahasa sederhana, bukan sebagai sumber definisi tersebut. Uraian metode mengikuti tinjauan dan pedoman yang sama. Setiap angka di bagian bukti berasal dari sumber primer yang disebutkan di bawah ini. Setiap klaim juga diberi tingkat keyakinan, sehingga Anda dapat melihat temuan mana yang sudah mapan dan mana yang bertumpu pada satu studi. Angka design effect di grafik dan tabel adalah perhitungan kami sendiri. Kami memakai rumus standar, dengan asumsi yang dicantumkan di keterangan gambar, sehingga Anda dapat menghitungnya ulang atau membantahnya dengan ukuran klaster Anda sendiri.
Apa yang tidak dibahasnya. Panduan ini membahas pengambilan sampel untuk survei dan studi observasional. Panduan ini tidak membahas desain eksperimen atau penugasan acak selain membedakan keduanya. Panduan ini juga tidak membahas pengambilan sampel untuk uji penerimaan, audit, dan pemrosesan sinyal, yang memakai kata yang sama untuk hal yang berbeda. Respondent-driven sampling, time-location sampling, dan adaptive cluster sampling adalah metode nyata yang dipakai para spesialis untuk populasi tersembunyi, dan berada di luar cakupan halaman ini. Angka korelasi intrakelas berasal dari survei rumah tangga di negara berpendapatan rendah dan menengah. Perlakukan angka itu sebagai ilustrasi, bukan sebagai nilai untuk dipindahkan ke konteks yang berbeda.
Di mana angkanya paling lemah. Analisis ulang Literary Digest bertumpu pada satu survei tahun 1937 dan satu analisis ulang di kemudian hari, dan kedua penulisnya menandai ketidakpastian mereka sendiri; karena itu klaim ini diberi tingkat B. Angka kesalahan jajak pendapat berasal dari jajak pendapat pemilu Amerika Serikat, yang diteliti dengan sangat baik dan belum tentu mewakili kesalahan survei secara umum.
Pengungkapan. SuperSurvey menjual perangkat lunak survei. Tidak ada yang dijual di halaman ini, tidak ada keharusan mendaftar untuk bagian mana pun, dan tidak ada organisasi yang mensponsori atau meninjau panduan ini. Ketika kami menautkan ke halaman kami sendiri, itu karena halaman tersebut membahas keputusan berikutnya, bukan karena tautan itu memberi kami keuntungan.
Referensi
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., dan Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- Pemerintah Inggris (UK Government) (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., dan Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., dan Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences dan ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., dan Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., dan Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., dan Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., dan Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, halaman 9 dan 15. Angka berasal dari edisi 2025; GSMA sejak itu telah menerbitkan edisi 2026 dengan kesenjangan yang lebih sempit.
- Brubaker, J., Kilic, T., dan Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., dkk. (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., dan Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., dan Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, halaman 9 dan Tabel 1.2.
- Kalton, G., Brick, J. M., dan Le, T. (2005). Estimating components of design effects for use in sample design. Dalam Household Sample Surveys in Developing and Transition Countries, Chapter VI. United Nations, Series F No. 96.