
Respuesta breve
El muestreo es el proceso de seleccionar un subconjunto de una población, llamado muestra, y estudiar ese subconjunto para sacar conclusiones sobre toda la población. Se muestrea porque medir a todo el mundo suele ser demasiado lento, demasiado caro o, sencillamente, imposible. La población es el grupo que quieres describir, la muestra es la parte que realmente mides y el marco muestral es la lista de la que extraes la muestra.
El muestreo probabilístico selecciona a las personas mediante un mecanismo aleatorio, de modo que cada unidad tiene una probabilidad conocida y distinta de cero de ser elegida. Eso es lo que te permite ponerle un número a tu incertidumbre.
El muestreo no probabilístico selecciona por conveniencia, por cuotas o por criterio. Suele ser más rápido, más barato y a veces la única opción ética, pero no puede respaldar una estimación poblacional con una precisión declarada.
Ve directamente a los 9 métodos comparados | cómo elegir uno | ponte a prueba | cómo redactarlo
Ideas clave
- Muestrear significa estudiar un subconjunto: mides una muestra para conocer una población cuando no es viable medir a todo el mundo.
- Domina primero cinco términos: población, marco muestral, unidad de muestreo, diseño muestral y la brecha entre la población que quieres y la que realmente puedes alcanzar. La mayoría de las discusiones sobre muestreo son, en realidad, discusiones sobre uno de ellos.
- Solo los métodos probabilísticos te permiten ponerle un número a tu incertidumbre. Las muestras por conveniencia, por cuotas, intencionales y de bola de nieve pueden ser útiles y honestas, pero no pueden respaldar una estimación poblacional con una precisión declarada.
- Tu marco fija tu techo: si un grupo no puede aparecer en la lista de la que extraes la muestra, ningún método ni ningún volumen de envíos adicionales lo llevará a tus resultados.
- La representatividad es una cadena, no una etiqueta: marco, luego selección, luego reclutamiento, luego respuesta y luego análisis. Un sorteo aleatorio es un eslabón de cinco.
Definición de muestreo (y los 5 términos que debes dominar)
El muestreo es el proceso de seleccionar un grupo más pequeño (una muestra) de un grupo más grande (una población) para poder conocer la población sin medir a todo el mundo. Un estudio de toda la población suele ser poco práctico, así que se muestrea para que el trabajo sea viable y aun así produzca conclusiones útiles.
Los cinco términos siguientes hacen la mayor parte del trabajo en cualquier capítulo de metodología. Si los defines mal, cada decisión posterior hereda el error.
- Población: el grupo completo que quieres describir, delimitado y con un periodo de tiempo. «Todos los estudiantes de último curso de enfermería de los tres campus, matriculados a 1 de marzo» es una población. «Enfermeros» no lo es.
- Población objetivo frente a población accesible: a quién quieres describir frente a quién pueden alcanzar realmente tu reclutamiento y tus herramientas. Nombrar la brecha entre ambas es una fortaleza en un informe de investigación, no una debilidad.
- Marco muestral: la lista o el mecanismo del que extraes la muestra. Un registro de estudiantes, un registro de pacientes, una base de datos de clientes, un listado de hogares de un pueblo, un censo electoral. Los problemas del marco generan error de cobertura, y ningún método los repara.
- Unidad de muestreo: lo que realmente se selecciona. Una persona, un hogar, una clínica, una clase, un turno, un pedido. En los diseños por conglomerados y polietápicos, la unidad de la primera etapa es un grupo, y ese grupo se llama unidad primaria de muestreo.
- Diseño muestral: el plan completo por escrito. Marco, método, cuántas unidades, cómo se contacta con ellas y qué harás con las personas que no respondan. El «diseño muestral» es lo que un tribunal o un revisor te está pidiendo en realidad cuando te pregunta por tu muestreo.
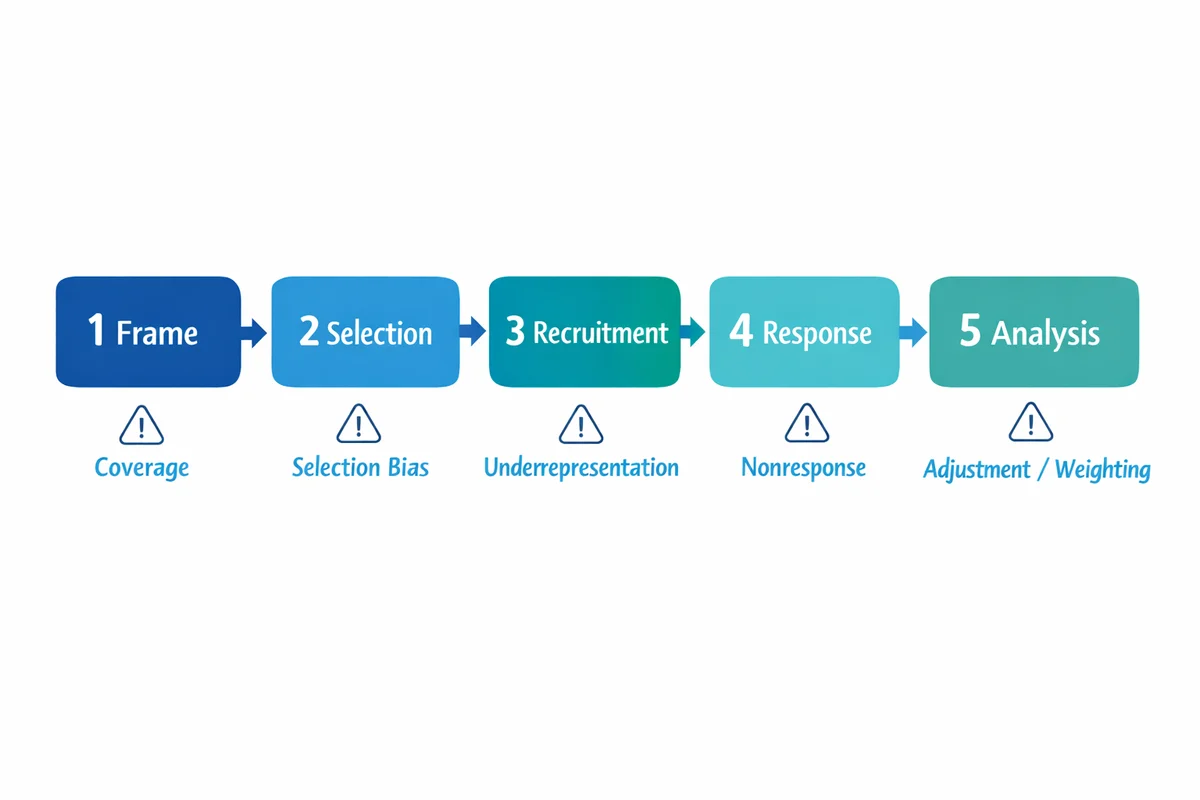
Puedes hacer una selección aleatoria de manual y aun así acabar con una muestra sesgada. Si tu marco omite un segmento, ese segmento nunca pudo ser elegido. Si un segmento no responde, se pierde después de haber sido elegido. Trata el muestreo como una cadena: marco, luego selección, luego reclutamiento, luego respuesta y luego análisis.
Para una definición oficial breve de la misma idea, consulta la nota formativa sobre muestreo de la U.S. Office of Research Integrity (Oficina de Integridad en la Investigación de EE. UU.).1 Si estás situando el muestreo dentro de un plan de estudio más amplio, nuestra guía sobre diseño de investigación por encuesta cubre los pasos anteriores y posteriores.
Por qué muestrear y cuándo un censo es la mejor respuesta
La necesidad de muestrear es práctica antes que estadística. Hay cuatro razones que aparecen una y otra vez.
Coste
Cada participante adicional cuesta dinero, tiempo del personal o buena voluntad. Una muestra de 600 bien extraída puede responder a la misma pregunta que un intento mal ejecutado con 60.000.
Rapidez
Las decisiones tienen plazos. Una muestra te da una respuesta dentro del margen de tiempo en el que esa respuesta todavía es útil.
Viabilidad
Algunas poblaciones no se pueden enumerar en absoluto: los transeúntes de un mercado, las personas que abandonaron un servicio, los vendedores informales. Otras son en la práctica infinitas, o medir una unidad la destruye.
Calidad
Esta sorprende a la gente. Concentrar el esfuerzo en un grupo más pequeño te permite insistir con quienes no responden, formar bien a los entrevistadores y revisar los datos. El esfuerzo por unidad suele valer más que el número de unidades.
Un censo, en cambio, mide a todo el mundo. Es la mejor opción cuando la población es lo bastante pequeña como para alcanzarla, cuando ya existen los datos de contacto o cuando cada miembro tiene derecho a que se le pregunte. Una encuesta a la plantilla de una organización de 200 personas es una cuestión de censo, no de muestreo. También lo es la evaluación de una clase. Cuando la población es pequeña, el muestreo apenas te aporta nada y te cuesta la posibilidad de informar por equipo.
Cómo es realmente una buena muestra
Los manuales describen una buena muestra como «representativa», lo que no es un criterio operativo. Estas cuatro propiedades sí lo son.
- Cobertura: cualquier persona de la población objetivo podría, en principio, haber sido seleccionada.
- Selección controlada: quién entra en la muestra lo decide una regla, no quién se ofrece voluntario o quién está más cerca de la puerta.
- Suficientes unidades en el grupo más pequeño sobre el que debes informar: una cifra global puede parecer sólida mientras el grupo que de verdad te importa se apoya en 11 envíos.
- Descriptible: puedes escribir exactamente cómo se extrajo, y otra persona podría repetirlo.
| Si tu objetivo es | Implicación para el muestreo | Error habitual |
|---|---|---|
| Estimar un porcentaje de la población | Usa un método probabilístico, controla quién responde e informa de la precisión junto a la cifra. | Tratar una muestra por conveniencia como si describiera a la población. |
| Comparar subgrupos | Planifica el número de envíos por subgrupo, normalmente estratificando y sobremuestreando los grupos pequeños. | Informar de un subgrupo cuyo resultado se apoya en un puñado de personas. |
| Explorar experiencias y mecanismos | La selección intencional o teórica es adecuada. Justifica qué perspectivas quedan cubiertas y cuáles no. | Perseguir un mínimo numérico sin ninguna justificación. |
| Probar una intervención | El muestreo determina a quién se puede generalizar el resultado. La asignación aleatoria determina si el efecto es real. | Confundir la asignación aleatoria con el muestreo aleatorio. Son operaciones distintas. |
Para una explicación en lenguaje sencillo de cómo las muestras respaldan las estimaciones poblacionales, la introducción de la U.S. Census Bureau (Oficina del Censo de EE. UU.) al muestreo por encuesta y la inferencia es un buen punto de partida.2
Tu marco muestral fija el techo
Un marco muestral es la lista o el mecanismo concreto del que extraes la muestra. Es la parte menos comentada del muestreo y el lugar donde la mayoría de los estudios reales se tuercen sin que nadie lo note, porque el marco decide quién podía siquiera ser seleccionado.
Los marcos son objetos corrientes. Un registro de estudiantes, un registro de pacientes, un listado de personal de RR. HH., una base de datos de clientes. Una lista de pueblos con su número de hogares, un censo electoral, una serie de pedidos, una lista de clínicas de un distrito. Fíjate en que algunos marcos enumeran personas y otros enumeran lugares. Esa distinción decide qué métodos tienes a tu alcance.
| Problema | Cómo se manifiesta | Qué le hace a tus resultados |
|---|---|---|
| Subcobertura | Faltan en la lista personas de la población: personal sin correo electrónico del trabajo, clientes que compraron en persona, hogares sin dirección registrada. | Segmentos enteros tienen una probabilidad nula de ser seleccionados. Más envíos no lo arreglan, porque las personas que faltan nunca pudieron ser elegidas. |
| Sobrecobertura | La lista contiene unidades ajenas a tu población: antiguos estudiantes, cuentas cerradas, personas que se mudaron. | Desperdicias esfuerzo y, si no las descartas, mides la población equivocada. |
| Duplicación | La misma persona aparece más de una vez: dos direcciones de correo electrónico, dos números de cuenta. | Esas personas tienen más probabilidad de ser seleccionadas que las demás, lo que rompe sin hacer ruido el supuesto de igual probabilidad. |
| Desactualización | La lista era exacta cuando se elaboró y ya no lo es. | Los contactos rebotados parecen negativas, así que tanto tu tasa de respuesta como tu diagnóstico del sesgo salen mal. |
Audita el marco antes de extraer la muestra, no después. Cuenta las filas. Compara ese recuento con cualquier total independiente que encuentres, como la plantilla según RR. HH. o una cifra de matrícula. Busca el segmento que más vergüenza te daría haber omitido y comprueba que está. Elimina duplicados. Anota lo que el marco excluye, porque esa frase va en tus limitaciones en cualquier caso.
El muestreo por conveniencia, por cuotas, intencional y de bola de nieve no necesitan ninguna lista. El muestreo por conglomerados y el polietápico solo necesitan una lista de grupos (centros escolares, clínicas, barrios, pueblos), no una lista de personas. El muestreo aleatorio simple, el sistemático y el estratificado necesitan una lista completa de individuos antes de empezar. Si no tienes una lista y no puedes elaborarla, ese único hecho descarta tres de los nueve métodos de esta página. Suele ser lo primero que hay que resolver.
Los 9 métodos de muestreo comparados
Los métodos de muestreo se dividen en dos familias. El muestreo probabilístico usa un mecanismo aleatorio, de modo que cada unidad del marco tiene una probabilidad de selección conocida y distinta de cero. El muestreo no probabilístico no lo hace, así que las probabilidades de selección son desconocidas. Todo lo demás se deriva de esa única distinción.
La segunda columna es la que la mayoría de las guías omiten, así que aquí va primero. Solo un diseño probabilístico respalda un margen de error, un intervalo de confianza o la frase «más o menos 5 puntos». Si un método dice que no ahí, aun así puedes aprender mucho de él. Simplemente no puedes publicar una cifra de precisión junto al resultado. La precisión en sí es otra conversación, que tratamos en nuestra guía sobre el tamaño de muestra.
| Método | ¿Respalda un margen de error? | Cómo funciona | Es la opción correcta cuando | Qué cuesta y qué sesgo favorece |
|---|---|---|---|---|
| Muestreo aleatorio simple Probabilístico Requiere una lista completa |
Sí | Cada unidad de la lista tiene la misma probabilidad. Extraes al azar el número necesario. | Tienes una lista limpia y sin duplicados, y ningún subgrupo sobre el que estés obligado a informar por separado. | CosteNecesitas la lista completa, y los grupos pequeños pueden quedar demasiado pequeños para informar sobre ellos.SesgoMuy poco en la selección. Todo el riesgo restante pasa a quién responde realmente. |
| Muestreo sistemático Probabilístico Requiere una lista completa |
Sí, si el orden de la lista no guarda relación con el resultado | Ordena la lista, elige un punto de partida aleatorio y toma cada k-ésimo registro. | La lista es larga o llega como un flujo, y un equipo de campo necesita una única regla sencilla. | CosteCasi nada, siempre que el orden no tenga nada que ver con lo que mides.SesgoPeriodicidad. Si la lista se repite en un ciclo que coincide con tu intervalo, das una y otra vez con el mismo tipo de unidad. |
| Muestreo estratificado Probabilístico Requiere una lista completa |
Sí, y normalmente más ajustado que el aleatorio simple | Divide la lista en los grupos (estratos) que importan y luego muestrea dentro de cada grupo. | Debes informar por región, facultad, departamento o franja de edad, o esperas que la respuesta difiera mucho entre grupos. | CosteLa variable de agrupación tiene que estar en la lista antes de extraer la muestra, y las tasas desiguales tienen que ponderarse en el análisis.SesgoBajo. El riesgo real es elegir estratos que no tienen nada que ver con el resultado, lo que añade trabajo y no aporta precisión. |
| Muestreo por conglomerados Probabilístico Requiere una lista de grupos |
Sí, ampliado por el efecto de diseño | Selecciona al azar grupos enteros (centros escolares, clínicas, barrios, pueblos) y luego encuesta a todas las personas de los grupos seleccionados. | No puedes enumerar a los individuos, pero sí los lugares donde se encuentran, y el coste de desplazamiento o de puesta en marcha domina el presupuesto. | CostePrecisión. Las personas de un mismo grupo se parecen entre sí, así que cada envío adicional aporta menos información nueva.SesgoBajo si los grupos se eligen al azar, pero un número reducido de grupos hace que el resultado sea inestable y difícil de defender. |
| Muestreo polietápico Probabilístico Requiere una lista de grupos |
Sí, con ponderaciones y un efecto de diseño | Primero muestrea grupos y luego muestrea unidades dentro de los grupos seleccionados, en dos o más etapas. | Estudios de distrito o nacionales en los que no existe una única lista de personas, pero sí unidades administrativas. | CosteComplejidad. Las probabilidades de selección varían entre unidades, así que el análisis necesita ponderaciones y alguien que sepa aplicarlas.SesgoBajo en principio. En la práctica, cada etapa es una nueva ocasión para que el equipo de campo se aparte del plan. |
| Muestreo por conveniencia No probabilístico Sin lista |
No | Tomas a quien sea más fácil de alcanzar: una ventana emergente en un sitio web, un grupo al que das clase, la gente que pasa junto a un puesto. También se llama muestreo por disponibilidad. | Estás explorando, haciendo una prueba piloto de un cuestionario o necesitas orientación esta semana, no una cifra defendible el próximo trimestre. | CosteLa afirmación. Renuncias a poder decir nada sobre la población.SesgoAutoselección. Sobrerrepresenta a quienes son fáciles de alcanzar, a quienes están disponibles y a quienes ya están implicados. |
| Muestreo por cuotas No probabilístico Sin lista |
No. Parece equilibrado sin ser aleatorio | Fija objetivos por grupo, por ejemplo 50 mujeres y 50 hombres, o 40 rurales y 60 urbanos, y luego recluta hasta cubrir cada objetivo. | Necesitas una muestra que al menos coincida con la población en características visibles, rápido y sin una lista de la que extraerla. | CosteEl control de quién llena cada cuota. Quienes reclutan siguen eligiendo, y eligen a las personas accesibles.SesgoSesgo de selección dentro de la cuota. Coincidir en edad y género no hace que las personas sean típicas en sus actitudes. |
| Muestreo intencional No probabilístico Sin lista |
No, ni lo pretende | Seleccionas deliberadamente casos que cumplen unos criterios declarados: personas expertas, casos extremos, casos típicos, casos críticos. También se llama muestreo de juicio. | Trabajo cualitativo, entrevistas a personas expertas, estudios de caso y cualquier pregunta en la que la profundidad importe más que contar. | CosteNinguno, siempre que dejes claro que nunca estabas contando.SesgoEl propio modelo del investigador sobre quién se considera relevante. |
| Muestreo de bola de nieve No probabilístico Sin lista |
No | Recluta a unos pocos participantes y luego pide a cada uno que recomiende a otras personas que cumplan los criterios. | El grupo está oculto, estigmatizado, es poco frecuente o no está registrado: trabajadores migrantes, personas que abandonaron un servicio, vendedores informales, personas con una enfermedad rara. | CosteTiempo, y el control sobre la forma de la muestra. Heredas la red social de quien te sirvió de punto de partida.SesgoHomofilia. Las personas recomiendan a gente parecida a ellas, así que un rincón de la población queda sobremuestreado. |
Cómo leer la tabla: los cinco primeros métodos son diseños probabilísticos y los cuatro últimos no. Esa única división, y no los nombres de cada método, es lo que decide si una cifra de precisión es honesta.
Métodos de muestreo probabilístico, uno a uno
El muestreo probabilístico significa que cada unidad del marco tiene una probabilidad conocida y distinta de cero de ser seleccionada, y que la selección la hace un mecanismo aleatorio. Esa es toda la base para afirmar algo numérico sobre la población. Cinco diseños cubren casi todos los estudios reales. Las revisiones de investigación clínica y sanitaria tratan la misma familia con etiquetas algo distintas, y conviene saber por qué antes de encontrarte con ambas: cada una de las dos que se citan aquí incluye el muestreo polietápico dentro del muestreo por conglomerados en lugar de listarlo por separado.34
Muestreo aleatorio simple
El muestreo aleatorio simple da a cada unidad de la lista exactamente la misma probabilidad de selección. Numeras la lista, generas números aleatorios y tomas las unidades que les corresponden.
Ejemplo resuelto. El registro de una universidad incluye 12.000 estudiantes matriculados y necesitas 400 envíos. Numera el registro del 1 al 12.000, genera 400 números aleatorios únicos en ese rango con una hoja de cálculo o un programa de estadística e invita a esos estudiantes. Si esperas una tasa de respuesta del 40 %, extrae e invita a 1000 para que 400 envíos completados sean realistas.
Dónde falla. Con 400 envíos repartidos en un registro de 12.000 estudiantes, un departamento de 300 estudiantes aporta unas 10 personas. No basta para informar sobre él. Si algún subgrupo tiene que aparecer en tus resultados, el muestreo aleatorio simple es la herramienta equivocada y el muestreo estratificado es la solución.
Anota tu aleatorización. El software utilizado, la semilla si la hubo y la fecha. Esa sola frase es lo que hace reproducible el sorteo, y los revisores sí la piden.
Muestreo sistemático
El muestreo sistemático toma cada k-ésima unidad de una lista ordenada a partir de un inicio aleatorio. Divide el tamaño de la lista entre el número que necesitas para obtener el intervalo k, elige un número aleatorio entre 1 y k como punto de partida y luego ve contando hacia delante.
Ejemplo resuelto. Un hospital comarcal registra 9000 consultas externas en un trimestre y quiere 600 entrevistas a la salida. El intervalo es 9000 entre 600, así que k es igual a 15. Elige un inicio aleatorio entre 1 y 15, por ejemplo 7, y entrevista las consultas 7, 22, 37, 52 y así sucesivamente. Un equipo de campo puede seguir esa regla sin un portátil, y esa es la verdadera razón por la que este método sigue vigente.
Dónde falla. Periodicidad. Si la lista tiene un ciclo repetitivo que coincide con k, muestreas la misma posición cada vez. Una lista de consultas ordenada por día de consulta con un ciclo de 7 días y un intervalo de 7 te daría un solo día de la semana y nada más. Revisa el orden antes de fijar k y baraja la lista si el orden guarda relación con lo que mides.
Muestreo estratificado
El muestreo estratificado divide la población en grupos que no se solapan, llamados estratos, y luego extrae una muestra aleatoria dentro de cada estrato. Es la mejora más útil a la que puede optar la mayoría de los estudios, porque garantiza que cada grupo sobre el que debes informar aparezca realmente.
Ejemplo resuelto con los cálculos. Una organización tiene 4200 empleados repartidos en seis provincias y necesita 600 envíos.
- Asignación proporcional. Una provincia con 1400 empleados tiene 1400 entre 4200, es decir, un tercio de la plantilla, así que le corresponde un tercio de 600, es decir, 200 envíos. Una provincia con 210 empleados obtiene 210 entre 4200 por 600, es decir, 30 envíos. Cada provincia está representada en proporción a su tamaño y no hace falta ponderar en el análisis.
- Asignación no proporcional, también llamada sobremuestreo. Treinta envíos son muy pocos para informar por separado sobre esa provincia pequeña. Así que tomas deliberadamente 80 de ella y reduces la provincia más grande para compensar. Ahora las probabilidades de selección difieren entre provincias, así que debes ponderar los datos para devolverlos a las proporciones reales antes de citar cualquier cifra del conjunto de la organización. Saltarse ese paso es el error más común del muestreo estratificado.
Elegir los estratos. Elige variables relacionadas con el resultado o con quién tiene probabilidad de responder, y que ya existan en tu marco. Región, centro, puesto, franja de antigüedad, curso, tipo de plan y franja de edad son los candidatos habituales. Los estratos que no tienen nada que ver con el resultado añaden gestión y no aportan precisión. Si la variable de agrupación no está en tu marco, puede que tengas que recogerla dentro del cuestionario. Nuestra guía de preguntas demográficas para encuestas explica cómo pedir esas variables sin perder participantes.
Muestreo por conglomerados
El muestreo por conglomerados selecciona al azar grupos enteros que existen de forma natural y luego encuesta a todas las personas de los grupos seleccionados. Necesitas una lista de los grupos, no una lista de las personas, y esa es su razón de ser.
Ejemplo resuelto. Un distrito tiene 180 colegios de primaria y ninguna lista central de alumnos. Seleccionas al azar 24 colegios y encuestas a todos los alumnos de 8.º curso de cada uno. Has hecho 24 visitas a colegios en lugar de 180, y nunca necesitaste un registro de alumnos para empezar.
Lo que pagas por ello. Los alumnos de un mismo colegio se parecen más entre sí que a los alumnos del resto del distrito. Así que cada alumno adicional de un colegio que ya has elegido aporta menos información nueva de la que aportaría un alumno independiente. Tu número efectivo de envíos es menor que tu número real de envíos. Esa inflación es el efecto de diseño, y hay que incorporarlo al plan en lugar de descubrirlo en el análisis.
Dónde falla. Demasiado pocos conglomerados. Seis colegios elegidos al azar pueden ser muy distintos entre sí, y el resultado oscila según qué seis te hayan tocado. Más conglomerados con menos personas en cada uno es casi siempre mejor que lo contrario.
Muestreo polietápico
El muestreo polietápico selecciona en dos o más etapas: primero grupos, luego unidades dentro de los grupos seleccionados y, a veces, una tercera etapa dentro de estas. Casi todas las encuestas nacionales de hogares del mundo se construyen así.
Ejemplo resuelto. Selecciona 120 barrios de la lista nacional de barrios. Dentro de cada barrio seleccionado, un equipo de campo enumera los hogares sobre el terreno y luego selecciona 20 al azar. Dentro de cada hogar seleccionado, se elige a un adulto al azar, en lugar de dejarlo en manos de quien abra la puerta. Son tres etapas, y la última importa: dejar que el hogar decida quién responde reintroduce exactamente el sesgo de selección que el diseño debía evitar.
Lo que pagas por ello. Distintas personas acaban con distintas probabilidades de selección, así que el análisis necesita ponderaciones y el cálculo de la varianza tiene que tener en cuenta la conglomeración en cada etapa. Es un diseño serio que necesita a alguien capaz de hacer un análisis ponderado. Si nadie en el proyecto puede hacerlo, elige un diseño más sencillo en lugar de uno polietápico sin ponderar.
Para profundizar: probabilidad proporcional al tamaño, y por qué los conglomerados grandes salen elegidos más a menudo
En el ejemplo de los colegios, cada colegio tenía la misma probabilidad de selección, tuviera 60 alumnos o 900. Eso da a un alumno de un colegio pequeño una probabilidad mucho mayor de entrar en la muestra que a un alumno de uno grande. Después, el análisis tiene que corregirlo.
La selección con probabilidad proporcional al tamaño lo corrige en la fase de diseño. La probabilidad de selección de cada conglomerado se fija en proporción al número de unidades que contiene. Así, un colegio de 900 alumnos tiene quince veces más probabilidades de salir elegido que uno de 60. Después tomas el mismo número de alumnos de cada colegio seleccionado. Las dos etapas se compensan, y cada alumno del distrito acaba con aproximadamente la misma probabilidad global de selección. Es el enfoque estándar en las encuestas nacionales, y necesita una medida del tamaño de cada conglomerado del marco antes de extraer la muestra.
Muestreo estratificado frente a por conglomerados: la diferencia en una línea
Estos dos se confunden constantemente, porque ambos empiezan dividiendo la población en grupos. La diferencia está en lo que haces después.
| Aspecto | Muestreo estratificado | Muestreo por conglomerados |
|---|---|---|
| Qué grupos usas | Se muestrea de todos los grupos. | Se seleccionan algunos grupos; el resto no se usa en absoluto. |
| A quién muestreas dentro de un grupo | Un subconjunto aleatorio del grupo. | A todo el grupo, o a otro subconjunto aleatorio en una versión polietápica. |
| Los grupos deben ser | Homogéneos por dentro y distintos entre sí. Región, puesto, curso. | Variados por dentro, cada uno una pequeña copia de la población. Colegios, clínicas, barrios. |
| Por qué lo elegirías | Precisión y representación garantizada de los subgrupos. | Coste y accesibilidad cuando no existe una lista de individuos. |
| Efecto sobre la precisión | Normalmente la mejora frente al aleatorio simple con el mismo número de envíos. | La reduce. Ten en cuenta el efecto de diseño al planificar. |
| Qué necesitas antes de empezar | Una lista completa de individuos, con la variable de agrupación ya incluida. | Solo una lista de grupos. |
Estratificado: todos los grupos, algunas de las personas. Conglomerados: algunos de los grupos, todas las personas. El estratificado busca exactitud; el de conglomerados, acceso.
Métodos de muestreo no probabilístico, uno a uno
El muestreo no probabilístico significa que las probabilidades de selección son desconocidas, porque ningún mecanismo aleatorio decidió a quién se eligió. Es la opción correcta en cuatro situaciones. No puedes construir un marco utilizable. El grupo está oculto. La rapidez importa más que la precisión. O la pregunta trata del significado y no de la magnitud.
Estos métodos no son de segunda categoría. Responden a una pregunta distinta. El fallo nunca es usarlos, sino usarlos y luego escribir una frase que solo una muestra probabilística podría respaldar.
Muestreo por conveniencia
El muestreo por conveniencia, también llamado muestreo por disponibilidad, recluta a quien sea más fácil de alcanzar. Una ventana emergente en un sitio web, un enlace en un boletín, los estudiantes de tu propia clase, la gente que pasa junto a un puesto de un mercado.
Ejemplo. Una tienda pone un enlace para opinar en el tique de compra. Todas las personas que responden han comprado algo, llevaban un móvil, tenían tiempo y tenían un motivo para molestarse. Cada uno de esos filtros elimina una parte distinta de la clientela.
Uso honesto. Hacer una prueba piloto de un cuestionario, generar hipótesis, averiguar qué lenguaje usan los clientes, comprobar que una pregunta se entiende. Todos son usos excelentes. Ninguno requiere una estimación poblacional.
Muestreo por cuotas
El muestreo por cuotas fija objetivos de reclutamiento para grupos concretos y los cubre. Cuarenta rurales y sesenta urbanos. Cincuenta mujeres y cincuenta hombres. Veinte en cada una de cinco franjas de edad.
Ejemplo. Un equipo de estudios de mercado necesita 500 envíos que reproduzcan la distribución nacional por edad, género y región, y no tiene una lista de la población. Recluta hasta llenar cada celda.
Por qué sigue sin ser un muestreo probabilístico. Las cuotas controlan la forma de la muestra, no la selección de las personas que la componen. Quien recluta sigue eligiendo, y las personas fáciles de abordar son sistemáticamente distintas de las que no lo son. Una muestra puede coincidir perfectamente con la población en edad y género y aun así equivocarse gravemente sobre las actitudes, porque la edad y el género nunca fueron las variables que causaban el daño.
Muestreo intencional
El muestreo intencional, también llamado muestreo de juicio, selecciona deliberadamente casos que cumplen unos criterios declarados. Las variantes habituales son la selección de casos típicos, de casos extremos, de casos críticos, de máxima variación y de personas expertas.
Ejemplo. Un estudio sobre cómo se usa un nuevo sistema de pago selecciona a ocho personas. Dos que lo usan a diario, dos que lo abandonaron, dos que nunca lo adoptaron y dos miembros del equipo de soporte que gestionan las quejas. Esa variedad se elige a propósito, y el razonamiento es el método.
Uso honesto. La mayor parte de la investigación cualitativa. Aquí el criterio no es la aleatoriedad. Es si puedes explicar por qué estos casos y no otros, y si el abanico de opiniones es lo bastante amplio para respaldar tus afirmaciones.
Muestreo de bola de nieve
El muestreo de bola de nieve recluta a un pequeño número de participantes que luego recomiendan a otras personas que cumplen los criterios, y estas recomiendan a más.
Ejemplo. Un estudio sobre comerciantes transfronterizos informales empieza con cuatro participantes identificados a través de una asociación local, y cada uno presenta a dos más. No existe un registro de comerciantes informales, así que no se puede usar ningún método basado en un marco.
Qué le hace a tu muestra. Homofilia. Las personas recomiendan a gente parecida a ellas. La muestra se desplaza hacia una red social y se aleja de los miembros aislados de la población, que suelen ser precisamente quienes más necesita escuchar la investigación. Empezar desde varias semillas sin conexión entre sí en lugar de una reduce la deriva, pero no la elimina.
Cómo hacer defendible una muestra no probabilística
La mayoría de las guías se quedan en «no puedes generalizar» y dejan al lector desamparado, porque la mayoría de los lectores están haciendo justo este tipo de estudio. Esta es la parte que suele faltar.
- Describe el reclutamiento, no solo el nombre del método. Dónde se publicó el enlace, en qué fechas, quién lo vio, si se ofreció un incentivo y a cuántas personas se contactó frente a cuántas respondieron. Esto es lo que permite al lector juzgar la muestra en lugar de adivinar.
- Compara la muestra obtenida con una referencia conocida y publica la comparación. Si tu organización tiene un 60 % de personal de campo y tus participantes son un 25 % de personal de campo, dilo en una tabla. Un sesgo declarado es un hallazgo. Uno oculto es un defecto.
- Ten claro lo que la ponderación puede y no puede hacer. Ajustar los datos para que la demografía coincida con la población puede corregir un desequilibrio visible. No puede corregir que haya personas que difieran de los participantes en algo que no mediste, y nunca convierte una muestra no probabilística en una que respalde una afirmación de precisión.
- Cambia la frase, no la estadística. En lugar de «el 38 % de los clientes está insatisfecho, con un margen de más o menos 4 puntos», escribe «el 38 % de los 620 clientes que respondieron declaró estar insatisfecho. Los participantes se reclutaron mediante un aviso dentro de la aplicación durante dos semanas y no son una muestra aleatoria de los clientes». La segunda frase es más corta, más útil y no se puede rebatir.
El trabajo cualitativo tiene su propio vocabulario para esto. Un protocolo suele pedir una justificación en lugar de un objetivo numérico. Debe cubrir el número previsto y el abanico de opiniones, una distinción que la guía de la University of Bath expone de forma concisa.5
Relaciona el método con la situación
Seis situaciones, seis métodos. Decide antes de abrir la respuesta. Es la forma más rápida de comprobar si la tabla anterior ha calado de verdad.
1. Tienes un registro completo de 4200 empleados y debes publicar resultados para cada una de seis provincias.
Muestreo estratificado. La lista completa existe, así que el muestreo probabilístico está a tu alcance, y la obligación de informar por provincia es exactamente para lo que sirve la estratificación. Con un muestreo aleatorio simple, la provincia más pequeña se quedaría con muy pocos envíos para informar.
2. Estudias a personas que abandonaron un servicio hace seis meses. No hay ninguna lista, y quienes se fueron más enfadados son los más difíciles de encontrar.
Muestreo de bola de nieve. No existe ningún marco y la población es difícil de alcanzar, lo que descarta todos los métodos probabilísticos. Empieza desde varias semillas sin conexión entre sí en lugar de una, e indica en tus limitaciones que las cadenas de recomendación sesgan la muestra hacia las personas bien conectadas.
3. Un hospital quiere datos sobre la experiencia de los pacientes a partir de un flujo de 9000 consultas por trimestre, recogidos por personal sin ordenador en el mostrador.
Muestreo sistemático. La población llega como un flujo ordenado, así que una regla de intervalo es a la vez un método probabilístico y algo que un mostrador con mucho trabajo puede aplicar de verdad. Comprueba primero que el orden de las consultas no siga un ciclo semanal que coincida con tu intervalo.
4. Necesitas entender por qué se está abandonando una nueva herramienta, y tienes tres semanas y ningún presupuesto.
Muestreo intencional. La pregunta trata del mecanismo, no de la magnitud. Selecciona deliberadamente a lo largo de todo el abanico: usuarios intensivos, personas que la abandonaron, personas que nunca la adoptaron, personal de soporte. No informes de porcentajes a partir de él.
5. Un distrito tiene 180 colegios, ningún registro de alumnos y un presupuesto de desplazamiento que cubre unas 25 visitas.
Muestreo por conglomerados. Existe una lista de colegios aunque no exista una lista de alumnos, y el coste de desplazamiento es la restricción determinante. Amplía el intervalo que publicas para tener en cuenta el efecto de diseño, y prefiere más colegios con menos alumnos en cada uno antes que lo contrario.
6. Debes obtener 500 envíos en cinco días que reproduzcan el perfil nacional por edad y región, y no hay una lista de la población.
Muestreo por cuotas. Es la forma más rápida de obtener una muestra que al menos coincida con la población en características visibles. Sigue sin ser una muestra probabilística, así que informa de la composición y prescinde de la afirmación de precisión.
Cómo elegir un método de muestreo
La mayoría de los estudios no fracasan porque alguien eligiera la técnica equivocada. Fracasan porque la técnica no encajaba con el marco, con la decisión o con lo que el equipo de campo podía hacer de forma realista. Tres preguntas lo resuelven casi siempre.
¿Qué método encaja con tu estudio?
Responde a tres preguntas. La recomendación aparece debajo y las filas correspondientes se resaltan en la tabla comparativa.
Empieza por la afirmación que necesitas hacer
Escribe la frase que quieres publicar antes de elegir nada. «El sesenta y dos por ciento de nuestros clientes nos recomendaría» y «los clientes que se van describen tres problemas recurrentes» son frases distintas que necesitan diseños distintos. Si nadie va a tratar el resultado como una cifra poblacional, tienes mucha más libertad de la que crees.
Audita el marco antes de comprometerte
¿Puedes enumerar realmente la población, o una aproximación cercana? Si no, ¿puedes enumerar los grupos a los que pertenece? Responder a esta sola pregunta elimina de inmediato la mayoría de los nueve métodos, por eso va en segundo lugar y no al final.
Nombra los subgrupos sobre los que estás obligado a informar
Si un resultado tiene que aparecer para cada región, centro o puesto, eso condiciona el diseño mediante estratos o cuotas. También condiciona cuántos envíos necesitas en cada grupo. Decidirlo después del trabajo de campo no tiene arreglo.
Contrasta el diseño con la realidad del campo
El tiempo, el presupuesto, la posibilidad de contactar, el acceso lingüístico, la alfabetización, la conectividad y la política de incentivos deciden qué es ejecutable. Un diseño que un equipo de campo no puede seguir se convierte en un muestreo por conveniencia con un nombre formal, lo que es peor que elegir con honestidad un muestreo por conveniencia. Planificar un reclutamiento inclusivo reduce la infrarrepresentación sistemática.6 Una vez seleccionada la muestra, usa un creador de encuestas online para preparar el cuestionario y enviarlo a las personas elegidas según tu plan de muestreo. Compartir un enlace público sin restricciones cambia quién puede responder; no preserva una muestra aleatoria.
Dónde fallan realmente las muestras: cobertura, selección y no respuesta
La selección es la parte que preocupa a todo el mundo y la que menos veces falla. El daño suele producirse antes de la selección, en el marco, o después, en quién se molesta en responder. Ambos producen hojas de cálculo de aspecto impecable y conclusiones erróneas.
| Error | Cómo se manifiesta | Cómo reducirlo |
|---|---|---|
| Error de cobertura, un problema del marco | Algunas personas no pueden ser seleccionadas en absoluto: sin correo electrónico del trabajo, un listado de personal desactualizado, clientes que solo compran en persona, hogares sin conectividad. | Mejora o combina marcos. Añade modos: papel, en persona, teléfono, SMS. Documenta con exactitud quién queda excluido. |
| Sesgo de selección, un problema del procedimiento | En la práctica se pasa por alto la regla aleatoria. Por orden de llegada. Un responsable designa quién participa. | Automatiza el sorteo. Separa a la persona que selecciona de la que recluta. Audita cada excepción. |
| Sesgo de no respuesta, un problema del resultado | Las personas seleccionadas no responden, y quienes no responden difieren de quienes sí lo hacen en aquello que estás midiendo. | Mejora la estrategia de contacto y la experiencia del cuestionario y, después, compara a los participantes con una referencia conocida. Consulta sesgo de respuesta. |
| Error de medición | Una muestra impecable sigue dándote resultados sin sentido porque las preguntas son tendenciosas, vagas o dobles. | Prueba el instrumento antes de lanzarlo. Nuestra guía para redactar preguntas de encuesta repasa los fallos habituales. |
El fracaso de muestreo más famoso tuvo 2,4 millones de participantes
En 1936, el Literary Digest predijo que Alf Landon obtendría aproximadamente el 55 % de los votos. Franklin Roosevelt ganó con alrededor del 61 %.7 La revista había enviado por correo 10 millones de papeletas y recibió unos 2,4 millones de vuelta, una tasa de respuesta del 24 % a la que hoy no se acerca ningún sondeo nacional.8 El sondeo situó a Roosevelt veinte puntos por debajo de su porcentaje real, con una muestra de dos millones y medio de personas.
La cifra que debería figurar en todas las páginas sobre muestreo. Un reanálisis posterior calculó el margen de error muestral de las estimaciones del Digest por estado: oscilaba entre 0,18 y 2,3 puntos porcentuales, con una mediana de 0,6.8 Una cifra de precisión de más o menos medio punto, encima de un error de veinte puntos. Nada demuestra con más claridad que un margen de error mide solo una de las varias formas en que una encuesta puede equivocarse.
Y la explicación habitual solo es correcta a medias. A todo el mundo se le enseña que el Digest muestreó a propietarios de coches y abonados al teléfono, que eran ricos y republicanos. Una comprobación empírica de esa afirmación utilizó una encuesta de Gallup de mayo de 1937. Las personas que tenían coche y teléfono seguían inclinándose por Roosevelt, 55 a 45. Entre todas las que dijeron haber recibido una papeleta del Digest, Roosevelt aventajaba 55 a 44. El marco se inclinaba hacia los republicanos, pero ni de lejos lo suficiente para producir una victoria aplastante de Landon.7
La mitad que falta es la no respuesta. Entre las personas que dijeron haber devuelto su papeleta, Landon aventajaba 51 a 48. Entre las que no la devolvieron, Roosevelt aventajaba 69 a 30. La descomposición aproximada atribuye unos once puntos del error al marco y unos siete a la no respuesta diferencial.7 Ponderar las papeletas devueltas según una pregunta que el Digest ya había hecho, a quién se votó en 1932, habría dado el ganador correcto con una aritmética disponible en 1936.8
Una tasa de respuesta alta no es el objetivo que crees
Las tasas de respuesta de los propios sondeos telefónicos del Pew Research Center cayeron del 36 % en 1997 al 9 % en 2012, y al 6 % en 2018.9 Mientras tanto, la National Family Health Survey de la India (Encuesta Nacional de Salud Familiar), realizada cara a cara, seleccionó 664.972 hogares y encontró 653.144 de ellos ocupados. Entrevistó a 636.699 de esos, una tasa de respuesta del 97,5 %. Lee ese denominador con atención, porque es donde más a menudo se equivoca una tasa de respuesta: frente al número de hogares seleccionados en lugar del número de ocupados, el mismo trabajo de campo da un 95,7 %. La encuesta extrajo su muestra de 30.456 conglomerados en los 707 distritos.10
Esos dos hechos pertenecen a la misma década. El modo y el esfuerzo del trabajo de campo influyen en las tasas de respuesta mucho más que cualquier afirmación general sobre la fatiga ante las encuestas. Si una guía te dice que la tasa de respuesta media es un número concreto, no está describiendo una cantidad real.
Ahora, el hallazgo más incómodo. Un metaanálisis de 235 estimaciones del sesgo de no respuesta procedentes de 30 estudios publicados encontró que la correlación entre la tasa de respuesta y la magnitud del sesgo de no respuesta era de 0,33. Al cuadrado, eso significa que la tasa de respuesta explica alrededor del 11 % de la variación del sesgo.11 Un estudio de seguimiento con 59 estudios diseñados específicamente para medir el sesgo de no respuesta llegó a la misma conclusión.12
Merece la pena informar de la tasa de respuesta y merece la pena mejorarla. No es un certificado. Lo que causa el sesgo es que la tendencia a responder esté ligada a lo que mides. Una encuesta sobre voluntariado lo sufre mucho más que una encuesta sobre la velocidad de la banda ancha. Persigue la correlación, no el porcentaje.
Más envíos no pueden reparar un marco defectuoso
Durante la campaña de vacunación de 2021, dos encuestas muy grandes siguieron la vacunación en Estados Unidos. Una recogía unos 250.000 envíos a la semana y sobrestimó la vacunación con la primera dosis en 17 puntos porcentuales frente a la referencia oficial. La otra recogía unos 75.000 cada dos semanas y la sobrestimó en 14. Una tercera encuesta, de unas 1000 personas y realizada según la práctica probabilística estándar, produjo estimaciones fiables.13
El mismo patrón aparece en el trabajo habitual con encuestas. Al comparar tres paneles probabilísticos con tres fuentes online de participación voluntaria en 28 referencias y 29.937 entrevistas, el error absoluto medio fue de 5,8 puntos porcentuales en las muestras de participación voluntaria y de 2,6 en los paneles probabilísticos. En las 25 referencias disponibles por subgrupos, la diferencia para los adultos de 18 a 29 años fue de 11,2 frente a 3,6.14
Y un diagnóstico memorable: en una encuesta de participación voluntaria, el 12 % de los adultos menores de 30 años dijo tener licencia para manejar un submarino nuclear.15 La cifra real es casi cero. Si un panel puede producir eso, puede producir cualquier cosa, y un pedido mayor al mismo panel solo compra más de lo mismo.
A quién omite tu marco fuera de EE. UU. y el Reino Unido
La mayoría de las guías de muestreo dan por supuesto, sin decirlo, un marco occidental: una lista de correo electrónico, un teléfono fijo, un registro nacional de direcciones. Gran parte del mundo no muestrea así, y las carencias de cobertura tienen una forma medida.
- Una encuesta online en un país de ingresos bajos o medios es una muestra de su parte conectada, y esa parte está sesgada hacia los hombres. Las mujeres de los países de ingresos bajos y medios tienen un 14 % menos de probabilidades que los hombres de usar internet móvil, lo que equivale aproximadamente a 235 millones de mujeres menos que hombres conectadas.16
- Las muestras telefónicas sobrerrepresentan a los cabezas de familia. En las encuestas telefónicas del Banco Mundial en cuatro países africanos, los participantes eran hombres en un 52 % en Uganda y en un 73 % en Nigeria, frente a aproximadamente la mitad de la población adulta. En Uganda, el 6 % de los participantes telefónicos tenía entre 15 y 24 años, frente al 38 % de la población adulta.17
- Qué hacer al respecto. Combina modos en lugar de defender uno solo. Enumera los hogares sobre el terreno donde no existe un registro. Haz el trabajo de campo en los idiomas que tu población lee de verdad, y haz un pretest de la traducción en lugar de retrotraducirla. Después indica la carencia restante en tus limitaciones, porque seguirá ahí.
Lo que la ponderación puede y no puede arreglar
La ponderación ajusta tus datos para que la composición de la muestra coincida con cifras conocidas de la población. Es realmente potente y se sobrevalora de forma habitual.
A su favor. En 2016, el último sondeo de la University of New Hampshire daba a Clinton 11 puntos de ventaja en una contienda que ganó por 0,4. No se había ajustado por nivel educativo. El comité de revisión concluyó que ese único ajuste habría eliminado prácticamente todo el error.18 Una sola variable, correlacionada tanto con la respuesta como con el resultado, haciendo todo el trabajo.
En contra de confiar en ella. Cuando se evaluaron más de 30.000 entrevistas online de participación voluntaria frente a 24 referencias, el sesgo medio estimado sin ponderar fue de 8,4 puntos porcentuales. Ninguno de los procedimientos de ponderación probados, incluidos métodos de emparejamiento sofisticados, consiguió dejar el sesgo medio por debajo de 6 puntos.19 Cuadruplicar el tamaño de muestra aportó otros 0,2 puntos.
La regla que se desprende es sencilla. La ponderación corrige el desequilibrio en las variables con las que ponderas, en la medida en que esas variables se relacionan con el resultado. No hace nada respecto a las diferencias entre quienes responden y quienes no en aspectos que nunca mediste, y nunca convierte una muestra no probabilística en una que respalde una afirmación de precisión.
Una cifra de precisión es un suelo, no un techo
Un margen de error cuantifica la variabilidad muestral, y solo eso. Supone que la muestra se extrajo al azar de la población objetivo y que el sesgo restante se ha eliminado. El error de cobertura, el sesgo de no respuesta, el error de medición y los participantes fraudulentos quedan fuera de él.
Los datos son contundentes. En la última quincena de 2020, 348 sondeos presidenciales por estado publicaron un margen de error, y la cifra media publicada fue de 3,9 puntos. Medido frente a esa media, el 55 % de ellos falló el margen final por más de un margen de error, y el 21 % por más del doble.20 Eran sondeos modernos con métodos modernos. Trata el margen de error como un suelo para tu incertidumbre, nunca como un techo.
| Afirmación | La cifra | Calificación | Fuente |
|---|---|---|---|
| La tasa de respuesta apenas predice el sesgo de no respuesta | r = 0,33, es decir, alrededor del 11 % de la variación, en 235 estimaciones de 30 estudios | A | Groves, 200611 |
| Una encuesta muy grande puede equivocarse mucho | Sobrestimó la vacunación en 17 puntos con unos 250.000 envíos a la semana | A | Bradley y otros, 202113 |
| Las muestras de participación voluntaria son aproximadamente el doble de inexactas que los paneles probabilísticos | 5,8 frente a 2,6 puntos porcentuales de error medio en 28 referencias | A | Mercer y Lau, 202314 |
| La ponderación mejora una muestra de participación voluntaria, pero no la rescata | 8,4 puntos sin ponderar; ningún método por debajo de 6,0 puntos | A | Mercer, Lau y Kennedy, 201819 |
| Un margen de error subestima el error real de los sondeos | El 55 % de 348 sondeos por estado en 2020 falló por más del margen de error medio publicado, de 3,9 puntos | A | Grupo de trabajo de la AAPOR, 202120 |
| La explicación del marco del Literary Digest es incompleta | Quienes tenían coche y teléfono seguían prefiriendo a Roosevelt, 55 a 45 | B | Squire, 19887 |
La calificación A indica una estadística oficial, un metaanálisis o un hallazgo replicado. La calificación B indica un único estudio sólido cuya conclusión aún no se ha repetido de forma independiente.
«Una tasa de respuesta del 50 % es adecuada, del 60 % es buena y del 70 % es muy buena». Una regla empírica de manual sin ningún dato que la respalde. Distintas autoridades del mismo campo dan 50, 60 y 80. El sesgo depende de la correlación entre responder y la respuesta, no de la tasa.
«Con treinta basta, porque es cuando entra en juego el teorema central del límite». No hay ninguna derivación que dé 30. Para resultados simétricos, la aproximación funciona muy por debajo de esa cifra, y para resultados asimétricos o sucesos raros falla muy por encima.
«La tasa de respuesta media de las encuestas es del 33 %». Circula por los blogs de proveedores con una redacción casi idéntica y sin fuente primaria. El modo, el patrocinador, la población y el incentivo pesan mucho más que cualquier media global.
«La capacidad de atención es ahora de ocho segundos, menor que la de un pez de colores». Se remonta a un informe de marketing de 2015 que citaba a una empresa que no pudo aportar ninguna fuente. La investigación original nunca menciona ocho segundos ni peces de colores.
Efecto de diseño: por qué las muestras por conglomerados necesitan más personas
Casi todas las guías recomiendan el muestreo por conglomerados por su ahorro y ahí se quedan. El ahorro es real, y la factura también. Las personas de un mismo colegio, clínica, barrio o tienda se parecen entre sí. Se parecen entre sí más que a personas elegidas al azar en toda la población. Así que cada envío adicional de un grupo que ya has elegido aporta menos información nueva.
El efecto de diseño es la cifra que mide esto. Dicho con palabras: cuánto aumenta tu incertidumbre en comparación con extraer el mismo número de personas de forma independiente. Para un diseño con grupos del mismo tamaño es
efecto de diseño = 1 + (tamaño medio del grupo - 1) x correlación intraclase
La correlación intraclase indica cuánto se parecen las personas de un mismo grupo en aquello que mides. Cero significa que estar en el mismo colegio no dice nada sobre la respuesta de un alumno. Uno significa que todos los alumnos de un colegio responden lo mismo, y el colegio bien podría ser una sola persona. Los valores reales son pequeños, pero los valores pequeños hacen mucho daño cuando los grupos son grandes. Agrupando 48 encuestas nacionales de hogares, la correlación intraclase media es de aproximadamente 0,06. Varía según lo que midas. Los ítems de fecundidad rondan entre 0,01 y 0,03, el uso actual de anticonceptivos entre 0,03 y 0,05, y los partos con asistencia médica llegan a 0,22 en las cifras nacionales.21
Si no tienes una estimación propia, toma prestado un valor por defecto con cuidado. El manual de muestreo de las DHS recurre a 1,5 para el deft cuando una encuesta no tiene una cifra propia.22 El deft no es la misma magnitud que el efecto de diseño de la fórmula anterior: es el cociente de los dos errores estándar, mientras que el efecto de diseño es el cociente de las dos varianzas. Hay que elevarlo al cuadrado, así que un deft de 1,5 es un efecto de diseño de 2,25. El manual llama a ese valor un recurso de emergencia, no un valor típico, y sus propios ejemplos resueltos usan 1,40 para el uso de anticonceptivos modernos y 1,22 para la vacunación infantil.
| Diseño | Efecto de diseño | Envíos efectivos | Qué significa en la práctica |
|---|---|---|---|
| Selección independiente, sin conglomeración | 1.00 | 960 | Cada envío vale un envío completo. |
| 24 grupos de 40, CCI 0,02 | 1.78 | 539 | Pagaste por 960 y puedes defender la precisión de 539. |
| 24 grupos de 40, CCI 0,05 | 2.95 | 325 | Dos tercios del trabajo de campo no te aportaron ninguna precisión adicional. |
| 24 grupos de 40, CCI 0,10 | 4.90 | 196 | El diseño se ha convertido sin hacer ruido en un estudio pequeño con el presupuesto de uno grande. |
La ponderación añade su propio componente. Una encuesta nacional que sobremuestrea una región y luego la vuelve a ponderar arrastra dos efectos de diseño a la vez. Un efecto de ponderación de 1,22 y un efecto de conglomeración de 1,80 dan un efecto de diseño global de 2,20. Así, 5000 hogares entrevistados se comportan como 2277 independientes.23
La lección de diseño. Más grupos con menos personas en cada uno supera a menos grupos con más personas en cada uno, casi siempre. Cuarenta colegios de 24 alumnos y 24 colegios de 40 alumnos cuestan aproximadamente los mismos 960 envíos, pero el primero tiene un efecto de diseño menor y un resultado defendible. Si estás planificando cuántos envíos necesitas en total, calcúlalo en nuestra guía sobre el tamaño de muestra y luego multiplícalo por el efecto de diseño. Hacerlo al revés es lo que hace que los estudios por conglomerados acaben sin potencia suficiente.
Tres ejemplos resueltos, de principio a fin
Los nombres de los métodos son fáciles. Las decisiones que los rodean son donde los estudios fallan de verdad. Estos tres llevan un diseño real desde la definición de la población hasta la frase que puedes publicar.
Ejemplo 1: la experiencia de los pacientes en un distrito
- Población. Adultos que acudieron a una consulta externa en cualquiera de las 46 clínicas públicas del distrito entre el 1 de abril y el 30 de junio.
- Marco. No existe un registro de pacientes de todo el distrito. Sí existe una lista de las 46 clínicas, con su número mensual de consultas.
- Método. Polietápico. Selecciona 18 clínicas con probabilidad proporcional al número de consultas y luego muestrea sistemáticamente a cada 8.º paciente que sale durante dos días de consulta elegidos al azar.
- Por qué no algo más sencillo. Una lista completa de pacientes permitiría un muestreo estratificado, pero no existe y no se puede elaborar dentro del plazo. Una muestra por conveniencia en las tres clínicas más grandes sería más rápida y describiría las tres clínicas más grandes.
- De qué hay que informar. Las probabilidades de selección varían según el tamaño de la clínica, así que el análisis necesita ponderaciones y el intervalo debe ampliarse por el efecto de diseño.
- La frase publicable. «Entre los adultos que acudieron a consultas externas de clínicas públicas del distrito durante el segundo trimestre, se estima que el 71 % consideró aceptable su tiempo de espera, según 1240 entrevistas a la salida en 18 clínicas seleccionadas con probabilidad proporcional al número de consultas».
Ejemplo 2: un estudio para un trabajo de fin de grado sobre una población de estudiantes
- Población. Estudiantes matriculados en la Facultad de Comercio en el curso académico actual: 3100 repartidos en tres cursos.
- Marco. El registro de matrícula de la facultad, que incluye el curso y la titulación.
- Método. Muestreo aleatorio estratificado por curso, con asignación proporcional y un objetivo de 350 envíos completados.
- Los cálculos. El primer curso tiene 1300 estudiantes, que son el 42 % de 3100, así que le corresponde el 42 % de 350, es decir, 147 envíos. Repite el cálculo para cada curso. Como la asignación es proporcional, no hace falta ponderar.
- Planificación de los envíos. Con una tasa de respuesta prevista del 35 %, tienes que invitar a unos 1000 estudiantes para conseguir 350 envíos completados, y conviene invitarlos estrato por estrato para que una respuesta floja en un curso se vea mientras aún hay tiempo de actuar.
- Límites que hay que declarar. Los estudiantes que se han dado de baja pero siguen en el registro son sobrecobertura. Los estudiantes matriculados después de extraer el registro son subcobertura. Ambos van en el párrafo de limitaciones.
Ejemplo 3: opiniones de clientes de una tienda online
- Población. Clientes que completaron un pedido en los últimos 90 días.
- Marco. La tabla de pedidos. Está completa para los pedidos online y para las compras como invitado, pero un cliente con dos cuentas aparece dos veces.
- Método. Elimina duplicados para dejar una fila por cliente y luego aplica un muestreo sistemático de cada 12.º cliente a partir de un inicio aleatorio, de forma continua y no en un único lote.
- La trampa que evita. Invitar solo a los suscriptores del boletín es más rápido y es una muestra por conveniencia de tus clientes más implicados. Hará que la satisfacción parezca mejor de lo que es, sin falta, cada trimestre.
- Una nota sobre la plantilla. La misma organización, si encuesta a sus propios 180 empleados, no debería muestrear en absoluto. Esa población es pequeña y alcanzable, y todo el mundo tiene derecho a que se le pregunte. Haz un censo y, si la participación es baja, trátalo como un hallazgo y no como un problema de muestreo.
Cómo redactar la parte de muestreo de tu metodología
Este es el paso que la mayoría de las guías se saltan, y es el que de verdad lee un director de tesis, un revisor o un cliente. La redacción del muestreo tiene que responder a cinco preguntas en orden: quién, a partir de qué lista, elegido cómo, cuántos y, por tanto, qué puedes afirmar.
Rellena los huecos de abajo. Es deliberadamente sobrio: aquí los evaluadores no buscan una prosa elegante, buscan un diseño que puedan juzgar.
El mismo estudio, mal redactado y bien redactado
Débil. «Se tomó una muestra aleatoria de estudiantes y se recogieron 350 envíos».
Aquí no se puede comprobar nada. «Aleatoria» está haciendo un trabajo que no se ha ganado: no hay marco, no hay denominador y no se dice quién quedó excluido.
Sólido. «La población objetivo eran los 3100 estudiantes matriculados en la Facultad de Comercio en 2026. El marco muestral fue el registro de matrícula de la facultad extraído el 3 de marzo de 2026. Se utilizó un muestreo aleatorio estratificado por curso con asignación proporcional para poder informar de cada curso por separado. Se invitó a mil estudiantes y 350 completaron el cuestionario, una tasa de respuesta del 35 %. No se aplicó ninguna ponderación porque la asignación era proporcional. Los estudiantes que se dieron de baja después de la fecha de extracción permanecieron en el marco y no pudieron identificarse, lo que constituye una fuente menor de sobrecobertura».
La segunda versión es más larga, y cada frase adicional es una frase sobre la que un revisor ya no tiene que preguntar.
«Los participantes se reclutaron mediante un aviso dentro de la aplicación mostrado a los usuarios activos durante dos semanas. Se trata de una muestra por conveniencia, por lo que los resultados describen a las personas que respondieron y no pueden generalizarse al conjunto de usuarios, y no se publica ninguna cifra de precisión. Los participantes tenían más probabilidades que el conjunto de usuarios de ser usuarios diarios, lo que debe tenerse en cuenta al interpretar los resultados». Escribe eso y nadie podrá acusarte de exagerar tus conclusiones. No lo hiciste.
Lista de control del plan de muestreo
Un plan de muestreo por escrito evita la mayoría de los errores evitables, porque obliga a tomar las decisiones antes del trabajo de campo y no durante el análisis. Ocho puntos, una página.
- 1. Objetivo de la investigación. ¿Qué decisión respalda y de qué se va a informar exactamente?
- 2. Población objetivo. Quién entra y quién queda fuera del alcance, incluido el periodo de tiempo.
- 3. Marco muestral. Fuente, fecha de extracción, número de filas, carencias conocidas y la regla de eliminación de duplicados.
- 4. Método y motivo. Cuál de los nueve, y por qué este dado el marco y la afirmación.
- 5. Objetivos. Envíos completados en total y por subgrupo, además de la tasa de respuesta prevista con la que planificas.
- 6. Plan de reclutamiento. Modos, calendario de recordatorios, medidas de idioma y accesibilidad, política de incentivos.
- 7. Seguimiento. Qué vigilarás durante el trabajo de campo: la respuesta por estrato, el punto de abandono, la no respuesta por ítem.
- 8. Notas para el análisis. Ponderación prevista, ajuste por el efecto de diseño y las limitaciones que declararás pase lo que pase.
Una vez fijado el plan, el instrumento decide si mereció la pena extraer la muestra. Una muestra perfecta no puede rescatar una pregunta tendenciosa o doble, así que conviene repasar algunos ejemplos de preguntas de encuesta antes de lanzar nada.
Preguntas frecuentes
¿Qué es el muestreo en investigación?
El muestreo es el proceso de seleccionar un subconjunto de una población, llamado muestra, y estudiar ese subconjunto para sacar conclusiones sobre toda la población. Se utiliza porque medir a todos los miembros de una población suele ser demasiado lento, demasiado caro o imposible. El método utilizado para seleccionar la muestra determina qué conclusiones pueden respaldar los resultados.
¿Cuál es la diferencia entre población y muestra?
La población es el grupo completo que quieres describir. La muestra es el subconjunto más pequeño que realmente mides. El muestreo es el proceso que te lleva de una a otra, y un censo es la alternativa en la que, en cambio, mides a toda la población.
¿Qué es un marco muestral?
Un marco muestral es la lista o el mecanismo concreto del que extraes tu muestra: un registro de estudiantes, un registro de pacientes, una base de datos de clientes, un listado de hogares, un censo electoral. Importa más que el nombre del método, porque cualquiera que falte en el marco tiene una probabilidad nula de ser seleccionado, por buena que sea tu técnica de muestreo.
¿Qué método de muestreo no requiere un marco muestral?
El muestreo por conveniencia, por cuotas, intencional y de bola de nieve no necesitan ninguna lista. El muestreo por conglomerados y el polietápico solo necesitan una lista de grupos, como centros escolares, clínicas o pueblos, no una lista de individuos. El muestreo aleatorio simple, el sistemático y el estratificado requieren una lista completa de individuos antes de empezar.
¿Cuál es la diferencia entre el muestreo probabilístico y el no probabilístico?
En el muestreo probabilístico, la selección la hace un mecanismo aleatorio, de modo que cada unidad tiene una probabilidad conocida y distinta de cero de ser elegida, y puedes calcular cuán inciertas son tus estimaciones. En el muestreo no probabilístico, esas probabilidades son desconocidas porque la selección depende de la conveniencia, de las cuotas o del criterio del investigador. La consecuencia práctica es que solo un diseño probabilístico respalda una cifra de precisión declarada para una estimación poblacional.
¿Cuál es la diferencia entre el muestreo estratificado y el muestreo por conglomerados?
El muestreo estratificado divide la población en grupos y toma una muestra aleatoria de cada grupo, lo que mejora la precisión y garantiza que cada grupo aparezca. El muestreo por conglomerados selecciona algunos grupos al azar y luego encuesta a todas las personas de los grupos seleccionados, lo que ahorra costes cuando no existe una lista de individuos. En resumen: el estratificado usa todos los grupos y algunas de las personas; el de conglomerados usa algunos de los grupos y todas las personas.
¿Qué es una unidad primaria de muestreo?
La unidad primaria de muestreo es lo que se selecciona en la primera etapa de un diseño polietápico. En una encuesta nacional de hogares suele ser una zona, como un barrio, un pueblo o una sección censal. Después, en la segunda etapa, se seleccionan hogares dentro de ella. Nombrar tu unidad primaria de muestreo es un requisito habitual al informar de un diseño por conglomerados, porque la conglomeración que crea tiene que reflejarse en el análisis.
¿Qué es el muestreo aleatorio estratificado?
El muestreo aleatorio estratificado divide la población en grupos que no se solapan, llamados estratos, y luego extrae una muestra aleatoria de forma independiente dentro de cada estrato. La asignación proporcional da a cada estrato una parte de la muestra igual a su parte de la población y no necesita ponderación. La asignación no proporcional sobremuestrea deliberadamente estratos pequeños pero importantes, y luego exige ponderar antes de informar de cualquier cifra global.
¿Es válido el muestreo de bola de nieve en la investigación académica?
Sí, cuando la población está oculta, es poco frecuente o no está registrada y no se puede construir un marco muestral. Es un enfoque reconocido para grupos de difícil acceso. Lo que no puede hacer es respaldar una estimación poblacional, y su principal debilidad es que los participantes recomiendan a personas parecidas a ellos, así que la muestra se desplaza hacia una sola red social. Empezar desde varias semillas sin conexión entre sí reduce esa deriva, y conviene describirlo en tu metodología.
¿Es lo mismo el muestreo aleatorio que la asignación aleatoria?
No. El muestreo aleatorio es cómo seleccionas a los participantes de una población, y determina a quién se generalizan tus resultados. La asignación aleatoria es cómo repartes a los participantes seleccionados entre las condiciones de un experimento, y determina si un efecto observado se puede atribuir al tratamiento. Un estudio puede usar uno sin el otro, y la mayoría de los experimentos usan la asignación aleatoria sin muestreo aleatorio.
¿Puedo usar un método de muestreo no probabilístico en un estudio cuantitativo?
Sí, y gran parte de la investigación cuantitativa publicada lo hace. Lo que cambia es lo que puedes afirmar. Puedes informar de recuentos, porcentajes y relaciones dentro de tu muestra, y puedes comparar grupos dentro de ella. No puedes presentar esos porcentajes como estimaciones de la población con una precisión declarada. Indica el método, describe el reclutamiento, compara a tus participantes con una referencia conocida cuando exista y redacta la limitación de forma explícita en lugar de esperar que nadie pregunte.
¿Cuál es la diferencia entre el muestreo y una distribución muestral?
El muestreo es el procedimiento para seleccionar una muestra. Una distribución muestral es una idea distinta. Imagina que repites el mismo procedimiento de muestreo muchas veces. La dispersión del estadístico resultante, como la media o el porcentaje, a lo largo de todas esas muestras imaginadas es la distribución muestral. La distribución muestral es lo que hace posibles los intervalos de confianza, y solo se comporta de forma predecible cuando la muestra se extrajo con un método probabilístico.
¿Cómo sé si mi muestra está sesgada?
Compara la muestra obtenida con una referencia conocida, como tu plantilla, los registros de matrícula o los datos administrativos, en variables relacionadas con lo que mides. Las diferencias grandes apuntan a problemas de cobertura, problemas de selección o no respuesta diferencial. Compara también entre canales de reclutamiento y oleadas de recordatorios. Ten en cuenta que una tasa de respuesta saludable es una prueba débil de un sesgo bajo: en 235 estimaciones publicadas, la tasa de respuesta explicaba solo alrededor del 11 % de la variación del sesgo de no respuesta.
Lecturas relacionadas
El muestreo es una decisión dentro de un estudio más amplio. Estas guías cubren las decisiones anteriores y posteriores.
- Diseño de investigación por encuesta sitúa el muestreo en secuencia con el resto de un estudio, desde la definición de la población hasta el lanzamiento.
- Cómo determinar el tamaño de muestra cubre los cálculos de precisión que esta página deja deliberadamente para otro sitio, fórmulas incluidas.
- Cómo redactar preguntas de encuesta cubre la parte de medición, que ningún diseño muestral puede rescatar.
- Principios de diseño de cuestionarios explica cómo se monta un instrumento completo una vez que existen las preguntas.
- Sesgo de respuesta profundiza en la diferencia entre las personas que seleccionaste y las que respondieron.
- Preguntas demográficas para encuestas es útil cuando a tu marco le falta la variable por la que necesitas estratificar.
- Significación estadística explica qué hacer con las cifras una vez recogida la muestra.
- Análisis de datos cuantitativos cubre los pasos de análisis posteriores, incluido dónde entran las ponderaciones.
Cómo se escribió esta guía y qué no cubre
Quién la escribió. Michael Hodge, que trabaja en metodología de encuestas, diseño de preguntas y calidad de los datos en SuperSurvey, y escribe las guías prácticas de nuestra sección Guías y ayuda.
En qué se basa. Las definiciones siguen la revisión metodológica y las guías universitarias de investigación citadas más abajo, que es donde realmente se definen los términos técnicos. Las páginas oficiales de integridad en la investigación y de las oficinas de estadística se incluyen como puntos de partida breves y en lenguaje sencillo, no como fuente de esas definiciones. Las descripciones de los métodos siguen las mismas revisiones y guías. Cada cifra de la sección de datos procede de una fuente primaria identificada en la lista de abajo. Cada afirmación lleva además una calificación de confianza, para que veas qué hallazgos están consolidados y cuáles se apoyan en un único estudio. Las cifras del efecto de diseño del gráfico y de la tabla son cálculos nuestros. Usamos la fórmula estándar, con los supuestos indicados en el pie, para que puedas rehacerlas o discutirlas con tus propios tamaños de conglomerado.
Qué no cubre. Esta guía trata del muestreo para encuestas y estudios observacionales. No cubre el diseño experimental ni la asignación aleatoria más allá de distinguirlos. También deja fuera el muestreo para pruebas de aceptación, auditoría y procesamiento de señales, que usan la misma palabra para cosas distintas. El muestreo dirigido por los participantes, el muestreo por tiempo y lugar y el muestreo adaptativo por conglomerados son métodos reales que los especialistas usan para poblaciones ocultas, y aquí quedan fuera del alcance. Las cifras de correlación intraclase proceden de encuestas de hogares en países de ingresos bajos y medios. Tómalas como ilustrativas, no como valores que trasladar a otro contexto.
Dónde son más débiles las cifras. El reanálisis del Literary Digest se apoya en una encuesta de 1937 y en un reanálisis posterior, y ambos autores señalan su propia incertidumbre; por eso tiene una calificación B. Las cifras de error de los sondeos proceden de sondeos electorales de Estados Unidos, que están inusualmente bien estudiados y no son necesariamente representativos del error de las encuestas en general.
Transparencia. SuperSurvey vende software de encuestas. Nada de esta página está a la venta, ninguna parte exige registrarse y ninguna organización ha patrocinado ni revisado esta guía. Cuando enlazamos a nuestras propias páginas es porque cubren la siguiente decisión, no porque un enlace nos reporte nada.
Referencias
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., y Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- UK Government (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., y Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., y Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences e ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., y Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., y Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., y Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., y Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, páginas 9 y 15. Las cifras son de la edición de 2025; desde entonces, la GSMA ha publicado una edición de 2026 con una brecha menor.
- Brubaker, J., Kilic, T., y Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., y otros (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., y Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., y Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, página 9 y tabla 1.2.
- Kalton, G., Brick, J. M., y Le, T. (2005). Estimating components of design effects for use in sample design. En Household Sample Surveys in Developing and Transition Countries, capítulo VI. Naciones Unidas, Series F No. 96.