
Krótka odpowiedź
Dobór próby to proces wybierania podzbioru populacji, nazywanego próbą, i badania tego podzbioru w celu wyciągnięcia wniosków o całej populacji. Badacze dobierają próbę, ponieważ zmierzenie wszystkich jest zwykle zbyt powolne, zbyt kosztowne lub po prostu niemożliwe. Populacja to grupa, którą chcesz opisać, próba to jej część, którą faktycznie mierzysz, a operat losowania to lista, z której losujesz próbę.
Dobór probabilistyczny wybiera osoby za pomocą mechanizmu losowego, więc każda jednostka ma znane, niezerowe prawdopodobieństwo wyboru. Właśnie to pozwala wyrazić Twoją niepewność liczbą.
Dobór nieprobabilistyczny opiera wybór na dostępności, kwotach lub ocenie badacza. Często jest szybszy i tańszy, a czasem jest jedyną etyczną opcją, ale nie pozwala oszacować wartości dla populacji z określoną precyzją.
Przejdź od razu do: porównania 9 metod | wyboru metody | sprawdzenia wiedzy | opisu w pracy
Najważniejsze wnioski
- Dobór próby to badanie podzbioru: mierzysz próbę, aby dowiedzieć się czegoś o populacji, gdy zmierzenie wszystkich nie jest wykonalne.
- Najpierw opanuj pięć pojęć: populacja, operat losowania, jednostka losowania, schemat doboru próby oraz różnica między populacją, którą chcesz opisać, a tą, do której faktycznie możesz dotrzeć. Większość sporów o dobór próby to w rzeczywistości spory o jedno z nich.
- Tylko metody probabilistyczne pozwalają wyrazić Twoją niepewność liczbą. Próby wygodne, kwotowe, celowe i dobierane metodą kuli śnieżnej mogą być przydatne i rzetelne, ale nie pozwalają oszacować wartości dla populacji z określoną precyzją.
- Operat wyznacza Twój pułap: jeśli jakaś grupa nie może znaleźć się na liście, z której losujesz, żadna metoda ani żadna liczba dodatkowych wypełnień nie wprowadzi jej do Twoich wyników.
- Reprezentatywność to łańcuch, a nie etykieta: operat, potem wybór, potem rekrutacja, potem udzielenie odpowiedzi, potem analiza. Losowanie to jedno ogniwo z pięciu.
Definicja doboru próby (i 5 pojęć, które musisz dobrze rozumieć)
Dobór próby to proces wybierania mniejszej grupy (próby) z większej grupy (populacji), aby poznać populację bez mierzenia wszystkich. Badanie całej populacji jest często niepraktyczne, dlatego badacze dobierają próbę, by praca była wykonalna, a wnioski nadal użyteczne.
Na tych pięciu pojęciach opiera się każdy rozdział metodologiczny. Pomyl je, a każda późniejsza decyzja odziedziczy ten błąd.
- Populacja: cała grupa, którą chcesz opisać, określona granicami i przedziałem czasowym. „Wszyscy studenci ostatniego roku pielęgniarstwa w trzech kampusach, zapisani na dzień 1 marca” to populacja. „Pielęgniarki” już nie.
- Populacja docelowa a populacja dostępna: kogo chcesz opisać, a do kogo Twoja rekrutacja i narzędzia mogą faktycznie dotrzeć. Nazwanie luki między nimi to w opisie badania atut, a nie słabość.
- Operat losowania: lista lub mechanizm, z którego losujesz. Rejestr studentów, rejestr pacjentów, baza klientów, spis gospodarstw domowych we wsi, rejestr wyborców. Problemy z operatem powodują błąd pokrycia i żadna metoda ich nie naprawi.
- Jednostka losowania: to, co faktycznie zostaje wybrane. Osoba, gospodarstwo domowe, przychodnia, klasa, zmiana, zamówienie. W schematach grupowych i wielostopniowych jednostką na pierwszym etapie jest grupa, nazywana jednostką losowania pierwszego stopnia.
- Schemat doboru próby: cały plan zapisany na piśmie. Operat, metoda, liczba jednostek, sposób kontaktu oraz to, co zrobisz z osobami, które nie odpowiedzą. „Schemat doboru próby” to właśnie to, o co pyta egzaminator lub recenzent, gdy pyta o Twój dobór próby.
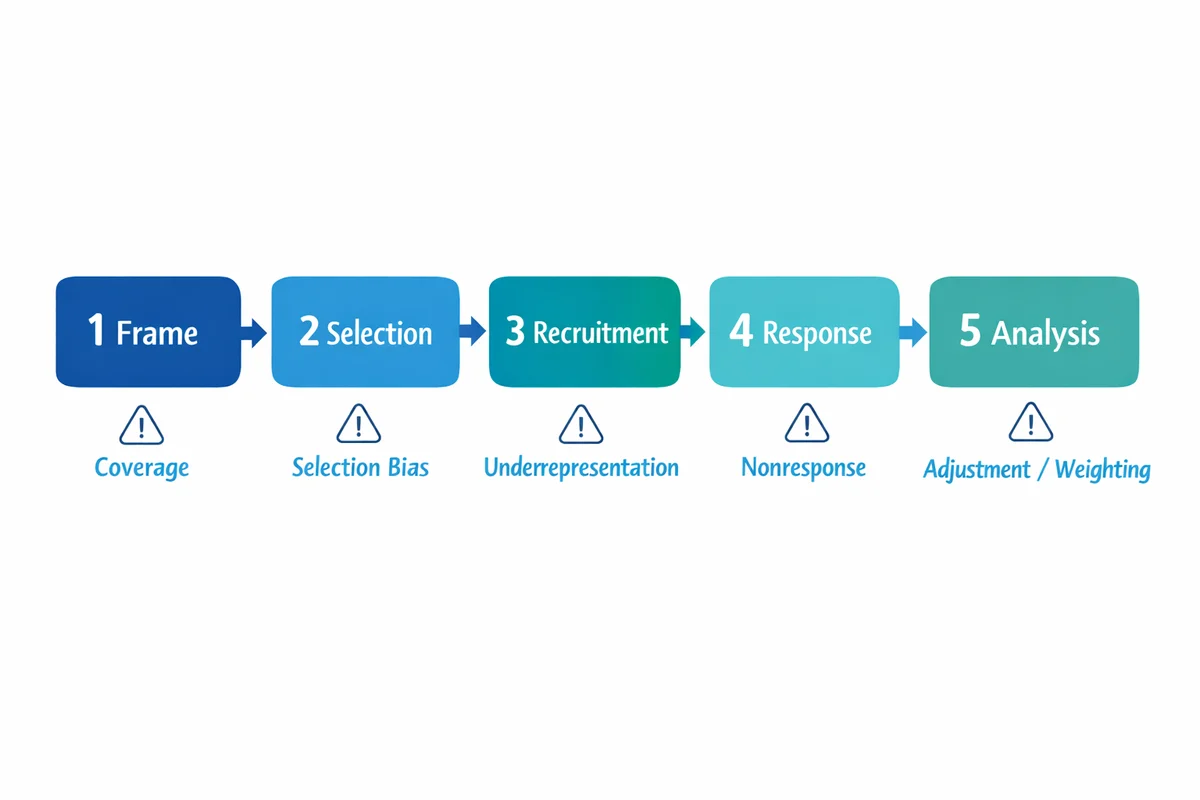
Możesz przeprowadzić podręcznikowe losowanie i mimo to skończyć z obciążoną próbą. Jeśli Twój operat pomija jakiś segment, jego członkowie nigdy nie mogli zostać wylosowani. Jeśli jakiś segment nie odpowiada, odpada już po wylosowaniu. Traktuj dobór próby jak łańcuch: operat, potem wybór, potem rekrutacja, potem udzielenie odpowiedzi, potem analiza.
Krótką oficjalną definicję tego samego pojęcia znajdziesz w materiale szkoleniowym amerykańskiego U.S. Office of Research Integrity na temat doboru próby.1 Jeśli umieszczasz dobór próby w szerszym planie badania, nasz przewodnik po projekcie badania ankietowego omawia kroki przed nim i po nim.
Po co w ogóle dobierać próbę i kiedy lepsze jest badanie pełne
Potrzeba doboru próby ma podłoże praktyczne, zanim stanie się statystyczna. Wciąż powracają cztery powody.
Koszt
Każdy dodatkowy uczestnik kosztuje pieniądze, czas pracowników lub dobrą wolę. Dobrze dobrana próba licząca 600 osób może odpowiedzieć na to samo pytanie co źle przeprowadzone badanie 60 000 osób.
Szybkość
Decyzje mają terminy. Próba daje Ci odpowiedź w czasie, w którym ta odpowiedź jest jeszcze przydatna.
Wykonalność
Niektórych populacji w ogóle nie da się spisać: przechodniów na targu, osób, które zrezygnowały z usługi, handlarzy z szarej strefy. Inne są w praktyce nieskończone albo zmierzenie jednostki ją niszczy.
Jakość
To wielu zaskakuje. Skupienie wysiłku na mniejszej grupie pozwala docierać do osób, które nie odpowiedziały, porządnie przeszkolić ankieterów i sprawdzić dane. Wysiłek włożony w każdą jednostkę jest zwykle wart więcej niż sama liczba jednostek.
Badanie pełne mierzy natomiast wszystkich. Jest lepszym wyborem, gdy populacja jest na tyle mała, że można do niej dotrzeć, gdy dane kontaktowe już istnieją lub gdy każdy jej członek ma prawo zostać zapytany. Ankieta pracownicza w organizacji liczącej 200 osób to kwestia badania pełnego, a nie doboru próby. Podobnie ocena zajęć. Gdy populacja jest mała, dobór próby nie daje prawie nic, a odbiera możliwość raportowania według zespołów.
Jak naprawdę wygląda dobra próba
Podręczniki opisują dobrą próbę jako „reprezentatywną”, co nie jest kryterium operacyjnym. Te cztery cechy nim są.
- Pokrycie: każdy z populacji docelowej mógł w zasadzie zostać wybrany.
- Kontrolowany wybór: o tym, kto trafia do próby, decyduje reguła, a nie to, kto się zgłosi albo kto stoi najbliżej drzwi.
- Wystarczająca liczba jednostek w najmniejszej grupie, którą musisz raportować: ogólna liczba może wyglądać dobrze, podczas gdy grupa, na której naprawdę Ci zależy, opiera się na 11 wypełnieniach.
- Możliwość opisu: możesz dokładnie zapisać, jak próba została wylosowana, a ktoś inny mógłby to powtórzyć.
| Jeśli Twoim celem jest | Konsekwencje dla doboru próby | Typowa pułapka |
|---|---|---|
| Oszacowanie odsetka w populacji | Zastosuj metodę probabilistyczną, śledź, kto odpowiada, i podawaj precyzję obok wyniku. | Traktowanie próby wygodnej tak, jakby opisywała populację. |
| Porównanie podgrup | Zaplanuj liczbę wypełnień w każdej podgrupie, zwykle przez warstwowanie i nadreprezentację małych grup. | Raportowanie podgrupy, której wynik opiera się na garstce osób. |
| Badanie doświadczeń i mechanizmów | Właściwy jest dobór celowy lub teoretyczny. Uzasadnij, które perspektywy są uwzględnione, a które nie. | Pogoń za minimalną liczbą bez żadnego uzasadnienia. |
| Testowanie interwencji | Dobór próby decyduje o tym, na kogo można uogólnić wynik. Losowy przydział decyduje o tym, czy efekt jest rzeczywisty. | Mylenie losowego przydziału z losowym doborem próby. To różne operacje. |
Przystępny opis tego, jak próby pozwalają szacować wartości dla populacji, znajdziesz w omówieniu doboru próby i wnioskowania w badaniach ankietowych przygotowanym przez U.S. Census Bureau. To dobry punkt wyjścia.2
Operat losowania wyznacza pułap
Operat losowania to konkretna lista lub mechanizm, z którego losujesz. To najrzadziej omawiana część doboru próby i miejsce, w którym większość rzeczywistych badań po cichu się psuje, bo to operat decyduje o tym, kto w ogóle mógł zostać wybrany.
Operaty to zwyczajne obiekty. Rejestr studentów, rejestr pacjentów, lista pracowników z działu HR, baza klientów. Lista wsi z liczbą gospodarstw domowych, rejestr wyborców, seria zamówień, lista przychodni w powiecie. Zauważ, że niektóre operaty wymieniają ludzi, a inne miejsca. To rozróżnienie decyduje o tym, które metody są dla Ciebie dostępne.
| Problem | Jak to wygląda | Jak wpływa na Twoje wyniki |
|---|---|---|
| Niepełne pokrycie | Na liście brakuje osób z populacji: pracowników bez służbowego e-maila, klientów, którzy kupowali stacjonarnie, gospodarstw domowych bez zarejestrowanego adresu. | Całe segmenty mają zerowe prawdopodobieństwo wyboru. Dodatkowe wypełnienia tego nie naprawią, bo brakujące osoby nigdy nie mogły zostać wybrane. |
| Nadmierne pokrycie | Lista zawiera jednostki spoza Twojej populacji: byłych studentów, zamknięte konta, osoby, które się wyprowadziły. | Marnujesz wysiłek, a jeśli ich nie odsiejesz, mierzysz niewłaściwą populację. |
| Duplikaty | Ta sama osoba występuje więcej niż raz: dwa adresy e-mail, dwa numery konta. | Te osoby mają większe prawdopodobieństwo wyboru niż wszyscy pozostali, co po cichu łamie założenie równych szans. |
| Nieaktualność | Lista była dokładna, gdy powstawała, ale teraz już nie jest. | Niedoręczone wiadomości wyglądają jak odmowy, więc zarówno Twój wskaźnik odpowiedzi, jak i diagnoza obciążenia wychodzą błędnie. |
Sprawdź operat przed losowaniem, a nie po nim. Policz wiersze. Porównaj tę liczbę z dowolną niezależną sumą, jaką znajdziesz, na przykład liczbą pracowników według działu HR lub liczbą zapisanych studentów. Poszukaj segmentu, którego pominięcie byłoby dla Ciebie najbardziej kompromitujące, i sprawdź, czy jest obecny. Usuń duplikaty. Zapisz, czego operat nie obejmuje, bo to zdanie i tak trafi do ograniczeń Twojego badania.
Dobór wygodny, kwotowy, celowy i metodą kuli śnieżnej w ogóle nie wymagają listy. Dobór grupowy i wielostopniowy wymagają jedynie listy grup (szkół, przychodni, okręgów, wsi), a nie listy osób. Prosty dobór losowy, dobór systematyczny i dobór warstwowy wymagają pełnej listy osób, zanim w ogóle zaczniesz. Jeśli nie masz listy i nie możesz jej zbudować, sam ten fakt wyklucza trzy z dziewięciu metod opisanych na tej stronie. Zwykle to pierwsza rzecz do ustalenia.
Porównanie 9 metod doboru próby
Metody doboru próby dzielą się na dwie rodziny. Dobór probabilistyczny wykorzystuje mechanizm losowy, więc każda jednostka w operacie ma znane, niezerowe prawdopodobieństwo wyboru. Dobór nieprobabilistyczny go nie wykorzystuje, więc prawdopodobieństwa wyboru są nieznane. Wszystko inne wynika z tego jednego rozróżnienia.
Druga kolumna to ta, którą większość poradników pomija, dlatego tutaj jest na początku. Tylko schemat probabilistyczny pozwala podać margines błędu, przedział ufności albo zdanie „plus minus 5 punktów procentowych”. Jeśli przy danej metodzie widnieje tam „nie”, nadal możesz się z niej wiele dowiedzieć. Po prostu nie możesz opublikować miary precyzji obok wyniku. Sama precyzja to osobny temat, omówiony w naszym przewodniku po wielkości próby.
| Metoda | Czy pozwala podać margines błędu? | Jak działa | Właściwy wybór, gdy | Ile kosztuje i jakie obciążenie wprowadza |
|---|---|---|---|---|
| Prosty dobór losowy Probabilistyczny Wymaga pełnej listy |
Tak | Każda jednostka na liście ma równe szanse. Losujesz wymaganą liczbę jednostek. | Masz jedną czystą listę bez duplikatów i żadnej podgrupy, którą musisz raportować osobno. | KosztMusisz mieć pełną listę, a małe grupy mogą okazać się zbyt małe, by o nich raportować.ObciążenieBardzo małe na etapie wyboru. Całe pozostałe ryzyko przenosi się na to, kto faktycznie odpowie. |
| Dobór systematyczny Probabilistyczny Wymaga pełnej listy |
Tak, jeśli kolejność na liście nie ma związku z badaną cechą | Posortuj listę, wybierz losowy punkt startowy, a następnie bierz co k-ty rekord. | Lista jest długa lub napływa na bieżąco, a zespół terenowy potrzebuje jednej prostej reguły. | KosztPrawie żaden, o ile kolejność nie ma nic wspólnego z tym, co mierzysz.ObciążenieOkresowość. Jeśli lista powtarza się w cyklu zgodnym z Twoim interwałem, ciągle trafiasz na ten sam rodzaj jednostki. |
| Dobór warstwowy Probabilistyczny Wymaga pełnej listy |
Tak, zwykle węższy niż przy prostym doborze losowym | Podziel listę na istotne grupy (warstwy), a następnie losuj w każdej z nich. | Musisz raportować według regionu, wydziału, działu lub przedziału wiekowego albo spodziewasz się, że odsetek odpowiedzi będzie się mocno różnić między grupami. | KosztZmienna grupująca musi być na liście przed losowaniem, a nierówne frakcje trzeba zważyć na etapie analizy.ObciążenieNiskie. Prawdziwym ryzykiem jest wybór warstw, które nie mają nic wspólnego z badaną cechą: to dodatkowa praca bez zysku na precyzji. |
| Dobór grupowy Probabilistyczny Wymaga listy grup |
Tak, poszerzony o efekt schematu losowania | Wylosuj całe grupy (szkoły, przychodnie, okręgi, wsie), a następnie przebadaj wszystkich w wylosowanych grupach. | Nie możesz sporządzić listy osób, ale możesz sporządzić listę miejsc, w których się znajdują, a koszty dojazdu lub organizacji dominują w budżecie. | KosztPrecyzja. Osoby w tej samej grupie są do siebie podobne, więc każde dodatkowe wypełnienie wnosi mniej nowych informacji.ObciążenieNiskie, jeśli grupy są losowane, ale mała liczba grup sprawia, że wynik jest niestabilny i trudny do obrony. |
| Dobór wielostopniowy Probabilistyczny Wymaga listy grup |
Tak, z wagami i efektem schematu losowania | Najpierw losuj grupy, a potem jednostki w wylosowanych grupach, w dwóch lub więcej etapach. | Badania obejmujące cały powiat lub cały kraj, gdzie nie istnieje jedna lista osób, ale istnieją jednostki administracyjne. | KosztZłożoność. Prawdopodobieństwa wyboru różnią się między jednostkami, więc analiza wymaga wag i kogoś, kto potrafi je zastosować.ObciążenieW teorii niskie. W praktyce każdy etap to nowa okazja, by zespół terenowy odszedł od planu. |
| Dobór wygodny Nieprobabilistyczny Bez listy |
Nie | Bierzesz tych, do których najłatwiej dotrzeć: okienko pop-up na stronie internetowej, grupę, którą uczysz, osoby przechodzące obok stoiska. Nazywany też doborem dostępnościowym. | Prowadzisz badanie eksploracyjne, testujesz kwestionariusz w badaniu pilotażowym albo potrzebujesz kierunku w tym tygodniu, a nie liczby do obrony w następnym kwartale. | KosztUprawnione wnioski. Rezygnujesz z możliwości powiedzenia czegokolwiek o populacji.ObciążenieAutoselekcja. Nadreprezentuje osoby łatwo osiągalne, dostępne i już zaangażowane. |
| Dobór kwotowy Nieprobabilistyczny Bez listy |
Nie. Wygląda na zrównoważony, choć nie jest losowy | Ustal docelowe liczebności dla grup, na przykład 50 kobiet i 50 mężczyzn albo 40 osób ze wsi i 60 z miast, a następnie rekrutuj, aż każda kwota zostanie wypełniona. | Potrzebujesz szybko próby, która przynajmniej odpowiada populacji pod względem widocznych cech, bez listy, z której można losować. | KosztKontrola nad tym, kto wypełnia każdą kwotę. Rekruterzy nadal wybierają, a wybierają osoby przystępne.ObciążenieObciążenie wyboru w obrębie kwot. Dopasowanie pod względem wieku i płci nie sprawia, że ludzie są typowi pod względem postaw. |
| Dobór celowy Nieprobabilistyczny Bez listy |
Nie i nie próbuje | Celowo wybierasz przypadki spełniające określone kryteria: ekspertów, przypadki skrajne, typowe lub krytyczne. Nazywany też doborem eksperckim. | Badania jakościowe, wywiady eksperckie, studia przypadków i każde pytanie, w którym głębia jest ważniejsza niż liczenie. | KosztŻaden, o ile jasno zaznaczasz, że nigdy nie chodziło o liczenie.ObciążenieWłasne wyobrażenie badacza o tym, kto jest istotny. |
| Dobór metodą kuli śnieżnej Nieprobabilistyczny Bez listy |
Nie | Zrekrutuj kilku uczestników, a następnie poproś każdego z nich o wskazanie innych osób spełniających kryteria. | Grupa jest ukryta, napiętnowana, rzadka lub niezarejestrowana: pracownicy migrujący, osoby, które zrezygnowały z usługi, handlarze z szarej strefy, osoby z rzadką chorobą. | KosztCzas i kontrola nad kształtem próby. Dziedziczysz sieć kontaktów osób, od których zaczynasz.ObciążenieHomofilia. Ludzie polecają osoby podobne do siebie, więc jeden zakątek populacji jest nadreprezentowany. |
Jak czytać tabelę: pierwsze pięć metod to schematy probabilistyczne, a ostatnie cztery nie. To jedno rozróżnienie, a nie nazwy poszczególnych metod, decyduje o tym, czy podana precyzja jest uczciwa.
Metody doboru probabilistycznego po kolei
Dobór probabilistyczny oznacza, że każda jednostka w operacie ma znane, niezerowe prawdopodobieństwo wyboru, a wyboru dokonuje mechanizm losowy. To jedyna podstawa, by mówić cokolwiek liczbowego o populacji. Pięć schematów obejmuje niemal każde rzeczywiste badanie. Przeglądy z badań klinicznych i badań nad zdrowiem omawiają tę samą rodzinę pod nieco innymi nazwami i warto wiedzieć dlaczego, zanim się z nimi zetkniesz: oba cytowane tutaj przeglądy włączają dobór wielostopniowy do doboru grupowego, zamiast wymieniać go osobno.34
Prosty dobór losowy
Prosty dobór losowy daje każdej jednostce na liście dokładnie takie samo prawdopodobieństwo wyboru. Numerujesz listę, generujesz liczby losowe i bierzesz jednostki, na które one wypadną.
Przykład z obliczeniami. Rejestr uczelni obejmuje 12 000 zapisanych studentów, a Ty potrzebujesz 400 wypełnień. Ponumeruj rejestr od 1 do 12000, wygeneruj w arkuszu kalkulacyjnym lub pakiecie statystycznym 400 niepowtarzalnych liczb losowych z tego zakresu i zaproś tych studentów. Jeśli spodziewasz się 40-procentowego wskaźnika odpowiedzi, wylosuj i zaproś 1000 osób, aby 400 wypełnień było realne.
Gdzie zawodzi. Przy 400 wypełnieniach rozłożonych na rejestr 12 000 studentów wydział liczący 300 studentów dostarcza około 10 osób. To za mało, by o nim raportować. Jeśli jakakolwiek podgrupa musi pojawić się w Twoich wynikach, prosty dobór losowy jest złym narzędziem, a rozwiązaniem jest dobór warstwowy.
Zapisz sposób losowania. Użyte oprogramowanie, ziarno generatora, jeśli było, i datę. To jedno zdanie sprawia, że losowanie da się odtworzyć, a recenzenci naprawdę o nie pytają.
Dobór systematyczny
Dobór systematyczny polega na wybieraniu co k-tej jednostki z uporządkowanej listy po losowym starcie. Podziel liczebność listy przez potrzebną liczbę, aby uzyskać interwał k, wybierz losową liczbę od 1 do k jako punkt startowy, a następnie odliczaj dalej.
Przykład z obliczeniami. Szpital powiatowy odnotowuje w kwartale 9000 wizyt ambulatoryjnych i chce przeprowadzić 600 wywiadów z pacjentami wychodzącymi z wizyty. Interwał to 9000 podzielone przez 600, czyli k równa się 15. Wybierz losowy start od 1 do 15, powiedzmy 7, a następnie przeprowadź wywiad przy wizycie 7, 22, 37, 52 i tak dalej. Zespół terenowy może stosować tę regułę bez laptopa i to jest prawdziwy powód, dla którego ta metoda przetrwała.
Gdzie zawodzi. Okresowość. Jeśli lista ma powtarzający się cykl zgodny z k, za każdym razem losujesz to samo miejsce w cyklu. Lista wizyt uporządkowana według dni przyjęć w 7-dniowym cyklu przy interwale 7 dałaby Ci jeden dzień tygodnia i nic więcej. Sprawdź kolejność, zanim ustalisz k, i przetasuj listę, jeśli kolejność ma związek z tym, co mierzysz.
Dobór warstwowy
Dobór warstwowy dzieli populację na rozłączne grupy zwane warstwami, a następnie losuje próbę w każdej warstwie. To najbardziej użyteczne ulepszenie dostępne w większości badań, bo gwarantuje, że każda grupa, o której musisz raportować, faktycznie się pojawi.
Przykład z pokazanymi obliczeniami. Organizacja zatrudnia 4200 pracowników w sześciu województwach i potrzebuje 600 wypełnień.
- Alokacja proporcjonalna. Województwo z 1400 pracownikami to 1400 podzielone przez 4200, czyli jedna trzecia kadry, więc otrzymuje jedną trzecią z 600, czyli 200 wypełnień. Województwo z 210 pracownikami otrzymuje 210 podzielone przez 4200 razy 600, czyli 30 wypełnień. Każde województwo jest reprezentowane proporcjonalnie do swojej wielkości i na etapie analizy nie trzeba stosować wag.
- Alokacja nieproporcjonalna, nazywana też nadreprezentacją. Trzydzieści wypełnień to za mało, by raportować o tym małym województwie osobno. Celowo bierzesz więc z niego 80 i dla równowagi zmniejszasz liczbę z największego województwa. Teraz prawdopodobieństwa wyboru różnią się między województwami, więc zanim podasz jakąkolwiek liczbę dla całej organizacji, musisz zważyć dane z powrotem do rzeczywistych proporcji. Pominięcie tego kroku to najczęstszy błąd w doborze warstwowym.
Wybór warstw. Wybieraj zmienne, które mają związek z badaną cechą lub z tym, kto prawdopodobnie odpowie, i które już są w Twoim operacie. Zwykle są to region, placówka, stanowisko, staż pracy, kierunek studiów, rodzaj planu i przedział wiekowy. Warstwy niezwiązane z badaną cechą dokładają pracy administracyjnej i nie dają żadnej precyzji. Jeśli zmiennej grupującej brakuje w operacie, być może trzeba będzie zebrać ją w samym kwestionariuszu. Nasz przewodnik po pytaniach demograficznych w ankiecie pokazuje, jak pytać o te zmienne, nie tracąc uczestników.
Dobór grupowy
Dobór grupowy polega na losowaniu całych naturalnie istniejących grup, a następnie badaniu wszystkich w wylosowanych grupach. Potrzebujesz listy grup, a nie listy osób, i właśnie dlatego ta metoda istnieje.
Przykład z obliczeniami. Powiat ma 180 szkół podstawowych i żadnej centralnej listy uczniów. Losujesz 24 szkoły i przeprowadzasz ankietę wśród wszystkich uczniów 8 klasy w każdej z nich. Odbywasz 24 wizyty w szkołach zamiast 180 i na starcie w ogóle nie potrzebujesz rejestru uczniów.
Ile Cię to kosztuje. Uczniowie tej samej szkoły są do siebie bardziej podobni niż do uczniów z całego powiatu. Każdy dodatkowy uczeń w szkole, którą już wybrano, wnosi więc mniej nowych informacji niż niezależnie wybrany uczeń. Efektywna liczba wypełnień jest mniejsza niż ich rzeczywista liczba. To zawyżenie to efekt schematu losowania i trzeba go uwzględnić w planie, a nie odkrywać na etapie analizy.
Gdzie zawodzi. Zbyt mało grup. Sześć losowo wybranych szkół może bardzo się od siebie różnić, a wynik zależy od tego, którą szóstkę akurat wylosujesz. Więcej grup z mniejszą liczbą osób w każdej jest prawie zawsze lepsze niż odwrotnie.
Dobór wielostopniowy
Dobór wielostopniowy polega na wyborze w dwóch lub więcej etapach: najpierw grupy, potem jednostki w wylosowanych grupach, a czasem trzeci etap w ich obrębie. Prawie każde krajowe badanie gospodarstw domowych na świecie jest zbudowane w ten sposób.
Przykład z obliczeniami. Wylosuj 120 okręgów z krajowej listy okręgów. W każdym wylosowanym okręgu zespół terenowy spisuje gospodarstwa domowe na miejscu, a następnie losuje 20 z nich. W każdym wylosowanym gospodarstwie domowym jedna osoba dorosła jest wybierana losowo, a nie ta, która akurat otworzy drzwi. To trzy etapy, a ostatni ma znaczenie: pozwolenie gospodarstwu domowemu na decyzję, kto odpowie, przywraca dokładnie to obciążenie wyboru, przed którym schemat miał chronić.
Ile Cię to kosztuje. Różne osoby mają różne prawdopodobieństwa wyboru, więc analiza wymaga wag, a obliczenie wariancji musi uwzględniać grupowanie na każdym etapie. To prawdziwy schemat, który wymaga kogoś, kto potrafi przeprowadzić analizę ważoną. Jeśli nikt w projekcie tego nie potrafi, wybierz prostszy schemat zamiast nieważonego schematu wielostopniowego.
Dla zaawansowanych: losowanie z prawdopodobieństwem proporcjonalnym do wielkości i dlaczego duże grupy są wybierane częściej
W przykładzie ze szkołami każda szkoła miała takie samo prawdopodobieństwo wyboru, niezależnie od tego, czy liczyła 60 uczniów, czy 900. To daje uczniowi małej szkoły znacznie większą szansę trafienia do próby niż uczniowi dużej szkoły. Analiza musi to potem skorygować.
Losowanie z prawdopodobieństwem proporcjonalnym do wielkości naprawia to na etapie projektowania. Prawdopodobieństwo wyboru każdej grupy ustala się proporcjonalnie do liczby jednostek, które obejmuje. Szkoła z 900 uczniami ma wtedy piętnaście razy większą szansę wylosowania niż szkoła z 60 uczniami. Następnie z każdej wylosowanej szkoły bierzesz tę samą liczbę uczniów. Oba etapy się równoważą i każdy uczeń w powiecie ma w efekcie mniej więcej takie samo łączne prawdopodobieństwo wyboru. To standardowe podejście w badaniach krajowych, a wymaga miary wielkości każdej grupy w operacie przed losowaniem.
Dobór warstwowy a grupowy: różnica w jednym zdaniu
Te dwie metody są ciągle mylone, bo obie zaczynają od podziału populacji na grupy. Różnica polega na tym, co robisz dalej.
| Aspekt | Dobór warstwowy | Dobór grupowy |
|---|---|---|
| Jakich grup używasz | Próbę dobiera się z każdej grupy. | Wybiera się niektóre grupy, a pozostałe w ogóle nie są wykorzystywane. |
| Kogo losujesz w obrębie grupy | Losowy podzbiór grupy. | Wszystkich w grupie albo, w wersji wielostopniowej, kolejny losowy podzbiór. |
| Grupy powinny być | Wewnętrznie podobne i różne od siebie nawzajem. Region, stanowisko, kierunek studiów. | Wewnętrznie zróżnicowane, każda jak mała kopia populacji. Szkoły, przychodnie, okręgi. |
| Dlaczego warto ją wybrać | Precyzja i gwarantowana reprezentacja podgrup. | Koszt i dostępność, gdy nie istnieje lista osób. |
| Wpływ na precyzję | Zwykle ją zwiększa w porównaniu z prostym doborem losowym przy tej samej liczbie wypełnień. | Zmniejsza ją. Uwzględnij w budżecie efekt schematu losowania. |
| Czego potrzebujesz na start | Pełnej listy osób, na której już jest zmienna grupująca. | Wyłącznie listy grup. |
Warstwowy: wszystkie grupy, niektórzy ludzie. Grupowy: niektóre grupy, wszyscy ludzie. Dobór warstwowy służy dokładności, grupowy dostępności.
Metody doboru nieprobabilistycznego po kolei
Dobór nieprobabilistyczny oznacza, że prawdopodobieństwa wyboru są nieznane, bo o tym, kto został wybrany, nie decydował żaden mechanizm losowy. To właściwy wybór w czterech sytuacjach. Nie możesz zbudować użytecznego operatu. Grupa jest ukryta. Szybkość jest ważniejsza niż precyzja. Albo pytanie dotyczy znaczenia, a nie skali.
Te metody nie są gorszego sortu. Odpowiadają na inne pytanie. Błędem nigdy nie jest samo ich użycie, tylko użycie ich, a potem napisanie zdania, które mogłaby uzasadnić wyłącznie próba probabilistyczna.
Dobór wygodny
Dobór wygodny, nazywany też doborem dostępnościowym, rekrutuje tych, do których najłatwiej dotrzeć. Okienko pop-up na stronie internetowej, link w newsletterze, studenci z Twojej własnej grupy, osoby przechodzące obok stoiska na targu.
Przykład. Sklep umieszcza link do opinii na paragonie. Każdy, kto odpowiada, coś kupił, miał przy sobie telefon, miał czas i miał powód, żeby się tym zająć. Każdy z tych filtrów usuwa inną część klientów.
Uczciwe zastosowanie. Badanie pilotażowe kwestionariusza, generowanie hipotez, poznawanie języka, jakim posługują się klienci, sprawdzanie, czy pytanie jest zrozumiałe. Wszystko to doskonałe zastosowania. Żadne z nich nie wymaga oszacowania dla populacji.
Dobór kwotowy
Dobór kwotowy wyznacza cele rekrutacyjne dla określonych grup i je wypełnia. Czterdzieści osób ze wsi i sześćdziesiąt z miast. Pięćdziesiąt kobiet i pięćdziesięciu mężczyzn. Po dwadzieścia osób w każdym z pięciu przedziałów wiekowych.
Przykład. Zespół badań rynkowych potrzebuje 500 wypełnień odpowiadających krajowemu rozkładowi wieku, płci i regionu i nie ma listy populacji. Rekrutuje, aż każda komórka zostanie wypełniona.
Dlaczego to nadal nie jest dobór probabilistyczny. Kwoty kontrolują kształt próby, a nie wybór osób, które się w niej znajdą. Rekrutujący nadal wybiera, a osoby, do których łatwo podejść, systematycznie różnią się od tych, do których nie. Próba może idealnie odpowiadać populacji pod względem wieku i płci, a mimo to poważnie mylić się co do postaw, bo to nie wiek i płeć były zmiennymi wyrządzającymi szkodę.
Dobór celowy
Dobór celowy, nazywany też doborem eksperckim, polega na świadomym wyborze przypadków spełniających określone kryteria. Typowe warianty to dobór przypadków typowych, skrajnych, krytycznych, maksymalnego zróżnicowania oraz dobór ekspertów.
Przykład. Badanie tego, jak używany jest nowy system płatności, obejmuje osiem osób. Dwie, które korzystają z niego codziennie, dwie, które z niego zrezygnowały, dwie, które nigdy nie zaczęły z niego korzystać, i dwie osoby z działu wsparcia, które obsługują reklamacje. Taki rozkład jest wybrany celowo, a uzasadnienie wyboru jest metodą.
Uczciwe zastosowanie. Większość badań jakościowych. Kryterium nie jest tu losowość. Liczy się to, czy potrafisz powiedzieć, dlaczego te przypadki, a nie inne, i czy zakres opinii jest wystarczająco szeroki, by uzasadnić Twoje wnioski.
Dobór metodą kuli śnieżnej
Dobór metodą kuli śnieżnej polega na zrekrutowaniu niewielkiej liczby uczestników, którzy następnie wskazują inne osoby spełniające kryteria, a te wskazują kolejne.
Przykład. Badanie nieformalnych handlarzy przygranicznych zaczyna się od czterech uczestników wskazanych przez lokalne stowarzyszenie, a każdy z nich przedstawia dwie kolejne osoby. Nie istnieje rejestr nieformalnych handlarzy, więc żadna metoda oparta na operacie nie jest dostępna.
Co to robi z Twoją próbą. Homofilia. Ludzie polecają osoby podobne do siebie. Próba dryfuje w stronę jednej sieci społecznej i oddala się od odizolowanych członków populacji, a to często ich badanie najbardziej potrzebuje usłyszeć. Rozpoczęcie od kilku niepowiązanych ze sobą osób startowych zamiast jednej zmniejsza ten dryf, ale go nie usuwa.
Jak sprawić, by próba nieprobabilistyczna była do obrony
Większość poradników kończy na „nie można uogólniać” i zostawia czytelnika bez pomocy, choć większość czytelników prowadzi właśnie takie badanie. Oto część, której zwykle brakuje.
- Opisz rekrutację, a nie tylko nazwę metody. Gdzie zamieszczono link, w jakich dniach, kto go zobaczył, czy oferowano zachętę oraz ile osób poproszono o udział, a ile odpowiedziało. To pozwala czytelnikowi ocenić próbę, zamiast zgadywać.
- Porównaj uzyskaną próbę ze znanym punktem odniesienia i opublikuj to porównanie. Jeśli w Twojej organizacji 60% to pracownicy terenowi, a wśród uczestników jest ich 25%, napisz to w tabeli. Ujawnione skrzywienie jest ustaleniem badawczym. Ukryte jest wadą.
- Wiedz, co ważenie może, a czego nie może. Dostosowanie danych tak, by struktura demograficzna odpowiadała populacji, może skorygować widoczną nierównowagę. Nie skoryguje jednak różnic między uczestnikami a innymi osobami pod względem czegoś, czego nie zmierzono, i nigdy nie zamieni próby nieprobabilistycznej w taką, która pozwala podać precyzję.
- Zmień zdanie, a nie statystykę. Zamiast „38% klientów jest niezadowolonych, plus minus 4 punkty procentowe” napisz „38% spośród 620 klientów, którzy odpowiedzieli, zgłosiło niezadowolenie. Uczestników zrekrutowano przez komunikat w aplikacji w ciągu dwóch tygodni i nie stanowią oni losowej próby klientów”. Drugie zdanie jest krótsze, bardziej użyteczne i nie da się go zaatakować.
Badania jakościowe mają na to własne słownictwo. Protokół badania zwykle wymaga uzasadnienia, a nie docelowej liczby. Powinien obejmować planowaną liczbę uczestników i zakres opinii; to rozróżnienie zwięźle przedstawia poradnik University of Bath.5
Dopasuj metodę do sytuacji
Sześć sytuacji, sześć metod. Zdecyduj, zanim otworzysz odpowiedź. To najszybszy sposób, by sprawdzić, czy tabela powyżej naprawdę do Ciebie trafiła.
1. Masz kompletny rejestr 4200 pracowników i musisz opublikować wyniki dla każdego z sześciu województw.
Dobór warstwowy. Pełna lista istnieje, więc dobór probabilistyczny jest dla Ciebie dostępny, a obowiązek raportowania według województw to dokładnie to, czemu służy warstwowanie. Prosty dobór losowy zostawiłby najmniejsze województwo ze zbyt małą liczbą wypełnień, by o nim raportować.
2. Badasz osoby, które zrezygnowały z usługi sześć miesięcy temu. Nie ma listy, a najtrudniej znaleźć tych, którzy odeszli najbardziej rozgniewani.
Dobór metodą kuli śnieżnej. Operat nie istnieje, a do populacji trudno dotrzeć, co wyklucza każdą metodę probabilistyczną. Zacznij od kilku niepowiązanych ze sobą osób startowych zamiast jednej i zaznacz w ograniczeniach badania, że łańcuchy poleceń przesuwają próbę w stronę osób dobrze powiązanych.
3. Szpital chce zebrać dane o doświadczeniach pacjentów ze strumienia 9000 wizyt na kwartał, a zbierać je ma personel bez komputera przy stanowisku.
Dobór systematyczny. Populacja napływa jako uporządkowany strumień, więc reguła interwału jest zarazem metodą probabilistyczną i czymś, co zapracowany personel rejestracji naprawdę może wykonać. Najpierw sprawdź, czy kolejność wizyt nie podlega tygodniowemu cyklowi zgodnemu z Twoim interwałem.
4. Musisz zrozumieć, dlaczego ludzie porzucają nowe narzędzie, a masz trzy tygodnie i zerowy budżet.
Dobór celowy. Pytanie dotyczy mechanizmu, a nie skali. Wybieraj świadomie z całego zakresu: intensywni użytkownicy, osoby, które zrezygnowały, osoby, które nigdy nie zaczęły, personel wsparcia. Nie podawaj na tej podstawie odsetków.
5. Powiat ma 180 szkół, nie ma rejestru uczniów, a budżet na dojazdy wystarcza na około 25 wizyt.
Dobór grupowy. Lista szkół istnieje, choć listy uczniów nie ma, a koszt dojazdów jest głównym ograniczeniem. Poszerz podawany przedział o efekt schematu losowania i wybieraj raczej więcej szkół z mniejszą liczbą uczniów w każdej niż odwrotnie.
6. Musisz w pięć dni zebrać 500 wypełnień odpowiadających krajowemu profilowi wieku i regionu, a nie ma listy populacji.
Dobór kwotowy. To najszybszy sposób na próbę, która przynajmniej odpowiada populacji pod względem widocznych cech. Nadal nie jest to próba probabilistyczna, więc opisz skład próby i zrezygnuj z podawania precyzji.
Jak wybrać metodę doboru próby
Większość badań nie upada dlatego, że ktoś wybrał niewłaściwą technikę z nazwy. Upadają, bo technika nie pasowała do operatu, do decyzji albo do tego, co zespół terenowy realnie mógł zrobić. Trzy pytania niemal zawsze to rozstrzygają.
Która metoda pasuje do Twojego badania?
Odpowiedz na trzy pytania. Rekomendacja pojawi się poniżej, a pasujące wiersze zostaną podświetlone w tabeli porównawczej.
Zacznij od twierdzenia, które chcesz sformułować
Zanim cokolwiek wybierzesz, napisz zdanie, które chcesz opublikować. „Sześćdziesiąt dwa procent naszych klientów poleciłoby nas” i „klienci, którzy odchodzą, opisują trzy powtarzające się problemy” to różne zdania, które wymagają różnych schematów. Jeśli nikt nie potraktuje wyniku jako liczby dla populacji, masz znacznie więcej swobody, niż myślisz.
Sprawdź operat, zanim się zdecydujesz
Czy naprawdę możesz sporządzić listę populacji lub czegoś, co ją dobrze przybliża? Jeśli nie, czy możesz sporządzić listę grup, do których należą jej członkowie? Odpowiedź na to jedno pytanie od razu eliminuje większość z dziewięciu metod i dlatego jest ono drugie, a nie ostatnie.
Wskaż podgrupy, o których musisz raportować
Jeśli wynik musi zostać podany dla każdego regionu, placówki lub stanowiska, wyznacza to schemat badania przez warstwy lub kwoty. Wyznacza też liczbę wypełnień potrzebnych w każdej grupie. Decyzji podjętej dopiero po badaniu terenowym nie da się już naprawić.
Sprawdź schemat w zderzeniu z realiami terenu
Czas, budżet, możliwość kontaktu, dostępność językowa, umiejętność czytania, dostęp do internetu i zasady przyznawania zachęt decydują o tym, co jest wykonalne. Schemat, którego zespół terenowy nie potrafi stosować, staje się doborem wygodnym z formalną nazwą, a to gorsze niż uczciwy wybór doboru wygodnego. Inkluzywne planowanie rekrutacji zmniejsza systematyczne niedoreprezentowanie.6 Gdy już wylosujesz próbę, użyj kreatora ankiet online, aby przygotować kwestionariusz i wysłać go osobom wybranym zgodnie z Twoim planem doboru próby. Udostępnienie nieograniczonego publicznego linku zmienia to, kto może odpowiedzieć, i nie zachowuje próby losowej.
Gdzie próby naprawdę zawodzą: pokrycie, wybór i brak odpowiedzi
Wybór to część, o którą wszyscy się martwią, a która psuje się najrzadziej. Szkody zwykle powstają przed wyborem, w operacie, albo po nim, w tym, kto zada sobie trud odpowiedzi. Jedno i drugie daje porządnie wyglądające arkusze i błędne wnioski.
| Błąd | Jak to wygląda | Jak go ograniczyć |
|---|---|---|
| Błąd pokrycia, problem operatu | Niektórych osób w ogóle nie da się wybrać: brak służbowego e-maila, nieaktualna lista, klienci kupujący wyłącznie stacjonarnie, gospodarstwa domowe bez dostępu do internetu. | Ulepsz lub połącz operaty. Dodaj tryby: papier, kontakt osobisty, telefon, SMS. Dokładnie udokumentuj, kto jest wykluczony. |
| Obciążenie wyboru, problem procedury | Reguła losowa zostaje w praktyce pominięta. Kto pierwszy, ten lepszy. Kierownik wskazuje, kto weźmie udział. | Zautomatyzuj losowanie. Oddziel osobę, która wybiera, od osoby, która rekrutuje. Sprawdzaj każdy wyjątek. |
| Błąd braku odpowiedzi, problem rezultatu | Wybrane osoby nie odpowiadają, a te, które nie odpowiadają, różnią się od tych, które odpowiadają, pod względem tego, co mierzysz. | Popraw strategię kontaktu i komfort wypełniania kwestionariusza, a następnie porównaj uczestników ze znanym punktem odniesienia. Zobacz zniekształcenie odpowiedzi. |
| Błąd pomiaru | Bezbłędna próba nadal daje bezsensowne wyniki, bo pytania są sugerujące, niejasne albo dotyczą dwóch rzeczy naraz. | Przetestuj narzędzie przed badaniem terenowym. Nasz przewodnik po pisaniu pytań do ankiety omawia typowe błędy. |
Najsłynniejsza porażka doboru próby miała 2,4 miliona uczestników
W 1936 roku Literary Digest przewidział, że Alf Landon zdobędzie około 55% głosów. Franklin Roosevelt wygrał z wynikiem około 61%.7 Magazyn rozesłał 10 milionów kart do głosowania i otrzymał z powrotem około 2,4 miliona, co daje wskaźnik odpowiedzi 24%, do którego żaden dzisiejszy ogólnokrajowy sondaż nawet się nie zbliża.8 Sondaż zaniżył rzeczywisty wynik Roosevelta o dwadzieścia punktów procentowych, i to na próbie dwóch i pół miliona osób.
Liczba, która powinna być na każdej stronie o doborze próby. W późniejszej ponownej analizie obliczono margines błędu losowego dla szacunków Digest na poziomie stanów: wynosił od 0,18 do 2,3 punktu procentowego, z medianą 0,6.8 Precyzja rzędu plus minus pół punktu przy błędzie wynoszącym dwadzieścia punktów. Nic nie pokazuje wyraźniej, że margines błędu mierzy tylko jeden z kilku sposobów, w jakie ankieta może się mylić.
A standardowe wyjaśnienie jest prawdziwe tylko w połowie. Wszystkich uczy się, że Digest dobierał próbę spośród właścicieli samochodów i abonentów telefonicznych, którzy byli zamożni i głosowali na republikanów. Jeden z empirycznych testów tej tezy wykorzystał badanie Gallupa z maja 1937 roku. Osoby, które miały i samochód, i telefon, i tak częściej wybierały Roosevelta, 55 do 45. Wśród wszystkich, którzy twierdzili, że otrzymali kartę od Digest, Roosevelt prowadził 55 do 44. Operat był przechylony w stronę republikanów, ale nie na tyle, by dać miażdżące zwycięstwo Landonowi.7
Brakującą połową jest brak odpowiedzi. Wśród osób, które twierdziły, że odesłały kartę, Landon prowadził 51 do 48. Wśród tych, które jej nie odesłały, Roosevelt prowadził 69 do 30. Przybliżony rozkład przypisuje około jedenastu punktów błędu operatowi, a około siedmiu zróżnicowanemu brakowi odpowiedzi.7 Zważenie odesłanych kart według pytania, które Digest już zadał, czyli jak głosowano w 1932 roku, wskazałoby właściwego zwycięzcę za pomocą arytmetyki dostępnej w 1936 roku.8
Wysoki wskaźnik odpowiedzi nie jest celem, za jaki go uważasz
Wskaźniki odpowiedzi w sondażach telefonicznych samego Pew Research Center spadły z 36% w 1997 roku do 9% w 2012 roku i do 6% w 2018 roku.9 Tymczasem indyjskie National Family Health Survey, prowadzone metodą wywiadów bezpośrednich, wylosowało 664 972 gospodarstwa domowe i ustaliło, że 653 144 z nich są zamieszkane. Przeprowadzono wywiady w 636 699 z nich, co daje wskaźnik odpowiedzi 97,5%. Uważnie przeczytaj ten mianownik, bo to najczęstsze miejsce, w którym wskaźnik odpowiedzi się psuje: w odniesieniu do liczby wylosowanych, a nie zamieszkanych gospodarstw, to samo badanie terenowe daje 95,7%. Próbę wylosowano z 30 456 grup we wszystkich 707 dystryktach.10
Te dwa fakty pochodzą z tej samej dekady. Tryb badania i wysiłek włożony w badanie terenowe wpływają na wskaźniki odpowiedzi znacznie bardziej niż jakiekolwiek ogólne twierdzenie o zmęczeniu ankietami. Jeśli poradnik podaje Ci, że przeciętny wskaźnik odpowiedzi to jakaś jedna liczba, nie opisuje rzeczywistej wielkości.
Teraz trudniejsze ustalenie. Metaanaliza 235 oszacowań błędu braku odpowiedzi z 30 opublikowanych badań wykazała, że korelacja między wskaźnikiem odpowiedzi a wielkością błędu braku odpowiedzi wynosiła 0,33. Po podniesieniu do kwadratu oznacza to, że wskaźnik odpowiedzi wyjaśnia około 11% zmienności obciążenia.11 Kolejna analiza 59 badań zaprojektowanych specjalnie do pomiaru błędu braku odpowiedzi doszła do tego samego wniosku.12
Wskaźnik odpowiedzi warto podawać i warto go poprawiać. Nie jest jednak certyfikatem. Obciążenie powstaje wtedy, gdy skłonność do udzielenia odpowiedzi wiąże się z tym, co mierzysz. Ankieta o wolontariacie cierpi na to znacznie bardziej niż ankieta o prędkości internetu. Goń za korelacją, a nie za odsetkiem.
Więcej wypełnień nie naprawi wadliwego operatu
Podczas kampanii szczepień w 2021 roku dwie bardzo duże ankiety śledziły poziom zaszczepienia w Stanach Zjednoczonych. Jedna zbierała około 250 000 wypełnień tygodniowo i zawyżyła odsetek osób zaszczepionych pierwszą dawką o 17 punktów procentowych w porównaniu z oficjalnym punktem odniesienia. Druga zbierała około 75 000 co dwa tygodnie i zawyżyła go o 14. Trzecia ankieta, licząca około 1000 uczestników i prowadzona zgodnie ze standardową praktyką probabilistyczną, dała wiarygodne oszacowania.13
Ten sam wzorzec pojawia się w zwykłej pracy ankietowej. W porównaniu trzech paneli probabilistycznych z trzema internetowymi źródłami opartymi na dobrowolnym zgłoszeniu, obejmującym 28 punktów odniesienia i 29 937 wywiadów, średni błąd bezwzględny wyniósł 5,8 punktu procentowego dla prób z dobrowolnym zgłoszeniem i 2,6 dla paneli probabilistycznych. W przypadku 25 z tych punktów odniesienia, dostępnych dla podgrup, różnica dla dorosłych w wieku od 18 do 29 lat wyniosła 11,2 wobec 3,6.14
I zapadający w pamięć test diagnostyczny: w jednej ankiecie z dobrowolnym zgłoszeniem 12% dorosłych poniżej 30 roku życia stwierdziło, że ma uprawnienia do kierowania okrętem podwodnym o napędzie atomowym.15 Rzeczywista liczba jest bliska zeru. Jeśli panel potrafi dać taki wynik, potrafi dać każdy, a większe zamówienie w tym samym panelu kupuje tylko więcej tego samego.
Kogo pomija Twój operat poza USA i Wielką Brytanią
Większość poradników o doborze próby po cichu zakłada zachodni operat: listę adresów e-mail, telefon stacjonarny, krajowy rejestr adresów. Duża część świata nie dobiera prób w ten sposób, a luki w pokryciu mają zmierzony kształt.
- Ankieta online w kraju o niskim lub średnim dochodzie to próba jego podłączonej do sieci części, a ta część jest zdominowana przez mężczyzn. Kobiety w krajach o niskim i średnim dochodzie o 14% rzadziej niż mężczyźni korzystają z mobilnego internetu, co oznacza około 235 milionów kobiet mniej niż mężczyzn w sieci.16
- Próby telefoniczne nadreprezentują głowy gospodarstw domowych. W telefonicznych badaniach Banku Światowego w czterech krajach afrykańskich mężczyźni stanowili 52% uczestników w Ugandzie i 73% w Nigerii, wobec mniej więcej połowy populacji dorosłych. W Ugandzie 6% uczestników badania telefonicznego było w wieku od 15 do 24 lat, wobec 38% populacji dorosłych.17
- Co z tym zrobić. Łącz tryby badania, zamiast bronić jednego. Spisuj gospodarstwa domowe na miejscu tam, gdzie nie ma rejestru. Prowadź badanie w językach, w których Twoja populacja faktycznie czyta, i przeprowadź pretest tłumaczenia, zamiast tłumaczyć je z powrotem. Następnie opisz pozostałą lukę w ograniczeniach badania, bo i tak nadal będzie istnieć.
Co ważenie może naprawić, a czego nie
Ważenie dostosowuje dane tak, by skład próby odpowiadał znanym danym o populacji. To naprawdę skuteczne narzędzie i nagminnie przecenia się jego możliwości.
Argument za. W 2016 roku ostatni sondaż University of New Hampshire dawał Clinton przewagę 11 punktów procentowych w wyścigu, który wygrała różnicą 0,4. Sondaż nie był ważony według wykształcenia. Komisja oceniająca uznała, że ta jedna korekta usunęłaby praktycznie cały błąd.18 Jedna zmienna, skorelowana zarówno z udzieleniem odpowiedzi, jak i z wynikiem, wykonała całą pracę.
Argument przeciw poleganiu na nim. Gdy ponad 30 000 internetowych wywiadów z dobrowolnym zgłoszeniem porównano z 24 punktami odniesienia, średnie szacowane obciążenie bez ważenia wyniosło 8,4 punktu procentowego. Żadna z testowanych procedur ważenia, łącznie z zaawansowanymi metodami dopasowania, nie obniżyła średniego obciążenia poniżej 6 punktów.19 Czterokrotne zwiększenie wielkości próby dało kolejne 0,2 punktu.
Wniosek jest prosty. Ważenie koryguje nierównowagę w zmiennych, według których ważysz, w takim stopniu, w jakim te zmienne wiążą się z wynikiem. Nie zmienia niczego w tym, czym uczestnicy różnią się od osób, które nie odpowiedziały, pod względem cech, których nigdy nie zmierzono, i nigdy nie zamienia próby nieprobabilistycznej w taką, która pozwala podać precyzję.
Miara precyzji to dolna granica, a nie górna
Margines błędu określa zmienność wynikającą z losowania próby i tylko ją. Zakłada, że próbę wylosowano z populacji docelowej i że pozostałe obciążenie zostało usunięte. Błąd pokrycia, błąd braku odpowiedzi, błąd pomiaru i nieuczciwi uczestnicy leżą poza nim.
Dowody są bezlitosne. W ostatnich dwóch tygodniach przed wyborami w 2020 roku 348 stanowych sondaży prezydenckich podało margines błędu, a średnia podana wartość wynosiła 3,9 punktu. W odniesieniu do tej średniej 55% z nich pomyliło się co do ostatecznej różnicy o więcej niż jeden margines błędu, a 21% o więcej niż dwa.20 Były to nowoczesne sondaże prowadzone nowoczesnymi metodami. Traktuj margines błędu jako dolną granicę swojej niepewności, nigdy jako górną.
| Twierdzenie | Liczba | Poziom | Źródło |
|---|---|---|---|
| Wskaźnik odpowiedzi ledwo przewiduje błąd braku odpowiedzi | r = 0,33, czyli około 11% zmienności, na podstawie 235 oszacowań z 30 badań | A | Groves, 200611 |
| Bardzo duża ankieta może się poważnie mylić | Zawyżony o 17 punktów poziom zaszczepienia przy około 250 000 wypełnień tygodniowo | A | Bradley i in., 202113 |
| Próby z dobrowolnym zgłoszeniem są mniej więcej dwa razy mniej dokładne niż panele probabilistyczne | 5,8 wobec 2,6 punktu procentowego średniego błędu dla 28 punktów odniesienia | A | Mercer i Lau, 202314 |
| Ważenie poprawia próbę z dobrowolnym zgłoszeniem, ale jej nie ratuje | 8,4 punktu bez ważenia, żadna metoda poniżej 6,0 punktu | A | Mercer, Lau i Kennedy, 201819 |
| Margines błędu zaniża rzeczywisty błąd sondaży | 55% z 348 stanowych sondaży w 2020 roku pomyliło się o więcej niż średni podany margines błędu wynoszący 3,9 punktu | A | Zespół zadaniowy AAPOR, 202120 |
| Wyjaśnienie porażki Literary Digest samym operatem jest niepełne | Właściciele samochodów i telefonów i tak woleli Roosevelta, 55 do 45 | B | Squire, 19887 |
Ocena A oznacza oficjalną statystykę, metaanalizę lub powtórzony wynik. Ocena B oznacza jedno mocne badanie, którego wniosku nie powtórzono jeszcze niezależnie.
„Wskaźnik odpowiedzi 50% jest wystarczający, 60 dobry, 70 bardzo dobry”. Podręcznikowa reguła kciuka bez żadnych danych na jej poparcie. Różne autorytety w tej samej dziedzinie podają 50, 60 i 80. Obciążenie zależy od korelacji między udzieleniem odpowiedzi a jej treścią, a nie od wskaźnika.
„Trzydzieści wystarczy, bo wtedy zaczyna działać centralne twierdzenie graniczne”. Nie istnieje wyprowadzenie, które daje 30. Dla rozkładów symetrycznych przybliżenie działa znacznie poniżej tej liczby, a dla rozkładów skośnych lub rzadkich zdarzeń zawodzi znacznie powyżej niej.
„Przeciętny wskaźnik odpowiedzi w ankietach wynosi 33%”. To zdanie krąży po blogach firm w niemal identycznym brzmieniu bez żadnego źródła pierwotnego. Tryb badania, zleceniodawca, populacja i zachęty przytłaczają każdą globalną średnią.
„Czas skupienia uwagi wynosi teraz osiem sekund, mniej niż u złotej rybki”. Pochodzi z raportu marketingowego z 2015 roku, który powoływał się na firmę niebędącą w stanie wskazać źródła. Badania, na których rzekomo się opierał, nigdy nie wspominają ani o ośmiu sekundach, ani o złotych rybkach.
Efekt schematu losowania: dlaczego próby grupowe potrzebują więcej osób
Prawie każdy poradnik poleca dobór grupowy ze względu na oszczędność kosztów i na tym kończy. Oszczędność jest prawdziwa, ale rachunek także. Osoby w tej samej szkole, przychodni, okręgu czy sklepie są do siebie podobne. Bardziej niż do osób wylosowanych z całej populacji. Każde dodatkowe wypełnienie z grupy, którą już wybrano, wnosi więc mniej nowych informacji.
Efekt schematu losowania to liczba, która to mierzy. Mówiąc słowami: o ile szerszy staje się zakres Twojej niepewności w porównaniu z niezależnym wylosowaniem tej samej liczby osób. Dla schematu z grupami równej wielkości wynosi on
efekt schematu losowania = 1 + (średnia wielkość grupy - 1) x korelacja wewnątrzklasowa
Korelacja wewnątrzklasowa mówi, jak bardzo osoby w obrębie grupy są do siebie podobne pod względem tego, co mierzysz. Zero oznacza, że przynależność do tej samej szkoły nic nie mówi o odpowiedzi ucznia. Jeden oznacza, że wszyscy w szkole odpowiadają identycznie, więc szkoła równie dobrze mogłaby być jedną osobą. Rzeczywiste wartości są małe, ale małe wartości wyrządzają dużo szkód, gdy grupy stają się duże. Po zsumowaniu danych z 48 krajowych badań gospodarstw domowych średnia korelacja wewnątrzklasowa wynosi około 0,06. Zależy od tego, co mierzysz. Dla pytań o dzietność wynosi około 0,01 do 0,03, dla obecnego stosowania antykoncepcji 0,03 do 0,05, a dla porodów z pomocą medyczną w danych krajowych nawet 0,22.21
Jeśli nie masz własnego oszacowania, ostrożnie zapożycz wartość domyślną. Podręcznik doboru próby DHS przyjmuje 1,5 dla deft, gdy badanie nie ma własnej wartości.22 Deft to nie ta sama wielkość co efekt schematu losowania we wzorze powyżej: to stosunek dwóch błędów standardowych, podczas gdy efekt schematu losowania to stosunek dwóch wariancji. Deft podnosi się do kwadratu, więc deft równy 1,5 to efekt schematu losowania równy 2,25. Podręcznik nazywa tę wartość awaryjną, a nie typową, a w jego własnych przykładach z obliczeniami przyjęto 1,40 dla stosowania nowoczesnej antykoncepcji i 1,22 dla szczepień dzieci.
| Schemat | Efekt schematu losowania | Efektywne wypełnienia | Co to oznacza w praktyce |
|---|---|---|---|
| Niezależny wybór, bez grupowania | 1.00 | 960 | Każde wypełnienie ma pełną wartość. |
| 24 grupy po 40, ICC 0,02 | 1.78 | 539 | Płacisz za 960, a możesz obronić precyzję odpowiadającą 539. |
| 24 grupy po 40, ICC 0,05 | 2.95 | 325 | Dwie trzecie badania terenowego nie dały żadnej dodatkowej precyzji. |
| 24 grupy po 40, ICC 0,10 | 4.90 | 196 | Schemat po cichu stał się małym badaniem z budżetem dużego. |
Ważenie dodaje własny składnik. Krajowe badanie, które nadreprezentuje jeden region, a potem przywraca mu właściwy udział przez ważenie, ma jednocześnie dwa efekty schematu. Efekt ważenia 1,22 i efekt grupowania 1,80 dają łączny efekt schematu losowania 2,20. Tak więc 5000 przebadanych gospodarstw domowych zachowuje się jak 2277 niezależnych.23
Lekcja dla projektu badania. Więcej grup z mniejszą liczbą osób w każdej wygrywa z mniejszą liczbą grup z większą liczbą osób w każdej niemal zawsze. Czterdzieści szkół po 24 uczniów i 24 szkoły po 40 uczniów kosztują mniej więcej tyle samo, czyli 960 wypełnień, ale pierwszy wariant ma mniejszy efekt schematu losowania i daje wynik do obrony. Jeśli planujesz, ile wypełnień potrzebujesz łącznie, oblicz to w naszym przewodniku po wielkości próby, a następnie pomnóż przez efekt schematu losowania. Robienie tego w odwrotnej kolejności sprawia, że badania grupowe kończą się zbyt małą mocą statystyczną.
Trzy przykłady z obliczeniami, od początku do końca
Nazwy metod są łatwe. To decyzje wokół nich sprawiają, że badania naprawdę się psują. Te trzy przykłady prowadzą rzeczywisty schemat od określenia populacji aż do zdania, które możesz opublikować.
Przykład 1: doświadczenia pacjentów w całym powiecie
- Populacja. Dorośli, którzy byli na wizycie ambulatoryjnej w którejkolwiek z 46 publicznych przychodni w powiecie między 1 kwietnia a 30 czerwca.
- Operat. Nie istnieje rejestr pacjentów obejmujący cały powiat. Istnieje lista 46 przychodni z miesięczną liczbą wizyt.
- Metoda. Dobór wielostopniowy. Wylosuj 18 przychodni z prawdopodobieństwem proporcjonalnym do liczby wizyt, a następnie systematycznie wybieraj co 8. wychodzącego pacjenta w dwa losowo wybrane dni przyjęć.
- Dlaczego nie coś prostszego. Pełna lista pacjentów pozwoliłaby na dobór warstwowy, ale nie istnieje i nie da się jej zbudować w dostępnym czasie. Próba wygodna w trzech największych przychodniach byłaby szybsza i opisywałaby trzy największe przychodnie.
- Co trzeba podać. Prawdopodobieństwa wyboru różnią się w zależności od wielkości przychodni, więc analiza wymaga wag, a przedział trzeba poszerzyć o efekt schematu losowania.
- Zdanie do publikacji. „Wśród dorosłych korzystających z publicznych przychodni ambulatoryjnych w powiecie w drugim kwartale szacunkowo 71% oceniło czas oczekiwania jako akceptowalny; oszacowanie oparto na 1240 wywiadach z pacjentami wychodzącymi z wizyty w 18 przychodniach wylosowanych z prawdopodobieństwem proporcjonalnym do liczby wizyt”.
Przykład 2: badanie do pracy dyplomowej na populacji studentów
- Populacja. Studenci zapisani na Wydział Handlu w bieżącym roku akademickim: 3100 osób na trzech latach studiów.
- Operat. Rejestr studentów wydziału, zawierający rok i kierunek studiów.
- Metoda. Warstwowy dobór losowy według roku studiów, alokacja proporcjonalna, cel: 350 wypełnień.
- Obliczenia. Pierwszy rok liczy 1300 studentów, czyli 42% z 3100, więc otrzymuje 42% z 350, czyli 147 wypełnień. Powtórz to dla każdego roku. Ponieważ alokacja jest proporcjonalna, ważenie nie jest potrzebne.
- Planowanie odpowiedzi. Przy oczekiwanym wskaźniku odpowiedzi 35% musisz zaprosić około 1000 studentów, aby uzyskać 350 wypełnień, a zaproszenia należy wysyłać warstwa po warstwie, aby słaby odzew na jednym roku był widoczny, póki jest jeszcze czas na reakcję.
- Ograniczenia do opisania. Studenci, którzy zrezygnowali, ale nadal są w rejestrze, to nadmierne pokrycie. Studenci zapisani po pobraniu rejestru to niepełne pokrycie. Oba przypadki należą do akapitu o ograniczeniach.
Przykład 3: opinie klientów sklepu internetowego
- Populacja. Klienci, którzy złożyli zamówienie w ciągu ostatnich 90 dni.
- Operat. Tabela zamówień. Jest kompletna dla zamówień online i kompletna dla zakupów bez rejestracji, ale klient z dwoma kontami pojawia się w niej dwa razy.
- Metoda. Usuń duplikaty, zostawiając jeden wiersz na klienta, a następnie zastosuj dobór systematyczny co 12. klienta po losowym starcie, prowadzony w sposób ciągły, a nie jednorazowo.
- Pułapka, której to pozwala uniknąć. Zapraszanie wyłącznie subskrybentów newslettera jest szybsze i daje próbę wygodną najbardziej zaangażowanych klientów. Sprawi, że zadowolenie będzie wyglądać lepiej, niż jest naprawdę, niezawodnie, w każdym kwartale.
- Uwaga o pracownikach. Ta sama organizacja, badając swoich 180 pracowników, w ogóle nie powinna dobierać próby. Ta populacja jest mała, osiągalna, a każdy ma prawo zostać zapytany. Przeprowadź badanie pełne, a jeśli udział jest niski, potraktuj to jako ustalenie, a nie problem doboru próby.
Jak napisać część metodologii poświęconą doborowi próby
To krok, który większość poradników pomija, a to właśnie go czyta promotor, recenzent lub klient. Opis doboru próby musi po kolei odpowiedzieć na pięć pytań: kto, z jakiej listy, jak wybrany, ilu i co w związku z tym wolno Ci twierdzić.
Uzupełnij luki poniżej. Wzór jest celowo prosty: egzaminatorzy nie szukają tu eleganckiej prozy, tylko schematu, który mogą ocenić.
To samo badanie opisane słabo i opisane dobrze
Słabo. „Pobrano losową próbę studentów i zebrano 350 wypełnień”.
Niczego tu nie da się sprawdzić. Słowo „losowa” wykonuje pracę, na którą nie zasłużyło, nie ma operatu, mianownika ani informacji o tym, kogo wykluczono.
Dobrze. „Populację docelową stanowiło 3100 studentów zapisanych na Wydział Handlu w 2026 roku. Operatem losowania był rejestr studentów wydziału pobrany 3 marca 2026 roku. Zastosowano warstwowy dobór losowy według roku studiów z alokacją proporcjonalną, aby każdy rok można było raportować osobno. Zaproszono tysiąc studentów, a 350 wypełniło kwestionariusz, co daje wskaźnik odpowiedzi 35%. Nie zastosowano ważenia, ponieważ alokacja była proporcjonalna. Studenci, którzy zrezygnowali po dacie pobrania rejestru, pozostali w operacie i nie można ich było zidentyfikować, co stanowi niewielkie źródło nadmiernego pokrycia”.
Druga wersja jest dłuższa, a każde dodatkowe zdanie to zdanie, o które recenzent nie musi już pytać.
„Uczestników zrekrutowano za pomocą komunikatu w aplikacji wyświetlanego aktywnym użytkownikom przez dwa tygodnie. Jest to próba wygodna, więc wyniki opisują osoby, które odpowiedziały, i nie można ich uogólnić na wszystkich użytkowników; nie podano też miary precyzji. Uczestnicy częściej niż ogół użytkowników byli użytkownikami codziennymi, co należy uwzględnić przy odczytywaniu wyników”. Napisz tak, a nikt nie zarzuci Ci przesadnych twierdzeń. Bo ich nie było.
Lista kontrolna planu doboru próby
Spisany plan doboru próby zapobiega większości błędów, których da się uniknąć, bo wymusza podjęcie decyzji przed badaniem terenowym, a nie w trakcie analizy. Osiem punktów, jedna strona.
- 1. Cel badania. Jaką decyzję to wspiera i co dokładnie zostanie podane w wynikach?
- 2. Populacja docelowa. Kto wchodzi w zakres, a kto nie, łącznie z przedziałem czasowym.
- 3. Operat losowania. Źródło, data pobrania, liczba wierszy, znane luki i zasada usuwania duplikatów.
- 4. Metoda i uzasadnienie. Która z dziewięciu i dlaczego właśnie ta, biorąc pod uwagę operat i twierdzenie.
- 5. Cele liczbowe. Liczba wypełnień ogółem i w każdej podgrupie oraz oczekiwany wskaźnik odpowiedzi, na którym opierasz plan.
- 6. Plan rekrutacji. Tryby kontaktu, harmonogram przypomnień, dostosowanie językowe i dostępność, zasady przyznawania zachęt.
- 7. Monitorowanie. Co będziesz obserwować podczas badania terenowego: odpowiedzi według warstw, moment rezygnacji, braki odpowiedzi na poszczególne pytania.
- 8. Uwagi do analizy. Planowane ważenie, korekta o efekt schematu losowania i ograniczenia, które ujawnisz niezależnie od wyników.
Gdy plan jest ustalony, to narzędzie badawcze decyduje o tym, czy warto było losować próbę. Idealna próba nie uratuje pytania sugerującego ani pytania o dwie rzeczy naraz, dlatego zanim cokolwiek uruchomisz, warto przejrzeć przykładowe pytania do ankiety.
Najczęściej zadawane pytania
Czym jest dobór próby w badaniach?
Dobór próby to proces wybierania podzbioru populacji, nazywanego próbą, i badania tego podzbioru w celu wyciągnięcia wniosków o całej populacji. Stosuje się go, bo zmierzenie każdego członka populacji jest zwykle zbyt powolne, zbyt kosztowne lub niemożliwe. Metoda wyboru próby decyduje o tym, jakie wnioski mogą uzasadnić wyniki.
Czym różni się populacja od próby?
Populacja to cała grupa, którą chcesz opisać. Próba to mniejszy podzbiór, który faktycznie mierzysz. Dobór próby to proces, który prowadzi od jednego do drugiego, a badanie pełne to alternatywa, w której mierzysz całą populację.
Czym jest operat losowania?
Operat losowania to konkretna lista lub mechanizm, z którego losujesz próbę: rejestr studentów, rejestr pacjentów, baza klientów, spis gospodarstw domowych, rejestr wyborców. Ma większe znaczenie niż nazwa metody, bo każdy, kogo brakuje w operacie, ma zerową szansę na wybór, niezależnie od tego, jak dobra jest Twoja technika doboru próby.
Która metoda doboru próby nie wymaga operatu losowania?
Dobór wygodny, kwotowy, celowy i metodą kuli śnieżnej w ogóle nie wymagają listy. Dobór grupowy i wielostopniowy wymagają jedynie listy grup, takich jak szkoły, przychodnie czy wsie, a nie listy osób. Prosty dobór losowy, dobór systematyczny i dobór warstwowy wymagają pełnej listy osób, zanim w ogóle zaczniesz.
Czym różni się dobór probabilistyczny od nieprobabilistycznego?
W doborze probabilistycznym wyboru dokonuje mechanizm losowy, więc każda jednostka ma znane, niezerowe prawdopodobieństwo wyboru, a Ty możesz obliczyć, jak niepewne są Twoje oszacowania. W doborze nieprobabilistycznym te prawdopodobieństwa są nieznane, bo wybór zależy od dostępności, kwot lub oceny badacza. Praktyczna konsekwencja jest taka, że tylko schemat probabilistyczny pozwala podać określoną precyzję oszacowania dla populacji.
Czym różni się dobór warstwowy od grupowego?
Dobór warstwowy dzieli populację na grupy i losuje próbę z każdej grupy, co zwiększa precyzję i gwarantuje obecność każdej grupy. Dobór grupowy losuje niektóre grupy, a następnie bada wszystkich w wylosowanych grupach, co obniża koszty, gdy nie istnieje lista osób. W skrócie: dobór warstwowy obejmuje wszystkie grupy i niektórych ludzi, a grupowy niektóre grupy i wszystkich ludzi.
Czym jest jednostka losowania pierwszego stopnia?
Jednostka losowania pierwszego stopnia to to, co zostaje wybrane na pierwszym etapie schematu wielostopniowego. W krajowym badaniu gospodarstw domowych jest to zwykle obszar, taki jak okręg, wieś lub obwód spisowy. Na drugim etapie losuje się w nim gospodarstwa domowe. Wskazanie jednostki losowania pierwszego stopnia to standardowy wymóg przy opisie schematu grupowego, bo wynikające z niego grupowanie musi zostać uwzględnione w analizie.
Czym jest warstwowy dobór losowy?
Warstwowy dobór losowy dzieli populację na rozłączne grupy zwane warstwami, a następnie niezależnie losuje próbę w każdej warstwie. Alokacja proporcjonalna daje każdej warstwie udział w próbie odpowiadający jej udziałowi w populacji i nie wymaga ważenia. Alokacja nieproporcjonalna celowo nadreprezentuje małe, ale ważne warstwy, a potem wymaga ważenia, zanim zostanie podana jakakolwiek liczba ogólna.
Czy dobór metodą kuli śnieżnej sprawdza się w badaniach naukowych?
Tak, gdy populacja jest ukryta, rzadka lub niezarejestrowana i nie da się zbudować operatu losowania. To uznane podejście w badaniach grup trudno dostępnych. Nie pozwala jednak na oszacowanie dla populacji, a jego główną słabością jest to, że uczestnicy polecają osoby podobne do siebie, więc próba dryfuje w stronę jednej sieci społecznej. Rozpoczęcie od kilku niepowiązanych ze sobą osób startowych zmniejsza ten dryf i powinno zostać opisane w Twojej metodologii.
Czy losowy dobór próby to to samo co losowy przydział?
Nie. Losowy dobór próby to sposób wybierania uczestników z populacji i decyduje o tym, na kogo można uogólnić Twoje wyniki. Losowy przydział to sposób przydzielania wybranych uczestników do warunków eksperymentu i decyduje o tym, czy zaobserwowany efekt można przypisać oddziaływaniu. Badanie może stosować jedno bez drugiego, a większość eksperymentów stosuje losowy przydział bez losowego doboru próby.
Czy mogę zastosować dobór nieprobabilistyczny w badaniu ilościowym?
Tak, i robi tak wiele opublikowanych badań ilościowych. Zmienia się to, co wolno Ci twierdzić. Możesz podawać liczebności, odsetki i zależności w obrębie próby oraz porównywać grupy w jej ramach. Nie możesz przedstawiać tych odsetków jako oszacowań dla populacji z określoną precyzją. Podaj metodę, opisz rekrutację, porównaj uczestników ze znanym punktem odniesienia, jeśli taki istnieje, i wprost opisz ograniczenie, zamiast liczyć na to, że nikt nie zapyta.
Czym różni się dobór próby od rozkładu z próby?
Dobór próby to procedura wybierania próby. Rozkład z próby to inne pojęcie. Wyobraź sobie, że wielokrotnie powtarzasz tę samą procedurę doboru próby. Rozrzut otrzymywanej statystyki, takiej jak średnia lub odsetek, we wszystkich tych wyobrażonych próbach to rozkład z próby. To on umożliwia wyznaczanie przedziałów ufności, a zachowuje się przewidywalnie tylko wtedy, gdy próbę wylosowano metodą probabilistyczną.
Skąd mam wiedzieć, czy moja próba jest obciążona?
Porównaj uzyskaną próbę ze znanym punktem odniesienia, takim jak lista pracowników, ewidencja studentów czy dane administracyjne, pod względem zmiennych związanych z tym, co mierzysz. Duże różnice wskazują na problemy z pokryciem, problemy z wyborem lub zróżnicowany brak odpowiedzi. Porównaj też kanały rekrutacji i kolejne fale przypomnień. Pamiętaj, że dobry wskaźnik odpowiedzi to słaby dowód niskiego obciążenia: w 235 opublikowanych oszacowaniach wskaźnik odpowiedzi wyjaśniał tylko około 11% zmienności błędu braku odpowiedzi.
Powiązane artykuły
Dobór próby to jedna decyzja w ramach większego badania. Te przewodniki omawiają decyzje przed nią i po niej.
- Projekt badania ankietowego pokazuje, gdzie dobór próby mieści się wśród pozostałych etapów badania, od zdefiniowania populacji po uruchomienie.
- Jak ustalić wielkość próby omawia obliczenia precyzji, które ta strona celowo pomija, łącznie ze wzorami.
- Jak pisać pytania do ankiety omawia stronę pomiarową, której żaden schemat doboru próby nie uratuje.
- Zasady budowy kwestionariusza pokazują, jak złożyć całe narzędzie, gdy pytania są już gotowe.
- Zniekształcenie odpowiedzi dokładniej omawia różnicę między osobami wybranymi a osobami, które odpowiedziały.
- Pytania demograficzne w ankiecie przydadzą się, gdy w Twoim operacie brakuje zmiennej potrzebnej do warstwowania.
- Istotność statystyczna pokazuje, co zrobić z liczbami, gdy próba jest już zebrana.
- Ilościowa analiza danych omawia kolejne kroki analizy, w tym miejsce na wagi.
Jak powstał ten przewodnik i czego nie obejmuje
Kto go napisał. Michael Hodge, który zajmuje się metodologią badań ankietowych, konstruowaniem pytań i jakością danych w SuperSurvey oraz pisze praktyczne przewodniki w naszym dziale „Poradniki i pomoc”.
Na czym się opiera. Definicje są zgodne z przeglądem metodologicznym i wytycznymi uczelnianymi cytowanymi poniżej, bo to tam faktycznie definiuje się pojęcia techniczne. Oficjalne strony dotyczące rzetelności badań i urzędów statystycznych podajemy jako krótkie, przystępne punkty wyjścia, a nie jako źródło tych definicji. Opisy metod opierają się na tych samych przeglądach i wytycznych. Każda liczba w części z dowodami pochodzi z wymienionego poniżej źródła pierwotnego. Każde twierdzenie ma też ocenę wiarygodności, więc widać, które ustalenia są pewne, a które opierają się na jednym badaniu. Wartości efektu schematu losowania na wykresie i w tabeli to nasze własne obliczenia. Użyliśmy standardowego wzoru, a założenia podaliśmy w podpisie, więc możesz je przeliczyć lub zakwestionować na podstawie wielkości własnych grup.
Czego nie obejmuje. Ten przewodnik dotyczy doboru próby w ankietach i badaniach obserwacyjnych. Nie omawia projektowania eksperymentów ani losowego przydziału poza ich odróżnieniem. Pomija też dobór próby w kontroli odbiorczej, audycie i przetwarzaniu sygnałów, gdzie to samo słowo oznacza co innego. Dobór sterowany przez respondentów, dobór czasowo-lokalizacyjny i adaptacyjny dobór grupowy to rzeczywiste metody stosowane przez specjalistów w badaniach populacji ukrytych, ale wykraczają poza zakres tej strony. Wartości korelacji wewnątrzklasowej pochodzą z badań gospodarstw domowych w krajach o niskim i średnim dochodzie. Traktuj je jako ilustrację, a nie wartości do przeniesienia w inne warunki.
Gdzie liczby są najsłabsze. Ponowna analiza Literary Digest opiera się na jednym badaniu z 1937 roku i jednej późniejszej ponownej analizie, a obaj autorzy sami sygnalizują swoją niepewność; dlatego ma ocenę B. Dane o błędach sondaży pochodzą z sondaży wyborczych w Stanach Zjednoczonych, które są wyjątkowo dobrze zbadane, ale niekoniecznie reprezentatywne dla błędów ankiet w ogóle.
Ujawnienie. SuperSurvey sprzedaje oprogramowanie do ankiet. Nic na tej stronie nie jest na sprzedaż, żadna jej część nie wymaga rejestracji, a żadna organizacja nie sponsorowała ani nie recenzowała tego przewodnika. Jeśli linkujemy do naszych własnych stron, to dlatego, że omawiają kolejną decyzję, a nie dlatego, że link coś nam przynosi.
Bibliografia
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., i Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- Rząd Wielkiej Brytanii (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., i Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., i Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences i ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., i Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., i Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., i Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., i Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, s. 9 i 15. Dane pochodzą z wydania z 2025 roku; GSMA opublikowała później wydanie z 2026 roku, w którym luka jest mniejsza.
- Brubaker, J., Kilic, T., i Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., i in. (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., i Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., i Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, s. 9 i tabela 1.2.
- Kalton, G., Brick, J. M., i Le, T. (2005). Estimating components of design effects for use in sample design. W: Household Sample Surveys in Developing and Transition Countries, rozdział VI. United Nations, Series F No. 96.