
Kort svar
Att göra ett urval innebär att välja ut en delmängd av en population, det så kallade urvalet, och att studera den delmängden för att dra slutsatser om hela populationen. Forskare gör urval eftersom det oftast tar för lång tid, kostar för mycket eller helt enkelt är omöjligt att mäta alla. Populationen är den grupp du vill beskriva, urvalet är den del av den som du faktiskt mäter, och urvalsramen är den lista du drar urvalet från.
Sannolikhetsurval väljer ut personer med hjälp av en slumpmekanism, så att varje enhet har en känd sannolikhet större än noll att bli vald. Det är det som gör att du kan sätta en siffra på din osäkerhet.
Icke-sannolikhetsurval väljer ut efter bekvämlighet, kvoter eller bedömning. Det är ofta snabbare och billigare, och ibland det enda etiskt försvarbara alternativet, men det kan inte ligga till grund för en populationsskattning med en angiven precision.
Gå direkt till de 9 metoderna jämförda | hur du väljer en | testa dig själv | hur du redovisar det
Det viktigaste i korthet
- Urval innebär att du studerar en delmängd: du mäter ett urval för att lära dig något om en population när det inte går att mäta alla.
- Få fem begrepp rätt först: population, urvalsram, urvalsenhet, urvalsdesign och glappet mellan den population du vill nå och den du faktiskt kan nå. De flesta diskussioner om urval handlar egentligen om något av dessa.
- Bara sannolikhetsmetoder låter dig sätta en siffra på din osäkerhet. Bekvämlighetsurval, kvoturval, strategiska urval och snöbollsurval kan vara användbara och ärliga, men de kan inte ligga till grund för en populationsskattning med en angiven precision.
- Din urvalsram sätter taket: om en grupp inte kan finnas med på listan du drar från, kommer ingen metod och ingen mängd extra svar att föra in den i dina resultat.
- Representativitet är en kedja, inte en etikett: urvalsram, sedan urvalsdragning, sedan rekrytering, sedan svar, sedan analys. En slumpmässig dragning är en länk av fem.
Definition av urval (och de 5 begrepp du måste få rätt)
Urval är processen att välja ut en mindre grupp (ett urval) ur en större grupp (en population) så att du kan lära dig något om populationen utan att mäta alla. En studie av hela populationen är ofta opraktisk, så forskare gör urval för att arbetet ska bli genomförbart och ändå ge användbara slutsatser.
De fem begreppen nedan gör det mesta av jobbet i ett metodkapitel. Blir de fel ärver varje senare beslut misstaget.
- Population: hela den grupp du vill beskriva, angiven med avgränsningar och en tidsperiod. ”Alla sistaårsstudenter på sjuksköterskeprogrammet vid de tre campusen, inskrivna per den 1 mars” är en population. ”Sjuksköterskor” är det inte.
- Målpopulation kontra tillgänglig population: vilka du vill beskriva, kontra vilka din rekrytering och dina verktyg faktiskt kan nå. Att sätta ord på glappet mellan de två är en styrka i en rapport, inte en svaghet.
- Urvalsram: listan eller mekanismen du drar från. Ett studentregister, ett patientregister, en kunddatabas, en förteckning över hushållen i en by, en röstlängd. Problem med urvalsramen ger täckningsfel, och ingen metod reparerar dem.
- Urvalsenhet: det som faktiskt väljs ut. En person, ett hushåll, en vårdcentral, en klass, ett arbetspass, en beställning. I kluster- och flerstegsdesigner är enheten i första steget en grupp, och den gruppen kallas den primära urvalsenheten.
- Urvalsdesign: hela planen nedskriven. Urvalsram, metod, hur många enheter, hur de kontaktas och vad du gör åt dem som inte svarar. ”Urvalsdesign” är det en examinator eller granskare faktiskt efterfrågar när de frågar om ditt urval.
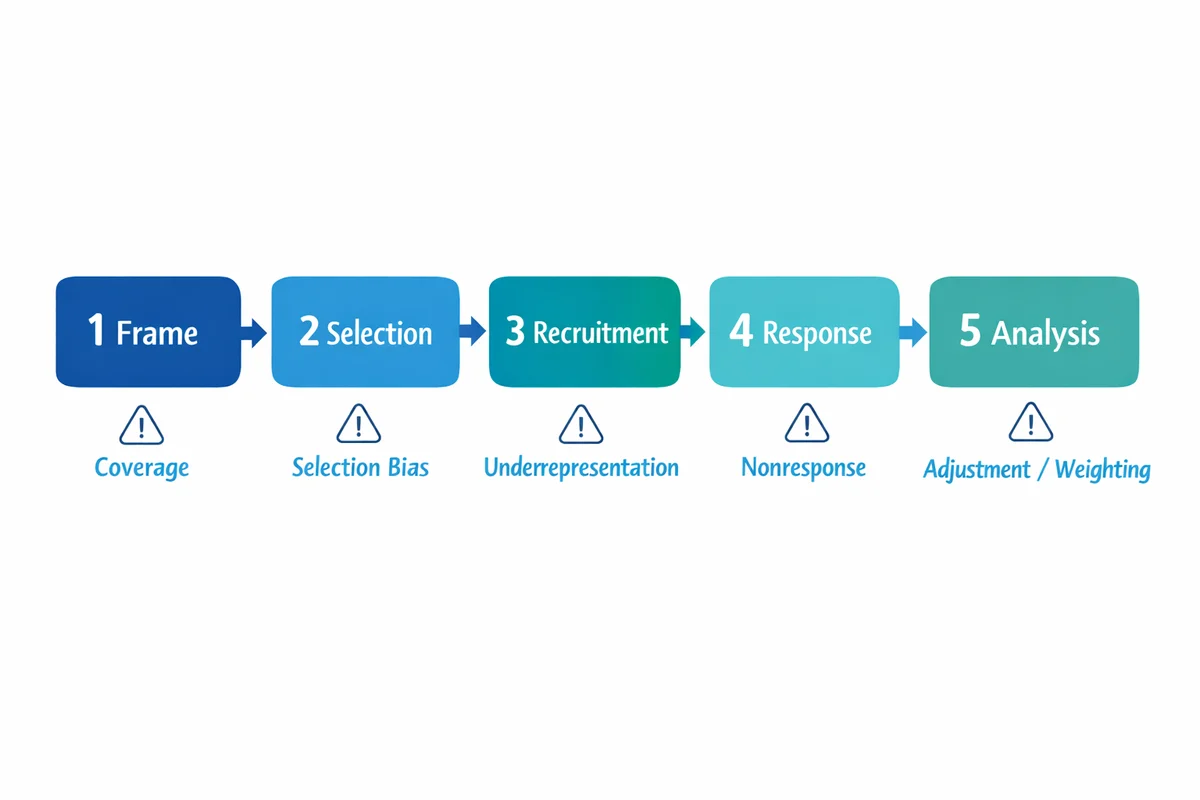
Du kan göra en slumpmässig urvalsdragning helt enligt läroboken och ändå sluta med ett snedvridet urval. Om din urvalsram missar ett segment kunde de aldrig dras. Om ett segment inte svarar faller de bort efter att ha dragits. Se urvalet som en kedja: urvalsram, sedan urvalsdragning, sedan rekrytering, sedan svar, sedan analys.
En kort officiell definition av samma idé finns i U.S. Office of Research Integritys utbildningsmaterial om urval.1 Om du placerar urvalet i en större studieplan går vår guide om forskningsdesign för enkätundersökningar igenom stegen före och efter.
Varför göra ett urval över huvud taget, och när en totalundersökning är bättre
Behovet av urval är praktiskt innan det är statistiskt. Fyra skäl dyker upp gång på gång.
Kostnad
Varje extra deltagare kostar pengar, arbetstid eller välvilja. Ett väldraget urval på 600 kan besvara samma fråga som ett dåligt genomfört försök med 60 000.
Snabbhet
Beslut har tidsgränser. Ett urval ger dig ett svar inom det tidsfönster där svaret fortfarande är användbart.
Genomförbarhet
Vissa populationer går inte att räkna upp alls: förbipasserande på en marknad, personer som har lämnat en tjänst, informella handlare. Andra är i praktiken oändliga, eller så förstörs en enhet när den mäts.
Kvalitet
Den här överraskar många. Om du koncentrerar insatsen på en mindre grupp kan du jaga dem som inte svarar, utbilda intervjuarna ordentligt och kontrollera data. Insats per enhet är oftast värd mer än fler enheter.
En totalundersökning mäter i stället alla. Den är det bättre valet när populationen är tillräckligt liten för att nå, när kontaktuppgifter redan finns eller när varje medlem har rätt att bli tillfrågad. En medarbetarenkät i en organisation med 200 personer är en fråga om totalundersökning, inte om urval. Detsamma gäller en kursutvärdering. När populationen är liten vinner du nästan ingenting på ett urval, och det kostar dig möjligheten att redovisa per team.
Hur ett bra urval faktiskt ser ut
Läroböcker beskriver ett bra urval som ”representativt”, vilket inte är ett praktiskt test. Det är däremot de här fyra egenskaperna.
- Täckning: alla i målpopulationen hade i princip kunnat väljas ut.
- Styrd urvalsdragning: vilka som hamnar i urvalet avgörs av en regel, inte av vem som anmäler sig frivilligt eller står närmast dörren.
- Tillräckligt många enheter i den minsta grupp du måste redovisa: en total siffra kan se sund ut medan den grupp du egentligen bryr dig om vilar på 11 svar.
- Beskrivbart: du kan skriva ner exakt hur det drogs, och någon annan skulle kunna upprepa det.
| Om ditt mål är att | Konsekvens för urvalet | Vanlig fälla |
|---|---|---|
| Skatta en andel i populationen | Använd en sannolikhetsmetod, följ upp vilka som svarar och redovisa precisionen tillsammans med siffran. | Att behandla ett bekvämlighetsurval som om det beskrev populationen. |
| Jämföra undergrupper | Planera antalet svar per undergrupp, oftast genom att stratifiera och dra ett större urval ur små grupper. | Att redovisa en undergrupp vars resultat vilar på en handfull personer. |
| Utforska erfarenheter och mekanismer | Strategiskt eller teoretiskt urval är lämpligt. Motivera vilka perspektiv som täcks in och vilka som inte gör det. | Att jaga ett numeriskt minimum utan någon motivering för det. |
| Testa en intervention | Urvalet styr vilka resultatet kan generaliseras till. Slumpmässig fördelning styr om effekten är verklig. | Att blanda ihop slumpmässig fördelning med slumpmässigt urval. Det är olika operationer. |
För en lättbegriplig redogörelse för hur urval kan bära skattningar för en population är U.S. Census Bureaus översikt över urval och inferens i enkätundersökningar en bra utgångspunkt.2
Din urvalsram sätter taket
En urvalsram är den konkreta lista eller mekanism du drar från. Den är den minst diskuterade delen av urvalet och stället där de flesta verkliga studier i det tysta går fel, eftersom urvalsramen avgör vilka som ens kunde väljas ut.
Urvalsramar är vardagliga saker. Ett studentregister, ett patientregister, en personalförteckning, en kunddatabas. En lista över byar med antal hushåll, en röstlängd, en serie beställningar, en lista över vårdcentraler i ett distrikt. Lägg märke till att vissa urvalsramar listar personer och andra listar platser. Den skillnaden avgör vilka metoder som står öppna för dig.
| Problem | Hur det ser ut | Vad det gör med dina resultat |
|---|---|---|
| Undertäckning | Personer i populationen saknas på listan: personal utan e-post i jobbet, kunder som handlat i butik, hushåll utan registrerad adress. | Hela segment har noll chans att väljas ut. Fler svar kan inte rätta till det, eftersom de som saknas aldrig kunde väljas. |
| Övertäckning | Listan innehåller enheter utanför din population: tidigare studenter, avslutade konton, personer som har flyttat. | Du slösar insats och, om du inte sållar bort dem, mäter du fel population. |
| Dubbletter | Samma person förekommer mer än en gång: två e-postadresser, två kontonummer. | De personerna får större chans att väljas ut än alla andra, vilket i det tysta bryter antagandet om lika chans. |
| Inaktuell lista | Listan var korrekt när den byggdes, men är det inte nu. | Adresser som studsar ser ut som vägran, så både din svarsfrekvens och din analys av snedvridningen blir fel. |
Granska urvalsramen innan du drar, inte efteråt. Räkna raderna. Jämför antalet med en oberoende totalsiffra om du kan hitta en, till exempel personalavdelningens antal anställda eller antalet inskrivna. Leta efter det segment du skulle skämmas mest över att ha missat, och kontrollera att det finns med. Ta bort dubbletter. Skriv ner vad urvalsramen utesluter, eftersom den meningen hör hemma bland dina begränsningar oavsett.
Bekvämlighetsurval, kvoturval, strategiskt urval och snöbollsurval behöver ingen lista alls. Klusterurval och flerstegsurval behöver bara en lista över grupper (skolor, vårdcentraler, avdelningar, byar), inte en lista över personer. Obundet slumpmässigt urval, systematiskt urval och stratifierat urval behöver alla en fullständig lista över individer innan du kan börja. Om du inte har någon lista och inte kan bygga en, utesluter den enda omständigheten tre av de nio metoderna på den här sidan. Det är oftast det första som behöver avgöras.
De 9 urvalsmetoderna jämförda
Urvalsmetoder delas in i två familjer. Sannolikhetsurval använder en slumpmekanism, så varje enhet i urvalsramen har en känd sannolikhet större än noll att väljas ut. Icke-sannolikhetsurval gör det inte, så urvalssannolikheterna är okända. Allt annat följer av den enda skillnaden.
Den andra kolumnen är den som de flesta guider utelämnar, så här kommer den först. Bara en sannolikhetsdesign kan bära en felmarginal, ett konfidensintervall eller meningen ”plus/minus 5 procentenheter”. Om en metod får ett nej där kan du ändå lära dig mycket av den. Du kan bara inte publicera ett precisionsmått tillsammans med resultatet. Själva precisionen hör till en annan diskussion, som tas upp i vår guide om urvalsstorlek.
| Metod | Går det att ange felmarginal? | Hur den fungerar | Rätt val när | Vad den kostar och vilken snedvridning den bjuder in till |
|---|---|---|---|---|
| Obundet slumpmässigt urval Sannolikhetsurval Kräver en fullständig lista |
Ja | Varje enhet på listan har samma chans. Du drar det antal du behöver slumpmässigt. | Du har en enda ren lista utan dubbletter och ingen undergrupp som du är skyldig att redovisa separat. | KostnadDu måste ha hela listan, och små grupper kan bli för små att redovisa.SnedvridningMycket lite vid urvalsdragningen. All återstående risk flyttas till vilka som faktiskt svarar. |
| Systematiskt urval Sannolikhetsurval Kräver en fullständig lista |
Ja, om listans ordning inte har något samband med utfallet | Sortera listan, välj en slumpmässig startpunkt och ta sedan var k:te post. | Listan är lång eller kommer som ett flöde, och ett fältteam behöver en enkel regel att följa. | KostnadNästan ingenting, så länge ordningen inte har något att göra med det du mäter.SnedvridningPeriodicitet. Om listan upprepar sig i en cykel som sammanfaller med ditt intervall, träffar du hela tiden samma sorts enhet. |
| Stratifierat urval Sannolikhetsurval Kräver en fullständig lista |
Ja, och oftast snävare än vid obundet slumpmässigt urval | Dela upp listan i grupper (strata) som spelar roll och dra sedan ett urval inom varje grupp. | Du måste redovisa per region, fakultet, avdelning eller åldersgrupp, eller så räknar du med att svarsbenägenheten skiljer sig kraftigt mellan grupperna. | KostnadGrupperingsvariabeln måste finnas på listan innan du drar, och olika urvalsandelar måste viktas i analysen.SnedvridningLåg. Den verkliga risken är att välja strata som inte har något med utfallet att göra, vilket ger mer arbete men ingen precision. |
| Klusterurval Sannolikhetsurval Kräver en lista över grupper |
Ja, breddad för designeffekten | Välj slumpmässigt ut hela grupper (skolor, vårdcentraler, avdelningar, byar) och undersök sedan alla inom de utvalda grupperna. | Du kan inte lista individer men du kan lista platserna där de finns, och kostnader för resor eller uppstart dominerar budgeten. | KostnadPrecision. Personer inom en grupp liknar varandra, så varje extra svar tillför mindre ny information.SnedvridningLåg om grupperna väljs slumpmässigt, men ett litet antal grupper gör resultatet instabilt och svårt att försvara. |
| Flerstegsurval Sannolikhetsurval Kräver en lista över grupper |
Ja, med vikter och en designeffekt | Dra först ett urval av grupper och dra sedan ett urval av enheter inom de utvalda grupperna, i två eller fler steg. | Studier av ett helt distrikt eller ett helt land där det inte finns någon samlad lista över personer, men väl över administrativa enheter. | KostnadKomplexitet. Urvalssannolikheterna skiljer sig mellan enheterna, så analysen kräver vikter och någon som kan tillämpa dem.SnedvridningLåg i princip. I praktiken är varje steg ett nytt tillfälle för fältteamet att glida ifrån planen. |
| Bekvämlighetsurval Icke-sannolikhetsurval Ingen lista behövs |
Nej | Du tar de som är lättast att nå: en popup på en webbplats, en klass du undervisar, personer som går förbi ett stånd. Kallas också tillgänglighetsurval. | Du utforskar, gör en pilotstudie av ett frågeformulär eller behöver en riktning den här veckan snarare än en försvarbar siffra nästa kvartal. | KostnadPåståendet. Du ger upp möjligheten att säga något om populationen.SnedvridningSjälvselektion. Det överrepresenterar de nåbara, de tillgängliga och de redan engagerade. |
| Kvoturval Icke-sannolikhetsurval Ingen lista behövs |
Nej. Det ser balanserat ut utan att vara slumpmässigt | Sätt mål för grupper, till exempel 50 kvinnor och 50 män, eller 40 på landsbygden och 60 i städer, och rekrytera sedan tills varje mål är uppfyllt. | Du behöver snabbt ett urval som åtminstone motsvarar populationen i synliga egenskaper, utan någon lista att dra från. | KostnadKontrollen över vilka som fyller varje kvot. Rekryterarna väljer fortfarande, och de väljer de lättillgängliga.SnedvridningSelektionsbias inom kvoterna. Att matcha på ålder och kön gör inte personerna typiska i sina attityder. |
| Strategiskt urval Icke-sannolikhetsurval Ingen lista behövs |
Nej, och det försöker inte heller | Du väljer medvetet ut fall som uppfyller angivna kriterier: experter, extremfall, typiska fall, kritiska fall. Kallas också bedömningsurval. | Kvalitativt arbete, expertintervjuer, fallstudier och alla frågor där djup betyder mer än att räkna. | KostnadIngenting, förutsatt att du är tydlig med att du aldrig räknade.SnedvridningForskarens egen bild av vem som räknas som relevant. |
| Snöbollsurval Icke-sannolikhetsurval Ingen lista behövs |
Nej | Rekrytera några deltagare och be sedan var och en av dem att hänvisa till andra som uppfyller kriterierna. | Gruppen är dold, stigmatiserad, sällsynt eller oregistrerad: migrantarbetare, personer som har lämnat en tjänst, informella handlare, personer med en sällsynt sjukdom. | KostnadTid, och kontrollen över urvalets sammansättning. Du ärver det sociala nätverket hos dem du började med.SnedvridningHomofili. Människor hänvisar till människor som liknar dem själva, så ett hörn av populationen blir överrepresenterat. |
Så läser du tabellen: de fem första metoderna är sannolikhetsdesigner och de fyra sista är det inte. Det är den enda uppdelningen, inte de enskilda metodnamnen, som avgör om ett precisionsmått är ärligt.
Sannolikhetsurval, metod för metod
Sannolikhetsurval innebär att varje enhet i urvalsramen har en känd sannolikhet större än noll att väljas ut, och att en slumpmekanism gör urvalet. Det är hela grunden för att kunna säga något numeriskt om populationen. Fem designer täcker nästan varje verklig studie. Översikter inom klinisk forskning och hälsoforskning tar upp samma familj under något andra namn, och det är värt att veta varför innan du stöter på båda: var och en av de två som citeras här räknar flerstegsurval som en form av klusterurval i stället för att lista det separat.34
Obundet slumpmässigt urval
Obundet slumpmässigt urval ger varje enhet på listan exakt samma chans att väljas ut. Du numrerar listan, genererar slumptal och tar de enheter de hamnar på.
Räknat exempel. Ett universitets register omfattar 12 000 inskrivna studenter och du behöver 400 svar. Numrera registret från 1 till 12 000, generera 400 unika slumptal i det intervallet med ett kalkylark eller ett statistikprogram och bjud in de studenterna. Om du räknar med en svarsfrekvens på 40 procent drar du och bjuder in 1 000, så att 400 fullständiga svar är realistiskt.
Där metoden brister. Med 400 svar fördelade över ett register på 12 000 studenter bidrar en institution med 300 studenter med ungefär 10 personer. Det räcker inte för att redovisa. Om någon undergrupp måste synas i dina resultat är obundet slumpmässigt urval fel verktyg, och stratifierat urval är lösningen.
Dokumentera din slumpning. Programvaran du använde, startvärdet (seed) om det fanns ett, och datumet. Den enda meningen är det som gör dragningen reproducerbar, och granskare frågar faktiskt efter den.
Systematiskt urval
Systematiskt urval tar var k:te enhet från en ordnad lista efter en slumpmässig start. Dela listans storlek med det antal du behöver för att få intervallet k, välj ett slumptal mellan 1 och k som startpunkt och räkna sedan framåt.
Räknat exempel. Ett distriktssjukhus registrerar 9 000 öppenvårdsbesök under ett kvartal och vill göra 600 utgångsintervjuer. Intervallet är 9 000 delat med 600, så k är lika med 15. Välj en slumpmässig start mellan 1 och 15, till exempel 7, och intervjua sedan besök 7, 22, 37, 52 och så vidare. Ett fältteam kan följa den regeln utan en bärbar dator, och det är det verkliga skälet till att metoden lever kvar.
Där metoden brister. Periodicitet. Om listan har en återkommande cykel som sammanfaller med k, drar du samma plats varje gång. En besökslista ordnad efter mottagningsdag med en cykel på 7 dagar och ett intervall på 7 skulle ge dig en enda veckodag och inget annat. Kontrollera ordningen innan du bestämmer k, och blanda om listan om ordningen har samband med det du mäter.
Stratifierat urval
Stratifierat urval delar in populationen i grupper som inte överlappar, så kallade strata, och drar sedan ett slumpmässigt urval inom varje stratum. Det är den mest användbara förbättringen som finns för de flesta studier, eftersom den garanterar att varje grupp du måste redovisa faktiskt finns med.
Räknat exempel med uträkningen visad. En organisation har 4 200 anställda i sex provinser och behöver 600 svar.
- Proportionell fördelning. En provins med 1 400 anställda har 1 400 delat med 4 200, alltså en tredjedel av personalstyrkan, så den får en tredjedel av 600, alltså 200 svar. En provins med 210 anställda får 210 delat med 4 200 gånger 600, alltså 30 svar. Varje provins är representerad i proportion till sin storlek, och ingen viktning behövs i analysen.
- Disproportionell fördelning, även kallad översampling. Trettio svar är för få för att redovisa den lilla provinsen separat. Därför tar du medvetet 80 därifrån i stället och minskar den största provinsen för att kompensera. Nu skiljer sig urvalssannolikheterna mellan provinserna, så du måste vikta tillbaka data till de verkliga proportionerna innan du anger någon siffra för hela organisationen. Att hoppa över det steget är det vanligaste enskilda felet vid stratifierat urval.
Att välja strata. Välj variabler som har samband med utfallet eller med vilka som sannolikt svarar, och som redan finns i din urvalsram. Region, arbetsplats, roll, anställningstid, kurs, abonnemangstyp och åldersgrupp är de vanliga kandidaterna. Strata som inte har något med utfallet att göra ger mer administration men ingen precision. Om grupperingsvariabeln saknas i din urvalsram kan du behöva samla in den i frågeformuläret i stället. Vår guide om demografiska frågor i enkäter visar hur du frågar efter de variablerna utan att tappa deltagare.
Klusterurval
Klusterurval väljer slumpmässigt ut hela, naturligt förekommande grupper och undersöker sedan alla inom de utvalda grupperna. Du behöver en lista över grupperna, inte en lista över personerna, och det är därför metoden finns.
Räknat exempel. Ett distrikt har 180 grundskolor och ingen central lista över elever. Du väljer slumpmässigt ut 24 skolor och undersöker varje elev i årskurs 8 på var och en av dem. Du har gjort 24 skolbesök i stället för 180, och du behövde aldrig ett elevregister för att börja.
Vad du betalar för det. Elever på samma skola liknar varandra mer än de liknar elever i resten av distriktet. Därför tillför varje extra elev på en skola du redan har valt mindre ny information än en oberoende elev skulle göra. Ditt effektiva antal svar är mindre än ditt faktiska antal svar. Den uppblåsningen är designeffekten, och den måste byggas in i planen i stället för att upptäckas i analysen.
Där metoden brister. För få kluster. Sex slumpmässigt valda skolor kan skilja sig kraftigt från varandra, och resultatet svänger beroende på vilka sex du råkade dra. Fler kluster med färre personer i varje är nästan alltid bättre än tvärtom.
Flerstegsurval
Flerstegsurval väljer ut i två eller fler steg: först grupper, sedan enheter inom de utvalda grupperna och ibland ett tredje steg inom dem. Nästan varje nationell hushållsundersökning i världen är uppbyggd så.
Räknat exempel. Välj ut 120 valdistrikt ur den nationella förteckningen över valdistrikt. Inom varje utvalt distrikt listar ett fältteam hushållen på plats och väljer sedan slumpmässigt ut 20 av dem. Inom varje utvalt hushåll väljs en vuxen slumpmässigt i stället för att det överlåts åt den som öppnar dörren. Det är tre steg, och det sista spelar roll: att låta hushållet bestämma vem som svarar återinför exakt den selektionsbias som designen byggdes för att undvika.
Vad du betalar för det. Olika personer får olika urvalssannolikheter, så analysen kräver vikter, och variansberäkningen måste ta hänsyn till klustringen i varje steg. Det här är en riktig design som kräver någon som kan genomföra en viktad analys. Om ingen i projektet kan det, välj en enklare design i stället för ett oviktat flerstegsurval.
Fördjupning: urval med sannolikhet proportionell mot storlek, och varför stora kluster väljs oftare
I skolexemplet hade varje skola samma chans att väljas ut, oavsett om den hade 60 elever eller 900. Det ger en elev på en liten skola mycket större chans att hamna i urvalet än en elev på en stor skola. Analysen måste då korrigera för det.
Urval med sannolikhet proportionell mot storlek åtgärdar detta redan i designen. Varje klusters chans att väljas ut sätts i proportion till hur många enheter det har. En skola med 900 elever har då femton gånger större sannolikhet att dras än en skola med 60 elever. Sedan tar du samma antal elever från varje utvald skola. De två stegen tar ut varandra, och varje elev i distriktet får ungefär samma totala chans att väljas ut. Det är standardmetoden i nationella undersökningar, och den kräver ett storleksmått för varje kluster i urvalsramen innan du drar.
Stratifierat urval kontra klusterurval: skillnaden på en rad
De här två blandas ständigt ihop, eftersom båda börjar med att dela in populationen i grupper. Skillnaden ligger i vad du gör sedan.
| Aspekt | Stratifierat urval | Klusterurval |
|---|---|---|
| Vilka grupper du använder | Urval dras från varje grupp. | Vissa grupper väljs ut, resten används inte alls. |
| Vilka du väljer ut inom en grupp | En slumpmässig delmängd av gruppen. | Alla i gruppen, eller ytterligare en slumpmässig delmängd i en flerstegsvariant. |
| Grupperna bör vara | Lika inbördes och olika varandra. Region, roll, kurs. | Varierade inbördes, var och en en liten kopia av populationen. Skolor, vårdcentraler, valdistrikt. |
| Varför du skulle välja den | Precision, och garanterad representation av undergrupper. | Kostnad och nåbarhet när det inte finns någon lista över individer. |
| Effekt på precisionen | Förbättrar den oftast jämfört med obundet slumpmässigt urval vid samma antal svar. | Minskar den. Budgetera för designeffekten. |
| Vad du behöver innan du börjar | En fullständig lista över individer, med grupperingsvariabeln redan på den. | Bara en lista över grupper. |
Stratifierat: alla grupperna, några av personerna. Kluster: några av grupperna, alla personerna. Stratifierat handlar om precision, kluster handlar om åtkomst.
Icke-sannolikhetsurval, metod för metod
Icke-sannolikhetsurval innebär att urvalssannolikheterna är okända, eftersom ingen slumpmekanism avgjorde vilka som valdes ut. Det är rätt val i fyra situationer. Du kan inte bygga en användbar urvalsram. Gruppen är dold. Snabbhet betyder mer än precision. Eller så handlar frågan om innebörd snarare än storlek.
De här metoderna är inte andra klassens. De besvarar en annan fråga. Misstaget är aldrig att använda dem, utan att använda dem och sedan skriva en mening som bara ett sannolikhetsurval skulle kunna bära.
Bekvämlighetsurval
Bekvämlighetsurval, även kallat tillgänglighetsurval, rekryterar de som är lättast att nå. En popup på en webbplats, en länk i ett nyhetsbrev, eleverna i din egen klass, personer som går förbi ett stånd på en marknad.
Exempel. En butik sätter en länk för återkoppling på kvittot. Alla som svarar har köpt något, hade en telefon med sig, hade tid och hade en anledning att bry sig. Vart och ett av de filtren tar bort en annan del av kundbasen.
Ärlig användning. Att göra en pilotstudie av ett frågeformulär, ta fram hypoteser, ta reda på vilket språk kunderna använder, kontrollera att en fråga blir förstådd. Alla utmärkta användningsområden. Inget av dem kräver en skattning för populationen.
Kvoturval
Kvoturval sätter rekryteringsmål för namngivna grupper och fyller dem. Fyrtio på landsbygden och sextio i städer. Femtio kvinnor och femtio män. Tjugo i var och en av fem åldersgrupper.
Exempel. Ett marknadsundersökningsteam behöver 500 svar som motsvarar den nationella fördelningen på ålder, kön och region, och har ingen lista över populationen. De rekryterar tills varje cell är full.
Varför det ändå inte är ett sannolikhetsurval. Kvoterna styr urvalets form, inte valet av personerna i det. Den som rekryterar väljer fortfarande, och personer som är lätta att närma sig skiljer sig systematiskt från dem som inte är det. Ett urval kan motsvara populationen perfekt i ålder och kön och ändå ge en kraftigt felaktig bild av attityderna, eftersom ålder och kön aldrig var de variabler som orsakade skadan.
Strategiskt urval
Strategiskt urval, även kallat bedömningsurval, väljer medvetet ut fall som uppfyller angivna kriterier. Vanliga varianter är urval av typiska fall, extremfall, kritiska fall, maximal variation och experter.
Exempel. En studie av hur ett nytt betalsystem används väljer ut åtta personer. Två som använder det dagligen, två som har gett upp det, två som aldrig började använda det och två i supporten som hanterar klagomål. Den spridningen är vald med avsikt, och resonemanget är metoden.
Ärlig användning. Det mesta av kvalitativ forskning. Måttstocken här är inte slumpmässighet. Den är om du kan säga varför just de här fallen och inte andra, och om bredden av synsätt räcker för att bära dina påståenden.
Snöbollsurval
Snöbollsurval rekryterar ett litet antal deltagare som sedan hänvisar till andra som uppfyller kriterierna, och de hänvisar i sin tur till fler.
Exempel. En studie av informella gränshandlare börjar med fyra deltagare som har identifierats via en lokal förening, och var och en av dem introducerar två till. Det finns inget register över informella handlare, så ingen metod som bygger på en urvalsram är möjlig.
Vad det gör med ditt urval. Homofili. Människor hänvisar till människor som liknar dem själva. Urvalet glider mot ett enda socialt nätverk och bort från isolerade medlemmar av populationen, som ofta är just de forskningen mest behöver höra. Att starta från flera fristående startpersoner i stället för en minskar glidningen men tar inte bort den.
Så gör du ett icke-sannolikhetsurval försvarbart
De flesta guider stannar vid ”du kan inte generalisera” och lämnar läsaren strandsatt, eftersom de flesta läsare genomför exakt den här sortens studie. Här är den del som brukar saknas.
- Beskriv rekryteringen, inte bara metodens namn. Var länken publicerades, under vilka datum, vilka som såg den, om en belöning erbjöds och hur många som tillfrågades jämfört med hur många som svarade. Det är det som gör att en läsare kan bedöma urvalet i stället för att gissa.
- Jämför ditt uppnådda urval med ett känt riktmärke och publicera jämförelsen. Om din organisation består av 60 procent fältpersonal och 25 procent av dina deltagare är fältpersonal, skriv det i en tabell. En redovisad skevhet är ett resultat. En dold skevhet är en brist.
- Känn till vad viktning kan och inte kan göra. Att justera dina data så att demografin motsvarar populationen kan rätta till synliga obalanser. Det kan inte rätta till att personer skiljer sig från deltagarna i något du inte mätte, och det gör aldrig om ett icke-sannolikhetsurval till ett som kan bära ett påstående om precision.
- Ändra meningen, inte statistiken. I stället för ”38 procent av kunderna är missnöjda, plus/minus 4 procentenheter”, skriv ”38 procent av de 620 kunder som svarade uppgav att de var missnöjda. Deltagarna rekryterades via en uppmaning i appen under två veckor och är inte ett slumpmässigt urval av kunderna.” Den andra meningen är kortare, mer användbar och går inte att angripa.
Kvalitativt arbete har ett eget språk för detta. Ett protokoll efterfrågar oftast en motivering snarare än ett numeriskt mål. Det bör omfatta det avsedda antalet och bredden av synsätt, en skillnad som University of Baths guide uttrycker koncist.5
Matcha metoden med situationen
Sex situationer, sex metoder. Bestäm dig innan du öppnar svaret. Det är det snabbaste sättet att ta reda på om tabellen ovan faktiskt gick fram.
1. Du har en fullständig personalförteckning på 4 200 personer och måste publicera resultat för var och en av sex provinser.
Stratifierat urval. Den fullständiga listan finns, så sannolikhetsurval står öppet för dig, och skyldigheten att redovisa per provins är precis vad stratifiering är till för. Ett obundet slumpmässigt urval skulle lämna den minsta provinsen med för få svar för att redovisa.
2. Du studerar personer som lämnade en tjänst för sex månader sedan. Det finns ingen lista, och de som lämnade argast är svårast att hitta.
Snöbollsurval. Det finns ingen urvalsram och populationen är svår att nå, vilket utesluter alla sannolikhetsmetoder. Starta från flera fristående startpersoner i stället för en, och skriv bland dina begränsningar att hänvisningskedjor snedvrider urvalet mot personer med många kontakter.
3. Ett sjukhus vill ha data om patienternas upplevelser från ett flöde av 9 000 besök per kvartal, insamlade av personal som inte har någon dator i receptionen.
Systematiskt urval. Populationen kommer som ett ordnat flöde, så en intervallregel är både en sannolikhetsmetod och något som en upptagen reception faktiskt kan genomföra. Kontrollera först att besöksordningen inte följer en veckocykel som sammanfaller med ditt intervall.
4. Du behöver förstå varför ett nytt verktyg överges, och du har tre veckor och ingen budget.
Strategiskt urval. Frågan handlar om mekanism, inte omfattning. Välj medvetet över hela bredden: storanvändare, de som har slutat, de som aldrig började, supportpersonal. Redovisa inga procentsatser från det.
5. Ett distrikt har 180 skolor, inget elevregister och en resebudget som räcker till ungefär 25 besök.
Klusterurval. En lista över skolor finns även om en lista över elever saknas, och resekostnaden är den begränsande faktorn. Bredda ditt redovisade intervall för designeffekten, och välj hellre fler skolor med färre elever i varje än tvärtom.
6. Du måste samla in 500 svar på fem dagar som motsvarar den nationella profilen för ålder och region, och det finns ingen lista över populationen.
Kvoturval. Det är det snabbaste sättet att få ett urval som åtminstone motsvarar populationen i synliga egenskaper. Det är fortfarande inte ett sannolikhetsurval, så redovisa sammansättningen och avstå från påståendet om precision.
Så väljer du urvalsmetod
De flesta studier misslyckas inte för att någon valde fel namngiven teknik. De misslyckas för att tekniken inte passade urvalsramen, beslutet eller vad fältteamet realistiskt kunde göra. Tre frågor avgör det nästan varje gång.
Vilken metod passar din studie?
Svara på tre frågor. Rekommendationen visas nedan och de matchande raderna markeras i jämförelsetabellen.
Börja med påståendet du behöver göra
Skriv meningen du vill publicera innan du väljer något. ”Sextiotvå procent av våra kunder skulle rekommendera oss” och ”kunder som lämnar beskriver tre återkommande problem” är olika meningar som kräver olika designer. Om ingen kommer att behandla resultatet som en siffra för populationen har du mycket större frihet än du tror.
Granska urvalsramen innan du bestämmer dig
Kan du faktiskt lista populationen, eller något som ligger nära? Om inte, kan du lista de grupper de tillhör? Svaret på den enda frågan utesluter de flesta av de nio metoderna direkt, och därför kommer den som nummer två och inte sist.
Namnge de undergrupper du är skyldig att redovisa
Om ett resultat måste redovisas för varje region, arbetsplats eller roll styr det designen via strata eller kvoter. Det styr också hur många svar du behöver i varje grupp. Att bestämma det efter fältarbetet går inte att reparera.
Stäm av designen mot verkligheten i fält
Tid, budget, kontaktbarhet, språklig tillgänglighet, läsförmåga, uppkoppling och policy för belöningar avgör vad som går att genomföra. En design som ett fältteam inte kan följa blir ett bekvämlighetsurval med ett formellt namn, vilket är värre än att ärligt välja bekvämlighetsurval. Inkluderande rekryteringsplanering minskar systematisk underrepresentation.6 När du har dragit urvalet använder du ett enkätverktyg online för att förbereda frågeformuläret och skicka det till de personer som din urvalsplan har valt ut. Att dela en öppen, offentlig länk ändrar vilka som kan svara; det bevarar inte ett slumpmässigt urval.
Där urval faktiskt brister: täckning, urvalsdragning och bortfall
Urvalsdragningen är den del alla oroar sig för och den del som går fel mest sällan. Skadan sker oftast före dragningen, i urvalsramen, eller efter den, i vilka som bryr sig om att svara. Båda ger kalkylark som ser rena ut och felaktiga slutsatser.
| Fel | Hur det ser ut | Så minskar du det |
|---|---|---|
| Täckningsfel, ett problem med urvalsramen | Vissa personer kan inte väljas ut alls: ingen e-post i jobbet, en inaktuell förteckning, kunder som bara handlar i butik, hushåll utan uppkoppling. | Förbättra eller kombinera urvalsramar. Lägg till insamlingssätt: papper, personligt besök, telefon, sms. Dokumentera exakt vilka som utesluts. |
| Selektionsbias, ett problem med tillvägagångssättet | Slumpregeln sätts ur spel i praktiken. Först till kvarn. En chef utser vilka som deltar. | Automatisera dragningen. Skilj den som väljer ut från den som rekryterar. Granska varje undantag. |
| Bortfallsfel, ett problem med utfallet | Utvalda personer svarar inte, och de som inte svarar skiljer sig från dem som gör det i det du mäter. | Förbättra kontaktstrategin och upplevelsen av frågeformuläret, och jämför sedan deltagarna med ett känt riktmärke. Se svarsbias. |
| Mätfel | Ett felfritt urval ger dig ändå nonsens eftersom frågorna är ledande, vaga eller dubbelfrågor. | Testa frågeformuläret innan du går ut i fält. Vår guide om att skriva enkätfrågor går igenom de vanliga felen. |
Det mest kända urvalsmisslyckandet hade 2,4 miljoner deltagare
År 1936 förutspådde Literary Digest att Alf Landon skulle få ungefär 55 procent av rösterna. Franklin Roosevelt fick omkring 61 procent.7 Tidskriften hade skickat ut 10 miljoner valsedlar och fått tillbaka omkring 2,4 miljoner, en svarsfrekvens på 24 procent som ingen nationell opinionsundersökning i dag kommer i närheten av.8 Undersökningen placerade Roosevelt tjugo procentenheter under hans faktiska andel, med ett urval på två och en halv miljon människor.
Siffran som borde stå på varje sida om urval. En senare omanalys beräknade urvalets felmarginal för Digests skattningar på delstatsnivå: den låg mellan 0,18 och 2,3 procentenheter, med en median på 0,6.8 Ett precisionsmått på plus/minus en halv procentenhet, ovanpå ett fel på tjugo procentenheter. Ingenting visar tydligare att en felmarginal bara mäter ett av flera sätt som en enkätundersökning kan ha fel på.
Och standardförklaringen är bara till hälften rätt. Alla får lära sig att Digest drog sitt urval bland bilägare och telefonabonnenter, som var rika och republikaner. Ett empiriskt test av det påståendet använde en Gallup-undersökning från maj 1937. Personer som ägde både bil och telefon röstade ändå på Roosevelt, 55 mot 45. Bland alla som sa att de hade fått en valsedel från Digest ledde Roosevelt med 55 mot 44. Urvalsramen lutade åt republikanerna, men inte alls tillräckligt för att ge en jordskredsseger för Landon.7
Den saknade halvan är bortfall. Bland dem som sa att de hade skickat tillbaka sin valsedel ledde Landon med 51 mot 48. Bland dem som inte skickade tillbaka den ledde Roosevelt med 69 mot 30. Den grova uppdelningen lägger ungefär elva procentenheter av felet på urvalsramen och ungefär sju på skillnader i bortfall.7 Att vikta svaren efter en fråga som Digest redan hade ställt, hur man röstade 1932, skulle ha gett rätt vinnare med räknemetoder som fanns 1936.8
En hög svarsfrekvens är inte det mål du tror
Svarsfrekvensen i Pew Research Centers egna telefonundersökningar sjönk från 36 procent 1997 till 9 procent 2012, och till 6 procent 2018.9 Samtidigt valde Indiens National Family Health Survey, som genomfördes genom personliga intervjuer, ut 664 972 hushåll och fann att 653 144 av dem var bebodda. Den intervjuade 636 699 av dem, en svarsfrekvens på 97,5 procent. Läs nämnaren noga, eftersom det är där en svarsfrekvens oftast blir fel: räknat mot antalet utvalda i stället för antalet bebodda blir samma fältarbete 95,7 procent. Undersökningen drog sitt urval från 30 456 kluster i alla 707 distrikt.10
De två fakta hör till samma decennium. Insamlingssätt och insats i fältarbetet påverkar svarsfrekvensen långt mer än något generellt påstående om enkättrötthet. Om en guide säger att den genomsnittliga svarsfrekvensen är en enda siffra beskriver den inte en verklig storhet.
Nu till det svårare resultatet. En metaanalys av 235 skattningar av bortfallsfel från 30 publicerade studier fann att korrelationen mellan svarsfrekvens och bortfallsfelets storlek var 0,33. I kvadrat innebär det att svarsfrekvensen förklarar ungefär 11 procent av variationen i snedvridningen.11 En uppföljning av 59 studier som var utformade särskilt för att mäta bortfallsfel kom fram till samma slutsats.12
Svarsfrekvensen är värd att redovisa och värd att förbättra. Den är inget kvalitetsintyg. Det som orsakar snedvridning är om benägenheten att svara hänger ihop med det du mäter. En enkätundersökning om volontärarbete drabbas av det långt mer än en om bredbandshastighet. Jaga sambandet, inte procentsatsen.
Fler svar kan inte reparera en trasig urvalsram
Under vaccinationsutrullningen 2021 följde två mycket stora enkätundersökningar vaccinationsgraden i USA. Den ena samlade in omkring 250 000 svar i veckan och överskattade andelen som fått första dosen med 17 procentenheter jämfört med det officiella riktmärket. Den andra samlade in omkring 75 000 varannan vecka och överskattade den med 14. En tredje undersökning med ungefär 1 000 deltagare, genomförd enligt vedertagen praxis för sannolikhetsurval, gav tillförlitliga skattningar.13
Samma mönster syns i vanligt enkätarbete. När tre sannolikhetspaneler jämfördes med tre källor med självrekryterade deltagare online, över 28 riktmärken och 29 937 intervjuer, var det genomsnittliga absoluta felet 5,8 procentenheter för de självrekryterade urvalen och 2,6 för sannolikhetspanelerna. För de 25 av riktmärkena som fanns för undergrupper var skillnaden för vuxna i åldern 18 till 29 år 11,2 mot 3,6.14
Och ett diagnostiskt exempel som fastnar: i en undersökning med självrekryterade deltagare sa 12 procent av vuxna under 30 att de hade licens att framföra en atomubåt.15 Den verkliga siffran är nära noll. Om en panel kan ge det kan den ge vad som helst, och en större beställning från samma panel köper bara mer av samma sak.
Vilka din urvalsram missar, utanför USA och Storbritannien
De flesta guider om urval utgår i det tysta från en västerländsk urvalsram: en e-postlista, en fast telefon, ett nationellt adressregister. Stora delar av världen gör inte urval på det sättet, och täckningsluckorna har en uppmätt form.
- En onlineenkät i ett låg- eller medelinkomstland är ett urval av den uppkopplade delen av landet, och den delen är skev mot män. Kvinnor i låg- och medelinkomstländer har 14 procent lägre sannolikhet än män att använda mobilt internet, vilket motsvarar ungefär 235 miljoner färre kvinnor än män online.16
- Telefonurval överrepresenterar hushållsöverhuvuden. I Världsbankens telefonundersökningar i fyra afrikanska länder var 52 procent av deltagarna män i Uganda och 73 procent i Nigeria, mot ungefär hälften av den vuxna befolkningen. I Uganda var 6 procent av telefondeltagarna i åldern 15 till 24 år, mot 38 procent av den vuxna befolkningen.17
- Vad du kan göra åt det. Kombinera insamlingssätt i stället för att försvara ett. Lista hushållen på plats där inget register finns. Genomför undersökningen på de språk din population faktiskt läser, och förtesta översättningen i stället för att bara översätta tillbaka den. Redovisa sedan den kvarvarande luckan bland dina begränsningar, för den kommer fortfarande att finnas där.
Vad viktning kan och inte kan rätta till
Viktning justerar dina data så att urvalets sammansättning motsvarar kända siffror för populationen. Det är verkligen kraftfullt, och det överskattas rutinmässigt.
Argumentet för. År 2016 hade University of New Hampshires sista opinionsundersökning Clinton i ledning med 11 procentenheter i ett val som hon vann med 0,4. Den hade inte justerat för utbildning. Granskningskommittén drog slutsatsen att den enda justeringen i princip skulle ha tagit bort hela felet.18 En enda variabel, korrelerad med både svarsbenägenhet och utfall, som gjorde hela jobbet.
Argumentet mot att förlita sig på det. När mer än 30 000 intervjuer med självrekryterade deltagare online prövades mot 24 riktmärken var den genomsnittliga skattade snedvridningen 8,4 procentenheter utan viktning. Av alla viktningsmetoder som testades, inklusive avancerade matchningsmetoder, fick ingen ner den genomsnittliga snedvridningen under 6 procentenheter.19 Att fyrdubbla urvalsstorleken gav ytterligare 0,2 procentenheter.
Regeln som följer är enkel. Viktning rättar till obalans i de variabler du viktar på, i den mån de variablerna har samband med utfallet. Den gör ingenting åt hur deltagarna skiljer sig från dem som inte svarade i saker du aldrig mätte, och den gör aldrig om ett icke-sannolikhetsurval till ett som kan bära ett påstående om precision.
Ett precisionsmått är ett golv, inte ett tak
En felmarginal kvantifierar urvalsvariationen, och bara den. Den förutsätter att urvalet drogs slumpmässigt ur målpopulationen och att den kvarvarande snedvridningen har tagits bort. Täckningsfel, bortfallsfel, mätfel och oärliga deltagare ligger alla utanför den.
Beläggen är entydiga. Under de sista två veckorna 2020 redovisade 348 presidentvalsundersökningar på delstatsnivå en felmarginal, och den genomsnittliga redovisade siffran var 3,9 procentenheter. Mätt mot det genomsnittet missade 55 procent av dem den slutliga marginalen mellan kandidaterna med mer än en felmarginal, och 21 procent missade med mer än två felmarginaler.20 Det här var moderna undersökningar med moderna metoder. Se felmarginalen som ett golv för din osäkerhet, aldrig som ett tak.
| Påstående | Siffran | Evidensgrad | Källa |
|---|---|---|---|
| Svarsfrekvensen förutsäger knappt bortfallsfel | r = 0,33, alltså ungefär 11 % av variationen, över 235 skattningar från 30 studier | A | Groves, 200611 |
| En mycket stor enkätundersökning kan ha kraftigt fel | Överskattade vaccinationsgraden med 17 procentenheter på omkring 250 000 svar i veckan | A | Bradley m.fl., 202113 |
| Självrekryterade urval är ungefär dubbelt så felaktiga som sannolikhetspaneler | 5,8 mot 2,6 procentenheter i genomsnittligt fel över 28 riktmärken | A | Mercer och Lau, 202314 |
| Viktning förbättrar ett självrekryterat urval men räddar det inte | 8,4 procentenheter utan viktning, ingen metod under 6,0 procentenheter | A | Mercer, Lau och Kennedy, 201819 |
| En felmarginal underskattar det verkliga felet i opinionsundersökningar | 55 % av 348 delstatsundersökningar 2020 missade med mer än den genomsnittliga redovisade felmarginalen på 3,9 procentenheter | A | AAPOR:s arbetsgrupp, 202120 |
| Förklaringen om Literary Digests urvalsram är ofullständig | Bil- och telefonägare föredrog ändå Roosevelt med 55 mot 45 | B | Squire, 19887 |
Evidensgrad A betyder officiell statistik, en metaanalys eller ett replikerat resultat. Evidensgrad B betyder en stark studie vars slutsats ännu inte har upprepats oberoende.
”En svarsfrekvens på 50 procent är tillräcklig, 60 är bra, 70 är mycket bra.” En tumregel från läroböckerna utan några data som stöder den. Olika auktoriteter inom samma område anger 50, 60 och 80. Snedvridningen beror på sambandet mellan att svara och svaret, inte på andelen.
”Trettio räcker, för det är då centrala gränsvärdessatsen slår in.” Det finns ingen härledning som ger 30. För symmetriska utfall fungerar approximationen långt under det, och för skeva utfall eller sällsynta händelser fungerar den inte ens långt över det.
”Den genomsnittliga svarsfrekvensen för enkäter är 33 procent.” Den cirkulerar på leverantörsbloggar i nästan identiska formuleringar utan någon primärkälla. Insamlingssätt, avsändare, population och belöning väger tyngre än något globalt genomsnitt.
”Uppmärksamhetsspannet är nu åtta sekunder, kortare än en guldfisks.” Spårat tillbaka till en marknadsföringsrapport från 2015 som citerade ett företag som inte kunde ta fram någon källa. Den underliggande forskningen nämner aldrig åtta sekunder eller guldfiskar.
Designeffekt: varför klusterurval behöver fler personer
Nästan varje guide rekommenderar klusterurval för kostnadsbesparingen och stannar där. Besparingen är verklig, och det är notan också. Personer inom samma skola, vårdcentral, avdelning eller butik liknar varandra. De liknar varandra mer än de liknar personer som valts slumpmässigt ur hela populationen. Därför tillför varje extra svar från en grupp du redan har valt mindre ny information.
Designeffekten är talet som mäter detta. I ord: hur mycket bredare din osäkerhet blir jämfört med om du hade dragit samma antal personer oberoende av varandra. För en design med lika stora grupper är den
designeffekt = 1 + (genomsnittlig gruppstorlek - 1) x intraklasskorrelation
Intraklasskorrelationen är hur lika personerna inom en grupp är i det du mäter. Noll betyder att vilken skola eleven går på inte säger något om elevens svar. Ett betyder att alla på en skola svarar exakt likadant, och skolan kunde lika gärna vara en enda person. Verkliga värden är små, men små värden gör stor skada när grupperna blir stora. Sammantaget över 48 nationella hushållsundersökningar är den genomsnittliga intraklasskorrelationen ungefär 0,06. Den varierar beroende på vad du mäter. Frågor om fruktsamhet ligger på ungefär 0,01 till 0,03, nuvarande preventivmedelsanvändning på 0,03 till 0,05 och förlossningar med medicinsk assistans så högt som 0,22 i de nationella siffrorna.21
Om du inte har någon egen skattning, låna ett standardvärde med försiktighet. DHS:s urvalshandbok använder 1,5 som reservvärde för deft när en undersökning inte har någon egen siffra.22 Deft är inte samma storhet som designeffekten i formeln ovan: den är kvoten mellan de två standardfelen, medan designeffekten är kvoten mellan de två varianserna. Du kvadrerar den, så en deft på 1,5 motsvarar en designeffekt på 2,25. Handboken kallar värdet en reservlösning snarare än ett typiskt värde, och dess egna räknade exempel använder 1,40 för användning av moderna preventivmedel och 1,22 för vaccination av barn.
| Design | Designeffekt | Effektiva svar | Vad det betyder i praktiken |
|---|---|---|---|
| Oberoende urval, ingen klustring | 1.00 | 960 | Varje svar är värt ett fullt svar. |
| 24 grupper om 40, ICC 0,02 | 1.78 | 539 | Du betalade för 960 och kan försvara precisionen hos 539. |
| 24 grupper om 40, ICC 0,05 | 2.95 | 325 | Två tredjedelar av fältarbetet gav dig ingen extra precision. |
| 24 grupper om 40, ICC 0,10 | 4.90 | 196 | Designen har i det tysta blivit en liten studie med en stor studies budget. |
Viktning lägger till en egen komponent. En nationell undersökning som drar ett större urval i en region och sedan viktar tillbaka det bär på två designeffekter samtidigt. En viktningseffekt på 1,22 och en klustereffekt på 1,80 ger en total designeffekt på 2,20. Därmed beter sig 5 000 intervjuade hushåll som 2 277 oberoende hushåll.23
Lärdomen för designen. Fler grupper med färre personer i varje slår färre grupper med fler personer i varje, nästan varje gång. Fyrtio skolor med 24 elever och 24 skolor med 40 elever kostar ungefär samma 960 svar, men det första alternativet har en mindre designeffekt och ett försvarbart resultat. Om du planerar hur många svar du behöver totalt, räkna ut det i vår guide om urvalsstorlek och multiplicera sedan med designeffekten. Det är när det görs i omvänd ordning som klusterstudier får för låg statistisk styrka.
Tre räknade exempel, från början till slut
Metodnamn är lätta. Det är besluten runt dem som får studier att gå fel. De här tre följer en verklig design från beskrivningen av populationen fram till meningen du kan publicera.
Exempel 1: patientupplevelser i ett distrikt
- Population. Vuxna som besökte en öppenvårdsmottagning på någon av distriktets 46 offentliga vårdcentraler mellan den 1 april och den 30 juni.
- Urvalsram. Det finns inget patientregister för hela distriktet. Det finns däremot en lista över de 46 vårdcentralerna, med antal besök per månad.
- Metod. Flerstegsurval. Välj ut 18 vårdcentraler med sannolikhet proportionell mot antalet besök, och dra sedan systematiskt var 8:e patient som lämnar mottagningen under två slumpmässigt valda mottagningsdagar.
- Varför inte något enklare. En fullständig patientlista skulle möjliggöra stratifierat urval, men den finns inte och kan inte byggas inom tidsramen. Ett bekvämlighetsurval på de tre största vårdcentralerna skulle gå snabbare och skulle beskriva de tre största vårdcentralerna.
- Vad som måste redovisas. Urvalssannolikheterna skiljer sig efter vårdcentralens storlek, så analysen kräver vikter, och intervallet måste breddas för designeffekten.
- Meningen som går att publicera. ”Bland vuxna som besökte offentliga öppenvårdsmottagningar i distriktet under andra kvartalet bedömde uppskattningsvis 71 procent att väntetiden var acceptabel, baserat på 1 240 utgångsintervjuer på 18 vårdcentraler utvalda med sannolikhet proportionell mot antalet besök.”
Exempel 2: en uppsatsstudie bland studenter
- Population. Studenter inskrivna vid handelsfakulteten under det aktuella läsåret: 3 100 fördelade på tre årskurser.
- Urvalsram. Fakultetens register över inskrivna studenter, som anger årskurs och program.
- Metod. Stratifierat slumpmässigt urval efter årskurs, proportionell fördelning, mål 350 fullständiga svar.
- Uträkningen. Första årskursen har 1 300 studenter, vilket är 42 procent av 3 100, så den får 42 procent av 350, alltså 147 svar. Upprepa för varje årskurs. Eftersom fördelningen är proportionell behövs ingen viktning.
- Planering av svaren. Med en förväntad svarsfrekvens på 35 procent behöver du bjuda in ungefär 1 000 studenter för att landa på 350 fullständiga svar, och du bör bjuda in dem stratum för stratum så att en svag svarsfrekvens i en årskurs syns medan det fortfarande finns tid att agera.
- Begränsningar att redovisa. Studenter som har avbrutit sina studier men finns kvar i registret är övertäckning. Studenter som skrevs in efter att registret togs ut är undertäckning. Båda hör hemma i stycket om begränsningar.
Exempel 3: kundåterkoppling för en webbutik
- Population. Kunder som har genomfört en beställning under de senaste 90 dagarna.
- Urvalsram. Ordertabellen. Den är fullständig för beställningar online och fullständig för köp som gäst, men en kund med två konton förekommer två gånger.
- Metod. Ta bort dubbletter så att det blir en rad per kund, och gör sedan ett systematiskt urval av var 12:e kund efter en slumpmässig start, löpande i stället för i en enda omgång.
- Fällan detta undviker. Att bara bjuda in prenumeranter på nyhetsbrevet går snabbare och är ett bekvämlighetsurval av dina mest engagerade kunder. Det får nöjdheten att se bättre ut än den är, varje kvartal och utan undantag.
- En kommentar om anställda. Om samma organisation undersöker sina egna 180 anställda bör den inte göra något urval alls. Den populationen är liten, nåbar och alla har rätt att bli tillfrågade. Gör en totalundersökning, och om deltagandet är lågt, behandla det som ett resultat snarare än som ett urvalsproblem.
Så skriver du urvalsdelen av din metodbeskrivning
Det här är steget de flesta guider hoppar över, och det är det som en handledare, granskare eller kund faktiskt läser. En redovisning av urvalet måste besvara fem frågor i ordning: vilka, från vilken lista, utvalda hur, hur många och vad du därför har rätt att påstå.
Fyll i luckorna nedan. Den är medvetet enkel: examinatorer letar inte efter elegant prosa här, de letar efter en design som de kan bedöma.
Samma studie, svagt skriven och väl skriven
Svag. ”Ett slumpmässigt urval av studenter gjordes och 350 svar samlades in.”
Ingenting här går att kontrollera. ”Slumpmässigt” gör ett jobb det inte har förtjänat, det finns ingen urvalsram, ingen nämnare och inget om vilka som uteslöts.
Stark. ”Målpopulationen var de 3 100 studenter som var inskrivna vid handelsfakulteten 2026. Urvalsramen var fakultetens register över inskrivna studenter, uttaget den 3 mars 2026. Stratifierat slumpmässigt urval efter årskurs med proportionell fördelning användes så att varje årskurs kunde redovisas separat. Ettusen studenter bjöds in och 350 fyllde i frågeformuläret, en svarsfrekvens på 35 procent. Ingen viktning gjordes eftersom fördelningen var proportionell. Studenter som avbröt sina studier efter uttagsdatumet fanns kvar i urvalsramen och kunde inte identifieras, vilket är en mindre källa till övertäckning.”
Den andra versionen är längre, och varje extra mening är en mening som en granskare inte längre behöver fråga om.
”Deltagarna rekryterades via en uppmaning i appen som visades för aktiva användare under två veckor. Detta är ett bekvämlighetsurval, så resultaten beskriver de personer som svarade och kan inte generaliseras till hela användarbasen, och inget precisionsmått redovisas. Deltagarna var i högre grad än användarbasen dagliga användare, vilket bör vägas in när resultaten läses.” Skriv det, så kan ingen anklaga dig för att påstå för mycket. Det gjorde du inte.
Checklista för urvalsplanen
En skriftlig urvalsplan förhindrar de flesta undvikbara fel, eftersom den tvingar fram besluten före fältarbetet i stället för under analysen. Åtta punkter, en sida.
- 1. Forskningssyfte. Vilket beslut ska detta ligga till grund för, och vad exakt kommer att redovisas?
- 2. Målpopulation. Vilka som ingår och inte ingår, inklusive tidsperioden.
- 3. Urvalsram. Källa, uttagsdatum, antal rader, kända luckor och regeln för att ta bort dubbletter.
- 4. Metod och skäl. Vilken av de nio, och varför just den givet urvalsramen och påståendet.
- 5. Mål. Fullständiga svar totalt och per undergrupp, plus den förväntade svarsfrekvens du planerar utifrån.
- 6. Rekryteringsplan. Insamlingssätt, schema för påminnelser, språk och tillgänglighet, policy för belöningar.
- 7. Uppföljning. Vad du kommer att bevaka under fältarbetet: svar per stratum, var deltagarna hoppar av, internt bortfall.
- 8. Anteckningar för analysen. Planerad viktning, justering för designeffekt och de begränsningar du kommer att redovisa oavsett vad som händer.
När planen är klar avgör frågeformuläret om urvalet var värt att dra. Ett perfekt urval kan inte rädda en ledande fråga eller en dubbelfråga, så det lönar sig att läsa igenom exempel på enkätfrågor innan du går ut i fält.
Vanliga frågor
Vad är urval i forskning?
Att göra ett urval innebär att välja ut en delmängd av en population, det så kallade urvalet, och att studera den delmängden för att dra slutsatser om hela populationen. Det görs eftersom det oftast tar för lång tid, kostar för mycket eller är omöjligt att mäta varje medlem av en population. Metoden som används för att välja ut urvalet avgör vilka slutsatser resultaten kan bära.
Vad är skillnaden mellan population och urval?
Populationen är hela den grupp du vill beskriva. Urvalet är den mindre delmängd du faktiskt mäter. Urvalsförfarandet är processen som tar dig från det ena till det andra, och en totalundersökning är alternativet där du i stället mäter hela populationen.
Vad är en urvalsram?
En urvalsram är den faktiska lista eller mekanism du drar ditt urval från: ett studentregister, ett patientregister, en kunddatabas, en förteckning över hushåll, en röstlängd. Den betyder mer än metodens namn, eftersom alla som saknas i urvalsramen har noll chans att väljas ut, hur bra din urvalsteknik än är.
Vilken urvalsmetod kräver ingen urvalsram?
Bekvämlighetsurval, kvoturval, strategiskt urval och snöbollsurval behöver ingen lista alls. Klusterurval och flerstegsurval behöver bara en lista över grupper, till exempel skolor, vårdcentraler eller byar, inte en lista över individer. Obundet slumpmässigt urval, systematiskt urval och stratifierat urval kräver alla en fullständig lista över individer innan du kan börja.
Vad är skillnaden mellan sannolikhetsurval och icke-sannolikhetsurval?
Vid sannolikhetsurval är det en slumpmekanism som väljer ut, så varje enhet har en känd sannolikhet större än noll att bli vald, och du kan beräkna hur osäkra dina skattningar är. Vid icke-sannolikhetsurval är de sannolikheterna okända, eftersom urvalet beror på bekvämlighet, kvoter eller forskarens bedömning. Den praktiska konsekvensen är att bara en sannolikhetsdesign kan bära ett angivet precisionsmått för en skattning av populationen.
Vad är skillnaden mellan stratifierat urval och klusterurval?
Stratifierat urval delar in populationen i grupper och drar ett slumpmässigt urval från varje grupp, vilket förbättrar precisionen och garanterar att varje grupp finns med. Klusterurval väljer slumpmässigt ut vissa grupper och undersöker sedan alla inom de utvalda grupperna, vilket sparar kostnader när det inte finns någon lista över individer. Kortversionen: stratifierat urval använder alla grupperna och några av personerna, klusterurval använder några av grupperna och alla personerna.
Vad är en primär urvalsenhet?
Den primära urvalsenheten är det som väljs ut i första steget av en flerstegsdesign. I en nationell hushållsundersökning är det oftast ett område, till exempel ett valdistrikt, en by eller ett räkneområde. Hushållen väljs sedan ut inom det i andra steget. Att ange din primära urvalsenhet är ett standardkrav när du redovisar en klusterdesign, eftersom klustringen den skapar måste återspeglas i analysen.
Vad är stratifierat slumpmässigt urval?
Stratifierat slumpmässigt urval delar upp populationen i grupper som inte överlappar, så kallade strata, och drar sedan ett slumpmässigt urval oberoende inom varje stratum. Proportionell fördelning ger varje stratum en andel av urvalet som motsvarar dess andel av populationen och kräver ingen viktning. Disproportionell fördelning drar medvetet ett större urval ur små men viktiga strata och kräver sedan viktning innan någon samlad siffra redovisas.
Är snöbollsurval giltigt i akademisk forskning?
Ja, när populationen är dold, sällsynt eller oregistrerad och ingen urvalsram kan byggas. Det är ett erkänt tillvägagångssätt för svårnådda grupper. Vad det inte kan göra är att bära en skattning för populationen, och dess största svaghet är att deltagarna hänvisar till personer som liknar dem själva, så att urvalet glider mot ett enda socialt nätverk. Att starta från flera fristående startpersoner minskar den glidningen och bör beskrivas i din metodbeskrivning.
Är slumpmässigt urval samma sak som slumpmässig fördelning?
Nej. Slumpmässigt urval är hur du väljer ut deltagare ur en population, och det styr vilka dina resultat kan generaliseras till. Slumpmässig fördelning är hur du fördelar utvalda deltagare mellan betingelser i ett experiment, och det styr om en observerad effekt kan tillskrivas behandlingen. En studie kan använda det ena utan det andra, och de flesta experiment använder slumpmässig fördelning utan slumpmässigt urval.
Kan jag använda en icke-sannolikhetsmetod i en kvantitativ studie?
Ja, och mycket publicerad kvantitativ forskning gör det. Det som ändras är vad du får påstå. Du kan redovisa antal, procentsatser och samband inom ditt urval, och du kan jämföra grupper inom det. Du kan inte presentera de procentsatserna som skattningar för populationen med en angiven precision. Ange metoden, beskriv rekryteringen, jämför dina deltagare med ett känt riktmärke där ett sådant finns och skriv ut begränsningen tydligt i stället för att hoppas att ingen frågar.
Vad är skillnaden mellan urval och en urvalsfördelning?
Urvalsförfarandet är sättet att välja ut ett urval. En urvalsfördelning är en annan idé. Tänk dig att du upprepar samma urvalsförfarande många gånger. Spridningen hos den statistika du får fram, till exempel medelvärdet eller andelen, över alla de tänkta urvalen är urvalsfördelningen. Urvalsfördelningen är det som gör konfidensintervall möjliga, och den beter sig bara förutsägbart när urvalet har dragits med en sannolikhetsmetod.
Hur vet jag om mitt urval är snedvridet?
Jämför ditt uppnådda urval med ett känt riktmärke, till exempel din personalförteckning, register över inskrivna eller administrativa data, i variabler som har samband med det du mäter. Stora skillnader tyder på täckningsproblem, problem med urvalsdragningen eller skillnader i bortfall. Jämför också mellan rekryteringskanaler och påminnelseomgångar. Tänk på att en god svarsfrekvens är ett svagt belägg för låg snedvridning: över 235 publicerade skattningar förklarade svarsfrekvensen bara ungefär 11 procent av variationen i bortfallsfel.
Läs vidare
Urvalet är ett beslut inom en större studie. De här guiderna går igenom besluten före och efter.
- Forskningsdesign för enkätundersökningar visar var urvalet kommer in bland de övriga stegen i en studie, från att definiera populationen till lanseringen.
- Så bestämmer du urvalsstorlek går igenom precisionsberäkningarna, inklusive formlerna, som den här sidan medvetet överlåter åt den guiden.
- Så skriver du enkätfrågor går igenom mätsidan, som ingen urvalsdesign kan rädda.
- Principer för utformning av frågeformulär visar hur ett helt frågeformulär sätts samman när frågorna väl finns.
- Svarsbias går djupare in på skillnaden mellan de personer du valde ut och de personer som svarade.
- Demografiska frågor i enkäter är användbar när din urvalsram saknar den variabel du behöver stratifiera på.
- Statistisk signifikans går igenom vad du gör med siffrorna när urvalet väl är insamlat.
- Kvantitativ dataanalys går igenom analysstegen som följer, inklusive var vikterna hör hemma.
Hur den här guiden skrevs, och vad den inte täcker
Vem som skrev den. Michael Hodge, som arbetar med enkätmetodik, frågekonstruktion och datakvalitet på SuperSurvey och skriver de praktiska guiderna i avdelningen Guider och hjälp.
Vad den bygger på. Definitionerna följer den metodologiska översikten och de universitetsriktlinjer för forskning som citeras nedan, eftersom det är där de tekniska begreppen faktiskt definieras. De officiella sidorna om forskningsetik och från statistikmyndigheter listas som korta, lättbegripliga utgångspunkter, inte som källan till definitionerna. Metodbeskrivningarna följer samma översikter och riktlinjer. Varje siffra i avsnittet om belägg kommer från en namngiven primärkälla som listas nedan. Varje påstående har också en evidensgrad, så att du kan se vilka resultat som är etablerade och vilka som vilar på en enda studie. Siffrorna för designeffekt i diagrammet och tabellen är vår egen beräkning. Vi använde standardformeln, med antagandena angivna i bildtexten, så att du kan räkna om dem eller ifrågasätta dem med dina egna klusterstorlekar.
Vad den inte täcker. Den här guiden handlar om urval för enkätundersökningar och observationsstudier. Den tar inte upp experimentell design eller slumpmässig fördelning, utöver att skilja dem åt. Den utelämnar också urval för acceptanstestning, revision och signalbehandling, som använder samma ord för andra saker. Respondentdrivet urval, tid-plats-urval och adaptivt klusterurval är verkliga metoder som specialister använder för dolda populationer, och de ligger utanför ramen här. Siffrorna för intraklasskorrelation kommer från hushållsundersökningar i låg- och medelinkomstländer. Se dem som illustrationer, inte som värden att föra över till ett annat sammanhang.
Där siffrorna är svagast. Omanalysen av Literary Digest vilar på en enda undersökning från 1937 och en senare omanalys, och båda författarna påpekar sin egen osäkerhet; den har därför evidensgrad B. Siffrorna för fel i opinionsundersökningar kommer från amerikanska valundersökningar, som är ovanligt väl studerade och inte nödvändigtvis representativa för fel i enkätundersökningar i allmänhet.
Upplysning. SuperSurvey säljer enkätprogramvara. Ingenting på den här sidan är till salu, ingen del av den kräver registrering, och ingen organisation har sponsrat eller granskat guiden. Där vi länkar till våra egna sidor är det för att de tar upp nästa beslut, inte för att en länk ger oss något.
Källor
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., och Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- UK Government (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., och Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., och Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences och ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., och Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., och Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., och Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., och Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, sidorna 9 och 15. Siffrorna kommer från 2025 års utgåva; GSMA har sedan dess publicerat en utgåva för 2026 med ett mindre glapp.
- Brubaker, J., Kilic, T., och Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., m.fl. (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., och Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., och Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, sidan 9 och tabell 1.2.
- Kalton, G., Brick, J. M., och Le, T. (2005). Estimating components of design effects for use in sample design. I Household Sample Surveys in Developing and Transition Countries, kapitel VI. United Nations, Series F No. 96.