
คำตอบสั้น ๆ
การสุ่มตัวอย่างคือกระบวนการเลือกส่วนย่อยของประชากรที่เรียกว่ากลุ่มตัวอย่าง แล้วศึกษาส่วนย่อยนั้นเพื่อสรุปผลเกี่ยวกับประชากรทั้งหมด นักวิจัยใช้การสุ่มตัวอย่างเพราะการวัดทุกคนมักช้าเกินไป แพงเกินไป หรือทำไม่ได้เลย ประชากรคือกลุ่มที่คุณต้องการอธิบาย กลุ่มตัวอย่างคือส่วนของประชากรที่คุณวัดจริง และกรอบการสุ่มตัวอย่างคือรายชื่อที่คุณใช้สุ่มกลุ่มตัวอย่างออกมา
การสุ่มตัวอย่างแบบอาศัยความน่าจะเป็นเลือกคนด้วยกลไกการสุ่ม ทุกหน่วยจึงมีโอกาสถูกเลือกที่ทราบค่าและไม่เป็นศูนย์ สิ่งนี้เองที่ทำให้คุณระบุความไม่แน่นอนของผลเป็นตัวเลขได้
การสุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็นเลือกตามความสะดวก โควตา หรือดุลยพินิจ มักเร็วกว่า ถูกกว่า และบางครั้งเป็นทางเลือกเดียวที่ถูกหลักจริยธรรม แต่ใช้ประมาณค่าประชากรพร้อมระบุความแม่นยำไม่ได้
ไปที่ เปรียบเทียบ 9 วิธี | วิธีเลือก | ทดสอบความเข้าใจ | วิธีเขียนรายงาน
ประเด็นสำคัญ
- การสุ่มตัวอย่างคือการศึกษาส่วนย่อย: คุณวัดกลุ่มตัวอย่างเพื่อเรียนรู้เกี่ยวกับประชากร เมื่อการวัดทุกคนทำไม่ได้
- ทำความเข้าใจคำห้าคำให้ถูกก่อน: ประชากร กรอบการสุ่มตัวอย่าง หน่วยการสุ่มตัวอย่าง แบบแผนการสุ่มตัวอย่าง และช่องว่างระหว่างประชากรที่คุณต้องการกับประชากรที่คุณเข้าถึงได้จริง ข้อถกเถียงเรื่องการสุ่มตัวอย่างส่วนใหญ่ แท้จริงแล้วคือข้อถกเถียงเรื่องใดเรื่องหนึ่งในห้าข้อนี้
- มีเพียงวิธีแบบอาศัยความน่าจะเป็นที่ทำให้คุณระบุความไม่แน่นอนเป็นตัวเลขได้ กลุ่มตัวอย่างแบบบังเอิญ แบบโควตา แบบเจาะจง และแบบสโนว์บอลอาจมีประโยชน์และซื่อตรงต่อข้อมูล แต่ใช้ประมาณค่าประชากรพร้อมระบุความแม่นยำไม่ได้
- กรอบกำหนดเพดานของคุณ: หากกลุ่มใดไม่มีทางปรากฏในรายชื่อที่คุณใช้สุ่ม ไม่ว่าวิธีใดหรือการตอบกลับเพิ่มอีกมากเท่าใดก็ทำให้กลุ่มนั้นเข้ามาอยู่ในผลลัพธ์ของคุณไม่ได้
- ความเป็นตัวแทนคือห่วงโซ่ ไม่ใช่ป้ายกำกับ: กรอบ ตามด้วยการคัดเลือก การสรรหา การตอบกลับ และการวิเคราะห์ การสุ่มเป็นเพียงข้อต่อเดียวจากห้าข้อต่อ
นิยามของการสุ่มตัวอย่าง (และคำ 5 คำที่คุณต้องเข้าใจให้ถูก)
การสุ่มตัวอย่างคือกระบวนการเลือกกลุ่มที่เล็กกว่า (กลุ่มตัวอย่าง) จากกลุ่มที่ใหญ่กว่า (ประชากร) เพื่อให้คุณเรียนรู้เกี่ยวกับประชากรได้โดยไม่ต้องวัดทุกคน การศึกษาประชากรทั้งหมดมักทำได้ยาก นักวิจัยจึงสุ่มตัวอย่างเพื่อให้งานเป็นไปได้ และยังได้ข้อสรุปที่มีประโยชน์
คำห้าคำด้านล่างเป็นแกนหลักของบทระเบียบวิธีวิจัยทุกบท หากเข้าใจผิด การตัดสินใจทุกอย่างหลังจากนั้นจะรับความผิดพลาดนั้นไปด้วย
- ประชากร: กลุ่มทั้งหมดที่คุณต้องการอธิบาย เขียนโดยระบุขอบเขตและช่วงเวลา “นักศึกษาพยาบาลชั้นปีสุดท้ายทั้งหมดในสามวิทยาเขต ที่ลงทะเบียน ณ วันที่ 1 มีนาคม” คือประชากร ส่วน “พยาบาล” ไม่ใช่
- ประชากรเป้าหมายกับประชากรที่เข้าถึงได้: กลุ่มที่คุณต้องการอธิบาย เทียบกับกลุ่มที่การสรรหาและเครื่องมือของคุณเข้าถึงได้จริง การระบุช่องว่างระหว่างสองกลุ่มนี้ในรายงานเป็นจุดแข็ง ไม่ใช่จุดอ่อน
- กรอบการสุ่มตัวอย่าง: รายชื่อหรือกลไกที่คุณใช้สุ่ม เช่น ทะเบียนนักศึกษา ทะเบียนผู้ป่วย ฐานข้อมูลลูกค้า บัญชีรายชื่อครัวเรือนในหมู่บ้าน หรือบัญชีรายชื่อผู้มีสิทธิเลือกตั้ง ปัญหาของกรอบทำให้เกิดความคลาดเคลื่อนจากการครอบคลุม และไม่มีวิธีใดแก้ได้
- หน่วยการสุ่มตัวอย่าง: สิ่งที่ถูกเลือกจริง อาจเป็นบุคคล ครัวเรือน คลินิก ห้องเรียน กะการทำงาน หรือคำสั่งซื้อ ในแบบแผนแบบกลุ่มและแบบหลายขั้นตอน หน่วยในขั้นแรกคือกลุ่ม และกลุ่มนั้นเรียกว่าหน่วยการสุ่มตัวอย่างขั้นปฐมภูมิ
- แบบแผนการสุ่มตัวอย่าง: แผนทั้งหมดที่เขียนเป็นลายลักษณ์อักษร ได้แก่ กรอบ วิธีการ จำนวนหน่วย วิธีติดต่อ และสิ่งที่คุณจะทำกับคนที่ไม่ตอบ “แบบแผนการสุ่มตัวอย่าง” คือสิ่งที่กรรมการสอบหรือผู้ทบทวนต้องการเห็นจริง ๆ เมื่อถามถึงการสุ่มตัวอย่างของคุณ
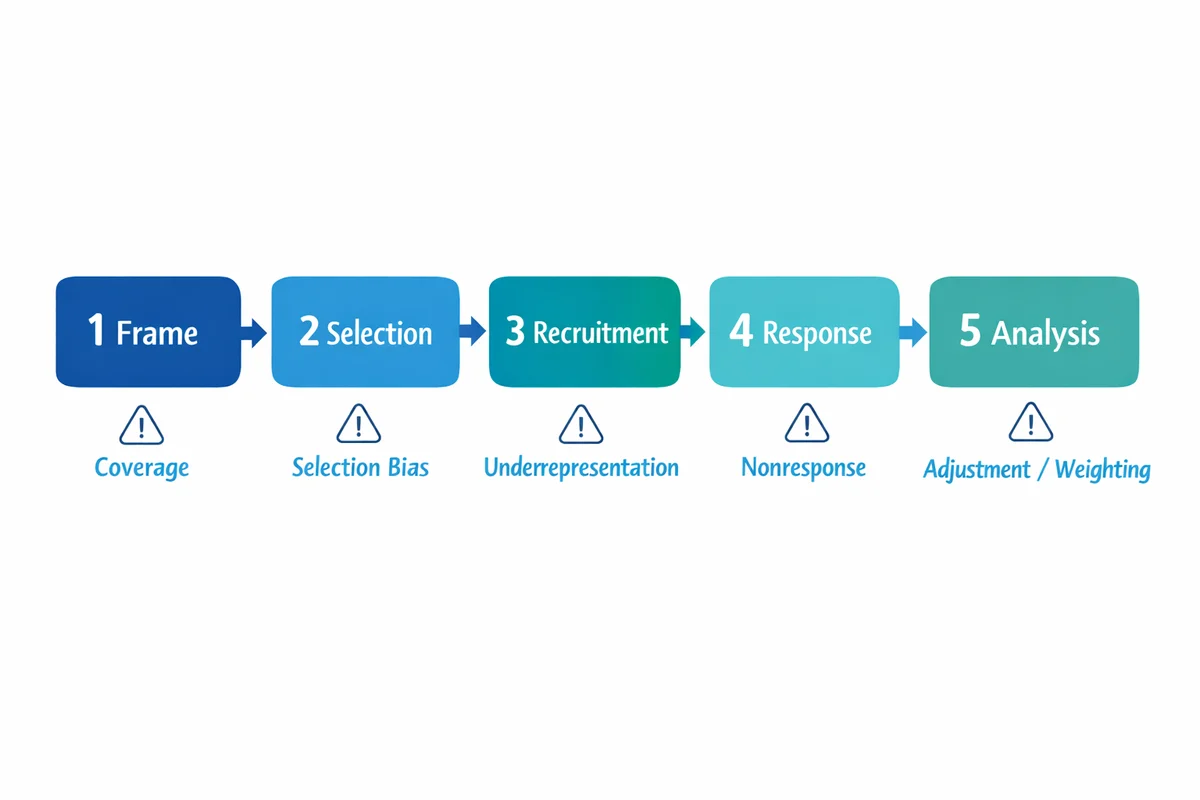
คุณอาจสุ่มเลือกตามตำราได้ครบทุกขั้น แต่ยังได้กลุ่มตัวอย่างที่มีอคติ หากกรอบของคุณตกหล่นกลุ่มใดไป กลุ่มนั้นก็ไม่เคยมีสิทธิ์ถูกสุ่มเลย หากกลุ่มใดไม่ตอบ กลุ่มนั้นก็หลุดออกไปหลังถูกสุ่มแล้ว ให้มองการสุ่มตัวอย่างเป็นห่วงโซ่: กรอบ ตามด้วยการคัดเลือก การสรรหา การตอบกลับ และการวิเคราะห์
หากต้องการนิยามอย่างเป็นทางการแบบสั้นของแนวคิดเดียวกัน ดูเอกสารฝึกอบรมเรื่องการสุ่มตัวอย่างของ U.S. Office of Research Integrity (สำนักงานจริยธรรมการวิจัยของสหรัฐอเมริกา)1 หากคุณกำลังวางการสุ่มตัวอย่างไว้ในแผนการศึกษาที่ใหญ่กว่า คู่มือการออกแบบการวิจัยเชิงสำรวจของเราครอบคลุมขั้นตอนก่อนและหลังขั้นนี้
ทำไมต้องสุ่มตัวอย่าง และเมื่อใดสำมะโนจึงเป็นคำตอบที่ดีกว่า
ความจำเป็นของการสุ่มตัวอย่างเป็นเรื่องปฏิบัติก่อนจะเป็นเรื่องสถิติ มีเหตุผลสี่ข้อที่พบซ้ำแล้วซ้ำเล่า
ต้นทุน
ผู้ตอบทุกคนที่เพิ่มขึ้นมีต้นทุนเป็นเงิน เวลาของทีมงาน หรือความเต็มใจของผู้คน กลุ่มตัวอย่าง 600 รายที่สุ่มมาอย่างดีตอบคำถามเดียวกันได้เท่ากับความพยายามเก็บข้อมูล 60,000 รายที่ทำอย่างหละหลวม
ความเร็ว
การตัดสินใจมีกำหนดเวลา กลุ่มตัวอย่างให้คำตอบแก่คุณภายในช่วงเวลาที่คำตอบนั้นยังมีประโยชน์
ความเป็นไปได้
ประชากรบางกลุ่มแจกแจงรายชื่อไม่ได้เลย เช่น ผู้คนที่เดินผ่านตลาด คนที่เลิกใช้บริการ หรือผู้ค้านอกระบบ บางกลุ่มมีขนาดแทบไม่สิ้นสุด หรือการวัดหน่วยหนึ่งก็ทำลายหน่วยนั้นไป
คุณภาพ
ข้อนี้ทำให้หลายคนแปลกใจ การทุ่มความพยายามกับกลุ่มที่เล็กลงทำให้คุณติดตามผู้ที่ไม่ตอบกลับได้ ฝึกผู้สัมภาษณ์ได้อย่างเหมาะสม และตรวจสอบข้อมูลได้ ความพยายามต่อหน่วยมักมีค่ามากกว่าจำนวนหน่วย
ส่วนสำมะโนคือการวัดทุกคน เป็นทางเลือกที่ดีกว่าเมื่อประชากรมีขนาดเล็กพอจะเข้าถึงได้ เมื่อมีข้อมูลติดต่ออยู่แล้ว หรือเมื่อสมาชิกทุกคนมีสิทธิ์ได้รับการสอบถาม แบบสำรวจพนักงานในองค์กร 200 คนเป็นเรื่องของสำมะโน ไม่ใช่เรื่องของการสุ่มตัวอย่าง การประเมินรายวิชาก็เช่นกัน เมื่อประชากรมีขนาดเล็ก การสุ่มตัวอย่างแทบไม่ได้อะไรเพิ่ม และทำให้คุณรายงานผลแยกตามทีมไม่ได้
กลุ่มตัวอย่างที่ดีมีลักษณะอย่างไร
ตำรามักบอกว่ากลุ่มตัวอย่างที่ดีต้อง “เป็นตัวแทน” ซึ่งไม่ใช่เกณฑ์ที่นำไปตรวจสอบได้จริง คุณสมบัติสี่ข้อนี้ต่างหากที่ตรวจสอบได้
- ความครอบคลุม: ทุกคนในประชากรเป้าหมายมีโอกาสถูกเลือกได้ตามหลักการ
- การคัดเลือกที่ควบคุมได้: ใครจะอยู่ในกลุ่มตัวอย่างตัดสินด้วยกฎ ไม่ใช่ด้วยว่าใครอาสาหรือใครอยู่ใกล้ประตูที่สุด
- มีหน่วยเพียงพอในกลุ่มที่เล็กที่สุดที่คุณต้องรายงาน: ตัวเลขภาพรวมอาจดูดี ขณะที่กลุ่มที่คุณสนใจจริง ๆ มีการตอบกลับเพียง 11 รายการ
- อธิบายได้: คุณเขียนได้อย่างแม่นยำว่าสุ่มมาอย่างไร และคนอื่นทำซ้ำได้
| หากเป้าหมายของคุณคือ | ผลต่อการสุ่มตัวอย่าง | กับดักที่พบบ่อย |
|---|---|---|
| ประมาณค่าร้อยละของประชากร | ใช้วิธีแบบอาศัยความน่าจะเป็น ติดตามว่าใครตอบ และรายงานความแม่นยำควบคู่กับตัวเลข | ใช้กลุ่มตัวอย่างแบบบังเอิญราวกับว่าอธิบายประชากรได้ |
| เปรียบเทียบกลุ่มย่อย | วางแผนจำนวนการตอบกลับต่อกลุ่มย่อย โดยทั่วไปด้วยการแบ่งชั้นภูมิและสุ่มกลุ่มเล็กเพิ่มเกินสัดส่วน | รายงานกลุ่มย่อยที่ผลลัพธ์มาจากคนเพียงไม่กี่คน |
| สำรวจประสบการณ์และกลไก | การเลือกแบบเจาะจงหรือแบบตามทฤษฎีเหมาะสม ให้อธิบายเหตุผลว่าครอบคลุมมุมมองใดและไม่ครอบคลุมมุมมองใด | ไล่ตามจำนวนขั้นต่ำโดยไม่มีเหตุผลรองรับ |
| ทดสอบมาตรการแทรกแซง | การสุ่มตัวอย่างกำหนดว่าผลลัพธ์อ้างอิงไปถึงใครได้ การสุ่มจัดกลุ่มกำหนดว่าผลนั้นเกิดขึ้นจริงหรือไม่ | สับสนระหว่างการสุ่มจัดกลุ่มกับการสุ่มตัวอย่าง ทั้งสองเป็นคนละกระบวนการกัน |
หากต้องการคำอธิบายภาษาง่ายว่ากลุ่มตัวอย่างใช้ประมาณค่าประชากรได้อย่างไร ภาพรวมเรื่องการสุ่มตัวอย่างและการอนุมานในแบบสำรวจของ U.S. Census Bureau (สำนักงานสำมะโนประชากรสหรัฐอเมริกา) เป็นจุดเริ่มต้นที่ดี2
กรอบการสุ่มตัวอย่างกำหนดเพดานของคุณ
กรอบการสุ่มตัวอย่างคือรายชื่อหรือกลไกที่จับต้องได้ซึ่งคุณใช้สุ่ม เป็นส่วนที่ถูกพูดถึงน้อยที่สุดของการสุ่มตัวอย่าง และเป็นจุดที่งานวิจัยจริงส่วนใหญ่ผิดพลาดอย่างเงียบ ๆ เพราะกรอบเป็นตัวตัดสินว่าใครมีสิทธิ์ถูกเลือกตั้งแต่แรก
กรอบเป็นสิ่งธรรมดา เช่น ทะเบียนนักศึกษา ทะเบียนผู้ป่วย รายชื่อพนักงานของฝ่ายบุคคล ฐานข้อมูลลูกค้า รายชื่อหมู่บ้านพร้อมจำนวนครัวเรือน บัญชีรายชื่อผู้มีสิทธิเลือกตั้ง ชุดคำสั่งซื้อต่อเนื่อง หรือรายชื่อคลินิกในอำเภอ สังเกตว่ากรอบบางแบบเป็นรายชื่อคน บางแบบเป็นรายชื่อสถานที่ ความต่างนี้ตัดสินว่าคุณใช้วิธีใดได้บ้าง
| ปัญหา | ลักษณะที่พบ | ผลต่อผลลัพธ์ของคุณ |
|---|---|---|
| ครอบคลุมไม่ครบ | คนในประชากรขาดหายจากรายชื่อ เช่น พนักงานที่ไม่มีอีเมลที่ทำงาน ลูกค้าที่ซื้อหน้าร้าน ครัวเรือนที่ไม่มีที่อยู่จดทะเบียน | บางกลุ่มทั้งกลุ่มไม่มีโอกาสถูกเลือกเลย การตอบกลับเพิ่มแก้ไม่ได้ เพราะคนที่ขาดหายไปไม่เคยมีสิทธิ์ถูกเลือก |
| ครอบคลุมเกิน | รายชื่อมีหน่วยที่อยู่นอกประชากรของคุณ เช่น ศิษย์เก่า บัญชีที่ปิดแล้ว คนที่ย้ายออกไปแล้ว | คุณเสียแรงเปล่า และหากไม่คัดกรองออก คุณจะวัดผิดประชากร |
| ซ้ำซ้อน | คนเดียวกันปรากฏมากกว่าหนึ่งครั้ง เช่น มีที่อยู่อีเมลสองที่อยู่ หรือมีเลขบัญชีสองเลข | คนเหล่านั้นมีโอกาสถูกเลือกสูงกว่าคนอื่น ซึ่งทำลายสมมติฐานเรื่องโอกาสเท่ากันอย่างเงียบ ๆ |
| ล้าสมัย | รายชื่อถูกต้องตอนที่จัดทำ แต่ตอนนี้ไม่ถูกต้องแล้ว | รายชื่อติดต่อที่ส่งไม่ถึงดูเหมือนการปฏิเสธ อัตราการตอบกลับและการวินิจฉัยอคติของคุณจึงผิดทั้งคู่ |
ตรวจสอบกรอบก่อนสุ่ม ไม่ใช่หลังสุ่ม นับจำนวนแถว เทียบจำนวนนั้นกับยอดรวมอิสระที่หาได้ เช่น จำนวนพนักงานของฝ่ายบุคคล หรือตัวเลขการลงทะเบียนเรียน มองหากลุ่มที่คุณจะอายที่สุดหากตกหล่น แล้วตรวจว่ามีอยู่จริง ลบรายการซ้ำ เขียนว่ากรอบไม่ครอบคลุมอะไร เพราะประโยคนั้นต้องอยู่ในส่วนข้อจำกัดของคุณไม่ว่าอย่างไร
การสุ่มตัวอย่างแบบบังเอิญ แบบโควตา แบบเจาะจง และแบบสโนว์บอลไม่ต้องใช้รายชื่อเลย การสุ่มตัวอย่างแบบกลุ่มและแบบหลายขั้นตอนต้องการเพียงรายชื่อกลุ่ม (โรงเรียน คลินิก หอผู้ป่วย หมู่บ้าน) ไม่ใช่รายชื่อคน ส่วนการสุ่มตัวอย่างแบบง่าย แบบมีระบบ และแบบแบ่งชั้นภูมิ ล้วนต้องมีรายชื่อบุคคลครบถ้วนก่อนเริ่ม หากคุณไม่มีรายชื่อและสร้างขึ้นไม่ได้ ข้อเท็จจริงข้อเดียวนี้ก็ตัดวิธีออกไปสามวิธีจากเก้าวิธีในหน้านี้ และมักเป็นเรื่องแรกที่ต้องตัดสินให้ได้
เปรียบเทียบวิธีการสุ่มตัวอย่าง 9 วิธี
วิธีการสุ่มตัวอย่างแบ่งเป็นสองตระกูล การสุ่มตัวอย่างแบบอาศัยความน่าจะเป็นใช้กลไกการสุ่ม ทุกหน่วยในกรอบจึงมีโอกาสถูกเลือกที่ทราบค่าและไม่เป็นศูนย์ การสุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็นไม่ได้ใช้ ความน่าจะเป็นของการถูกเลือกจึงไม่ทราบค่า ทุกอย่างที่เหลือล้วนตามมาจากความต่างข้อเดียวนี้
คอลัมน์ที่สองคือคอลัมน์ที่คู่มือส่วนใหญ่ละไว้ ในหน้านี้จึงนำมาไว้ก่อน มีเพียงแบบแผนแบบอาศัยความน่าจะเป็นที่รองรับค่าความคลาดเคลื่อน ช่วงความเชื่อมั่น หรือประโยค “บวกลบ 5 จุด” ได้ หากวิธีใดได้คำตอบว่า “ไม่” ในคอลัมน์นั้น คุณยังเรียนรู้จากวิธีนั้นได้มาก เพียงแต่เผยแพร่ตัวเลขความแม่นยำควบคู่กับผลไม่ได้ ส่วนเรื่องความแม่นยำเป็นอีกเรื่องหนึ่ง ซึ่งอธิบายไว้ในคู่มือขนาดกลุ่มตัวอย่างของเรา
| วิธีการ | รองรับค่าความคลาดเคลื่อนหรือไม่? | ทำงานอย่างไร | เหมาะเมื่อ | ต้นทุน และอคติที่อาจเกิด |
|---|---|---|---|---|
| การสุ่มตัวอย่างแบบง่าย อาศัยความน่าจะเป็น ต้องมีรายชื่อครบ |
ใช่ | ทุกหน่วยในรายชื่อมีโอกาสเท่ากัน คุณสุ่มจับตามจำนวนที่ต้องการ | คุณมีรายชื่อชุดเดียวที่สะอาดและไม่มีรายการซ้ำ และไม่มีกลุ่มย่อยที่ต้องรายงานแยก | ต้นทุนคุณต้องมีรายชื่อครบ และกลุ่มเล็กอาจได้จำนวนน้อยเกินกว่าจะรายงานได้อคติมีน้อยมากในขั้นการคัดเลือก ความเสี่ยงที่เหลือทั้งหมดย้ายไปอยู่ที่ว่าใครตอบจริง |
| การสุ่มตัวอย่างแบบมีระบบ อาศัยความน่าจะเป็น ต้องมีรายชื่อครบ |
ใช่ หากลำดับในรายชื่อไม่เกี่ยวข้องกับผลที่วัด | เรียงรายชื่อ สุ่มจุดเริ่มต้น แล้วเลือกทุกรายการลำดับที่ k | รายชื่อยาวหรือเข้ามาต่อเนื่อง และทีมภาคสนามต้องการกฎง่าย ๆ ข้อเดียวไว้ทำตาม | ต้นทุนแทบไม่มี ตราบใดที่การเรียงลำดับไม่เกี่ยวข้องกับสิ่งที่คุณวัดอคติความเป็นคาบ หากรายชื่อวนซ้ำเป็นรอบที่ตรงกับช่วงห่างของคุณ คุณจะได้หน่วยแบบเดิมซ้ำไปเรื่อย ๆ |
| การสุ่มตัวอย่างแบบแบ่งชั้นภูมิ อาศัยความน่าจะเป็น ต้องมีรายชื่อครบ |
ใช่ และมักแคบกว่าแบบง่าย | แบ่งรายชื่อเป็นกลุ่มที่มีความหมาย (ชั้นภูมิ) แล้วสุ่มตัวอย่างภายในทุกกลุ่ม | คุณต้องรายงานแยกตามภูมิภาค คณะ แผนก หรือช่วงอายุ หรือคาดว่าการตอบกลับจะต่างกันมากระหว่างกลุ่ม | ต้นทุนตัวแปรที่ใช้แบ่งกลุ่มต้องอยู่ในรายชื่อก่อนสุ่ม และอัตราการสุ่มที่ไม่เท่ากันต้องถ่วงน้ำหนักตอนวิเคราะห์อคติต่ำ ความเสี่ยงจริงคือการเลือกชั้นภูมิที่ไม่เกี่ยวข้องกับผลที่วัด ซึ่งเพิ่มงานโดยไม่ได้ความแม่นยำเพิ่ม |
| การสุ่มตัวอย่างแบบกลุ่ม อาศัยความน่าจะเป็น ต้องมีรายชื่อกลุ่ม |
ใช่ โดยขยายให้กว้างขึ้นตามค่า design effect | สุ่มเลือกทั้งกลุ่ม (โรงเรียน คลินิก หอผู้ป่วย หมู่บ้าน) แล้วสำรวจทุกคนในกลุ่มที่ถูกเลือก | คุณทำรายชื่อบุคคลไม่ได้ แต่ทำรายชื่อสถานที่ที่พบพวกเขาได้ และค่าเดินทางหรือค่าเตรียมงานเป็นสัดส่วนใหญ่ของงบประมาณ | ต้นทุนความแม่นยำ คนในกลุ่มเดียวกันมักคล้ายกัน การตอบกลับที่เพิ่มแต่ละครั้งจึงให้ข้อมูลใหม่น้อยลงอคติต่ำหากสุ่มเลือกกลุ่ม แต่จำนวนกลุ่มที่น้อยทำให้ผลไม่นิ่งและยากจะยืนยันความน่าเชื่อถือได้ |
| การสุ่มตัวอย่างแบบหลายขั้นตอน อาศัยความน่าจะเป็น ต้องมีรายชื่อกลุ่ม |
ใช่ โดยใช้การถ่วงน้ำหนักและค่า design effect | สุ่มกลุ่มก่อน แล้วสุ่มหน่วยภายในกลุ่มที่ถูกเลือก ตั้งแต่สองขั้นตอนขึ้นไป | การศึกษาระดับอำเภอหรือระดับประเทศ ที่ไม่มีรายชื่อคนชุดเดียว แต่มีหน่วยการปกครอง | ต้นทุนความซับซ้อน ความน่าจะเป็นของการถูกเลือกต่างกันระหว่างหน่วย การวิเคราะห์จึงต้องถ่วงน้ำหนักและต้องมีคนที่ทำเป็นอคติต่ำตามหลักการ แต่ในทางปฏิบัติ ทุกขั้นตอนเป็นโอกาสใหม่ที่ทีมภาคสนามจะคลาดจากแผน |
| การสุ่มตัวอย่างแบบบังเอิญ ไม่อาศัยความน่าจะเป็น ไม่ต้องใช้รายชื่อ |
ไม่ | คุณเลือกใครก็ได้ที่เข้าถึงง่ายที่สุด เช่น ป๊อปอัปบนเว็บไซต์ ชั้นเรียนที่คุณสอน หรือคนที่เดินผ่านบูธ เรียกอีกชื่อว่าการสุ่มตัวอย่างตามความสะดวก | คุณกำลังสำรวจเบื้องต้น ทดลองนำร่องแบบสอบถาม หรือต้องการทิศทางภายในสัปดาห์นี้ มากกว่าตัวเลขที่ยืนยันความน่าเชื่อถือได้ในไตรมาสหน้า | ต้นทุนสิ่งที่กล่าวอ้างได้ คุณสละความสามารถที่จะพูดถึงประชากรอคติการเลือกตัวเอง มีคนที่เข้าถึงง่าย ว่าง และมีส่วนร่วมอยู่แล้วมากเกินสัดส่วน |
| การสุ่มตัวอย่างแบบโควตา ไม่อาศัยความน่าจะเป็น ไม่ต้องใช้รายชื่อ |
ไม่ ดูสมดุลแต่ไม่ได้สุ่ม | ตั้งเป้าหมายให้แต่ละกลุ่ม เช่น ผู้หญิง 50 คนและผู้ชาย 50 คน หรือชนบท 40 คนและเมือง 60 คน แล้วสรรหาจนครบทุกเป้าหมาย | คุณต้องการกลุ่มตัวอย่างที่อย่างน้อยตรงกับประชากรในลักษณะที่มองเห็นได้ อย่างรวดเร็ว โดยไม่มีรายชื่อให้สุ่ม | ต้นทุนการควบคุมว่าใครเข้ามาเติมแต่ละโควตา ผู้สรรหายังคงเป็นคนเลือก และมักเลือกคนที่เข้าหาง่ายอคติอคติจากการคัดเลือกภายในโควตา การจับคู่อายุและเพศไม่ได้ทำให้ทัศนคติของผู้คนเป็นแบบทั่วไป |
| การสุ่มตัวอย่างแบบเจาะจง ไม่อาศัยความน่าจะเป็น ไม่ต้องใช้รายชื่อ |
ไม่ และไม่ได้ตั้งใจจะรองรับ | คุณจงใจเลือกกรณีที่ตรงกับเกณฑ์ที่กำหนด เช่น ผู้เชี่ยวชาญ กรณีสุดขั้ว กรณีทั่วไป กรณีวิกฤต เรียกอีกชื่อว่าการสุ่มตัวอย่างตามดุลยพินิจ | งานเชิงคุณภาพ การสัมภาษณ์ผู้เชี่ยวชาญ กรณีศึกษา และคำถามใดก็ตามที่ความลึกสำคัญกว่าการนับ | ต้นทุนไม่มี หากคุณระบุชัดว่าไม่ได้ตั้งใจนับตั้งแต่แรกอคติมุมมองของผู้วิจัยเองว่าใครนับว่าเกี่ยวข้อง |
| การสุ่มตัวอย่างแบบสโนว์บอล ไม่อาศัยความน่าจะเป็น ไม่ต้องใช้รายชื่อ |
ไม่ | สรรหาผู้เข้าร่วมไม่กี่คน แล้วขอให้แต่ละคนแนะนำคนอื่นที่ตรงตามเกณฑ์ | กลุ่มเป้าหมายซ่อนตัว ถูกตีตรา หายาก หรือไม่มีการขึ้นทะเบียน เช่น แรงงานข้ามชาติ คนที่เลิกใช้บริการ ผู้ค้านอกระบบ ผู้ที่มีโรคหายาก | ต้นทุนเวลา และการควบคุมรูปร่างของกลุ่มตัวอย่าง คุณได้เครือข่ายสังคมของคนที่คุณเริ่มต้นด้วยติดมาด้วยอคติการคบหาคนคล้ายกัน ผู้คนแนะนำคนที่เหมือนตัวเอง ประชากรบางมุมจึงถูกสุ่มมามากเกินไป |
วิธีอ่านตาราง: ห้าวิธีแรกเป็นแบบแผนแบบอาศัยความน่าจะเป็น และสี่วิธีหลังไม่ใช่ การแบ่งข้อนี้ข้อเดียว ไม่ใช่ชื่อของแต่ละวิธี ที่ตัดสินว่าตัวเลขความแม่นยำนั้นซื่อตรงหรือไม่
วิธีการสุ่มตัวอย่างแบบอาศัยความน่าจะเป็นทีละวิธี
การสุ่มตัวอย่างแบบอาศัยความน่าจะเป็นหมายความว่าทุกหน่วยในกรอบมีโอกาสถูกเลือกที่ทราบค่าและไม่เป็นศูนย์ และกลไกการสุ่มเป็นผู้เลือก นี่คือพื้นฐานทั้งหมดของการกล่าวถึงประชากรเป็นตัวเลข แบบแผนห้าแบบครอบคลุมงานวิจัยจริงเกือบทั้งหมด บทความทบทวนในงานวิจัยทางคลินิกและสุขภาพกล่าวถึงตระกูลเดียวกันนี้ด้วยชื่อที่ต่างเล็กน้อย และควรรู้เหตุผลก่อนเจอทั้งสองแบบ: บทความทั้งสองที่อ้างถึงในที่นี้รวมการสุ่มตัวอย่างแบบหลายขั้นตอนไว้ในแบบกลุ่ม แทนที่จะแยกออกมา34
การสุ่มตัวอย่างแบบง่าย
การสุ่มตัวอย่างแบบง่ายให้ทุกหน่วยในรายชื่อมีโอกาสถูกเลือกเท่ากันพอดี คุณใส่หมายเลขให้รายชื่อ สร้างตัวเลขสุ่ม แล้วเลือกหน่วยที่ตรงกับตัวเลขเหล่านั้น
ตัวอย่างการทำ ทะเบียนของมหาวิทยาลัยมีนักศึกษาที่ลงทะเบียน 12,000 คน และคุณต้องการการตอบกลับ 400 รายการ ใส่หมายเลขทะเบียนตั้งแต่ 1 ถึง 12,000 สร้างตัวเลขสุ่มที่ไม่ซ้ำกัน 400 ตัวในช่วงนั้นด้วยสเปรดชีตหรือโปรแกรมสถิติ แล้วเชิญนักศึกษาเหล่านั้น หากคาดว่าอัตราการตอบกลับจะอยู่ที่ร้อยละ 40 ให้สุ่มและเชิญ 1,000 คน เพื่อให้ได้การตอบกลับที่สมบูรณ์ 400 รายการได้จริง
จุดที่ใช้ไม่ได้ เมื่อการตอบกลับ 400 รายการกระจายอยู่ทั่วทะเบียนนักศึกษา 12,000 คน ภาควิชาที่มีนักศึกษา 300 คนจะมีคนอยู่ในกลุ่มตัวอย่างราว 10 คน ซึ่งไม่พอจะรายงานได้ หากกลุ่มย่อยใดต้องปรากฏในผลลัพธ์ของคุณ การสุ่มตัวอย่างแบบง่ายเป็นเครื่องมือที่ผิด และการสุ่มตัวอย่างแบบแบ่งชั้นภูมิคือทางแก้
บันทึกการสุ่มของคุณ ระบุซอฟต์แวร์ที่ใช้ ค่า seed หากมี และวันที่ ประโยคเดียวนี้ทำให้การสุ่มทำซ้ำได้ และผู้ทบทวนก็ถามหาจริง ๆ
การสุ่มตัวอย่างแบบมีระบบ
การสุ่มตัวอย่างแบบมีระบบเลือกทุกหน่วยลำดับที่ k จากรายชื่อที่เรียงลำดับแล้ว หลังจากสุ่มจุดเริ่มต้น นำขนาดรายชื่อหารด้วยจำนวนที่ต้องการเพื่อหาช่วงห่าง k สุ่มเลขระหว่าง 1 ถึง k เป็นจุดเริ่มต้น แล้วนับต่อไปข้างหน้า
ตัวอย่างการทำ โรงพยาบาลอำเภอแห่งหนึ่งบันทึกการมารับบริการผู้ป่วยนอก 9,000 ครั้งในหนึ่งไตรมาส และต้องการสัมภาษณ์ผู้ป่วยขณะออกจากโรงพยาบาล 600 ราย ช่วงห่างคือ 9,000 หารด้วย 600 ดังนั้น k เท่ากับ 15 สุ่มจุดเริ่มต้นระหว่าง 1 ถึง 15 เช่น 7 แล้วสัมภาษณ์การมารับบริการครั้งที่ 7, 22, 37, 52 ไปเรื่อย ๆ ทีมภาคสนามทำตามกฎนี้ได้โดยไม่ต้องใช้แล็ปท็อป ซึ่งเป็นเหตุผลจริงที่วิธีนี้ยังคงใช้กันอยู่
จุดที่ใช้ไม่ได้ ความเป็นคาบ หากรายชื่อมีรอบที่วนซ้ำตรงกับ k คุณจะสุ่มได้ช่องเดิมทุกครั้ง รายชื่อการมารับบริการที่เรียงตามวันของคลินิกซึ่งวนรอบทุก 7 วัน และใช้ช่วงห่างเท่ากับ 7 จะให้คุณเพียงวันเดียวของสัปดาห์และไม่มีวันอื่นเลย ตรวจการเรียงลำดับก่อนกำหนด k และสลับรายชื่อหากลำดับเกี่ยวข้องกับสิ่งที่คุณวัด
การสุ่มตัวอย่างแบบแบ่งชั้นภูมิ
การสุ่มตัวอย่างแบบแบ่งชั้นภูมิแบ่งประชากรเป็นกลุ่มที่ไม่ทับซ้อนกันเรียกว่าชั้นภูมิ แล้วสุ่มกลุ่มตัวอย่างภายในทุกชั้นภูมิ เป็นการยกระดับที่มีประโยชน์ที่สุดสำหรับงานวิจัยส่วนใหญ่ เพราะรับประกันได้ว่าทุกกลุ่มที่คุณต้องรายงานจะปรากฏอยู่จริง
ตัวอย่างการทำพร้อมการคำนวณ องค์กรแห่งหนึ่งมีพนักงาน 4,200 คนในหกจังหวัด และต้องการการตอบกลับ 600 รายการ
- การจัดสรรตามสัดส่วน จังหวัดที่มีพนักงาน 1,400 คน คิดเป็น 1,400 หารด้วย 4,200 หรือหนึ่งในสามของพนักงานทั้งหมด จึงได้หนึ่งในสามของ 600 คือการตอบกลับ 200 รายการ จังหวัดที่มีพนักงาน 210 คนได้ 210 หารด้วย 4,200 คูณ 600 คือการตอบกลับ 30 รายการ ทุกจังหวัดมีตัวแทนตามสัดส่วนขนาดของตน และไม่ต้องถ่วงน้ำหนักตอนวิเคราะห์
- การจัดสรรแบบไม่เป็นสัดส่วน หรือเรียกว่าการสุ่มเกินสัดส่วน การตอบกลับสามสิบรายการน้อยเกินไปที่จะรายงานจังหวัดเล็กนั้นแยกต่างหาก คุณจึงจงใจเก็บจากจังหวัดนั้น 80 รายการแทน และลดจำนวนของจังหวัดที่ใหญ่ที่สุดลงเพื่อชดเชย ตอนนี้ความน่าจะเป็นของการถูกเลือกต่างกันระหว่างจังหวัด คุณจึงต้องถ่วงน้ำหนักข้อมูลกลับให้ตรงกับสัดส่วนจริง ก่อนอ้างตัวเลขใดของทั้งองค์กร การข้ามขั้นตอนนี้คือข้อผิดพลาดที่พบบ่อยที่สุดของการสุ่มตัวอย่างแบบแบ่งชั้นภูมิ
การเลือกชั้นภูมิ เลือกตัวแปรที่เกี่ยวข้องกับผลที่วัดหรือกับว่าใครมีแนวโน้มจะตอบ และมีอยู่ในกรอบของคุณแล้ว ภูมิภาค สถานที่ บทบาท ช่วงอายุงาน หลักสูตร ประเภทแพ็กเกจ และช่วงอายุ คือตัวเลือกที่พบบ่อย ชั้นภูมิที่ไม่เกี่ยวข้องกับผลที่วัดเพิ่มงานบริหารโดยไม่ได้ความแม่นยำเพิ่ม หากตัวแปรที่ใช้แบ่งกลุ่มไม่มีในกรอบ คุณอาจต้องเก็บข้อมูลนั้นในแบบสอบถามแทน คู่มือคำถามด้านประชากรศาสตร์ในแบบสำรวจของเราอธิบายวิธีถามตัวแปรเหล่านั้นโดยไม่เสียผู้ตอบ
การสุ่มตัวอย่างแบบกลุ่ม
การสุ่มตัวอย่างแบบกลุ่มสุ่มเลือกกลุ่มที่มีอยู่ตามธรรมชาติทั้งกลุ่ม แล้วสำรวจทุกคนในกลุ่มที่ถูกเลือก คุณต้องการรายชื่อกลุ่ม ไม่ใช่รายชื่อคน และนี่คือเหตุผลที่วิธีนี้มีอยู่
ตัวอย่างการทำ อำเภอหนึ่งมีโรงเรียนประถมศึกษา 180 แห่ง และไม่มีรายชื่อนักเรียนส่วนกลาง คุณสุ่มเลือกโรงเรียน 24 แห่ง แล้วสำรวจนักเรียนชั้นปีที่ 8 ทุกคนในแต่ละแห่ง คุณไปโรงเรียน 24 แห่งแทนที่จะเป็น 180 แห่ง และไม่ต้องใช้ทะเบียนนักเรียนเลยในการเริ่มต้น
สิ่งที่คุณต้องแลก นักเรียนในโรงเรียนเดียวกันคล้ายกันมากกว่าที่คล้ายนักเรียนทั่วทั้งอำเภอ นักเรียนแต่ละคนที่เพิ่มในโรงเรียนที่เลือกไว้แล้วจึงให้ข้อมูลใหม่น้อยกว่านักเรียนที่เป็นอิสระต่อกัน จำนวนการตอบกลับที่มีผลจริงจึงน้อยกว่าจำนวนการตอบกลับที่ได้จริง การเพิ่มขึ้นของความแปรปรวนนี้คือค่า design effect และต้องวางไว้ในแผนตั้งแต่ต้น ไม่ใช่มาพบตอนวิเคราะห์
จุดที่ใช้ไม่ได้ จำนวนกลุ่มน้อยเกินไป โรงเรียนหกแห่งที่สุ่มมาอาจต่างกันอย่างมาก และผลลัพธ์จะแกว่งตามว่าคุณบังเอิญได้หกแห่งไหน จำนวนกลุ่มมากขึ้นโดยมีคนในแต่ละกลุ่มน้อยลง แทบจะดีกว่าแบบกลับกันเสมอ
การสุ่มตัวอย่างแบบหลายขั้นตอน
การสุ่มตัวอย่างแบบหลายขั้นตอนเลือกในสองขั้นตอนขึ้นไป: เลือกกลุ่มก่อน แล้วเลือกหน่วยภายในกลุ่มที่ถูกเลือก และบางครั้งมีขั้นที่สามภายในหน่วยเหล่านั้นอีก แบบสำรวจครัวเรือนระดับประเทศแทบทุกแบบในโลกสร้างด้วยวิธีนี้
ตัวอย่างการทำ เลือกเขตย่อย 120 เขตจากรายชื่อเขตย่อยระดับประเทศ ในแต่ละเขตที่ถูกเลือก ทีมภาคสนามทำรายชื่อครัวเรือนในพื้นที่จริง แล้วสุ่มเลือก 20 ครัวเรือน ในแต่ละครัวเรือนที่ถูกเลือก สุ่มเลือกผู้ใหญ่หนึ่งคน แทนที่จะปล่อยให้เป็นใครก็ตามที่มาเปิดประตู นี่คือสามขั้นตอน และขั้นสุดท้ายสำคัญ: การปล่อยให้ครัวเรือนเลือกเองว่าใครจะตอบ จะนำอคติจากการคัดเลือกที่แบบแผนนี้ตั้งใจหลีกเลี่ยงกลับมาอีกครั้ง
สิ่งที่คุณต้องแลก แต่ละคนมีความน่าจะเป็นของการถูกเลือกต่างกัน การวิเคราะห์จึงต้องถ่วงน้ำหนัก และการคำนวณความแปรปรวนต้องคำนึงถึงการจัดกลุ่มในทุกขั้นตอน นี่เป็นแบบแผนจริงจังที่ต้องมีคนวิเคราะห์แบบถ่วงน้ำหนักเป็น หากไม่มีใครในโครงการทำได้ ให้เลือกแบบแผนที่ง่ายกว่า แทนที่จะใช้แบบหลายขั้นตอนโดยไม่ถ่วงน้ำหนัก
เจาะลึกสำหรับผู้เชี่ยวชาญ: การสุ่มด้วยความน่าจะเป็นตามสัดส่วนขนาด และเหตุผลที่กลุ่มใหญ่ถูกเลือกบ่อยกว่า
ในตัวอย่างโรงเรียน ทุกโรงเรียนมีโอกาสถูกเลือกเท่ากัน ไม่ว่าจะมีนักเรียน 60 คนหรือ 900 คน ทำให้นักเรียนในโรงเรียนเล็กมีโอกาสเข้ามาอยู่ในกลุ่มตัวอย่างสูงกว่านักเรียนในโรงเรียนใหญ่มาก การวิเคราะห์จึงต้องปรับแก้ในจุดนี้
การเลือกด้วยความน่าจะเป็นตามสัดส่วนขนาดแก้ปัญหานี้ตั้งแต่ขั้นออกแบบ โอกาสถูกเลือกของแต่ละกลุ่มกำหนดตามสัดส่วนจำนวนหน่วยที่กลุ่มนั้นมี โรงเรียนที่มีนักเรียน 900 คนจึงมีโอกาสถูกสุ่มมากกว่าโรงเรียนที่มีนักเรียน 60 คนถึงสิบห้าเท่า จากนั้นคุณเลือกนักเรียนจำนวนเท่ากันจากทุกโรงเรียนที่ถูกเลือก สองขั้นตอนนี้หักล้างกัน และนักเรียนทุกคนในอำเภอจะมีโอกาสถูกเลือกโดยรวมใกล้เคียงกัน นี่คือแนวทางมาตรฐานในแบบสำรวจระดับประเทศ และต้องมีค่าขนาดของทุกกลุ่มในกรอบก่อนสุ่ม
การสุ่มตัวอย่างแบบแบ่งชั้นภูมิกับแบบกลุ่ม: ความต่างในบรรทัดเดียว
สองวิธีนี้ถูกสับสนกันอยู่เสมอ เพราะทั้งคู่เริ่มด้วยการแบ่งประชากรเป็นกลุ่ม ความต่างอยู่ที่สิ่งที่คุณทำต่อจากนั้น
| ประเด็น | การสุ่มตัวอย่างแบบแบ่งชั้นภูมิ | การสุ่มตัวอย่างแบบกลุ่ม |
|---|---|---|
| ใช้กลุ่มใด | สุ่มจากทุกกลุ่ม | เลือกบางกลุ่ม กลุ่มที่เหลือไม่ได้ใช้เลย |
| สุ่มใครภายในกลุ่ม | ส่วนย่อยที่สุ่มจากกลุ่ม | ทุกคนในกลุ่ม หรือสุ่มส่วนย่อยอีกชั้นในแบบหลายขั้นตอน |
| กลุ่มควรเป็นแบบ | ภายในกลุ่มคล้ายกัน และต่างจากกลุ่มอื่น เช่น ภูมิภาค บทบาท หลักสูตร | ภายในกลุ่มหลากหลาย แต่ละกลุ่มเป็นภาพย่อของประชากร เช่น โรงเรียน คลินิก หอผู้ป่วย |
| เหตุผลที่เลือกใช้ | ความแม่นยำ และรับประกันว่ากลุ่มย่อยมีตัวแทน | ต้นทุนและการเข้าถึง เมื่อไม่มีรายชื่อบุคคล |
| ผลต่อความแม่นยำ | มักดีขึ้นเมื่อเทียบกับแบบง่ายที่จำนวนการตอบกลับเท่ากัน | ลดลง เผื่อไว้สำหรับค่า design effect |
| สิ่งที่ต้องมีก่อนเริ่ม | รายชื่อบุคคลครบถ้วน ที่มีตัวแปรสำหรับแบ่งกลุ่มอยู่แล้ว | รายชื่อกลุ่มเท่านั้น |
แบ่งชั้นภูมิ: ทุกกลุ่ม บางคน แบบกลุ่ม: บางกลุ่ม ทุกคน แบบแบ่งชั้นภูมิเน้นความแม่นยำ แบบกลุ่มเน้นการเข้าถึง
วิธีการสุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็นทีละวิธี
การสุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็นหมายความว่าไม่ทราบความน่าจะเป็นของการถูกเลือก เพราะไม่มีกลไกการสุ่มเป็นตัวตัดสินว่าใครถูกเลือก เป็นทางเลือกที่ถูกต้องในสี่สถานการณ์ คือ คุณไม่สามารถสร้างกรอบที่ใช้งานได้ กลุ่มเป้าหมายซ่อนตัว ความเร็วสำคัญกว่าความแม่นยำ หรือคำถามเกี่ยวกับความหมายมากกว่าขนาด
วิธีเหล่านี้ไม่ได้ด้อยกว่า เพียงแต่ตอบคำถามคนละข้อ ความผิดพลาดไม่ใช่การใช้วิธีเหล่านี้ แต่คือการใช้แล้วเขียนประโยคที่มีเพียงกลุ่มตัวอย่างแบบอาศัยความน่าจะเป็นเท่านั้นที่รองรับได้
การสุ่มตัวอย่างแบบบังเอิญ
การสุ่มตัวอย่างแบบบังเอิญ หรือเรียกว่าการสุ่มตัวอย่างตามความสะดวก สรรหาใครก็ได้ที่เข้าถึงง่ายที่สุด เช่น ป๊อปอัปบนเว็บไซต์ ลิงก์ในจดหมายข่าว นักศึกษาในชั้นเรียนของคุณเอง หรือคนที่เดินผ่านแผงในตลาด
ตัวอย่าง ร้านค้าแห่งหนึ่งพิมพ์ลิงก์ขอความคิดเห็นไว้บนใบเสร็จ ทุกคนที่ตอบล้วนซื้อของ มีโทรศัพท์ติดตัว มีเวลา และมีเหตุผลที่จะตอบ ตัวกรองแต่ละข้อตัดลูกค้าคนละส่วนออกไป
การใช้อย่างซื่อตรง ทดลองนำร่องแบบสอบถาม ตั้งสมมติฐาน หาว่าลูกค้าใช้ภาษาแบบไหน ตรวจว่าคำถามเข้าใจได้ ล้วนเป็นการใช้ที่ดีเยี่ยม และไม่มีข้อใดต้องการการประมาณค่าประชากร
การสุ่มตัวอย่างแบบโควตา
การสุ่มตัวอย่างแบบโควตาตั้งเป้าการสรรหาให้กลุ่มที่ระบุ แล้วเก็บให้ครบ เช่น ชนบทสี่สิบคนและเมืองหกสิบคน ผู้หญิงห้าสิบคนและผู้ชายห้าสิบคน หรือช่วงอายุละยี่สิบคนในห้าช่วงอายุ
ตัวอย่าง ทีมวิจัยการตลาดต้องการการตอบกลับ 500 รายการ ที่มีสัดส่วนอายุ เพศ และภูมิภาคตรงกับระดับประเทศ และไม่มีรายชื่อประชากร ทีมจึงสรรหาจนทุกช่องครบ
ทำไมยังไม่ใช่การสุ่มตัวอย่างแบบอาศัยความน่าจะเป็น โควตาควบคุมรูปร่างของกลุ่มตัวอย่าง ไม่ใช่การคัดเลือกคนที่อยู่ในนั้น ผู้สรรหายังคงเป็นคนเลือก และคนที่เข้าหาง่ายย่อมต่างจากคนที่เข้าหายากอย่างเป็นระบบ กลุ่มตัวอย่างอาจตรงกับประชากรทุกประการในเรื่องอายุและเพศ แต่ยังผิดพลาดอย่างมากเรื่องทัศนคติ เพราะอายุและเพศไม่เคยเป็นตัวแปรที่ก่อความเสียหายตั้งแต่แรก
การสุ่มตัวอย่างแบบเจาะจง
การสุ่มตัวอย่างแบบเจาะจง หรือเรียกว่าการสุ่มตัวอย่างตามดุลยพินิจ จงใจเลือกกรณีที่ตรงตามเกณฑ์ที่กำหนด แบบที่พบบ่อย ได้แก่ การเลือกกรณีทั่วไป กรณีสุดขั้ว กรณีวิกฤต กรณีที่หลากหลายที่สุด และการเลือกผู้เชี่ยวชาญ
ตัวอย่าง การศึกษาว่าระบบชำระเงินใหม่ถูกใช้อย่างไร เลือกคนแปดคน คือ สองคนที่ใช้ทุกวัน สองคนที่เลิกใช้ สองคนที่ไม่เคยเริ่มใช้ และพนักงานฝ่ายช่วยเหลือสองคนที่รับเรื่องร้องเรียน การกระจายนี้เลือกโดยตั้งใจ และเหตุผลของการเลือกก็คือวิธีการนั่นเอง
การใช้อย่างซื่อตรง งานวิจัยเชิงคุณภาพส่วนใหญ่ มาตรฐานในที่นี้ไม่ใช่ความสุ่ม แต่คือคุณบอกได้หรือไม่ว่าทำไมจึงเป็นกรณีเหล่านี้และไม่ใช่กรณีอื่น และความหลากหลายของมุมมองกว้างพอจะรองรับข้อกล่าวอ้างของคุณหรือไม่
การสุ่มตัวอย่างแบบสโนว์บอล
การสุ่มตัวอย่างแบบสโนว์บอลสรรหาผู้เข้าร่วมจำนวนน้อย แล้วให้พวกเขาแนะนำคนอื่นที่ตรงตามเกณฑ์ และคนเหล่านั้นก็แนะนำต่อไปอีก
ตัวอย่าง การศึกษาผู้ค้านอกระบบข้ามพรมแดนเริ่มจากผู้เข้าร่วมสี่คนที่พบผ่านสมาคมในท้องถิ่น และแต่ละคนแนะนำเพิ่มอีกสองคน ไม่มีทะเบียนผู้ค้านอกระบบ จึงไม่มีวิธีที่อาศัยกรอบให้ใช้ได้
ผลต่อกลุ่มตัวอย่างของคุณ การคบหาคนคล้ายกัน ผู้คนแนะนำคนที่เหมือนตัวเอง กลุ่มตัวอย่างจึงเอนไปทางเครือข่ายสังคมเดียว และห่างจากสมาชิกของประชากรที่โดดเดี่ยว ซึ่งมักเป็นกลุ่มที่งานวิจัยต้องการรับฟังมากที่สุด การเริ่มจากจุดตั้งต้นหลายจุดที่ไม่เชื่อมโยงกันแทนจุดเดียวช่วยลดการเอนเอียงนี้ได้ แต่ไม่ได้ขจัดไป
วิธีทำให้กลุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็นอธิบายได้อย่างมีน้ำหนัก
คู่มือส่วนใหญ่หยุดอยู่ที่ “คุณอ้างอิงไปยังประชากรไม่ได้” แล้วทิ้งผู้อ่านไว้กลางทาง ทั้งที่ผู้อ่านส่วนใหญ่กำลังทำการศึกษาแบบนี้อยู่พอดี นี่คือส่วนที่มักหายไป
- อธิบายการสรรหา ไม่ใช่แค่ชื่อวิธี ลิงก์โพสต์ไว้ที่ไหน ช่วงวันที่ใด ใครเห็น มีสิ่งจูงใจหรือไม่ และติดต่อไปกี่คนเทียบกับตอบกลับกี่คน สิ่งนี้ทำให้ผู้อ่านประเมินกลุ่มตัวอย่างได้แทนการเดา
- เทียบกลุ่มตัวอย่างที่ได้จริงกับค่าอ้างอิงที่ทราบ แล้วเผยแพร่การเปรียบเทียบนั้น หากองค์กรของคุณมีพนักงานภาคสนามร้อยละ 60 แต่ผู้ตอบของคุณเป็นพนักงานภาคสนามร้อยละ 25 ให้ระบุไว้ในตาราง ความเบ้ที่ระบุไว้คือข้อค้นพบ ความเบ้ที่ซ่อนไว้คือข้อบกพร่อง
- รู้ว่าการถ่วงน้ำหนักทำอะไรได้และไม่ได้ การปรับข้อมูลให้ลักษณะประชากรศาสตร์ตรงกับประชากรแก้ความไม่สมดุลที่มองเห็นได้ แต่แก้ไม่ได้ในกรณีที่คนต่างจากผู้ตอบในเรื่องที่คุณไม่ได้วัด และไม่มีทางเปลี่ยนกลุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็นให้รองรับการกล่าวอ้างความแม่นยำได้
- เปลี่ยนประโยค ไม่ใช่เปลี่ยนสถิติ แทนที่จะเขียนว่า “ลูกค้าร้อยละ 38 ไม่พึงพอใจ บวกลบ 4 จุด” ให้เขียนว่า “ร้อยละ 38 ของลูกค้า 620 รายที่ตอบกลับรายงานว่าไม่พึงพอใจ ผู้ตอบได้รับการสรรหาผ่านข้อความแจ้งในแอปเป็นเวลาสองสัปดาห์ และไม่ใช่กลุ่มตัวอย่างสุ่มของลูกค้า” ประโยคที่สองสั้นกว่า มีประโยชน์กว่า และไม่มีช่องให้โจมตี
งานเชิงคุณภาพมีคำศัพท์เฉพาะสำหรับเรื่องนี้ โครงร่างการวิจัยมักขอเหตุผลรองรับมากกว่าเป้าหมายเชิงตัวเลข และควรครอบคลุมทั้งจำนวนที่ตั้งใจและความหลากหลายของมุมมอง ซึ่งคู่มือของ University of Bath อธิบายความแตกต่างนี้ไว้อย่างกระชับ5
จับคู่วิธีการให้ตรงกับสถานการณ์
หกสถานการณ์ หกวิธี ตัดสินใจก่อนเปิดดูคำตอบ นี่คือวิธีที่เร็วที่สุดที่จะรู้ว่าตารางด้านบนเข้าใจแล้วจริงหรือไม่
1. คุณมีทะเบียนพนักงานครบถ้วน 4,200 คน และต้องเผยแพร่ผลลัพธ์ของแต่ละจังหวัดทั้งหกจังหวัด
การสุ่มตัวอย่างแบบแบ่งชั้นภูมิ มีรายชื่อครบอยู่แล้ว คุณจึงใช้การสุ่มตัวอย่างแบบอาศัยความน่าจะเป็นได้ และหน้าที่ต้องรายงานแยกตามจังหวัดตรงกับจุดประสงค์ของการแบ่งชั้นภูมิพอดี การสุ่มตัวอย่างแบบง่ายจะทำให้จังหวัดที่เล็กที่สุดมีการตอบกลับน้อยเกินกว่าจะรายงานได้
2. คุณกำลังศึกษาคนที่เลิกใช้บริการเมื่อหกเดือนก่อน ไม่มีรายชื่อ และคนที่เลิกใช้เพราะโกรธที่สุดก็หาตัวยากที่สุด
การสุ่มตัวอย่างแบบสโนว์บอล ไม่มีกรอบและประชากรเข้าถึงยาก ซึ่งตัดวิธีแบบอาศัยความน่าจะเป็นออกทั้งหมด เริ่มจากจุดตั้งต้นหลายจุดที่ไม่เชื่อมโยงกันแทนจุดเดียว และระบุในส่วนข้อจำกัดว่าสายการแนะนำทำให้กลุ่มตัวอย่างเอนไปทางคนที่มีเครือข่าย
3. โรงพยาบาลต้องการข้อมูลประสบการณ์ผู้ป่วยจากการมารับบริการ 9,000 ครั้งต่อไตรมาสที่เข้ามาต่อเนื่อง โดยให้เจ้าหน้าที่ที่ไม่มีคอมพิวเตอร์ที่เคาน์เตอร์เป็นผู้เก็บ
การสุ่มตัวอย่างแบบมีระบบ ประชากรเข้ามาเป็นสายต่อเนื่องที่มีลำดับ กฎช่วงห่างจึงเป็นทั้งวิธีแบบอาศัยความน่าจะเป็น และเป็นสิ่งที่เคาน์เตอร์ที่ยุ่งทำได้จริง ตรวจก่อนว่าลำดับการมารับบริการไม่ได้เป็นรอบรายสัปดาห์ที่ตรงกับช่วงห่างของคุณ
4. คุณต้องเข้าใจว่าทำไมเครื่องมือใหม่จึงถูกเลิกใช้ และคุณมีเวลาสามสัปดาห์โดยไม่มีงบประมาณ
การสุ่มตัวอย่างแบบเจาะจง คำถามเกี่ยวกับกลไก ไม่ใช่ขนาด เลือกอย่างตั้งใจให้ครอบคลุมทุกแบบ ได้แก่ ผู้ใช้หนัก ผู้ที่เลิกใช้ ผู้ที่ไม่เคยเริ่มใช้ และพนักงานฝ่ายช่วยเหลือ อย่ารายงานค่าร้อยละจากกลุ่มตัวอย่างนี้
5. อำเภอหนึ่งมีโรงเรียน 180 แห่ง ไม่มีทะเบียนนักเรียน และงบเดินทางพอสำหรับการลงพื้นที่ราว 25 แห่ง
การสุ่มตัวอย่างแบบกลุ่ม มีรายชื่อโรงเรียน แม้จะไม่มีรายชื่อนักเรียน และค่าเดินทางคือข้อจำกัดหลัก ขยายช่วงที่รายงานให้กว้างขึ้นตามค่า design effect และเลือกโรงเรียนจำนวนมากขึ้นโดยมีนักเรียนน้อยลงในแต่ละแห่ง ดีกว่าแบบกลับกัน
6. คุณต้องเก็บการตอบกลับ 500 รายการภายในห้าวัน ให้ตรงกับโครงสร้างอายุและภูมิภาคของประเทศ และไม่มีรายชื่อประชากร
การสุ่มตัวอย่างแบบโควตา เป็นวิธีที่เร็วที่สุดที่จะได้กลุ่มตัวอย่างที่อย่างน้อยตรงกับประชากรในลักษณะที่มองเห็นได้ แต่ยังไม่ใช่กลุ่มตัวอย่างแบบอาศัยความน่าจะเป็น จึงให้รายงานองค์ประกอบของกลุ่มตัวอย่าง และงดการกล่าวอ้างความแม่นยำ
วิธีเลือกวิธีการสุ่มตัวอย่าง
งานวิจัยส่วนใหญ่ไม่ได้ล้มเหลวเพราะมีคนเลือกเทคนิคผิดชื่อ แต่ล้มเหลวเพราะเทคนิคไม่เข้ากับกรอบ การตัดสินใจ หรือสิ่งที่ทีมภาคสนามทำได้จริง คำถามสามข้อตัดสินเรื่องนี้ได้แทบทุกครั้ง
วิธีใดเหมาะกับการศึกษาของคุณ?
ตอบคำถามสามข้อ คำแนะนำจะแสดงด้านล่าง และแถวที่ตรงกันจะถูกไฮไลต์ในตารางเปรียบเทียบ
เริ่มจากข้อกล่าวอ้างที่คุณต้องการ
เขียนประโยคที่คุณต้องการเผยแพร่ก่อนเลือกสิ่งใด “ลูกค้าของเราร้อยละหกสิบสองจะแนะนำเราต่อ” กับ “ลูกค้าที่เลิกใช้เล่าถึงปัญหาที่เกิดซ้ำสามเรื่อง” เป็นคนละประโยคที่ต้องใช้แบบแผนต่างกัน หากไม่มีใครจะใช้ผลเป็นตัวเลขของประชากร คุณมีอิสระมากกว่าที่คิด
ตรวจสอบกรอบก่อนตัดสินใจ
คุณทำรายชื่อประชากรหรือสิ่งที่ใกล้เคียงได้จริงหรือไม่? หากไม่ได้ คุณทำรายชื่อกลุ่มที่พวกเขาสังกัดได้หรือไม่? การตอบคำถามข้อนี้ข้อเดียวตัดวิธีส่วนใหญ่จากเก้าวิธีออกได้ทันที นี่จึงเป็นข้อที่สอง ไม่ใช่ข้อสุดท้าย
ระบุกลุ่มย่อยที่คุณต้องรายงาน
หากต้องแสดงผลแยกตามภูมิภาค สถานที่ หรือบทบาท สิ่งนี้จะกำหนดแบบแผนผ่านชั้นภูมิหรือโควตา และกำหนดจำนวนการตอบกลับที่ต้องการในแต่ละกลุ่มด้วย การตัดสินใจเรื่องนี้หลังเก็บข้อมูลภาคสนามแล้วจะแก้ไขไม่ได้
ตรวจแบบแผนกับสภาพจริงในภาคสนาม
เวลา งบประมาณ ความสามารถในการติดต่อ การเข้าถึงด้านภาษา การอ่านออกเขียนได้ การเชื่อมต่ออินเทอร์เน็ต และนโยบายสิ่งจูงใจ เป็นตัวตัดสินว่าอะไรทำได้จริง แบบแผนที่ทีมภาคสนามทำตามไม่ได้จะกลายเป็นการสุ่มตัวอย่างแบบบังเอิญที่มีชื่อทางการแปะไว้ ซึ่งแย่กว่าการเลือกแบบบังเอิญอย่างตรงไปตรงมา การวางแผนการสรรหาอย่างครอบคลุมช่วยลดการมีตัวแทนน้อยเกินไปอย่างเป็นระบบ6 เมื่อเลือกกลุ่มตัวอย่างแล้ว ให้ใช้เครื่องมือสร้างแบบสำรวจออนไลน์เตรียมแบบสอบถามและส่งให้คนที่ถูกเลือกตามแผนการสุ่มตัวอย่างของคุณ การแชร์ลิงก์สาธารณะที่ไม่จำกัดผู้ตอบจะเปลี่ยนว่าใครตอบได้ และไม่ได้รักษากลุ่มตัวอย่างสุ่มไว้
จุดที่กลุ่มตัวอย่างผิดพลาดจริง: การครอบคลุม การคัดเลือก และการไม่ตอบกลับ
การคัดเลือกเป็นส่วนที่ทุกคนกังวล และเป็นส่วนที่ผิดพลาดน้อยที่สุด ความเสียหายมักเกิดก่อนการคัดเลือก คือที่กรอบ หรือหลังการคัดเลือก คือที่ว่าใครยอมตอบ ทั้งสองแบบให้สเปรดชีตที่ดูเรียบร้อยแต่ข้อสรุปผิด
| ความคลาดเคลื่อน | ลักษณะที่พบ | วิธีลด |
|---|---|---|
| ความคลาดเคลื่อนจากการครอบคลุม ปัญหาของกรอบ | บางคนไม่มีทางถูกเลือกเลย เช่น ไม่มีอีเมลที่ทำงาน รายชื่อที่ล้าสมัย ลูกค้าที่ซื้อหน้าร้านเท่านั้น ครัวเรือนที่ไม่มีอินเทอร์เน็ต | ปรับปรุงหรือรวมกรอบหลายชุด เพิ่มช่องทาง เช่น กระดาษ พบตัว โทรศัพท์ SMS บันทึกให้ชัดว่าใครถูกตัดออก |
| อคติจากการคัดเลือก ปัญหาของขั้นตอน | กฎการสุ่มถูกละเลยในทางปฏิบัติ มาก่อนได้ก่อน ผู้จัดการเสนอชื่อคนที่จะเข้าร่วม | ให้ระบบสุ่มอัตโนมัติ แยกคนที่คัดเลือกออกจากคนที่สรรหา ตรวจสอบทุกกรณียกเว้น |
| อคติจากการไม่ตอบกลับ ปัญหาของผลลัพธ์ | คนที่ถูกเลือกไม่ตอบ และคนที่ไม่ตอบต่างจากคนที่ตอบในเรื่องที่คุณวัด | ปรับปรุงวิธีติดต่อและประสบการณ์การตอบแบบสอบถาม แล้วเทียบผู้ตอบกับค่าอ้างอิงที่ทราบ ดูอคติในการตอบ |
| ความคลาดเคลื่อนจากการวัด | กลุ่มตัวอย่างที่ไร้ที่ติก็ยังให้ข้อมูลไร้สาระได้ หากคำถามชี้นำ คลุมเครือ หรือถามสองเรื่องในข้อเดียว | ทดสอบเครื่องมือก่อนลงภาคสนาม คู่มือการเขียนคำถามแบบสำรวจของเราครอบคลุมข้อบกพร่องที่พบบ่อย |
ความล้มเหลวด้านการสุ่มตัวอย่างที่โด่งดังที่สุดมีผู้ตอบ 2.4 ล้านคน
ในปี 1936 นิตยสาร Literary Digest ทำนายว่า Alf Landon จะได้คะแนนเสียงราวร้อยละ 55 แต่ Franklin Roosevelt ชนะด้วยคะแนนราวร้อยละ 617 นิตยสารส่งบัตรลงคะแนนทางไปรษณีย์ 10 ล้านใบ และได้คืนมาราว 2.4 ล้านใบ คิดเป็นอัตราการตอบกลับร้อยละ 24 ซึ่งไม่มีโพลระดับประเทศในปัจจุบันใดเข้าใกล้ได้8 โพลนี้ให้ Roosevelt ต่ำกว่าส่วนแบ่งจริงยี่สิบจุด จากกลุ่มตัวอย่างสองล้านห้าแสนคน
ตัวเลขที่ควรอยู่ในทุกหน้าที่พูดถึงการสุ่มตัวอย่าง การวิเคราะห์ซ้ำในภายหลังคำนวณค่าความคลาดเคลื่อนจากการสุ่มตัวอย่างของค่าประมาณระดับรัฐของ Digest ได้ตั้งแต่ 0.18 ถึง 2.3 จุดเปอร์เซ็นต์ โดยมีค่ามัธยฐาน 0.68 ตัวเลขความแม่นยำบวกลบครึ่งจุด ซ้อนอยู่บนความคลาดเคลื่อนยี่สิบจุด ไม่มีอะไรแสดงได้ชัดกว่านี้ว่าค่าความคลาดเคลื่อนวัดได้เพียงหนึ่งในหลายทางที่แบบสำรวจจะผิดพลาดได้
และคำอธิบายมาตรฐานก็ถูกเพียงครึ่งเดียว ทุกคนถูกสอนว่า Digest สุ่มตัวอย่างจากเจ้าของรถยนต์และผู้ใช้โทรศัพท์ ซึ่งร่ำรวยและสนับสนุนพรรครีพับลิกัน การทดสอบเชิงประจักษ์ครั้งหนึ่งต่อข้อกล่าวอ้างนี้ใช้แบบสำรวจของ Gallup จากเดือนพฤษภาคม 1937 คนที่มีทั้งรถยนต์และโทรศัพท์ยังคงเลือก Roosevelt มากกว่า 55 ต่อ 45 ในบรรดาคนที่บอกว่าได้รับบัตรลงคะแนนของ Digest Roosevelt นำ 55 ต่อ 44 กรอบเอนไปทางพรรครีพับลิกันจริง แต่ไม่มากพอจะทำให้ Landon ชนะถล่มทลาย7
อีกครึ่งที่หายไปคือการไม่ตอบกลับ ในบรรดาคนที่บอกว่าส่งบัตรคืน Landon นำ 51 ต่อ 48 ในบรรดาคนที่ไม่ได้ส่งคืน Roosevelt นำ 69 ต่อ 30 การแยกองค์ประกอบคร่าว ๆ ให้ความคลาดเคลื่อนราวสิบเอ็ดจุดมาจากกรอบ และราวเจ็ดจุดมาจากการไม่ตอบกลับที่ต่างกันระหว่างกลุ่ม7 การถ่วงน้ำหนักบัตรที่ได้คืนด้วยคำถามที่ Digest ถามไว้แล้ว คือคุณลงคะแนนอย่างไรในปี 1932 จะได้ผู้ชนะที่ถูกต้อง ด้วยการคำนวณที่ทำได้อยู่แล้วในปี 19368
อัตราการตอบกลับที่สูงไม่ใช่เป้าหมายอย่างที่คุณคิด
อัตราการตอบกลับของโพลทางโทรศัพท์ของ Pew Research Center เองลดลงจากร้อยละ 36 ในปี 1997 เหลือร้อยละ 9 ในปี 2012 และร้อยละ 6 ในปี 20189 ขณะเดียวกัน แบบสำรวจสุขภาพครอบครัวแห่งชาติของอินเดียซึ่งเก็บข้อมูลแบบพบตัว เลือกครัวเรือน 664,972 ครัวเรือน และพบว่ามีผู้อยู่อาศัย 653,144 ครัวเรือน สัมภาษณ์ได้ 636,699 ครัวเรือน คิดเป็นอัตราการตอบกลับร้อยละ 97.5 อ่านตัวหารให้ดี เพราะเป็นจุดที่อัตราการตอบกลับผิดพลาดบ่อยที่สุด หากเทียบกับจำนวนที่เลือกแทนจำนวนที่มีผู้อยู่อาศัย งานภาคสนามเดียวกันจะได้ร้อยละ 95.7 แบบสำรวจนี้สุ่มกลุ่มตัวอย่างจาก 30,456 กลุ่ม ครอบคลุมทั้ง 707 อำเภอ10
ข้อเท็จจริงสองข้อนี้อยู่ในทศวรรษเดียวกัน ช่องทางและความพยายามในภาคสนามกำหนดอัตราการตอบกลับมากกว่าข้อกล่าวอ้างทั่วไปเรื่องความเบื่อหน่ายต่อแบบสำรวจมาก หากคู่มือใดบอกว่าอัตราการตอบกลับเฉลี่ยเป็นตัวเลขเดียว คู่มือนั้นไม่ได้อธิบายปริมาณที่มีอยู่จริง
ต่อไปคือข้อค้นพบที่ยากกว่า การวิเคราะห์อภิมานของค่าประมาณอคติจากการไม่ตอบกลับ 235 ค่า จากการศึกษาที่ตีพิมพ์ 30 เรื่อง พบว่าสหสัมพันธ์ระหว่างอัตราการตอบกลับกับขนาดของอคติจากการไม่ตอบกลับเท่ากับ 0.33 เมื่อยกกำลังสอง หมายความว่าอัตราการตอบกลับอธิบายความแปรผันของอคติได้ราวร้อยละ 1111 การศึกษาติดตามผลจาก 59 การศึกษาที่ออกแบบมาเพื่อวัดอคติจากการไม่ตอบกลับโดยเฉพาะได้ข้อสรุปเดียวกัน12
อัตราการตอบกลับควรรายงานและควรปรับปรุง แต่ไม่ใช่ใบรับประกันคุณภาพ สิ่งที่ก่อให้เกิดอคติคือแนวโน้มที่จะตอบผูกอยู่กับสิ่งที่คุณวัดหรือไม่ แบบสำรวจเรื่องงานอาสาสมัครเจอปัญหานี้มากกว่าแบบสำรวจเรื่องความเร็วอินเทอร์เน็ตบรอดแบนด์มาก ให้ติดตามสหสัมพันธ์ ไม่ใช่ค่าร้อยละ
การตอบกลับที่มากขึ้นซ่อมกรอบที่เสียไม่ได้
ระหว่างการฉีดวัคซีนในปี 2021 แบบสำรวจขนาดใหญ่มากสองแบบติดตามอัตราการรับวัคซีนในสหรัฐอเมริกา แบบแรกเก็บการตอบกลับราว 250,000 รายการต่อสัปดาห์ และประเมินอัตราการรับวัคซีนเข็มแรกสูงเกินจริง 17 จุดเปอร์เซ็นต์เมื่อเทียบกับค่าอ้างอิงทางการ แบบที่สองเก็บราว 75,000 รายการทุกสองสัปดาห์ และประเมินสูงเกินจริง 14 จุด แบบสำรวจที่สามซึ่งมีผู้ตอบราว 1,000 คน และทำตามแนวปฏิบัติมาตรฐานของการสุ่มแบบอาศัยความน่าจะเป็น ให้ค่าประมาณที่เชื่อถือได้13
รูปแบบเดียวกันนี้ปรากฏในงานแบบสำรวจทั่วไป เมื่อเปรียบเทียบพาเนลแบบอาศัยความน่าจะเป็นสามแหล่งกับแหล่งออนไลน์แบบสมัครใจเข้าร่วมสามแหล่ง บนค่าอ้างอิง 28 ค่าและการสัมภาษณ์ 29,937 ครั้ง ความคลาดเคลื่อนสัมบูรณ์เฉลี่ยของกลุ่มตัวอย่างแบบสมัครใจเข้าร่วมเท่ากับ 5.8 จุดเปอร์เซ็นต์ และของพาเนลแบบอาศัยความน่าจะเป็นเท่ากับ 2.6 สำหรับค่าอ้างอิง 25 ค่าในจำนวนนั้นที่มีข้อมูลกลุ่มย่อย ช่องว่างในกลุ่มผู้ใหญ่อายุ 18 ถึง 29 ปีเท่ากับ 11.2 เทียบกับ 3.614
และตัวบ่งชี้ที่น่าจดจำ: ในแบบสำรวจแบบสมัครใจเข้าร่วมครั้งหนึ่ง ผู้ใหญ่อายุต่ำกว่า 30 ปีร้อยละ 12 บอกว่าตนมีใบอนุญาตขับเรือดำน้ำนิวเคลียร์15 ตัวเลขจริงใกล้ศูนย์ หากพาเนลใดให้ผลแบบนี้ได้ ก็ให้ผลแบบไหนก็ได้ และการสั่งจำนวนมากขึ้นจากพาเนลเดิมก็เพียงได้สิ่งเดิมมากขึ้น
กรอบของคุณตกหล่นใคร นอกสหรัฐอเมริกาและสหราชอาณาจักร
คู่มือการสุ่มตัวอย่างส่วนใหญ่สันนิษฐานอย่างเงียบ ๆ ว่าใช้กรอบแบบตะวันตก เช่น รายชื่ออีเมล โทรศัพท์บ้าน หรือทะเบียนที่อยู่ระดับประเทศ แต่หลายพื้นที่ในโลกไม่ได้สุ่มตัวอย่างแบบนั้น และช่องว่างของการครอบคลุมก็มีรูปแบบที่วัดได้
- แบบสำรวจออนไลน์ในประเทศรายได้ต่ำหรือปานกลางคือกลุ่มตัวอย่างของส่วนที่เชื่อมต่ออินเทอร์เน็ตเท่านั้น และส่วนนั้นเอนไปทางผู้ชาย ผู้หญิงในประเทศรายได้ต่ำและปานกลางมีโอกาสใช้อินเทอร์เน็ตบนมือถือน้อยกว่าผู้ชายร้อยละ 14 คิดเป็นผู้หญิงที่ออนไลน์น้อยกว่าผู้ชายราว 235 ล้านคน16
- กลุ่มตัวอย่างทางโทรศัพท์มีหัวหน้าครัวเรือนมากเกินสัดส่วน ในแบบสำรวจทางโทรศัพท์ของ World Bank ในสี่ประเทศแอฟริกา ผู้ตอบเป็นผู้ชายร้อยละ 52 ในยูกันดา และร้อยละ 73 ในไนจีเรีย เทียบกับราวครึ่งหนึ่งของประชากรผู้ใหญ่ ในยูกันดา ผู้ตอบทางโทรศัพท์ร้อยละ 6 มีอายุ 15 ถึง 24 ปี เทียบกับร้อยละ 38 ของประชากรผู้ใหญ่17
- สิ่งที่ควรทำ ผสมหลายช่องทางแทนการยึดช่องทางเดียว ทำรายชื่อครัวเรือนในพื้นที่จริงในที่ที่ไม่มีทะเบียน เก็บข้อมูลในภาษาที่ประชากรของคุณอ่านจริง และทดสอบคำแปลกับผู้ตอบล่วงหน้าแทนการแปลย้อนกลับ จากนั้นระบุช่องว่างที่เหลืออยู่ในส่วนข้อจำกัด เพราะช่องว่างนั้นจะยังคงอยู่
สิ่งที่การถ่วงน้ำหนักแก้ได้และแก้ไม่ได้
การถ่วงน้ำหนักปรับข้อมูลให้องค์ประกอบของกลุ่มตัวอย่างตรงกับตัวเลขประชากรที่ทราบ เป็นเครื่องมือที่ทรงพลังจริง และก็ถูกยกย่องเกินจริงเป็นประจำ
เหตุผลที่ควรใช้ ในปี 2016 โพลสุดท้ายของ University of New Hampshire ให้ Clinton นำ 11 จุด ในการแข่งขันที่เธอชนะเพียง 0.4 จุด โพลนั้นไม่ได้ปรับตามระดับการศึกษา คณะกรรมการทบทวนสรุปว่าการปรับเพียงข้อเดียวนี้จะขจัดความคลาดเคลื่อนได้แทบทั้งหมด18 ตัวแปรเดียวที่สัมพันธ์ทั้งกับการตอบและผลลัพธ์ ทำงานทั้งหมดได้
เหตุผลที่ไม่ควรพึ่งพา เมื่อนำการสัมภาษณ์ออนไลน์แบบสมัครใจเข้าร่วมกว่า 30,000 ครั้งมาเทียบกับค่าอ้างอิง 24 ค่า อคติประมาณการเฉลี่ยเท่ากับ 8.4 จุดเปอร์เซ็นต์เมื่อไม่ถ่วงน้ำหนัก และไม่มีวิธีถ่วงน้ำหนักใดที่ทดสอบ รวมถึงวิธีจับคู่ที่ซับซ้อน ที่ลดอคติเฉลี่ยได้ต่ำกว่า 6 จุด19 การเพิ่มขนาดกลุ่มตัวอย่างเป็นสี่เท่าได้เพิ่มมาอีกเพียง 0.2 จุด
กฎที่ตามมานั้นเรียบง่าย การถ่วงน้ำหนักแก้ความไม่สมดุลของตัวแปรที่คุณใช้ถ่วงน้ำหนัก ตามขอบเขตที่ตัวแปรเหล่านั้นสัมพันธ์กับผลลัพธ์ แต่ไม่ได้ช่วยอะไรเลยในเรื่องที่ผู้ตอบต่างจากผู้ไม่ตอบในสิ่งที่คุณไม่เคยวัด และไม่มีทางเปลี่ยนกลุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็นให้รองรับการกล่าวอ้างความแม่นยำได้
ตัวเลขความแม่นยำคือพื้น ไม่ใช่เพดาน
ค่าความคลาดเคลื่อนวัดความแปรปรวนจากการสุ่มตัวอย่าง และวัดเพียงเท่านั้น โดยสันนิษฐานว่ากลุ่มตัวอย่างถูกสุ่มจากประชากรเป้าหมาย และอคติที่เหลือถูกขจัดไปแล้ว ความคลาดเคลื่อนจากการครอบคลุม อคติจากการไม่ตอบกลับ ความคลาดเคลื่อนจากการวัด และผู้ตอบที่ฉ้อโกง ล้วนอยู่นอกค่านี้ทั้งหมด
หลักฐานชัดเจนตรงไปตรงมา ในสองสัปดาห์สุดท้ายของปี 2020 โพลประธานาธิบดีระดับรัฐ 348 โพลรายงานค่าความคลาดเคลื่อน โดยค่าเฉลี่ยที่รายงานเท่ากับ 3.9 จุด เมื่อวัดเทียบกับค่าเฉลี่ยนั้น ร้อยละ 55 ของโพลเหล่านั้นพลาดผลต่างคะแนนจริงมากกว่าหนึ่งเท่าของค่าความคลาดเคลื่อน และร้อยละ 21 พลาดมากกว่าสองเท่า20 นี่คือโพลสมัยใหม่ที่ใช้วิธีสมัยใหม่ ให้ถือว่าค่าความคลาดเคลื่อนเป็นพื้นของความไม่แน่นอน ไม่ใช่เพดาน
| ข้อกล่าวอ้าง | ตัวเลข | ระดับหลักฐาน | แหล่งที่มา |
|---|---|---|---|
| อัตราการตอบกลับแทบทำนายอคติจากการไม่ตอบกลับไม่ได้ | r = 0.33 คือราว 11% ของความแปรผัน จากค่าประมาณ 235 ค่าใน 30 การศึกษา | A | Groves, 200611 |
| แบบสำรวจขนาดใหญ่มากก็ผิดพลาดได้มาก | ประเมินอัตราการรับวัคซีนสูงเกินจริง 17 จุด จากการตอบกลับราว 250,000 รายการต่อสัปดาห์ | A | Bradley และคณะ, 202113 |
| กลุ่มตัวอย่างแบบสมัครใจเข้าร่วมคลาดเคลื่อนมากกว่าพาเนลแบบอาศัยความน่าจะเป็นราวสองเท่า | ความคลาดเคลื่อนเฉลี่ย 5.8 เทียบกับ 2.6 จุดเปอร์เซ็นต์ จากค่าอ้างอิง 28 ค่า | A | Mercer และ Lau, 202314 |
| การถ่วงน้ำหนักช่วยให้กลุ่มตัวอย่างแบบสมัครใจเข้าร่วมดีขึ้น แต่กอบกู้ไม่ได้ | 8.4 จุดเมื่อไม่ถ่วงน้ำหนัก ไม่มีวิธีใดต่ำกว่า 6.0 จุด | A | Mercer, Lau และ Kennedy, 201819 |
| ค่าความคลาดเคลื่อนต่ำกว่าความคลาดเคลื่อนจริงของโพล | 55% ของโพลระดับรัฐ 348 โพลในปี 2020 พลาดมากกว่าค่าความคลาดเคลื่อนเฉลี่ยที่รายงานไว้ 3.9 จุด | A | คณะทำงาน AAPOR, 202120 |
| คำอธิบายเรื่องกรอบของ Literary Digest ยังไม่ครบ | เจ้าของรถยนต์และโทรศัพท์ยังคงเลือก Roosevelt มากกว่า 55 ต่อ 45 | B | Squire, 19887 |
ระดับ A หมายถึงสถิติทางการ การวิเคราะห์อภิมาน หรือข้อค้นพบที่ทำซ้ำแล้ว ระดับ B หมายถึงการศึกษาที่แข็งแรงหนึ่งเรื่อง ซึ่งข้อสรุปยังไม่ถูกทำซ้ำโดยอิสระ
“อัตราการตอบกลับร้อยละ 50 ถือว่าพอใช้ 60 ถือว่าดี 70 ถือว่าดีมาก” กฎจำง่ายจากตำราที่ไม่มีข้อมูลรองรับ ผู้เชี่ยวชาญต่างคนในสาขาเดียวกันให้ตัวเลข 50, 60 และ 80 อคติขึ้นกับสหสัมพันธ์ระหว่างการตอบกับคำตอบ ไม่ได้ขึ้นกับอัตรา
“สามสิบคนก็พอ เพราะเป็นจุดที่ทฤษฎีบทขีดจำกัดกลางเริ่มใช้ได้” ไม่มีการพิสูจน์ใดที่ได้ตัวเลข 30 สำหรับผลที่มีการแจกแจงสมมาตร การประมาณใช้ได้ที่จำนวนต่ำกว่านั้นมาก และสำหรับผลที่เบ้หรือเหตุการณ์ที่เกิดยาก การประมาณใช้ไม่ได้แม้จำนวนจะสูงกว่านั้นมาก
“อัตราการตอบกลับแบบสำรวจโดยเฉลี่ยคือร้อยละ 33” ตัวเลขนี้วนเวียนอยู่ในบล็อกของผู้ให้บริการด้วยถ้อยคำแทบเหมือนกัน โดยไม่มีแหล่งที่มาปฐมภูมิ ช่องทาง ผู้สนับสนุน ประชากร และสิ่งจูงใจมีผลมากกว่าค่าเฉลี่ยรวมใด ๆ
“ช่วงความสนใจของคนตอนนี้เหลือแปดวินาที สั้นกว่าปลาทอง” สืบย้อนไปได้ถึงรายงานการตลาดปี 2015 ที่อ้างบริษัทหนึ่งซึ่งไม่สามารถแสดงแหล่งที่มาได้ งานวิจัยต้นทางไม่เคยพูดถึงแปดวินาทีหรือปลาทองเลย
ค่า design effect: ทำไมกลุ่มตัวอย่างแบบกลุ่มจึงต้องใช้คนมากขึ้น
คู่มือแทบทุกฉบับแนะนำการสุ่มตัวอย่างแบบกลุ่มเพราะประหยัดต้นทุน แล้วก็หยุดแค่นั้น การประหยัดเป็นเรื่องจริง และค่าใช้จ่ายที่ตามมาก็จริงเช่นกัน คนในโรงเรียน คลินิก หอผู้ป่วย หรือร้านเดียวกันมักคล้ายกัน คล้ายกันมากกว่าคนที่สุ่มมาจากทั่วทั้งประชากร การตอบกลับที่เพิ่มแต่ละครั้งจากกลุ่มที่เลือกไว้แล้วจึงให้ข้อมูลใหม่น้อยลง
ค่า design effect คือตัวเลขที่วัดเรื่องนี้ พูดง่าย ๆ คือ ความไม่แน่นอนของคุณกว้างขึ้นเท่าใด เมื่อเทียบกับการสุ่มคนจำนวนเท่ากันอย่างเป็นอิสระต่อกัน สำหรับแบบแผนที่กลุ่มมีขนาดเท่ากัน ค่านี้คือ
design effect = 1 + (ขนาดกลุ่มเฉลี่ย - 1) x สหสัมพันธ์ภายในกลุ่ม
สหสัมพันธ์ภายในกลุ่ม (intraclass correlation) คือระดับที่คนในกลุ่มเดียวกันคล้ายกันในเรื่องที่คุณวัด ศูนย์หมายความว่าการอยู่โรงเรียนเดียวกันไม่ได้บอกอะไรเกี่ยวกับคำตอบของนักเรียน หนึ่งหมายความว่าทุกคนในโรงเรียนตอบเหมือนกันหมด และโรงเรียนนั้นก็เหมือนเป็นคนคนเดียว ค่าจริงมีขนาดเล็ก แต่ค่าเล็ก ๆ ก็สร้างความเสียหายมากเมื่อกลุ่มมีขนาดใหญ่ เมื่อรวมจากแบบสำรวจครัวเรือนระดับประเทศ 48 แบบ สหสัมพันธ์ภายในกลุ่มเฉลี่ยอยู่ที่ราว 0.06 และแปรผันตามสิ่งที่วัด ข้อคำถามด้านภาวะเจริญพันธุ์อยู่ที่ราว 0.01 ถึง 0.03 การใช้การคุมกำเนิดในปัจจุบัน 0.03 ถึง 0.05 และการคลอดโดยบุคลากรทางการแพทย์สูงถึง 0.22 ในตัวเลขระดับประเทศ21
หากคุณไม่มีค่าประมาณของตนเอง ให้ยืมค่าตั้งต้นอย่างระมัดระวัง คู่มือการสุ่มตัวอย่างของ DHS ใช้ค่า deft เท่ากับ 1.5 เป็นค่าสำรองเมื่อแบบสำรวจไม่มีตัวเลขของตนเอง22 deft ไม่ใช่ปริมาณเดียวกับค่า design effect ในสูตรด้านบน: deft คืออัตราส่วนของความคลาดเคลื่อนมาตรฐานสองค่า ส่วนค่า design effect คืออัตราส่วนของความแปรปรวนสองค่า คุณต้องยกกำลังสอง deft 1.5 จึงเท่ากับค่า design effect 2.25 คู่มือเรียกค่านี้ว่าค่าสำรอง ไม่ใช่ค่าทั่วไป และตัวอย่างการคำนวณของคู่มือเองใช้ 1.40 สำหรับการใช้การคุมกำเนิดสมัยใหม่ และ 1.22 สำหรับการฉีดวัคซีนเด็ก
| แบบแผน | ค่า design effect | การตอบกลับที่มีผลจริง | ความหมายในทางปฏิบัติ |
|---|---|---|---|
| เลือกอย่างอิสระ ไม่จัดกลุ่ม | 1.00 | 960 | การตอบกลับทุกรายการมีค่าเต็มหนึ่งรายการ |
| 24 กลุ่ม กลุ่มละ 40, ICC 0.02 | 1.78 | 539 | คุณจ่ายสำหรับ 960 รายการ แต่ยืนยันความแม่นยำได้เท่ากับ 539 รายการ |
| 24 กลุ่ม กลุ่มละ 40, ICC 0.05 | 2.95 | 325 | งานภาคสนามสองในสามไม่ได้ให้ความแม่นยำเพิ่มเลย |
| 24 กลุ่ม กลุ่มละ 40, ICC 0.10 | 4.90 | 196 | แบบแผนนี้กลายเป็นการศึกษาขนาดเล็กที่ใช้งบประมาณของการศึกษาขนาดใหญ่ไปอย่างเงียบ ๆ |
การถ่วงน้ำหนักก็มีส่วนของตนเอง แบบสำรวจระดับประเทศที่สุ่มภูมิภาคหนึ่งเกินสัดส่วนแล้วถ่วงน้ำหนักกลับ จะมีค่า design effect สองส่วนพร้อมกัน ผลจากการถ่วงน้ำหนัก 1.22 และผลจากการจัดกลุ่ม 1.80 ให้ค่า design effect รวม 2.20 ครัวเรือนที่สัมภาษณ์ 5,000 ครัวเรือนจึงมีผลเท่ากับครัวเรือนอิสระ 2,277 ครัวเรือน23
บทเรียนด้านการออกแบบ กลุ่มจำนวนมากขึ้นที่มีคนน้อยลงในแต่ละกลุ่ม ดีกว่ากลุ่มจำนวนน้อยที่มีคนมากในแต่ละกลุ่มแทบทุกครั้ง โรงเรียนสี่สิบแห่งแห่งละ 24 คน กับโรงเรียน 24 แห่งแห่งละ 40 คน มีต้นทุนพอ ๆ กันคือการตอบกลับ 960 รายการ แต่แบบแรกมีค่า design effect ต่ำกว่าและได้ผลที่ยืนยันได้ หากคุณกำลังวางแผนว่าต้องการการตอบกลับทั้งหมดเท่าใด ให้คำนวณในคู่มือขนาดกลุ่มตัวอย่างของเรา แล้วคูณด้วยค่า design effect การทำกลับด้านคือสาเหตุที่การศึกษาแบบกลุ่มมีอำนาจการทดสอบไม่พอ
ตัวอย่างการทำสามตัวอย่าง ตั้งแต่ต้นจนจบ
ชื่อวิธีการนั้นง่าย การตัดสินใจรอบ ๆ วิธีการต่างหากที่ทำให้การศึกษาผิดพลาดจริง ตัวอย่างทั้งสามนี้พาแบบแผนจริงไปตั้งแต่การนิยามประชากร จนถึงประโยคที่คุณเผยแพร่ได้
ตัวอย่างที่ 1: ประสบการณ์ผู้ป่วยทั่วทั้งอำเภอ
- ประชากร ผู้ใหญ่ที่เข้ารับการตรวจแบบผู้ป่วยนอกที่คลินิกรัฐแห่งใดก็ได้จาก 46 แห่งในอำเภอ ระหว่างวันที่ 1 เมษายนถึง 30 มิถุนายน
- กรอบ ไม่มีทะเบียนผู้ป่วยระดับอำเภอ แต่มีรายชื่อคลินิกทั้ง 46 แห่ง พร้อมจำนวนผู้มารับบริการรายเดือน
- วิธีการ แบบหลายขั้นตอน เลือกคลินิก 18 แห่งด้วยความน่าจะเป็นตามสัดส่วนจำนวนผู้มารับบริการ แล้วสุ่มแบบมีระบบทุกผู้ป่วยคนที่ 8 ที่ออกจากคลินิก ในวันให้บริการสองวันที่สุ่มเลือก
- ทำไมไม่ใช้วิธีที่ง่ายกว่า รายชื่อผู้ป่วยครบถ้วนจะทำให้ใช้การสุ่มตัวอย่างแบบแบ่งชั้นภูมิได้ แต่รายชื่อนั้นไม่มี และสร้างไม่ทันในกรอบเวลา กลุ่มตัวอย่างแบบบังเอิญที่คลินิกใหญ่ที่สุดสามแห่งจะเร็วกว่า และจะอธิบายได้เพียงคลินิกใหญ่ที่สุดสามแห่งนั้น
- สิ่งที่ต้องรายงาน ความน่าจะเป็นของการถูกเลือกต่างกันตามขนาดคลินิก การวิเคราะห์จึงต้องถ่วงน้ำหนัก และต้องขยายช่วงให้กว้างขึ้นตามค่า design effect
- ประโยคที่เผยแพร่ได้ “ในบรรดาผู้ใหญ่ที่มารับบริการที่คลินิกผู้ป่วยนอกของรัฐในอำเภอในไตรมาสที่สอง ประมาณร้อยละ 71 ให้คะแนนว่าระยะเวลารอยอมรับได้ โดยอิงจากการสัมภาษณ์ขณะออกจากคลินิก 1,240 ครั้ง ในคลินิก 18 แห่งที่เลือกด้วยความน่าจะเป็นตามสัดส่วนจำนวนผู้มารับบริการ”
ตัวอย่างที่ 2: งานวิจัยวิทยานิพนธ์กับประชากรนักศึกษา
- ประชากร นักศึกษาที่ลงทะเบียนในคณะพาณิชยศาสตร์ในปีการศึกษาปัจจุบัน จำนวน 3,100 คน ในสามชั้นปี
- กรอบ ทะเบียนนักศึกษาของคณะ ซึ่งระบุชั้นปีและหลักสูตร
- วิธีการ การสุ่มตัวอย่างแบบแบ่งชั้นภูมิตามชั้นปี จัดสรรตามสัดส่วน เป้าหมายการตอบกลับที่สมบูรณ์ 350 รายการ
- การคำนวณ ชั้นปีที่หนึ่งมีนักศึกษา 1,300 คน คิดเป็นร้อยละ 42 ของ 3,100 จึงได้ร้อยละ 42 ของ 350 คือการตอบกลับ 147 รายการ ทำซ้ำสำหรับแต่ละชั้นปี เนื่องจากจัดสรรตามสัดส่วน จึงไม่ต้องถ่วงน้ำหนัก
- การวางแผนการตอบกลับ ที่อัตราการตอบกลับคาดการณ์ร้อยละ 35 คุณต้องเชิญนักศึกษาราว 1,000 คน เพื่อให้ได้การตอบกลับที่สมบูรณ์ 350 รายการ และควรเชิญทีละชั้นภูมิ เพื่อให้เห็นการตอบกลับที่ต่ำในชั้นปีใดปีหนึ่งขณะที่ยังมีเวลาแก้ไข
- ข้อจำกัดที่ต้องระบุ นักศึกษาที่ลาออกแล้วแต่ยังอยู่ในทะเบียนคือการครอบคลุมเกิน นักศึกษาที่ลงทะเบียนหลังดึงข้อมูลทะเบียนแล้วคือการครอบคลุมไม่ครบ ทั้งสองข้อต้องอยู่ในย่อหน้าข้อจำกัด
ตัวอย่างที่ 3: ความคิดเห็นลูกค้าของร้านค้าออนไลน์
- ประชากร ลูกค้าที่สั่งซื้อสำเร็จในช่วง 90 วันที่ผ่านมา
- กรอบ ตารางคำสั่งซื้อ ซึ่งครบถ้วนสำหรับคำสั่งซื้อออนไลน์ และครบถ้วนสำหรับการชำระเงินแบบไม่เป็นสมาชิก แต่ลูกค้าที่มีสองบัญชีจะปรากฏสองครั้ง
- วิธีการ ลบรายการซ้ำให้เหลือหนึ่งแถวต่อลูกค้าหนึ่งคน แล้วสุ่มแบบมีระบบทุกลูกค้าคนที่ 12 หลังจุดเริ่มต้นแบบสุ่ม โดยทำต่อเนื่องแทนที่จะทำเป็นชุดเดียว
- กับดักที่วิธีนี้ช่วยหลีกเลี่ยง การเชิญเฉพาะผู้รับจดหมายข่าวเร็วกว่า แต่เป็นกลุ่มตัวอย่างแบบบังเอิญของลูกค้าที่มีส่วนร่วมมากที่สุด ซึ่งจะทำให้ความพึงพอใจดูดีกว่าความจริงอย่างสม่ำเสมอทุกไตรมาส
- หมายเหตุเรื่องพนักงาน องค์กรเดียวกันที่สำรวจพนักงานของตนเอง 180 คนไม่ควรสุ่มตัวอย่างเลย ประชากรนั้นมีขนาดเล็ก เข้าถึงได้ และทุกคนมีสิทธิ์ได้รับการสอบถาม ให้ทำสำมะโน และหากการเข้าร่วมน้อย ให้ถือเป็นข้อค้นพบ ไม่ใช่ปัญหาการสุ่มตัวอย่าง
วิธีเขียนส่วนการสุ่มตัวอย่างในระเบียบวิธีวิจัย
นี่คือขั้นตอนที่คู่มือส่วนใหญ่ข้ามไป และเป็นส่วนที่อาจารย์ที่ปรึกษา ผู้ทบทวน หรือลูกค้าอ่านจริง ๆ การเขียนเรื่องการสุ่มตัวอย่างต้องตอบคำถามห้าข้อตามลำดับ: ใคร จากรายชื่อใด เลือกอย่างไร จำนวนเท่าใด และด้วยเหตุนี้คุณกล่าวอ้างอะไรได้
เติมช่องว่างด้านล่าง เทมเพลตนี้ตั้งใจให้เรียบง่าย กรรมการสอบไม่ได้มองหาภาษาสละสลวยตรงนี้ แต่มองหาแบบแผนที่ประเมินได้
การศึกษาเดียวกัน เขียนแบบอ่อนและเขียนแบบดี
แบบอ่อน “สุ่มตัวอย่างนักศึกษาและเก็บการตอบกลับได้ 350 รายการ”
ไม่มีอะไรในประโยคนี้ที่ตรวจสอบได้ คำว่า “สุ่ม” ถูกใช้เกินกว่าที่พิสูจน์ได้ ไม่มีกรอบ ไม่มีตัวหาร และไม่ได้ระบุว่าใครถูกตัดออก
แบบดี “ประชากรเป้าหมายคือนักศึกษา 3,100 คนที่ลงทะเบียนในคณะพาณิชยศาสตร์ในปี 2026 กรอบการสุ่มตัวอย่างคือทะเบียนนักศึกษาของคณะที่ดึงข้อมูลเมื่อวันที่ 3 มีนาคม 2026 ใช้การสุ่มตัวอย่างแบบแบ่งชั้นภูมิตามชั้นปีโดยจัดสรรตามสัดส่วน เพื่อให้รายงานแต่ละชั้นปีแยกกันได้ เชิญนักศึกษาหนึ่งพันคน และ 350 คนตอบแบบสอบถามครบ คิดเป็นอัตราการตอบกลับร้อยละ 35 ไม่ได้ถ่วงน้ำหนักเพราะจัดสรรตามสัดส่วน นักศึกษาที่ลาออกหลังวันที่ดึงข้อมูลยังอยู่ในกรอบและระบุตัวไม่ได้ ซึ่งเป็นแหล่งเล็กน้อยของการครอบคลุมเกิน”
แบบที่สองยาวกว่า และทุกประโยคที่เพิ่มขึ้นคือประโยคที่ผู้ทบทวนไม่ต้องถามอีก
“ผู้เข้าร่วมได้รับการสรรหาผ่านข้อความแจ้งในแอปที่แสดงต่อผู้ใช้ที่ใช้งานอยู่เป็นเวลาสองสัปดาห์ นี่คือกลุ่มตัวอย่างแบบบังเอิญ ข้อค้นพบจึงอธิบายเฉพาะผู้ที่ตอบกลับ และอ้างอิงไปยังผู้ใช้ทั้งหมดไม่ได้ และไม่ได้รายงานตัวเลขความแม่นยำ ผู้ตอบมีแนวโน้มเป็นผู้ใช้รายวันมากกว่าผู้ใช้โดยรวม ซึ่งควรนำมาพิจารณาเมื่ออ่านผลลัพธ์” เขียนแบบนี้ แล้วจะไม่มีใครกล่าวหาว่าคุณอ้างเกินจริงได้ เพราะคุณไม่ได้อ้างเกินจริง
รายการตรวจสอบแผนการสุ่มตัวอย่าง
แผนการสุ่มตัวอย่างที่เขียนไว้ช่วยป้องกันข้อผิดพลาดที่หลีกเลี่ยงได้ส่วนใหญ่ เพราะบังคับให้ตัดสินใจก่อนลงภาคสนาม ไม่ใช่ระหว่างวิเคราะห์ แปดข้อ หนึ่งหน้า
- 1. วัตถุประสงค์การวิจัย สิ่งนี้สนับสนุนการตัดสินใจใด และจะรายงานอะไรบ้างอย่างชัดเจน?
- 2. ประชากรเป้าหมาย ใครอยู่ในขอบเขตและใครอยู่นอกขอบเขต รวมถึงช่วงเวลา
- 3. กรอบการสุ่มตัวอย่าง แหล่งที่มา วันที่ดึงข้อมูล จำนวนแถว ช่องว่างที่ทราบ และกฎการลบรายการซ้ำ
- 4. วิธีการและเหตุผล วิธีใดในเก้าวิธี และทำไมจึงเป็นวิธีนี้ เมื่อพิจารณากรอบและข้อกล่าวอ้าง
- 5. เป้าหมาย การตอบกลับที่สมบูรณ์ทั้งหมดและต่อกลุ่มย่อย พร้อมอัตราการตอบกลับที่คาดไว้ซึ่งใช้วางแผน
- 6. แผนการสรรหา ช่องทาง กำหนดการส่งข้อความเตือน การรองรับด้านภาษาและการเข้าถึง และนโยบายสิ่งจูงใจ
- 7. การติดตาม สิ่งที่คุณจะเฝ้าดูระหว่างเก็บข้อมูลภาคสนาม ได้แก่ การตอบกลับแยกตามชั้นภูมิ จุดที่ผู้ตอบออกกลางคัน และการไม่ตอบรายข้อ
- 8. หมายเหตุการวิเคราะห์ แผนการถ่วงน้ำหนัก การปรับตามค่า design effect และข้อจำกัดที่คุณจะเปิดเผยไม่ว่าผลจะเป็นอย่างไร
เมื่อแผนลงตัวแล้ว เครื่องมือวัดจะเป็นตัวตัดสินว่ากลุ่มตัวอย่างนั้นคุ้มค่าที่จะสุ่มหรือไม่ กลุ่มตัวอย่างที่สมบูรณ์แบบกอบกู้คำถามชี้นำหรือคำถามที่ถามสองเรื่องในข้อเดียวไม่ได้ จึงควรอ่านตัวอย่างคำถามแบบสำรวจก่อนเริ่มเก็บข้อมูล
คำถามที่พบบ่อย
การสุ่มตัวอย่างในงานวิจัยคืออะไร?
การสุ่มตัวอย่างคือกระบวนการเลือกส่วนย่อยของประชากรที่เรียกว่ากลุ่มตัวอย่าง แล้วศึกษาส่วนย่อยนั้นเพื่อสรุปผลเกี่ยวกับประชากรทั้งหมด ใช้เพราะการวัดสมาชิกทุกคนของประชากรมักช้าเกินไป แพงเกินไป หรือทำไม่ได้ วิธีที่ใช้เลือกกลุ่มตัวอย่างเป็นตัวกำหนดว่าผลลัพธ์รองรับข้อสรุปใดได้
ประชากรกับกลุ่มตัวอย่างต่างกันอย่างไร?
ประชากรคือกลุ่มทั้งหมดที่คุณต้องการอธิบาย กลุ่มตัวอย่างคือส่วนย่อยที่เล็กกว่าซึ่งคุณวัดจริง การสุ่มตัวอย่างคือกระบวนการที่พาคุณจากอย่างแรกไปสู่อย่างหลัง และสำมะโนคือทางเลือกที่คุณวัดประชากรทั้งหมดแทน
กรอบการสุ่มตัวอย่างคืออะไร?
กรอบการสุ่มตัวอย่างคือรายชื่อหรือกลไกจริงที่คุณใช้สุ่มกลุ่มตัวอย่าง เช่น ทะเบียนนักศึกษา ทะเบียนผู้ป่วย ฐานข้อมูลลูกค้า รายชื่อครัวเรือน หรือบัญชีรายชื่อผู้มีสิทธิเลือกตั้ง กรอบสำคัญกว่าชื่อวิธี เพราะใครก็ตามที่ไม่อยู่ในกรอบไม่มีโอกาสถูกเลือกเลย ไม่ว่าเทคนิคการสุ่มตัวอย่างของคุณจะดีเพียงใด
วิธีสุ่มตัวอย่างใดที่ไม่ต้องใช้กรอบการสุ่มตัวอย่าง?
การสุ่มตัวอย่างแบบบังเอิญ แบบโควตา แบบเจาะจง และแบบสโนว์บอลไม่ต้องใช้รายชื่อเลย การสุ่มตัวอย่างแบบกลุ่มและแบบหลายขั้นตอนต้องการเพียงรายชื่อกลุ่ม เช่น โรงเรียน คลินิก หรือหมู่บ้าน ไม่ใช่รายชื่อบุคคล ส่วนการสุ่มตัวอย่างแบบง่าย แบบมีระบบ และแบบแบ่งชั้นภูมิ ล้วนต้องมีรายชื่อบุคคลครบถ้วนก่อนเริ่ม
การสุ่มตัวอย่างแบบอาศัยความน่าจะเป็นกับแบบไม่อาศัยความน่าจะเป็นต่างกันอย่างไร?
ในการสุ่มตัวอย่างแบบอาศัยความน่าจะเป็น กลไกการสุ่มเป็นผู้เลือก ทุกหน่วยจึงมีโอกาสถูกเลือกที่ทราบค่าและไม่เป็นศูนย์ และคุณคำนวณได้ว่าค่าประมาณของคุณไม่แน่นอนเพียงใด ในการสุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็น ไม่ทราบโอกาสเหล่านั้น เพราะการเลือกขึ้นกับความสะดวก โควตา หรือดุลยพินิจของผู้วิจัย ผลในทางปฏิบัติคือ มีเพียงแบบแผนแบบอาศัยความน่าจะเป็นที่รองรับการระบุตัวเลขความแม่นยำของค่าประมาณประชากรได้
การสุ่มตัวอย่างแบบแบ่งชั้นภูมิกับแบบกลุ่มต่างกันอย่างไร?
การสุ่มตัวอย่างแบบแบ่งชั้นภูมิแบ่งประชากรเป็นกลุ่ม แล้วสุ่มกลุ่มตัวอย่างจากทุกกลุ่ม ซึ่งเพิ่มความแม่นยำและรับประกันว่าทุกกลุ่มจะปรากฏ การสุ่มตัวอย่างแบบกลุ่มสุ่มเลือกบางกลุ่ม แล้วสำรวจทุกคนในกลุ่มที่ถูกเลือก ซึ่งประหยัดต้นทุนเมื่อไม่มีรายชื่อบุคคล จำง่าย ๆ ว่า แบบแบ่งชั้นภูมิใช้ทุกกลุ่มและบางคน แบบกลุ่มใช้บางกลุ่มและทุกคน
หน่วยการสุ่มตัวอย่างขั้นปฐมภูมิคืออะไร?
หน่วยการสุ่มตัวอย่างขั้นปฐมภูมิคือสิ่งที่ถูกเลือกในขั้นแรกของแบบแผนแบบหลายขั้นตอน ในแบบสำรวจครัวเรือนระดับประเทศ มักเป็นพื้นที่ เช่น เขตย่อย หมู่บ้าน หรือเขตแจงนับสำมะโน จากนั้นจึงเลือกครัวเรือนภายในพื้นที่นั้นในขั้นที่สอง การระบุหน่วยการสุ่มตัวอย่างขั้นปฐมภูมิเป็นข้อกำหนดมาตรฐานเมื่อรายงานแบบแผนแบบกลุ่ม เพราะการจัดกลุ่มที่เกิดขึ้นต้องสะท้อนอยู่ในการวิเคราะห์
การสุ่มตัวอย่างแบบแบ่งชั้นภูมิคืออะไร?
การสุ่มตัวอย่างแบบแบ่งชั้นภูมิแบ่งประชากรเป็นกลุ่มที่ไม่ทับซ้อนกันเรียกว่าชั้นภูมิ แล้วสุ่มกลุ่มตัวอย่างภายในแต่ละชั้นภูมิอย่างเป็นอิสระต่อกัน การจัดสรรตามสัดส่วนให้แต่ละชั้นภูมิได้ส่วนแบ่งของกลุ่มตัวอย่างตรงกับส่วนแบ่งในประชากร และไม่ต้องถ่วงน้ำหนัก การจัดสรรแบบไม่เป็นสัดส่วนจงใจสุ่มชั้นภูมิที่เล็กแต่สำคัญเกินสัดส่วน และต้องถ่วงน้ำหนักก่อนรายงานตัวเลขรวมใด ๆ
การสุ่มตัวอย่างแบบสโนว์บอลใช้ได้ในงานวิจัยทางวิชาการหรือไม่?
ใช้ได้ เมื่อประชากรซ่อนตัว หายาก หรือไม่มีการขึ้นทะเบียน และสร้างกรอบการสุ่มตัวอย่างไม่ได้ เป็นแนวทางที่ได้รับการยอมรับสำหรับกลุ่มที่เข้าถึงยาก สิ่งที่ทำไม่ได้คือการประมาณค่าประชากร และจุดอ่อนหลักคือผู้เข้าร่วมแนะนำคนที่คล้ายตัวเอง กลุ่มตัวอย่างจึงเอนไปทางเครือข่ายสังคมเดียว การเริ่มจากจุดตั้งต้นหลายจุดที่ไม่เชื่อมโยงกันช่วยลดการเอนเอียงนั้น และควรอธิบายไว้ในระเบียบวิธีวิจัยของคุณ
การสุ่มตัวอย่างเหมือนกับการสุ่มจัดกลุ่มหรือไม่?
ไม่เหมือน การสุ่มตัวอย่างคือวิธีที่คุณเลือกผู้เข้าร่วมจากประชากร และเป็นตัวกำหนดว่าข้อค้นพบของคุณอ้างอิงไปถึงใครได้ การสุ่มจัดกลุ่มคือวิธีที่คุณจัดผู้เข้าร่วมที่เลือกแล้วเข้าสู่เงื่อนไขต่าง ๆ ในการทดลอง และเป็นตัวกำหนดว่าผลที่สังเกตได้มาจากสิ่งที่ทดลองหรือไม่ การศึกษาหนึ่งอาจใช้อย่างหนึ่งโดยไม่ใช้อีกอย่าง และการทดลองส่วนใหญ่ใช้การสุ่มจัดกลุ่มโดยไม่มีการสุ่มตัวอย่าง
ใช้วิธีการสุ่มตัวอย่างแบบไม่อาศัยความน่าจะเป็นในการศึกษาเชิงปริมาณได้หรือไม่?
ได้ และงานวิจัยเชิงปริมาณที่ตีพิมพ์จำนวนมากก็ทำเช่นนั้น สิ่งที่เปลี่ยนคือสิ่งที่คุณกล่าวอ้างได้ คุณรายงานจำนวน ค่าร้อยละ และความสัมพันธ์ภายในกลุ่มตัวอย่างได้ และเปรียบเทียบกลุ่มภายในกลุ่มตัวอย่างได้ แต่นำเสนอค่าร้อยละเหล่านั้นเป็นค่าประมาณของประชากรพร้อมระบุความแม่นยำไม่ได้ ระบุวิธีการ อธิบายการสรรหา เทียบผู้ตอบกับค่าอ้างอิงที่ทราบหากมี และเขียนข้อจำกัดให้ชัดเจน แทนการหวังว่าจะไม่มีใครถาม
การสุ่มตัวอย่างกับการแจกแจงของตัวอย่างต่างกันอย่างไร?
การสุ่มตัวอย่างคือขั้นตอนการเลือกกลุ่มตัวอย่าง การแจกแจงของตัวอย่างเป็นอีกแนวคิดหนึ่ง ลองนึกภาพการทำขั้นตอนการสุ่มตัวอย่างเดิมซ้ำหลายครั้ง การกระจายของค่าสถิติที่ได้ เช่น ค่าเฉลี่ยหรือค่าร้อยละ จากกลุ่มตัวอย่างในจินตนาการทั้งหมดนั้น คือการแจกแจงของตัวอย่าง การแจกแจงของตัวอย่างคือสิ่งที่ทำให้ช่วงความเชื่อมั่นเป็นไปได้ และจะคาดการณ์ได้ก็ต่อเมื่อกลุ่มตัวอย่างถูกสุ่มด้วยวิธีแบบอาศัยความน่าจะเป็นเท่านั้น
จะรู้ได้อย่างไรว่ากลุ่มตัวอย่างมีอคติ?
เทียบกลุ่มตัวอย่างที่ได้จริงกับค่าอ้างอิงที่ทราบ เช่น รายชื่อพนักงาน ข้อมูลการลงทะเบียน หรือข้อมูลการบริหาร ในตัวแปรที่เกี่ยวข้องกับสิ่งที่คุณวัด ช่องว่างขนาดใหญ่ชี้ถึงปัญหาการครอบคลุม ปัญหาการคัดเลือก หรือการไม่ตอบกลับที่ต่างกันระหว่างกลุ่ม เทียบระหว่างช่องทางการสรรหาและรอบการส่งข้อความเตือนด้วย พึงระวังว่าอัตราการตอบกลับที่ดีเป็นหลักฐานที่อ่อนว่ามีอคติต่ำ: จากค่าประมาณที่ตีพิมพ์ 235 ค่า อัตราการตอบกลับอธิบายความแปรผันของอคติจากการไม่ตอบกลับได้เพียงราวร้อยละ 11
บทความที่เกี่ยวข้อง
การสุ่มตัวอย่างเป็นการตัดสินใจหนึ่งในการศึกษาที่ใหญ่กว่า คู่มือเหล่านี้ครอบคลุมการตัดสินใจก่อนและหลังขั้นนี้
- การออกแบบการวิจัยเชิงสำรวจ วางการสุ่มตัวอย่างไว้ในลำดับร่วมกับส่วนอื่นของการศึกษา ตั้งแต่การนิยามประชากรจนถึงการเริ่มเก็บข้อมูล
- วิธีกำหนดขนาดกลุ่มตัวอย่าง ครอบคลุมการคำนวณความแม่นยำที่หน้านี้ตั้งใจส่งต่อ รวมถึงสูตรต่าง ๆ
- วิธีเขียนคำถามแบบสำรวจ ครอบคลุมด้านการวัด ซึ่งไม่มีแบบแผนการสุ่มตัวอย่างใดกอบกู้ได้
- หลักการออกแบบแบบสอบถาม ครอบคลุมวิธีประกอบเครื่องมือทั้งชุดเมื่อมีคำถามแล้ว
- อคติในการตอบ เจาะลึกความแตกต่างระหว่างคนที่คุณเลือกกับคนที่ตอบจริง
- คำถามด้านประชากรศาสตร์ในแบบสำรวจ มีประโยชน์เมื่อกรอบของคุณไม่มีตัวแปรที่ต้องใช้แบ่งชั้นภูมิ
- นัยสำคัญทางสถิติ ครอบคลุมสิ่งที่ต้องทำกับตัวเลขเมื่อได้กลุ่มตัวอย่างมาแล้ว
- การวิเคราะห์ข้อมูลเชิงปริมาณ ครอบคลุมขั้นตอนการวิเคราะห์ที่ตามมา รวมถึงจุดที่ต้องใช้การถ่วงน้ำหนัก
คู่มือนี้เขียนขึ้นอย่างไร และไม่ครอบคลุมอะไร
ผู้เขียน Michael Hodge ผู้ทำงานด้านระเบียบวิธีแบบสำรวจ การออกแบบคำถาม และคุณภาพข้อมูลที่ SuperSurvey และเขียนคู่มือเชิงปฏิบัติในหมวดคู่มือและความช่วยเหลือของเรา
ข้อมูลที่ใช้อ้างอิง นิยามต่าง ๆ อิงตามบทความทบทวนด้านระเบียบวิธีและแนวทางการวิจัยของมหาวิทยาลัยที่อ้างถึงด้านล่าง ซึ่งเป็นแหล่งที่นิยามศัพท์เทคนิคไว้จริง หน้าของหน่วยงานด้านจริยธรรมการวิจัยและสำนักงานสถิติทางการระบุไว้เป็นจุดเริ่มต้นสั้น ๆ ที่อ่านง่าย ไม่ใช่แหล่งที่มาของนิยามเหล่านั้น คำอธิบายวิธีการอิงตามบทความทบทวนและแนวทางชุดเดียวกัน ตัวเลขทุกตัวในส่วนหลักฐานมาจากแหล่งที่มาปฐมภูมิที่ระบุชื่อไว้ด้านล่าง ข้อกล่าวอ้างแต่ละข้อมีระดับความน่าเชื่อถือกำกับ เพื่อให้คุณเห็นว่าข้อค้นพบใดยืนยันแล้ว และข้อใดอิงการศึกษาเพียงเรื่องเดียว ตัวเลขค่า design effect ในแผนภูมิและตารางเป็นการคำนวณของเราเอง เราใช้สูตรมาตรฐานพร้อมข้อสมมติที่พิมพ์ไว้ในคำบรรยายภาพ เพื่อให้คุณคำนวณซ้ำหรือโต้แย้งได้ด้วยขนาดกลุ่มของคุณเอง
สิ่งที่ไม่ครอบคลุม คู่มือนี้ว่าด้วยการสุ่มตัวอย่างสำหรับแบบสำรวจและการศึกษาเชิงสังเกต ไม่ครอบคลุมการออกแบบการทดลองหรือการสุ่มจัดกลุ่ม นอกจากการแยกความต่าง และยังไม่รวมการสุ่มตัวอย่างสำหรับการทดสอบเพื่อยอมรับ การตรวจสอบบัญชี และการประมวลผลสัญญาณ ซึ่งใช้คำเดียวกันในความหมายต่างกัน การสุ่มตัวอย่างที่ขับเคลื่อนโดยผู้ตอบ การสุ่มตัวอย่างตามเวลาและสถานที่ และการสุ่มตัวอย่างแบบกลุ่มปรับตัว เป็นวิธีจริงที่ผู้เชี่ยวชาญใช้กับประชากรที่ซ่อนตัว และอยู่นอกขอบเขตของคู่มือนี้ ตัวเลขสหสัมพันธ์ภายในกลุ่มมาจากแบบสำรวจครัวเรือนในประเทศรายได้ต่ำและปานกลาง ให้ถือเป็นตัวอย่างประกอบ ไม่ใช่ค่าที่จะนำไปใช้ในบริบทอื่น
จุดที่ตัวเลขอ่อนที่สุด การวิเคราะห์ซ้ำของ Literary Digest อิงแบบสำรวจปี 1937 หนึ่งชุดและการวิเคราะห์ซ้ำในภายหลังหนึ่งครั้ง และผู้เขียนทั้งสองระบุความไม่แน่นอนของตนเองไว้ จึงได้ระดับ B ตัวเลขความคลาดเคลื่อนของโพลมาจากโพลการเลือกตั้งในสหรัฐอเมริกา ซึ่งได้รับการศึกษาอย่างดีเป็นพิเศษ และไม่จำเป็นต้องเป็นตัวแทนของความคลาดเคลื่อนในแบบสำรวจโดยทั่วไป
การเปิดเผยข้อมูล SuperSurvey ขายซอฟต์แวร์แบบสำรวจ ไม่มีสิ่งใดในหน้านี้ที่ขาย ไม่มีส่วนใดที่ต้องสมัครสมาชิกก่อนอ่าน และไม่มีองค์กรใดสนับสนุนหรือตรวจทานคู่มือนี้ ที่เราลิงก์ไปยังหน้าของเราเองก็เพราะหน้านั้นครอบคลุมการตัดสินใจขั้นถัดไป ไม่ใช่เพราะลิงก์ทำให้เราได้ประโยชน์
เอกสารอ้างอิง
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., and Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- UK Government (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., and Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., and Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences and ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., and Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., and Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., and Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., and Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, pages 9 and 15. ตัวเลขมาจากฉบับปี 2025 ต่อมา GSMA ได้เผยแพร่ฉบับปี 2026 ซึ่งช่องว่างแคบลง
- Brubaker, J., Kilic, T., and Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., and others (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., and Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., and Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, page 9 and Table 1.2.
- Kalton, G., Brick, J. M., and Le, T. (2005). Estimating components of design effects for use in sample design. In Household Sample Surveys in Developing and Transition Countries, Chapter VI. United Nations, Series F No. 96.