
In breve
Il campionamento è il processo con cui si seleziona un sottoinsieme di una popolazione, chiamato campione, e lo si studia per trarre conclusioni sull’intera popolazione. I ricercatori campionano perché misurare tutti è di solito troppo lento, troppo costoso o semplicemente impossibile. La popolazione è il gruppo che vuoi descrivere, il campione è la parte che misuri davvero e la lista di campionamento è l’elenco da cui estrai il campione.
Il campionamento probabilistico seleziona le persone con un meccanismo casuale, quindi ogni unità ha una probabilità nota e diversa da zero di essere scelta. È questo che ti permette di dare un numero alla tua incertezza.
Il campionamento non probabilistico seleziona per comodità, per quote o a giudizio. Spesso è più rapido, più economico e a volte l’unica opzione eticamente possibile, ma non può sostenere una stima sulla popolazione con una precisione dichiarata.
Vai direttamente a i 9 metodi a confronto | come sceglierne uno | mettiti alla prova | come descriverlo
Punti chiave
- Campionare significa studiare un sottoinsieme: misuri un campione per conoscere una popolazione quando misurare tutti non è fattibile.
- Prima di tutto, definisci bene cinque termini: popolazione, lista di campionamento, unità di campionamento, disegno di campionamento e lo scarto tra la popolazione che vuoi e quella che riesci davvero a raggiungere. La maggior parte delle discussioni sul campionamento riguarda in realtà uno di questi.
- Solo i metodi probabilistici ti permettono di dare un numero alla tua incertezza. I campioni di convenienza, per quote, ragionati e a valanga possono essere utili e onesti, ma non possono sostenere una stima sulla popolazione con una precisione dichiarata.
- La lista fissa il tuo limite massimo: se un gruppo non può comparire nell’elenco da cui estrai, nessun metodo e nessuna quantità di risposte in più lo porterà nei tuoi risultati.
- La rappresentatività è una catena, non un’etichetta: lista, poi selezione, poi reclutamento, poi risposta, poi analisi. Un’estrazione casuale è solo uno dei cinque anelli.
Definizione di campionamento (e i 5 termini da non sbagliare)
Il campionamento è il processo con cui si seleziona un gruppo più piccolo (un campione) da un gruppo più grande (una popolazione) per conoscere la popolazione senza misurare tutti. Uno studio sull’intera popolazione spesso non è praticabile, quindi i ricercatori campionano per rendere il lavoro fattibile senza rinunciare a conclusioni utili.
I cinque termini qui sotto fanno gran parte del lavoro in qualsiasi capitolo di metodologia. Se li sbagli, ogni decisione successiva eredita l’errore.
- Popolazione: l’intero gruppo che vuoi descrivere, definito con confini e un intervallo di tempo. “Tutti gli studenti dell’ultimo anno di infermieristica nelle tre sedi, iscritti al 1º marzo” è una popolazione. “Gli infermieri” no.
- Popolazione obiettivo e popolazione accessibile: chi vuoi descrivere e chi il tuo reclutamento e i tuoi strumenti possono raggiungere davvero. Indicare lo scarto tra le due è un punto di forza in una relazione, non una debolezza.
- Lista di campionamento: l’elenco o il meccanismo da cui estrai. Un registro degli studenti, un registro dei pazienti, un database clienti, un elenco delle famiglie di un villaggio, una lista elettorale. I problemi della lista creano errori di copertura e nessun metodo li ripara.
- Unità di campionamento: ciò che viene effettivamente selezionato. Una persona, una famiglia, un ambulatorio, una classe, un turno, un ordine. Nei disegni a grappolo e a più stadi l’unità del primo stadio è un gruppo, e il gruppo si chiama unità primaria di campionamento.
- Disegno di campionamento: l’intero piano messo per iscritto. Lista, metodo, quante unità, come vengono contattate e che cosa farai con le persone che non rispondono. Il “disegno di campionamento” è ciò che un esaminatore o un revisore ti sta davvero chiedendo quando ti fa domande sul tuo campionamento.
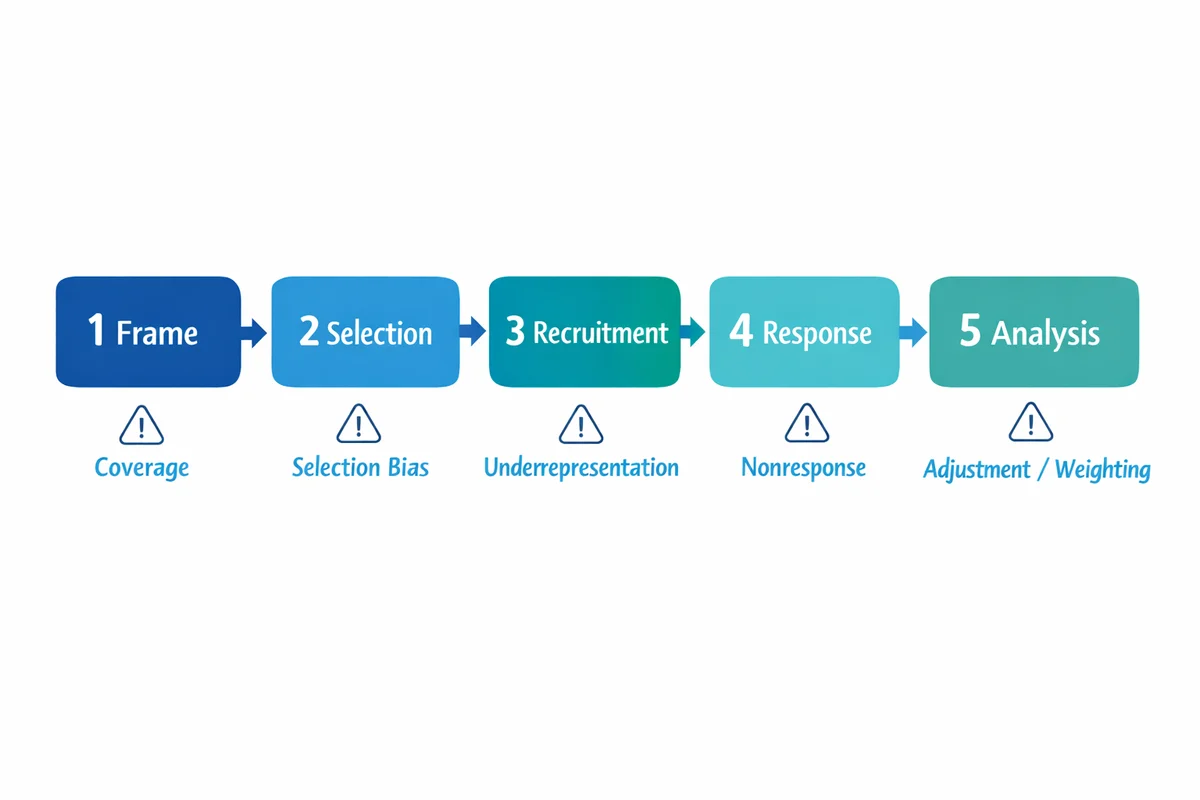
Puoi fare una selezione casuale da manuale e ritrovarti comunque con un campione distorto. Se la tua lista non comprende un segmento, quelle persone non potevano mai essere estratte. Se un segmento non risponde, esce dopo essere stato estratto. Tratta il campionamento come una catena: lista, poi selezione, poi reclutamento, poi risposta, poi analisi.
Per una breve definizione ufficiale della stessa idea, consulta la nota formativa sul campionamento dello U.S. Office of Research Integrity.1 Se stai inserendo il campionamento in un piano di studio più ampio, la nostra guida al disegno di ricerca dell’indagine copre i passaggi che lo precedono e lo seguono.
Perché campionare, e quando un censimento è la risposta migliore
Il bisogno di campionare è pratico prima ancora che statistico. Quattro ragioni ricorrono di continuo.
Costo
Ogni partecipante in più costa denaro, tempo del personale o buona volontà. Un campione ben estratto di 600 persone può rispondere alla stessa domanda di un tentativo mal gestito su 60.000.
Velocità
Le decisioni hanno delle scadenze. Un campione ti dà una risposta entro la finestra in cui quella risposta è ancora utile.
Fattibilità
Alcune popolazioni non si possono enumerare affatto: i passanti di un mercato, le persone che hanno abbandonato un servizio, i venditori informali. Altre sono di fatto infinite, oppure misurare un’unità la distrugge.
Qualità
Questa sorprende molti. Concentrare l’impegno su un gruppo più piccolo ti permette di sollecitare chi non risponde, formare bene gli intervistatori e controllare i dati. L’impegno per unità vale di solito più del numero di unità.
Un censimento, invece, misura tutti. È la scelta migliore quando la popolazione è abbastanza piccola da essere raggiunta, quando i recapiti esistono già o quando ogni membro ha il diritto di essere interpellato. Un questionario per i dipendenti in un’organizzazione di 200 persone è una questione di censimento, non di campionamento. Lo stesso vale per la valutazione di una classe. Quando la popolazione è piccola, il campionamento non ti fa guadagnare quasi nulla e ti toglie la possibilità di riportare i risultati per team.
Com’è davvero un buon campione
I manuali descrivono un buon campione come “rappresentativo”, ma questo non è un criterio operativo. Queste quattro proprietà invece lo sono.
- Copertura: chiunque appartenga alla popolazione obiettivo avrebbe potuto, in linea di principio, essere selezionato.
- Selezione controllata: chi entra nel campione lo decide una regola, non chi si offre volontario o chi è più vicino alla porta.
- Unità sufficienti nel gruppo più piccolo che devi riportare: un numero complessivo può sembrare solido mentre il gruppo che ti interessa davvero si regge su 11 risposte.
- Descrivibile: puoi mettere per iscritto esattamente come è stato estratto, e qualcun altro potrebbe ripeterlo.
| Se il tuo obiettivo è | Implicazione per il campionamento | Trappola comune |
|---|---|---|
| Stimare una percentuale della popolazione | Usa un metodo probabilistico, tieni traccia di chi risponde e riporta la precisione insieme al numero. | Trattare un campione di convenienza come se descrivesse la popolazione. |
| Confrontare sottogruppi | Pianifica il numero di risposte per sottogruppo, di solito stratificando e sovracampionando i gruppi piccoli. | Riportare un sottogruppo il cui risultato si regge su una manciata di persone. |
| Esplorare esperienze e meccanismi | È appropriata una selezione ragionata o teorica. Giustifica quali prospettive sono coperte e quali no. | Inseguire un minimo numerico senza alcuna motivazione. |
| Verificare un intervento | Il campionamento determina a chi si può generalizzare il risultato. L’assegnazione casuale determina se l’effetto è reale. | Confondere l’assegnazione casuale con il campionamento casuale. Sono operazioni diverse. |
Per una spiegazione in linguaggio semplice di come i campioni sostengono le stime sulla popolazione, la panoramica dello U.S. Census Bureau sul campionamento e l’inferenza nelle indagini è un buon punto di partenza.2
La lista di campionamento fissa il tuo limite massimo
Una lista di campionamento è l’elenco o il meccanismo concreto da cui estrai. È la parte del campionamento di cui si parla meno e il punto in cui la maggior parte degli studi reali va storta senza che nessuno se ne accorga, perché la lista decide chi poteva anche solo essere selezionato.
Le liste sono oggetti comuni. Un registro degli studenti, un registro dei pazienti, un elenco del personale, un database clienti. Un elenco di villaggi con il numero di famiglie, una lista elettorale, una serie di ordini, un elenco degli ambulatori di un distretto. Nota che alcune liste elencano persone e altre elencano luoghi. Questa distinzione decide quali metodi puoi usare.
| Problema | Come si presenta | Che effetto ha sui tuoi risultati |
|---|---|---|
| Sottocopertura | Mancano dall’elenco persone della popolazione: personale senza email aziendale, clienti che hanno acquistato di persona, famiglie senza indirizzo registrato. | Interi segmenti hanno probabilità zero di essere selezionati. Le risposte in più non possono rimediare, perché le persone mancanti non sono mai state selezionabili. |
| Sovracopertura | L’elenco contiene unità esterne alla tua popolazione: ex studenti, account chiusi, persone che si sono trasferite. | Sprechi impegno e, se non le escludi, misuri la popolazione sbagliata. |
| Duplicazione | La stessa persona compare più di una volta: due indirizzi email, due numeri di account. | Quelle persone hanno una probabilità di selezione più alta di tutti gli altri, il che rompe silenziosamente l’ipotesi di pari probabilità. |
| Obsolescenza | L’elenco era accurato quando è stato creato, ma ora non lo è più. | I contatti non recapitati sembrano rifiuti, quindi sia il tuo tasso di risposta sia la tua diagnosi del bias risultano sbagliati. |
Verifica la lista prima di estrarre, non dopo. Conta le righe. Confronta quel conteggio con qualsiasi totale indipendente che riesci a trovare, come l’organico dell’ufficio del personale o il numero di iscritti. Cerca il segmento che più ti imbarazzerebbe aver tralasciato e controlla che ci sia. Elimina i duplicati. Scrivi che cosa la lista esclude, perché quella frase va comunque nei tuoi limiti.
Il campionamento di convenienza, per quote, ragionato e a valanga non richiede alcun elenco. Il campionamento a grappolo e a più stadi richiede solo un elenco di gruppi (scuole, ambulatori, quartieri, villaggi), non un elenco di persone. Il campionamento casuale semplice, sistematico e stratificato richiede tutti un elenco completo degli individui prima di poter iniziare. Se non hai un elenco e non puoi crearne uno, questo solo fatto esclude tre dei nove metodi di questa pagina. Di solito è la prima cosa da chiarire.
I 9 metodi di campionamento a confronto
I metodi di campionamento si dividono in due famiglie. Il campionamento probabilistico usa un meccanismo casuale, quindi ogni unità della lista ha una probabilità di selezione nota e diversa da zero. Il campionamento non probabilistico no, quindi le probabilità di selezione sono ignote. Tutto il resto discende da questa sola distinzione.
La seconda colonna è quella che la maggior parte delle guide tralascia, per questo qui viene prima. Solo un disegno probabilistico sostiene un margine di errore, un intervallo di confidenza o la frase “più o meno 5 punti”. Se un metodo lì dice no, puoi comunque imparare molto da esso. Semplicemente non puoi pubblicare un dato di precisione accanto al risultato. La precisione in sé è un altro discorso, trattato nella nostra guida alla dimensione del campione.
| Metodo | Sostiene un margine di errore? | Come funziona | Scelta giusta quando | Quanto costa e quale bias favorisce |
|---|---|---|---|---|
| Campionamento casuale semplice Probabilistico Richiede un elenco completo |
Sì | Ogni unità dell’elenco ha la stessa probabilità. Estrai a caso il numero richiesto. | Hai un unico elenco pulito e senza duplicati e nessun sottogruppo da riportare separatamente. | CostoDevi avere l’elenco completo, e i gruppi piccoli possono risultare troppo piccoli per riportarli.BiasMolto basso in fase di selezione. Tutto il rischio residuo si sposta su chi risponde davvero. |
| Campionamento sistematico Probabilistico Richiede un elenco completo |
Sì, se l’ordine dell’elenco non ha legami con il risultato | Ordina l’elenco, scegli un punto di partenza casuale, poi prendi un record ogni k. | L’elenco è lungo o arriva come un flusso, e una squadra sul campo ha bisogno di una sola regola semplice da seguire. | CostoQuasi nullo, purché l’ordinamento non abbia nulla a che fare con ciò che misuri.BiasPeriodicità. Se l’elenco si ripete con un ciclo che coincide con il tuo intervallo, continui a pescare lo stesso tipo di unità. |
| Campionamento stratificato Probabilistico Richiede un elenco completo |
Sì, e di solito più preciso del casuale semplice | Dividi l’elenco nei gruppi (strati) che contano, poi campiona all’interno di ogni gruppo. | Devi riportare i risultati per regione, facoltà, reparto o fascia d’età, oppure ti aspetti che la risposta cambi molto tra i gruppi. | CostoLa variabile di raggruppamento deve essere nell’elenco prima dell’estrazione, e le frazioni diverse vanno ponderate in fase di analisi.BiasBasso. Il vero rischio è scegliere strati che non hanno nulla a che fare con il risultato: aggiungono lavoro e non danno precisione. |
| Campionamento a grappolo Probabilistico Richiede un elenco di gruppi |
Sì, ampliato per l’effetto del disegno | Seleziona a caso interi gruppi (scuole, ambulatori, quartieri, villaggi), poi coinvolgi nell’indagine tutti i membri dei gruppi selezionati. | Non puoi elencare gli individui ma puoi elencare i luoghi in cui si trovano, e i costi di spostamento o di avvio pesano più di tutto sul budget. | CostoPrecisione. Le persone di uno stesso gruppo si somigliano, quindi ogni risposta in più porta meno informazione nuova.BiasBasso se i gruppi sono scelti a caso, ma un numero ridotto di gruppi rende il risultato instabile e difficile da difendere. |
| Campionamento a più stadi Probabilistico Richiede un elenco di gruppi |
Sì, con pesi e un effetto del disegno | Campiona prima i gruppi, poi le unità all’interno dei gruppi selezionati, in due o più stadi. | Studi distrettuali o nazionali in cui non esiste un unico elenco di persone ma esistono unità amministrative. | CostoComplessità. Le probabilità di selezione variano tra le unità, quindi l’analisi richiede pesi e qualcuno in grado di applicarli.BiasBasso in teoria. In pratica ogni stadio è una nuova occasione per la squadra sul campo di allontanarsi dal piano. |
| Campionamento di convenienza Non probabilistico Nessun elenco richiesto |
No | Prendi chi è più facile da raggiungere: un pop-up su un sito web, una classe in cui insegni, le persone che passano davanti a un banco. Detto anche campionamento per disponibilità. | Stai esplorando, fai uno studio pilota di un questionario o ti serve una direzione questa settimana più che un numero difendibile il prossimo trimestre. | CostoL’affermazione. Rinunci alla possibilità di dire qualcosa sulla popolazione.BiasAutoselezione. Sovrarappresenta chi è raggiungibile, chi è disponibile e chi è già coinvolto. |
| Campionamento per quote Non probabilistico Nessun elenco richiesto |
No. Sembra bilanciato senza essere casuale | Fissa degli obiettivi per gruppo, per esempio 50 donne e 50 uomini, oppure 40 in aree rurali e 60 in aree urbane, poi recluta finché ogni obiettivo non è raggiunto. | Ti serve in fretta un campione che corrisponda almeno alla popolazione per le caratteristiche visibili, senza un elenco da cui estrarre. | CostoIl controllo su chi riempie ogni quota. Chi recluta continua a scegliere, e sceglie le persone più avvicinabili.BiasBias di selezione all’interno delle quote. Corrispondere per età e genere non rende le persone tipiche negli atteggiamenti. |
| Campionamento ragionato Non probabilistico Nessun elenco richiesto |
No, e non ci prova nemmeno | Selezioni deliberatamente i casi che rispondono a criteri dichiarati: esperti, casi estremi, casi tipici, casi critici. Detto anche campionamento a scelta ragionata. | Lavoro qualitativo, interviste a esperti, studi di caso e qualsiasi domanda in cui la profondità conta più del conteggio. | CostoNessuno, purché tu chiarisca che non stavi mai contando.BiasL’idea personale del ricercatore su chi sia rilevante. |
| Campionamento a valanga Non probabilistico Nessun elenco richiesto |
No | Recluta alcuni partecipanti, poi chiedi a ciascuno di segnalare altre persone che rispondono ai criteri. | Il gruppo è nascosto, stigmatizzato, raro o non registrato: lavoratori migranti, persone che hanno lasciato un servizio, venditori informali, persone con una malattia rara. | CostoTempo e controllo sulla forma del campione. Erediti la rete sociale delle persone da cui hai iniziato.BiasOmofilia. Le persone segnalano persone simili a loro, quindi un angolo della popolazione viene sovracampionato. |
Come leggere la tabella: i primi cinque metodi sono disegni probabilistici e gli ultimi quattro no. È questa sola divisione, non i nomi dei singoli metodi, a decidere se un dato di precisione è onesto.
I metodi di campionamento probabilistico, uno per uno
Il campionamento probabilistico significa che ogni unità della lista ha una probabilità nota e diversa da zero di essere selezionata, e che a selezionare è un meccanismo casuale. È l’unica base per dire qualcosa di numerico sulla popolazione. Cinque disegni coprono quasi tutti gli studi reali. Le rassegne della ricerca clinica e sanitaria trattano la stessa famiglia con etichette leggermente diverse, e conviene sapere perché prima di incontrarle entrambe: ciascuna delle due citate qui fa rientrare il campionamento a più stadi in quello a grappolo invece di elencarlo a parte.34
Campionamento casuale semplice
Il campionamento casuale semplice dà a ogni unità dell’elenco esattamente la stessa probabilità di selezione. Numeri l’elenco, generi numeri casuali e prendi le unità su cui cadono.
Esempio svolto. Il registro di un’università contiene 12.000 studenti iscritti e ti servono 400 risposte. Numera il registro da 1 a 12.000, genera 400 numeri casuali distinti in quell’intervallo con un foglio di calcolo o un software statistico e invita quegli studenti. Se prevedi un tasso di risposta del 40 per cento, estrai e invita 1.000 studenti, così 400 risposte complete diventano realistiche.
Dove non funziona. Con 400 risposte distribuite su un registro di 12.000 studenti, un dipartimento di 300 studenti contribuisce con circa 10 persone. Non bastano per riportare un risultato. Se un sottogruppo deve comparire nei tuoi risultati, il campionamento casuale semplice è lo strumento sbagliato e la soluzione è il campionamento stratificato.
Annota come hai randomizzato. Il software usato, il seme se c’era, e la data. Quella sola frase rende l’estrazione riproducibile, e i revisori la chiedono davvero.
Campionamento sistematico
Il campionamento sistematico prende un’unità ogni k da un elenco ordinato, dopo un inizio casuale. Dividi la dimensione dell’elenco per il numero che ti serve per ottenere l’intervallo k, scegli un numero casuale tra 1 e k come punto di partenza, poi procedi contando in avanti.
Esempio svolto. Un ospedale distrettuale registra 9.000 visite ambulatoriali in un trimestre e vuole 600 interviste all’uscita. L’intervallo è 9.000 diviso 600, quindi k è uguale a 15. Scegli un inizio casuale tra 1 e 15, per esempio 7, poi intervista le visite 7, 22, 37, 52 e così via. Una squadra sul campo può seguire questa regola senza un portatile, ed è questo il vero motivo per cui il metodo sopravvive.
Dove non funziona. Periodicità. Se l’elenco ha un ciclo ripetuto che coincide con k, campioni ogni volta la stessa posizione. Un elenco di visite ordinato per giorno di ambulatorio con un ciclo di 7 giorni e un intervallo di 7 ti darebbe un solo giorno della settimana e nient’altro. Controlla l’ordinamento prima di fissare k, e mescola l’elenco se l’ordine è legato a ciò che misuri.
Campionamento stratificato
Il campionamento stratificato divide la popolazione in gruppi che non si sovrappongono, chiamati strati, poi estrae un campione casuale all’interno di ogni strato. È il miglioramento più utile a disposizione della maggior parte degli studi, perché garantisce che ogni gruppo su cui devi riportare i risultati compaia davvero.
Esempio svolto, con i calcoli. Un’organizzazione ha 4.200 dipendenti in sei province e le servono 600 risposte.
- Allocazione proporzionale. Una provincia con 1.400 dipendenti rappresenta 1.400 diviso 4.200, cioè un terzo del personale, quindi riceve un terzo di 600, cioè 200 risposte. Una provincia con 210 dipendenti riceve 210 diviso 4.200 per 600, cioè 30 risposte. Ogni provincia è rappresentata in proporzione alla sua dimensione e in fase di analisi non serve alcuna ponderazione.
- Allocazione non proporzionale, detta anche sovracampionamento. Trenta risposte sono troppo poche per riportare separatamente quella piccola provincia. Quindi ne prendi deliberatamente 80 e riduci la provincia più grande per compensare. Ora le probabilità di selezione variano tra le province, quindi devi ponderare i dati riportandoli alle proporzioni reali prima di citare qualsiasi dato relativo all’intera organizzazione. Saltare questo passaggio è in assoluto l’errore più comune nel campionamento stratificato.
Scegliere gli strati. Scegli variabili legate al risultato o a chi è probabile che risponda, e che siano già presenti nella tua lista. Regione, sede, ruolo, fascia di anzianità, corso, tipo di piano e fascia d’età sono i candidati abituali. Gli strati che non hanno nulla a che fare con il risultato aggiungono lavoro amministrativo e non danno precisione. Se la variabile di raggruppamento manca nella tua lista, potresti doverla raccogliere direttamente nel questionario. La nostra guida alle domande demografiche spiega come chiedere queste variabili senza perdere partecipanti.
Campionamento a grappolo
Il campionamento a grappolo seleziona a caso interi gruppi naturali e poi coinvolge nell’indagine tutti i membri dei gruppi selezionati. Ti serve un elenco dei gruppi, non delle persone: è per questo che esiste.
Esempio svolto. Un distretto ha 180 scuole primarie e nessun elenco centrale degli alunni. Selezioni a caso 24 scuole e somministri il questionario a tutti gli alunni dell’8º anno di ciascuna. Hai fatto 24 visite scolastiche invece di 180, e per iniziare non ti è mai servito un registro degli alunni.
Che cosa paghi in cambio. Gli alunni della stessa scuola si somigliano tra loro più di quanto somiglino agli alunni del resto del distretto. Quindi ogni alunno in più di una scuola già scelta aggiunge meno informazione nuova di quanta ne aggiungerebbe un alunno indipendente. Il tuo numero effettivo di risposte è più piccolo del tuo numero reale di risposte. Questa inflazione è l’effetto del disegno, e va prevista nel piano invece di scoprirla in fase di analisi.
Dove non funziona. Troppo pochi grappoli. Sei scuole scelte a caso possono essere molto diverse tra loro, e il risultato oscilla a seconda di quali sei hai estratto. Più grappoli con meno persone ciascuno è quasi sempre meglio del contrario.
Campionamento a più stadi
Il campionamento a più stadi seleziona in due o più stadi: prima i gruppi, poi le unità all’interno dei gruppi selezionati, e a volte un terzo stadio all’interno di queste. Quasi tutte le indagini nazionali sulle famiglie nel mondo sono costruite così.
Esempio svolto. Seleziona 120 circoscrizioni dall’elenco nazionale delle circoscrizioni. In ogni circoscrizione selezionata, una squadra sul campo elenca le famiglie sul posto, poi ne seleziona 20 a caso. In ogni famiglia selezionata, un adulto viene scelto a caso invece di lasciare la risposta a chi apre la porta. Sono tre stadi, e l’ultimo conta: lasciare che sia la famiglia a decidere chi risponde reintroduce proprio il bias di selezione che il disegno doveva evitare.
Che cosa paghi in cambio. Persone diverse finiscono per avere probabilità di selezione diverse, quindi l’analisi richiede pesi, e il calcolo della varianza deve tenere conto del raggruppamento a ogni stadio. È un disegno vero e proprio, che richiede qualcuno in grado di condurre un’analisi ponderata. Se nessuno nel progetto ne è capace, scegli un disegno più semplice piuttosto che uno a più stadi senza ponderazione.
Approfondimento per esperti: probabilità proporzionale alla dimensione, e perché i grappoli grandi vengono scelti più spesso
Nell’esempio delle scuole ogni scuola aveva la stessa probabilità di selezione, che avesse 60 alunni o 900. Così un alunno di una scuola piccola ha una probabilità molto più alta di entrare nel campione rispetto a un alunno di una scuola grande. L’analisi deve poi correggere questo squilibrio.
La selezione con probabilità proporzionale alla dimensione risolve il problema in fase di disegno. La probabilità di selezione di ogni grappolo è fissata in proporzione a quante unità contiene. Una scuola di 900 alunni ha così quindici volte più probabilità di essere estratta di una scuola di 60 alunni. Poi prendi lo stesso numero di alunni da ogni scuola selezionata. I due stadi si compensano, e ogni alunno del distretto finisce con all’incirca la stessa probabilità complessiva di selezione. È l’approccio standard nelle indagini nazionali, e richiede una misura della dimensione per ogni grappolo della lista prima dell’estrazione.
Campionamento stratificato o a grappolo: la differenza in una riga
Questi due vengono confusi di continuo, perché entrambi iniziano dividendo la popolazione in gruppi. La differenza sta in quello che fai dopo.
| Aspetto | Campionamento stratificato | Campionamento a grappolo |
|---|---|---|
| Quali gruppi usi | Si campiona da ogni gruppo. | Si selezionano alcuni gruppi, gli altri non vengono usati affatto. |
| Chi campioni all’interno di un gruppo | Un sottoinsieme casuale del gruppo. | Tutti i membri del gruppo, oppure un ulteriore sottoinsieme casuale nella versione a più stadi. |
| I gruppi dovrebbero essere | Omogenei al loro interno e diversi tra loro. Regione, ruolo, corso. | Eterogenei al loro interno, ciascuno una piccola copia della popolazione. Scuole, ambulatori, quartieri. |
| Perché sceglierlo | Precisione e rappresentazione garantita dei sottogruppi. | Costo e raggiungibilità quando non esiste un elenco di individui. |
| Effetto sulla precisione | Di solito la migliora rispetto al casuale semplice a parità di numero di risposte. | La riduce. Metti in conto l’effetto del disegno. |
| Che cosa ti serve prima di iniziare | Un elenco completo degli individui, con la variabile di raggruppamento già presente. | Solo un elenco di gruppi. |
Stratificato: tutti i gruppi, alcune persone. A grappolo: alcuni gruppi, tutte le persone. Lo stratificato riguarda l’accuratezza, quello a grappolo l’accesso.
I metodi di campionamento non probabilistico, uno per uno
Il campionamento non probabilistico significa che le probabilità di selezione sono ignote, perché nessun meccanismo casuale ha deciso chi è stato scelto. È la scelta giusta in quattro situazioni. Non riesci a costruire una lista utilizzabile. Il gruppo è nascosto. La velocità conta più della precisione. Oppure la domanda riguarda il significato più che la dimensione.
Questi metodi non sono di serie B. Rispondono a una domanda diversa. L’errore non è mai usarli, è usarli e poi scrivere una frase che solo un campione probabilistico potrebbe sostenere.
Campionamento di convenienza
Il campionamento di convenienza, detto anche campionamento per disponibilità, recluta chi è più facile da raggiungere. Un pop-up su un sito web, un link in una newsletter, gli studenti della tua classe, le persone che passano davanti a un banco del mercato.
Esempio. Un negozio inserisce un link per il feedback sullo scontrino. Tutti quelli che rispondono hanno comprato qualcosa, avevano con sé un telefono, avevano tempo e avevano un motivo per prendersi il disturbo. Ognuno di questi filtri elimina una parte diversa della clientela.
Uso onesto. Fare uno studio pilota di un questionario, generare ipotesi, scoprire il linguaggio che usano i clienti, verificare che una domanda venga capita. Tutti usi eccellenti. Nessuno di questi richiede una stima sulla popolazione.
Campionamento per quote
Il campionamento per quote fissa obiettivi di reclutamento per gruppi definiti e li riempie. Quaranta in aree rurali e sessanta in aree urbane. Cinquanta donne e cinquanta uomini. Venti in ciascuna di cinque fasce d’età.
Esempio. Un team di ricerche di mercato ha bisogno di 500 risposte che rispecchino la ripartizione nazionale per età, genere e regione, e non ha un elenco della popolazione. Recluta finché ogni cella non è piena.
Perché non è comunque un campionamento probabilistico. Le quote controllano la forma del campione, non la selezione delle persone che lo compongono. Chi recluta continua a scegliere, e le persone facili da avvicinare sono sistematicamente diverse da quelle che non lo sono. Un campione può corrispondere perfettamente alla popolazione per età e genere ed essere comunque molto lontano dalla realtà sugli atteggiamenti, perché età e genere non erano mai le variabili che causavano il danno.
Campionamento ragionato
Il campionamento ragionato, detto anche campionamento a scelta ragionata, seleziona deliberatamente i casi che rispondono a criteri dichiarati. Le varianti più comuni sono la selezione di casi tipici, di casi estremi, di casi critici, a massima variazione e di esperti.
Esempio. Uno studio su come viene usato un nuovo sistema di pagamento seleziona otto persone. Due che lo usano ogni giorno, due che ci hanno rinunciato, due che non l’hanno mai adottato e due addetti dell’assistenza che gestiscono i reclami. Quella varietà è scelta di proposito, e il ragionamento è il metodo.
Uso onesto. La maggior parte della ricerca qualitativa. Qui il criterio non è la casualità. È se sai dire perché proprio questi casi e non altri, e se la gamma di punti di vista è abbastanza ampia da sostenere le tue affermazioni.
Campionamento a valanga
Il campionamento a valanga recluta un piccolo numero di partecipanti che poi segnalano altre persone che rispondono ai criteri, e queste ne segnalano altre ancora.
Esempio. Uno studio sui venditori transfrontalieri informali parte da quattro partecipanti individuati tramite un’associazione locale, e ciascuno ne presenta altri due. Non esiste un registro dei venditori informali, quindi nessun metodo basato su una lista è disponibile.
Che effetto ha sul tuo campione. Omofilia. Le persone segnalano persone simili a loro. Il campione scivola verso una sola rete sociale e si allontana dai membri isolati della popolazione, che spesso sono proprio quelli che la ricerca ha più bisogno di ascoltare. Partire da diversi punti di partenza non collegati tra loro invece che da uno solo riduce lo scivolamento ma non lo elimina.
Come rendere difendibile un campione non probabilistico
La maggior parte delle guide si ferma a “non puoi generalizzare” e lascia il lettore a piedi, perché la maggior parte dei lettori sta conducendo proprio questo tipo di studio. Ecco la parte che di solito manca.
- Descrivi il reclutamento, non solo il nome del metodo. Dove è stato pubblicato il link, in quali date, chi lo ha visto, se è stato offerto un incentivo e quante persone sono state contattate rispetto a quante hanno risposto. È questo che permette a chi legge di giudicare il campione invece di tirare a indovinare.
- Confronta il campione ottenuto con un riferimento noto e pubblica il confronto. Se la tua organizzazione è composta per il 60 per cento da personale sul campo e i tuoi partecipanti lo sono per il 25 per cento, dillo in una tabella. Uno squilibrio dichiarato è un risultato. Uno nascosto è un difetto.
- Sappi che cosa la ponderazione può fare e che cosa no. Correggere i dati perché le caratteristiche demografiche corrispondano alla popolazione può rimediare a uno squilibrio visibile. Non può rimediare alle persone che differiscono dai partecipanti per qualcosa che non hai misurato, e non trasforma mai un campione non probabilistico in uno che sostiene un’affermazione di precisione.
- Cambia la frase, non le statistiche. Invece di “il 38 per cento dei clienti è insoddisfatto, più o meno 4 punti”, scrivi “il 38 per cento dei 620 clienti che hanno risposto si è dichiarato insoddisfatto. I partecipanti sono stati reclutati tramite un avviso nell’app nell’arco di due settimane e non sono un campione casuale dei clienti.” La seconda frase è più breve, più utile e inattaccabile.
Il lavoro qualitativo ha un proprio vocabolario per questo. Un protocollo di solito chiede una motivazione più che un obiettivo numerico. Dovrebbe indicare il numero previsto e la gamma di punti di vista, una distinzione che la guida della University of Bath spiega in modo conciso.5
Abbina il metodo alla situazione
Sei situazioni, sei metodi. Decidi prima di aprire la risposta. È il modo più rapido per capire se la tabella qui sopra è stata davvero assimilata.
1. Hai un registro completo del personale di 4.200 persone e devi pubblicare i risultati per ciascuna delle sei province.
Campionamento stratificato. L’elenco completo esiste, quindi il campionamento probabilistico è alla tua portata, e l’obbligo di riportare i risultati per provincia è proprio lo scopo della stratificazione. Il campionamento casuale semplice lascerebbe la provincia più piccola con troppo poche risposte per riportarla.
2. Stai studiando persone che hanno lasciato un servizio sei mesi fa. Non c’è un elenco, e chi se n’è andato più arrabbiato è il più difficile da trovare.
Campionamento a valanga. Non esiste una lista e la popolazione è difficile da raggiungere, il che esclude tutti i metodi probabilistici. Parti da diversi punti di partenza non collegati tra loro invece che da uno solo, e dichiara nei limiti che le catene di segnalazioni spostano il campione verso le persone più connesse.
3. Un ospedale vuole dati sull’esperienza dei pazienti da un flusso di 9.000 visite a trimestre, raccolti da personale senza computer allo sportello.
Campionamento sistematico. La popolazione arriva come un flusso ordinato, quindi una regola a intervallo è sia un metodo probabilistico sia qualcosa che uno sportello affollato può davvero applicare. Controlla prima che l’ordine delle visite non segua un ciclo settimanale che coincide con il tuo intervallo.
4. Devi capire perché un nuovo strumento viene abbandonato, e hai tre settimane e nessun budget.
Campionamento ragionato. La domanda riguarda il meccanismo, non l’entità. Seleziona deliberatamente lungo tutta la gamma: utenti assidui, chi ha abbandonato, chi non l’ha mai adottato, personale di assistenza. Non riportare percentuali da questo campione.
5. Un distretto ha 180 scuole, nessun registro degli alunni e un budget per gli spostamenti che copre circa 25 visite.
Campionamento a grappolo. Un elenco delle scuole esiste anche se non esiste un elenco degli alunni, e il costo degli spostamenti è il vincolo decisivo. Amplia l’intervallo che riporti per tenere conto dell’effetto del disegno, e preferisci più scuole con meno alunni ciascuna al contrario.
6. Devi raccogliere 500 risposte in cinque giorni che rispecchino il profilo nazionale per età e regione, e non c’è un elenco della popolazione.
Campionamento per quote. È il modo più rapido per ottenere un campione che corrisponda almeno alla popolazione per le caratteristiche visibili. Non è comunque un campione probabilistico, quindi riporta la composizione e rinuncia all’affermazione di precisione.
Come scegliere un metodo di campionamento
La maggior parte degli studi non fallisce perché qualcuno ha scelto la tecnica sbagliata. Fallisce perché la tecnica non era adatta alla lista, alla decisione da prendere o a ciò che la squadra sul campo poteva realisticamente fare. Tre domande risolvono la questione quasi sempre.
Quale metodo è adatto al tuo studio?
Rispondi a tre domande. La raccomandazione compare qui sotto e le righe corrispondenti vengono evidenziate nella tabella di confronto.
Parti dall’affermazione che devi fare
Scrivi la frase che vuoi pubblicare, prima di scegliere qualsiasi cosa. “Il sessantadue per cento dei nostri clienti ci consiglierebbe” e “i clienti che se ne vanno descrivono tre problemi ricorrenti” sono frasi diverse che richiedono disegni diversi. Se nessuno tratterà il risultato come un dato sulla popolazione, hai molta più libertà di quanto pensi.
Verifica la lista prima di impegnarti
Riesci davvero a elencare la popolazione, o un suo equivalente molto vicino? Se no, riesci a elencare i gruppi a cui appartiene? Rispondere a questa sola domanda elimina subito la maggior parte dei nove metodi, ed è per questo che viene per seconda e non per ultima.
Indica i sottogruppi che devi riportare
Se un risultato deve comparire per ogni regione, sede o ruolo, questo orienta il disegno verso strati o quote. Determina anche quante risposte ti servono in ogni gruppo. Deciderlo dopo la rilevazione sul campo non è più rimediabile.
Confronta il disegno con la realtà sul campo
Tempo, budget, contattabilità, accesso linguistico, alfabetizzazione, connettività e politica sugli incentivi decidono che cosa è realizzabile. Un disegno che la squadra sul campo non riesce a seguire diventa un campionamento di convenienza con un nome formale, il che è peggio che scegliere onestamente il campionamento di convenienza. Pianificare un reclutamento inclusivo riduce la sottorappresentazione sistematica.6 Una volta selezionato il campione, usa un generatore di questionari online per preparare il questionario e inviarlo alle persone scelte dal tuo piano di campionamento. Condividere un link pubblico senza restrizioni cambia chi può rispondere: non preserva un campione casuale.
Dove i campioni cedono davvero: copertura, selezione e mancata risposta
La selezione è la parte che preoccupa tutti e quella che va storta meno spesso. Il danno di solito avviene prima della selezione, nella lista, oppure dopo, in chi si prende la briga di rispondere. Entrambi producono fogli di calcolo dall’aspetto pulito e conclusioni sbagliate.
| Errore | Come si presenta | Come ridurlo |
|---|---|---|
| Errore di copertura, un problema della lista | Alcune persone non possono essere selezionate affatto: niente email aziendale, un elenco del personale non aggiornato, clienti che comprano solo di persona, famiglie senza connessione. | Migliora o combina le liste. Aggiungi modalità: carta, di persona, telefono, SMS. Documenta esattamente chi è escluso. |
| Bias di selezione, un problema di procedura | In pratica la regola casuale viene scavalcata. Chi prima arriva meglio alloggia. Un responsabile indica chi partecipa. | Automatizza l’estrazione. Separa chi seleziona da chi recluta. Verifica ogni eccezione. |
| Bias di non risposta, un problema di esito | Le persone selezionate non rispondono, e chi non risponde differisce da chi risponde proprio per ciò che stai misurando. | Migliora la strategia di contatto e l’esperienza del questionario, poi confronta i partecipanti con un riferimento noto. Vedi bias di risposta. |
| Errore di misura | Anche un campione impeccabile ti dà risultati privi di senso se le domande sono tendenziose, vaghe o doppie. | Prova lo strumento prima di avviare la rilevazione. La nostra guida alla scrittura delle domande di un questionario tratta i difetti più comuni. |
Il fallimento di campionamento più famoso aveva 2,4 milioni di partecipanti
Nel 1936 il Literary Digest previde che Alf Landon avrebbe ottenuto circa il 55 per cento dei voti. Franklin Roosevelt vinse con circa il 61 per cento.7 La rivista aveva spedito 10 milioni di schede e ne aveva ricevute indietro circa 2,4 milioni, un tasso di risposta del 24 per cento a cui nessun sondaggio nazionale di oggi si avvicina.8 Il sondaggio collocò Roosevelt venti punti sotto la sua quota reale, su un campione di due milioni e mezzo di persone.
Il numero che dovrebbe comparire in ogni pagina sul campionamento. Una successiva rianalisi calcolò il margine di errore campionario delle stime del Digest a livello di singolo stato: andava da 0,18 a 2,3 punti percentuali, con una mediana di 0,6.8 Un dato di precisione di più o meno mezzo punto, sopra un errore di venti punti. Nulla dimostra in modo più netto che un margine di errore misura solo uno dei tanti modi in cui un’indagine può sbagliare.
E la spiegazione classica è giusta solo a metà. A tutti viene insegnato che il Digest campionò proprietari di auto e abbonati al telefono, che erano ricchi e repubblicani. Una verifica empirica di questa tesi ha usato un sondaggio Gallup del maggio 1937. Le persone che possedevano sia un’auto sia un telefono si schieravano comunque per Roosevelt, 55 a 45. Tra tutti quelli che dissero di aver ricevuto una scheda del Digest, Roosevelt era in testa 55 a 44. La lista pendeva verso i repubblicani, ma non abbastanza da produrre una valanga di voti per Landon.7
La metà mancante è la mancata risposta. Tra chi disse di aver restituito la scheda, Landon era in testa 51 a 48. Tra chi non l’aveva restituita, Roosevelt era in testa 69 a 30. La scomposizione approssimativa attribuisce circa undici punti dell’errore alla lista e circa sette alla mancata risposta differenziale.7 Ponderare le schede restituite su una domanda che il Digest aveva già posto, come avevi votato nel 1932, avrebbe indicato il vincitore giusto con l’aritmetica disponibile nel 1936.8
Un alto tasso di risposta non è l’obiettivo che pensi
I tassi di risposta dei sondaggi telefonici del Pew Research Center sono scesi dal 36 per cento del 1997 al 9 per cento nel 2012, e al 6 per cento nel 2018.9 Nel frattempo la National Family Health Survey dell’India, condotta faccia a faccia, ha selezionato 664.972 famiglie e ne ha trovate abitate 653.144. Ne ha intervistate 636.699, un tasso di risposta del 97,5 per cento. Leggi con attenzione quel denominatore, perché è il punto in cui un tasso di risposta sbaglia più spesso: rispetto al numero di famiglie selezionate invece che a quello delle abitate, la stessa rilevazione risulta al 95,7 per cento. L’indagine ha estratto il campione da 30.456 grappoli in tutti i 707 distretti.10
Questi due fatti appartengono allo stesso decennio. La modalità e l’impegno sul campo influenzano i tassi di risposta molto più di qualsiasi affermazione generale sulla stanchezza da questionari. Se una guida ti dice che il tasso di risposta medio è un certo numero preciso, non sta descrivendo una quantità reale.
Ora il risultato più scomodo. Una meta-analisi di 235 stime del bias di non risposta tratte da 30 studi pubblicati ha rilevato che la correlazione tra tasso di risposta ed entità del bias di non risposta era 0,33. Elevata al quadrato, significa che il tasso di risposta spiega circa l’11 per cento della variazione del bias.11 Un’analisi successiva su 59 studi progettati appositamente per misurare il bias di non risposta è giunta alla stessa conclusione.12
Il tasso di risposta vale la pena di riportarlo e di migliorarlo. Non è un certificato di qualità. Ciò che causa il bias è se la propensione a rispondere è legata a ciò che misuri. Un’indagine sul volontariato ne soffre molto più di un’indagine sulla velocità della banda larga. Insegui la correlazione, non la percentuale.
Più risposte non possono riparare una lista difettosa
Durante la campagna vaccinale del 2021, due indagini molto grandi hanno monitorato l’adesione ai vaccini negli Stati Uniti. Una raccoglieva circa 250.000 risposte a settimana e ha sovrastimato l’adesione alla prima dose di 17 punti percentuali rispetto al riferimento ufficiale. L’altra ne raccoglieva circa 75.000 ogni due settimane e l’ha sovrastimata di 14. Una terza indagine su circa 1.000 partecipanti, condotta secondo la prassi probabilistica standard, ha prodotto stime affidabili.13
Lo stesso schema compare nel lavoro ordinario con i questionari. Confrontando tre panel probabilistici con tre fonti online ad adesione volontaria su 28 riferimenti e 29.937 interviste, l’errore assoluto medio era di 5,8 punti percentuali per i campioni ad adesione volontaria e di 2,6 per i panel probabilistici. Sui 25 di quei riferimenti disponibili per i sottogruppi, il divario per gli adulti tra i 18 e i 29 anni era di 11,2 contro 3,6.14
E una diagnosi memorabile: in un’indagine ad adesione volontaria, il 12 per cento degli adulti sotto i 30 anni ha dichiarato di avere l’abilitazione a guidare un sottomarino nucleare.15 Il dato reale è vicino allo zero. Se un panel può produrre questo, può produrre qualsiasi cosa, e ordinare un campione più grande allo stesso panel significa solo comprarne di più.
Chi manca nella tua lista, fuori da Stati Uniti e Regno Unito
La maggior parte delle guide al campionamento dà per scontata una lista occidentale: una mailing list, un telefono fisso, un registro nazionale degli indirizzi. Gran parte del mondo non campiona così, e le lacune di copertura hanno una forma misurata.
- Un’indagine online in un paese a reddito basso o medio è un campione della sua parte connessa, e quella parte è sbilanciata verso gli uomini. Nei paesi a reddito basso e medio le donne hanno il 14 per cento di probabilità in meno rispetto agli uomini di usare internet da mobile, il che corrisponde a circa 235 milioni di donne in meno online rispetto agli uomini.16
- I campioni telefonici sovrarappresentano i capifamiglia. Nelle indagini telefoniche della Banca Mondiale in quattro paesi africani, i partecipanti erano uomini al 52 per cento in Uganda e al 73 per cento in Nigeria, a fronte di circa la metà della popolazione adulta. In Uganda il 6 per cento dei partecipanti telefonici aveva tra i 15 e i 24 anni, contro il 38 per cento della popolazione adulta.17
- Che cosa fare. Combina più modalità invece di difenderne una sola. Elenca le famiglie sul posto dove non esiste un registro. Fai la rilevazione nelle lingue che la tua popolazione legge davvero, e fai un pretest della traduzione invece di ritradurla all’indietro. Poi dichiara la lacuna residua nei tuoi limiti, perché ci sarà ancora.
Che cosa la ponderazione può correggere e che cosa no
La ponderazione corregge i dati perché la composizione del campione corrisponda ai dati noti della popolazione. È davvero potente ed è regolarmente sopravvalutata.
Gli argomenti a favore. Nel 2016 l’ultimo sondaggio della University of New Hampshire dava Clinton avanti di 11 punti in una corsa che vinse con uno scarto di 0,4. Non era stato corretto per il livello di istruzione. La commissione di revisione concluse che questa sola correzione avrebbe eliminato sostanzialmente tutto l’errore.18 Una variabile, correlata sia con la risposta sia con il risultato, che fa tutto il lavoro.
Gli argomenti contro l’affidarsi a essa. Quando oltre 30.000 interviste online ad adesione volontaria sono state confrontate con 24 riferimenti, il bias medio stimato era di 8,4 punti percentuali senza ponderazione. Con tutte le procedure di ponderazione provate, compresi sofisticati metodi di abbinamento, nessuna ha portato il bias medio sotto i 6 punti.19 Quadruplicare la dimensione del campione ha fatto guadagnare altri 0,2 punti.
La regola che ne deriva è semplice. La ponderazione corregge lo squilibrio sulle variabili su cui ponderi, nella misura in cui quelle variabili sono legate al risultato. Non fa nulla per i modi in cui i partecipanti differiscono da chi non risponde per aspetti che non hai mai misurato, e non trasforma mai un campione non probabilistico in uno che sostiene un’affermazione di precisione.
Un dato di precisione è un minimo, non un massimo
Un margine di errore quantifica la variabilità campionaria, e soltanto quella. Presuppone che il campione sia stato estratto a caso dalla popolazione obiettivo e che il bias residuo sia stato eliminato. L’errore di copertura, il bias di non risposta, l’errore di misura e i partecipanti fraudolenti ne restano tutti fuori.
Le prove sono nette. Nelle ultime due settimane del 2020, 348 sondaggi presidenziali a livello di singolo stato riportavano un margine di errore, e il dato medio riportato era di 3,9 punti. Rispetto a quella media, il 55 per cento ha mancato il margine finale di più di un margine di errore, e il 21 per cento di più del doppio.20 Erano sondaggi moderni con metodi moderni. Tratta il margine di errore come un minimo della tua incertezza, mai come un massimo.
| Affermazione | Il numero | Livello | Fonte |
|---|---|---|---|
| Il tasso di risposta predice a malapena il bias di non risposta | r = 0,33, quindi circa l’11% della variazione, su 235 stime da 30 studi | A | Groves, 200611 |
| Un’indagine molto grande può sbagliare di molto | Ha sovrastimato l’adesione ai vaccini di 17 punti su circa 250.000 risposte a settimana | A | Bradley e altri, 202113 |
| I campioni ad adesione volontaria sono circa due volte meno accurati dei panel probabilistici | Errore medio di 5,8 contro 2,6 punti percentuali su 28 riferimenti | A | Mercer e Lau, 202314 |
| La ponderazione migliora un campione ad adesione volontaria ma non lo salva | 8,4 punti senza ponderazione, nessun metodo sotto i 6,0 punti | A | Mercer, Lau e Kennedy, 201819 |
| Un margine di errore sottostima l’errore reale dei sondaggi | Il 55% di 348 sondaggi nei singoli stati del 2020 ha sbagliato di più del margine di errore medio riportato di 3,9 punti | A | Task force AAPOR, 202120 |
| La spiegazione del Literary Digest basata sulla lista è incompleta | I proprietari di auto e telefono preferivano comunque Roosevelt 55 a 45 | B | Squire, 19887 |
Il livello A indica una statistica ufficiale, una meta-analisi o un risultato replicato. Il livello B indica un singolo studio solido la cui conclusione non è ancora stata ripetuta in modo indipendente.
“Un tasso di risposta del 50 per cento è adeguato, il 60 è buono, il 70 è molto buono.” Una regola pratica da manuale senza alcun dato a sostegno. Autorità diverse dello stesso settore indicano 50, 60 e 80. Il bias dipende dalla correlazione tra il rispondere e la risposta, non dal tasso.
“Trenta bastano, perché è lì che entra in gioco il teorema del limite centrale.” Non esiste alcuna dimostrazione che porti a 30. Per esiti simmetrici l’approssimazione funziona ben al di sotto, e per esiti asimmetrici o eventi rari fallisce ben al di sopra.
“Il tasso di risposta medio dei questionari è del 33 per cento.” Circola sui blog dei fornitori con formulazioni quasi identiche e senza una fonte primaria. Modalità, committente, popolazione e incentivi sommergono qualsiasi media globale.
“La soglia di attenzione oggi è di otto secondi, meno di quella di un pesce rosso.” Risale a un report di marketing del 2015 che citava un’azienda incapace di indicarne la fonte. La ricerca originale non menziona mai né gli otto secondi né i pesci rossi.
Effetto del disegno: perché i campioni a grappolo richiedono più persone
Quasi tutte le guide consigliano il campionamento a grappolo per il risparmio che offre e si fermano lì. Il risparmio è reale, e lo è anche il conto da pagare. Le persone della stessa scuola, ambulatorio, quartiere o negozio si somigliano. Si somigliano più di quanto somiglino a persone scelte a caso in tutta la popolazione. Quindi ogni risposta in più da un gruppo che hai già scelto porta meno informazione nuova.
L’effetto del disegno è il numero che misura questo fenomeno. In parole semplici: di quanto si allarga la tua incertezza rispetto a estrarre lo stesso numero di persone in modo indipendente. Per un disegno con gruppi di uguale dimensione è
effetto del disegno = 1 + (dimensione media del gruppo - 1) x correlazione intraclasse
La correlazione intraclasse indica quanto si somigliano le persone di uno stesso gruppo rispetto a ciò che stai misurando. Zero significa che essere nella stessa scuola non dice nulla sulla risposta di un alunno. Uno significa che tutti in una scuola rispondono in modo identico, e tanto varrebbe considerare la scuola come una sola persona. I valori reali sono piccoli, ma i valori piccoli fanno molti danni quando i gruppi diventano grandi. Considerando insieme 48 indagini nazionali sulle famiglie, la correlazione intraclasse media è di circa 0,06. Varia a seconda di ciò che misuri. Gli item sulla fecondità vanno da circa 0,01 a 0,03, l’uso attuale di contraccettivi da 0,03 a 0,05, e i parti assistiti da personale sanitario arrivano fino a 0,22 nei dati nazionali.21
Se non hai una stima tua, prendi in prestito un valore predefinito con cautela. Il manuale di campionamento DHS ricorre a 1,5 per il deft quando un’indagine non ha un dato proprio.22 Il deft non è la stessa grandezza dell’effetto del disegno nella formula qui sopra: è il rapporto tra i due errori standard, mentre l’effetto del disegno è il rapporto tra le due varianze. Va elevato al quadrato, quindi un deft di 1,5 corrisponde a un effetto del disegno di 2,25. Il manuale definisce questo valore un ripiego, non un valore tipico, e i suoi esempi svolti usano 1,40 per l’uso di contraccettivi moderni e 1,22 per la vaccinazione infantile.
| Disegno | Effetto del disegno | Risposte effettive | Che cosa significa in pratica |
|---|---|---|---|
| Selezione indipendente, nessun raggruppamento | 1.00 | 960 | Ogni risposta vale una risposta piena. |
| 24 gruppi da 40, ICC 0,02 | 1.78 | 539 | Ne hai pagate 960 e puoi difendere la precisione di 539. |
| 24 gruppi da 40, ICC 0,05 | 2.95 | 325 | Due terzi della rilevazione sul campo non ti hanno dato nulla in più in precisione. |
| 24 gruppi da 40, ICC 0,10 | 4.90 | 196 | Il disegno è diventato, senza che nessuno se ne accorgesse, uno studio piccolo con il budget di uno grande. |
La ponderazione aggiunge una sua componente. Un’indagine nazionale che sovracampiona una regione e poi la ripondera porta con sé due effetti del disegno insieme. Un effetto di ponderazione di 1,22 e un effetto di raggruppamento di 1,80 danno un effetto del disegno complessivo di 2,20. Così 5.000 famiglie intervistate si comportano come 2.277 famiglie indipendenti.23
La lezione per il disegno. Più gruppi con meno persone ciascuno battono meno gruppi con più persone ciascuno, quasi sempre. Quaranta scuole da 24 alunni e 24 scuole da 40 alunni costano più o meno le stesse 960 risposte, ma la prima soluzione ha un effetto del disegno più piccolo e un risultato difendibile. Se stai pianificando quante risposte ti servono in totale, calcolalo con la nostra guida alla dimensione del campione e poi moltiplica per l’effetto del disegno. Fare il contrario è il modo in cui gli studi a grappolo finiscono per avere una potenza insufficiente.
Tre esempi svolti, dall’inizio alla fine
I nomi dei metodi sono facili. È nelle decisioni intorno a essi che gli studi sbagliano davvero. Questi tre esempi portano un disegno reale dalla definizione della popolazione fino alla frase che puoi pubblicare.
Esempio 1: l’esperienza dei pazienti in un distretto
- Popolazione. Adulti che hanno avuto una visita ambulatoriale in uno qualsiasi dei 46 ambulatori pubblici del distretto tra il 1 aprile e il 30 giugno.
- Lista. Non esiste un registro dei pazienti per l’intero distretto. Esiste invece un elenco dei 46 ambulatori, con il numero mensile di accessi.
- Metodo. A più stadi. Seleziona 18 ambulatori con probabilità proporzionale agli accessi, poi campiona in modo sistematico un paziente ogni 8 in uscita durante due giorni di ambulatorio scelti a caso.
- Perché non qualcosa di più semplice. Un elenco completo dei pazienti permetterebbe un campionamento stratificato, ma non esiste e non si può costruire nei tempi previsti. Un campione di convenienza nei tre ambulatori più grandi sarebbe più rapido e descriverebbe i tre ambulatori più grandi.
- Che cosa va riportato. Le probabilità di selezione variano con la dimensione dell’ambulatorio, quindi l’analisi richiede pesi, e l’intervallo va ampliato per tenere conto dell’effetto del disegno.
- La frase pubblicabile. “Tra gli adulti che si sono rivolti agli ambulatori pubblici del distretto nel secondo trimestre, si stima che il 71 per cento abbia giudicato accettabile l’attesa, sulla base di 1.240 interviste all’uscita in 18 ambulatori selezionati con probabilità proporzionale agli accessi.”
Esempio 2: una tesi su una popolazione di studenti
- Popolazione. Studenti iscritti alla Facoltà di Economia nell’anno accademico in corso: 3.100 distribuiti su tre anni di corso.
- Lista. Il registro delle iscrizioni della facoltà, che riporta l’anno di corso e il corso di laurea.
- Metodo. Campionamento casuale stratificato per anno di corso, allocazione proporzionale, obiettivo 350 risposte complete.
- I calcoli. Il primo anno conta 1.300 studenti, cioè il 42 per cento di 3.100, quindi riceve il 42 per cento di 350, cioè 147 risposte. Ripeti per ogni anno. Poiché l’allocazione è proporzionale, non serve alcuna ponderazione.
- Pianificare le risposte. Con un tasso di risposta previsto del 35 per cento devi invitare circa 1.000 studenti per arrivare a 350 risposte complete, e conviene invitarli strato per strato, così una risposta debole in un anno si vede quando c’è ancora tempo per intervenire.
- Limiti da dichiarare. Gli studenti che si sono ritirati ma restano nel registro sono sovracopertura. Gli studenti iscritti dopo l’estrazione del registro sono sottocopertura. Entrambi vanno nel paragrafo sui limiti.
Esempio 3: il feedback dei clienti per un negozio online
- Popolazione. Clienti che hanno completato un ordine negli ultimi 90 giorni.
- Lista. La tabella degli ordini. È completa per gli ordini online e per gli acquisti come ospite, ma un cliente con due account compare due volte.
- Metodo. Elimina i duplicati per avere una riga per cliente, poi campionamento sistematico di un cliente ogni 12 dopo un inizio casuale, in modo continuo anziché in un unico blocco.
- La trappola che eviti. Invitare solo gli iscritti alla newsletter è più rapido ed è un campione di convenienza dei tuoi clienti più coinvolti. Farà sembrare la soddisfazione migliore di quanto sia, puntualmente, ogni trimestre.
- Una nota sui dipendenti. La stessa organizzazione che somministra un questionario ai suoi 180 dipendenti non dovrebbe campionare affatto. Quella popolazione è piccola, raggiungibile, e tutti hanno il diritto di essere interpellati. Fai un censimento e, se la partecipazione è scarsa, trattalo come un risultato e non come un problema di campionamento.
Come scrivere la parte sul campionamento della tua metodologia
È il passaggio che la maggior parte delle guide salta, ed è quello che un relatore, un revisore o un cliente legge davvero. La descrizione del campionamento deve rispondere a cinque domande in ordine: chi, da quale elenco, scelto come, quanti, e che cosa puoi quindi affermare.
Completa gli spazi qui sotto. È volutamente semplice: qui gli esaminatori non cercano una prosa elegante, cercano un disegno che possano valutare.
Lo stesso studio, scritto male e scritto bene
Debole. “È stato estratto un campione casuale di studenti e sono state raccolte 350 risposte.”
Qui non si può verificare nulla. “Casuale” fa un lavoro che non si è guadagnato, non c’è una lista, non c’è un denominatore e non si dice chi è stato escluso.
Solido. “La popolazione obiettivo erano i 3.100 studenti iscritti alla Facoltà di Economia nel 2026. La lista di campionamento era il registro delle iscrizioni della facoltà estratto il 3 marzo 2026. È stato usato un campionamento casuale stratificato per anno di corso con allocazione proporzionale, in modo da poter riportare ogni anno separatamente. Sono stati invitati mille studenti e 350 hanno completato il questionario, con un tasso di risposta del 35 per cento. Non è stata applicata alcuna ponderazione perché l’allocazione era proporzionale. Gli studenti ritirati dopo la data di estrazione sono rimasti nella lista e non è stato possibile identificarli, il che costituisce una fonte minore di sovracopertura.”
La seconda versione è più lunga, e ogni frase in più è una domanda che un revisore non deve più fare.
“I partecipanti sono stati reclutati tramite un avviso nell’app mostrato agli utenti attivi per due settimane. Si tratta di un campione di convenienza, quindi i risultati descrivono le persone che hanno risposto e non possono essere generalizzati all’intera base di utenti, e non viene riportato alcun dato di precisione. Rispetto all’insieme degli utenti, tra i partecipanti erano più frequenti gli utenti quotidiani, il che va tenuto presente nella lettura dei risultati.” Scrivi così e nessuno potrà accusarti di affermare troppo. Non l’hai fatto.
Checklist del piano di campionamento
Un piano di campionamento scritto evita la maggior parte degli errori evitabili, perché costringe a prendere le decisioni prima della rilevazione sul campo invece che durante l’analisi. Otto punti, una pagina.
- 1. Obiettivo della ricerca. Quale decisione supporta e che cosa esattamente verrà riportato?
- 2. Popolazione obiettivo. Chi è incluso e chi è escluso, compreso l’intervallo di tempo.
- 3. Lista di campionamento. Fonte, data di estrazione, numero di righe, lacune note e regola per eliminare i duplicati.
- 4. Metodo e motivazione. Quale dei nove, e perché proprio questo data la lista e l’affermazione da fare.
- 5. Obiettivi. Risposte complete in totale e per sottogruppo, più il tasso di risposta previsto su cui basi la pianificazione.
- 6. Piano di reclutamento. Modalità, calendario dei promemoria, disposizioni per lingua e accessibilità, politica sugli incentivi.
- 7. Monitoraggio. Che cosa terrai d’occhio durante la rilevazione: risposte per strato, punto di abbandono, mancata risposta ai singoli item.
- 8. Note per l’analisi. Ponderazione prevista, correzione per l’effetto del disegno e i limiti che dichiarerai in ogni caso.
Una volta definito il piano, è lo strumento a decidere se valeva la pena estrarre il campione. Un campione perfetto non può salvare una domanda tendenziosa o doppia, quindi conviene leggere qualche esempio di domande per questionari prima di avviare la rilevazione.
Domande frequenti
Che cos’è il campionamento nella ricerca?
Il campionamento è il processo con cui si seleziona un sottoinsieme di una popolazione, chiamato campione, e lo si studia per trarre conclusioni sull’intera popolazione. Si usa perché misurare ogni membro di una popolazione è di solito troppo lento, troppo costoso o impossibile. Il metodo usato per selezionare il campione determina quali conclusioni i risultati possono sostenere.
Qual è la differenza tra popolazione e campione?
La popolazione è l’intero gruppo che vuoi descrivere. Il campione è il sottoinsieme più piccolo che misuri davvero. Il campionamento è il processo che ti porta dall’una all’altro, e il censimento è l’alternativa in cui misuri invece l’intera popolazione.
Che cos’è una lista di campionamento?
Una lista di campionamento è l’elenco o il meccanismo concreto da cui estrai il campione: un registro degli studenti, un registro dei pazienti, un database clienti, un elenco delle famiglie, una lista elettorale. Conta più del nome del metodo, perché chiunque manchi dalla lista ha probabilità zero di essere selezionato, per quanto buona sia la tua tecnica di campionamento.
Quale metodo di campionamento non richiede una lista di campionamento?
Il campionamento di convenienza, per quote, ragionato e a valanga non richiede alcun elenco. Il campionamento a grappolo e a più stadi richiede solo un elenco di gruppi come scuole, ambulatori o villaggi, non un elenco di individui. Il campionamento casuale semplice, sistematico e stratificato richiede tutti un elenco completo degli individui prima di poter iniziare.
Qual è la differenza tra campionamento probabilistico e non probabilistico?
Nel campionamento probabilistico è un meccanismo casuale a selezionare, quindi ogni unità ha una probabilità nota e diversa da zero di essere scelta, e puoi calcolare quanto sono incerte le tue stime. Nel campionamento non probabilistico queste probabilità sono ignote, perché la selezione dipende dalla comodità, dalle quote o dal giudizio del ricercatore. La conseguenza pratica è che solo un disegno probabilistico sostiene un dato di precisione dichiarato per una stima sulla popolazione.
Qual è la differenza tra campionamento stratificato e a grappolo?
Il campionamento stratificato divide la popolazione in gruppi e prende un campione casuale da ogni gruppo, il che migliora la precisione e garantisce che ogni gruppo sia presente. Il campionamento a grappolo seleziona a caso alcuni gruppi e poi coinvolge nell’indagine tutti i membri dei gruppi selezionati, il che fa risparmiare quando non esiste un elenco di individui. In sintesi: lo stratificato usa tutti i gruppi e alcune persone, quello a grappolo alcuni gruppi e tutte le persone.
Che cos’è un’unità primaria di campionamento?
L’unità primaria di campionamento è ciò che viene selezionato al primo stadio di un disegno a più stadi. In un’indagine nazionale sulle famiglie di solito è un’area, come un quartiere, un villaggio o una sezione di censimento. Le famiglie vengono poi selezionate al suo interno al secondo stadio. Indicare l’unità primaria di campionamento è un requisito standard quando si riporta un disegno a grappolo, perché il raggruppamento che crea deve riflettersi nell’analisi.
Che cos’è il campionamento casuale stratificato?
Il campionamento casuale stratificato divide la popolazione in gruppi che non si sovrappongono, chiamati strati, poi estrae un campione casuale in modo indipendente all’interno di ogni strato. L’allocazione proporzionale assegna a ogni strato una quota del campione pari alla sua quota della popolazione e non richiede ponderazione. L’allocazione non proporzionale sovracampiona deliberatamente strati piccoli ma importanti, e richiede poi una ponderazione prima di riportare qualsiasi dato complessivo.
Il campionamento a valanga è valido per la ricerca accademica?
Sì, quando la popolazione è nascosta, rara o non registrata e non si può costruire una lista di campionamento. È un approccio riconosciuto per i gruppi difficili da raggiungere. Quello che non può fare è sostenere una stima sulla popolazione, e il suo punto debole principale è che i partecipanti segnalano persone simili a loro, quindi il campione scivola verso una sola rete sociale. Partire da diversi punti di partenza non collegati tra loro riduce questo scivolamento e va descritto nella metodologia.
Il campionamento casuale è la stessa cosa dell’assegnazione casuale?
No. Il campionamento casuale è il modo in cui selezioni i partecipanti da una popolazione, e determina a chi si possono generalizzare i tuoi risultati. L’assegnazione casuale è il modo in cui distribuisci i partecipanti selezionati tra le condizioni di un esperimento, e determina se un effetto osservato si può attribuire al trattamento. Uno studio può usare l’una senza l’altro, e la maggior parte degli esperimenti usa l’assegnazione casuale senza il campionamento casuale.
Posso usare un metodo di campionamento non probabilistico in uno studio quantitativo?
Sì, e lo fa gran parte della ricerca quantitativa pubblicata. Quello che cambia è ciò che puoi affermare. Puoi riportare conteggi, percentuali e relazioni all’interno del tuo campione, e puoi confrontare i gruppi al suo interno. Non puoi presentare quelle percentuali come stime sulla popolazione con una precisione dichiarata. Indica il metodo, descrivi il reclutamento, confronta i partecipanti con un riferimento noto quando esiste, e scrivi il limite in modo esplicito invece di sperare che nessuno lo chieda.
Qual è la differenza tra campionamento e distribuzione campionaria?
Il campionamento è la procedura per selezionare un campione. La distribuzione campionaria è un’idea diversa. Immagina di ripetere la stessa procedura di campionamento molte volte. La dispersione della statistica risultante, come la media o la percentuale, su tutti quei campioni immaginari è la distribuzione campionaria. È la distribuzione campionaria a rendere possibili gli intervalli di confidenza, e si comporta in modo prevedibile solo quando il campione è stato estratto con un metodo probabilistico.
Come faccio a sapere se il mio campione è distorto?
Confronta il campione ottenuto con un riferimento noto, come il tuo elenco del personale, i registri delle iscrizioni o i dati amministrativi, sulle variabili legate a ciò che stai misurando. Grandi scarti indicano problemi di copertura, problemi di selezione o una mancata risposta differenziale. Confronta anche i diversi canali di reclutamento e le ondate di promemoria. Tieni presente che un buon tasso di risposta è una prova debole di un bias basso: su 235 stime pubblicate, il tasso di risposta spiegava solo circa l’11 per cento della variazione del bias di non risposta.
Letture correlate
Il campionamento è una decisione all’interno di uno studio più ampio. Queste guide coprono le decisioni che lo precedono e lo seguono.
- Disegno di ricerca dell’indagine colloca il campionamento nella sequenza del resto dello studio, dalla definizione della popolazione all’avvio.
- Come determinare la dimensione del campione tratta i calcoli sulla precisione che questa pagina lascia volutamente ad altri, formule comprese.
- Come scrivere le domande di un questionario tratta il lato della misura, che nessun disegno di campionamento può salvare.
- Principi di progettazione del questionario spiega come si assembla un intero strumento una volta che le domande esistono.
- Bias di risposta approfondisce la differenza tra le persone che hai selezionato e quelle che hanno risposto.
- Domande demografiche è utile quando la tua lista non contiene la variabile su cui ti serve stratificare.
- Significatività statistica spiega che cosa fare con i numeri una volta raccolto il campione.
- Analisi dei dati quantitativi tratta i passaggi di analisi successivi, compreso dove vanno applicati i pesi.
Come è stata scritta questa guida e che cosa non tratta
Chi l’ha scritta. Michael Hodge, che si occupa di metodologia delle indagini, progettazione delle domande e qualità dei dati in SuperSurvey, e scrive le guide pratiche della nostra sezione Guide e aiuto.
Su che cosa si basa. Le definizioni seguono la rassegna metodologica e le linee guida universitarie sulla ricerca citate qui sotto, che è dove i termini tecnici vengono effettivamente definiti. Le pagine ufficiali sull’integrità della ricerca e degli istituti di statistica sono indicate come brevi punti di partenza in linguaggio semplice, non come fonte di quelle definizioni. Le descrizioni dei metodi seguono le stesse rassegne e linee guida. Ogni numero della sezione sulle prove proviene da una fonte primaria indicata qui sotto. Ogni affermazione ha anche un livello di affidabilità, così puoi vedere quali risultati sono consolidati e quali si basano su un solo studio. I dati sull’effetto del disegno nel grafico e nella tabella sono calcoli nostri. Abbiamo usato la formula standard, con le ipotesi riportate nella didascalia, così puoi rifarli o contestarli con le dimensioni dei tuoi grappoli.
Che cosa non tratta. Questa guida riguarda il campionamento per indagini e studi osservazionali. Non tratta il disegno sperimentale né l’assegnazione casuale, se non per distinguerli. Lascia fuori anche il campionamento per il collaudo di accettazione, la revisione contabile e l’elaborazione dei segnali, che usano la stessa parola per cose diverse. Il campionamento guidato dai partecipanti, il campionamento tempo-luogo e il campionamento a grappolo adattivo sono metodi reali che gli specialisti usano per le popolazioni nascoste, e qui non vengono trattati. I dati sulla correlazione intraclasse provengono da indagini sulle famiglie in paesi a reddito basso e medio. Considerali illustrativi, non valori da trasferire in un contesto diverso.
Dove i numeri sono più deboli. La rianalisi del Literary Digest si basa su un solo sondaggio del 1937 e su una sola rianalisi successiva, ed entrambi gli autori segnalano la propria incertezza; per questo ha livello B. I dati sull’errore dei sondaggi provengono dai sondaggi elettorali degli Stati Uniti, che sono studiati in modo insolitamente approfondito e non sono necessariamente rappresentativi dell’errore delle indagini in generale.
Trasparenza. SuperSurvey vende software per questionari. Niente in questa pagina è in vendita, nessuna parte richiede la registrazione, e nessuna organizzazione ha sponsorizzato o revisionato questa guida. Quando rimandiamo alle nostre pagine è perché trattano la decisione successiva, non perché un link ci faccia guadagnare qualcosa.
Bibliografia
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., e Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- Governo del Regno Unito (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., e Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., e Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences e ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., e Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., e Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., e Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., e Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, pagine 9 e 15. I dati sono tratti dall’edizione 2025; GSMA ha poi pubblicato un’edizione 2026 con un divario più ridotto.
- Brubaker, J., Kilic, T., e Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., e altri (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., e Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., e Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, pagina 9 e tabella 1.2.
- Kalton, G., Brick, J. M., e Le, T. (2005). Estimating components of design effects for use in sample design. In Household Sample Surveys in Developing and Transition Countries, capitolo VI. Nazioni Unite, Series F No. 96.