
Кратко
Формирование выборки — это процесс отбора части генеральной совокупности, называемой выборкой, и изучения этой части, чтобы сделать выводы обо всей генеральной совокупности. Исследователи прибегают к выборке, потому что измерить всех обычно слишком долго, слишком дорого или просто невозможно. Генеральная совокупность — это группа, которую Вы хотите описать, выборка — та её часть, которую Вы фактически измеряете, а основа выборки — список, из которого Вы извлекаете выборку.
Вероятностная выборка отбирает людей с помощью случайного механизма, поэтому у каждой единицы есть известный ненулевой шанс попасть в выборку. Именно это позволяет выразить Вашу неопределённость числом.
Невероятностная выборка отбирает по принципу удобства, квот или суждения исследователя. Часто она быстрее, дешевле, а иногда это единственный этичный вариант, но она не может обосновать оценку для генеральной совокупности с заявленной точностью.
Перейти сразу к разделам: сравнение 9 методов | как выбрать метод | проверьте себя | как это описать
Главное
- Выборка означает изучение части: Вы измеряете выборку, чтобы узнать о генеральной совокупности, когда измерить всех невозможно.
- Сначала разберитесь с пятью терминами: генеральная совокупность, основа выборки, единица выборки, дизайн выборки и разрыв между генеральной совокупностью, которую Вы хотите изучить, и той, которую Вы реально можете охватить. Большинство споров о выборке на самом деле — споры об одном из этих терминов.
- Только вероятностные методы позволяют выразить неопределённость числом. Удобные, квотные, целевые выборки и выборки методом «снежного кома» могут быть полезными и честными, но они не могут обосновать оценку для генеральной совокупности с заявленной точностью.
- Основа выборки задаёт Ваш потолок: если группа не может попасть в список, из которого Вы отбираете, никакой метод и никакой объём дополнительных ответов не добавит её в Ваши результаты.
- Репрезентативность — это цепочка, а не ярлык: основа выборки, затем отбор, затем привлечение, затем отклик, затем анализ. Случайный отбор — лишь одно звено из пяти.
Определение выборки (и 5 терминов, в которых нельзя ошибиться)
Формирование выборки — это процесс отбора меньшей группы (выборки) из большей группы (генеральной совокупности), чтобы узнать о генеральной совокупности, не измеряя всех. Сплошное исследование всей генеральной совокупности часто непрактично, поэтому исследователи используют выборку: так работа становится выполнимой, а выводы остаются полезными.
Пять терминов ниже несут основную нагрузку в любой главе о методологии. Ошибётесь в них — и каждое последующее решение унаследует эту ошибку.
- Генеральная совокупность: вся группа, которую Вы хотите описать, с чётко заданными границами и временными рамками. «Все студенты выпускного курса сестринского дела трёх кампусов, зачисленные на 1 марта» — это генеральная совокупность. «Медсёстры» — нет.
- Целевая и доступная генеральная совокупность: кого Вы хотите описать и кого Ваши способы привлечения и инструменты могут реально охватить. Если в отчёте назван разрыв между ними, это сильная сторона работы, а не слабая.
- Основа выборки: список или механизм, из которого Вы отбираете. Реестр студентов, реестр пациентов, база данных клиентов, перечень домохозяйств деревни, список избирателей. Проблемы основы выборки порождают ошибку охвата, и никакой метод их не исправит.
- Единица выборки: то, что фактически отбирается. Человек, домохозяйство, клиника, класс, смена, заказ. В кластерных и многоступенчатых дизайнах единицей на первой ступени является группа, и такая группа называется первичной единицей выборки.
- Дизайн выборки: весь план в письменном виде. Основа выборки, метод, сколько единиц, как с ними связываются и что Вы будете делать с теми, кто не ответит. Именно «дизайн выборки» на самом деле хочет увидеть экзаменатор или рецензент, когда спрашивает о Вашей выборке.
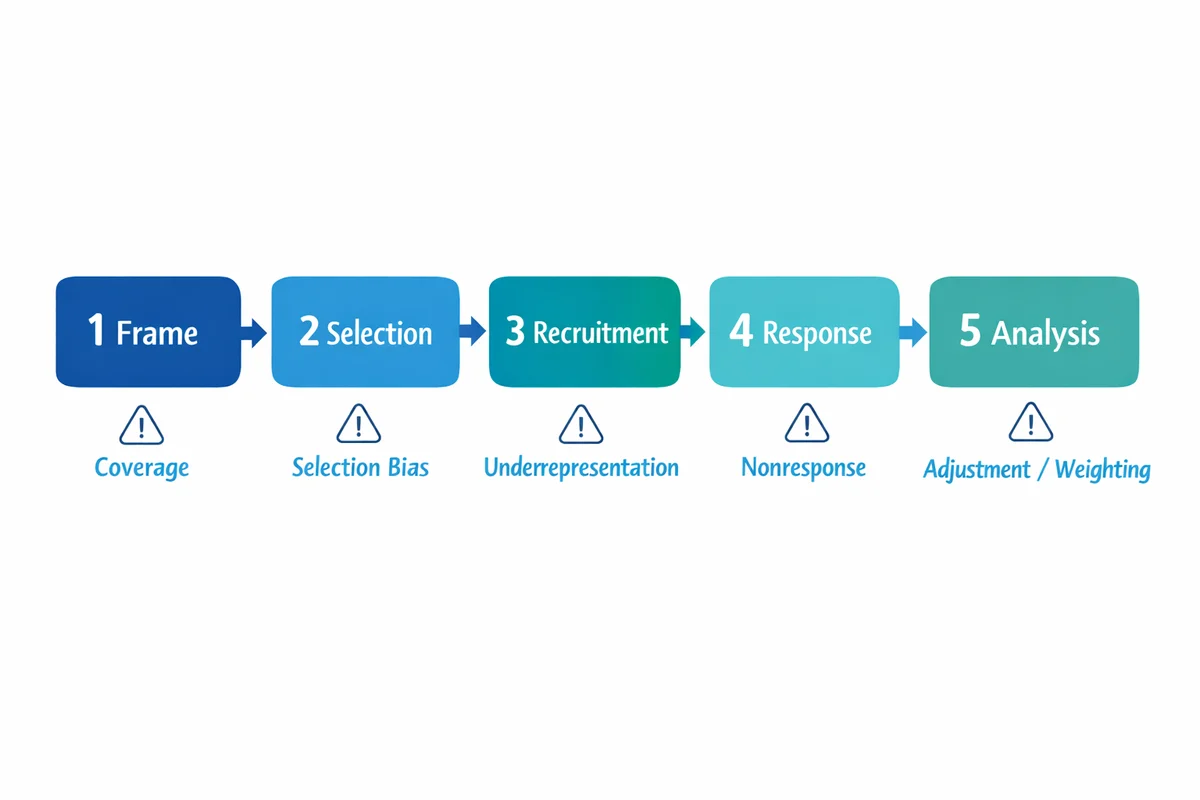
Можно провести случайный отбор строго по учебнику и всё равно получить смещённую выборку. Если основа выборки упускает какой-то сегмент, у этих людей никогда не было возможности попасть в выборку. Если сегмент не отвечает, он выпадает уже после отбора. Рассматривайте выборку как цепочку: основа выборки, затем отбор, затем привлечение, затем отклик, затем анализ.
Краткое официальное определение той же идеи приведено в учебной заметке о выборке Управления по добросовестности в научных исследованиях США (Office of Research Integrity).1 Если Вы встраиваете выборку в более широкий план исследования, наше руководство по дизайну исследования описывает шаги до и после неё.
Зачем вообще нужна выборка и когда сплошное обследование — лучший ответ
Потребность в выборке сначала практическая и лишь потом статистическая. Снова и снова возникают четыре причины.
Стоимость
Каждый дополнительный участник стоит денег, рабочего времени сотрудников или доброй воли. Хорошо отобранная выборка из 600 человек может ответить на тот же вопрос, что и плохо организованная попытка опросить 60 000.
Скорость
У решений есть сроки. Выборка даёт ответ в том временном окне, когда этот ответ ещё полезен.
Осуществимость
Некоторые генеральные совокупности вообще невозможно перечислить: прохожие на рынке, люди, отказавшиеся от услуги, неформальные торговцы. Другие фактически бесконечны, или измерение единицы её уничтожает.
Качество
Эта причина удивляет многих. Сосредоточив усилия на меньшей группе, можно добиваться ответа от тех, кто не ответил, как следует обучить интервьюеров и проверить данные. Усилия на одну единицу обычно ценнее, чем количество единиц.
Сплошное обследование (перепись), напротив, измеряет всех. Это лучший выбор, когда генеральная совокупность достаточно мала, чтобы охватить её целиком, когда контактные данные уже есть или когда каждый её член имеет право быть опрошенным. Опрос сотрудников в организации из 200 человек — это вопрос сплошного обследования, а не выборки. Как и оценка учебного курса группой. Когда генеральная совокупность мала, выборка почти ничего не даёт и лишает Вас возможности отчитываться по отдельным командам.
Как на самом деле выглядит хорошая выборка
Учебники называют хорошую выборку «репрезентативной», но это не практический критерий. А вот следующие четыре свойства — критерий.
- Охват: любой член целевой генеральной совокупности в принципе мог быть отобран.
- Контролируемый отбор: кто попадёт в выборку, решает правило, а не то, кто вызвался сам или кто оказался ближе всех к двери.
- Достаточно единиц в самой малой группе, по которой нужно отчитаться: общая цифра может выглядеть солидно, тогда как группа, которая Вас действительно интересует, держится на 11 ответах.
- Поддаётся описанию: Вы можете точно записать, как она была отобрана, и кто-то другой сможет это повторить.
| Если Ваша цель — | Что это значит для выборки | Типичная ловушка |
|---|---|---|
| Оценить процент в генеральной совокупности | Используйте вероятностный метод, отслеживайте, кто отвечает, и указывайте точность рядом с цифрой. | Считать, что удобная выборка описывает генеральную совокупность. |
| Сравнить подгруппы | Запланируйте число ответов на каждую подгруппу — обычно с помощью стратификации и избыточного отбора в малых группах. | Отчёт по подгруппе, результат которой держится на горстке людей. |
| Изучить опыт и механизмы | Уместен целевой или теоретический отбор. Обоснуйте, какие точки зрения охвачены, а какие нет. | Погоня за числовым минимумом без какого-либо обоснования. |
| Проверить вмешательство | Выборка определяет, на кого распространяется результат. Случайное распределение по группам определяет, реален ли эффект. | Путать случайное распределение по группам со случайным отбором. Это разные операции. |
Понятное изложение того, как выборки позволяют получать оценки для генеральной совокупности, можно найти в обзоре Бюро переписи населения США (U.S. Census Bureau) о выборочных обследованиях и статистическом выводе — хорошая отправная точка.2
Основа выборки задаёт потолок
Основа выборки — это конкретный список или механизм, из которого Вы отбираете. Это самая недооценённая часть формирования выборки и место, где большинство реальных исследований незаметно идут не туда, ведь именно основа выборки решает, кто вообще мог быть отобран.
Основы выборки — вполне обычные вещи. Реестр студентов, реестр пациентов, кадровый список, база данных клиентов. Список деревень с числом домохозяйств, список избирателей, поток заказов, перечень клиник района. Обратите внимание: одни основы выборки перечисляют людей, другие — места. От этого различия зависит, какие методы Вам доступны.
| Проблема | Как она выглядит | Как она влияет на результаты |
|---|---|---|
| Недостаточный охват | Часть людей из генеральной совокупности отсутствует в списке: сотрудники без рабочей электронной почты, клиенты, купившие лично, домохозяйства без зарегистрированного адреса. | У целых сегментов нулевой шанс попасть в выборку. Дополнительные ответы этого не исправят, потому что отсутствующие люди никогда не могли быть отобраны. |
| Избыточный охват | Список содержит единицы вне Вашей генеральной совокупности: бывших студентов, закрытые аккаунты, переехавших людей. | Вы тратите усилия впустую и, если не отсеете их, измеряете не ту генеральную совокупность. |
| Дублирование | Один и тот же человек встречается несколько раз: два адреса электронной почты, два номера счёта. | Эти люди получают более высокий шанс попасть в выборку, чем все остальные, что незаметно нарушает допущение о равных шансах. |
| Устаревание | Список был точным, когда его составили, но сейчас уже нет. | Недоставленные приглашения выглядят как отказы, поэтому и доля ответивших, и диагностика смещения оказываются неверными. |
Проверяйте основу выборки до отбора, а не после. Посчитайте строки. Сравните это число с любым независимым итогом, который сможете найти, например с численностью персонала по данным отдела кадров или с числом зачисленных. Найдите сегмент, пропуск которого было бы особенно неловко признать, и убедитесь, что он есть. Удалите дубликаты. Запишите, что основа выборки не охватывает, потому что эта фраза в любом случае войдёт в раздел об ограничениях.
Удобной и квотной выборке, целевой выборке и выборке методом «снежного кома» список не нужен вовсе. Кластерной и многоступенчатой выборке нужен только список групп (школ, клиник, отделений, деревень), а не список людей. Простой случайной, систематической и стратифицированной выборке нужен полный список индивидов ещё до начала работы. Если списка нет и составить его невозможно, один этот факт исключает три из девяти методов на этой странице. Обычно это первое, что нужно решить.
Сравнение 9 методов формирования выборки
Методы формирования выборки делятся на два семейства. Вероятностная выборка использует случайный механизм, поэтому у каждой единицы основы выборки есть известный ненулевой шанс быть отобранной. Невероятностная выборка его не использует, поэтому вероятности отбора неизвестны. Всё остальное вытекает из этого одного различия.
Второй столбец большинство руководств опускают, поэтому здесь он идёт первым. Только вероятностный дизайн позволяет указать погрешность, доверительный интервал или фразу «плюс-минус 5 пунктов». Если у метода там стоит «нет», он всё равно может многое Вам дать. Просто Вы не сможете опубликовать показатель точности рядом с результатом. Сама точность — тема отдельного разговора, которому посвящено наше руководство по объёму выборки.
| Метод | Позволяет указать погрешность? | Как работает | Подходит, когда | Чего он стоит и к какому смещению склонен |
|---|---|---|---|---|
| Простая случайная выборка Вероятностная Нужен полный список |
Да | У каждой единицы списка равный шанс. Нужное число единиц отбирается случайно. | У Вас есть один чистый список без дубликатов и нет подгрупп, по которым Вы обязаны отчитываться отдельно. | ЦенаНужен полный список, а малые группы могут оказаться слишком маленькими для отчёта.СмещениеПри отборе — очень небольшое. Весь оставшийся риск переходит к тому, кто на самом деле отвечает. |
| Систематическая выборка Вероятностная Нужен полный список |
Да, если порядок в списке не связан с изучаемым показателем | Упорядочьте список, выберите случайную начальную точку, затем берите каждую k-ю запись. | Список длинный или поступает потоком, и полевой команде нужно одно простое правило. | ЦенаПочти никакой, если порядок никак не связан с тем, что Вы измеряете.СмещениеПериодичность. Если список повторяется циклом, совпадающим с Вашим шагом, Вы раз за разом попадаете на один и тот же тип единиц. |
| Стратифицированная выборка Вероятностная Нужен полный список |
Да, и обычно точнее, чем простая случайная | Разделите список на значимые группы (страты), затем проведите отбор внутри каждой группы. | Вам нужно отчитываться по регионам, факультетам, отделам или возрастным группам, или Вы ожидаете, что отклик в группах будет сильно различаться. | ЦенаГруппирующая переменная должна быть в списке до отбора, а неравные доли отбора нужно взвешивать при анализе.СмещениеНизкое. Реальный риск — выбрать страты, никак не связанные с изучаемым показателем: работы прибавится, а точности не будет. |
| Кластерная выборка Вероятностная Нужен список групп |
Да, с поправкой на эффект дизайна | Случайным образом отберите целые группы (школы, клиники, отделения, деревни), затем опросите всех внутри отобранных групп. | Вы не можете составить список людей, но можете перечислить места, где они находятся, а расходы на поездки или организацию составляют основную часть бюджета. | ЦенаТочность. Люди внутри группы похожи друг на друга, поэтому каждый дополнительный ответ несёт меньше новой информации.СмещениеНизкое, если группы отобраны случайно, но при малом числе групп результат неустойчив и его трудно защитить. |
| Многоступенчатая выборка Вероятностная Нужен список групп |
Да, с весами и эффектом дизайна | Сначала отберите группы, затем отберите единицы внутри отобранных групп — в две или более ступени. | Исследования на уровне района или страны, где нет единого списка людей, но есть административные единицы. | ЦенаСложность. Вероятности отбора у единиц различаются, поэтому для анализа нужны веса и специалист, умеющий их применять.СмещениеВ принципе низкое. На практике каждая ступень — новая возможность для полевой команды отклониться от плана. |
| Удобная выборка Невероятностная Список не нужен |
Нет | Вы берёте тех, кто доступнее всего: всплывающее окно на сайте, группа, в которой Вы преподаёте, люди, проходящие мимо стенда. Её также называют доступной выборкой. | Вы проводите разведку, пилотажное исследование анкеты или Вам нужно направление уже на этой неделе, а не защитимая цифра в следующем квартале. | ЦенаСамо утверждение. Вы теряете возможность сказать что-либо о генеральной совокупности.СмещениеСамоотбор. Перепредставлены легкодоступные, свободные и уже вовлечённые. |
| Квотная выборка Невероятностная Список не нужен |
Нет. Она выглядит сбалансированной, не будучи случайной | Задайте целевые значения для групп, например 50 женщин и 50 мужчин или 40 сельских и 60 городских жителей, затем набирайте участников, пока каждая квота не будет заполнена. | Вам нужна выборка, которая хотя бы по видимым характеристикам соответствует генеральной совокупности, причём быстро и без списка для отбора. | ЦенаКонтроль над тем, кто заполняет каждую квоту. Выбирают всё равно рекрутеры, и выбирают они тех, к кому легко подойти.СмещениеСмещение отбора внутри квоты. Совпадение по возрасту и полу не делает людей типичными по взглядам. |
| Целевая выборка Невероятностная Список не нужен |
Нет, и она к этому не стремится | Вы намеренно отбираете случаи, отвечающие заданным критериям: экспертов, крайние случаи, типичные случаи, критические случаи. Её также называют экспертной выборкой (выборкой по суждению). | Качественные исследования, экспертные интервью, кейс-стади и любые вопросы, где глубина важнее подсчёта. | ЦенаНикакой, если Вы ясно даёте понять, что ничего не подсчитывали.СмещениеСобственное представление исследователя о том, кто считается релевантным. |
| Выборка методом «снежного кома» Невероятностная Список не нужен |
Нет | Привлеките нескольких участников, затем попросите каждого из них порекомендовать других, отвечающих критериям. | Группа скрытая, стигматизированная, редкая или нигде не зарегистрированная: трудовые мигранты, люди, отказавшиеся от услуги, неформальные торговцы, люди с редким заболеванием. | ЦенаВремя и контроль над составом выборки. Вы наследуете социальную сеть тех, с кого начали.СмещениеГомофилия. Люди рекомендуют похожих на себя, поэтому один уголок генеральной совокупности оказывается перепредставлен. |
Как читать таблицу: первые пять методов — вероятностные дизайны, последние четыре — нет. Именно это разделение, а не названия отдельных методов, решает, будет ли показатель точности честным.
Методы вероятностной выборки по порядку
Вероятностная выборка означает, что у каждой единицы основы выборки есть известный ненулевой шанс быть отобранной, а отбор выполняет случайный механизм. Только на этом и основано право говорить о генеральной совокупности что-либо в числах. Пять дизайнов покрывают почти любое реальное исследование. Обзоры клинических исследований и исследований в здравоохранении описывают то же семейство под несколько иными названиями, и стоит понимать причину, прежде чем Вы встретите оба варианта: оба цитируемых здесь обзора включают многоступенчатую выборку в кластерную, а не выделяют её отдельно.34
Простая случайная выборка
Простая случайная выборка даёт каждой единице списка ровно одинаковый шанс быть отобранной. Вы нумеруете список, генерируете случайные числа и берёте единицы, на которые они выпали.
Разобранный пример. В реестре университета 12 000 зачисленных студентов, а Вам нужно 400 ответов. Пронумеруйте реестр от 1 до 12 000, сгенерируйте 400 неповторяющихся случайных чисел в этом диапазоне в электронной таблице или статистическом пакете и пригласите этих студентов. Если Вы ожидаете долю ответивших 40 процентов, отберите и пригласите 1000 человек, чтобы 400 заполненных ответов были реалистичны.
Где метод даёт сбой. Когда 400 ответов распределены по реестру из 12 000 студентов, кафедра из 300 студентов даёт около 10 человек. Для отчёта этого недостаточно. Если какая-либо подгруппа должна фигурировать в результатах, простая случайная выборка — неподходящий инструмент, а решение — стратифицированная выборка.
Задокументируйте рандомизацию. Использованная программа, начальное значение генератора (seed), если оно было, и дата. Именно это одно предложение делает отбор воспроизводимым, и рецензенты действительно его требуют.
Систематическая выборка
Систематическая выборка берёт каждую k-ю единицу из упорядоченного списка после случайного начала. Разделите размер списка на нужное число единиц, чтобы получить шаг k, выберите случайное число от 1 до k в качестве начальной точки, затем отсчитывайте вперёд.
Разобранный пример. Районная больница фиксирует 9000 амбулаторных посещений за квартал и хочет провести 600 интервью на выходе. Шаг равен 9000, делённым на 600, то есть k равно 15. Выберите случайное начало от 1 до 15, например 7, затем опрашивайте посещения 7, 22, 37, 52 и так далее. Полевая команда может следовать этому правилу без ноутбука — в этом и есть настоящая причина, по которой метод до сих пор жив.
Где метод даёт сбой. Периодичность. Если в списке есть повторяющийся цикл, совпадающий с k, Вы каждый раз попадаете в одну и ту же позицию. Список посещений, упорядоченный по дням приёма с 7-дневным циклом, при шаге 7 дал бы Вам один день недели и ничего больше. Проверьте порядок, прежде чем фиксировать k, и перемешайте список, если порядок связан с тем, что Вы измеряете.
Стратифицированная выборка
Стратифицированная выборка делит генеральную совокупность на непересекающиеся группы, называемые стратами, а затем внутри каждой страты проводится случайный отбор. Для большинства исследований это самое полезное из доступных улучшений, потому что оно гарантирует, что каждая группа, по которой Вы обязаны отчитаться, действительно попадёт в выборку.
Разобранный пример с расчётами. В организации 4200 сотрудников в шести провинциях, и ей нужно 600 ответов.
- Пропорциональное размещение. В провинции с 1400 сотрудниками работает 1400, делённое на 4200, то есть треть персонала, поэтому она получает треть от 600, то есть 200 ответов. Провинция с 210 сотрудниками получает 210, делённое на 4200 и умноженное на 600, то есть 30 ответов. Каждая провинция представлена пропорционально своему размеру, и при анализе взвешивание не требуется.
- Непропорциональное размещение, или избыточный отбор. Тридцати ответов слишком мало, чтобы отчитываться по этой маленькой провинции отдельно. Поэтому Вы намеренно берёте из неё 80 ответов, а для компенсации сокращаете самую крупную провинцию. Теперь вероятности отбора в провинциях различаются, и прежде чем приводить любую цифру по организации в целом, данные нужно взвесить обратно к истинным пропорциям. Пропуск этого шага — самая распространённая ошибка стратифицированной выборки.
Выбор страт. Выбирайте переменные, связанные с изучаемым показателем или с тем, кто вероятнее ответит, и уже имеющиеся в основе выборки. Обычные кандидаты — регион, площадка, должность, стаж, курс, тип тарифа и возрастная группа. Страты, никак не связанные с изучаемым показателем, добавляют административной работы и не дают точности. Если группирующей переменной нет в основе выборки, возможно, её придётся собрать в самой анкете. Наше руководство по демографическим вопросам в опросе рассказывает, как спрашивать о таких переменных, не теряя участников.
Кластерная выборка
Кластерная выборка случайным образом отбирает целые естественные группы, а затем опрашивает всех внутри отобранных групп. Нужен список групп, а не список людей — ради этого метод и существует.
Разобранный пример. В районе 180 начальных школ и нет централизованного списка учеников. Вы случайно отбираете 24 школы и опрашиваете в каждой всех учеников 8-го класса. Вы совершили 24 выезда в школы вместо 180, и для начала Вам ни разу не понадобился реестр учеников.
Чем за это приходится платить. Ученики одной школы больше похожи друг на друга, чем на учеников по всему району. Поэтому каждый дополнительный ученик из уже отобранной школы добавляет меньше новой информации, чем независимый ученик. Ваше эффективное число ответов меньше фактического. Это увеличение и есть эффект дизайна, и его нужно заложить в план, а не обнаружить при анализе.
Где метод даёт сбой. Слишком мало кластеров. Шесть случайно отобранных школ могут сильно отличаться друг от друга, и результат колеблется в зависимости от того, какие шесть школ Вам выпали. Больше кластеров с меньшим числом людей в каждом почти всегда лучше, чем наоборот.
Многоступенчатая выборка
Многоступенчатая выборка проводит отбор в две или более ступени: сначала группы, затем единицы внутри отобранных групп, а иногда и третья ступень внутри них. Почти все национальные обследования домохозяйств в мире построены именно так.
Разобранный пример. Отберите 120 избирательных округов из общенационального списка округов. Внутри каждого отобранного округа полевая команда составляет список домохозяйств на месте, затем случайно отбирает 20 из них. Внутри каждого отобранного домохозяйства одного взрослого выбирают случайно, а не оставляют того, кто откроет дверь. Это три ступени, и последняя важна: если домохозяйство само решает, кто будет отвечать, возвращается именно то смещение отбора, от которого дизайн должен был защитить.
Чем за это приходится платить. У разных людей оказываются разные вероятности отбора, поэтому для анализа нужны веса, а расчёт дисперсии должен учитывать кластеризацию на каждой ступени. Это полноценный дизайн, которому нужен человек, способный провести взвешенный анализ. Если в проекте такого человека нет, выберите более простой дизайн, а не многоступенчатый без взвешивания.
Для экспертов: вероятность, пропорциональная размеру, и почему крупные кластеры отбираются чаще
В примере со школами у каждой школы был одинаковый шанс быть отобранной, учится ли в ней 60 учеников или 900. Из-за этого ученик маленькой школы имеет гораздо больший шанс попасть в выборку, чем ученик большой. Затем это приходится исправлять при анализе.
Отбор с вероятностью, пропорциональной размеру, решает эту проблему на этапе дизайна. Шанс каждого кластера быть отобранным задаётся пропорционально числу единиц в нём. Тогда школа на 900 учеников будет отобрана с вероятностью в пятнадцать раз выше, чем школа на 60 учеников. Затем из каждой отобранной школы берётся одинаковое число учеников. Две ступени уравновешивают друг друга, и каждый ученик района получает примерно одинаковый общий шанс быть отобранным. Это стандартный подход в национальных обследованиях, и он требует показателя размера для каждого кластера в основе выборки до начала отбора.
Стратифицированная и кластерная выборка: разница в одной строке
Эти два метода постоянно путают, потому что оба начинаются с деления генеральной совокупности на группы. Разница в том, что Вы делаете дальше.
| Аспект | Стратифицированная выборка | Кластерная выборка |
|---|---|---|
| Какие группы используются | Отбор ведётся из каждой группы. | Отбираются некоторые группы, остальные не используются вовсе. |
| Кого отбирают внутри группы | Случайную часть группы. | Всех в группе или, в многоступенчатом варианте, ещё одну случайную часть. |
| Группы должны быть | Однородными внутри и разными между собой. Регион, должность, курс. | Разнородными внутри, каждая — маленькая копия генеральной совокупности. Школы, клиники, отделения. |
| Зачем его выбирать | Точность и гарантированное представительство подгрупп. | Стоимость и досягаемость, когда списка индивидов нет. |
| Влияние на точность | Обычно повышает её по сравнению с простой случайной выборкой при том же числе ответов. | Снижает её. Заложите в бюджет эффект дизайна. |
| Что нужно перед началом | Полный список индивидов, в котором уже есть группирующая переменная. | Только список групп. |
Стратифицированная: все группы, часть людей. Кластерная: часть групп, все люди. Стратифицированная — ради точности, кластерная — ради доступа.
Методы невероятностной выборки по порядку
Невероятностная выборка означает, что вероятности отбора неизвестны, потому что никакой случайный механизм не решал, кто будет отобран. Это правильный выбор в четырёх ситуациях. Невозможно построить пригодную основу выборки. Группа скрыта. Скорость важнее точности. Или вопрос касается смысла, а не масштаба.
Эти методы не второсортные. Они отвечают на другой вопрос. Ошибка — никогда не в том, чтобы их использовать, а в том, чтобы использовать их и затем написать фразу, которую может обосновать только вероятностная выборка.
Удобная выборка
Удобная выборка, которую также называют доступной, привлекает тех, кто доступнее всего. Всплывающее окно на сайте, ссылка в рассылке, студенты Вашей собственной группы, люди, проходящие мимо прилавка на рынке.
Пример. Магазин размещает ссылку для отзыва на чеке. Каждый, кто ответил, что-то купил, имел при себе телефон, располагал временем и имел причину потрудиться. Каждый из этих фильтров отсекает свою часть клиентской базы.
Честное применение. Пилотажное исследование анкеты, выдвижение гипотез, выяснение того, какими словами говорят клиенты, проверка понятности вопроса. Всё это отличные применения. Ни одно из них не требует оценки для генеральной совокупности.
Квотная выборка
Квотная выборка задаёт цели набора для названных групп и заполняет их. Сорок сельских и шестьдесят городских жителей. Пятьдесят женщин и пятьдесят мужчин. По двадцать человек в каждой из пяти возрастных групп.
Пример. Команде маркетинговых исследований нужно 500 ответов, соответствующих национальному распределению по возрасту, полу и региону, а списка генеральной совокупности нет. Она набирает участников, пока не заполнится каждая ячейка.
Почему это всё же не вероятностная выборка. Квоты контролируют структуру выборки, а не отбор людей в неё. Тот, кто набирает участников, всё равно выбирает, а люди, к которым легко подойти, систематически отличаются от тех, к кому подойти трудно. Выборка может идеально совпадать с генеральной совокупностью по возрасту и полу и всё равно сильно ошибаться во взглядах, потому что вред наносили вовсе не возраст и пол.
Целевая выборка
Целевая выборка, которую также называют экспертной (выборкой по суждению), намеренно отбирает случаи, отвечающие заданным критериям. Распространённые варианты — отбор типичных случаев, крайних случаев, критических случаев, максимальной вариативности и экспертов.
Пример. Для исследования того, как используется новая платёжная система, отбирают восемь человек. Двоих, кто пользуется ею ежедневно, двоих, кто от неё отказался, двоих, кто так и не начал ею пользоваться, и двух сотрудников поддержки, разбирающих жалобы. Такой разброс выбран намеренно, и обоснование этого выбора и есть метод.
Честное применение. Большинство качественных исследований. Критерий здесь не случайность. Он в том, можете ли Вы объяснить, почему именно эти случаи, а не другие, и достаточно ли широк диапазон мнений, чтобы подкрепить Ваши выводы.
Выборка методом «снежного кома»
Выборка методом «снежного кома» привлекает небольшое число участников, которые затем рекомендуют других, отвечающих критериям, а те — следующих.
Пример. Исследование неформальных приграничных торговцев начинается с четырёх участников, найденных через местную ассоциацию, и каждый из них знакомит исследователей ещё с двумя. Реестра неформальных торговцев не существует, поэтому ни один метод, требующий основы выборки, недоступен.
Как это влияет на выборку. Гомофилия. Люди рекомендуют похожих на себя. Выборка смещается к одной социальной сети и уходит от изолированных членов генеральной совокупности, а ведь именно их исследованию зачастую важнее всего услышать. Если начинать с нескольких не связанных между собой стартовых участников, а не с одного, смещение уменьшается, но не исчезает.
Как сделать невероятностную выборку защитимой
Большинство руководств останавливаются на фразе «обобщать нельзя» и бросают читателя на полпути, хотя большинство читателей проводят именно такое исследование. Вот та часть, которой обычно не хватает.
- Описывайте процедуру привлечения, а не только название метода. Где была размещена ссылка, в какие даты, кто её видел, предлагалось ли вознаграждение и сколько людей было приглашено по сравнению с тем, сколько ответило. Именно это позволяет читателю оценить выборку, а не гадать.
- Сравните полученную выборку с известным эталоном и опубликуйте это сравнение. Если в Вашей организации 60 процентов составляют полевые сотрудники, а среди участников их 25 процентов, укажите это в таблице. Названный перекос — это результат. Скрытый — это дефект.
- Знайте, на что способно взвешивание, а на что нет. Корректировка данных так, чтобы демографический состав совпадал с генеральной совокупностью, может исправить видимый дисбаланс. Она не может исправить различия между участниками и остальными по признаку, который Вы не измеряли, и никогда не превращает невероятностную выборку в такую, которая позволяет заявлять о точности.
- Меняйте формулировку, а не статистику. Вместо «38 процентов клиентов недовольны, плюс-минус 4 пункта» напишите: «38 процентов из 620 клиентов, ответивших на опрос, сообщили о недовольстве. Участники привлекались через подсказку в приложении в течение двух недель и не являются случайной выборкой клиентов». Вторая формулировка короче, полезнее и неуязвима для критики.
У качественных исследований для этого есть собственный словарь. Протокол обычно требует обоснования, а не числовой цели. В нём должны быть указаны планируемое число участников и диапазон мнений — это различие кратко сформулировано в руководстве Университета Бата (University of Bath).5
Подберите метод к ситуации
Шесть ситуаций, шесть методов. Примите решение, прежде чем открывать ответ. Это самый быстрый способ проверить, действительно ли Вы усвоили таблицу выше.
1. У Вас есть полный реестр персонала из 4200 человек, и Вы должны опубликовать результаты по каждой из шести провинций.
Стратифицированная выборка. Полный список существует, поэтому вероятностная выборка Вам доступна, а обязанность отчитываться по провинциям — именно то, для чего нужна стратификация. При простой случайной выборке в самой маленькой провинции оказалось бы слишком мало ответов для отчёта.
2. Вы изучаете людей, которые отказались от услуги полгода назад. Списка нет, а тех, кто ушёл самым недовольным, найти труднее всего.
Выборка методом «снежного кома». Основы выборки нет, а генеральная совокупность труднодоступна, что исключает все вероятностные методы. Начинайте с нескольких не связанных между собой стартовых участников, а не с одного, и укажите в ограничениях, что цепочки рекомендаций смещают выборку в сторону людей с широкими связями.
3. Больница хочет получить данные об опыте пациентов из потока в 9000 посещений за квартал, причём собирать их будут сотрудники, у которых на стойке нет компьютера.
Систематическая выборка. Генеральная совокупность поступает упорядоченным потоком, поэтому правило шага — это и вероятностный метод, и то, что загруженная стойка регистрации реально может выполнить. Сначала проверьте, что порядок посещений не следует недельному циклу, совпадающему с Вашим шагом.
4. Вам нужно понять, почему от нового инструмента отказываются, а у Вас три недели и нет бюджета.
Целевая выборка. Вопрос о механизме, а не о масштабе. Отбирайте намеренно по всему диапазону: активные пользователи, отказавшиеся, так и не начавшие, сотрудники поддержки. Не приводите по ней проценты.
5. В районе 180 школ, нет реестра учеников, а бюджета на поездки хватает примерно на 25 выездов.
Кластерная выборка. Список школ существует, хотя списка учеников нет, а стоимость поездок — главное ограничение. Расширьте указываемый интервал с учётом эффекта дизайна и предпочитайте больше школ с меньшим числом учеников в каждой, а не наоборот.
6. Вам нужно за пять дней получить 500 ответов, соответствующих национальному профилю по возрасту и региону, а списка генеральной совокупности нет.
Квотная выборка. Это самый быстрый способ получить выборку, которая хотя бы по видимым характеристикам соответствует генеральной совокупности. Это всё равно не вероятностная выборка, поэтому укажите состав выборки и откажитесь от заявления о точности.
Как выбрать метод формирования выборки
Большинство исследований проваливаются не потому, что кто-то выбрал не тот метод с громким названием. Они проваливаются потому, что метод не соответствовал основе выборки, принимаемому решению или тому, что полевая команда могла реально выполнить. Три вопроса почти всегда решают дело.
Какой метод подходит для Вашего исследования?
Ответьте на три вопроса. Рекомендация появится ниже, а подходящие строки будут выделены в сравнительной таблице.
Начните с утверждения, которое Вам нужно сделать
Прежде чем что-либо выбирать, напишите фразу, которую хотите опубликовать. «Шестьдесят два процента наших клиентов порекомендовали бы нас» и «уходящие клиенты называют три повторяющиеся проблемы» — это разные утверждения, которым нужны разные дизайны. Если никто не будет воспринимать результат как цифру для генеральной совокупности, свободы у Вас гораздо больше, чем кажется.
Проверьте основу выборки, прежде чем принимать решение
Можете ли Вы действительно составить список генеральной совокупности или близкой замены? Если нет, можете ли перечислить группы, к которым эти люди относятся? Ответ на этот единственный вопрос сразу исключает большинство из девяти методов — поэтому он идёт вторым, а не последним.
Назовите подгруппы, по которым Вы обязаны отчитаться
Если результат должен быть представлен по каждому региону, площадке или должности, это определяет дизайн — через страты или квоты. Это же определяет, сколько ответов нужно в каждой группе. Если решить это после полевого этапа, исправить уже ничего нельзя.
Сверьте дизайн с полевой реальностью
Время, бюджет, возможность связаться с людьми, языковая доступность, грамотность, наличие связи и политика вознаграждений определяют, что выполнимо. Дизайн, которому полевая команда не может следовать, превращается в удобную выборку с формальным названием, а это хуже, чем честно выбрать удобную выборку. Инклюзивное планирование привлечения снижает систематическую недопредставленность.6 Когда выборка отобрана, используйте онлайн-конструктор опросов, чтобы подготовить анкету и отправить её людям, отобранным по Вашему плану выборки. Если поделиться общедоступной ссылкой без ограничений, изменится круг тех, кто может ответить; случайная выборка при этом не сохраняется.
Где выборки на самом деле дают сбой: охват, отбор и неответы
Об отборе беспокоятся все, а ошибки в нём случаются реже всего. Ущерб обычно возникает до отбора — в основе выборки — или после него — в том, кто потрудится ответить. И то и другое даёт аккуратные на вид таблицы и неверные выводы.
| Ошибка | Как она выглядит | Как её уменьшить |
|---|---|---|
| Ошибка охвата — проблема основы выборки | Некоторые люди вообще не могут быть отобраны: нет рабочей электронной почты, устаревший список, клиенты, покупающие только лично, домохозяйства без связи. | Улучшите или объедините основы выборки. Добавьте способы сбора: бумажные анкеты, личные интервью, телефон, SMS. Точно задокументируйте, кто исключён. |
| Смещение отбора — проблема процедуры | На практике случайное правило нарушается. Кто первый пришёл, того и опросили. Руководитель сам назначает, кто участвует. | Автоматизируйте отбор. Разделите того, кто отбирает, и того, кто привлекает. Проверяйте каждое исключение. |
| Смещение из-за неответов — проблема результата | Отобранные люди не отвечают, и те, кто не ответил, отличаются от ответивших именно по тому, что Вы измеряете. | Улучшите стратегию контактов и удобство анкеты, затем сравните участников с известным эталоном. См. смещение ответов. |
| Ошибка измерения | Безупречная выборка всё равно даёт бессмыслицу, потому что вопросы наводящие, расплывчатые или двойные. | Протестируйте инструмент перед запуском в поле. Наше руководство по составлению вопросов для опроса описывает типичные ошибки. |
В самом известном провале выборки было 2,4 миллиона участников
В 1936 году журнал Literary Digest предсказал, что Альф Лэндон получит примерно 55 процентов голосов. Франклин Рузвельт набрал около 61 процента.7 Журнал разослал 10 миллионов бюллетеней и получил обратно около 2,4 миллиона — доля ответивших 24 процента, к которой сегодня не приближается ни один общенациональный опрос общественного мнения.8 Опрос занизил долю Рузвельта на двадцать пунктов по сравнению с фактической — на выборке в два с половиной миллиона человек.
Цифра, которая должна быть на каждой странице о выборке. Позднейший повторный анализ рассчитал выборочную погрешность для оценок Digest по отдельным штатам: она составляла от 0,18 до 2,3 процентного пункта, медиана — 0,6.8 Показатель точности плюс-минус полпункта поверх ошибки в двадцать пунктов. Ничто не показывает нагляднее, что погрешность измеряет лишь один из нескольких способов, которыми опрос может ошибиться.
И стандартное объяснение верно лишь наполовину. Всех учат, что Digest опрашивал владельцев автомобилей и телефонных абонентов — людей богатых и голосующих за республиканцев. Одна эмпирическая проверка этого утверждения использовала опрос Gallup от мая 1937 года. Люди, у которых были и автомобиль, и телефон, всё равно поддерживали Рузвельта — 55 против 45. Среди всех, кто сказал, что получил бюллетень Digest, Рузвельт лидировал со счётом 55 против 44. Основа выборки была смещена в сторону республиканцев, но далеко не настолько, чтобы дать Лэндону сокрушительную победу.7
Недостающая половина — неответы. Среди тех, кто сказал, что вернул бюллетень, Лэндон лидировал со счётом 51 против 48. Среди тех, кто его не вернул, Рузвельт лидировал со счётом 69 против 30. Грубое разложение относит около одиннадцати пунктов ошибки на основу выборки и около семи — на различия в неответах.7 Взвешивание полученных ответов по вопросу, который Digest уже задавал, — как Вы голосовали в 1932 году, — дало бы правильного победителя с помощью арифметики, доступной в 1936 году.8
Высокая доля ответивших — не та цель, которой Вы её считаете
Доля ответивших в собственных телефонных опросах Pew Research Center упала с 36 процентов в 1997 году до 9 процентов к 2012 году и до 6 процентов к 2018 году.9 Тем временем Национальное обследование семьи и здоровья Индии (National Family Health Survey), проводимое лично, отобрало 664 972 домохозяйства и обнаружило, что 653 144 из них заселены. Из них было опрошено 636 699 — доля ответивших 97,5 процента. Внимательно посмотрите на знаменатель, потому что именно здесь доля ответивших чаще всего считается неверно: относительно числа отобранных, а не заселённых домохозяйств та же полевая работа даёт 95,7 процента. Выборка обследования была извлечена из 30 456 кластеров во всех 707 округах.10
Оба факта относятся к одному десятилетию. Способ сбора и усилия в поле влияют на долю ответивших гораздо сильнее, чем любое общее утверждение об усталости от опросов. Если руководство говорит Вам, что средняя доля ответивших равна какому-то одному числу, оно описывает несуществующую величину.
Теперь более неудобный вывод. Метаанализ 235 оценок смещения из-за неответов, взятых из 30 опубликованных исследований, показал, что корреляция между долей ответивших и величиной смещения из-за неответов составляет 0,33. В квадрате это означает, что доля ответивших объясняет около 11 процентов вариации смещения.11 Последующий анализ 59 исследований, специально задуманных для измерения смещения из-за неответов, пришёл к тому же выводу.12
Долю ответивших стоит указывать и стоит повышать. Но это не сертификат качества. Смещение возникает тогда, когда склонность отвечать связана с тем, что Вы измеряете. Опрос о волонтёрстве страдает от этого гораздо сильнее, чем опрос о скорости интернета. Следите за корреляцией, а не за процентом.
Больше ответов не исправят негодную основу выборки
Во время кампании вакцинации 2021 года два очень крупных опроса отслеживали охват вакцинацией в США. Один собирал около 250 000 ответов в неделю и завысил охват первой дозой на 17 процентных пунктов по сравнению с официальным эталоном. Другой собирал около 75 000 ответов каждые две недели и завысил его на 14. Третий опрос примерно из 1000 участников, проведённый по стандартной вероятностной методике, дал надёжные оценки.13
Та же картина видна и в обычной работе с опросами. При сравнении трёх вероятностных панелей с тремя онлайн-источниками с добровольным участием по 28 эталонным показателям и 29 937 интервью средняя абсолютная ошибка составила 5,8 процентного пункта для выборок с добровольным участием и 2,6 для вероятностных панелей. По 25 из этих показателей, доступным для подгрупп, разрыв для взрослых в возрасте от 18 до 29 лет составил 11,2 против 3,6.14
И запоминающийся диагностический пример: в одном опросе с добровольным участием 12 процентов взрослых моложе 30 лет заявили, что имеют лицензию на управление атомной подводной лодкой.15 Реальная цифра близка к нулю. Если панель способна выдать такое, она способна выдать что угодно, а более крупный заказ у той же панели просто купит больше того же самого.
Кого упускает основа выборки за пределами США и Великобритании
Большинство руководств по выборке молча предполагают западную основу выборки: список адресов электронной почты, стационарный телефон, национальный адресный реестр. Значительная часть мира так выборку не строит, и пробелы в охвате там хорошо измерены.
- Онлайн-опрос в стране с низким или средним уровнем дохода — это выборка из её подключённой к интернету части, а эта часть смещена в сторону мужчин. Женщины в странах с низким и средним уровнем дохода на 14 процентов реже мужчин пользуются мобильным интернетом, то есть в сети примерно на 235 миллионов женщин меньше, чем мужчин.16
- Телефонные выборки перепредставляют глав домохозяйств. В телефонных опросах Всемирного банка в четырёх африканских странах среди участников было 52 процента мужчин в Уганде и 73 процента в Нигерии, тогда как среди взрослого населения мужчин примерно половина. В Уганде 6 процентов участников телефонного опроса были в возрасте от 15 до 24 лет, тогда как во взрослом населении таких 38 процентов.17
- Что с этим делать. Сочетайте способы сбора, а не отстаивайте один. Составляйте списки домохозяйств на месте там, где реестра нет. Проводите опрос на тех языках, на которых Ваша генеральная совокупность действительно читает, и проводите предварительное тестирование перевода вместо обратного перевода. Затем укажите оставшийся разрыв в ограничениях, потому что он всё равно останется.
Что взвешивание может исправить, а что нет
Взвешивание корректирует данные так, чтобы состав выборки совпадал с известными показателями генеральной совокупности. Это действительно мощный инструмент, и его возможности постоянно преувеличивают.
Аргумент за. В 2016 году последний опрос Университета Нью-Гэмпшира показывал преимущество Клинтон в 11 пунктов в гонке, которую она выиграла с перевесом в 0,4 пункта. Поправки на образование в нём не было. Комиссия по анализу пришла к выводу, что одна эта поправка устранила бы практически всю ошибку.18 Одна переменная, связанная и с откликом, и с результатом, сделала всю работу.
Аргумент против того, чтобы на него полагаться. Когда более 30 000 онлайн-интервью с добровольным участием сравнили с 24 эталонными показателями, среднее оценённое смещение без взвешивания составило 8,4 процентного пункта. Ни одна из проверенных процедур взвешивания, включая сложные методы сопоставления, не снизила среднее смещение ниже 6 пунктов.19 Увеличение объёма выборки в четыре раза дало ещё 0,2 пункта.
Отсюда простое правило. Взвешивание исправляет дисбаланс по тем переменным, по которым Вы взвешиваете, в той мере, в какой эти переменные связаны с изучаемым показателем. Оно никак не влияет на различия между ответившими и не ответившими по признакам, которые Вы никогда не измеряли, и никогда не превращает невероятностную выборку в такую, которая позволяет заявлять о точности.
Показатель точности — нижняя граница, а не верхняя
Погрешность количественно описывает выборочную изменчивость, и только её. Она предполагает, что выборка извлечена случайно из целевой генеральной совокупности и что оставшееся смещение устранено. Ошибка охвата, смещение из-за неответов, ошибка измерения и недобросовестные участники — всё это вне её.
Данные говорят прямо. В последние две недели кампании 2020 года 348 президентских опросов по отдельным штатам указали погрешность, и в среднем она составляла 3,9 пункта. Если мерить этим средним, 55 процентов из них ошиблись в итоговом перевесе больше чем на одну погрешность, а 21 процент — больше чем на две.20 Это были современные опросы с современными методами. Считайте погрешность нижней границей Вашей неопределённости, а не верхней.
| Утверждение | Цифра | Уровень | Источник |
|---|---|---|---|
| Доля ответивших почти не предсказывает смещение из-за неответов | r = 0,33, то есть около 11% вариации, по 235 оценкам из 30 исследований | A | Groves, 200611 |
| Очень крупный опрос может сильно ошибаться | Завысил охват вакцинацией на 17 пунктов при примерно 250 000 ответов в неделю | A | Bradley и соавт., 202113 |
| Выборки с добровольным участием примерно вдвое менее точны, чем вероятностные панели | 5,8 против 2,6 процентного пункта средней ошибки по 28 эталонным показателям | A | Mercer и Lau, 202314 |
| Взвешивание улучшает выборку с добровольным участием, но не спасает её | 8,4 пункта без взвешивания, ни один метод не опустился ниже 6,0 пункта | A | Mercer, Lau и Kennedy, 201819 |
| Погрешность занижает реальную ошибку опросов | 55% из 348 опросов по штатам в 2020 году ошиблись больше, чем на среднюю заявленную погрешность в 3,9 пункта | A | Рабочая группа AAPOR, 202120 |
| Объяснение провала Literary Digest через основу выборки неполно | Владельцы автомобилей и телефонов всё равно поддерживали Рузвельта — 55 против 45 | B | Squire, 19887 |
Уровень A означает официальную статистику, метаанализ или воспроизведённый результат. Уровень B означает одно сильное исследование, вывод которого ещё не был независимо повторён.
«Доля ответивших 50 процентов — приемлемо, 60 — хорошо, 70 — очень хорошо». Учебное эмпирическое правило, за которым не стоит никаких данных. Разные авторитеты в одной и той же области называют 50, 60 и 80. Смещение зависит от корреляции между участием в опросе и ответом, а не от доли.
«Тридцати достаточно, потому что именно тогда начинает работать центральная предельная теорема». Нет вывода, который давал бы число 30. Для симметричных показателей приближение работает и на гораздо меньших выборках, а для асимметричных показателей или редких событий не работает даже на гораздо больших.
«Средняя доля ответивших в опросах — 33 процента». Эта цифра кочует по блогам поставщиков почти в одинаковой формулировке без первоисточника. Способ сбора, заказчик, генеральная совокупность и вознаграждение перекрывают любое общее среднее.
«Концентрация внимания теперь восемь секунд — меньше, чем у золотой рыбки». Восходит к маркетинговому отчёту 2015 года, который ссылался на компанию, не сумевшую предъявить источник. В исходном исследовании нет ни восьми секунд, ни золотых рыбок.
Эффект дизайна: почему кластерным выборкам нужно больше людей
Почти каждое руководство рекомендует кластерную выборку за экономию и на этом останавливается. Экономия реальна, но реален и счёт. Люди внутри одной школы, клиники, отделения или магазина похожи друг на друга. Они похожи друг на друга больше, чем на людей, случайно отобранных из всей генеральной совокупности. Поэтому каждый дополнительный ответ из уже отобранной группы несёт меньше новой информации.
Эту величину измеряет эффект дизайна. Словами: насколько шире становится Ваша неопределённость по сравнению с независимым отбором того же числа людей. Для дизайна с группами одинакового размера он равен
эффект дизайна = 1 + (средний размер группы - 1) x внутриклассовая корреляция
Внутриклассовая корреляция (ICC) показывает, насколько похожи люди внутри группы по тому, что Вы измеряете. Ноль означает, что принадлежность к одной школе ничего не говорит об ответе ученика. Единица означает, что все в школе отвечают одинаково, и школа с тем же успехом могла бы быть одним человеком. Реальные значения невелики, но малые значения наносят большой ущерб, когда группы становятся крупными. По данным 48 национальных обследований домохозяйств средняя внутриклассовая корреляция составляет около 0,06. Она зависит от того, что Вы измеряете. Для пунктов о рождаемости — примерно от 0,01 до 0,03, для текущего использования контрацепции — от 0,03 до 0,05, а для родов с медицинской помощью — вплоть до 0,22 в национальных показателях.21
Если собственной оценки нет, заимствуйте значение по умолчанию осторожно. Руководство DHS по выборке использует для deft значение 1,5, когда у обследования нет собственной цифры.22 Deft — не та же величина, что эффект дизайна в формуле выше: это отношение двух стандартных ошибок, тогда как эффект дизайна — отношение двух дисперсий. Его нужно возвести в квадрат, поэтому deft 1,5 соответствует эффекту дизайна 2,25. Руководство называет это значение запасным, а не типичным, и в его собственных разобранных примерах используется 1,40 для использования современных методов контрацепции и 1,22 для вакцинации детей.
| Дизайн | Эффект дизайна | Эффективные ответы | Что это значит на практике |
|---|---|---|---|
| Независимый отбор, без кластеризации | 1.00 | 960 | Каждый ответ идёт в зачёт полностью. |
| 24 группы по 40, ICC 0,02 | 1.78 | 539 | Вы заплатили за 960, а защитить можете точность 539. |
| 24 группы по 40, ICC 0,05 | 2.95 | 325 | Две трети полевой работы не дали Вам никакой дополнительной точности. |
| 24 группы по 40, ICC 0,10 | 4.90 | 196 | Дизайн незаметно превратился в маленькое исследование с бюджетом большого. |
Взвешивание добавляет собственную составляющую. Национальное обследование, в котором один регион отобран с избытком, а затем взвешен обратно, несёт сразу два эффекта дизайна. Эффект взвешивания 1,22 и эффект кластеризации 1,80 дают общий эффект дизайна 2,20. Поэтому 5000 опрошенных домохозяйств ведут себя как 2277 независимых.23
Урок для дизайна. Больше групп с меньшим числом людей в каждой почти всегда лучше, чем меньше групп с большим числом людей в каждой. Сорок школ по 24 ученика и 24 школы по 40 учеников обходятся примерно в те же 960 ответов, но у первого варианта эффект дизайна меньше, а результат защитим. Если Вы планируете, сколько всего ответов Вам нужно, рассчитайте это с помощью нашего руководства по объёму выборки, а затем умножьте на эффект дизайна. Если делать наоборот, кластерные исследования в итоге оказываются с недостаточной статистической мощностью.
Три разобранных примера от начала до конца
Названия методов запомнить легко. А ошибаются исследования как раз в решениях вокруг них. Эти три примера проводят реальный дизайн от описания генеральной совокупности до фразы, которую можно опубликовать.
Пример 1: опыт пациентов в районе
- Генеральная совокупность. Взрослые, посетившие амбулаторный приём в любой из 46 государственных клиник района в период с 1 апреля по 30 июня.
- Основа выборки. Единого реестра пациентов района не существует. Существует список 46 клиник с ежемесячным числом посещений.
- Метод. Многоступенчатый. Отберите 18 клиник с вероятностью, пропорциональной посещаемости, затем систематически отбирайте каждого 8-го выходящего пациента в течение двух случайно выбранных дней приёма.
- Почему не что-то попроще. Полный список пациентов позволил бы использовать стратифицированную выборку, но его нет и составить его в отведённые сроки невозможно. Удобная выборка в трёх крупнейших клиниках была бы быстрее и описывала бы три крупнейшие клиники.
- Что необходимо указать. Вероятности отбора зависят от размера клиники, поэтому анализу нужны веса, а интервал нужно расширить с учётом эффекта дизайна.
- Фраза для публикации. «Среди взрослых, посещавших государственные амбулаторные клиники района во втором квартале, по оценкам, 71 процент сочли время ожидания приемлемым — на основе 1240 интервью на выходе в 18 клиниках, отобранных с вероятностью, пропорциональной посещаемости».
Пример 2: диссертационное исследование среди студентов
- Генеральная совокупность. Студенты, зачисленные на коммерческий факультет в текущем учебном году: 3100 человек на трёх курсах.
- Основа выборки. Реестр зачисленных студентов факультета, в котором указаны курс и образовательная программа.
- Метод. Стратифицированная случайная выборка по курсам, пропорциональное размещение, цель — 350 заполненных ответов.
- Расчёт. На первом курсе 1300 студентов, это 42 процента от 3100, поэтому он получает 42 процента от 350, то есть 147 ответов. Повторите для каждого курса. Поскольку размещение пропорциональное, взвешивание не требуется.
- Планирование отклика. При ожидаемой доле ответивших 35 процентов нужно пригласить примерно 1000 студентов, чтобы получить 350 заполненных ответов, и приглашать их следует страта за стратой, чтобы слабый отклик на каком-то курсе был заметен, пока ещё есть время что-то предпринять.
- Ограничения, которые нужно указать. Отчисленные студенты, оставшиеся в реестре, — это избыточный охват. Студенты, зачисленные после выгрузки реестра, — недостаточный охват. И то и другое относится к абзацу об ограничениях.
Пример 3: отзывы клиентов интернет-магазина
- Генеральная совокупность. Клиенты, оформившие заказ за последние 90 дней.
- Основа выборки. Таблица заказов. Она полна для онлайн-заказов и для заказов без регистрации, но клиент с двумя аккаунтами встречается в ней дважды.
- Метод. Удалите дубликаты, чтобы на каждого клиента приходилась одна строка, затем примените систематическую выборку — каждый 12-й клиент после случайного начала, непрерывно, а не одной партией.
- Ловушка, которой это позволяет избежать. Приглашать только подписчиков рассылки быстрее, но это удобная выборка из самых вовлечённых клиентов. Удовлетворённость будет выглядеть лучше, чем есть на самом деле, — стабильно, каждый квартал.
- Примечание о сотрудниках. Той же организации, опрашивающей собственных 180 сотрудников, выборка не нужна вовсе. Эта генеральная совокупность мала, досягаема, и каждый имеет право быть опрошенным. Проведите сплошное обследование, а если участие окажется низким, считайте это результатом, а не проблемой выборки.
Как описать выборку в разделе о методологии
Этот шаг большинство руководств пропускают, а именно его на самом деле читают научный руководитель, рецензент или заказчик. Описание выборки должно по порядку ответить на пять вопросов: кто, из какого списка, как отобраны, сколько и что Вы, следовательно, вправе утверждать.
Заполните пропуски ниже. Шаблон намеренно простой: экзаменаторы ищут здесь не изящную прозу, а дизайн, который можно оценить.
Одно и то же исследование: слабое описание и сильное
Слабо. «Была сделана случайная выборка студентов, и собрано 350 ответов».
Здесь ничего нельзя проверить. Слово «случайная» претендует на то, чего ничем не подтверждает: нет основы выборки, нет знаменателя и не сказано, кто был исключён.
Сильно. «Целевой генеральной совокупностью были 3100 студентов, зачисленных на коммерческий факультет в 2026 году. Основой выборки служил реестр зачисленных студентов факультета, выгруженный 3 марта 2026 года. Использовалась стратифицированная случайная выборка по курсам с пропорциональным размещением, чтобы по каждому курсу можно было отчитаться отдельно. Была приглашена тысяча студентов, и 350 из них заполнили анкету, доля ответивших — 35 процентов. Взвешивание не применялось, поскольку размещение было пропорциональным. Студенты, отчисленные после даты выгрузки, остались в основе выборки и не могли быть выявлены, что является незначительным источником избыточного охвата».
Вторая версия длиннее, и каждое дополнительное предложение — это вопрос, который рецензенту больше не нужно задавать.
«Участники привлекались с помощью подсказки в приложении, которая в течение двух недель показывалась активным пользователям. Это удобная выборка, поэтому результаты описывают тех, кто ответил, и не могут быть обобщены на всю пользовательскую базу; показатель точности не приводится. Среди участников чаще, чем в пользовательской базе, встречались ежедневные пользователи, что следует учитывать при чтении результатов». Напишите так, и никто не сможет обвинить Вас в преувеличении. Вы ничего не преувеличили.
Чек-лист плана выборки
Письменный план выборки предотвращает большинство ошибок, которых можно избежать, потому что заставляет принимать решения до полевого этапа, а не во время анализа. Восемь пунктов, одна страница.
- 1. Цель исследования. Какое решение это поддерживает и что именно будет представлено в отчёте?
- 2. Целевая генеральная совокупность. Кто входит в рамки исследования и кто нет, включая временные рамки.
- 3. Основа выборки. Источник, дата выгрузки, число строк, известные пробелы и правило удаления дубликатов.
- 4. Метод и обоснование. Какой из девяти и почему именно этот с учётом основы выборки и утверждения.
- 5. Целевые показатели. Заполненные ответы в целом и по каждой подгруппе, а также ожидаемая доля ответивших, на которую Вы ориентируетесь при планировании.
- 6. План привлечения. Способы сбора, график напоминаний, языковая доступность и доступность для людей с ограничениями, политика вознаграждений.
- 7. Мониторинг. За чем Вы будете следить во время полевого этапа: отклик по стратам, точка, где участники бросают анкету, пропуски ответов на отдельные вопросы.
- 8. Заметки к анализу. Планируемое взвешивание, поправка на эффект дизайна и ограничения, которые Вы раскроете при любом исходе.
Когда план утверждён, именно инструмент решает, стоило ли отбирать выборку. Идеальная выборка не спасёт наводящий или двойной вопрос, поэтому перед запуском стоит просмотреть примеры вопросов для опроса.
Частые вопросы
Что такое выборка в исследовании?
Формирование выборки — это процесс отбора части генеральной совокупности, называемой выборкой, и изучения этой части, чтобы сделать выводы обо всей генеральной совокупности. Его используют, потому что измерить каждого члена генеральной совокупности обычно слишком долго, слишком дорого или невозможно. Метод отбора выборки определяет, какие выводы могут подкрепить результаты.
Чем генеральная совокупность отличается от выборки?
Генеральная совокупность — это вся группа, которую Вы хотите описать. Выборка — меньшая её часть, которую Вы фактически измеряете. Формирование выборки — процесс, который ведёт от одной к другой, а сплошное обследование — альтернатива, при которой Вы измеряете всю генеральную совокупность.
Что такое основа выборки?
Основа выборки — это реальный список или механизм, из которого Вы извлекаете выборку: реестр студентов, реестр пациентов, база данных клиентов, перечень домохозяйств, список избирателей. Она важнее названия метода, потому что у любого, кого нет в основе выборки, нулевой шанс быть отобранным, каким бы хорошим ни был Ваш метод формирования выборки.
Какому методу формирования выборки не нужна основа выборки?
Удобной и квотной выборке, целевой выборке и выборке методом «снежного кома» список не нужен вовсе. Кластерной и многоступенчатой выборке нужен только список групп, например школ, клиник или деревень, а не список индивидов. Простой случайной, систематической и стратифицированной выборке нужен полный список индивидов ещё до начала работы.
Чем вероятностная выборка отличается от невероятностной?
При вероятностной выборке отбор выполняет случайный механизм, поэтому у каждой единицы есть известный ненулевой шанс быть отобранной, и Вы можете рассчитать, насколько неопределённы Ваши оценки. При невероятностной выборке эти шансы неизвестны, потому что отбор зависит от удобства, квот или суждения исследователя. Практическое следствие: только вероятностный дизайн позволяет указать для оценки по генеральной совокупности заявленный показатель точности.
Чем стратифицированная выборка отличается от кластерной?
Стратифицированная выборка делит генеральную совокупность на группы и берёт случайную выборку из каждой группы, что повышает точность и гарантирует присутствие каждой группы. Кластерная выборка случайно отбирает некоторые группы, а затем опрашивает всех внутри отобранных групп, что экономит средства, когда списка индивидов нет. Коротко: стратифицированная использует все группы и часть людей, кластерная — часть групп и всех людей.
Что такое первичная единица выборки?
Первичная единица выборки — это то, что отбирается на первой ступени многоступенчатого дизайна. В национальном обследовании домохозяйств это обычно территория, например округ, деревня или счётный участок переписи. Затем на второй ступени внутри неё отбираются домохозяйства. Указание первичной единицы выборки — стандартное требование при описании кластерного дизайна, потому что создаваемая ею кластеризация должна учитываться при анализе.
Что такое стратифицированная случайная выборка?
Стратифицированная случайная выборка делит генеральную совокупность на непересекающиеся группы, называемые стратами, а затем независимо проводит случайный отбор внутри каждой страты. Пропорциональное размещение даёт каждой страте долю выборки, совпадающую с её долей в генеральной совокупности, и не требует взвешивания. Непропорциональное размещение намеренно увеличивает отбор в малых, но важных стратах и затем требует взвешивания, прежде чем приводить любую общую цифру.
Допустима ли выборка методом «снежного кома» в академическом исследовании?
Да, когда генеральная совокупность скрыта, редка или нигде не зарегистрирована и построить основу выборки невозможно. Это признанный подход для труднодоступных групп. Обосновать оценку для генеральной совокупности он не может, а его главная слабость в том, что участники рекомендуют похожих на себя, поэтому выборка смещается к одной социальной сети. Начало с нескольких не связанных между собой стартовых участников уменьшает это смещение, и это следует описать в методологии.
Случайный отбор — это то же самое, что случайное распределение по группам?
Нет. Случайный отбор — это то, как Вы отбираете участников из генеральной совокупности, и он определяет, на кого распространяются Ваши выводы. Случайное распределение — это то, как Вы распределяете отобранных участников по условиям эксперимента, и оно определяет, можно ли приписать наблюдаемый эффект воздействию. В исследовании может использоваться одно без другого, и в большинстве экспериментов используется случайное распределение без случайного отбора.
Можно ли использовать невероятностный метод формирования выборки в количественном исследовании?
Да, и так поступает значительная часть опубликованных количественных исследований. Меняется то, что Вы вправе утверждать. Вы можете приводить количества, проценты и связи внутри своей выборки и сравнивать группы внутри неё. Но Вы не можете представлять эти проценты как оценки для генеральной совокупности с заявленной точностью. Укажите метод, опишите процедуру привлечения, сравните участников с известным эталоном, если он есть, и прямо сформулируйте ограничение, а не надейтесь, что никто не спросит.
Чем формирование выборки отличается от выборочного распределения?
Формирование выборки — это процедура отбора выборки. Выборочное распределение — другое понятие. Представьте, что одна и та же процедура отбора повторяется много раз. Разброс получаемой статистики, например среднего или процента, по всем этим воображаемым выборкам и есть выборочное распределение. Именно выборочное распределение делает возможными доверительные интервалы, и ведёт оно себя предсказуемо, только если выборка извлечена вероятностным методом.
Как понять, смещена ли моя выборка?
Сравните полученную выборку с известным эталоном, например со списком сотрудников, данными о зачислении или административными данными, по переменным, связанным с тем, что Вы измеряете. Большие расхождения указывают на проблемы охвата, проблемы отбора или различия в неответах. Сравните также каналы привлечения и волны напоминаний. Учтите, что хорошая доля ответивших — слабое свидетельство низкого смещения: по 235 опубликованным оценкам доля ответивших объясняла лишь около 11 процентов вариации смещения из-за неответов.
Читайте также
Выборка — лишь одно решение внутри более крупного исследования. Эти руководства описывают решения до и после неё.
- Дизайн исследования показывает место выборки в последовательности шагов исследования — от определения генеральной совокупности до запуска.
- Как определить объём выборки — расчёты точности, которые эта страница намеренно выносит за свои рамки, включая формулы.
- Как составлять вопросы для опроса — сторона измерения, которую не спасёт никакой дизайн выборки.
- Принципы разработки анкеты — как собирается весь инструмент, когда вопросы уже готовы.
- Смещение ответов — подробнее о разнице между теми, кого Вы отобрали, и теми, кто ответил.
- Демографические вопросы в опросе — полезно, когда в основе выборки нет переменной, нужной для стратификации.
- Статистическая значимость — что делать с цифрами, когда выборка собрана.
- Количественный анализ данных — последующие шаги анализа, включая то, где применяются веса.
Как написано это руководство и чего оно не охватывает
Кто его написал. Michael Hodge, который занимается методологией опросов, разработкой вопросов и качеством данных в SuperSurvey и пишет практические руководства для нашего раздела «Руководства и помощь».
На чём оно основано. Определения следуют методологическому обзору и университетским руководствам по исследованиям, приведённым ниже: именно там технические термины действительно определены. Официальные страницы о добросовестности в исследованиях и статистических ведомств указаны как краткие понятные отправные точки, а не как источник этих определений. Описания методов основаны на тех же обзорах и руководствах. Каждая цифра в разделе с данными взята из названного первоисточника, указанного ниже. Каждое утверждение также имеет уровень надёжности, чтобы Вы видели, какие выводы устоялись, а какие основаны на одном исследовании. Цифры эффекта дизайна на диаграмме и в таблице — наши собственные расчёты. Мы использовали стандартную формулу с допущениями, указанными в подписи, чтобы Вы могли повторить их или оспорить, подставив размеры своих кластеров.
Чего оно не охватывает. Это руководство посвящено выборке для опросов и наблюдательных исследований. Оно не охватывает планирование экспериментов и случайное распределение по группам — лишь объясняет, чем они отличаются. В нём также не рассматривается выборка для приёмочного контроля, аудита и обработки сигналов, где то же слово означает другое. Выборка, управляемая респондентами (respondent-driven sampling), выборка по времени и месту и адаптивная кластерная выборка — реальные методы, которые специалисты используют для скрытых генеральных совокупностей, но здесь они не рассматриваются. Значения внутриклассовой корреляции взяты из обследований домохозяйств в странах с низким и средним уровнем дохода. Считайте их иллюстративными, а не значениями для переноса в другие условия.
Где цифры наименее надёжны. Повторный анализ Literary Digest основан на одном опросе 1937 года и одном более позднем повторном анализе, и оба автора сами указывают на свою неопределённость; поэтому ему присвоен уровень B. Цифры об ошибках опросов взяты из предвыборных опросов в США, которые изучены необычайно хорошо и не обязательно отражают ошибки опросов в целом.
Раскрытие информации. SuperSurvey продаёт программное обеспечение для опросов. Ничто на этой странице не продаётся, ни одна её часть не требует регистрации, и ни одна организация не спонсировала и не рецензировала это руководство. Если мы ссылаемся на собственные страницы, то потому, что они описывают следующее решение, а не потому, что ссылка нам что-то приносит.
Источники
- Office of Research Integrity, U.S. Department of Health and Human Services. Elements of Research: Sampling.
- U.S. Census Bureau. Sampling Estimation and Survey Inference.
- Elfil, M., and Negida, A. (2017). Sampling Methods in Clinical Research: an Educational Review. Emergency (Tehran), 5(1), e52. PMC5325924.
- Spolarich, A. E. (2023). Sampling Methods: A Guide for Researchers. Journal of Dental Hygiene, 97(4), 73-77.
- University of Bath. Sampling in research.
- UK Government (2020). A guide to inclusive social research practices.
- Squire, P. (1988). Why the 1936 Literary Digest Poll Failed. Public Opinion Quarterly, 52(1), 125-133. DOI 10.1086/269085.
- Lohr, S. L., and Brick, J. M. (2017). Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll. Statistics, Politics and Policy, 8(1), 65-84. DOI 10.1515/spp-2016-0006.
- Kennedy, C., and Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- International Institute for Population Sciences and ICF (2022). National Family Health Survey (NFHS-5), 2019-21: India, Volume I.
- Groves, R. M. (2006). Nonresponse Rates and Nonresponse Bias in Household Surveys. Public Opinion Quarterly, 70(5), 646-675. DOI 10.1093/poq/nfl033.
- Groves, R. M., and Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189. DOI 10.1093/poq/nfn011.
- Bradley, V. C., Kuriwaki, S., Isakov, M., Sejdinovic, D., Meng, X.-L., and Flaxman, S. (2021). Unrepresentative big surveys significantly overestimated US vaccine uptake. Nature, 600, 695-700. DOI 10.1038/s41586-021-04198-4.
- Mercer, A., and Lau, A. (2023). Comparing Two Types of Online Survey Samples. Pew Research Center.
- Mercer, A., Kennedy, C., and Keeter, S. (2024). Online opt-in polls can produce misleading results, especially for young people and Hispanic adults. Pew Research Center.
- GSMA (2025). The Mobile Gender Gap Report 2025, с. 9 и 15. Цифры взяты из издания 2025 года; с тех пор GSMA опубликовала издание 2026 года, в котором разрыв меньше.
- Brubaker, J., Kilic, T., and Wollburg, P. (2021). Representativeness of individual-level data in COVID-19 phone surveys: Findings from Sub-Saharan Africa. PLOS ONE, 16(11), e0258877. DOI 10.1371/journal.pone.0258877.
- Kennedy, C., Blumenthal, M., Clement, S., Clinton, J. D., and others (2018). An Evaluation of the 2016 Election Polls in the United States. Public Opinion Quarterly, 82(1), 1-33. DOI 10.1093/poq/nfx047.
- Mercer, A., Lau, A., and Kennedy, C. (2018). For Weighting Online Opt-In Samples, What Matters Most? Pew Research Center.
- AAPOR Task Force on 2020 Pre-Election Polling (2021). An Evaluation of the 2020 General Election Polls. American Association for Public Opinion Research.
- Aliaga, A., and Ren, R. (2006). Optimal Sample Sizes for Two-stage Cluster Sampling in Demographic and Health Surveys. DHS Working Paper No. 30.
- ICF International (2012). Demographic and Health Survey Sampling and Household Listing Manual, с. 9 и табл. 1.2.
- Kalton, G., Brick, J. M., and Le, T. (2005). Estimating components of design effects for use in sample design. In Household Sample Surveys in Developing and Transition Countries, Chapter VI. United Nations, Series F No. 96.