
Wielkość próby w ankiecie to liczba wypełnień uwzględnionych w analizie, oznaczana jako n. To nie to samo co liczba zaproszeń ani liczba osób na Twojej liście. Przy założeniach kalkulatora dotyczących doboru próby większa próba zawęża margines błędu, ale nie usuwa obciążonej rekrutacji ani źle sformułowanych pytań.
Kalkulator wielkości próby
Nic nie jest ukryte za rejestracją i nic nie jest nigdzie wysyłane. Kalkulator działa w Twojej przeglądarce, od razu pokazuje przykładowy wynik oraz wypisuje wzór i obliczenia, których użył, więc możesz je sprawdzić lub odtworzyć ręcznie.
Ilu wypełnień potrzebuję?
Ustaw sześć danych wejściowych. Wynik, wzór i obliczenia aktualizują się na bieżąco podczas wpisywania.
Potrzebna liczba wypełnień
370
Po korekcie dla populacji skończonej.
Liczba osób do zaproszenia
1,234
Przy wskaźniku odpowiedzi 30%.
Frakcja próby
3.7%
Odsetek populacji, od którego potrzebujesz odpowiedzi.
Łącznie, licząc osobno każdą podgrupę
370
Obliczenia krok po kroku
| Margines błędu | Potrzebne wypełnienia | Potrzebne zaproszenia |
|---|
Za większą precyzję płacisz liczbą wypełnień rosnącą mniej więcej z kwadratem poprawy. Zmniejszenie marginesu błędu o połowę zwiększa próbę mniej więcej czterokrotnie.
Przycisk kopiowania tworzy krótki akapit metodologiczny z Twoimi liczbami, wzorem i cytowaniem, gotowy do wklejenia do opisu projektu lub rozdziału metodologicznego.
Jak cytować ten kalkulator: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Wynikiem jest liczba wypełnień, a nie zaproszeń. To liczba, którą musisz mieć w ręku na koniec badania terenowego. Liczba zaproszeń to ta wartość podzielona przez oczekiwany wskaźnik odpowiedzi i właśnie tu większość planów doboru próby się myli. Gdy cel jest ustalony, utwórz ankietę i przeprowadź badanie pilotażowe wśród docelowych odbiorców. Wykorzystaj je, aby sprawdzić sformułowania i oszacować, jaki odsetek zaproszonych wypełni ankietę w Twoim projekcie.
Czym jest wielkość próby
Wielkość próby to liczba osób, które wypełnią Twoją ankietę. W każdym wzorze na tej stronie oznacza się ją jako n; to jedyna wielkość, którą kupujesz badaniem terenowym, zamiast wybrać ją na papierze, i to z niej oblicza się Twój margines błędu.
Mylone są z nią trzy liczby, a ich rozróżnienie to większość tego, czym zajmuje się plan doboru próby:
- Populacja (N): wszyscy, których chcesz opisać. Lista klientów, liczba pracowników, kraj.
- Zaproszenia: ile osób kontaktujesz. Zawsze więcej niż n, bo nie wszyscy odpowiadają.
- Wielkość próby (n): ile wypełnień masz w chwili zakończenia badania terenowego. To liczba, którą wyznacza wzór, i jedyna z trzech, która zmienia Twój margines błędu.
Wielkość próby kupuje precyzję, czyli szerokość przedziału plus minus wokół każdego wyniku. Nie kupuje dokładności, czyli tego, czy osoby, które odpowiedziały, przypominają te, które nie odpowiedziały. Duża próba wygodna może być dalej od prawdy niż mała próba losowa i żadna wartość n tego nie naprawi. Różnicę omawia sekcja Gdzie planowanie wielkości próby zawodzi, a rozstrzyga o niej sposób doboru próby.
Krótka odpowiedź, jeśli chcesz tylko liczby
Kluczowe liczby
- 385 wypełnień to domyślna odpowiedź. Tyle zwraca wzór przy poziomie ufności 95%, marginesie błędu plus minus 5 punktów procentowych i braku wcześniejszego oszacowania wyniku.
- Małe populacje potrzebują znacznie mniej. Lista 1000 osób wymaga 278. Lista 100 osób wymaga 80. Tak działa korekta dla populacji skończonej.
- Precyzja jest droga. Zmniejszenie marginesu błędu o połowę zwiększa próbę mniej więcej czterokrotnie. Przejście z plus minus 5 punktów do plus minus 1 punktu oznacza wzrost z 385 do 9604.
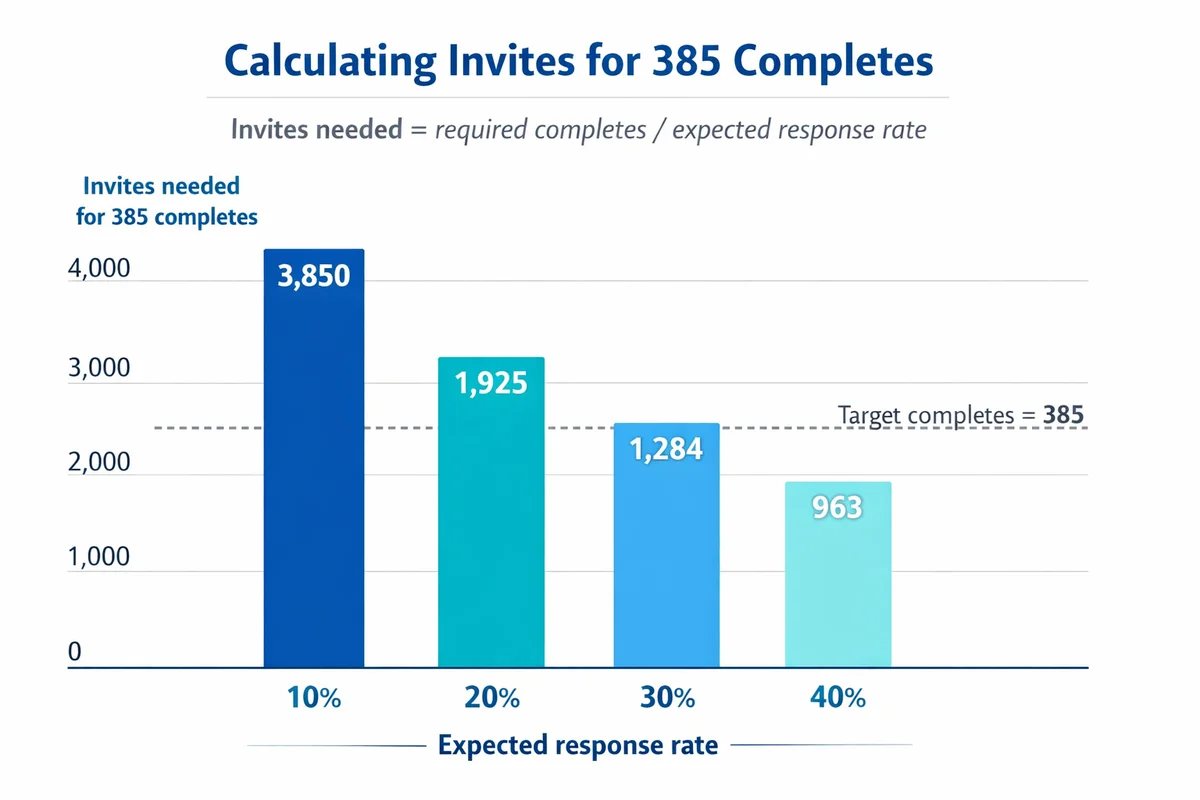
- Wzory liczą wypełnienia, a nie zaproszenia. Potrzebna liczba zaproszeń to liczba wypełnień podzielona przez oczekiwany wskaźnik odpowiedzi. Przy wskaźniku 30% potrzebujesz 1284 zaproszeń, aby uzyskać 385 wypełnień.
- Margines błędu obejmuje jeden rodzaj błędu. Mierzy szum wynikający z badania niektórych osób zamiast wszystkich. Nie mówi nic o osobach, które nigdy nie odpowiedziały.
Wzór na wielkość próby i jak policzyć ją ręcznie
Dla ankiety, która podaje odsetek, standardowym punktem wyjścia jest wielkość próby dla populacji na tyle dużej, że można ją traktować jako nieograniczoną:
n0 = (z^2 x p x (1 - p)) / E^2
Czytając od lewej do prawej:
- n0 to wymagana liczba wypełnień przed jakąkolwiek korektą dla populacji.
- z to wartość z dla Twojego poziomu ufności. Dla 95% użyj 1,96.
- p to oczekiwana proporcja zapisana jako ułamek dziesiętny. Jeśli jej nie znasz, użyj 0,5.
- E to margines błędu zapisany jako ułamek dziesiętny. Pięć punktów procentowych to 0,05.
Symbolem wielkości próby jest n. Niektóre źródła zapisują wartość bez korekty jako n0, a skorygowaną jako n i tę konwencję stosujemy tutaj.
| Poziom ufności | z | Ile Cię to kosztuje |
|---|---|---|
| 80% | 1.282 | 165 wypełnień przy plus minus 5 punktach |
| 90% | 1.645 | 271 wypełnień |
| 95% (standardowy) | 1.960 | 385 wypełnień |
| 99% | 2.576 | 664 wypełnienia |
| 99,9% | 3.291 | 1084 wypełnienia |
Przykład z obliczeniami: od 385 do listy zaproszeń
Scenariusz. Chcesz poznać odsetek klientów, którzy by Cię polecili. Chcesz poziomu ufności 95% i plus minus 5 punktów. Nie masz wcześniejszego oszacowania, więc p = 0,5.
Wybierz poziom ufności i margines błędu
Poziom ufności 95% oznacza z = 1,96. Plus minus 5 punktów procentowych to E = 0,05.
Wybierz oczekiwany wynik
p = 0,5, bo nie ma wcześniejszego oszacowania, a 0,5 daje największą próbę. Nic, czego dowiesz się później, nie sprawi, że próba okaże się za mała.
Zastosuj wzór na wielkość próby
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Zaokrąglij w górę: 385 wypełnień. Zawsze zaokrąglaj w górę. Nie da się zebrać ułamka ankiety.
Skoryguj dla małej populacji
Jeśli ci klienci to lista 1000 osób, a nie otwarty rynek, zastosuj korektę: n = 384,16 / (1 + 383,16 / 1000) = 384,16 / 1,38316 = 277,7, czyli 278 wypełnień. Korekta zaczyna mieć znaczenie dopiero wtedy, gdy próba stanowi dużą część populacji.
Przelicz wypełnienia na zaproszenia
Przy wskaźniku odpowiedzi 30% zaproszenia = 278 / 0,30 = 926,7, więc zaproś 927 osób. Wzór wyznacza liczbę wypełnień. Zaproszenia to to, co faktycznie wysyłasz, i nigdy nie może ich być więcej niż osób w populacji, z której losujesz.
Przy poziomie ufności 95% i p = 0,5 cały wzór sprowadza się do 0,9604 podzielone przez E do kwadratu. Ten jeden skrót odpowiada na większość pytań o wielkość próby w jednej linijce i dlatego 385 wciąż pojawia się w tabelach wielkości próby, które znajdziesz gdzie indziej.
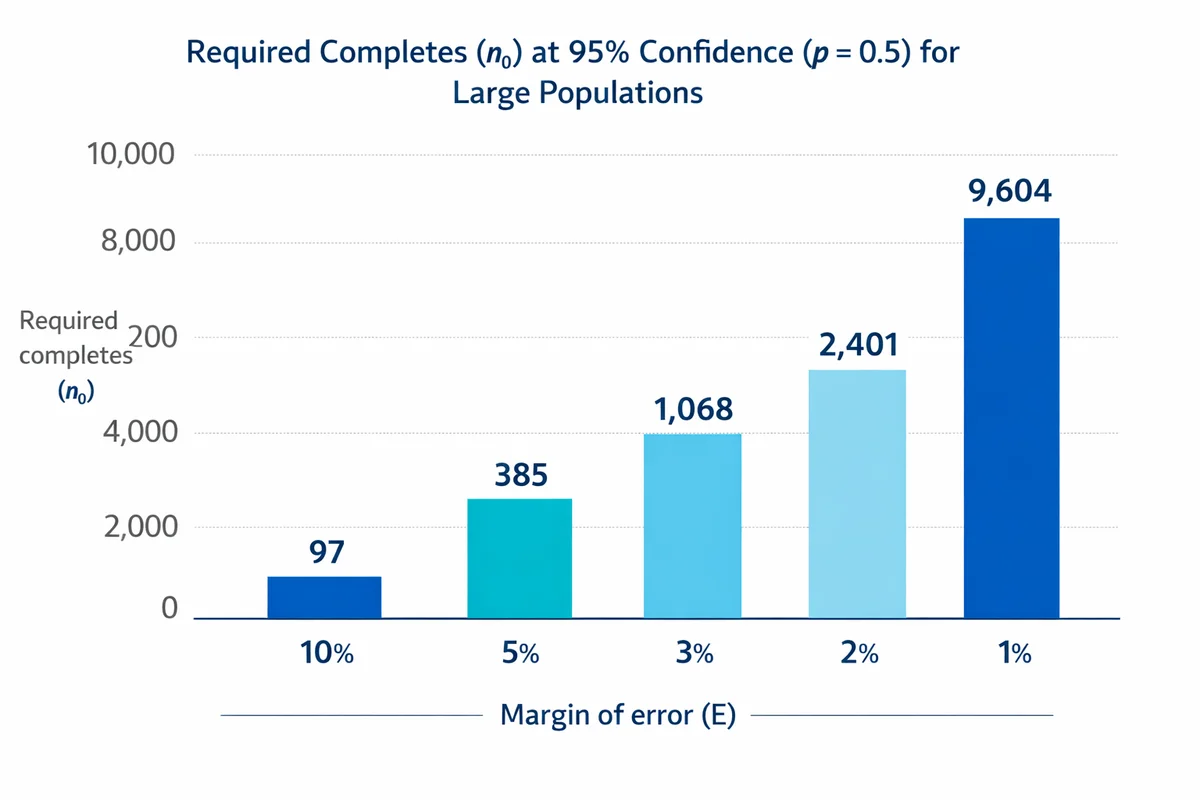
Tabela wielkości próby dla typowych wielkości populacji
Te wartości obliczono za pomocą powyższego wzoru przy poziomie ufności 95%, plus minus 5 punktach i p = 0,5, a następnie skorygowano dla populacji. Dwie ostatnie kolumny to nasze własne porównanie z tabelą opublikowaną przez Krejciego i Morgana w 1970 roku, którą cytuje większość rozdziałów metodologicznych.
| Populacja (N) | Potrzebne wypełnienia | Krejcie i Morgan (1970) | Różnica |
|---|---|---|---|
| 10 | 10 | 10 | tyle samo |
| 25 | 24 | brak w tabeli | |
| 50 | 45 | 44 | 1 więcej |
| 100 | 80 | 80 | tyle samo |
| 200 | 132 | 132 | tyle samo |
| 500 | 218 | 217 | 1 więcej |
| 1,000 | 278 | 278 | tyle samo |
| 2,000 | 323 | 322 | 1 więcej |
| 5,000 | 357 | 357 | tyle samo |
| 10,000 | 370 | 370 | tyle samo |
| 50,000 | 382 | 381 | 1 więcej |
| 100,000 | 383 | 384 | 1 mniej |
Jak to sprawdziliśmy. Obliczyliśmy wzór dla 21 wielkości populacji i porównaliśmy każdy wynik z wartością opublikowaną przez Krejciego i Morgana. Dwanaście wyników zgadzało się dokładnie. Pozostałe dziewięć różniło się dokładnie o jedno wypełnienie, co wynika z miejsca zaokrąglania w każdej z metod, a nie z różnicy w obliczeniach. Jeśli promotor zapyta, dlaczego Twoja liczba różni się od tabeli o jeden, to właśnie jest powód.
Warto wiedzieć, jeśli cytujesz tę tabelę: Krejcie i Morgan nie wyprowadzili własnego wzoru. Ich artykuł z 1970 roku liczy około 400 słów i jedną tabelę, a jedyny przypis przypisuje wzór biuletynowi badawczemu National Education Association z 1960 roku. Ich własne podsumowanie tej zależności wciąż jest najlepszym jednozdaniowym opisem: wraz ze wzrostem populacji wymagana próba rośnie coraz wolniej i stabilizuje się na poziomie nieco ponad 380 przypadków.
Wybór danych wejściowych, po kolei
Wynik zależy od czterech liczb. Trzy z nich to decyzje, a nie fakty, i każdą można wybrać w sposób dający się obronić.
Poziom ufności: jak często metoda się nie myli
Poziom ufności opisuje metodę, a nie tę konkretną ankietę. Przy poziomie ufności 95% przedziały wyznaczone w ten sposób w długim okresie zawierają prawdziwą wartość 95 razy na 100. Nie oznacza to 95% szans, że Twoja konkretna odpowiedź jest poprawna.
Stosuj 95%, chyba że masz powód, by tego nie robić. Przejście na 99% zwiększa próbę z 385 do 664 przy tej samej precyzji, czyli koszt rośnie o 72%, a zysk jest niewielki. Pokrewnym pojęciem w testowaniu hipotez jest alfa i dlatego ludzie mylą te dwa pojęcia. Jeśli to rozróżnienie jest dla Ciebie niejasne, zanim wybierzesz liczbę, przeczytaj o istotności statystycznej i znaczeniu wartości p.
Margines błędu: zmienna decyzyjna
Nad tą wartością zastanów się najdłużej, bo to jedyna dana wejściowa, która wiąże próbę z decyzją. Wybierz ją, pytając, jaka różnica zmieniłaby to, co zrobisz.
Jeśli postąpisz inaczej, gdy zadowolenie wyniesie 72%, a nie 74%, potrzebujesz wąskiego marginesu. Jeśli działasz dopiero przy różnicy 72 wobec 82, plus minus 5 punktów w zupełności wystarczy. Ogólne raporty zwykle zatrzymują się na 5 punktach przy szybkim badaniu nastrojów lub na 3 punktach przy badaniu trendów. Poniżej 2 punktów koszt szybko rośnie.
Wielkość populacji: zwykle bez znaczenia, do czasu
Przy dużych populacjach wymagana próba prawie się nie zmienia. Dziesięć tysięcy osób wymaga 370 wypełnień. Sto tysięcy – 383. Wielkość populacji ma znaczenie dopiero wtedy, gdy Twoja próba stanowi jej istotną część, a tak jest w przypadku list pracowników, rejestrów członków i roczników szkolnych. Tym zajmuje się następna sekcja.
Oczekiwany wynik (p): gdy nie wiesz, użyj 0,5
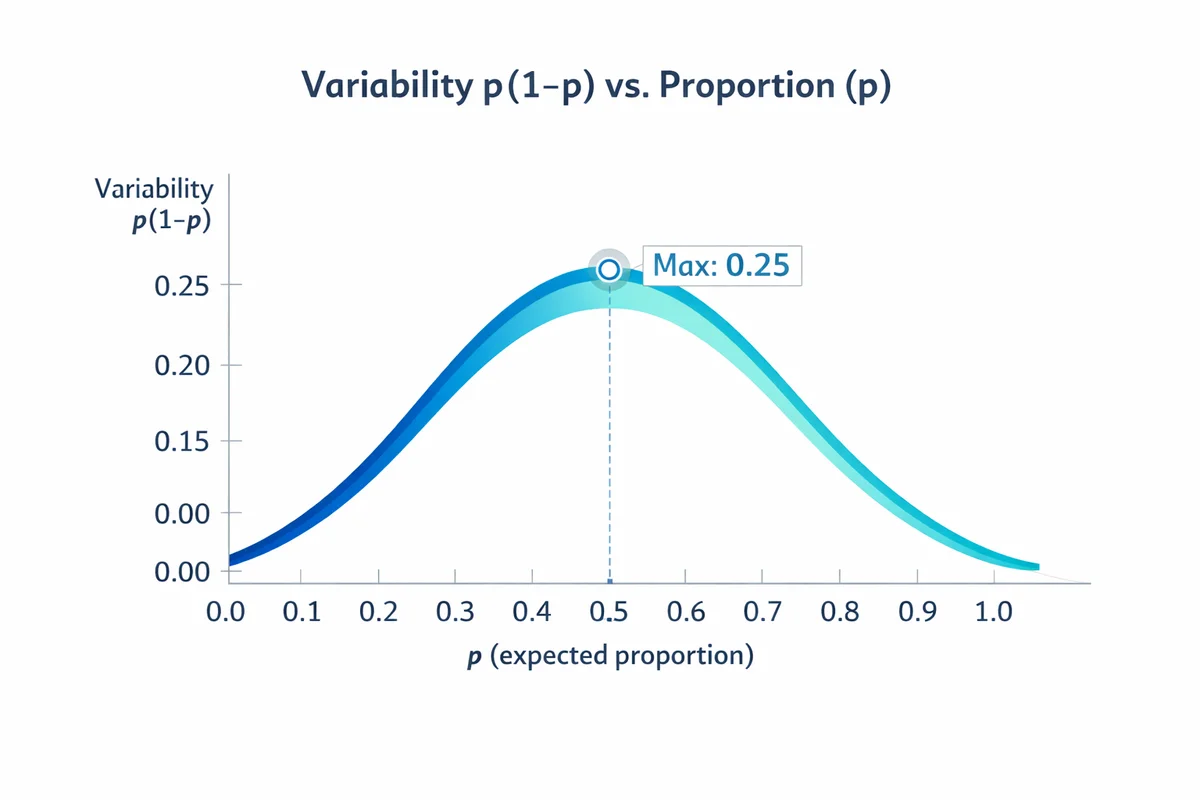
W pytaniu o odsetek niepewność zależy od iloczynu p razy (1 minus p). Ten iloczyn jest największy przy p = 0,5, więc 0,5 to wybór ostrożny, który daje największą próbę. To właściwa wartość domyślna, gdy nie masz wcześniejszego oszacowania.
Jeśli je masz, wykorzystaj je, bo oszczędność jest duża. Przy poziomie ufności 95% i plus minus 5 punktach p = 0,5 wymaga 385 wypełnień, a p = 0,9 tylko 139. Wcześniejsze ankiety, badanie pilotażowe lub opublikowany punkt odniesienia to uczciwe źródła takiego oszacowania. Niejasne pytania także zwiększają rozrzut, więc jaśniejsze sformułowania mogą ustabilizować wynik bez żadnych dodatkowych wypełnień. Pisanie lepszych pytań do ankiety jest często tańsze niż zbieranie większej liczby odpowiedzi.
Małe populacje: korekta dla populacji skończonej
Podstawowy wzór zakłada, że losujesz z puli tak głębokiej, że usunięcie z niej ludzi niczego nie zmienia. Gdy Twoja próba stanowi istotną część populacji, to założenie każe Ci zebrać za dużo. Korekta dla populacji skończonej zwraca Ci te wypełnienia.
n = n0 / (1 + ((n0 - 1) / N))
- n to skorygowana liczba potrzebnych wypełnień.
- n0 to wartość bez korekty z powyższego wzoru.
- N to wielkość populacji.
Zwykle korektę stosuje się, gdy n0 przekracza około 5% N. Poniżej tego progu korekta prawie niczego nie zmienia, więc nie warto jej nikomu tłumaczyć.
Przykład z obliczeniami: ankieta pracownicza
Scenariusz. Masz 1200 pracowników. Chcesz poziomu ufności 95%, plus minus 5 punktów i przyjmujesz p = 0,5.
- Bez korekty: n0 = 384,16.
- Po korekcie: n = 384,16 / (1 + (383,16 / 1200)) = 384,16 / 1,3193 = 291,2.
- Zaokrąglij w górę: 292 wypełnienia.
Bez korekty trzeba by zebrać 385 wypełnień z listy 1200 osób, czyli od 32% wszystkich. Z korektą tę samą precyzję daje 292. Przy liście tej wielkości to miesiąc ponaglania, którego możesz sobie oszczędzić.
Poniżej około 200 osób skorygowana próba stanowi tak dużą część listy, że zaproszenie wszystkich jest prostsze i łatwiejsze do obrony. Badanie pełne obejmujące 150 osób w ogóle nie ma błędu losowania. Twój wysiłek idzie wtedy we wskaźnik odpowiedzi i w ustalenie, kogo brakuje, czyli tam, gdzie powinien.
Margines błędu: ten sam wzór, odwrócony
Margines błędu to przedział plus minus wokół wyniku ankiety, wynikający z tego, że zapytano niektóre osoby, a nie wszystkie. Jeśli 62% z 385 uczestników wybiera daną opcję, a margines błędu wynosi 5 punktów, podajesz 62% i piszesz, że prawdopodobny zakres wynosi od 57 do 67%.
Przekształcenie wzoru na wielkość próby względem E daje:
E = z x pierwiastek kwadratowy z (p x (1 - p) / n)
Dla populacji skończonej pomnóż ten wynik przez pierwiastek kwadratowy z (N - n) podzielonego przez (N - 1). Obie wersje są w kalkulatorze poniżej, który przełącza się automatycznie, gdy zaznaczysz lub odznaczysz pole populacji.
Jaki jest margines błędu dla wypełnień, które już mam?
Ten sam wzór, przekształcony. Wpisz zebrane wypełnienia i odczytaj precyzję.
Margines błędu
5.0
Punkty procentowe, plus minus.
Twój przedział
45,0 do 55,0
Procent, przy poziomie ufności 95%.
Obliczenia krok po kroku
Czy margines błędu rośnie wraz z wielkością próby?
Maleje, i to proporcjonalnie do pierwiastka kwadratowego z n. Ten pierwiastek to cała ekonomia ankiet. Czterysta wypełnień daje o połowę mniejszy błąd niż sto. Aby zmniejszyć go o połowę jeszcze raz, potrzebujesz 1600. Każde kolejne miejsce po przecinku precyzji kosztuje mniej więcej czterokrotnie więcej pracy w terenie i dlatego 385 jest tak częstym punktem docelowym: tam koszt i precyzja przestają się spierać.
Cztery pojęcia, które ludzie mylą
Błąd standardowy, margines błędu, poziom ufności i przedział ufności są używane tak, jakby były wymienne. To cztery różne rzeczy, a różnica ma znaczenie, gdy ktoś zakwestionuje Twoją liczbę.
| Pojęcie | Czym jest | Przy 385 wypełnieniach i 50% |
|---|---|---|
| Błąd standardowy | Surowy rozrzut oszacowania. Pierwiastek kwadratowy z p razy (1 minus p) podzielonego przez n. | 0,0255, czyli 2,55 punktu procentowego |
| Margines błędu | Błąd standardowy pomnożony przez wartość z dla wybranego poziomu ufności. | Plus minus 5,0 punktu przy 95% |
| Poziom ufności | Wybrana wartość z wyrażona w procentach. Wybór, a nie pomiar. | 95%, więc z = 1,96 |
| Przedział ufności | Wynik z uwzględnionym marginesem błędu, zapisany jako zakres. | Od 45,0% do 55,0% |
W skrócie: błąd standardowy to właściwość Twoich danych, poziom ufności to Twój wybór, margines błędu to iloczyn tych dwóch, a przedział ufności to to, co drukujesz w raporcie.
Czego margines błędu nie obejmuje
Obejmuje losowy błąd próby i nic więcej. Nie obejmuje osób, które zignorowały zaproszenie, listy, na której brakowało części populacji, ani pytania, które połowa uczestników zrozumiała inaczej, niż zamierzono. Ankieta może mieć porządny margines błędu i mimo to się mylić. Błędy, których żadna wielkość próby nie naprawi, omawia artykuł o zniekształceniu odpowiedzi i błędzie braku odpowiedzi.
Organizacja zawodowa badaczy ankietowych mówi o tym dosadniej niż większość dostawców. AAPOR stwierdza, że nie istnieje coś takiego jak mierzalny całkowity margines błędu sondażu, bo ankiety obciążone są innymi błędami, których w ogóle nie da się zmierzyć, od sposobu sformułowania pytań po sposób prowadzenia wywiadów. Obliczyć można tylko część wynikającą z losowania próby. Tę część podaje Ci kalkulator i warto jasno powiedzieć, że to tylko część.
Dwie zasady użycia z tego samego źródła, które większość tekstów o ankietach stosuje źle:
- To punkty procentowe, a nie procenty. Pisz „plus minus 3 punkty procentowe”, a nie „plus minus 3 procent”. To oznacza co innego.
- W ogóle nie dotyczy prób z dobrowolnym zgłoszeniem. Margines błędu zakłada, że każda osoba miała znane, niezerowe prawdopodobieństwo wyboru. Otwarty link, panel ochotników czy post w mediach społecznościowych nie spełniają tego warunku. Publikowanie marginesu błędu obok wyników z otwartego linku to deklarowanie precyzji, za którą nie zapłacono.
Przeliczanie wypełnień na zaproszenia
Wzór podaje liczbę ukończonych wypełnień. Badanie terenowe daje wskaźnik odpowiedzi. Luka między nimi to miejsce, w którym plany doboru próby zwykle zawodzą, a obliczenie mieści się w jednej linijce:
Zaproszenia = wymagane wypełnienia / oczekiwany wskaźnik odpowiedzi
Wpisz wskaźnik jako ułamek dziesiętny, czyli 30% to 0,30, i zaokrąglij w górę. Dla 292 wypełnień przy 35% to 292 podzielone przez 0,35 = 834,3, więc zaproś co najmniej 835 osób.
| Potrzebne wypełnienia | Oczekiwany wskaźnik odpowiedzi | Zaproszenia |
|---|---|---|
| 385 | 60% | 642 |
| 385 | 30% | 1,284 |
| 385 | 15% | 2,567 |
| 292 | 50% | 584 |
| 292 | 35% | 835 |
| 292 | 20% | 1,460 |
Jak wybrać wskaźnik odpowiedzi, którego możesz bronić
Twoje własne dane historyczne są lepsze niż każdy opublikowany punkt odniesienia, o ile dotyczą tych samych odbiorców, tego samego kanału i ankiety o podobnej długości. Jeśli nie masz się na czym oprzeć, zaplanuj trzy scenariusze: 20, 30 i 40%, i traktuj listę zaproszeń jako dźwignię, którą możesz regulować w trakcie badania terenowego. Przypomnienia, dłuższy czas trwania i szersza lista to rzeczy, które można zmienić w połowie. Docelowej liczby wypełnień zmienić nie można.
Większość tabel z punktami odniesienia w internecie podaje jedną średnią bez źródła. Nie ma jednej średniej. Oto, co faktycznie podają źródła pierwotne, aby można było zacytować wiersz pasujący do Twojej sytuacji zamiast liczby, którą ktoś wymyślił.
| Kontekst | Wskaźnik odpowiedzi | Skala i źródło |
|---|---|---|
| Amerykańskie agencje federalne zatrudniające poniżej 1000 osób | 71% | 2024 Federal Employee Viewpoint Survey (OPM) |
| Amerykańskie agencje federalne zatrudniające od 1000 do 9999 osób | 60% | To samo badanie, ten sam rok (OPM) |
| Amerykańskie agencje federalne zatrudniające ponad 75 000 osób | 37% | To samo badanie, ten sam rok (OPM) |
| Wszyscy pracownicy federalni w USA | 41% | Ponad 1,6 mln zaproszonych, ponad 674 000 odpowiedziało, 2024 (OPM) |
| Opublikowane ankiety online, wszystkie rodzaje | średnio 44,1% | Metaanaliza 1071 podanych wskaźników (Wu i in., 2022) |
| Opublikowane badania organizacyjne | 68% w 2020 roku wobec 48% w 2005 roku | 1014 ankiet w 17 czasopismach (Holtom i in., 2022) |
| Sondaże telefoniczne ogółu społeczeństwa | 6% w 2018 roku wobec 36% w 1997 roku | Wskaźnik monitorowany przez samo Pew Research Center (Kennedy i Hartig, 2019) |
| Ankieta internetowa w porównaniu z każdym innym trybem | około 12 punktów mniej | Metaanaliza 114 porównań eksperymentalnych (Daikeler i in., 2020) |
Z tej tabeli wynikają dwie rzeczy. Po pierwsze, wielkość badanej grupy przewiduje wskaźnik lepiej niż niemal wszystko inne, na co masz wpływ. Firma licząca 300 osób i agencja licząca 300 000 osób nie prowadzą tej samej ankiety. Po drugie, często powtarzane twierdzenie, że wskaźniki odpowiedzi wszędzie się załamują, jest prawdziwe tylko w niektórych miejscach. Sondaże telefoniczne rzeczywiście się załamały. Opublikowane badania organizacyjne poszły w przeciwną stronę: z 48% do 68% w ciągu piętnastu lat.
Jeszcze jedno obliczenie planistyczne warte zapożyczenia: standardowe wytyczne zalecają dodanie do listy zaproszeń około 10% na osoby, do których po prostu nie da się dotrzeć, i około 30% na osoby, które mogłyby odpowiedzieć, ale tego nie zrobią.
Co nasz własny zbiór szablonów mówi o długości
Wskaźnik odpowiedzi zapożyczony z cudzej ankiety słabo się przenosi, a długość to jedna z niewielu rzeczy na tej liście, nad którą masz pełną kontrolę. Oto liczba, którą możemy podać my, a konkurencja nie, bo pochodzi z policzenia naszego własnego opublikowanego zbioru, a nie z pytania praktyków, co według nich robią.
W naszym przeglądzie z 21 sierpnia 2026 roku wszystkie 87 szablonów ankiet miało 14 pytań lub mniej, a 86 miało 10 pytań lub mniej. Łącznie zawierały 799 pytań. Mediana wynosiła 9 pytań, a dokładnie jeden szablon przekraczał 10. Te liczby opisują stan z tego dnia, a nie obecną bibliotekę.
| Pytania w szablonie | Szablony | Udział w zbiorze |
|---|---|---|
| 7 pytań | 4 | 5% |
| 8 pytań | 17 | 20% |
| 9 pytań | 29 | 33% |
| 10 pytań | 36 | 41% |
| 14 pytań | 1 | 1% |
Według formatu odpowiedzi 355 z 799 pytań to skale ocen, 281 to listy jednokrotnego wyboru, a 163 wymagają wpisania czegoś. To właśnie ta grupa najbardziej obniża liczbę ukończonych ankiet, więc przeczytaliśmy ją ręcznie, zamiast ufać zapisanemu polu. Spośród 163 aż 137 to wielowierszowe pola komentarza. Pozostałe 26 to pola jednowierszowe, a ich lektura pokazała, że 22 to krótkie pola identyfikacyjne lub klasyfikacyjne: imię i nazwisko, adres e-mail, data, dział, stanowisko. Tylko 4 to merytoryczne krótkie odpowiedzi. Uczciwa liczba naprawdę otwartych pytań wynosi więc 141, czyli mniej więcej jedno pytanie na sześć, a nie jedno na pięć, jak wynikałoby z surowego pola.
Jak liczyliśmy i jak to sprawdziliśmy. Przeanalizowaliśmy zapisaną listę pytań każdego szablonu ankiety dostępnego na tej stronie 21 sierpnia 2026 roku, zachowaliśmy pozycje zawierające treść pytania, a następnie pobraliśmy każdą opublikowaną stronę i porównaliśmy oba zbiory, zamiast ufać wyłącznie naszej bazie danych. Wszystkie 87 stron zwróciło HTTP 200, a adres, o którym wiemy, że nie działa, zwrócił w tym samym przebiegu 410, więc test faktycznie rozróżniał przypadki, a nie wszędzie dawał wynik pozytywny. 785 z 799 pytań, czyli 98%, pojawia się na opublikowanej stronie. Sześć z tych dopasowań różni się od bazy danych tylko użytym znakiem apostrofu i policzyliśmy je jako dopasowania, co wolimy ujawnić, niż po cichu zaokrąglić. Osiemdziesiąt sześć z 87 szablonów zweryfikowano w całości. Ten, którego nie udało się zweryfikować, jest naszym najdłuższym, ma 14 pytań, a jego opublikowana strona obecnie nie wyświetla żadnych pytań w podglądzie, więc nie dało się ich potwierdzić z zewnątrz.
Długość szablonu nie mówi, jaki będzie wskaźnik odpowiedzi na zaproszenia. Nasze osobne zestawienie odpowiedzi w ankietach bada zachowanie osób, które już weszły w interakcję z ankietą; nie liczy wszystkich zaproszonych. Do planowania zaproszeń użyj udokumentowanego wskaźnika z porównywalnego projektu lub badania pilotażowego i zachowaj spójny mianownik.
Praktyczne zastosowanie jest wąskie, ale realne. Jeśli zapożyczasz wskaźnik odpowiedzi do obliczenia liczby zaproszeń w kalkulatorze, zapożycz go z ankiety o długości zbliżonej do tej, którą zamierzasz wysłać, do podobnych odbiorców i podobnym kanałem. Nasze własne opublikowane kwestionariusze mają od 7 do 10 pytań, czyli mniej niż większość pierwszych wersji roboczych.
Więcej zaproszeń nie zmniejszy obciążenia
Niski wskaźnik odpowiedzi tworzy dwa problemy, które wyglądają jak jeden. Pierwszy polega na tym, że nie osiągasz celu, więc margines błędu jest szerszy, niż planowano. Drugi polega na tym, że osoby, które odpowiedziały, mogą różnić się od tych, które nie odpowiedziały, w sposób istotny dla wyniku.
Zaproszenie większej liczby osób rozwiązuje pierwszy problem. Nie rozwiązuje w niezawodny sposób drugiego. Groves i Peytcheva zebrali 59 badań, w których mierzono rzeczywisty błąd braku odpowiedzi względem znanej prawdy, i stwierdzili jedynie niewielki związek między wskaźnikiem odpowiedzi ankiety a tym, jak bardzo okazała się obciążona. Pew przetestowało tę samą tezę bezpośrednio: ten sam kwestionariusz przeprowadzono dwukrotnie, raz standardowymi metodami, które dały wskaźnik odpowiedzi 9%, i raz według pracochłonnego protokołu, który dał 22%. Spośród 40 wspólnych pytań w 28 wyniki obu ankiet różniły się o nie więcej niż 2 punkty.
Uczciwy kontrprzykład. Ten wniosek nie przenosi się na każdy temat i warto wiedzieć, gdzie przestaje działać. W ankietach satysfakcji ten związek jest rzeczywisty i silny. Badanie 717 ankiet satysfakcji pacjentów w 164 szwajcarskich szpitalach wykazało, że średni wynik satysfakcji i wskaźnik odpowiedzi były skorelowane na poziomie r = 0,61, bo odpowiadają ludzie zachwyceni i wściekli, a obojętny środek już nie. Jeśli prowadzisz badania CSAT lub NPS, rosnący wskaźnik odpowiedzi może sam przesunąć Twój wynik, a niski prawdopodobnie Ci schlebia.
Wniosek: zabiegaj o wysoki wskaźnik odpowiedzi, gdy mierzysz, co ludzie o Tobie sądzą. Nie traktuj go jako certyfikatu trafności, gdy mierzysz cokolwiek innego.
Wielkość próby w badaniach ilościowych: czego wymaga rozdział metodologiczny
Nie ma jednej dobrej wielkości próby dla badań ilościowych, a każde źródło, które ją podaje, nie pytając, co mierzysz, zgaduje. Rozdział metodologiczny zostaje zaakceptowany nie dzięki dużej liczbie, lecz dzięki podanej liczbie, obok której zapisano poziom ufności, margines błędu, przyjętą proporcję i populację, z przywołaniem konkretnego wzoru.
Promotorzy zwykle oczekują jednego z czterech znanych podejść. W większości dają podobne wyniki i warto wiedzieć, o które z nich chodzi.
| Podejście | Czego od Ciebie wymaga | Wynik dla N = 1000 przy 95% i 5 punktach | Kiedy go użyć |
|---|---|---|---|
| Cochran (1977) | z, p, E, a następnie korekty dla populacji skończonej, jeśli populacja jest mała | 278 | Domyślnie. To wzór z tej strony i ten, z którego wywodzą się pozostałe. |
| Krejcie i Morgan (1970) | Niczego. Odczytujesz odpowiedź z opublikowanej tabeli według wielkości populacji. | 278 | Chcesz tabeli, którą można zacytować, zamiast obliczeń. To Cochran przy ustalonych parametrach. |
| Yamane (1967), często nazywany wzorem Slovina | Tylko N i marginesu błędu | 286 | Tylko wtedy, gdy p naprawdę jest nieznane i akceptujesz wbudowany poziom ufności 95%. Zobacz zastrzeżenie poniżej. |
| Analiza mocy | Wielkości efektu, mocy, alfy i testu, który przeprowadzisz | Zależy całkowicie od wielkości efektu | Testujesz hipotezę, a nie szacujesz odsetek. Użyj G*Power lub OpenEpi, a nie tej strony. |
Cochran i dlaczego wszystko inne to jego skrót
Wzór Cochrana to ten na górze tej strony: n0 = z do kwadratu razy p razy (1 minus p), podzielone przez E do kwadratu, a następnie korekta dla populacji skończonej, gdy populacja jest mała. Pozostałe znane metody ustalają niektóre z tych danych wejściowych, aby skrócić obliczenia. Gdy to wiesz, ta rodzina przestaje wyglądać jak cztery konkurujące reguły, a zaczyna wyglądać jak jedna reguła z trzema gotowymi ustawieniami.
Yamane i Slovin: stosuj świadomie
Wzór n = N / (1 + N x e^2) pojawia się w tysiącach prac dyplomowych, zwykle przypisywany Slovinowi. Jest szybki: dla N = 1000 i e = 0,05 daje 286.
Zanim go zacytujesz, warto wiedzieć trzy rzeczy.
- To Cochran z zaspawanymi ustawieniami. Licząc wstecz, jest to wzór dla proporcji z p ustalonym na 0,5, poziomem ufności ustalonym na 95% i wartością z zaokrągloną z 1,96 do 2. Nie odpowie na pytanie przy żadnym innym poziomie ufności i nie ma żadnej danej wejściowej opisującej zmienność populacji. Dwie populacje tej samej wielkości, ale o zupełnie innym rozrzucie, dostają tę samą odpowiedź, co nie może być prawdą.
- To zaokrąglenie sprawia, że jego wyniki są zawyżone. Przy z = 2 górny limit wzoru dla nieograniczonej populacji wynosi dokładnie 1 podzielone przez e do kwadratu, czyli 400. Górny limit Cochrana to 384,16, bo 1,96 do kwadratu to 3,8416, a nie 4. Każda wartość Yamane w powyższej tabeli jest o kilka procent większa od wartości Cochrana właśnie z tego powodu. Jeśli kiedyś zastanawiało Cię, dlaczego dwa podręczniki podają dwie różne wielkości próby dla tego samego badania, zwykle właśnie to jest odpowiedź.
- Przypisanie autorstwa się nie broni. Czasopismo statystyczne prześledziło historię wzoru i stwierdziło, że nie da się ustalić żadnej osoby o nazwisku Slovin, która by za nim stała, a najstarszym możliwym do wskazania źródłem jest podręcznik Taro Yamane z 1967 roku. Wolfram MathWorld opisuje go jako wzór doraźny, pozbawiony matematycznej ścisłości. Jeśli Twój wydział go oczekuje, użyj go i cytuj Yamane, a nie Slovina. Jeśli masz wybór, użyj wzoru Cochrana, bo wytrzymuje pytanie, skąd wzięło się 95%.
Reguły kciuka, uczciwie ocenione
Te reguły są szeroko rozpowszechnione. Niektóre są przydatne, inne to folklor i warto wiedzieć, które są które.
- Co najmniej 30 na grupę. Rozsądne jako minimum przy porównywaniu grup, ale nie jako cel. Bierze się z tego, kiedy rozkłady z próby zaczynają się dobrze zachowywać, a nie z jakiegokolwiek wymogu precyzji.
- Dziesięć przypadków na zmienną w regresji. Robocza heurystyka, powszechnie stosowana i powszechnie krytykowana. Przedstawiaj ją jako heurystykę, nigdy jako regułę.
- Dziesięć procent populacji. Ta reguła jest po prostu błędna, a powyższa tabela pokazuje dlaczego. Dziesięć procent ze 100 000 to 10 000 wypełnień, podczas gdy 383 daje tę samą precyzję.
- Zawsze 385. Prawdziwe tylko dla dużej populacji przy 95% i 5 punktach. Podawaj tę liczbę razem z tymi warunkami, inaczej nic nie znaczy.
- Małe n w badaniach użyteczności i produktów. Nielsen Norman Group publikuje uczciwą wersję tej reguły: 40 uczestników daje miarę typu tak lub nie z dokładnością plus minus 15 punktów przy poziomie ufności 95%, a 47 daje średnią z tą samą precyzją. Te liczby są małe, bo deklarowana precyzja jest luźna. Powiedz otwarcie, jaka jest precyzja, a małe próby przestaną być powodem do wstydu.
Jeśli Twoje badanie porównuje grupy, a nie szacuje jeden odsetek, wielkość próby staje się kwestią mocy testu i to nie jest właściwy kalkulator. Potrzebujesz wielkości efektu, której możesz bronić, a także alfy i mocy. G*Power i OpenEpi to darmowe narzędzia, których oczekuje większość promotorów, i oba są bezpłatne. Powiedzenie, gdzie kończą się możliwości narzędzia, jest bardziej przydatne niż udawanie, że potrafi wszystko.
Badania jakościowe mają inne zasady doboru liczebności
Wywiadów i grup fokusowych nie projektuje się pod margines błędu, bo nie szacują one odsetka w populacji. Zwykłym argumentem jest nasycenie: prowadzisz badanie, dopóki nowi uczestnicy nie przestaną wnosić nowych wątków, a następnie opisujesz, kiedy to nastąpiło i jak to oceniono. Przepuszczenie badania jakościowego przez ten kalkulator daje liczbę, która wygląda na precyzyjną, a nic nie znaczy.
Jeśli potrzebujesz wyników dla podgrup, dobierz wielkość próby dla podgrupy
Większość ankiet ma raportować według regionu, stanowiska, stażu lub linii produktów. To tutaj plany doboru próby po cichu się psują, a zasada jest krótka.
Twój margines błędu dotyczy grupy tylko wtedy, gdy ta grupa ma tyle wypełnień. Jeśli chcesz plus minus 5 punktów dla każdego z sześciu regionów, potrzebujesz około 385 wypełnień w każdym regionie, a nie 385 łącznie. To ankieta sześć razy większa, niż się wydawało na etapie planowania.
Dwa uczciwe wyjścia:
- Nadreprezentuj małe grupy. Celowo zaproś większy odsetek mniejszych segmentów, aby każdy osiągnął swój cel. Potem ważeniem przywracasz wynikom właściwe proporcje.
- Zaakceptuj szersze przedziały dla przekrojów. Zachowaj jedną mocną liczbę ogólną i publikuj każdą podgrupę z jej własnym, większym marginesem błędu obok. Zwykle to właściwa odpowiedź.
Kalkulator ma do tego pole. Ustaw Podgrupy raportowane osobno na liczbę grup, dla których musisz podać wynik, a kalkulator prawidłowo dobierze wielkość próby dla każdej grupy i je zsumuje.
Określ zakres, zanim zaczniesz badanie terenowe. Wypisz segmenty, o których musisz raportować, a nie te, które byłoby miło mieć. Oszacuj, ile wypełnień każdy z nich realnie może dać, i rozpoznaj je za pomocą pytań demograficznych. Jeśli segment może dać tylko 80 wypełnień, nie obiecuj dla niego plus minus 5 punktów. Przy 80 wypełnieniach przedział wynosi plus minus 11 punktów.
AAPOR posługuje się przykładem, który warto zapamiętać. Ankieta wśród 1000 dorosłych ma ogólny margines błędu około plus minus 3 punktów. Jeśli 200 z tych osób to podgrupa, o której naprawdę chcesz mówić, margines błędu tej podgrupy wynosi plus minus 6,9 punktu, czyli ponad dwa razy więcej. Liczba z pierwszej strony raportu to nie ta liczba, która rządzi wykresem na stronie dziewiątej.
Opublikowane wytyczne dotyczące minimalnej liczebności komórek są starsze i mniej rygorystyczne niż wzory i można je traktować jako dolną granicę, a nie cel: około 100 wypełnień dla podgrupy, o której będziesz rzetelnie raportować, oraz od 20 do 50 dla mniejszej, o której wspomnisz tylko mimochodem.
Gdzie planowanie wielkości próby zawodzi
Wielkość próby kontroluje błąd losowania, czyli losowy szum wynikający z tego, że nie pytasz wszystkich. Rzeczywiste ankiety obciążone są też błędem systematycznym, którego żadna wielkość próby nie naprawi, a duża próba może go zamaskować.
Traktowanie próby wygodnej jak próby probabilistycznej
Każdy wzór na tej stronie zakłada, że każda osoba miała znane, niezerowe prawdopodobieństwo wyboru, a udzielenie odpowiedzi nie było silnie powiązane z tym, co mierzysz. Otwarty link w mediach społecznościowych nie spełnia żadnego z tych warunków. Nadal możesz obliczyć margines błędu z wypełnień i będzie wyglądał uspokajająco, ale nie będzie znaczył tego, co twierdzi. Jasno określ, jaki rodzaj próby faktycznie dobrano.
Uznawanie większego n za lepszy pomiar
Duża próba sprawia, że zaszumiony pomiar jest precyzyjnie zaszumiony. Jeśli pytanie jest niejednoznaczne, dotyczy dwóch rzeczy naraz albo jest sugerujące, więcej wypełnień go nie uratuje. Wysoki odsetek pominięć i niespójne odpowiedzi to sygnały, by najpierw poprawić narzędzie. Przepisanie jednego złego pytania często daje więcej niż potrojenie próby.
Wybór precyzji bez decyzji, która za nią stoi
Precyzja ma właściwą wartość dopiero wtedy, gdy wiesz, do czego służy. Wielkości próby łatwo bronić, gdy potrafisz dokończyć zdanie: musimy odróżnić wyniki różniące się o X punktów. Nie da się jej bronić, gdy jedynym uzasadnieniem jest to, że większa liczba wydawała się bezpieczniejsza. Powiąż ją z projektem badania i z tym, co zrobisz z wynikiem.
Liczby na tej stronie i ich wiarygodność
Każda podana wyżej liczba to albo obliczenie, które możesz odtworzyć w kalkulatorze, albo cytat, który możesz sprawdzić. Ocena A oznacza wynik powtórzony lub bezpośrednio obliczalny, B jedno mocne badanie, a C wynik szeroko powtarzany, ale sporny.
| Twierdzenie | Liczba | Poziom | Źródło |
|---|---|---|---|
| Przy poziomie ufności 95% i braku wcześniejszego oszacowania duża populacja wymaga 385 wypełnień dla plus minus 5 punktów. | 385 | A | Bezpośrednie obliczenie ze standardowego wzoru dla proporcji. NIST, sekcja 3.3.3; Israel (1992). |
| Wzór z tej strony odtwarza opublikowaną tabelę wielkości próby Krejciego i Morgana z dokładnością do jednego wypełnienia dla każdej z 21 sprawdzonych wielkości populacji. | 21 z 21 z dokładnością do 1 | A | Nasze własne porównanie z danymi Krejciego i Morgana (1970). Metodę opisano pod tabelą. |
| Wskaźnik odpowiedzi słabo przewiduje błąd braku odpowiedzi. Metaanaliza 59 badań poświęconych obciążeniu wykazała tylko niewielki związek między nimi. | 59 badań | A | Groves i Peytcheva (2008), Public Opinion Quarterly. |
| Pew przeprowadziło ten sam kwestionariusz przy wskaźniku odpowiedzi 9% i 22%. Spośród 40 wspólnych pytań w 28 wyniki różniły się o nie więcej niż 2 punkty. | 28 z 40 w granicach 2 punktów | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Ale w ankietach satysfakcji ten związek jest rzeczywisty i silny. W 717 ankietach szpitalnych średni wynik satysfakcji był skorelowany ze wskaźnikiem odpowiedzi na poziomie r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux i Combescure (2020), BMC Health Services Research. |
| Wskaźnik odpowiedzi w ankietach pracowniczych niemal idealnie podąża za wielkością organizacji. W 2024 roku federalna ankieta pracownicza w USA uzyskała 71% w agencjach zatrudniających poniżej 1000 osób i 37% w agencjach zatrudniających ponad 75 000 osób. | 71% wobec 37% | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, ponad 1,6 mln zaproszonych pracowników. |
| Średni wskaźnik odpowiedzi w 1071 opublikowanych ankietach online wyniósł 44,1%. Nie ma jednego normalnego wskaźnika. | 44,1% | A | Wu, Zhao i Fils-Aime (2022), metaanaliza, Computers in Human Behavior Reports. |
| Ankiety internetowe dają wskaźnik odpowiedzi o około 12 punktów procentowych niższy niż inne tryby, w 114 porównaniach eksperymentalnych. | 12 punktów mniej | A | Daikeler, Bosnjak i Lozar Manfreda (2020), metaanaliza, JSSAM. |
| Zmniejszenie marginesu błędu o połowę zwiększa wymaganą próbę mniej więcej czterokrotnie, bo n rośnie proporcjonalnie do 1 przez E do kwadratu. Podwojenie próby z 1000 do 2000 daje około jednego punktu. | około 4x | A | Algebraiczna właściwość wzoru; AAPOR wprost opisuje przypadek 1000 i 2000. |
| Przyjęcie p = 0,5 zamiast znanego p = 0,9 niemal potraja próbę, którą trzeba zebrać: ze 139 do 385. | 139 wobec 385 | A | Bezpośrednie obliczenie. Do odtworzenia w kalkulatorze przez zmianę oczekiwanego wyniku. |
| Wszystkie 87 szablonów ankiet opublikowanych na tej stronie ma 14 pytań lub mniej, a 86 z 87 ma 10 lub mniej. 785 z ich 799 pytań potwierdzono na opublikowanych stronach. | 87 szablonów, 799 pytań | A | Nasze własne zliczenie bieżącego zbioru szablonów z 21 sierpnia 2026 roku, sprawdzone z wszystkimi 87 opublikowanymi stronami. Metodę, ręczny przegląd i odsetek weryfikacji podano przy tabeli. |
| Nie da się ustalić żadnej osoby o nazwisku Slovin stojącej za wzorem, który nosi to nazwisko. Najstarszym możliwym do wskazania źródłem jest Yamane (1967). | autora nie da się ustalić | B | Tejada i Punzalan (2012), The Philippine Statistician; Wolfram MathWorld nazywa go wzorem doraźnym. |
„Zawsze potrzebujesz 385 wypełnień”. Tylko przy poziomie ufności 95%, plus minus 5 punktach, p = 0,5 i dużej populacji. Podana bez tych warunków jest błędna dla każdej małej populacji.
„Przebadaj 10% swojej populacji”. Nie ma to żadnych podstaw statystycznych. Znacznie zawyża próbę w dużych populacjach i zaniża ją w małych.
„Wskaźnik odpowiedzi poniżej 50 lub 60% unieważnia ankietę”. Żaden próg tego nie robi. Drabinka 50, 60 i 70% to podręcznikowa reguła kciuka bez empirycznego uzasadnienia, a metaanaliza Grovesa i Peytchevej jej przeczy. Wskaźnik odpowiedzi wyznacza górną granicę obciążenia w najgorszym przypadku. Nie mierzy rzeczywistego obciążenia.
„Przeciętny wskaźnik odpowiedzi w ankietach wynosi X%”. Zweryfikowane dane z tych samych kilku lat wahają się od 6% do 71%, całkowicie w zależności od tego, kogo się bada. Każda pojedyncza średnia to ukrywa. Zamiast tego zacytuj wiersz z powyższej tabeli, który pasuje do Twojej sytuacji.
Wzór Slovina przedstawiany jako wyprowadzenie. To wzór Cochrana z wbudowanym poziomem ufności 95% i p = 0,5 oraz wartością z zaokrągloną do 2, a przypisanie go Slovinowi nie ma żadnego możliwego do ustalenia źródła.
Szablon uzasadnienia
Większość argumentów dotyczących wielkości próby upada, bo założeń nigdy nie spisano. Przycisk Skopiuj uzasadnienie w kalkulatorze zapisuje je z Twoimi liczbami. Jeśli wolisz złożyć je samodzielnie, oto dziewięć rzeczy, których będzie szukał recenzent.
- Populacja (N): zdefiniuj populację i podaj jej liczebność. Na przykład wszyscy aktywni klienci z ostatnich 90 dni, N = 48 200.
- Co mierzysz: proporcję (odsetek) lub średnią (np. średnią ocenę). Wzór na tej stronie wyznacza wielkość próby dla proporcji, co obejmuje większość raportowanych wskaźników KPI.
- Poziom ufności: wybrany poziom i powód wyboru. Konwencja i tolerancja ryzyka to akceptowalne powody, jeśli je podasz.
- Margines błędu (E): docelowa precyzja ogółem i osobno dla każdej podgrupy, o której obiecano raportować.
- Przyjęta proporcja (p): użyta wartość i jej źródło. Napisz wprost, jeśli wynosi 0,5, bo nie było nic lepszego.
- Korekta dla populacji skończonej: czy ją zastosowano i co o tym zdecydowało, na przykład n0 przekraczające 10% N.
- Docelowa liczba wypełnień (n): ostateczna wymagana liczba wypełnień po wszystkich korektach.
- Oczekiwany wskaźnik odpowiedzi: przyjęty wskaźnik, dane historyczne, z których pochodzi, i wynikająca z niego liczba zaproszeń.
- Jak wybierzesz osoby: prosty dobór losowy, dobór warstwowy, badanie pełne lub dobór wygodny, a także ewentualna nadreprezentacja kluczowych segmentów. Nazwij to uczciwie.
Gdy ankieta trwa, obserwuj liczbę wypełnień w poszczególnych segmentach, a nie tylko sumę. Dobra liczba ogólna może ukrywać segment, który nigdy nie osiągnie celu, a to problem, który w pierwszym tygodniu da się jeszcze naprawić, a w czwartym już nie. Raportując, podawaj przy każdym odsetku jego margines błędu i przeczytaj, jak analizować dane z ankiety, zanim uznasz zmianę o dwa punkty za rzeczywistą.
Arkusz planowania wielkości próby
Jedna strona do wydrukowania, wypełnienia ręcznie i dołączenia do opisu projektu. Wypełnij środkową kolumnę przed rozpoczęciem badania terenowego, a nie po nim. Nic nie jest nigdzie wysyłane i nie potrzebujesz konta.
| Decyzja | Twoja wartość | Wskazówka |
|---|---|---|
| Populacja (N) | Kto dokładnie i ile osób. Zapisz definicję, a nie tylko liczbę. | |
| Co mierzysz | Odsetek lub średnią. Ta strona wyznacza wielkość próby dla odsetków. | |
| Poziom ufności | 95%, chyba że masz powód. Zapisz ten powód. | |
| Margines błędu (E) | Różnica w punktach, którą musisz umieć rozróżnić. | |
| Przyjęta proporcja (p) | 0,5, jeśli nie ma nic lepszego. Podaj, skąd pochodzi inna wartość. | |
| Korekta dla populacji skończonej | Czy ją zastosowano i co o tym zdecydowało. | |
| Docelowa liczba wypełnień (n) | Ostateczna liczba po wszystkich korektach. | |
| Podgrupy raportowane osobno | Ile ich jest i ile wypełnień każda musi dostarczyć osobno. | |
| Oczekiwany wskaźnik odpowiedzi | Wskaźnik i dane historyczne, na których się opiera. Nie liczba z internetu. | |
| Liczba zaproszeń do wysłania | Wypełnienia podzielone przez wskaźnik, zaokrąglone w górę. Nigdy więcej niż N. | |
| Jak wybierane są osoby | Dobór losowy, warstwowy, badanie pełne lub dobór wygodny. Nazwij to uczciwie. | |
| Punkt kontrolny badania terenowego | Data, w której sprawdzisz liczbę wypełnień według segmentów, a nie tylko sumę. |
Wzór: n0 = (z^2 x p x (1 - p)) / E^2, następnie n = n0 / (1 + (n0 - 1) / N). Źródło: Cochran (1977); NIST/SEMATECH e-Handbook, sekcja 3.3.3; Israel (1992). Arkusz ze strony https://www.supersurvey.com/Sample-Size
Najczęściej zadawane pytania
Czym jest wielkość próby?
Wielkość próby to liczba wypełnień w ankiecie, oznaczana jako n. To nie liczba zaproszonych osób ani wielkość opisywanej populacji. To liczba, z którą kończysz badanie terenowe, i to z niej oblicza się margines błędu: 385 wypełnień daje około plus minus 5 punktów przy poziomie ufności 95%, gdy populacja jest duża. Różnicę między populacją, zaproszeniami a n wyjaśnia sekcja Czym jest wielkość próby.
Ilu wypełnień potrzebuję w ankiecie?
W przypadku większości ankiet robocza odpowiedź to 385 wypełnień. Tyle zwraca wzór przy poziomie ufności 95%, marginesie błędu plus minus 5 punktów procentowych i braku wcześniejszego oszacowania wyniku. Jeśli Twoja populacja jest mała, potrzebujesz mniej: 278 dla listy 1000 osób, 80 dla listy 100 osób. Wpisz własne liczby do kalkulatora, aby zobaczyć dokładną wartość i obliczenia.
Jakiej wielkości próby potrzebuję przy poziomie ufności 95% i marginesie błędu 5%?
385 wypełnień, jeśli populacja jest duża i przyjmujesz p = 0,5. Obliczenie to n0 = 1,96 do kwadratu razy 0,5 razy 0,5, podzielone przez 0,05 do kwadratu, czyli 0,9604 podzielone przez 0,0025, co daje 384,16. Po zaokrągleniu w górę otrzymujesz 385. Jeśli Twoja populacja jest mała, zastosuj korektę dla populacji skończonej, a liczba spadnie.
Czym jest margines błędu?
Margines błędu to przedział plus minus wokół wyniku ankiety, wynikający z tego, że do próby wybrano niektóre osoby, a nie wszystkie. Wynik 62% z marginesem błędu 5 punktów oznacza, że metoda w większości przypadków dawałaby przedział zawierający prawdziwą wartość, a ten konkretny przedział wynosi od 57 do 67%. Opisuje wyłącznie losowy błąd próby. Nie mówi nic o osobach, które nigdy nie odpowiedziały.
Jak obliczyć margines błędu?
Oblicz pierwiastek kwadratowy z p razy (1 minus p) podzielonego przez n, a następnie pomnóż go przez wartość z dla Twojego poziomu ufności. Przy poziomie ufności 95%, 385 wypełnieniach i p = 0,5 jest to 1,96 razy pierwiastek z 0,25 podzielonego przez 385, czyli 1,96 razy 0,025482, co daje 0,0499. Margines błędu wynosi więc plus minus 5,0 punktu procentowego. Kalkulator marginesu błędu na tej stronie zrobi to za Ciebie i pokaże obliczenia.
Czy margines błędu rośnie wraz z wielkością próby?
Nie, maleje, i to proporcjonalnie do pierwiastka kwadratowego z wielkości próby. Przejście ze 100 wypełnień do 400 zmniejsza margines błędu o połowę. Przejście z 400 do 1600 zmniejsza go o połowę ponownie. Ta zależność od pierwiastka sprawia, że precyzja jest droga: każde kolejne miejsce po przecinku dokładności kosztuje mniej więcej czterokrotnie więcej wypełnień.
Czy margines błędu to to samo co błąd standardowy?
Nie. Błąd standardowy to podstawowy rozrzut oszacowania. Margines błędu to błąd standardowy pomnożony przez wartość z dla wybranego poziomu ufności. Przy poziomie ufności 95% margines błędu to około 1,96 błędu standardowego. Błąd standardowy jest właściwością danych. Margines błędu to wybór sposobu raportowania nałożony na ten błąd.
Jaka jest dobra wielkość próby w badaniach ilościowych?
Nie ma jednej dobrej liczby, a każde źródło, które ją podaje, nie pytając, co mierzysz, zgaduje. W badaniu, które podaje odsetki z populacji liczącej mniej niż około 10 000 osób, odpowiedzią, której można bronić, jest wartość zwracana przez wzór przy poziomie ufności 95% i marginesie błędu, który potrafisz uzasadnić. Dla listy 1000 osób to 278. Rozdział metodologiczny zostaje zaakceptowany nie dzięki dużej liczbie, lecz dzięki podanej liczbie, obok której zapisano poziom ufności, margines błędu, przyjętą proporcję i populację. Znane wzory, których może oczekiwać Twój promotor, opisuje sekcja Wielkość próby w badaniach ilościowych.
Jaki wskaźnik odpowiedzi w ankiecie jest normalny?
Nie ma jednego normalnego wskaźnika, a każda strona podająca jedną liczbę zgaduje. Rzeczywiste dane ze źródłami z tego samego okresu wahają się od 6% (sondaże telefoniczne Pew w 2018 roku) do 71% (małe amerykańskie agencje federalne w Federal Employee Viewpoint Survey 2024). Metaanaliza 1071 opublikowanych ankiet online wykazała średnią 44,1%. Wielkość organizacji ma ogromne znaczenie: ta sama ankieta federalna uzyskała 71% w agencjach zatrudniających poniżej 1000 osób i 37% w agencjach zatrudniających ponad 75 000 osób. Najpierw korzystaj z własnych danych historycznych, a dane, które można zacytować, znajdziesz w tabeli punktów odniesienia.
Czy wielkość populacji ma znaczenie dla wielkości próby?
Prawie żadnego, dopóki próba nie stanowi dużej części populacji. Przejście ze 100 000 osób do 1 000 000 zmienia wymaganie z 383 na 385. Przejście z 1000 osób do 100 zmienia je z 278 na 80. Wielkość populacji ma znaczenie przy małych populacjach i właśnie tam stosuje się korektę dla populacji skończonej.
Kiedy p = 0,5 to właściwy wybór?
Stosuj p = 0,5 zawsze, gdy nie masz wcześniejszego oszacowania, którego można bronić. Iloczyn p razy (1 minus p) jest największy przy 0,5, więc daje największą wymaganą próbę. To czyni je bezpiecznym założeniem: próba nie okaże się za mała. Jeśli masz badanie pilotażowe, punkt odniesienia lub zeszłoroczną liczbę, wykorzystaj je. Przyjęcie p = 0,9 zamiast 0,5 zmniejsza wymaganą próbę z 385 do 139.
Czy zapraszając więcej osób, wyeliminuję błąd braku odpowiedzi?
Nie. Więcej zaproszeń daje więcej wypełnień, co zmniejsza margines błędu. Obciążenie to osobny problem: zależy od tego, czy osoby, które odpowiedziały, różnią się od tych, które nie odpowiedziały. Metaanaliza 59 badań błędu braku odpowiedzi wykazała tylko niewielki związek między wskaźnikiem odpowiedzi a rzeczywistym obciążeniem. Pew przeprowadziło ten sam kwestionariusz dwukrotnie, przy wskaźniku odpowiedzi 9% i 22%, a w 28 z 40 wspólnych pytań wyniki różniły się o nie więcej niż 2 punkty. Zobacz zniekształcenie odpowiedzi i błąd braku odpowiedzi.
Jak dobrać wielkość próby, jeśli potrzebuję wyników według działów lub regionów?
Dobierz wielkość próby dla każdej podgrupy osobno. Margines błędu dotyczy grupy tylko wtedy, gdy ta grupa ma tyle wypełnień. Jeśli chcesz plus minus 5 punktów dla każdego regionu, każdy region potrzebuje własnych 385 wypełnień lub własnej liczby skorygowanej dla populacji skończonej. Użyj pytań demograficznych, aby rozpoznać grupy, i zaplanuj nadreprezentację małych grup.
Jakiej wielkości próby potrzebuję, aby wynik był istotny statystycznie?
To pytanie łączy dwie idee. Wzory na wielkość próby dobierają liczebność oszacowania do wybranej precyzji. Testowanie istotności porównuje dwie liczby i pyta, czy różnica między nimi może być dziełem przypadku. Potrzebna wielkość zależy od tego, jak małą różnicę chcesz móc wykryć, a nie od stałego progu. Dobierz wielkość ankiety tutaj, a zanim porównasz jeden wynik z drugim, przeczytaj o istotności statystycznej.
Czy te wzory działają w badaniach jakościowych?
Nie. Wywiadów, grup fokusowych i pytań otwartych nie projektuje się pod margines błędu, bo nie szacują one odsetka w populacji. Liczebność próby w badaniach jakościowych uzasadnia się nasyceniem, czyli momentem, w którym nowi uczestnicy przestają wnosić nowe wątki, i opisuje się ją jako ocenę popartą dowodami, a nie jako wynik wzoru. Nie przepuszczaj badania jakościowego przez ten kalkulator.
Bibliografia
- National Institute of Standards and Technology (NIST). (b.d.). Selecting Sample Sizes. W: NIST/SEMATECH e-Handbook of Statistical Methods, sekcja 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.