
Объём выборки опроса — это число заполненных ответов, включённых в анализ; обозначается n. Он отличается от числа приглашений или людей в Вашем списке. При допущениях калькулятора о выборке более крупная выборка сужает погрешность, но не устраняет смещённое привлечение участников или неудачно сформулированные вопросы.
Калькулятор объёма выборки
Ничего не скрыто за регистрацией и никуда не отправляется. Калькулятор работает в Вашем браузере, сразу показывает готовый пример ответа и выводит формулу и расчёты, чтобы Вы могли их проверить или повторить вручную.
Сколько ответов мне нужно?
Задайте шесть исходных значений. Ответ, формула и расчёты обновляются по мере ввода.
Нужно заполненных ответов
370
С поправкой на конечную генеральную совокупность.
Сколько пригласить
1,234
При доле ответивших 30 процентов.
Доля выборки
3.7%
Доля генеральной совокупности, от которой нужно получить ответ.
Итого с расчётом на каждую подгруппу
370
Расчёт по шагам
| Погрешность | Нужно ответов | Нужно приглашений |
|---|
Цена точности растёт примерно как квадрат её улучшения. Если уменьшить погрешность вдвое, выборка увеличится примерно в четыре раза.
Кнопка копирования создаёт короткий абзац для раздела о методах с Вашими цифрами, формулой и ссылкой на источник — его можно вставить в описание проекта или в главу о методологии.
Как цитировать этот калькулятор: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Результат — это заполненные ответы, а не приглашения. Это число ответов, которое должно быть у Вас на руках в конце полевого этапа. Число приглашений — это число заполненных ответов, делённое на ожидаемую долю ответивших, и именно здесь ошибается большинство планов выборки. Когда цель задана, создайте свой опрос и проведите пилотажное исследование с целевой аудиторией. С его помощью проверьте формулировки и оцените, какая доля приглашённых заполняет опрос в Вашем собственном проекте.
Что такое объём выборки
Объём выборки — это число людей, которые заполнили Ваш опрос. Во всех формулах на этой странице он обозначается n; это единственная величина, которую Вы покупаете полевой работой, а не выбираете на бумаге, и именно по ней рассчитывается Ваша погрешность.
С ним путают три числа, и различать их — основная задача плана выборки:
- Генеральная совокупность (N): все, кого Вы хотите описать. Список клиентов, численность персонала, страна.
- Приглашения: сколько людей Вы приглашаете. Их всегда больше, чем n, потому что отвечают не все.
- Объём выборки (n): сколько заполненных ответов у Вас на руках по окончании полевого этапа. Именно это число рассчитывает формула, и только оно из трёх влияет на погрешность.
Объём выборки покупает точность — ширину диапазона «плюс-минус» вокруг каждого результата. Он не покупает достоверность — то, насколько ответившие похожи на тех, кто не ответил. Большая удобная выборка может оказаться дальше от истины, чем маленькая случайная, и никакое значение n этого не исправит. Разница описана в разделе где планирование объёма выборки даёт сбой, а решает её то, как Вы формируете выборку.
Кратко, если Вам нужно просто число
Ключевые цифры
- 385 заполненных ответов — ответ по умолчанию. Столько выдаёт формула при доверительной вероятности 95 процентов, погрешности плюс-минус 5 процентных пунктов и без предварительной оценки результата.
- Малым генеральным совокупностям нужно гораздо меньше. Для списка из 1000 человек нужно 278. Для списка из 100 — 80. Это работает поправка на конечную генеральную совокупность.
- Точность дорога. Если уменьшить погрешность вдвое, выборка увеличится примерно в четыре раза. Переход от плюс-минус 5 пунктов к плюс-минус 1 пункту увеличивает выборку с 385 до 9604.
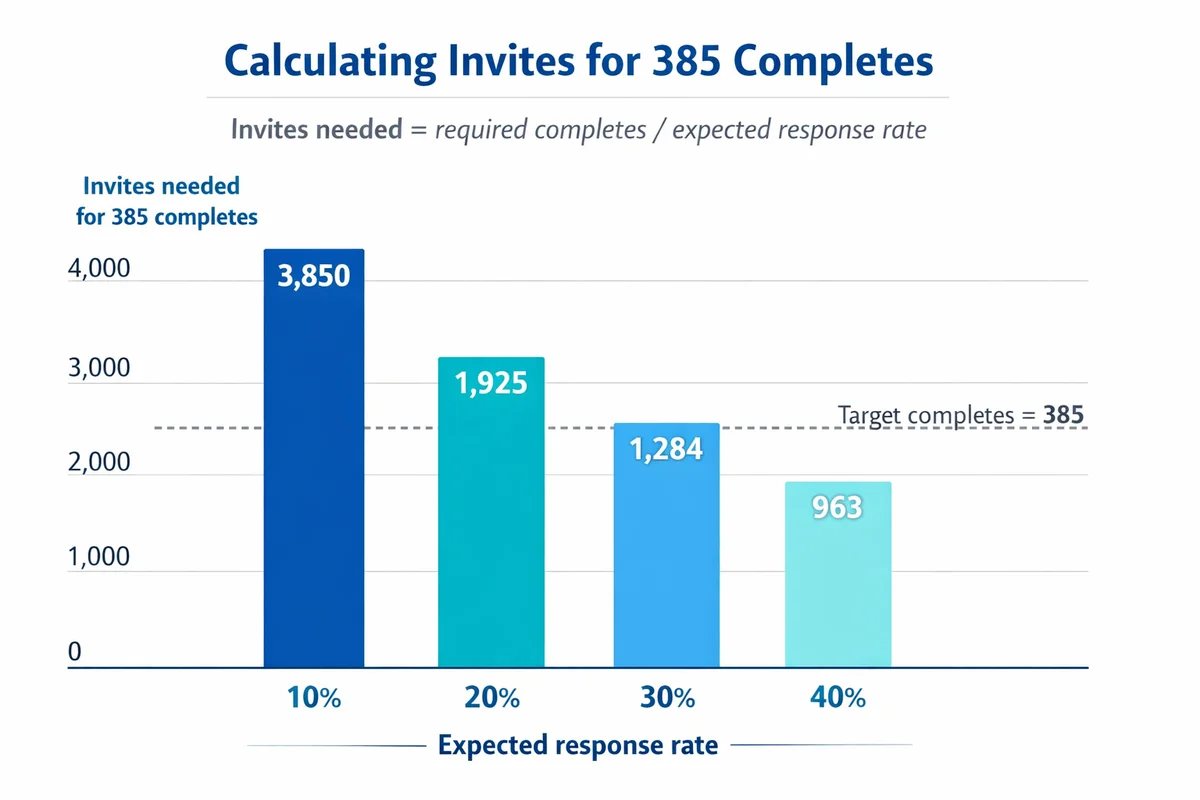
- Формулы считают заполненные ответы, а не приглашения. Нужное число приглашений равно числу заполненных ответов, делённому на ожидаемую долю ответивших. При 30 процентах для 385 заполненных ответов нужно пригласить 1284 человека.
- Погрешность охватывает только один вид ошибки. Она измеряет шум от того, что опрошены некоторые люди, а не все. О тех, кто так и не ответил, она ничего не говорит.
Формула объёма выборки и как посчитать вручную
Для опроса, результатом которого является процент, стандартная отправная точка — объём выборки для генеральной совокупности, настолько большой, что её можно считать неограниченной:
n0 = (z^2 x p x (1 - p)) / E^2
Читаем слева направо:
- n0 — необходимое число заполненных ответов до какой-либо поправки на генеральную совокупность.
- z — z-значение для Вашей доверительной вероятности. Для 95 процентов используйте 1,96.
- p — ожидаемая доля, которую Вы измеряете, в виде десятичной дроби. Если не знаете, используйте 0,5.
- E — погрешность в виде десятичной дроби. Пять процентных пунктов — это 0,05.
Объём выборки обозначается символом n. В некоторых источниках нескорректированное значение обозначают n0, а скорректированное — n; здесь используется именно это обозначение.
| Доверительная вероятность | z | Чего это стоит |
|---|---|---|
| 80 процентов | 1.282 | 165 заполненных ответов при плюс-минус 5 пунктах |
| 90 процентов | 1.645 | 271 заполненный ответ |
| 95 процентов (норма) | 1.960 | 385 заполненных ответов |
| 99 процентов | 2.576 | 664 заполненных ответа |
| 99,9 процента | 3.291 | 1084 заполненных ответа |
Разобранный пример: от 385 к списку приглашений
Сценарий. Вы хотите узнать процент клиентов, которые порекомендовали бы Вас. Вам нужны доверительная вероятность 95 процентов и плюс-минус 5 пунктов. Предварительной оценки нет, поэтому p = 0,5.
Выберите доверительную вероятность и погрешность
Доверительная вероятность 95 процентов задаёт z = 1,96. Плюс-минус 5 процентных пунктов — это E = 0,05.
Выберите ожидаемый результат
p = 0,5, потому что предварительной оценки нет, а 0,5 даёт наибольшую выборку. Ничто из того, что Вы узнаете позже, не оставит Вас с нехваткой ответов.
Примените формулу объёма выборки
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Округлите вверх: 385 заполненных ответов. Всегда округляйте вверх. Нельзя собрать дробную часть анкеты.
Сделайте поправку на малую генеральную совокупность
Если эти клиенты — список из 1000 человек, а не открытый рынок, примените поправку: n = 384,16 / (1 + 383,16 / 1000) = 384,16 / 1,38316 = 277,7, то есть 278 заполненных ответов. Поправка начинает играть роль, только когда выборка составляет большую долю генеральной совокупности.
Переведите заполненные ответы в приглашения
При доле ответивших 30 процентов число приглашений = 278 / 0,30 = 926,7, поэтому пригласите 927 человек. Формула рассчитывает заполненные ответы. Приглашения — это то, что Вы фактически отправляете, и их не может быть больше, чем людей в генеральной совокупности, из которой Вы отбираете.
При доверительной вероятности 95 процентов и p = 0,5 вся формула сводится к 0,9604, делённому на E в квадрате. Это единственное сокращение отвечает на большинство вопросов об объёме выборки одной строкой, и именно поэтому число 385 постоянно встречается в таблицах объёма выборки, которые можно найти в других источниках.
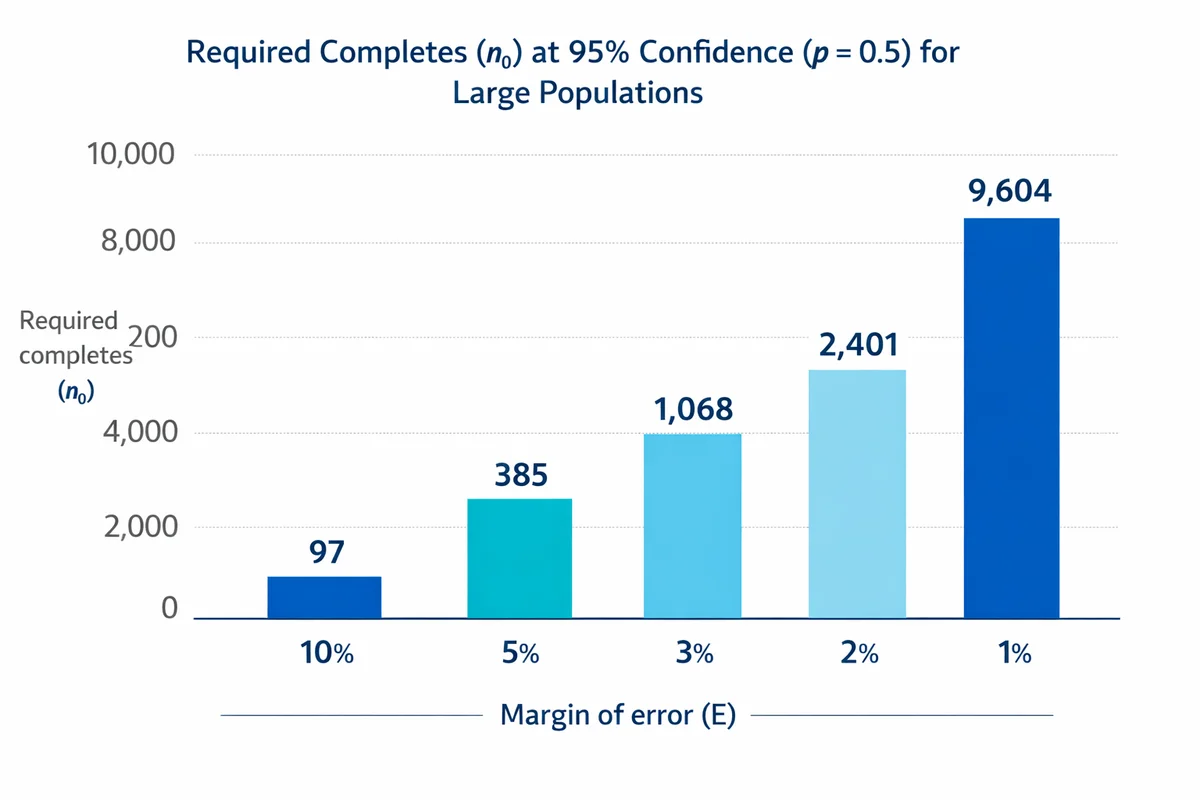
Таблица объёма выборки для типичных размеров генеральной совокупности
Эти цифры рассчитаны по формуле выше при доверительной вероятности 95 процентов, плюс-минус 5 пунктах и p = 0,5, а затем скорректированы на генеральную совокупность. Последние два столбца — наша собственная сверка с таблицей, опубликованной Krejcie и Morgan в 1970 году, — именно её цитирует большинство глав о методах.
| Генеральная совокупность (N) | Нужно ответов | Krejcie и Morgan (1970) | Разница |
|---|---|---|---|
| 10 | 10 | 10 | совпадает |
| 25 | 24 | нет в таблице | |
| 50 | 45 | 44 | на 1 больше |
| 100 | 80 | 80 | совпадает |
| 200 | 132 | 132 | совпадает |
| 500 | 218 | 217 | на 1 больше |
| 1,000 | 278 | 278 | совпадает |
| 2,000 | 323 | 322 | на 1 больше |
| 5,000 | 357 | 357 | совпадает |
| 10,000 | 370 | 370 | совпадает |
| 50,000 | 382 | 381 | на 1 больше |
| 100,000 | 383 | 384 | на 1 меньше |
Как мы это проверили. Мы рассчитали формулу для 21 размера генеральной совокупности и сравнили каждый результат с опубликованным значением Krejcie и Morgan. Двенадцать совпали точно. Остальные девять отличались ровно на один ответ — из-за того, на каком шаге каждый метод округляет, а не из-за разногласий в арифметике. Если научный руководитель спросит, почему Ваше число отличается от таблицы на единицу, причина именно в этом.
Полезно знать, если Вы цитируете эту таблицу: Krejcie и Morgan не выводили собственную формулу. Их статья 1970 года — это около 400 слов и одна таблица, а единственная ссылка в ней приписывает формулу исследовательскому бюллетеню National Education Association 1960 года. Их собственное краткое описание закономерности по-прежнему лучше всего описывает её одной строкой: по мере роста генеральной совокупности необходимая выборка увеличивается всё медленнее и останавливается на уровне чуть более 380 случаев.
Выбор исходных данных по одному
Ответ определяют четыре числа. Три из них — решения, а не факты, и для каждого есть обоснованный способ выбора.
Доверительная вероятность: как часто метод оказывается прав
Доверительная вероятность описывает метод, а не этот конкретный опрос. При доверительной вероятности 95 процентов интервалы, построенные таким способом, в долгосрочной перспективе содержат истинное значение в 95 случаях из 100. Это не 95-процентная вероятность того, что Ваш конкретный ответ верен.
Используйте 95 процентов, если нет причин поступить иначе. Переход к 99 процентам увеличивает выборку с 385 до 664 при той же точности — это рост затрат на 72 процента ради очень небольшого выигрыша. Родственное понятие при проверке гипотез — альфа, поэтому их и путают. Если это различие Вам не до конца ясно, прочитайте материал о статистической значимости и о том, что означают p-значения, прежде чем выбирать число.
Погрешность: параметр, от которого зависит решение
Над ней стоит подумать больше всего, потому что это единственный параметр, связывающий выборку с решением. Выбирайте её, спросив себя, какая разница изменила бы Ваши действия.
Если Вы поступите по-разному при удовлетворённости 72 процента и 74 процента, нужна узкая погрешность. Если Вы действуете только при разнице между 72 и 82, плюс-минус 5 пунктов более чем достаточно. Общая сводная отчётность обычно останавливается на 5 пунктах для разового замера или на 3 пунктах для мониторинга. Ниже 2 пунктов затраты быстро растут.
Размер генеральной совокупности: в основном неважен, пока не станет важен
Для больших генеральных совокупностей необходимая выборка почти не меняется. Десяти тысячам человек нужно 370 ответов. Ста тысячам — 383. Размер генеральной совокупности начинает играть роль, только когда Ваша выборка составляет заметную её долю, — так бывает со списками сотрудников, реестрами членов организаций и школьными потоками. Этим занимается следующий раздел.
Ожидаемый результат (p): если не знаете, используйте 0,5
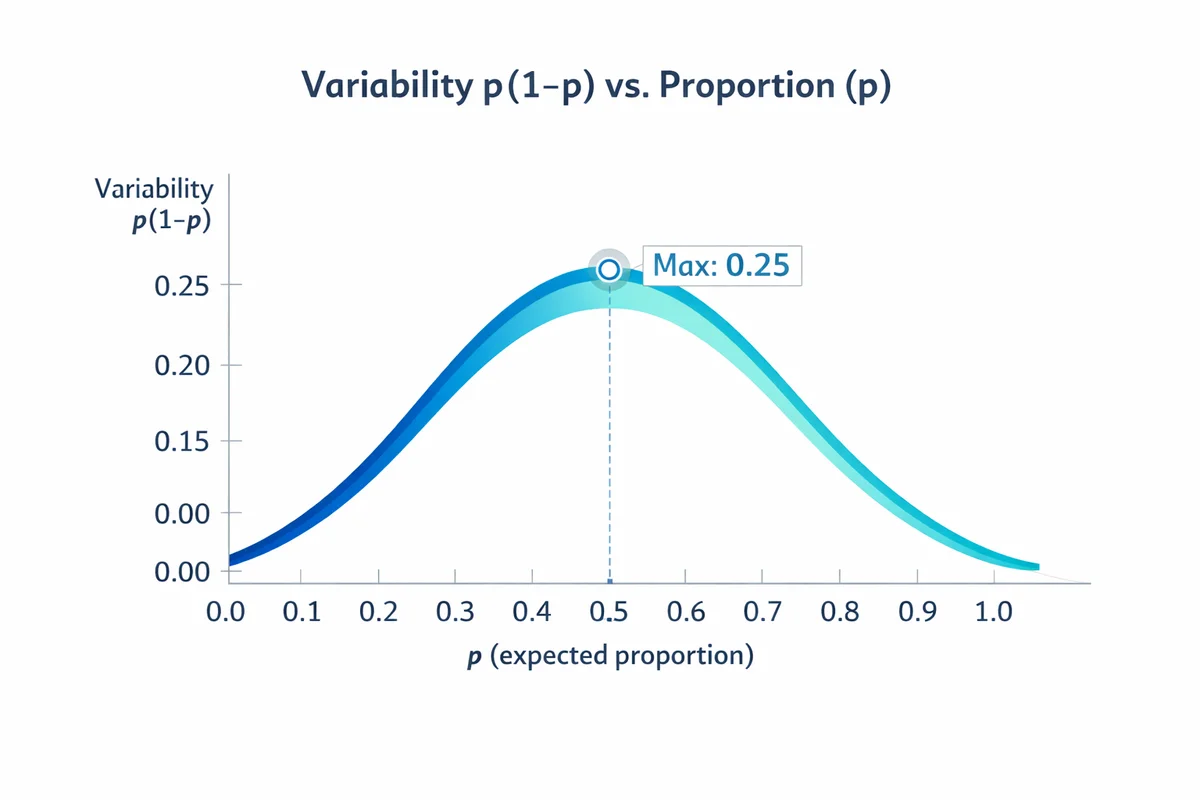
Для вопроса, результат которого — процент, неопределённость определяется произведением p на (1 минус p). Этот член максимален при p = 0,5, поэтому 0,5 — консервативный выбор, дающий наибольшую выборку. Это правильное значение по умолчанию, когда предварительной оценки нет.
Если оценка есть, используйте её, потому что экономия велика. При доверительной вероятности 95 процентов и плюс-минус 5 пунктах p = 0,5 требует 385 ответов, а p = 0,9 — 139. Прошлые опросы, пилотажное исследование или опубликованный эталон — всё это допустимые источники такой оценки. Нечёткие вопросы тоже увеличивают разброс, поэтому более ясные формулировки могут стабилизировать результат без дополнительных ответов. Составить вопросы лучше часто дешевле, чем собрать больше ответов.
Малые генеральные совокупности: поправка на конечную генеральную совокупность
Базовая формула предполагает, что Вы отбираете из настолько большого резервуара, что изъятие людей из него ничего не меняет. Как только Ваша выборка становится реальной частью генеральной совокупности, это допущение заставляет Вас переплачивать. Поправка на конечную генеральную совокупность возвращает лишние ответы.
n = n0 / (1 + ((n0 - 1) / N))
- n — скорректированное число заполненных ответов, которое Вам нужно.
- n0 — нескорректированное значение из формулы выше.
- N — размер генеральной совокупности.
Обычно поправку применяют, когда n0 превышает примерно 5 процентов от N. Ниже этого порога поправка почти ничего не меняет, и объяснять её никому не стоит.
Разобранный пример: опрос сотрудников
Сценарий. У Вас 1200 сотрудников. Вам нужны доверительная вероятность 95 процентов и плюс-минус 5 пунктов, и Вы используете p = 0,5.
- Без поправки n0 = 384,16.
- С поправкой: n = 384,16 / (1 + (383,16 / 1200)) = 384,16 / 1,3193 = 291,2.
- Округлите вверх: 292 заполненных ответа.
Без поправки Вы добивались бы 385 ответов от списка из 1200 человек, то есть от 32 процентов всех. С поправкой 292 ответа дают ту же точность. Для списка такого размера это месяц напоминаний, которые не придётся рассылать.
Когда людей меньше примерно 200, скорректированная выборка составляет такую большую долю списка, что пригласить всех проще и обоснованнее. Сплошное обследование 150 человек вообще не имеет выборочной ошибки. Тогда усилия направляются на долю ответивших и на то, кого не хватает, — туда, где им и место.
Погрешность: та же формула, только в обратную сторону
Погрешность — это диапазон «плюс-минус» вокруг результата опроса, возникающий из-за того, что опрошены некоторые люди, а не все. Если 62 процента из 385 участников выбрали вариант, а погрешность составляет 5 пунктов, Вы сообщаете 62 процента и указываете, что правдоподобный диапазон — от 57 до 67 процентов.
Если преобразовать формулу объёма выборки и выразить E, получим:
E = z x квадратный корень из (p x (1 - p) / n)
Для конечной генеральной совокупности умножьте это на квадратный корень из (N - n), делённого на (N - 1). Обе версии есть в калькуляторе ниже, который переключается автоматически, когда Вы ставите или снимаете флажок генеральной совокупности.
Какова погрешность для уже полученных ответов?
Та же формула, только преобразованная. Введите собранные ответы и получите точность.
Погрешность
5.0
Процентные пункты, плюс-минус.
Ваш интервал
от 45,0 до 55,0
Проценты, при доверительной вероятности 95 процентов.
Расчёт по шагам
Увеличивается ли погрешность с ростом объёма выборки?
Она уменьшается, причём пропорционально квадратному корню из n. Этот квадратный корень — вся экономика опросов. Четыреста ответов дают вдвое меньшую ошибку, чем сто. Чтобы уменьшить её вдвое ещё раз, нужно 1600. Каждый следующий знак после запятой в точности стоит примерно в четыре раза больше полевой работы, поэтому 385 — такая частая точка остановки: здесь стоимость и точность перестают спорить.
Четыре термина, которые путают
Стандартную ошибку, погрешность, доверительную вероятность и доверительный интервал употребляют так, будто они взаимозаменяемы. Это четыре разные вещи, и разница важна, когда кто-то ставит Вашу цифру под сомнение.
| Термин | Что это | При 385 ответах и 50 процентах |
|---|---|---|
| Стандартная ошибка | Исходный разброс оценки. Квадратный корень из произведения p на (1 минус p), делённого на n. | 0,0255, или 2,55 процентного пункта |
| Погрешность | Стандартная ошибка, умноженная на z-значение для выбранной Вами доверительной вероятности. | Плюс-минус 5,0 пункта при 95 процентах |
| Доверительная вероятность | Выбранное Вами z-значение, выраженное в процентах. Это выбор, а не измерение. | 95 процентов, поэтому z = 1,96 |
| Доверительный интервал | Результат с учётом погрешности, записанный как диапазон. | От 45,0 процента до 55,0 процента |
Коротко: стандартная ошибка — свойство Ваших данных, доверительная вероятность — Ваш выбор, погрешность — их произведение, а доверительный интервал — то, что Вы печатаете в отчёте.
Чего погрешность не охватывает
Она охватывает случайную ошибку выборки и ничего больше. Она не учитывает людей, проигнорировавших приглашение, список, в котором не хватало части генеральной совокупности, или вопрос, который половина участников поняла не так, как Вы задумали. Опрос может иметь аккуратную погрешность и всё равно ошибаться. Об ошибках, которые не исправит никакой объём выборки, см. смещение ответов и смещение из-за неответов.
Профессиональная ассоциация исследователей опросов говорит об этом прямее, чем большинство поставщиков. AAPOR утверждает, что измеримой общей погрешности опроса не существует, потому что опросы несут и другие ошибки, которые вообще невозможно измерить, — от того, как были сформулированы вопросы, до того, как проводились интервью. Рассчитать можно лишь выборочную часть. Именно её даёт калькулятор, и стоит ясно понимать, что это лишь часть.
Два правила употребления из того же источника, которые нарушает большинство текстов об опросах:
- Это процентные пункты, а не проценты. Пишите «плюс-минус 3 процентных пункта», а не «плюс-минус 3 процента». Это разные вещи.
- К выборкам с добровольным участием она вообще неприменима. Погрешность предполагает, что у каждого человека был известный ненулевой шанс быть отобранным. Открытая ссылка, панель добровольцев или публикация в социальных сетях этому не соответствуют. Публиковать погрешность рядом с результатами по открытой ссылке — значит заявлять точность, за которую Вы не заплатили.
Как перевести заполненные ответы в приглашения
Формула даёт Вам заполненные ответы. Полевой этап даёт долю ответивших. Именно в разрыве между ними обычно и проваливаются планы выборки, а расчёт занимает одну строку:
Приглашения = необходимые заполненные ответы / ожидаемая доля ответивших
Используйте долю в виде десятичной дроби — 30 процентов это 0,30 — и округляйте вверх. Для 292 заполненных ответов при 35 процентах это 292, делённое на 0,35 = 834,3, поэтому пригласите не менее 835 человек.
| Нужно ответов | Ожидаемая доля ответивших | Приглашения |
|---|---|---|
| 385 | 60 процентов | 642 |
| 385 | 30 процентов | 1,284 |
| 385 | 15 процентов | 2,567 |
| 292 | 50 процентов | 584 |
| 292 | 35 процентов | 835 |
| 292 | 20 процентов | 1,460 |
Как выбрать долю ответивших, которую можно обосновать
Ваш собственный опыт лучше любого опубликованного эталона, если это та же аудитория, тот же канал и опрос похожей длины. Если опереться не на что, спланируйте три сценария — 20, 30 и 40 процентов — и используйте список приглашений как регулируемый рычаг во время полевого этапа. Напоминания, более длинный срок и более широкий список можно изменить по ходу. Цель по заполненным ответам — нет.
Большинство таблиц эталонов в интернете приводят одно среднее значение без источника. Единого среднего не существует. Вот что на самом деле сообщают первоисточники, чтобы Вы могли сослаться на строку, соответствующую Вашей ситуации, а не на чью-то выдуманную цифру.
| Условия | Доля ответивших | Масштаб и источник |
|---|---|---|
| Федеральные ведомства США с численностью персонала до 1000 человек | 71 процент | Federal Employee Viewpoint Survey 2024 года (OPM) |
| Федеральные ведомства США с численностью персонала от 1000 до 9999 человек | 60 процентов | Тот же опрос, тот же год (OPM) |
| Федеральные ведомства США с численностью персонала более 75 000 человек | 37 процентов | Тот же опрос, тот же год (OPM) |
| Все федеральные служащие США | 41 процент | Приглашено более 1,6 миллиона, ответили более 674 000, 2024 год (OPM) |
| Опубликованные онлайн-опросы, все виды | 44,1 процента в среднем | Метаанализ 1071 опубликованного значения (Wu и соавт., 2022) |
| Опубликованные организационные исследования | 68 процентов в 2020 году против 48 процентов в 2005 году | 1014 опросов в 17 журналах (Holtom и соавт., 2022) |
| Телефонные опросы населения | 6 процентов в 2018 году против 36 процентов в 1997 году | Собственные данные Pew Research Center (Kennedy и Hartig, 2019) |
| Веб-опрос по сравнению с любым другим способом | примерно на 12 пунктов ниже | Метаанализ 114 экспериментальных сравнений (Daikeler и соавт., 2020) |
Из этой таблицы следуют два вывода. Во-первых, размер опрашиваемой группы предсказывает долю ответивших лучше почти всего остального, что Вы контролируете. Компания на 300 человек и ведомство на 300 000 человек проводят не один и тот же опрос. Во-вторых, широко повторяемое утверждение о том, что доля ответивших повсеместно обваливается, верно лишь в некоторых местах. Телефонные опросы действительно обвалились. Опубликованные организационные исследования пошли в обратную сторону — от 48 процентов к 68 процентам за пятнадцать лет.
Ещё один полезный приём планирования: стандартная практическая рекомендация — добавить к списку приглашений около 10 процентов на людей, с которыми просто не удастся связаться, и около 30 процентов на тех, кто мог бы ответить, но не ответит.
Что говорит о длине наша собственная коллекция шаблонов
Доля ответивших, заимствованная из чужого опроса, плохо переносится, а длина — одна из немногих вещей в этом списке, которые Вы полностью контролируете. Вот цифра, которую можем получить мы, но не конкурент, потому что она получена подсчётом нашей собственной опубликованной коллекции, а не опросом практиков о том, что они, по их мнению, делают.
В нашем аудите от 21 августа 2026 года все 87 шаблонов опросов содержали не более 14 вопросов, а 86 — не более 10 вопросов. Всего в них было 799 вопросов. Медиана составляла 9 вопросов, и ровно один шаблон превышал 10. Эти цифры описывают снимок на указанную дату, а не текущую библиотеку.
| Вопросов в шаблоне | Шаблонов | Доля коллекции |
|---|---|---|
| 7 вопросов | 4 | 5 процентов |
| 8 вопросов | 17 | 20 процентов |
| 9 вопросов | 29 | 33 процента |
| 10 вопросов | 36 | 41 процент |
| 14 вопросов | 1 | 1 процент |
По формату ответа 355 из 799 вопросов — шкалы оценки, 281 — списки с одним вариантом ответа, а 163 просят участника что-то ввести. Именно последняя группа стоит Вам заполненных анкет, поэтому мы прочитали её вручную, а не доверились сохранённому полю. Из 163 вопросов 137 — многострочные поля для комментариев. Остальные 26 — однострочные поля, и при чтении выяснилось, что 22 из них — короткие поля идентификации или классификации: имя, адрес электронной почты, дата, отдел, должность. Лишь 4 — содержательные короткие ответы. Поэтому честное число действительно открытых вопросов — 141, или примерно один вопрос из шести, а не один из пяти, как показало бы исходное поле.
Как мы считали и как проверяли. Мы разобрали сохранённый список вопросов каждого шаблона опроса, опубликованного на этом сайте на 21 августа 2026 года, оставили записи с текстом вопроса, затем загрузили каждую опубликованную страницу и сравнили два набора, а не стали доверять одной лишь собственной базе данных. Все 87 страниц вернули HTTP 200, а адрес, который заведомо не работает, в том же прогоне вернул 410, так что проверка действительно различала результаты, а не показывала везде зелёный свет. 785 из 799 вопросов, или 98 процентов, присутствуют на опубликованной странице. Шесть из этих совпадений отличаются от базы данных лишь используемым символом апострофа, и мы засчитали их как совпадения — об этом мы предпочитаем сказать прямо, а не тихо округлить. Восемьдесят шесть из 87 шаблонов полностью прошли проверку. Не прошёл наш самый длинный шаблон из 14 вопросов: его опубликованная страница сейчас вообще не показывает вопросы для предпросмотра, поэтому подтвердить его вопросы извне было невозможно.
Длина шаблона ничего не говорит о доле ответивших на приглашение. Наш отдельный эталонный анализ ответов на опросы изучает поведение людей после того, как они начали взаимодействовать с опросом; он не учитывает всех приглашённых. Для планирования приглашений используйте задокументированную долю из сопоставимого проекта или пилотажного исследования и сохраняйте один и тот же знаменатель.
Практическое применение узкое, но реальное. Если Вы заимствуете долю ответивших для расчёта числа приглашений в калькуляторе, берите её из опроса примерно той же длины, что и Ваш, проведённого среди похожей аудитории по похожему каналу. Наши собственные опубликованные инструменты содержат от 7 до 10 вопросов — это короче, чем большинство первоначальных черновиков.
Больше приглашений не означает меньше смещения
Низкая доля ответивших создаёт две проблемы, которые выглядят как одна. Первая — Вы не добираете до цели, поэтому погрешность оказывается шире запланированной. Вторая — ответившие могут отличаться от не ответивших так, что это влияет на Ваш результат.
Приглашение большего числа людей решает первую проблему. Вторую оно надёжно не решает. Groves и Peytcheva объединили 59 исследований, в которых фактическое смещение из-за неответов измерялось относительно известной истины, и обнаружили лишь слабую связь между долей ответивших в опросе и тем, насколько смещённым он оказался. Pew проверил ту же идею напрямую: одну и ту же анкету провели дважды — один раз стандартными методами с долей ответивших 9 процентов и один раз по протоколу с повышенными усилиями с долей 22 процента. Из 40 общих для двух опросов вопросов 28 дали результаты, расходящиеся не более чем на 2 пункта.
Честный контрпример. Этот вывод не распространяется на все темы, и стоит знать, где он перестаёт работать. В опросах удовлетворённости связь реальна и велика. Исследование 717 опросов удовлетворённости пациентов в 164 швейцарских больницах показало, что средний балл удовлетворённости и доля ответивших коррелируют с r = 0,61, потому что отвечают восхищённые и разгневанные, а колеблющаяся середина — нет. Если Вы проводите опросы CSAT или NPS, рост доли ответивших сам по себе может сдвинуть Ваш показатель, а низкая доля, вероятно, приукрашивает картину.
Итак: добивайтесь высокой доли ответивших, когда измеряете, как люди к Вам относятся. Не считайте её сертификатом достоверности, когда измеряете что-либо другое.
Объём выборки для количественного исследования: что нужно для главы о методах
Единого хорошего объёма выборки для количественного исследования не существует, и любой источник, который называет его, не спросив, что Вы измеряете, гадает. Главу о методах одобряют не за большое число. Её одобряют за заявленное число, рядом с которым указаны доверительная вероятность, погрешность, предполагаемая доля и генеральная совокупность, и за ссылку на названную формулу.
Научные руководители обычно ожидают один из четырёх названных подходов. В основном они согласуются друг с другом, и стоит знать, какой именно от Вас требуют.
| Подход | Что он требует от Вас | Результат для N = 1000 при 95 процентах и 5 пунктах | Когда использовать |
|---|---|---|---|
| Cochran (1977) | z, p, E, затем поправка на конечную генеральную совокупность, если она мала | 278 | По умолчанию. Это формула на этой странице, и из неё выведены остальные. |
| Krejcie и Morgan (1970) | Ничего. Ответ берётся из опубликованной таблицы по размеру генеральной совокупности. | 278 | Вам нужна таблица, на которую можно сослаться, а не расчёт. Это формула Cochran при фиксированных параметрах. |
| Yamane (1967), часто называемая формулой Slovin | Только N и погрешность | 286 | Только когда p действительно неизвестно и Вас устраивает жёстко заданная доверительная вероятность 95 процентов. См. предостережение ниже. |
| Анализ мощности | Размер эффекта, мощность, альфа и тест, который Вы будете применять | Полностью зависит от размера эффекта | Вы проверяете гипотезу, а не оцениваете процент. Используйте G*Power или OpenEpi, а не эту страницу. |
Cochran и почему всё остальное — его сокращения
Формула Cochran — та, что приведена в начале этой страницы: n0 = z в квадрате, умноженное на p и на (1 минус p) и делённое на E в квадрате, а затем, если генеральная совокупность мала, поправка на конечную генеральную совокупность. Другие названные методы фиксируют часть этих параметров, чтобы сократить расчёт. Когда Вы это знаете, семейство перестаёт выглядеть как четыре конкурирующих правила и начинает выглядеть как одно правило с тремя предустановками.
Yamane и Slovin: применяйте осознанно
Формула n = N / (1 + N x e^2) встречается в тысячах диссертаций и обычно приписывается Slovin. Она быстрая: для N = 1000 и e = 0,05 она даёт 286.
Прежде чем на неё ссылаться, стоит знать три вещи.
- Это формула Cochran с намертво заваренными настройками. Если проследить в обратную сторону, это формула для доли с p, зафиксированным на 0,5, доверительной вероятностью, зафиксированной на 95 процентах, и z, округлённым с 1,96 до 2. Она не может ответить на вопрос при любой другой доверительной вероятности и вообще не имеет параметра для изменчивости Вашей генеральной совокупности. Две генеральные совокупности одного размера, но с совершенно разным разбросом получают один и тот же ответ, что не может быть верным.
- Из-за этого округления её цифры завышены. При z = 2 потолок формулы для неограниченной генеральной совокупности равен ровно 1, делённой на e в квадрате, то есть 400. Потолок Cochran — 384,16, потому что 1,96 в квадрате — это 3,8416, а не 4. Именно поэтому каждое значение Yamane в таблице выше на несколько процентов больше значения Cochran. Если Вы когда-нибудь задумывались, почему два учебника дают два разных объёма выборки для одного и того же исследования, обычно ответ именно в этом.
- Авторство не подтверждается. Статистический журнал проследил историю формулы и пришёл к выводу, что за ней невозможно найти человека по имени Slovin, а самый старый прослеживаемый источник — учебник Taro Yamane 1967 года. Wolfram MathWorld называет её эмпирической формулой, лишённой математической строгости. Если Ваша кафедра её ожидает, используйте её и ссылайтесь на Yamane, а не на Slovin. Если у Вас есть выбор, используйте Cochran, потому что эта формула выдерживает вопрос о том, откуда взялись 95 процентов.
Эмпирические правила с честной оценкой
Они широко распространены. Одни полезны, другие — фольклор, и полезно знать, какие есть какие.
- Не менее 30 на группу. Разумно как нижняя граница для сравнения групп, но не как цель. Это правило происходит из того, когда выборочные распределения начинают вести себя предсказуемо, а не из какого-либо требования к точности.
- Десять наблюдений на переменную в регрессии. Рабочая эвристика, широко используемая и широко критикуемая. Называйте её эвристикой, никогда — правилом.
- Десять процентов генеральной совокупности. Это просто неверно, и таблица выше показывает почему. Десять процентов от 100 000 — это 10 000 ответов, тогда как 383 дают ту же точность.
- Всегда 385. Верно только для большой генеральной совокупности при 95 процентах и 5 пунктах. Приводите это число вместе с этими условиями, иначе оно ничего не значит.
- Малое n для исследований юзабилити и продуктов. Nielsen Norman Group публикует честную версию этого правила: 40 участников дают показатель «да или нет» с точностью плюс-минус 15 пунктов при доверительной вероятности 95 процентов, а 47 — среднее значение с той же точностью. Эти числа малы, потому что заявленная точность невысока. Назовите точность вслух — и малые выборки перестанут быть поводом для смущения.
Если Ваше исследование сравнивает группы, а не оценивает один процент, объём выборки становится вопросом мощности, и этот калькулятор не подходит. Вам нужен размер эффекта, который Вы готовы обосновать, а также альфа и мощность. G*Power и OpenEpi — бесплатные инструменты, которых ожидает большинство научных руководителей, и оба бесплатны. Честно сказать, где возможности инструмента заканчиваются, полезнее, чем делать вид, будто он умеет всё.
Качественные исследования рассчитываются иначе
Объём интервью и фокус-групп не рассчитывают через погрешность, потому что они не оценивают процент в генеральной совокупности. Обычный аргумент — насыщение: Вы продолжаете, пока новые участники не перестанут давать новые темы, а затем указываете, когда это произошло и как Вы это оценили. Если прогнать качественное исследование через этот калькулятор, получится число, которое выглядит точным и ничего не значит.
Если нужны результаты по подгруппам, рассчитывайте объём для подгруппы
От большинства опросов требуют отчётности по регионам, должностям, стажу или продуктовым линейкам. Именно здесь планы выборки незаметно ломаются, а правило короткое.
Ваша погрешность относится к группе, только если в этой группе столько же заполненных ответов. Если Вам нужно плюс-минус 5 пунктов для каждого из шести регионов, нужно примерно 385 заполненных ответов в каждом регионе, а не 385 всего. Это опрос в шесть раз больше, чем Вы думали.
Два честных выхода:
- Увеличьте отбор в малых группах. Намеренно пригласите большую долю из меньших сегментов, чтобы каждый достиг своей цели. Затем результаты взвешиваются обратно.
- Смиритесь с более широкими интервалами для разбивок. Сохраните одну надёжную общую цифру и публикуйте каждую подгруппу с её собственной, более широкой погрешностью рядом. Обычно это правильный ответ.
В калькуляторе для этого есть поле. Укажите в поле Подгруппы для отдельного отчёта число групп, по которым Вы должны дать результат, и он правильно рассчитает объём для каждой группы и сложит их.
Определите рамки до полевого этапа. Перечислите сегменты, по которым Вы обязаны отчитаться, а не те, по которым было бы неплохо. Оцените, сколько заполненных ответов реально может дать каждый, определяя их с помощью демографических вопросов. Если сегмент может дать только 80 ответов, не обещайте для него плюс-минус 5 пунктов. При 80 ответах интервал составляет плюс-минус 11 пунктов.
AAPOR приводит разобранный пример, который стоит запомнить. Опрос 1000 взрослых имеет общую погрешность около плюс-минус 3 пунктов. Если 200 из этих людей — подгруппа, о которой Вы на самом деле хотите говорить, погрешность этой подгруппы — плюс-минус 6,9 пункта, более чем вдвое больше. Цифра на первой странице отчёта — не та цифра, которая определяет диаграмму на девятой странице.
Опубликованные рекомендации о минимальном размере ячеек старше и менее строги, чем формулы, и их вполне можно считать нижней границей, а не целью: примерно 100 ответов для подгруппы, по которой Вы будете полноценно отчитываться, и от 20 до 50 для второстепенной, которую Вы упомянете мимоходом.
Где планирование объёма выборки даёт сбой
Объём выборки управляет ошибкой выборки — случайным шумом от того, что опрошены не все. В реальных опросах есть и систематическая ошибка, которую не исправит никакой объём выборки и которую большая выборка может замаскировать.
Удобная выборка вместо вероятностной
Каждая формула здесь предполагает, что у каждого человека был известный ненулевой шанс быть отобранным и что участие в опросе не было сильно связано с тем, что Вы измеряете. Открытая ссылка в социальных сетях не удовлетворяет ни одному из этих условий. Погрешность по ответам всё равно можно рассчитать, она будет выглядеть обнадёживающе — и не будет означать того, что говорит. Прямо укажите, какую выборку Вы на самом деле сформировали.
Большее n как более качественное измерение
Большая выборка лишь точнее измеряет шум зашумлённого измерения. Если вопрос двусмысленный, двойной или наводящий, больше ответов его не спасут. Высокая доля пропусков и противоречивые ответы — признаки того, что сначала нужно исправить инструмент. Переписать один плохой вопрос часто полезнее, чем утроить выборку.
Выбор точности без стоящего за ним решения
У точности есть правильный ответ только тогда, когда Вы знаете, для чего она нужна. Объём выборки легко обосновать, если Вы можете закончить фразу: нам нужно различать результаты, отличающиеся на X пунктов. Его невозможно обосновать, если единственный довод — большее число казалось надёжнее. Свяжите его с Вашим дизайном исследования и с тем, что Вы будете делать с результатом.
Цифры на этой странице и насколько они надёжны
Каждая приведённая выше цифра — либо расчёт, который можно воспроизвести в калькуляторе, либо ссылка, которую можно проверить. Уровень A означает воспроизведённый или напрямую вычислимый результат, B — одно сильное исследование, C — широко повторяемое, но оспариваемое утверждение.
| Утверждение | Цифра | Уровень | Источник |
|---|---|---|---|
| При доверительной вероятности 95 процентов и без предварительной оценки большой генеральной совокупности для плюс-минус 5 пунктов нужно 385 заполненных ответов. | 385 | A | Прямой расчёт по стандартной формуле для доли. NIST, раздел 3.3.3; Israel (1992). |
| Формула на этой странице воспроизводит опубликованную таблицу объёма выборки Krejcie и Morgan с точностью до одного ответа для каждого из 21 проверенного размера генеральной совокупности. | 21 из 21 в пределах 1 | A | Наша собственная сверка с Krejcie и Morgan (1970). Метод описан под таблицей. |
| Доля ответивших — слабый предиктор смещения из-за неответов. Метаанализ 59 специальных исследований смещения выявил лишь слабую связь между ними. | 59 исследований | A | Groves и Peytcheva (2008), Public Opinion Quarterly. |
| Pew провёл одну и ту же анкету при доле ответивших 9 процентов и 22 процента. Из 40 общих вопросов 28 дали результаты в пределах 2 пунктов. | 28 из 40 в пределах 2 пунктов | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Но в опросах удовлетворённости связь реальна и велика. По 717 больничным опросам средний балл удовлетворённости коррелировал с долей ответивших с r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux и Combescure (2020), BMC Health Services Research. |
| Доля ответивших в опросах сотрудников почти идеально следует за размером организации. В 2024 году опрос федеральных служащих США получил 71 процент в ведомствах численностью до 1000 человек и 37 процентов в ведомствах численностью более 75 000. | 71 против 37 процентов | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, приглашено более 1,6 миллиона сотрудников. |
| Средняя доля ответивших по 1071 опубликованному онлайн-опросу составила 44,1 процента. Единой нормальной доли не существует. | 44,1 процента | A | Метаанализ Wu, Zhao и Fils-Aime (2022), Computers in Human Behavior Reports. |
| Веб-опросы дают примерно на 12 процентных пунктов меньшую долю ответивших, чем другие способы, по 114 экспериментальным сравнениям. | на 12 пунктов ниже | A | Метаанализ Daikeler, Bosnjak и Lozar Manfreda (2020), JSSAM. |
| Уменьшение погрешности вдвое увеличивает необходимую выборку примерно в четыре раза, потому что n пропорционально 1, делённой на E в квадрате. Удвоение выборки с 1000 до 2000 даёт около одного пункта. | примерно в 4 раза | A | Алгебраическое свойство формулы; AAPOR прямо приводит случай от 1000 до 2000. |
| Допущение p = 0,5 вместо известного p = 0,9 почти утраивает выборку, которую Вам предлагают собрать, — со 139 до 385. | 139 против 385 | A | Прямой расчёт. Воспроизводится в калькуляторе изменением ожидаемого результата. |
| Все 87 шаблонов опросов, опубликованных на этом сайте, содержат не более 14 вопросов, а 86 из 87 — не более 10. 785 из 799 вопросов подтверждены на опубликованных страницах. | 87 шаблонов, 799 вопросов | A | Наш собственный подсчёт действующей коллекции шаблонов на 21 августа 2026 года, сверенный со всеми 87 опубликованными страницами. Метод, ручная проверка и доля подтверждения указаны рядом с таблицей. |
| За формулой, носящей имя Slovin, не удаётся найти человека с таким именем. Самый старый прослеживаемый источник — Yamane (1967). | автор не прослеживается | B | Tejada и Punzalan (2012), The Philippine Statistician; Wolfram MathWorld называет её эмпирической. |
«Вам всегда нужно 385 ответов». Только при доверительной вероятности 95 процентов, плюс-минус 5 пунктах, p = 0,5 и большой генеральной совокупности. Без этих условий это неверно для любой малой генеральной совокупности.
«Опросите 10 процентов генеральной совокупности». Статистического обоснования у этого нет. Для больших генеральных совокупностей это сильно завышает выборку, а для малых — занижает.
«Доля ответивших ниже 50 или 60 процентов делает опрос недействительным». Никакой порог этого не делает. Лестница 50, 60 и 70 процентов — учебное эмпирическое правило без какого-либо эмпирического вывода, и метаанализ Groves и Peytcheva ему противоречит. Доля ответивших ограничивает смещение в худшем случае. Фактическое смещение она не измеряет.
«Средняя доля ответивших в опросах — X процентов». Проверенные цифры за одни и те же несколько лет варьируют от 6 до 71 процента и полностью зависят от того, кого опрашивают. Любое единое среднее это скрывает. Вместо него ссылайтесь на строку из таблицы выше, соответствующую Вашей ситуации.
Формула Slovin, представленная как вывод. Это формула Cochran с жёстко заданными доверительной вероятностью 95 процентов и p = 0,5 и z, округлённым до 2, а у приписывания её Slovin нет прослеживаемого источника.
Шаблон обоснования
Большинство аргументов об объёме выборки не выдерживают критики, потому что допущения так и не были записаны. Кнопка Скопировать обоснование в калькуляторе записывает его, сразу подставляя Ваши цифры. Если Вы предпочитаете составить его сами, вот девять вещей, которые будет искать рецензент.
- Генеральная совокупность (N): определите генеральную совокупность и укажите её численность. Например, все активные клиенты за последние 90 дней, N = 48 200.
- Что Вы измеряете: долю (процент) или среднее (средний балл). Формула здесь рассчитывает объём для долей, что охватывает большинство показателей KPI в отчётах.
- Доверительная вероятность: выбранный уровень и почему. Принятая практика и допустимый риск — оба приемлемые основания, если Вы их назовёте.
- Погрешность (E): целевая точность в целом и отдельно для каждой подгруппы, по которой Вы обещали отчитаться.
- Предполагаемая доля (p): использованное значение и его происхождение. Прямо укажите, если это 0,5, потому что ничего лучшего не было.
- Поправка на конечную генеральную совокупность: применяли ли Вы её и что послужило основанием, например n0 больше 10 процентов от N.
- Цель по заполненным ответам (n): итоговое необходимое число заполненных ответов после всех корректировок.
- Ожидаемая доля ответивших: предполагаемая доля, опыт, на котором она основана, и получившееся число приглашений.
- Как Вы будете отбирать людей: простая случайная выборка, стратифицированная, сплошное обследование или удобная выборка, а также избыточный отбор для ключевых сегментов. Назовите метод честно.
Когда опрос запущен, следите за заполненными ответами по сегментам, а не за общим числом. Хорошая общая цифра может скрывать сегмент, который никогда не достигнет своей цели, — а эту проблему ещё можно исправить на первой неделе и уже нельзя на четвёртой. В отчёте указывайте рядом с каждым процентом его погрешность и прочитайте материал о том, как анализировать данные опроса, прежде чем считать сдвиг на два пункта реальным.
Рабочий лист планирования объёма выборки
Одна страница, которую можно распечатать, заполнить вручную и приложить к описанию проекта. Заполните средний столбец до начала полевого этапа, а не после. Ничего никуда не отправляется, аккаунт не нужен.
| Решение | Ваше значение | Подсказка |
|---|---|---|
| Генеральная совокупность (N) | Кто именно и сколько их. Запишите определение, а не только число. | |
| Что Вы измеряете | Процент или среднее. Эта страница рассчитывает объём для процентов. | |
| Доверительная вероятность | 95 процентов, если нет причины выбрать иное. Запишите причину. | |
| Погрешность (E) | Разница в пунктах, которую нужно уметь различать. | |
| Предполагаемая доля (p) | 0,5, если ничего лучшего нет. Укажите, откуда взялось другое значение. | |
| Поправка на конечную генеральную совокупность | Применена или нет и что послужило основанием. | |
| Цель по заполненным ответам (n) | Итоговая цифра после всех корректировок. | |
| Подгруппы с отдельной отчётностью | Сколько их и сколько заполненных ответов нужно каждой. | |
| Ожидаемая доля ответивших | Доля и опыт, на котором она основана. Не цифра из интернета. | |
| Сколько приглашений отправить | Заполненные ответы, делённые на долю, с округлением вверх. Никогда не больше N. | |
| Как отбираются люди | Случайная, стратифицированная выборка, сплошное обследование или удобная выборка. Назовите метод честно. | |
| Контрольная точка полевого этапа | Дата, когда Вы проверите заполненные ответы по сегментам, а не только общее число. |
Формула: n0 = (z^2 x p x (1 - p)) / E^2, затем n = n0 / (1 + (n0 - 1) / N). Источник: Cochran (1977); NIST/SEMATECH e-Handbook, раздел 3.3.3; Israel (1992). Рабочий лист со страницы https://www.supersurvey.com/Sample-Size
Часто задаваемые вопросы
Что такое объём выборки?
Объём выборки — это число заполненных ответов в опросе; обозначается n. Это не число приглашённых и не размер описываемой генеральной совокупности. Это число ответов, с которым Вы завершаете полевой этап, и именно по нему рассчитывается погрешность: 385 заполненных ответов дают около плюс-минус 5 пунктов при доверительной вероятности 95 процентов, если генеральная совокупность велика. Разница между генеральной совокупностью, приглашениями и n описана в разделе Что такое объём выборки.
Сколько ответов нужно для опроса?
Для большинства опросов рабочий ответ — 385 заполненных ответов. Столько выдаёт формула при доверительной вероятности 95 процентов, погрешности плюс-минус 5 процентных пунктов и без предварительной оценки результата. Если генеральная совокупность мала, нужно меньше: 278 для списка из 1000 человек, 80 для списка из 100. Введите свои цифры в калькулятор, чтобы увидеть точное число и расчёт.
Какой объём выборки нужен для доверительной вероятности 95 процентов и погрешности 5 процентов?
385 заполненных ответов, если генеральная совокупность велика и Вы используете p = 0,5. Расчёт: n0 = 1,96 в квадрате, умноженное на 0,5 и на 0,5 и делённое на 0,05 в квадрате, то есть 0,9604, делённое на 0,0025, что равно 384,16. Округлив вверх, получаем 385. Если генеральная совокупность мала, примените поправку на конечную генеральную совокупность, и число уменьшится.
Что такое погрешность?
Погрешность — это диапазон «плюс-минус» вокруг результата опроса, возникающий из-за того, что в выборку попали некоторые люди, а не все. Результат 62 процента с погрешностью 5 пунктов означает, что метод в большинстве случаев даёт интервал, содержащий истинное значение, а этот конкретный интервал — от 57 до 67 процентов. Она описывает только случайную ошибку выборки. О людях, которые так и не ответили, она ничего не говорит.
Как найти погрешность?
Извлеките квадратный корень из произведения p на (1 минус p), делённого на n, а затем умножьте на z-значение для Вашей доверительной вероятности. При доверительной вероятности 95 процентов, 385 ответах и p = 0,5 это 1,96, умноженное на квадратный корень из 0,25, делённого на 385, то есть 1,96, умноженное на 0,025482, что равно 0,0499. Значит, погрешность — плюс-минус 5,0 процентного пункта. Калькулятор погрешности на этой странице сделает это за Вас и покажет расчёт.
Увеличивается ли погрешность с ростом объёма выборки?
Нет, она уменьшается, причём пропорционально квадратному корню из объёма выборки. Переход от 100 ответов к 400 уменьшает погрешность вдвое. Переход от 400 к 1600 уменьшает её вдвое ещё раз. Именно из-за этой зависимости от квадратного корня точность обходится дорого: каждый следующий знак после запятой в точности стоит примерно в четыре раза больше ответов.
Погрешность — это то же самое, что стандартная ошибка?
Нет. Стандартная ошибка — это исходный разброс оценки. Погрешность — это стандартная ошибка, умноженная на z-значение для выбранной Вами доверительной вероятности. При доверительной вероятности 95 процентов погрешность составляет около 1,96 стандартной ошибки. Стандартная ошибка — свойство данных. Погрешность — выбор способа отчётности поверх неё.
Какой объём выборки хорош для количественного исследования?
Единого хорошего числа не существует, и любой источник, который называет его, не спросив, что Вы измеряете, гадает. Для исследования, сообщающего проценты по генеральной совокупности менее примерно 10 000 человек, обоснованный ответ — то, что выдаёт формула при доверительной вероятности 95 процентов и погрешности, которую Вы можете обосновать. Для списка из 1000 это 278. Главу о методах одобряют не за большое число, а за заявленное число, рядом с которым указаны доверительная вероятность, погрешность, предполагаемая доля и генеральная совокупность. Названные формулы, которых может ожидать научный руководитель, см. в разделе объём выборки для количественного исследования.
Какая доля ответивших в опросе считается нормальной?
Единой нормальной доли не существует, и любая страница, приводящая одно число, гадает. Реальные цифры с источниками за одну и ту же эпоху варьируют от 6 процентов (телефонные опросы Pew в 2018 году) до 71 процента (небольшие федеральные ведомства США в Federal Employee Viewpoint Survey 2024 года). Метаанализ 1071 опубликованного онлайн-опроса показал среднее значение 44,1 процента. Размер организации имеет огромное значение: тот же федеральный опрос получил 71 процент в ведомствах численностью до 1000 человек и 37 процентов в ведомствах численностью более 75 000. Сначала используйте собственный опыт, а цифры, на которые можно сослаться, смотрите в таблице эталонов.
Влияет ли размер генеральной совокупности на объём выборки?
Почти не влияет, пока выборка не станет большой долей генеральной совокупности. Переход от 100 000 человек к 1 000 000 меняет требование с 383 на 385. Переход от 1000 человек к 100 меняет его с 278 на 80. Размер генеральной совокупности важен на малом конце шкалы — именно там применяется поправка на конечную генеральную совокупность.
Когда p = 0,5 — правильный выбор?
Используйте p = 0,5 всякий раз, когда у Вас нет обоснованной предварительной оценки. Произведение p на (1 минус p) максимально при 0,5, поэтому даёт наибольшую необходимую выборку. Это делает допущение безопасным: Вы не окажетесь с нехваткой ответов. Если у Вас есть пилотажное исследование, эталон или прошлогодняя цифра, используйте их. Допущение p = 0,9 вместо 0,5 сокращает необходимую выборку с 385 до 139.
Если пригласить больше людей, исчезнет ли смещение из-за неответов?
Нет. Больше приглашений дают больше заполненных ответов, что сужает погрешность. Смещение — отдельная проблема: оно зависит от того, отличаются ли ответившие от не ответивших. Метаанализ 59 исследований смещения из-за неответов выявил лишь слабую связь между долей ответивших и фактическим смещением. Pew провёл одну и ту же анкету дважды — при доле ответивших 9 и 22 процента, — и 28 из 40 общих вопросов дали результаты в пределах 2 пунктов друг от друга. См. смещение ответов и смещение из-за неответов.
Как быть с объёмом выборки, если нужны результаты по отделам или регионам?
Рассчитывайте объём для каждой подгруппы отдельно. Погрешность относится к группе, только если в этой группе столько же заполненных ответов. Если Вам нужно плюс-минус 5 пунктов для каждого региона, каждому региону нужны свои 385 заполненных ответов или своё число с поправкой на конечную генеральную совокупность. Используйте демографические вопросы, чтобы определить группы, и запланируйте избыточный отбор в малых группах.
Какой объём выборки нужен для статистически значимого результата?
Этот вопрос смешивает две идеи. Формулы объёма выборки рассчитывают объём для оценки с заданной точностью. Проверка значимости сравнивает два числа и спрашивает, может ли разница правдоподобно объясняться случайностью. Нужный объём зависит от того, насколько малую разницу Вы хотите уметь обнаружить, а не от фиксированного порога. Рассчитайте объём опроса здесь, а затем прочитайте материал о статистической значимости, прежде чем сравнивать один результат с другим.
Подходят ли эти формулы для качественных исследований?
Нет. Объём интервью, фокус-групп и работы с открытыми ответами не рассчитывают через погрешность, потому что они не оценивают процент в генеральной совокупности. Объём качественной выборки обосновывается насыщением — моментом, когда новые участники перестают давать новые темы, — и описывается как суждение, подкреплённое данными, а не как формула. Не прогоняйте качественное исследование через этот калькулятор.
Источники
- National Institute of Standards and Technology (NIST). (n.d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, section 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.