
Urvalsstorlek i en enkät är antalet fullständiga svar som ingår i din analys, skrivet som n. Det är något annat än antalet inbjudningar eller antalet personer på din lista. Under kalkylatorns antaganden om urvalet ger ett större urval en mindre felmarginal; det tar inte bort snedvriden rekrytering eller dåligt formulerade frågor.
Kalkylator för urvalsstorlek
Ingenting är gömt bakom en registrering och ingenting skickas någonstans. Kalkylatorn körs i din webbläsare, börjar med ett uträknat svar redan på skärmen och visar formeln och uträkningen den använde, så att du kan kontrollera den eller göra om den för hand.
Hur många svar behöver jag?
Ange dina sex indata. Svaret, formeln och uträkningen uppdateras medan du skriver.
Fullständiga svar du behöver
370
Efter korrektion för ändlig population.
Personer att bjuda in
1,234
Vid en svarsfrekvens på 30 procent.
Urvalsandel
3.7%
Andel av populationen som du behöver svar från.
Totalt, dimensionerat per undergrupp
370
Uträkningen, steg för steg
| Felmarginal | Fullständiga svar som behövs | Inbjudningar som behövs |
|---|
Högre precision kostar svar ungefär i proportion till förbättringen i kvadrat. Att halvera felmarginalen multiplicerar urvalet med ungefär fyra.
Kopieringsknappen skriver ett kort metodstycke med dina siffror, formeln och källhänvisningen, klart att klistra in i en projektbeskrivning eller ett metodkapitel.
Citera kalkylatorn: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Resultatet är fullständiga svar, inte inbjudningar. Det är det antal du behöver ha i handen när fältarbetet är slut. Antalet inbjudningar är den siffran delad med den svarsfrekvens du räknar med, och det är där de flesta urvalsplaner går fel. När målet är satt kan du skapa din enkät och göra en pilotstudie med den tänkta målgruppen. Använd pilotstudien för att kontrollera formuleringarna och uppskatta andelen inbjudna som fullföljer i just ditt projekt.
Vad urvalsstorlek betyder
Urvalsstorlek är antalet personer som fyller i hela din enkät. Den skrivs som n i varje formel på den här sidan, den är den enda storhet som du får genom fältarbete i stället för att bestämma på papperet, och den är siffran som din felmarginal beräknas från.
Tre antal förväxlas med den, och att skilja dem åt är det mesta av vad en urvalsplan gör:
- Population (N): alla du vill beskriva. En kundlista, antalet anställda, ett land.
- Inbjudningar: hur många personer du kontaktar. Alltid fler än n, eftersom inte alla svarar.
- Urvalsstorlek (n): hur många fullständiga svar du har när fältarbetet är slut. Det är det antal som formeln dimensionerar, och det enda av de tre som påverkar din felmarginal.
Urvalsstorleken ger dig precision, som är bredden på plus/minus-intervallet kring varje resultat. Den ger dig inte riktighet, som handlar om huruvida de som svarade liknar dem som inte gjorde det. Ett stort bekvämlighetsurval kan ligga längre från sanningen än ett litet slumpmässigt, och inget värde på n reparerar det. Där planeringen av urvalsstorlek går fel förklarar skillnaden, och hur du drar urvalet är det som avgör den.
Det korta svaret, om du bara vill ha en siffra
Viktiga siffror
- 385 fullständiga svar är standardsvaret. Det är vad formeln ger vid 95 procents konfidensnivå, en felmarginal på plus/minus 5 procentenheter och ingen tidigare skattning av resultatet.
- Små populationer behöver betydligt färre. En lista med 1 000 personer behöver 278. En lista med 100 behöver 80. Det är korrektionen för ändlig population som verkar.
- Precision är dyrt. Att halvera felmarginalen multiplicerar urvalet med ungefär fyra. Att gå från plus/minus 5 procentenheter till plus/minus 1 procentenhet tar dig från 385 till 9 604.
- Formlerna räknar fullständiga svar, inte inbjudningar. Antalet inbjudningar som behövs är lika med antalet fullständiga svar delat med din förväntade svarsfrekvens. Vid 30 procent innebär 385 fullständiga svar att du bjuder in 1 284 personer.
- Felmarginalen täcker en sorts fel. Den mäter bruset från att du frågar några personer i stället för alla. Den säger ingenting om dem som aldrig svarade.
Formeln för urvalsstorlek, och hur du räknar för hand
För en enkät som redovisar en andel är den vanliga utgångspunkten urvalsstorleken för en population som är så stor att den kan behandlas som obegränsad:
n0 = (z^2 x p x (1 - p)) / E^2
Läst från vänster till höger:
- n0 är antalet fullständiga svar som krävs, före eventuell korrektion för populationen.
- z är z-värdet för din konfidensnivå. Använd 1,96 för 95 procent.
- p är den andel du räknar med att mäta, som decimaltal. Använd 0,5 om du inte vet.
- E är felmarginalen som decimaltal. Fem procentenheter är 0,05.
Symbolen för urvalsstorlek är n. Vissa källor skriver den okorrigerade siffran som n0 och den korrigerade som n, och det är den konvention som används här.
| Konfidensnivå | z | Vad den kostar dig |
|---|---|---|
| 80 procent | 1.282 | 165 fullständiga svar vid plus/minus 5 procentenheter |
| 90 procent | 1.645 | 271 fullständiga svar |
| 95 procent (standard) | 1.960 | 385 fullständiga svar |
| 99 procent | 2.576 | 664 fullständiga svar |
| 99,9 procent | 3.291 | 1 084 fullständiga svar |
Räknat exempel: från 385 till en lista över inbjudna
Scenario. Du vill veta hur stor andel av kunderna som skulle rekommendera dig. Du vill ha 95 procents konfidensnivå och plus/minus 5 procentenheter. Du har ingen tidigare skattning, så p = 0,5.
Välj konfidensnivå och felmarginal
95 procents konfidensnivå ger z = 1,96. Plus/minus 5 procentenheter är E = 0,05.
Välj ett förväntat resultat
p = 0,5, eftersom det inte finns någon tidigare skattning och 0,5 ger det största urvalet. Ingenting du får veta senare kan lämna dig med för få svar.
Använd formeln för urvalsstorlek
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Avrunda uppåt: 385 fullständiga svar. Avrunda alltid uppåt. Du kan inte samla in en bråkdel av en enkät.
Korrigera för en liten population
Om kunderna utgör en lista på 1 000 i stället för en öppen marknad, tillämpa korrektionen: n = 384,16 / (1 + 383,16 / 1 000) = 384,16 / 1,38316 = 277,7, alltså 278 fullständiga svar. Korrektionen får effekt först när urvalet är en stor andel av populationen.
Gör om fullständiga svar till inbjudningar
Vid en svarsfrekvens på 30 procent är inbjudningar = 278 / 0,30 = 926,7, så bjud in 927 personer. Fullständiga svar är vad formeln dimensionerar. Inbjudningar är vad du faktiskt skickar, och de kan aldrig bli fler än den population du drar från.
Vid 95 procents konfidensnivå och p = 0,5 förenklas hela formeln till 0,9604 delat med E i kvadrat. Den enda genvägen besvarar de flesta frågor om urvalsstorlek på en rad, och det är därför 385 dyker upp i tabeller över urvalsstorlek som du hittar på andra ställen.
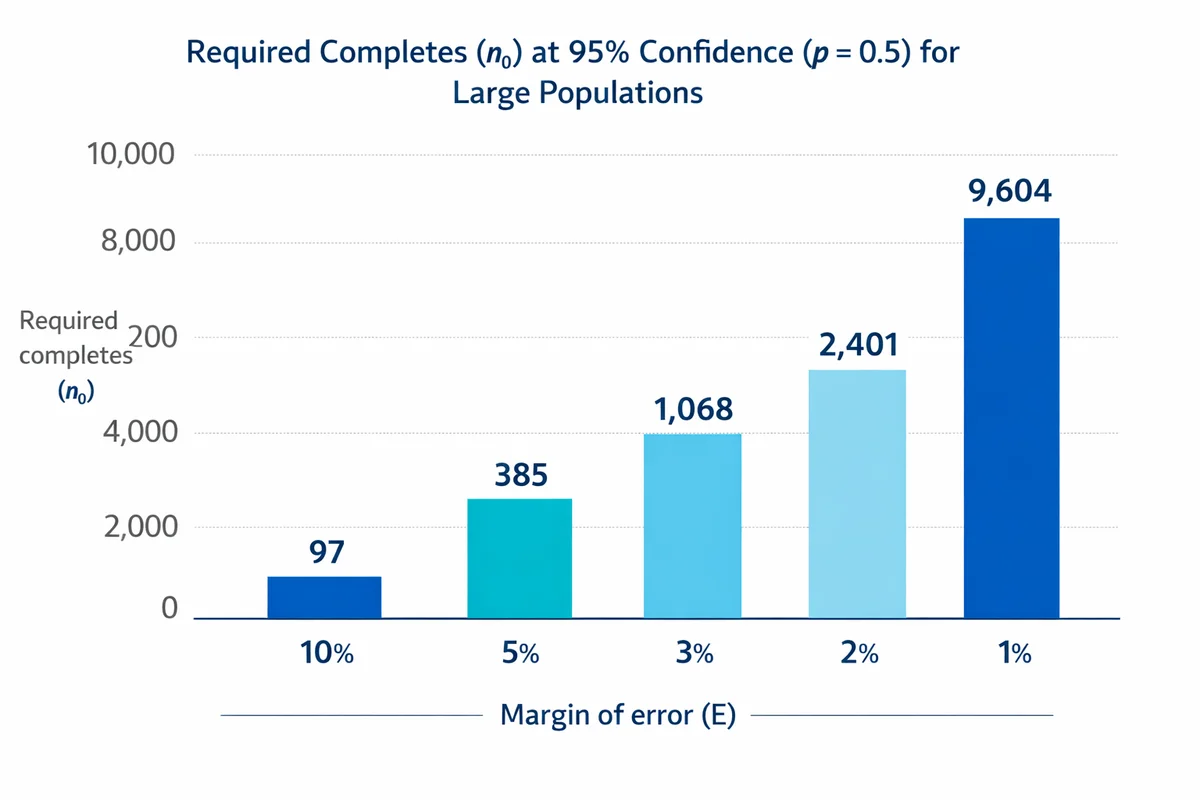
Tabell över urvalsstorlek för vanliga populationsstorlekar
Siffrorna är beräknade med formeln ovan vid 95 procents konfidensnivå, plus/minus 5 procentenheter och p = 0,5, och sedan korrigerade för populationen. De två sista kolumnerna är vår egen kontroll mot tabellen som Krejcie och Morgan publicerade 1970, som är den tabell de flesta metodkapitel hänvisar till.
| Population (N) | Fullständiga svar som behövs | Krejcie och Morgan (1970) | Skillnad |
|---|---|---|---|
| 10 | 10 | 10 | samma |
| 25 | 24 | finns inte med | |
| 50 | 45 | 44 | 1 mer |
| 100 | 80 | 80 | samma |
| 200 | 132 | 132 | samma |
| 500 | 218 | 217 | 1 mer |
| 1,000 | 278 | 278 | samma |
| 2,000 | 323 | 322 | 1 mer |
| 5,000 | 357 | 357 | samma |
| 10,000 | 370 | 370 | samma |
| 50,000 | 382 | 381 | 1 mer |
| 100,000 | 383 | 384 | 1 mindre |
Så kontrollerade vi det. Vi körde formeln för 21 populationsstorlekar och jämförde varje resultat med det publicerade värdet från Krejcie och Morgan. Tolv stämde exakt. De övriga nio skilde sig med exakt ett svar, vilket beror på var respektive metod avrundar, inte på någon oenighet om uträkningen. Om en handledare frågar varför din siffra skiljer sig med ett från tabellen är det förklaringen.
Värt att veta om du hänvisar till den tabellen: Krejcie och Morgan härledde inte någon egen formel. Deras artikel från 1970 är ungefär 400 ord plus en tabell, och dess enda källhänvisning tillskriver formeln en forskningsbulletin från 1960 utgiven av National Education Association. Deras egen sammanfattning av mönstret är fortfarande den bästa beskrivningen på en rad: när populationen växer ökar det nödvändiga urvalet i avtagande takt och stannar vid drygt 380 fall.
Att välja indata, ett i taget
Fyra tal styr svaret. Tre av dem är beslut, inte fakta, och för vart och ett finns ett försvarbart sätt att välja.
Konfidensnivå: hur ofta metoden har rätt
Konfidensnivån beskriver metoden, inte just den här enkäten. Vid 95 procents konfidensnivå innehåller intervall som tas fram på det här sättet det sanna värdet 95 gånger av 100 i det långa loppet. Det är inte 95 procents chans att just ditt svar är rätt.
Använd 95 procent om du inte har skäl att låta bli. Att gå upp till 99 procent ökar urvalet från 385 till 664 för samma precision, en kostnadsökning på 72 procent som ger väldigt lite tillbaka. Det närliggande begreppet vid hypotesprövning är alfa, och det är därför många blandar ihop de två. Om den skillnaden känns oklar, läs statistisk signifikans och vad p-värden betyder innan du väljer en siffra.
Felmarginal: beslutsvariabeln
Det här är den du ska tänka hårdast på, eftersom den är den enda parametern som kopplar urvalet till ett beslut. Välj den genom att fråga dig vilken skillnad som skulle ändra vad du gör.
Om du agerar olika när nöjdheten är 72 procent i stället för 74 procent behöver du en snäv felmarginal. Om du bara agerar vid 72 mot 82 räcker plus/minus 5 procentenheter gott. Övergripande redovisning brukar landa på 5 procentenheter för en snabb lägesbild eller 3 procentenheter för uppföljning över tid. Under 2 procentenheter stiger kostnaden snabbt.
Populationens storlek: oftast oviktig, tills den inte är det
För stora populationer rör sig det nödvändiga urvalet knappt. Tiotusen personer kräver 370 svar. Hundratusen kräver 383. Populationens storlek får betydelse först när ditt urval är en märkbar andel av den, vilket är fallet för personallistor, medlemsregister och skolårskullar. Det är vad nästa avsnitt tar upp.
Förväntat resultat (p): använd 0,5 när du inte vet
För en fråga om en andel styrs osäkerheten av p gånger (1 minus p). Den termen är störst vid p = 0,5, så 0,5 är det försiktiga valet och ger det största urvalet. Det är rätt standardvärde när du inte har någon tidigare skattning.
Om du har en, använd den, för besparingen är stor. Vid 95 procents konfidensnivå och plus/minus 5 procentenheter kräver p = 0,5 385 svar och p = 0,9 kräver 139. Tidigare enkäter, en pilotstudie eller ett publicerat riktmärke är alla rimliga källor till den skattningen. Brusiga frågor ökar också spridningen, så tydligare formuleringar kan stabilisera ett resultat utan några extra svar. Att skriva bättre enkätfrågor är ofta billigare än att samla in fler svar.
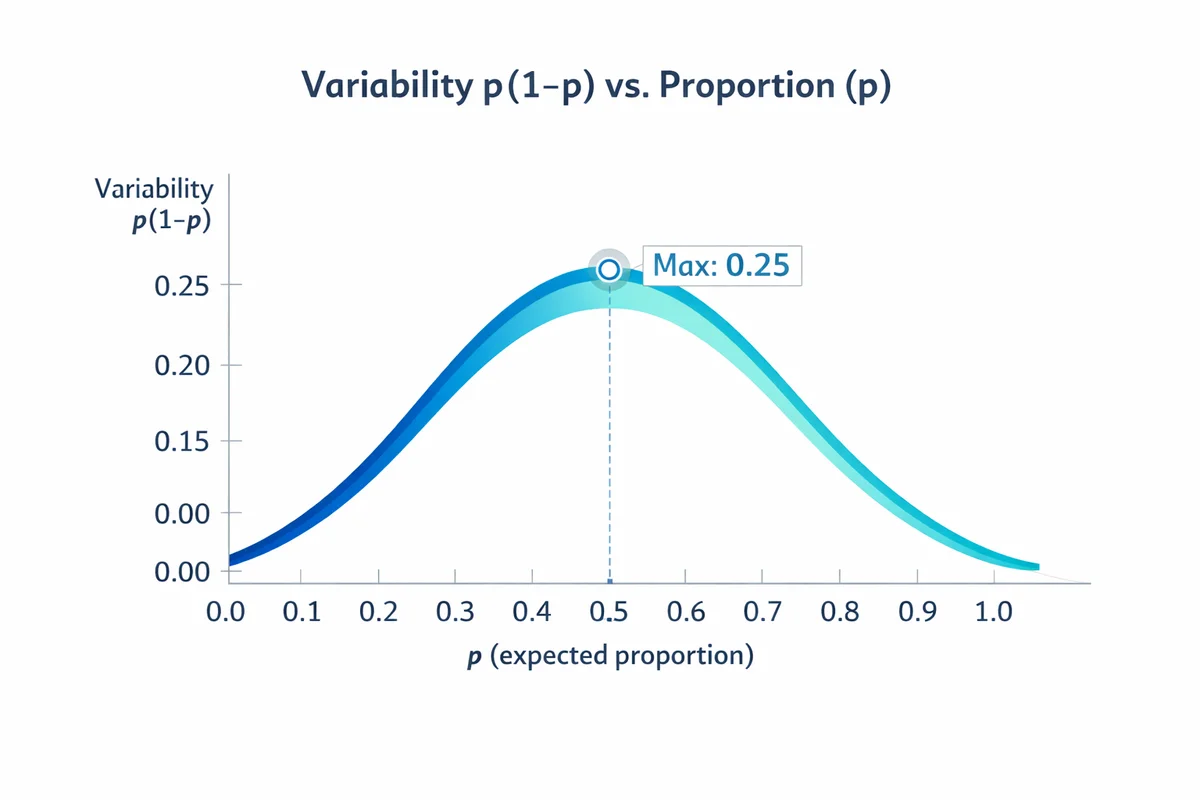
Små populationer: korrektionen för ändlig population
Grundformeln förutsätter att du drar från en så stor mängd att det inte påverkar något att plocka ut personer ur den. När ditt urval utgör en märkbar del av populationen gör det antagandet att du betalar för mycket. Korrektionen för ändlig population ger dig tillbaka svaren.
n = n0 / (1 + ((n0 - 1) / N))
- n är det korrigerade antalet fullständiga svar du behöver.
- n0 är den okorrigerade siffran från formeln ovan.
- N är populationens storlek.
Den vanliga tumregeln är att korrigera när n0 är mer än ungefär 5 procent av N. Under det ändrar korrektionen nästan ingenting, så den är inte värd att förklara för någon.
Räknat exempel: en medarbetarenkät
Scenario. Du har 1 200 anställda. Du vill ha 95 procents konfidensnivå, plus/minus 5 procentenheter, och du använder p = 0,5.
- Okorrigerat, n0 = 384,16.
- Korrigerat: n = 384,16 / (1 + (383,16 / 1 200)) = 384,16 / 1,3193 = 291,2.
- Avrunda uppåt: 292 fullständiga svar.
Utan korrektionen skulle du jaga 385 svar från en lista på 1 200, vilket är 32 procent av alla. Med den ger 292 samma precision. På en lista av den storleken är det en månads jagande som du slipper.
Under ungefär 200 personer är det korrigerade urvalet en så stor del av listan att det är enklare och mer försvarbart att bjuda in alla. En totalundersökning av 150 personer har inget urvalsfel alls. Din insats går då till svarsfrekvensen och till vilka som saknas, vilket är där den hör hemma.
Felmarginal: samma formel, baklänges
Felmarginalen är plus/minus-intervallet kring ett enkätresultat som uppstår för att du har frågat några personer i stället för alla. Om 62 procent av 385 deltagare väljer ett alternativ och felmarginalen är 5 procentenheter, redovisar du 62 procent och anger att det rimliga intervallet går från 57 till 67 procent.
Om du skriver om formeln för urvalsstorlek och löser ut E får du:
E = z x kvadratroten ur (p x (1 - p) / n)
Med en ändlig population multiplicerar du det med kvadratroten ur (N - n) delat med (N - 1). Båda varianterna finns i kalkylatorn nedan, som växlar automatiskt när du markerar eller avmarkerar rutan för populationen.
Vilken felmarginal har de svar jag redan har?
Samma formel, omskriven. Ange de svar du har samlat in och läs av precisionen.
Felmarginal
5.0
Procentenheter, plus/minus.
Ditt intervall
45,0 till 55,0
Procent, vid 95 procents konfidensnivå.
Uträkningen, steg för steg
Ökar felmarginalen med urvalsstorleken?
Den minskar, och den minskar med kvadratroten ur n. Den kvadratroten är hela enkätekonomin. Fyrahundra svar ger dig halva felet jämfört med hundra. För att halvera det igen behöver du 1 600. Varje ytterligare decimal i precision kostar ungefär fyra gånger så mycket fältarbete, och det är därför 385 är en så vanlig landningspunkt: det är där kostnad och precision slutar bråka.
Fyra begrepp som blandas ihop
Standardfel, felmarginal, konfidensnivå och konfidensintervall används som om de vore utbytbara. Det är fyra olika saker, och skillnaden spelar roll när någon ifrågasätter din siffra.
| Begrepp | Vad det är | Vid 385 svar och 50 procent |
|---|---|---|
| Standardfel | Skattningens råa spridning. Kvadratroten ur p gånger (1 minus p) delat med n. | 0,0255, eller 2,55 procentenheter |
| Felmarginal | Standardfelet multiplicerat med ett z-värde för den konfidensnivå du valde. | Plus/minus 5,0 procentenheter vid 95 procent |
| Konfidensnivå | Det z-värde du valde, uttryckt i procent. Ett val, inte en mätning. | 95 procent, alltså z = 1,96 |
| Konfidensintervall | Resultatet med felmarginalen tillämpad, skrivet som ett intervall. | 45,0 procent till 55,0 procent |
Kortversionen: standardfelet är en egenskap hos dina data, konfidensnivån är ett val du har gjort, felmarginalen är de två multiplicerade med varandra, och konfidensintervallet är det du skriver i rapporten.
Vad felmarginalen inte täcker
Den täcker slumpmässiga urvalsfel och ingenting annat. Den täcker inte personer som struntade i inbjudan, en lista som saknade en del av populationen eller en fråga som hälften av dina deltagare läste på ett annat sätt än du menade. En enkätundersökning kan ha en prydlig felmarginal och ändå ha fel. Se svarsbias och bortfallsfel för de fel som ingen urvalsstorlek rättar till.
Branschorganisationen för enkätforskning uttrycker det rakare än de flesta leverantörer gör. AAPOR konstaterar att det inte finns något sådant som en mätbar total felmarginal för en opinionsundersökning, eftersom undersökningar bär på andra fel som inte går att mäta alls, från hur frågorna skrevs till hur intervjuerna genomfördes. Det du kan beräkna är urvalsdelen. Det är den delen kalkylatorn ger dig, och det är värt att vara tydlig med att det är en del.
Två regler för språkbruket från samma källa, som de flesta enkättexter bryter mot:
- Det är procentenheter, inte procent. Skriv ”plus/minus 3 procentenheter”, inte ”plus/minus 3 procent”. De betyder olika saker.
- Den gäller inte alls för självrekryterade urval. En felmarginal förutsätter att varje person hade en känd sannolikhet större än noll att väljas ut. En öppen länk, en panel av frivilliga eller ett inlägg i sociala medier uppfyller inte det. Att publicera en felmarginal bredvid resultat från en öppen länk är att påstå en precision du inte har täckning för.
Att göra om fullständiga svar till inbjudningar
Formeln ger dig färdiga svar. Fältarbetet ger dig en svarsfrekvens. Det är i glappet mellan dem som urvalsplaner brukar spricka, och uträkningen är en rad:
Inbjudningar = fullständiga svar som krävs / förväntad svarsfrekvens
Använd frekvensen som decimaltal, så att 30 procent blir 0,30, och avrunda uppåt. För 292 fullständiga svar vid 35 procent blir det 292 delat med 0,35 = 834,3, så bjud in minst 835 personer.
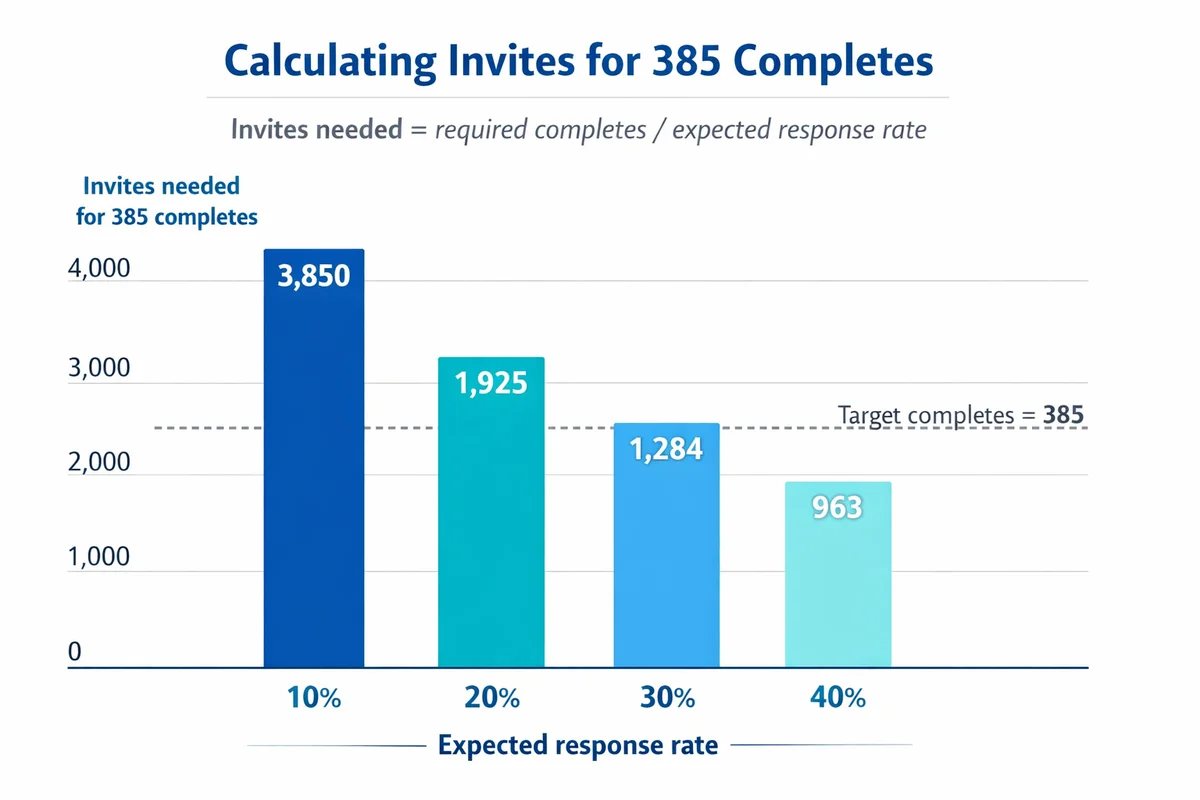
| Fullständiga svar som behövs | Förväntad svarsfrekvens | Inbjudningar |
|---|---|---|
| 385 | 60 procent | 642 |
| 385 | 30 procent | 1,284 |
| 385 | 15 procent | 2,567 |
| 292 | 50 procent | 584 |
| 292 | 35 procent | 835 |
| 292 | 20 procent | 1,460 |
Att välja en svarsfrekvens du kan försvara
Din egen historik slår alla publicerade riktmärken, så länge det är samma målgrupp, samma kanal och en enkät av liknande längd. Om du inte har något att gå på, planera tre scenarier med 20, 30 och 40 procent och behandla listan över inbjudna som en justerbar spak under fältarbetet. Påminnelser, en längre svarsperiod och en bredare lista är allt sådant du kan ändra under tiden. Målet för fullständiga svar är det inte.
De flesta tabeller med riktmärken på internet anger ett enda genomsnitt utan källa. Det finns inget enda genomsnitt. Här är vad primärkällorna faktiskt redovisar, så att du kan hänvisa till den rad som motsvarar din situation i stället för en siffra som någon hittat på.
| Sammanhang | Svarsfrekvens | Omfattning och källa |
|---|---|---|
| Amerikanska federala myndigheter med färre än 1 000 anställda | 71 procent | 2024 Federal Employee Viewpoint Survey (OPM) |
| Amerikanska federala myndigheter med 1 000 till 9 999 anställda | 60 procent | Samma undersökning, samma år (OPM) |
| Amerikanska federala myndigheter med fler än 75 000 anställda | 37 procent | Samma undersökning, samma år (OPM) |
| Alla amerikanska federala anställda | 41 procent | Över 1,6 miljoner inbjudna, över 674 000 svarade, 2024 (OPM) |
| Publicerade onlineenkäter, alla slag | 44,1 procent i genomsnitt | Metaanalys av 1 071 redovisade svarsfrekvenser (Wu m.fl., 2022) |
| Publicerad organisationsforskning | 68 procent 2020, upp från 48 procent 2005 | 1 014 enkäter i 17 tidskrifter (Holtom m.fl., 2022) |
| Telefonundersökningar bland allmänheten | 6 procent 2018, ned från 36 procent 1997 | Den svarsfrekvens som Pew Research Center själv följer upp (Kennedy och Hartig, 2019) |
| Webbenkät jämfört med alla andra insamlingssätt | ungefär 12 procentenheter lägre | Metaanalys av 114 experimentella jämförelser (Daikeler m.fl., 2020) |
Två saker framgår av tabellen. För det första: storleken på den grupp du undersöker förutsäger svarsfrekvensen bättre än nästan allt annat du kan styra över. Ett företag med 300 personer och en myndighet med 300 000 personer genomför inte samma enkät. För det andra är det ofta upprepade påståendet att svarsfrekvenserna rasar överallt bara sant på vissa ställen. Telefonundersökningarna rasade. Publicerad organisationsforskning gick åt andra hållet, från 48 procent till 68 procent på femton år.
Ytterligare en planeringsberäkning som är värd att låna: den vanliga riktlinjen är att lägga till ungefär 10 procent på listan över inbjudna för personer du helt enkelt inte kan nå, och ungefär 30 procent för personer som skulle kunna svara men inte gör det.
Vad vår egen samling mallar säger om längd
En svarsfrekvens som lånats från någon annans enkät går dåligt att överföra, och längden är en av få saker på den listan som du har full kontroll över. Här är en siffra som vi kan ta fram och en konkurrent inte kan, eftersom den kommer från att räkna vår egen publicerade samling i stället för att fråga yrkesverksamma vad de tror att de gör.
I vår genomgång den 21 augusti 2026 hade alla 87 enkätmallar 14 frågor eller färre, och 86 hade 10 frågor eller färre. Tillsammans innehöll de 799 frågor. Medianen var 9 frågor och exakt en mall hade fler än 10. Siffrorna beskriver den daterade ögonblicksbilden, inte det nuvarande biblioteket.
| Frågor i mallen | Mallar | Andel av samlingen |
|---|---|---|
| 7 frågor | 4 | 5 procent |
| 8 frågor | 17 | 20 procent |
| 9 frågor | 29 | 33 procent |
| 10 frågor | 36 | 41 procent |
| 14 frågor | 1 | 1 procent |
Efter svarsformat är 355 av de 799 frågorna skattningsskalor, 281 är listor med ett val och 163 ber läsaren skriva något. Den sista gruppen är den som kostar dig fullföljda svar, så vi läste den för hand i stället för att lita på det lagrade fältet. Av de 163 är 137 kommentarsrutor med flera rader. De övriga 26 är rutor med en rad, och genomläsningen visade att 22 är korta fält för identifiering eller klassificering: ett namn, en e-postadress, ett datum, en avdelning, en befattning. Bara 4 är korta svar med verkligt innehåll. Det ärliga antalet verkligt öppna frågor är alltså 141, eller ungefär en fråga av sex, inte en av fem som det råa fältet skulle ha gett oss.
Hur vi räknade, och hur vi kontrollerade det. Vi läste in den lagrade frågelistan för varje enkätmall som var publicerad på webbplatsen den 21 augusti 2026, behöll posterna med frågetext, hämtade sedan varje publicerad sida och jämförde de två uppsättningarna i stället för att lita på vår egen databas ensam. Alla 87 sidor svarade med HTTP 200, medan en adress som vi vet inte längre finns svarade med 410 i samma körning, så kontrollen kunde faktiskt skilja på rätt och fel i stället för att bara ge grönt överallt. 785 av de 799 frågorna, eller 98 procent, finns på den publicerade sidan. Sex av dessa träffar skiljer sig från databasen bara i vilket apostroftecken som används, och vi räknade dem som träffar, vilket vi hellre redovisar än tyst avrundar bort. Åttiosex av de 87 mallarna verifierades helt. Den som inte gjorde det är vår längsta, med 14 frågor, och dess publicerade sida visar för närvarande inga förhandsvisade frågor alls, så dess frågor kunde inte bekräftas utifrån.
Mallens längd säger inget om svarsfrekvensen bland inbjudna. Vårt separata riktmärke för enkätsvar undersöker beteendet efter att personer har interagerat med en enkät; det räknar inte alla som bjudits in. För att planera inbjudningar, använd en dokumenterad svarsfrekvens från ett jämförbart projekt eller en pilotstudie, och håll nämnaren konsekvent.
Den praktiska nyttan är begränsad men verklig. Om du lånar en svarsfrekvens för antalet inbjudningar i kalkylatorn, låna den från en enkät av ungefär samma längd som den du ska skicka, till en liknande målgrupp i en liknande kanal. Våra egna publicerade frågeformulär har mellan 7 och 10 frågor, vilket är kortare än de flesta utkast är från början.
Fler inbjudningar ger dig inte mindre snedvridning
En låg svarsfrekvens skapar två problem som ser ut som ett. Det första är att du hamnar under ditt mål, så att din felmarginal blir bredare än du planerade. Det andra är att de som svarade kan skilja sig från dem som inte gjorde det, på sätt som har betydelse för ditt resultat.
Att bjuda in fler personer löser det första problemet. Det andra löser det inte med någon säkerhet. Groves och Peytcheva sammanställde 59 studier som mätte faktiskt bortfallsfel mot känd sanning och fann bara ett litet samband mellan en undersöknings svarsfrekvens och hur snedvriden den visade sig vara. Pew testade samma idé direkt: de körde ett frågeformulär två gånger, en gång med standardmetoder som gav en svarsfrekvens på 9 procent och en gång med ett mer krävande upplägg som gav 22 procent. Av de 40 frågor som de två undersökningarna hade gemensamt hamnade 28 inom 2 procentenheter från varandra.
Det ärliga motexemplet. Det resultatet går inte att generalisera till alla ämnen, och det är värt att veta var det brister. I nöjdhetsundersökningar är sambandet verkligt och stort. En studie av 717 patientnöjdhetsundersökningar på 164 schweiziska sjukhus fann att genomsnittlig nöjdhet och svarsfrekvens korrelerade med r = 0,61, eftersom förtjusta och rasande personer svarar medan den kluvna mitten inte gör det. Om du mäter CSAT eller NPS kan en stigande svarsfrekvens i sig flytta ditt resultat, och en låg svarsfrekvens smickrar dig troligen.
Alltså: jaga svarsfrekvens när du mäter vad människor tycker om dig. Behandla den inte som ett kvalitetsintyg när du mäter något annat.
Urvalsstorlek i kvantitativ forskning: vad ett metodkapitel behöver
Det finns ingen enskild bra urvalsstorlek för kvantitativ forskning, och en källa som ger dig en utan att fråga vad du mäter gissar. Det som får ett metodkapitel godkänt är inte ett stort tal. Det är ett angivet tal, med konfidensnivå, felmarginal, antagen andel och population angivna bredvid, och en namngiven formel.
Handledare brukar förvänta sig ett av fyra namngivna tillvägagångssätt. De stämmer för det mesta överens med varandra, och det är värt att veta vilket du förväntas använda.
| Namngiven metod | Vad den kräver av dig | Resultat för N = 1 000 vid 95 procent och 5 procentenheter | Använd den när |
|---|---|---|---|
| Cochran (1977) | z, p, E och sedan korrektion för ändlig population om populationen är liten | 278 | Standardvalet. Det är formeln på den här sidan, och den som de andra är härledda från. |
| Krejcie och Morgan (1970) | Ingenting. Du läser av svaret i en publicerad tabell efter populationsstorlek. | 278 | Du vill ha en citerbar tabell i stället för uträkningar. Det är Cochran med fasta inställningar. |
| Yamane (1967), ofta kallad Slovin | Bara N och felmarginalen | 286 | Bara när p verkligen är okänt och du godtar att 95 procents konfidensnivå är inbyggd. Se förbehållet nedan. |
| Styrkeanalys | Effektstorlek, statistisk styrka, alfa och det test du ska göra | Beror helt på effektstorleken | Du prövar en hypotes snarare än skattar en andel. Använd G*Power eller OpenEpi, inte den här sidan. |
Cochran, och varför allt annat är förenklingar av den
Cochrans formel är den högst upp på den här sidan: n0 = z i kvadrat gånger p gånger (1 minus p), delat med E i kvadrat, följt av korrektionen för ändlig population när populationen är liten. De andra namngivna metoderna låser några av dessa indata för att göra uträkningen kortare. När du vet det slutar familjen se ut som fyra konkurrerande regler och börjar se ut som en regel med tre förinställningar.
Yamane och Slovin: använd med öppna ögon
Formeln n = N / (1 + N x e^2) förekommer i tusentals uppsatser, oftast tillskriven Slovin. Den är snabb: för N = 1 000 och e = 0,05 ger den 286.
Tre saker är värda att veta innan du hänvisar till den.
- Det är Cochran med inställningarna fastsvetsade. Räknar man baklänges är formeln andelsformeln med p låst till 0,5, konfidensnivån låst till 95 procent och z avrundat från 1,96 till 2. Den kan inte besvara en fråga vid någon annan konfidensnivå, och den har ingen indata alls för hur varierande din population är. Två populationer av samma storlek men med helt olika spridning får samma svar, vilket inte kan stämma.
- Den avrundningen är skälet till att dess tal blir höga. Med z = 2 är formelns tak för en obegränsad population exakt 1 delat med e i kvadrat, alltså 400. Cochrans tak är 384,16, eftersom 1,96 i kvadrat är 3,8416 och inte 4. Varje Yamane-siffra i tabellen ovan är några procent större än Cochran-siffran av exakt det skälet. Om du någon gång har undrat varför två läroböcker ger dig två olika urvalsstorlekar för samma studie är det oftast förklaringen.
- Tillskrivningen håller inte. En statistisk tidskrift spårade formelns historia och kom fram till att ingen person vid namn Slovin går att hitta bakom den, och att den äldsta spårbara källan är Taro Yamanes lärobok från 1967. Wolfram MathWorld beskriver den som en ad hoc-formel utan matematisk stringens. Om din institution förväntar sig den, använd den och hänvisa till Yamane i stället för Slovin. Om du har ett val, använd Cochran, eftersom den klarar frågan om var de 95 procenten kom ifrån.
Tumregler, ärligt bedömda
De här cirkulerar flitigt. Vissa är användbara, vissa är folklore, och det hjälper att veta vilka som är vilka.
- Minst 30 per grupp. Rimligt som golv för jämförelser mellan grupper, inte som mål. Det kommer från var urvalsfördelningar börjar bete sig väl, inte från något krav på precision.
- Tio fall per variabel i en regression. En arbetsheuristik, flitigt använd och flitigt kritiserad. Ange den som en heuristik, aldrig som en regel.
- Tio procent av populationen. Den här är helt enkelt fel, och tabellen ovan visar varför. Tio procent av 100 000 är 10 000 svar, när 383 ger dig samma precision.
- Alltid 385. Rätt bara för en stor population vid 95 procent och 5 procentenheter. Ange den med de villkoren, annars betyder den ingenting.
- Litet n för användbarhets- och produktstudier. Nielsen Norman Group publicerar den ärliga versionen av detta: 40 deltagare ger dig ett ja/nej-mått med plus/minus 15 procentenheter vid 95 procents konfidensnivå, och 47 ger dig ett medelvärde med samma precision. De talen är små eftersom den precision som utlovas är grov. Säg precisionen högt, så slutar små urval vara pinsamma.
Om din studie jämför grupper snarare än skattar en enda andel blir urvalsstorleken en fråga om statistisk styrka, och då är det här inte rätt kalkylator. Du behöver en effektstorlek du är beredd att försvara, plus alfa och styrka. G*Power och OpenEpi är de gratisverktyg som de flesta handledare förväntar sig, och båda är kostnadsfria. Att säga var ett verktyg slutar är mer användbart än att låtsas att det klarar allt.
Kvalitativt arbete dimensioneras på ett annat sätt
Intervjuer och fokusgrupper dimensioneras inte med en felmarginal, eftersom de inte skattar en andel i en population. Det vanliga argumentet är mättnad: du fortsätter tills nya deltagare slutar ge nya teman och redovisar sedan var det inträffade och hur du bedömde det. Att köra en kvalitativ studie genom den här kalkylatorn ger ett tal som ser exakt ut och inte betyder någonting.
Om du behöver resultat per undergrupp, dimensionera för undergruppen
De flesta enkäter förväntas redovisa per region, roll, anställningstid eller produktlinje. Det är här urvalsplaner i det tysta brister, och regeln är kort.
Din felmarginal gäller för en grupp bara om den gruppen har så många fullständiga svar. Om du vill ha plus/minus 5 procentenheter för var och en av sex regioner behöver du ungefär 385 fullständiga svar i varje region, inte 385 totalt. Det är en enkät som är sex gånger så stor som du trodde att du planerade.
Två ärliga vägar ut:
- Dra ett större urval ur de små grupperna. Bjud medvetet in en större andel av de mindre segmenten så att vart och ett når sitt eget mål. Du viktar tillbaka resultaten efteråt.
- Godta bredare intervall för uppdelningarna. Behåll en stark samlad siffra och publicera varje undergrupp med sin egen, större felmarginal bredvid. Det är oftast rätt svar.
Kalkylatorn har ett fält för detta. Ställ in Undergrupper att redovisa separat på antalet grupper du ska redovisa ett resultat för, så dimensionerar den varje grupp korrekt och summerar dem.
Avgränsa innan du går ut i fält. Lista de segment du måste redovisa, inte de som vore trevliga att ha. Uppskatta hur många fullständiga svar vart och ett realistiskt kan ge, med hjälp av demografiska frågor för att identifiera dem. Om ett segment bara kan ge 80 svar, lova inte plus/minus 5 procentenheter för det. Vid 80 svar är intervallet plus/minus 11 procentenheter.
AAPOR använder ett räknat exempel som är värt att lägga på minnet. En undersökning av 1 000 vuxna har en total felmarginal på ungefär plus/minus 3 procentenheter. Om 200 av de personerna är den undergrupp du egentligen vill tala om, är den undergruppens felmarginal plus/minus 6,9 procentenheter, mer än dubbelt så stor. Rubriksiffran på rapportens framsida är inte den siffra som styr diagrammet på sidan nio.
Publicerade riktlinjer om minsta cellstorlek är äldre och lösare än formlerna, och det är rimligt att behandla dem som ett golv snarare än ett mål: ungefär 100 svar för en undergrupp som du ska redovisa ordentligt, och 20 till 50 för en mindre som du nämner i förbigående.
Där planeringen av urvalsstorlek går fel
Urvalsstorleken hanterar urvalsfel, det slumpmässiga bruset från att inte fråga alla. Verkliga enkätundersökningar bär också på systematiska fel, som ingen urvalsstorlek rättar till och som ett stort urval kan dölja.
Att behandla ett bekvämlighetsurval som ett sannolikhetsurval
Varje formel här förutsätter att varje person hade en känd sannolikhet större än noll att väljas ut, och att benägenheten att svara inte hängde starkt ihop med det du mäter. En öppen länk i sociala medier uppfyller inget av villkoren. Du kan ändå beräkna en felmarginal utifrån svaren, och den kommer att se lugnande ut, och den kommer inte att betyda vad den säger. Var tydlig med vilken sorts urval du faktiskt drog.
Att tolka ett större n som bättre mätning
Ett stort urval gör en brusig mätning exakt brusig. Om en fråga är tvetydig, en dubbelfråga eller ledande kommer fler svar inte att rädda den. Många överhoppade frågor och motsägelsefulla svar är tecken på att du först ska rätta till frågeformuläret. Att skriva om en dålig fråga gör ofta mer än att tredubbla urvalet.
Att välja precision utan ett beslut bakom
Precision har ett rätt svar först när du vet vad den ska användas till. En urvalsstorlek är lätt att försvara när du kan avsluta den här meningen: vi behöver kunna skilja på utfall som skiljer sig med X procentenheter. Den är omöjlig att försvara när det enda skälet är att ett större tal kändes tryggare. Koppla den tillbaka till din forskningsdesign och till vad du ska göra med resultatet.
Siffrorna på den här sidan, och hur bra de är
Varje siffra ovan är antingen en uträkning du kan återskapa i kalkylatorn eller en källhänvisning du kan kontrollera. Evidensgrad A betyder replikerat eller direkt beräkningsbart, B betyder en enda stark studie, C betyder flitigt upprepat men omstritt.
| Påstående | Siffra | Evidensgrad | Källa |
|---|---|---|---|
| Vid 95 procents konfidensnivå utan tidigare skattning behöver en stor population 385 fullständiga svar för plus/minus 5 procentenheter. | 385 | A | Direkt uträkning med standardformeln för andelar. NIST avsnitt 3.3.3; Israel (1992). |
| Formeln på den här sidan återskapar Krejcie och Morgans publicerade tabell över urvalsstorlek med högst ett svars skillnad för var och en av de 21 populationsstorlekar vi kontrollerade. | 21 av 21 inom 1 | A | Vår egen kontroll mot Krejcie och Morgan (1970). Metoden beskrivs under tabellen. |
| Svarsfrekvensen är en svag prediktor för bortfallsfel. En metaanalys av 59 studier inriktade på snedvridning fann bara ett litet samband mellan de två. | 59 studier | A | Groves och Peytcheva (2008), Public Opinion Quarterly. |
| Pew körde samma frågeformulär vid en svarsfrekvens på 9 procent och 22 procent. Av 40 gemensamma frågor hamnade 28 inom 2 procentenheter. | 28 av 40 inom 2 procentenheter | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Men i nöjdhetsundersökningar är sambandet verkligt och stort. I 717 sjukhusundersökningar korrelerade genomsnittlig nöjdhet med svarsfrekvensen med r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux och Combescure (2020), BMC Health Services Research. |
| Svarsfrekvensen i medarbetarenkäter följer organisationens storlek nästan perfekt. År 2024 fick den amerikanska federala medarbetarenkäten 71 procent från myndigheter med färre än 1 000 personer och 37 procent från myndigheter med fler än 75 000. | 71 mot 37 procent | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, över 1,6 miljoner anställda inbjudna. |
| Den genomsnittliga svarsfrekvensen i 1 071 publicerade onlineenkäter var 44,1 procent. Det finns ingen enskild normal svarsfrekvens. | 44,1 procent | A | Wu, Zhao och Fils-Aime (2022), metaanalys, Computers in Human Behavior Reports. |
| Webbenkäter ger ungefär 12 procentenheter lägre svarsfrekvens än andra insamlingssätt, över 114 experimentella jämförelser. | 12 procentenheter lägre | A | Daikeler, Bosnjak och Lozar Manfreda (2020), metaanalys, JSSAM. |
| Att halvera felmarginalen multiplicerar det nödvändiga urvalet med ungefär fyra, eftersom n växer med 1 delat med E i kvadrat. Att fördubbla ett urval från 1 000 till 2 000 ger ungefär en procentenhet. | ungefär 4x | A | En algebraisk egenskap hos formeln; AAPOR anger fallet 1 000 till 2 000 uttryckligen. |
| Att anta p = 0,5 i stället för ett känt p = 0,9 nästan tredubblar det urval du uppmanas samla in, från 139 till 385. | 139 mot 385 | A | Direkt uträkning. Går att återskapa i kalkylatorn genom att ändra det förväntade resultatet. |
| Alla 87 enkätmallar som publicerats på den här webbplatsen har 14 frågor eller färre, och 86 av de 87 har 10 eller färre. 785 av deras 799 frågor bekräftades på de publicerade sidorna. | 87 mallar, 799 frågor | A | Vår egen räkning av den publicerade samlingen mallar, 21 augusti 2026, kontrollerad mot alla 87 publicerade sidor. Metod, manuell granskning och verifieringsgrad anges vid tabellen. |
| Det finns ingen spårbar person vid namn Slovin bakom formeln som bär namnet. Den äldsta spårbara källan är Yamane (1967). | ingen spårbar upphovsperson | B | Tejada och Punzalan (2012), The Philippine Statistician; Wolfram MathWorld kallar den ad hoc. |
”Du behöver alltid 385 svar.” Bara vid 95 procents konfidensnivå, plus/minus 5 procentenheter, p = 0,5 och en stor population. Angiven utan villkor är den fel för varje liten population.
”Undersök 10 procent av din population.” Det finns ingen statistisk grund för det. Det ger alldeles för stora urval i stora populationer och för små i små.
”En svarsfrekvens under 50 eller 60 procent gör en enkätundersökning ogiltig.” Ingen tröskel gör det. Stegen med 50, 60 och 70 procent är en tumregel från läroböckerna utan någon empirisk härledning bakom sig, och metaanalysen av Groves och Peytcheva motsäger den. Svarsfrekvensen sätter en gräns för den värsta tänkbara snedvridningen. Den mäter inte den faktiska snedvridningen.
”Den genomsnittliga svarsfrekvensen för enkäter är X procent.” Verifierade siffror från samma få år sträcker sig från 6 procent till 71 procent, helt beroende på vilka som undersöks. Varje enskilt genomsnitt döljer det. Hänvisa i stället till den rad i tabellen ovan som motsvarar din situation.
Slovins formel presenterad som en härledning. Det är Cochrans formel med 95 procents konfidensnivå och p = 0,5 inbyggda och z avrundat till 2, och tillskrivningen till Slovin har ingen spårbar källa.
Mallen för motivering
De flesta argument för en urvalsstorlek faller eftersom antagandena aldrig skrevs ner. Knappen Kopiera motiveringen i kalkylatorn skriver ut detta med dina egna siffror redan ifyllda. Om du hellre sätter ihop det själv är det här de nio saker som en granskare letar efter.
- Population (N): definiera populationen och ange antalet. Till exempel alla aktiva kunder under de senaste 90 dagarna, N = 48 200.
- Vad du mäter: en andel (en procentsats) eller ett medelvärde (ett genomsnitt på en skattningsskala). Formeln här dimensionerar andelar, vilket täcker de flesta nyckeltal som redovisas.
- Konfidensnivå: den nivå du valde och varför. Konvention och risktolerans är båda godtagbara skäl, om du säger det.
- Felmarginal (E): din målprecision totalt, och separat för varje undergrupp du har lovat att redovisa.
- Antagen andel (p): värdet som användes och var det kom ifrån. Säg rakt ut om det är 0,5 för att inget bättre fanns.
- Korrektion för ändlig population: om du tillämpade den och vad som utlöste den, till exempel att n0 översteg 10 procent av N.
- Mål för fullständiga svar (n): det slutliga antalet fullständiga svar som krävs efter alla justeringar.
- Förväntad svarsfrekvens: den antagna svarsfrekvensen, historiken den kommer från och det antal inbjudningar den leder till.
- Hur du väljer ut personer: obundet slumpmässigt urval, stratifierat urval, totalundersökning eller bekvämlighetsurval, plus eventuellt större urval för viktiga segment. Benämn det ärligt.
När enkäten väl är ute i fält, fortsätt att bevaka fullständiga svar per segment snarare än totalen. En sund total siffra kan dölja ett segment som aldrig kommer att nå sitt mål, och det är ett problem som du fortfarande kan åtgärda vecka ett men inte vecka fyra. När du redovisar, ange varje procentsats tillsammans med dess felmarginal, och läs hur du analyserar enkätdata innan du behandlar en förändring på två procentenheter som verklig.
Planeringsunderlag för urvalsstorlek
En sida som du kan skriva ut, fylla i för hand och häfta fast vid en projektbeskrivning. Fyll i mittenkolumnen innan fältarbetet börjar, inte efteråt. Ingenting skickas någonstans och inget konto behövs.
| Beslut | Ditt värde | Att tänka på |
|---|---|---|
| Population (N) | Vilka exakt, och hur många. Skriv definitionen, inte bara antalet. | |
| Vad du mäter | En procentsats eller ett medelvärde. Den här sidan dimensionerar procentsatser. | |
| Konfidensnivå | 95 procent om du inte har ett skäl. Skriv skälet. | |
| Felmarginal (E) | Den skillnad du behöver kunna urskilja, i procentenheter. | |
| Antagen andel (p) | 0,5 om inget bättre finns. Ange varifrån ett annat värde kom. | |
| Korrektion för ändlig population | Tillämpad eller inte, och vad som utlöste den. | |
| Mål för fullständiga svar (n) | Den slutliga siffran efter alla justeringar. | |
| Undergrupper som redovisas separat | Hur många, och hur många fullständiga svar var och en behöver för egen del. | |
| Förväntad svarsfrekvens | Svarsfrekvensen och historiken bakom den. Inte en siffra från internet. | |
| Inbjudningar att skicka | Fullständiga svar delat med svarsfrekvensen, avrundat uppåt. Aldrig fler än N. | |
| Hur personerna väljs ut | Slumpmässigt, stratifierat, totalundersökning eller bekvämlighetsurval. Benämn det ärligt. | |
| Kontrollpunkt under fältarbetet | Datumet då du kontrollerar fullständiga svar per segment, inte bara totalen. |
Formel: n0 = (z^2 x p x (1 - p)) / E^2, sedan n = n0 / (1 + (n0 - 1) / N). Källa: Cochran (1977); NIST/SEMATECH e-Handbook avsnitt 3.3.3; Israel (1992). Underlag från https://www.supersurvey.com/Sample-Size
Vanliga frågor
Vad är urvalsstorlek?
Urvalsstorlek är antalet fullständiga svar i en enkät, skrivet som n. Det är inte antalet personer du bjöd in, och det är inte storleken på den population du beskriver. Det är det antal du har när fältarbetet är slut, och det är siffran som din felmarginal beräknas från: 385 fullständiga svar ger ungefär plus/minus 5 procentenheter vid 95 procents konfidensnivå när populationen är stor. Vad urvalsstorlek betyder reder ut skillnaden mellan populationen, inbjudningarna och n.
Hur många svar behöver jag för en enkät?
För de flesta enkäter är det praktiska svaret 385 fullständiga svar. Det är vad formeln ger vid 95 procents konfidensnivå, en felmarginal på plus/minus 5 procentenheter och ingen tidigare skattning av resultatet. Om din population är liten behöver du färre: 278 för en lista med 1 000 personer, 80 för en lista med 100. Ange dina egna siffror i kalkylatorn för att se den exakta siffran och uträkningen bakom den.
Vilken urvalsstorlek behöver jag för 95 procents konfidensnivå och 5 procents felmarginal?
385 fullständiga svar, om populationen är stor och du använder p = 0,5. Uträkningen är n0 = 1,96 i kvadrat gånger 0,5 gånger 0,5, delat med 0,05 i kvadrat, vilket är 0,9604 delat med 0,0025, vilket är 384,16. Avrunda uppåt så får du 385. Om din population är liten, tillämpa korrektionen för ändlig population, så sjunker antalet.
Vad är felmarginal?
Felmarginalen är plus/minus-intervallet kring ett enkätresultat som uppstår för att du har gjort ett urval av några personer i stället för att fråga alla. Ett resultat på 62 procent med en felmarginal på 5 procentenheter betyder att metoden för det mesta skulle ge ett intervall som innehåller det sanna värdet, och just det här intervallet går från 57 till 67 procent. Den beskriver bara slumpmässiga urvalsfel. Den säger ingenting om dem som aldrig svarade.
Hur räknar man ut felmarginalen?
Ta kvadratroten ur p gånger (1 minus p) delat med n, och multiplicera sedan med z-värdet för din konfidensnivå. Vid 95 procents konfidensnivå, 385 svar och p = 0,5 är det 1,96 gånger kvadratroten ur 0,25 delat med 385, vilket är 1,96 gånger 0,025482, vilket är 0,0499. Felmarginalen är alltså plus/minus 5,0 procentenheter. Kalkylatorn för felmarginal på den här sidan gör det åt dig och visar uträkningen.
Ökar felmarginalen med urvalsstorleken?
Nej, den minskar, och den minskar med kvadratroten ur urvalet. Att gå från 100 svar till 400 halverar felmarginalen. Att gå från 400 till 1 600 halverar den igen. Det sambandet med kvadratroten är skälet till att precision blir dyr: varje ytterligare decimal i noggrannhet kostar ungefär fyra gånger så många svar.
Är felmarginal samma sak som standardfel?
Nej. Standardfelet är skattningens underliggande spridning. Felmarginalen är standardfelet multiplicerat med ett z-värde för den konfidensnivå du valde. Vid 95 procents konfidensnivå är felmarginalen ungefär 1,96 standardfel. Standardfelet är en egenskap hos data. Felmarginalen är ett val i redovisningen som läggs ovanpå.
Vad är en bra urvalsstorlek för kvantitativ forskning?
Det finns inget enskilt bra tal, och en källa som ger dig ett utan att fråga vad du mäter gissar. För en studie som redovisar procentsatser från en population under ungefär 10 000 är det försvarbara svaret det som formeln ger vid 95 procents konfidensnivå och en felmarginal du kan motivera. För en lista med 1 000 är det 278. Talet som får ett metodkapitel godkänt är inte ett stort tal, utan ett angivet tal med konfidensnivå, felmarginal, antagen andel och population angivna bredvid. Se urvalsstorlek i kvantitativ forskning för de namngivna formler som din handledare kan förvänta sig.
Vad är en normal svarsfrekvens för en enkät?
Det finns ingen enskild normal svarsfrekvens, och en sida som anger en enda siffra gissar. Verkliga siffror med källor från samma period sträcker sig från 6 procent (Pews telefonundersökningar 2018) till 71 procent (små amerikanska federala myndigheter i 2024 års Federal Employee Viewpoint Survey). En metaanalys av 1 071 publicerade onlineenkäter fann ett genomsnitt på 44,1 procent. Organisationens storlek spelar enormt stor roll: samma federala undersökning fick 71 procent från myndigheter med färre än 1 000 personer och 37 procent från myndigheter med fler än 75 000. Använd din egen historik först, och se tabellen med riktmärken för siffror du kan hänvisa till.
Spelar populationens storlek roll för urvalsstorleken?
Knappt, förrän ditt urval blir en stor andel av populationen. Att gå från 100 000 personer till 1 000 000 ändrar kravet från 383 till 385. Att gå från 1 000 personer till 100 ändrar det från 278 till 80. Populationens storlek spelar roll i den lilla änden, vilket är precis där korrektionen för ändlig population gäller.
När är p = 0,5 rätt val?
Använd p = 0,5 när du inte har någon försvarbar tidigare skattning. Termen p gånger (1 minus p) är störst vid 0,5, så den ger det största nödvändiga urvalet. Det gör det till det säkra antagandet: du kan inte bli stående med för få svar. Om du har en pilotstudie, ett riktmärke eller förra årets siffra, använd den. Att anta p = 0,9 i stället för 0,5 minskar det nödvändiga urvalet från 385 till 139.
Om jag bjuder in fler personer, blir jag då av med bortfallsfelet?
Nej. Fler inbjudningar ger dig fler fullständiga svar, vilket minskar felmarginalen. Snedvridning är ett separat problem: den beror på om de som svarade skiljer sig från dem som inte gjorde det. En metaanalys av 59 studier av bortfallsfel fann bara ett litet samband mellan svarsfrekvens och faktisk snedvridning. Pew körde samma frågeformulär två gånger, vid en svarsfrekvens på 9 procent och 22 procent, och 28 av de 40 gemensamma frågorna hamnade inom 2 procentenheter från varandra. Se svarsbias och bortfallsfel.
Hur hanterar jag urvalsstorleken om jag behöver resultat per avdelning eller region?
Dimensionera varje undergrupp separat. Din felmarginal gäller för en grupp bara om den gruppen har så många fullständiga svar. Om du vill ha plus/minus 5 procentenheter för varje region behöver varje region sina egna 385 fullständiga svar, eller sitt eget tal korrigerat för ändlig population. Använd demografiska frågor för att identifiera grupperna och planera för att dra ett större urval ur de små.
Vilken urvalsstorlek behöver jag för ett statistiskt signifikant resultat?
Den frågan blandar ihop två idéer. Formler för urvalsstorlek dimensionerar en skattning till en vald precision. Signifikanstest jämför två tal och frågar om skillnaden rimligen kan bero på slumpen. Storleken du behöver beror på hur liten skillnad du vill kunna upptäcka, inte på en fast tröskel. Dimensionera enkäten här och läs sedan om statistisk signifikans innan du prövar ett resultat mot ett annat.
Fungerar formlerna för kvalitativ forskning?
Nej. Intervjuer, fokusgrupper och arbete med öppna frågor dimensioneras inte med en felmarginal, eftersom de inte skattar en andel i en population. Urvalsstorleken i kvalitativ forskning motiveras utifrån mättnad, den punkt där nya deltagare slutar ge nya teman, och den redovisas som en bedömning med belägg snarare än som en formel. Kör inte en kvalitativ studie genom den här kalkylatorn.
Källor
- National Institute of Standards and Technology (NIST). (u.å.). Selecting Sample Sizes. I NIST/SEMATECH e-Handbook of Statistical Methods, avsnitt 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.