
Ukuran sampel survei adalah jumlah respons lengkap yang dimasukkan dalam analisis Anda, ditulis sebagai n. Angka ini berbeda dari jumlah undangan atau jumlah orang dalam daftar Anda. Dengan asumsi pengambilan sampel yang dipakai kalkulator, sampel yang lebih besar mempersempit margin kesalahan; sampel yang lebih besar tidak menghilangkan perekrutan yang bias atau pertanyaan yang kata-katanya buruk.
Kalkulator ukuran sampel
Tidak ada yang disembunyikan di balik pendaftaran dan tidak ada yang dikirim ke mana pun. Kalkulator berjalan di browser Anda, dimulai dengan contoh jawaban yang sudah tampil di layar, dan menampilkan rumus serta aritmetika yang dipakainya agar Anda dapat memeriksanya atau menghitung ulang secara manual.
Berapa banyak respons yang saya perlukan?
Isi enam input Anda. Jawaban, rumus, dan aritmetikanya diperbarui saat Anda mengetik.
Respons lengkap yang Anda perlukan
370
Setelah koreksi populasi terbatas.
Orang yang perlu diundang
1,234
Dengan tingkat respons 30 persen.
Fraksi sampel
3.7%
Bagian populasi yang perlu Anda dengar tanggapannya.
Total, dihitung per subkelompok
370
Aritmetikanya, langkah demi langkah
| Margin kesalahan | Respons lengkap yang diperlukan | Undangan yang diperlukan |
|---|
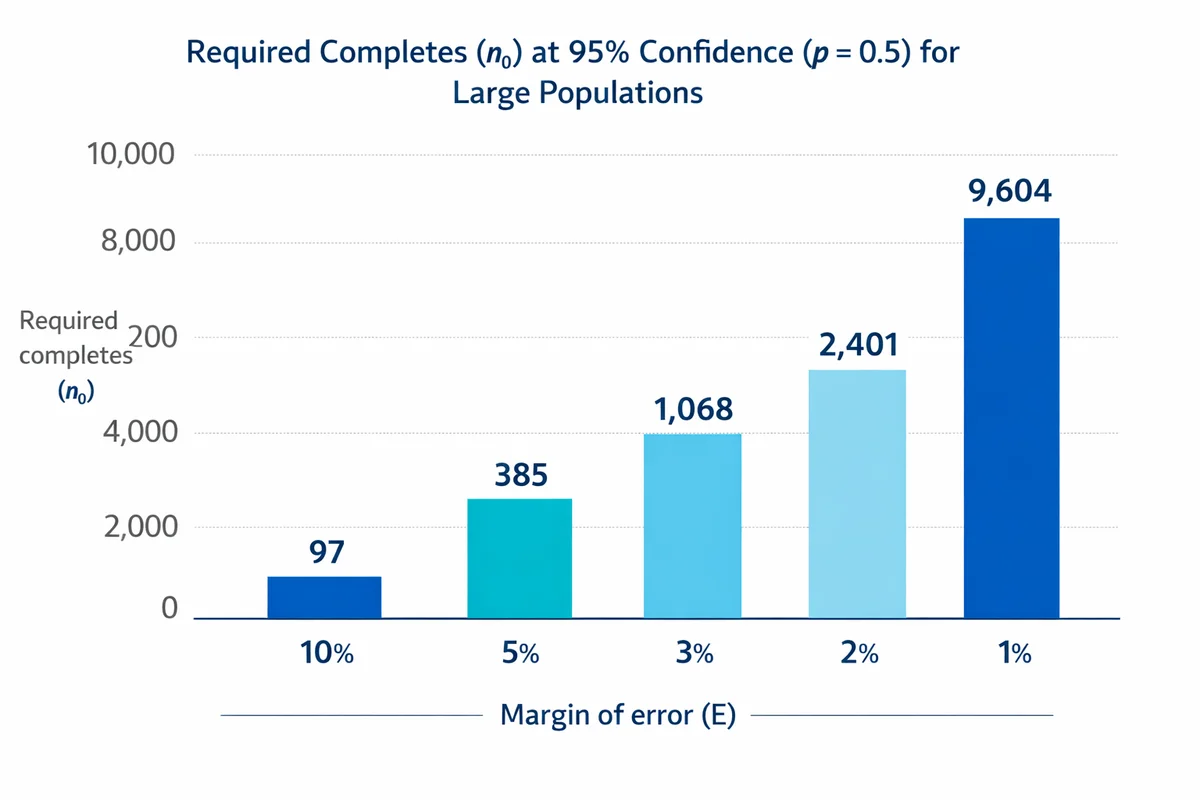
Presisi yang lebih ketat menuntut respons kira-kira sebesar kuadrat perbaikannya. Membagi dua margin kesalahan melipatgandakan sampel sekitar empat kali.
Tombol salin menulis paragraf metode singkat berisi angka Anda, rumusnya, dan kutipannya, siap ditempelkan ke ringkasan proyek atau bab metodologi.
Kutip kalkulator ini: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Hasilnya adalah respons lengkap, bukan undangan. Itulah jumlah yang perlu Anda pegang di akhir kerja lapangan. Angka undangan adalah angka itu dibagi tingkat respons yang Anda perkirakan, dan di sinilah sebagian besar rencana sampel keliru. Setelah targetnya ditetapkan, buat survei Anda dan lakukan studi pilot dengan audiens yang dituju. Gunakan studi pilot itu untuk memeriksa kata-katanya dan memperkirakan rasio undangan terhadap respons lengkap untuk proyek Anda sendiri.
Arti ukuran sampel
Ukuran sampel adalah jumlah orang yang menyelesaikan survei Anda. Ukuran sampel ditulis sebagai n dalam setiap rumus di halaman ini, merupakan satu-satunya besaran yang Anda beli dengan kerja lapangan alih-alih Anda pilih di atas kertas, dan merupakan angka yang menjadi dasar perhitungan margin kesalahan Anda.
Tiga hitungan sering dikira sama dengannya, dan membedakan ketiganya adalah sebagian besar tugas sebuah rencana sampel:
- Populasi (N): semua orang yang ingin Anda gambarkan. Daftar pelanggan, jumlah karyawan, sebuah negara.
- Undangan: berapa banyak orang yang Anda hubungi. Selalu lebih besar daripada n, karena tidak semua orang menjawab.
- Ukuran sampel (n): berapa banyak respons lengkap yang Anda pegang ketika kerja lapangan berakhir. Inilah angka yang dihitung oleh rumus, dan satu-satunya dari ketiganya yang mengubah margin kesalahan Anda.
Ukuran sampel menghasilkan presisi, yaitu lebar pita plus minus di sekitar setiap hasil. Ukuran sampel tidak menghasilkan akurasi, yaitu apakah orang yang menjawab mirip dengan orang yang tidak menjawab. Sampel convenience yang besar bisa lebih jauh dari kebenaran daripada sampel acak yang kecil, dan tidak ada nilai n yang dapat memperbaikinya. Di mana perencanaan ukuran sampel keliru membahas perbedaannya, dan cara Anda menarik sampel adalah yang menentukannya.
Jawaban singkat, jika Anda hanya ingin satu angka
Angka-angka kunci
- 385 respons lengkap adalah jawaban bawaan. Itulah hasil rumus pada tingkat kepercayaan 95 persen, margin kesalahan plus minus 5 poin persentase, dan tanpa estimasi awal atas hasilnya.
- Populasi kecil memerlukan jauh lebih sedikit. Daftar berisi 1.000 orang memerlukan 278. Daftar berisi 100 orang memerlukan 80. Itulah hasil kerja koreksi populasi terbatas.
- Presisi itu mahal. Membagi dua margin kesalahan melipatgandakan sampel sekitar empat kali. Beralih dari plus minus 5 poin ke plus minus 1 poin membawa Anda dari 385 ke 9.604.
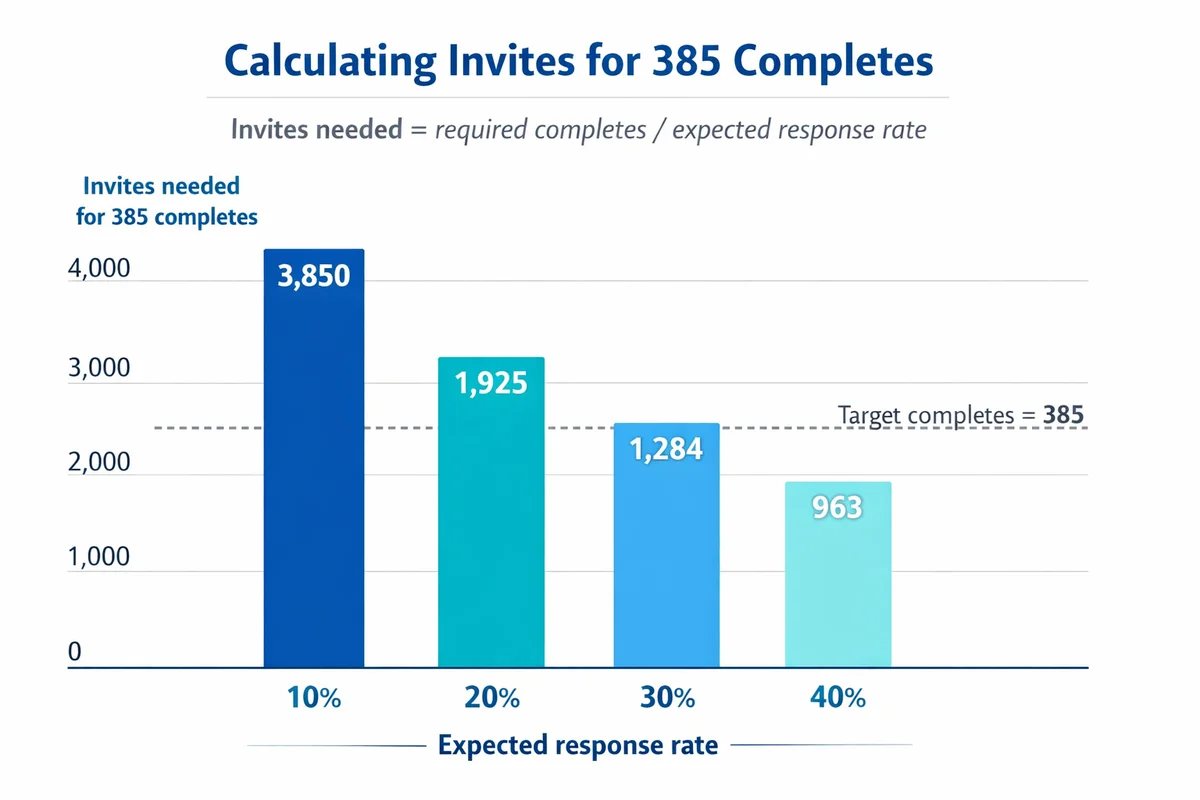
- Rumus menghitung respons lengkap, bukan undangan. Undangan yang diperlukan sama dengan respons lengkap dibagi perkiraan tingkat respons Anda. Pada 30 persen, 385 respons lengkap berarti mengundang 1.284 orang.
- Margin kesalahan hanya mencakup satu jenis kesalahan. Margin kesalahan mengukur derau akibat mengambil sampel sebagian orang alih-alih semuanya. Margin kesalahan tidak mengatakan apa pun tentang orang yang tidak pernah menjawab.
Rumus ukuran sampel, dan cara menghitungnya secara manual
Untuk survei yang melaporkan persentase, titik awal standarnya adalah ukuran sampel untuk populasi yang cukup besar sehingga dapat dianggap tidak terbatas:
n0 = (z^2 x p x (1 - p)) / E^2
Dibaca dari kiri ke kanan:
- n0 adalah respons lengkap yang diperlukan, sebelum koreksi populasi apa pun.
- z adalah skor z untuk tingkat kepercayaan Anda. Gunakan 1,96 untuk 95 persen.
- p adalah proporsi yang Anda perkirakan akan diukur, dalam bentuk desimal. Gunakan 0,5 jika Anda tidak tahu.
- E adalah margin kesalahan dalam bentuk desimal. Lima poin persentase adalah 0,05.
Simbol untuk ukuran sampel adalah n. Sebagian sumber menulis angka sebelum koreksi sebagai n0 dan angka setelah koreksi sebagai n, dan konvensi itulah yang dipakai di sini.
| Tingkat kepercayaan | z | Biayanya bagi Anda |
|---|---|---|
| 80 persen | 1.282 | 165 respons lengkap pada plus minus 5 poin |
| 90 persen | 1.645 | 271 respons lengkap |
| 95 persen (standar) | 1.960 | 385 respons lengkap |
| 99 persen | 2.576 | 664 respons lengkap |
| 99,9 persen | 3.291 | 1.084 respons lengkap |
Contoh perhitungan: dari 385 menjadi daftar undangan
Skenario. Anda ingin mengetahui persentase pelanggan yang akan merekomendasikan Anda. Anda menginginkan tingkat kepercayaan 95 persen dan plus minus 5 poin. Anda tidak punya estimasi awal, jadi p = 0,5.
Pilih tingkat kepercayaan dan margin kesalahan Anda
Tingkat kepercayaan 95 persen menetapkan z = 1,96. Plus minus 5 poin persentase adalah E = 0,05.
Pilih hasil yang diperkirakan
p = 0,5, karena tidak ada estimasi awal dan 0,5 menghasilkan sampel terbesar. Tidak ada hal yang Anda ketahui kemudian yang dapat membuat sampel Anda kurang.
Terapkan rumus ukuran sampel
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Bulatkan ke atas: 385 respons lengkap. Selalu bulatkan ke atas. Anda tidak dapat mengumpulkan pecahan dari sebuah survei.
Koreksi untuk populasi kecil
Jika pelanggan itu berupa daftar berisi 1.000 orang, bukan pasar terbuka, terapkan koreksinya: n = 384,16 / (1 + 383,16 / 1.000) = 384,16 / 1,38316 = 277,7, jadi 278 respons lengkap. Koreksi ini baru berpengaruh ketika sampel merupakan bagian besar dari populasi.
Ubah respons lengkap menjadi undangan
Dengan tingkat respons 30 persen, undangan = 278 / 0,30 = 926,7, jadi undang 927 orang. Respons lengkap adalah yang dihitung oleh rumus. Undangan adalah yang benar-benar Anda kirim, dan jumlahnya tidak pernah boleh melebihi populasi tempat Anda menarik sampel.
Pada tingkat kepercayaan 95 persen dengan p = 0,5, seluruh rumus menyusut menjadi 0,9604 dibagi E kuadrat. Satu jalan pintas itu menjawab sebagian besar pertanyaan tentang ukuran sampel dalam satu baris, dan itulah sebabnya angka 385 terus muncul dalam tabel ukuran sampel yang Anda temukan di tempat lain.
Tabel ukuran sampel untuk ukuran populasi yang umum
Angka-angka ini dihitung dengan rumus di atas pada tingkat kepercayaan 95 persen, plus minus 5 poin, dan p = 0,5, lalu dikoreksi untuk populasinya. Dua kolom terakhir adalah pemeriksaan kami sendiri terhadap tabel yang diterbitkan Krejcie dan Morgan pada 1970, yaitu tabel yang dikutip oleh sebagian besar bab metodologi.
| Populasi (N) | Respons lengkap yang diperlukan | Krejcie dan Morgan (1970) | Selisih |
|---|---|---|---|
| 10 | 10 | 10 | sama |
| 25 | 24 | tidak tercantum | |
| 50 | 45 | 44 | 1 lebih banyak |
| 100 | 80 | 80 | sama |
| 200 | 132 | 132 | sama |
| 500 | 218 | 217 | 1 lebih banyak |
| 1,000 | 278 | 278 | sama |
| 2,000 | 323 | 322 | 1 lebih banyak |
| 5,000 | 357 | 357 | sama |
| 10,000 | 370 | 370 | sama |
| 50,000 | 382 | 381 | 1 lebih banyak |
| 100,000 | 383 | 384 | 1 lebih sedikit |
Cara kami memeriksanya. Kami menjalankan rumus pada 21 ukuran populasi dan membandingkan setiap hasil dengan nilai Krejcie dan Morgan yang diterbitkan. Dua belas cocok persis. Sembilan lainnya berbeda tepat satu respons, yang berasal dari titik pembulatan masing-masing metode, bukan dari perbedaan aritmetika. Jika pembimbing bertanya mengapa angka Anda berbeda satu dari tabel, itulah alasannya.
Perlu diketahui jika Anda mengutip tabel itu: Krejcie dan Morgan tidak menurunkan rumus mereka sendiri. Makalah mereka tahun 1970 hanya sekitar 400 kata ditambah satu tabel, dan satu-satunya referensinya menyebutkan rumus itu berasal dari buletin penelitian tahun 1960 dari National Education Association. Ringkasan mereka sendiri tentang polanya masih merupakan deskripsi satu kalimat terbaik: seiring bertambahnya populasi, sampel yang diperlukan meningkat dengan laju yang makin kecil dan akhirnya stabil di sedikit lebih dari 380 kasus.
Memilih input Anda, satu per satu
Empat angka menentukan jawabannya. Tiga di antaranya adalah keputusan, bukan fakta, dan masing-masing memiliki cara pemilihan yang dapat dipertanggungjawabkan.
Tingkat kepercayaan: seberapa sering metodenya benar
Tingkat kepercayaan menggambarkan metodenya, bukan survei tertentu ini. Pada tingkat kepercayaan 95 persen, interval yang dibuat dengan cara ini memuat nilai sebenarnya 95 kali dari 100 dalam jangka panjang. Ini bukan peluang 95 persen bahwa jawaban spesifik Anda benar.
Gunakan 95 persen kecuali Anda punya alasan untuk tidak melakukannya. Beralih ke 99 persen menaikkan sampel dari 385 menjadi 664 untuk presisi yang sama, yaitu kenaikan biaya 72 persen untuk manfaat yang sangat kecil. Gagasan terkait dalam pengujian hipotesis adalah alfa, dan itulah sebabnya orang mencampuradukkan keduanya. Jika perbedaan itu masih kabur, baca signifikansi statistik dan arti nilai p sebelum Anda memilih angka.
Margin kesalahan: variabel keputusan
Inilah input yang paling perlu dipikirkan dengan sungguh-sungguh, karena hanya input ini yang mengaitkan sampel dengan sebuah keputusan. Pilihlah dengan bertanya selisih berapa yang akan mengubah tindakan Anda.
Jika Anda bertindak berbeda ketika kepuasan 72 persen dibandingkan 74 persen, Anda memerlukan margin yang sempit. Jika Anda hanya bertindak pada 72 dibandingkan 82, plus minus 5 poin sudah lebih dari cukup. Pelaporan ringkas yang umum biasanya memakai 5 poin untuk pemeriksaan cepat atau 3 poin untuk pemantauan berkala. Di bawah 2 poin, biayanya naik dengan cepat.
Ukuran populasi: sebagian besar tidak relevan, sampai menjadi relevan
Untuk populasi besar, sampel yang diperlukan nyaris tidak berubah. Sepuluh ribu orang memerlukan 370 respons. Seratus ribu memerlukan 383. Ukuran populasi baru berpengaruh ketika sampel Anda merupakan bagian yang berarti dari populasi itu, seperti pada daftar karyawan, daftar anggota, dan angkatan sekolah. Itulah yang dibahas di bagian berikutnya.
Hasil yang diperkirakan (p): gunakan 0,5 jika Anda tidak tahu
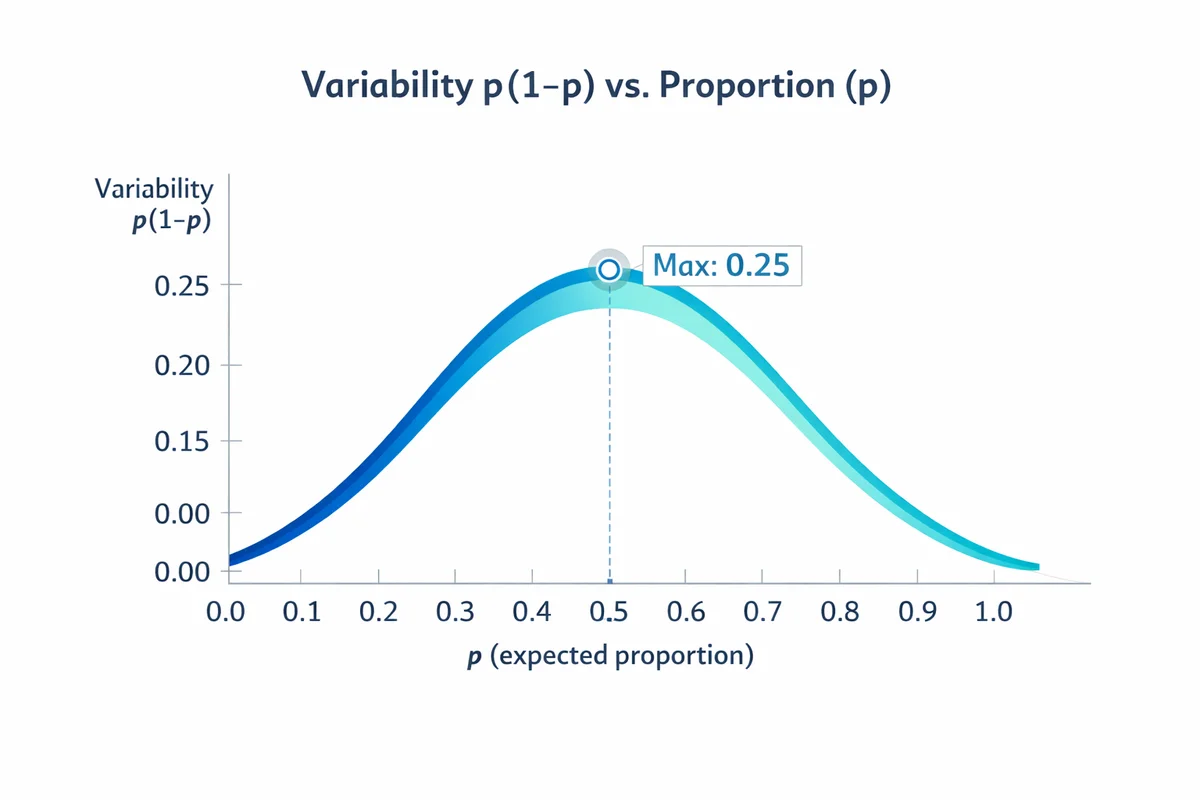
Untuk pertanyaan berbentuk persentase, ketidakpastian ditentukan oleh p dikali (1 dikurangi p). Suku itu paling besar pada p = 0,5, sehingga 0,5 adalah pilihan konservatif dan menghasilkan sampel terbesar. Itulah nilai bawaan yang tepat ketika Anda tidak punya estimasi awal.
Jika Anda punya estimasi, gunakanlah, karena penghematannya besar. Pada tingkat kepercayaan 95 persen dan plus minus 5 poin, p = 0,5 memerlukan 385 respons dan p = 0,9 memerlukan 139. Survei sebelumnya, studi pilot, atau tolok ukur yang diterbitkan semuanya sumber yang wajar untuk estimasi itu. Pertanyaan yang ambigu juga memperlebar sebaran, sehingga kata-kata yang lebih jelas dapat menstabilkan hasil tanpa respons tambahan. Menulis pertanyaan survei yang lebih baik sering kali lebih murah daripada mengumpulkan lebih banyak respons.
Populasi kecil: koreksi populasi terbatas
Rumus dasar mengasumsikan Anda menarik sampel dari kumpulan yang cukup besar sehingga mengambil orang dari kumpulan itu tidak mengubah apa pun. Begitu sampel Anda menjadi irisan nyata dari populasi, asumsi itu membuat Anda membayar terlalu mahal. Koreksi populasi terbatas mengembalikan respons yang berlebih itu.
n = n0 / (1 + ((n0 - 1) / N))
- n adalah jumlah respons lengkap yang diperlukan setelah dikoreksi.
- n0 adalah angka sebelum koreksi dari rumus di atas.
- N adalah ukuran populasi.
Pemicu yang biasa adalah n0 lebih dari sekitar 5 persen dari N. Di bawah itu, koreksinya hampir tidak mengubah apa pun, jadi tidak perlu dijelaskan kepada siapa pun.
Contoh perhitungan: survei karyawan
Skenario. Anda memiliki 1.200 karyawan. Anda menginginkan tingkat kepercayaan 95 persen, plus minus 5 poin, dan Anda memakai p = 0,5.
- Sebelum koreksi, n0 = 384,16.
- Setelah koreksi: n = 384,16 / (1 + (383,16 / 1.200)) = 384,16 / 1,3193 = 291,2.
- Bulatkan ke atas: 292 respons lengkap.
Tanpa koreksi, Anda akan mengejar 385 respons dari daftar berisi 1.200 orang, yaitu 32 persen dari semua orang. Dengan koreksi, 292 respons memberi presisi yang sama. Pada daftar sebesar itu, artinya ada sebulan pengejaran yang tidak perlu Anda lakukan.
Di bawah sekitar 200 orang, sampel yang sudah dikoreksi merupakan bagian yang begitu besar dari daftar sehingga mengundang semua orang lebih sederhana dan lebih dapat dipertanggungjawabkan. Sensus terhadap 150 orang sama sekali tidak memiliki kesalahan sampel. Upaya Anda kemudian dicurahkan untuk tingkat respons dan untuk mencari tahu siapa yang tidak ada, dan memang di situlah upaya itu seharusnya dicurahkan.
Margin kesalahan: rumus yang sama, dijalankan terbalik
Margin kesalahan adalah pita plus minus di sekitar hasil survei yang muncul karena Anda bertanya kepada sebagian orang, bukan kepada semuanya. Jika 62 persen dari 385 responden memilih suatu opsi dan margin kesalahannya 5 poin, Anda melaporkan 62 persen dan menyatakan bahwa rentang yang masuk akal adalah 57 hingga 67 persen.
Menyusun ulang rumus ukuran sampel untuk mencari E menghasilkan:
E = z x akar kuadrat dari (p x (1 - p) / n)
Untuk populasi terbatas, kalikan hasilnya dengan akar kuadrat dari (N - n) dibagi (N - 1). Kedua versi ada di kalkulator di bawah, yang beralih secara otomatis ketika Anda mencentang atau menghapus centang kotak populasi.
Berapa margin kesalahan dari respons yang sudah saya miliki?
Rumus yang sama, disusun ulang. Masukkan respons yang Anda kumpulkan dan baca kembali presisinya.
Margin kesalahan
5.0
Poin persentase, plus minus.
Interval Anda
45.0 hingga 55.0
Persen, pada tingkat kepercayaan 95 persen.
Aritmetikanya, langkah demi langkah
Apakah margin kesalahan bertambah seiring ukuran sampel?
Margin kesalahan justru menyusut, dan menyusut sebanding dengan akar kuadrat dari n. Akar kuadrat itulah seluruh ekonomi survei. Empat ratus respons memberi Anda separuh kesalahan dari seratus respons. Untuk membaginya dua lagi, Anda memerlukan 1.600. Setiap tambahan satu angka desimal presisi memerlukan kira-kira empat kali kerja lapangan, dan itulah sebabnya 385 menjadi titik yang begitu umum: di situlah biaya dan presisi berhenti bertentangan.
Empat istilah yang sering tertukar
Galat baku, margin kesalahan, tingkat kepercayaan, dan interval kepercayaan sering dipakai seolah-olah dapat saling menggantikan. Keempatnya hal yang berbeda, dan perbedaannya penting ketika seseorang mempertanyakan angka Anda.
| Istilah | Artinya | Pada 385 respons dan 50 persen |
|---|---|---|
| Galat baku | Sebaran mentah dari estimasi. Akar kuadrat dari p dikali (1 dikurangi p) dibagi n. | 0,0255, atau 2,55 poin persentase |
| Margin kesalahan | Galat baku dikalikan skor z untuk tingkat kepercayaan yang Anda pilih. | Plus minus 5,0 poin pada 95 persen |
| Tingkat kepercayaan | Skor z yang Anda pilih, dinyatakan sebagai persentase. Sebuah pilihan, bukan hasil pengukuran. | 95 persen, jadi z = 1,96 |
| Interval kepercayaan | Hasil setelah margin kesalahan diterapkan, ditulis sebagai rentang. | 45,0 persen hingga 55,0 persen |
Versi singkatnya: galat baku adalah sifat data Anda, tingkat kepercayaan adalah pilihan yang Anda buat, margin kesalahan adalah hasil perkalian keduanya, dan interval kepercayaan adalah yang Anda cetak dalam laporan.
Apa yang tidak dicakup margin kesalahan
Margin kesalahan mencakup kesalahan sampel acak dan tidak ada yang lain. Margin kesalahan tidak mencakup orang yang mengabaikan undangan, daftar yang tidak memuat sebagian populasi, atau pertanyaan yang dibaca separuh responden secara berbeda dari maksud Anda. Sebuah survei bisa memiliki margin kesalahan yang rapi dan tetap keliru. Lihat bias respons dan bias nonrespons untuk kesalahan yang tidak dapat diperbaiki oleh ukuran sampel apa pun.
Badan profesi untuk riset survei menyatakan hal ini lebih terus terang daripada kebanyakan vendor. AAPOR menyatakan bahwa tidak ada margin kesalahan keseluruhan yang dapat diukur untuk sebuah jajak pendapat, karena survei membawa kesalahan lain yang sama sekali tidak dapat diukur, mulai dari cara pertanyaan ditulis hingga cara wawancara dijalankan. Yang dapat Anda hitung adalah bagian sampelnya. Itulah bagian yang diberikan kalkulator ini, dan perlu ditegaskan bahwa itu hanya sebagian.
Dua aturan penggunaan dari sumber yang sama, keduanya sering salah dalam tulisan tentang survei:
- Satuannya poin persentase, bukan persen. Tulis "plus minus 3 poin persentase", bukan "plus minus 3 persen". Keduanya berarti hal yang berbeda.
- Margin kesalahan sama sekali tidak berlaku untuk sampel opt-in. Margin kesalahan mengasumsikan setiap orang memiliki peluang terpilih yang diketahui dan tidak nol. Tautan terbuka, panel sukarelawan, atau unggahan media sosial tidak memenuhi syarat itu. Memublikasikan margin kesalahan di samping hasil dari tautan terbuka berarti mengklaim presisi yang tidak Anda beli.
Mengubah respons lengkap menjadi undangan
Rumus memberi Anda respons yang selesai. Kerja lapangan memberi Anda tingkat respons. Celah di antara keduanya adalah tempat rencana sampel biasanya gagal, dan aritmetikanya hanya satu baris:
Undangan = respons lengkap yang diperlukan / perkiraan tingkat respons
Gunakan tingkat respons dalam bentuk desimal, jadi 30 persen adalah 0,30, lalu bulatkan ke atas. Untuk 292 respons lengkap pada 35 persen, hasilnya 292 dibagi 0,35 = 834,3, jadi undang setidaknya 835 orang.
| Respons lengkap yang diperlukan | Perkiraan tingkat respons | Undangan |
|---|---|---|
| 385 | 60 persen | 642 |
| 385 | 30 persen | 1,284 |
| 385 | 15 persen | 2,567 |
| 292 | 50 persen | 584 |
| 292 | 35 persen | 835 |
| 292 | 20 persen | 1,460 |
Memilih tingkat respons yang dapat Anda pertanggungjawabkan
Riwayat Anda sendiri mengalahkan tolok ukur terbitan mana pun, selama audiensnya sama, salurannya sama, dan panjang surveinya serupa. Jika Anda tidak punya pegangan sama sekali, rencanakan tiga skenario pada 20, 30, dan 40 persen, dan perlakukan daftar undangan sebagai tuas yang dapat disesuaikan selama kerja lapangan. Pengingat, periode yang lebih panjang, dan daftar yang lebih luas semuanya dapat Anda ubah di tengah jalan. Target respons lengkap tidak dapat diubah.
Sebagian besar tabel tolok ukur di internet mengutip satu angka rata-rata tanpa sumber. Tidak ada satu rata-rata tunggal. Berikut ini yang sebenarnya dilaporkan oleh sumber-sumber primer, agar Anda dapat mengutip baris yang sesuai dengan situasi Anda, bukan angka yang dikarang seseorang.
| Konteks | Tingkat respons | Skala dan sumber |
|---|---|---|
| Lembaga federal AS dengan kurang dari 1.000 staf | 71 persen | Federal Employee Viewpoint Survey 2024 (OPM) |
| Lembaga federal AS dengan 1.000 hingga 9.999 staf | 60 persen | Survei yang sama, tahun yang sama (OPM) |
| Lembaga federal AS dengan lebih dari 75.000 staf | 37 persen | Survei yang sama, tahun yang sama (OPM) |
| Seluruh pegawai federal AS | 41 persen | Lebih dari 1,6 juta diundang, lebih dari 674.000 menjawab, 2024 (OPM) |
| Survei online yang diterbitkan, semua jenis | Rata-rata 44,1 persen | Meta-analisis atas 1.071 tingkat respons yang dilaporkan (Wu dan kawan-kawan, 2022) |
| Penelitian organisasi yang diterbitkan | 68 persen pada 2020, naik dari 48 persen pada 2005 | 1.014 survei di 17 jurnal (Holtom dan kawan-kawan, 2022) |
| Jajak pendapat telepon terhadap masyarakat umum | 6 persen pada 2018, turun dari 36 persen pada 1997 | Tingkat respons yang dipantau sendiri oleh Pew Research Center (Kennedy dan Hartig, 2019) |
| Moda web dibandingkan moda lain mana pun | sekitar 12 poin lebih rendah | Meta-analisis atas 114 perbandingan eksperimental (Daikeler dan kawan-kawan, 2020) |
Dua hal dapat disimpulkan dari tabel itu. Pertama, ukuran kelompok yang Anda survei memprediksi tingkat respons lebih baik daripada hampir semua hal lain yang Anda kendalikan. Perusahaan berisi 300 orang dan lembaga berisi 300.000 orang tidak sedang menjalankan survei yang sama. Kedua, klaim yang sering diulang bahwa tingkat respons anjlok di mana-mana hanya benar di sebagian tempat. Jajak pendapat telepon memang anjlok. Penelitian organisasi yang diterbitkan justru bergerak ke arah sebaliknya, dari 48 persen menjadi 68 persen dalam lima belas tahun.
Satu lagi aritmetika perencanaan yang patut dipinjam: pedoman penyuluhan (extension) standar menyarankan menambah sekitar 10 persen ke daftar undangan untuk orang yang sama sekali tidak dapat Anda jangkau, dan sekitar 30 persen untuk orang yang bisa menjawab tetapi tidak menjawab.
Apa kata korpus templat kami sendiri tentang panjang survei
Tingkat respons yang dipinjam dari survei orang lain sulit dipindahkan, dan panjang survei adalah salah satu dari sedikit hal dalam daftar itu yang sepenuhnya Anda kendalikan. Berikut angka yang dapat kami hasilkan dan tidak dapat dihasilkan pesaing, karena angka ini berasal dari menghitung korpus terbitan kami sendiri, bukan dari menanyai praktisi apa yang mereka kira mereka lakukan.
Dalam audit kami pada 21 Agustus 2026, seluruh 87 templat survei berisi 14 pertanyaan atau kurang, dan 86 di antaranya berisi 10 pertanyaan atau kurang. Bersama-sama, templat itu memuat 799 pertanyaan. Mediannya 9 pertanyaan, dan tepat satu templat melebihi 10. Angka-angka ini menggambarkan potret pada tanggal tersebut, bukan pustaka saat ini.
| Pertanyaan dalam templat | Templat | Bagian dari korpus |
|---|---|---|
| 7 pertanyaan | 4 | 5 persen |
| 8 pertanyaan | 17 | 20 persen |
| 9 pertanyaan | 29 | 33 persen |
| 10 pertanyaan | 36 | 41 persen |
| 14 pertanyaan | 1 | 1 persen |
Menurut format jawaban, 355 dari 799 pertanyaan adalah skala rating, 281 adalah daftar pilihan tunggal, dan 163 meminta pembaca mengetik sesuatu. Kelompok terakhir itulah yang membuat Anda kehilangan respons lengkap, jadi kami membacanya satu per satu alih-alih memercayai kolom yang tersimpan. Dari 163 itu, 137 adalah kotak komentar multibaris. 26 sisanya adalah kotak satu baris, dan setelah dibaca, 22 di antaranya ternyata kolom identitas atau klasifikasi singkat: nama, alamat email, tanggal, departemen, jabatan. Hanya 4 yang merupakan jawaban singkat yang substantif. Jadi hitungan jujur untuk pertanyaan yang benar-benar terbuka adalah 141, atau kira-kira satu dari enam pertanyaan, bukan satu dari lima seperti yang akan ditunjukkan kolom mentahnya.
Cara kami menghitung, dan cara kami memeriksanya. Kami mengurai daftar pertanyaan tersimpan dari setiap templat survei yang aktif di situs ini pada 21 Agustus 2026, menyimpan entri yang memuat teks pertanyaan, lalu mengambil setiap halaman yang diterbitkan dan membandingkan kedua kumpulan itu alih-alih memercayai basis data kami sendiri begitu saja. Seluruh 87 halaman mengembalikan HTTP 200, sementara slug yang kami tahu sudah mati mengembalikan 410 dalam proses yang sama, sehingga pemeriksaannya benar-benar membedakan, bukan selalu lolos. 785 dari 799 pertanyaan, atau 98 persen, muncul di halaman yang diterbitkan. Enam dari kecocokan itu berbeda dari basis data hanya pada karakter apostrof yang dipakai, dan kami menghitungnya sebagai cocok, yang lebih baik kami ungkapkan daripada diam-diam dibulatkan. Delapan puluh enam dari 87 templat terverifikasi sepenuhnya. Satu yang tidak terverifikasi adalah templat terpanjang kami, dengan 14 pertanyaan, dan halaman terbitannya saat ini sama sekali tidak menampilkan pratinjau pertanyaan, sehingga pertanyaannya tidak dapat dikonfirmasi dari luar.
Panjang templat tidak memberi tahu Anda tingkat respons undangan. Tolok ukur respons survei kami yang terpisah meneliti perilaku setelah orang berinteraksi dengan survei; tolok ukur itu tidak menghitung semua orang yang diundang. Untuk perencanaan undangan, gunakan tingkat respons yang terdokumentasi dari proyek yang sebanding atau dari studi pilot, dan jaga agar penyebutnya konsisten.
Kegunaan praktisnya sempit tetapi nyata. Jika Anda meminjam tingkat respons untuk jumlah undangan di kalkulator, pinjamlah dari survei yang panjangnya kira-kira sama dengan survei yang akan Anda kirim, kepada audiens serupa melalui saluran serupa. Instrumen terbitan kami sendiri berisi antara 7 dan 10 pertanyaan, lebih pendek daripada kebanyakan draf awal.
Lebih banyak undangan tidak membuat bias lebih kecil
Tingkat respons yang rendah menimbulkan dua masalah yang tampak seperti satu. Yang pertama, Anda berakhir di bawah target, sehingga margin kesalahan Anda lebih lebar daripada yang direncanakan. Yang kedua, orang yang menjawab mungkin berbeda dari orang yang tidak menjawab, dengan cara yang penting bagi hasil Anda.
Mengundang lebih banyak orang memperbaiki masalah pertama. Cara itu tidak selalu memperbaiki masalah kedua. Groves dan Peytcheva menggabungkan 59 studi yang mengukur bias nonrespons yang sebenarnya terhadap kebenaran yang diketahui, dan hanya menemukan hubungan kecil antara tingkat respons sebuah survei dan seberapa bias survei itu ternyata. Pew menguji gagasan yang sama secara langsung: mereka menjalankan satu kuesioner dua kali, sekali dengan metode standar yang menghasilkan tingkat respons 9 persen dan sekali dengan protokol upaya tinggi yang menghasilkan 22 persen. Dari 40 pertanyaan yang sama di kedua survei, 28 hasilnya berselisih tidak lebih dari 2 poin.
Kasus tandingan yang jujur. Temuan itu tidak berlaku untuk setiap topik, dan perlu diketahui di mana temuan itu tidak berlaku. Dalam survei kepuasan, hubungannya nyata dan besar. Sebuah studi atas 717 survei kepuasan pasien rumah sakit di 164 rumah sakit Swiss menemukan bahwa rata-rata skor kepuasan dan tingkat respons berkorelasi pada r = 0,61, karena orang yang sangat senang dan yang sangat marah menjawab, sementara kelompok tengah yang biasa-biasa saja tidak. Jika Anda menjalankan CSAT atau NPS, kenaikan tingkat respons dapat menggeser skor Anda dengan sendirinya, dan tingkat respons yang rendah mungkin membuat hasil Anda tampak lebih baik.
Jadi: kejarlah tingkat respons ketika Anda mengukur perasaan orang terhadap Anda. Jangan memperlakukannya sebagai sertifikat validitas ketika Anda mengukur hal lain.
Ukuran sampel untuk penelitian kuantitatif: apa yang diperlukan bab metodologi
Tidak ada satu ukuran sampel yang baik untuk penelitian kuantitatif, dan sumber mana pun yang memberi Anda satu angka tanpa menanyakan apa yang Anda ukur hanya menebak. Yang membuat bab metodologi disetujui bukanlah angka yang besar, melainkan angka yang dinyatakan, dengan tingkat kepercayaan, margin kesalahan, proporsi yang diasumsikan, dan populasi ditulis di sampingnya, serta nama rumus yang dipakai.
Pembimbing cenderung mengharapkan salah satu dari empat pendekatan bernama. Keempatnya sebagian besar saling sepakat, dan ada baiknya Anda tahu pendekatan mana yang diminta dari Anda.
| Nama pendekatan | Apa yang diminta dari Anda | Hasil untuk N = 1.000 pada 95 persen dan 5 poin | Gunakan bila |
|---|---|---|---|
| Cochran (1977) | z, p, E, lalu koreksi populasi terbatas jika populasinya kecil | 278 | Pilihan bawaan. Inilah rumus di halaman ini, dan rumus yang menjadi dasar turunan pendekatan lainnya. |
| Krejcie dan Morgan (1970) | Tidak ada. Anda membaca jawabannya dari tabel terbitan berdasarkan ukuran populasi. | 278 | Anda menginginkan tabel yang dapat dikutip, bukan aritmetika. Pendekatan ini adalah Cochran dengan pengaturan tetap. |
| Yamane (1967), sering disebut Slovin | Hanya N dan margin kesalahan | 286 | Hanya ketika p benar-benar tidak diketahui dan Anda menerima tingkat kepercayaan 95 persen yang sudah tertanam di dalamnya. Lihat peringatan di bawah. |
| Analisis kekuatan uji (power analysis) | Ukuran efek, kekuatan uji, alfa, dan uji yang akan Anda jalankan | Sepenuhnya bergantung pada ukuran efek | Anda sedang menguji hipotesis, bukan mengestimasi persentase. Gunakan G*Power atau OpenEpi, bukan halaman ini. |
Cochran, dan mengapa semua pendekatan lain adalah jalan pintasnya
Rumus Cochran adalah rumus di bagian atas halaman ini: n0 = z kuadrat dikali p dikali (1 dikurangi p), dibagi E kuadrat, diikuti koreksi populasi terbatas bila populasinya kecil. Metode bernama lainnya menetapkan sebagian input tersebut agar aritmetikanya lebih singkat. Begitu Anda memahami hal itu, keluarga ini tidak lagi tampak seperti empat aturan yang bersaing, melainkan satu aturan dengan tiga pengaturan siap pakai.
Yamane dan Slovin: gunakan dengan mata terbuka
Rumus n = N / (1 + N x e^2) muncul di ribuan skripsi dan tesis, biasanya disebut sebagai rumus Slovin. Rumus ini cepat: untuk N = 1.000 dan e = 0,05 hasilnya 286.
Ada tiga hal yang perlu diketahui sebelum Anda mengutipnya.
- Rumus ini adalah Cochran dengan pengaturan yang dikunci mati. Jika ditelusuri mundur, rumus ini adalah rumus proporsi dengan p ditetapkan 0,5, tingkat kepercayaan ditetapkan 95 persen, dan z dibulatkan dari 1,96 menjadi 2. Rumus ini tidak dapat menjawab pertanyaan pada tingkat kepercayaan lain, dan sama sekali tidak punya input untuk seberapa beragam populasi Anda. Dua populasi berukuran sama tetapi dengan sebaran yang sangat berbeda mendapat jawaban yang sama, dan itu tidak mungkin benar.
- Pembulatan itulah sebabnya angkanya cenderung tinggi. Dengan z = 2, batas atas rumus ini untuk populasi tak terbatas tepat 1 dibagi e kuadrat, yaitu 400. Batas atas Cochran adalah 384,16, karena 1,96 kuadrat adalah 3,8416, bukan 4. Setiap angka Yamane di tabel di atas beberapa persen lebih besar daripada angka Cochran tepat karena alasan itu. Jika Anda pernah bertanya-tanya mengapa dua buku teks memberi dua ukuran sampel berbeda untuk studi yang sama, biasanya itulah jawabannya.
- Atribusinya tidak dapat dipertahankan. Sebuah jurnal statistik menelusuri sejarah rumus ini dan menyimpulkan bahwa tidak ada orang bernama Slovin yang dapat ditemukan di baliknya, dan bahwa sumber tertua yang dapat ditelusuri adalah buku teks Taro Yamane tahun 1967. Wolfram MathWorld menggambarkannya sebagai rumus ad hoc yang tidak memiliki ketelitian matematis. Jika departemen Anda mengharapkannya, gunakanlah dan kutip Yamane, bukan Slovin. Jika Anda punya pilihan, gunakan Cochran, karena rumus itu dapat menjawab pertanyaan dari mana angka 95 persen berasal.
Patokan kasar, dinilai dengan jujur
Patokan-patokan ini beredar luas. Sebagian berguna, sebagian hanya cerita turun-temurun, dan ada baiknya Anda tahu mana yang mana.
- Minimal 30 per kelompok. Masuk akal sebagai batas bawah untuk perbandingan kelompok, bukan sebagai target. Angka ini berasal dari titik ketika distribusi sampling mulai berperilaku baik, bukan dari persyaratan presisi apa pun.
- Sepuluh kasus per variabel dalam regresi. Heuristik kerja yang banyak dipakai dan banyak dikritik. Sebutkan sebagai heuristik, jangan pernah sebagai aturan.
- Sepuluh persen dari populasi. Patokan ini memang salah, dan tabel di atas menunjukkan sebabnya. Sepuluh persen dari 100.000 adalah 10.000 respons, padahal 383 sudah memberi presisi yang sama.
- Selalu 385. Hanya benar untuk populasi besar pada 95 persen dan 5 poin. Kutip angka itu beserta syarat-syaratnya, atau angka itu tidak berarti apa-apa.
- n kecil untuk studi kegunaan dan produk. Nielsen Norman Group menerbitkan versi jujurnya: 40 partisipan memberi Anda ukuran ya atau tidak hingga plus minus 15 poin pada tingkat kepercayaan 95 persen, dan 47 partisipan memberi Anda rata-rata dengan presisi yang sama. Angka-angka itu kecil karena presisi yang diklaim longgar. Nyatakan presisinya secara terbuka, dan sampel kecil tidak lagi memalukan.
Jika studi Anda membandingkan kelompok alih-alih mengestimasi satu persentase, ukuran sampel menjadi persoalan kekuatan uji dan ini bukan kalkulator yang tepat. Anda memerlukan ukuran efek yang siap Anda pertanggungjawabkan, ditambah alfa dan kekuatan uji. G*Power dan OpenEpi adalah alat yang paling sering diharapkan pembimbing, dan keduanya gratis. Menyatakan di mana sebuah alat berhenti lebih berguna daripada berpura-pura alat itu bisa melakukan segalanya.
Penelitian kualitatif menentukan ukurannya dengan cara berbeda
Wawancara dan diskusi kelompok terarah tidak ditentukan ukurannya dengan margin kesalahan, karena keduanya tidak mengestimasi persentase populasi. Argumen yang biasa dipakai adalah saturasi: Anda terus menambah partisipan sampai partisipan baru tidak lagi memunculkan tema baru, lalu melaporkan kapan hal itu terjadi dan bagaimana Anda menilainya. Menjalankan studi kualitatif melalui kalkulator ini menghasilkan angka yang tampak presisi tetapi tidak berarti apa-apa.
Jika Anda memerlukan hasil per subkelompok, tentukan ukuran untuk subkelompok
Sebagian besar survei diminta melaporkan per wilayah, jabatan, masa kerja, atau lini produk. Di sinilah rencana sampel diam-diam gagal, dan aturannya singkat.
Margin kesalahan Anda hanya berlaku untuk suatu kelompok jika kelompok itu memiliki respons lengkap sebanyak itu. Jika Anda menginginkan plus minus 5 poin untuk masing-masing dari enam wilayah, Anda memerlukan sekitar 385 respons lengkap di setiap wilayah, bukan 385 secara total. Itu survei yang enam kali lebih besar daripada yang Anda kira sedang Anda rencanakan.
Dua jalan keluar yang jujur:
- Lakukan oversampling pada kelompok kecil. Dengan sengaja undang bagian yang lebih besar dari segmen yang lebih kecil agar masing-masing mencapai targetnya sendiri. Anda membobot hasilnya kembali sesudahnya.
- Terima pita yang lebih lebar untuk rincian per kelompok. Pertahankan satu angka keseluruhan yang kuat dan publikasikan setiap subkelompok dengan margin kesalahannya sendiri yang lebih besar di sampingnya. Biasanya inilah jawaban yang tepat.
Kalkulator menyediakan kolom untuk ini. Isi Subkelompok yang dilaporkan terpisah dengan jumlah kelompok yang hasilnya wajib Anda sajikan, dan kalkulator akan menghitung ukuran setiap kelompok dengan benar lalu menjumlahkannya.
Tentukan cakupannya sebelum turun ke lapangan. Daftar segmen yang wajib Anda laporkan, bukan yang sekadar bagus untuk dimiliki. Perkirakan respons lengkap yang realistis dari masing-masing segmen, menggunakan pertanyaan demografis untuk mengidentifikasinya. Jika suatu segmen hanya dapat menghasilkan 80 respons, jangan menjanjikan plus minus 5 poin untuknya. Pada 80 respons, pitanya plus minus 11 poin.
AAPOR memakai contoh perhitungan yang layak dihafal. Survei terhadap 1.000 orang dewasa memiliki margin kesalahan keseluruhan sekitar plus minus 3 poin. Jika 200 orang di antaranya adalah subkelompok yang benar-benar ingin Anda bahas, margin kesalahan subkelompok itu adalah plus minus 6,9 poin, lebih dari dua kali lipat. Angka utama di halaman depan laporan bukanlah angka yang berlaku untuk grafik di halaman sembilan.
Pedoman terbitan tentang ukuran sel minimum lebih tua dan lebih longgar daripada rumus-rumusnya, dan wajar diperlakukan sebagai batas bawah, bukan target: sekitar 100 respons untuk subkelompok yang akan Anda laporkan dengan layak, dan 20 hingga 50 untuk subkelompok kecil yang hanya akan Anda sebut sekilas.
Di mana perencanaan ukuran sampel keliru
Ukuran sampel mengelola kesalahan sampel, yaitu derau acak karena tidak menanyai semua orang. Survei nyata juga membawa kesalahan sistematis, yang tidak dapat diperbaiki ukuran sampel apa pun dan dapat disamarkan oleh sampel yang besar.
Memperlakukan sampel convenience seperti sampel probabilitas
Setiap rumus di sini mengasumsikan setiap orang memiliki peluang terpilih yang diketahui dan tidak nol, serta bahwa kesediaan menjawab tidak berkaitan erat dengan apa yang Anda ukur. Tautan terbuka di media sosial tidak memenuhi kedua syarat itu. Anda tetap dapat menghitung margin kesalahan dari respons yang ada, angkanya akan tampak meyakinkan, dan angka itu tidak berarti seperti yang dikatakannya. Nyatakan dengan jelas jenis sampel apa yang sebenarnya Anda tarik.
Menganggap n yang lebih besar sebagai pengukuran yang lebih baik
Sampel yang besar membuat pengukuran yang kacau menjadi kacau secara presisi. Jika sebuah pertanyaan ambigu, bermakna ganda, atau menggiring, lebih banyak respons tidak akan menyelamatkannya. Banyaknya pertanyaan yang dilewati dan jawaban yang tidak konsisten adalah tanda untuk memperbaiki instrumennya lebih dulu. Menulis ulang satu pertanyaan yang buruk sering kali lebih berguna daripada melipattigakan sampel.
Memilih presisi tanpa keputusan di baliknya
Presisi baru memiliki jawaban yang benar setelah Anda tahu untuk apa presisi itu. Ukuran sampel mudah dipertanggungjawabkan jika Anda dapat menyelesaikan kalimat ini: kami perlu membedakan hasil yang selisihnya X poin. Ukuran sampel mustahil dipertanggungjawabkan jika satu-satunya alasannya adalah angka yang lebih besar terasa lebih aman. Kaitkan kembali dengan desain penelitian Anda dan dengan apa yang akan Anda lakukan terhadap hasilnya.
Angka-angka di halaman ini, dan seberapa kuat angka-angka itu
Setiap angka yang dikutip di atas adalah aritmetika yang dapat Anda ulangi di kalkulator atau kutipan yang dapat Anda periksa. Tingkat A berarti telah direplikasi atau dapat dihitung langsung, B berarti satu studi kuat, C berarti sering diulang tetapi diperdebatkan.
| Klaim | Angka | Tingkat | Sumber |
|---|---|---|---|
| Pada tingkat kepercayaan 95 persen tanpa estimasi awal, populasi besar memerlukan 385 respons lengkap untuk plus minus 5 poin. | 385 | A | Aritmetika langsung dari rumus proporsi standar. NIST bagian 3.3.3; Israel (1992). |
| Rumus di halaman ini mereproduksi tabel ukuran sampel Krejcie dan Morgan yang diterbitkan dengan selisih paling banyak satu respons pada setiap dari 21 ukuran populasi yang kami periksa. | 21 dari 21 dalam selisih 1 | A | Pemeriksaan kami sendiri terhadap Krejcie dan Morgan (1970). Metode dijelaskan di bawah tabel. |
| Tingkat respons adalah prediktor yang lemah bagi bias nonrespons. Meta-analisis atas 59 studi khusus tentang bias hanya menemukan hubungan kecil antara keduanya. | 59 studi | A | Groves dan Peytcheva (2008), Public Opinion Quarterly. |
| Pew menjalankan kuesioner yang sama pada tingkat respons 9 persen dan 22 persen. Dari 40 pertanyaan yang sama, 28 hasilnya berselisih tidak lebih dari 2 poin. | 28 dari 40 dalam selisih 2 poin | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Namun dalam survei kepuasan, hubungannya nyata dan besar. Pada 717 survei rumah sakit, rata-rata skor kepuasan berkorelasi dengan tingkat respons pada r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux, dan Combescure (2020), BMC Health Services Research. |
| Tingkat respons survei karyawan mengikuti ukuran organisasi hampir dengan sempurna. Pada 2024, survei pegawai federal AS memperoleh 71 persen dari lembaga dengan kurang dari 1.000 orang dan 37 persen dari lembaga dengan lebih dari 75.000 orang. | 71 vs 37 persen | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, lebih dari 1,6 juta pegawai diundang. |
| Rata-rata tingkat respons dari 1.071 survei online yang diterbitkan adalah 44,1 persen. Tidak ada satu tingkat yang normal. | 44,1 persen | A | Meta-analisis Wu, Zhao, dan Fils-Aime (2022), Computers in Human Behavior Reports. |
| Survei web menghasilkan tingkat respons sekitar 12 poin persentase lebih rendah daripada moda lain, dalam 114 perbandingan eksperimental. | 12 poin lebih rendah | A | Meta-analisis Daikeler, Bosnjak, dan Lozar Manfreda (2020), JSSAM. |
| Membagi dua margin kesalahan melipatgandakan sampel yang diperlukan sekitar empat kali, karena n berbanding lurus dengan 1 dibagi E kuadrat. Menggandakan sampel dari 1.000 menjadi 2.000 hanya mempersempit margin kesalahan sekitar satu poin. | sekitar 4x | A | Sifat aljabar rumus; AAPOR menyebutkan kasus 1.000 ke 2.000 secara eksplisit. |
| Mengasumsikan p = 0,5 alih-alih p = 0,9 yang sudah diketahui hampir melipattigakan sampel yang harus Anda kumpulkan, dari 139 menjadi 385. | 139 vs 385 | A | Aritmetika langsung. Dapat diulangi di kalkulator dengan mengubah hasil yang diperkirakan. |
| Seluruh 87 templat survei yang diterbitkan di situs ini berisi 14 pertanyaan atau kurang, dan 86 dari 87 berisi 10 atau kurang. 785 dari 799 pertanyaannya terkonfirmasi di halaman yang diterbitkan. | 87 templat, 799 pertanyaan | A | Hitungan kami sendiri atas korpus templat yang aktif, 21 Agustus 2026, diperiksa kembali terhadap seluruh 87 halaman yang diterbitkan. Metode, audit manual, dan tingkat verifikasi dijelaskan bersama tabelnya. |
| Tidak ada orang bernama Slovin yang dapat ditelusuri di balik rumus yang menyandang nama itu. Sumber tertua yang dapat ditelusuri adalah Yamane (1967). | tidak ada penulis yang dapat ditelusuri | B | Tejada dan Punzalan (2012), The Philippine Statistician; Wolfram MathWorld menyebutnya ad hoc. |
"Anda selalu memerlukan 385 respons." Hanya pada tingkat kepercayaan 95 persen, plus minus 5 poin, p = 0,5, dan populasi besar. Jika dikutip tanpa syarat, angka itu salah untuk setiap populasi kecil.
"Survei 10 persen dari populasi Anda." Tidak ada dasar statistiknya. Patokan ini sangat berlebihan untuk populasi besar dan terlalu sedikit untuk populasi kecil.
"Tingkat respons di bawah 50 atau 60 persen membuat survei tidak sah." Tidak ada ambang batas yang berbuat demikian. Tangga 50, 60, dan 70 persen adalah patokan kasar buku teks tanpa penurunan empiris di baliknya, dan meta-analisis Groves dan Peytcheva membantahnya. Tingkat respons membatasi bias dalam kasus terburuk. Tingkat respons tidak mengukur bias yang sebenarnya.
"Rata-rata tingkat respons survei adalah X persen." Angka terverifikasi dari beberapa tahun yang sama berkisar dari 6 persen hingga 71 persen, sepenuhnya tergantung siapa yang disurvei. Rata-rata tunggal mana pun menyembunyikan hal itu. Kutiplah baris yang sesuai dengan situasi Anda dari tabel di atas.
Rumus Slovin yang disajikan sebagai hasil penurunan. Rumus itu adalah rumus Cochran dengan tingkat kepercayaan 95 persen dan p = 0,5 yang sudah tertanam serta z dibulatkan menjadi 2, dan atribusi kepada Slovin tidak memiliki sumber yang dapat ditelusuri.
Templat justifikasi
Sebagian besar argumen ukuran sampel gagal karena asumsinya tidak pernah dituliskan. Tombol Salin justifikasi di kalkulator menuliskannya dengan angka Anda sendiri di dalamnya. Jika Anda lebih suka menyusunnya sendiri, inilah sembilan hal yang akan dicari oleh penelaah.
- Populasi (N): definisikan populasinya dan sebutkan jumlahnya. Misalnya, semua pelanggan aktif dalam 90 hari terakhir, N = 48.200.
- Apa yang Anda ukur: proporsi (persentase) atau rata-rata (rata-rata rating). Rumus di sini menghitung ukuran untuk proporsi, yang mencakup sebagian besar KPI yang dilaporkan.
- Tingkat kepercayaan: tingkat yang Anda pilih dan alasannya. Konvensi dan toleransi risiko sama-sama alasan yang dapat diterima jika Anda menyatakannya.
- Margin kesalahan (E): target presisi Anda secara keseluruhan, dan secara terpisah untuk setiap subkelompok yang Anda janjikan untuk dilaporkan.
- Proporsi yang diasumsikan (p): nilai yang dipakai, dan asalnya. Nyatakan dengan terus terang jika nilainya 0,5 karena tidak ada yang lebih baik.
- Koreksi populasi terbatas: apakah Anda menerapkannya dan apa pemicunya, misalnya n0 melebihi 10 persen dari N.
- Target respons lengkap (n): jumlah akhir respons lengkap yang diperlukan setelah semua penyesuaian.
- Perkiraan tingkat respons: tingkat yang diasumsikan, riwayat yang menjadi dasarnya, dan jumlah undangan yang dihasilkan.
- Cara Anda memilih orang: acak sederhana, stratified, sensus, atau convenience, ditambah oversampling apa pun untuk segmen utama. Sebutkan dengan jujur.
Setelah survei berjalan di lapangan, terus pantau respons lengkap per segmen, bukan totalnya. Angka keseluruhan yang sehat dapat menyembunyikan segmen yang tidak akan pernah mencapai targetnya, dan itu masalah yang masih dapat Anda perbaiki di minggu pertama tetapi tidak dapat diperbaiki di minggu keempat. Saat melaporkan, sertakan margin kesalahan pada setiap persentase, dan baca cara menganalisis data survei sebelum menganggap pergeseran dua poin sebagai sesuatu yang nyata.
Lembar kerja perencanaan ukuran sampel
Satu halaman yang dapat Anda cetak, isi dengan tangan, dan lampirkan pada ringkasan proyek. Isi kolom tengah sebelum kerja lapangan dimulai, bukan sesudahnya. Tidak ada yang dikirim ke mana pun dan tidak perlu akun.
| Keputusan | Nilai Anda | Petunjuk pengisian |
|---|---|---|
| Populasi (N) | Siapa tepatnya, dan berapa banyak. Tuliskan definisinya, bukan hanya angkanya. | |
| Apa yang Anda ukur | Persentase atau rata-rata. Halaman ini menghitung ukuran untuk persentase. | |
| Tingkat kepercayaan | 95 persen kecuali Anda punya alasan. Tuliskan alasannya. | |
| Margin kesalahan (E) | Selisih yang perlu dapat Anda bedakan, dalam poin. | |
| Proporsi yang diasumsikan (p) | 0,5 jika tidak ada yang lebih baik. Sebutkan asal nilai lain yang dipakai. | |
| Koreksi populasi terbatas | Diterapkan atau tidak, dan apa pemicunya. | |
| Target respons lengkap (n) | Angka akhir setelah semua penyesuaian. | |
| Subkelompok yang dilaporkan terpisah | Berapa banyak, dan respons lengkap yang harus dipenuhi masing-masing. | |
| Perkiraan tingkat respons | Tingkatnya, dan riwayat di baliknya. Bukan angka dari internet. | |
| Undangan yang dikirim | Respons lengkap dibagi tingkat respons, dibulatkan ke atas. Tidak pernah lebih dari N. | |
| Cara orang dipilih | Acak, stratified, sensus, atau convenience. Sebutkan dengan jujur. | |
| Titik pemeriksaan kerja lapangan | Tanggal Anda akan memeriksa respons lengkap per segmen, bukan hanya totalnya. |
Rumus: n0 = (z^2 x p x (1 - p)) / E^2, lalu n = n0 / (1 + (n0 - 1) / N). Sumber: Cochran (1977); NIST/SEMATECH e-Handbook bagian 3.3.3; Israel (1992). Lembar kerja dari https://www.supersurvey.com/Sample-Size
Pertanyaan yang sering diajukan
Apa itu ukuran sampel?
Ukuran sampel adalah jumlah respons lengkap dalam sebuah survei, ditulis sebagai n. Ukuran sampel bukan jumlah orang yang Anda undang, dan bukan ukuran populasi yang Anda gambarkan. Ukuran sampel adalah jumlah yang Anda pegang saat kerja lapangan selesai, dan merupakan angka yang menjadi dasar perhitungan margin kesalahan Anda: 385 respons lengkap memberi sekitar plus minus 5 poin pada tingkat kepercayaan 95 persen ketika populasinya besar. Arti ukuran sampel menguraikan perbedaan antara populasi, undangan, dan n.
Berapa banyak respons yang saya perlukan untuk sebuah survei?
Untuk sebagian besar survei, jawaban praktisnya adalah 385 respons lengkap. Itulah hasil rumus pada tingkat kepercayaan 95 persen, margin kesalahan plus minus 5 poin persentase, dan tanpa estimasi awal atas hasilnya. Jika populasi Anda kecil, Anda memerlukan lebih sedikit: 278 untuk daftar berisi 1.000 orang, 80 untuk daftar berisi 100 orang. Masukkan angka Anda sendiri ke kalkulator untuk melihat angka tepatnya dan aritmetika di baliknya.
Berapa ukuran sampel yang saya perlukan untuk tingkat kepercayaan 95 persen dan margin kesalahan 5 persen?
385 respons lengkap, jika populasinya besar dan Anda memakai p = 0,5. Aritmetikanya adalah n0 = 1,96 kuadrat dikali 0,5 dikali 0,5, dibagi 0,05 kuadrat, yaitu 0,9604 dibagi 0,0025, yaitu 384,16. Bulatkan ke atas dan Anda mendapat 385. Jika populasi Anda kecil, terapkan koreksi populasi terbatas dan angkanya akan turun.
Apa itu margin kesalahan?
Margin kesalahan adalah pita plus minus di sekitar hasil survei yang muncul karena Anda mengambil sampel sebagian orang, bukan semuanya. Hasil 62 persen dengan margin kesalahan 5 poin berarti metode itu akan menghasilkan interval yang memuat nilai sebenarnya di sebagian besar waktu, dan interval khusus ini berkisar dari 57 hingga 67 persen. Margin kesalahan hanya menggambarkan kesalahan sampel acak. Margin kesalahan tidak mengatakan apa pun tentang orang yang tidak pernah menjawab.
Bagaimana cara menghitung margin kesalahan?
Ambil akar kuadrat dari p dikali (1 dikurangi p) dibagi n, lalu kalikan dengan skor z untuk tingkat kepercayaan Anda. Pada tingkat kepercayaan 95 persen, 385 respons, dan p = 0,5, hasilnya 1,96 dikali akar kuadrat dari 0,25 dibagi 385, yaitu 1,96 dikali 0,025482, yaitu 0,0499. Jadi margin kesalahannya plus minus 5,0 poin persentase. Kalkulator margin kesalahan di halaman ini menghitungnya untuk Anda dan menampilkan langkah-langkahnya.
Apakah margin kesalahan bertambah seiring ukuran sampel?
Tidak, margin kesalahan justru menyusut, dan menyusut sebanding dengan akar kuadrat dari ukuran sampel. Beralih dari 100 respons ke 400 membagi dua margin kesalahan. Beralih dari 400 ke 1.600 membaginya dua lagi. Hubungan akar kuadrat itulah sebabnya presisi menjadi mahal: setiap tambahan satu angka desimal ketelitian memerlukan kira-kira empat kali lipat respons.
Apakah margin kesalahan sama dengan galat baku?
Tidak. Galat baku adalah sebaran dasar dari estimasi. Margin kesalahan adalah galat baku dikalikan skor z untuk tingkat kepercayaan yang Anda pilih. Pada tingkat kepercayaan 95 persen, margin kesalahan sekitar 1,96 galat baku. Galat baku adalah sifat data. Margin kesalahan adalah pilihan pelaporan yang diletakkan di atasnya.
Berapa ukuran sampel yang baik untuk penelitian kuantitatif?
Tidak ada satu angka yang baik, dan sumber mana pun yang memberi Anda satu angka tanpa menanyakan apa yang Anda ukur hanya menebak. Untuk studi yang melaporkan persentase dari populasi di bawah sekitar 10.000, jawaban yang dapat dipertanggungjawabkan adalah hasil rumus pada tingkat kepercayaan 95 persen dan margin kesalahan yang dapat Anda jelaskan alasannya. Untuk daftar berisi 1.000, hasilnya 278. Angka yang membuat bab metodologi disetujui bukanlah angka yang besar, melainkan angka yang dinyatakan dengan tingkat kepercayaan, margin kesalahan, proporsi yang diasumsikan, dan populasi ditulis di sampingnya. Lihat ukuran sampel untuk penelitian kuantitatif untuk rumus-rumus bernama yang mungkin diharapkan pembimbing Anda.
Berapa tingkat respons survei yang normal?
Tidak ada satu tingkat yang normal, dan halaman mana pun yang mengutip satu angka hanya menebak. Angka nyata yang bersumber dari era yang sama berkisar dari 6 persen (jajak pendapat telepon Pew pada 2018) hingga 71 persen (lembaga federal AS yang kecil dalam Federal Employee Viewpoint Survey 2024). Meta-analisis atas 1.071 survei online yang diterbitkan menemukan rata-rata 44,1 persen. Ukuran organisasi sangat berpengaruh: survei federal yang sama memperoleh 71 persen dari lembaga dengan kurang dari 1.000 orang dan 37 persen dari lembaga dengan lebih dari 75.000 orang. Gunakan riwayat Anda sendiri terlebih dahulu, dan lihat tabel tolok ukur untuk angka yang dapat Anda kutip.
Apakah ukuran populasi berpengaruh pada ukuran sampel?
Hampir tidak, sampai sampel Anda menjadi bagian besar dari populasi. Beralih dari 100.000 orang ke 1.000.000 hanya mengubah kebutuhan dari 383 menjadi 385. Beralih dari 1.000 orang ke 100 mengubahnya dari 278 menjadi 80. Ukuran populasi berpengaruh pada ujung yang kecil, tepat di mana koreksi populasi terbatas berlaku.
Kapan p = 0,5 menjadi pilihan yang tepat?
Gunakan p = 0,5 setiap kali Anda tidak punya estimasi awal yang dapat dipertanggungjawabkan. Suku p dikali (1 dikurangi p) paling besar pada 0,5, sehingga menghasilkan sampel terbesar yang diperlukan. Itulah yang membuatnya asumsi yang aman: sampel Anda tidak mungkin kurang. Jika Anda punya studi pilot, tolok ukur, atau angka tahun lalu, gunakanlah. Mengasumsikan p = 0,9 alih-alih 0,5 memangkas sampel yang diperlukan dari 385 menjadi 139.
Jika saya mengundang lebih banyak orang, apakah bias nonrespons hilang?
Tidak. Lebih banyak undangan menghasilkan lebih banyak respons lengkap, yang mempersempit margin kesalahan. Bias adalah masalah tersendiri: bias bergantung pada apakah orang yang menjawab berbeda dari orang yang tidak menjawab. Meta-analisis atas 59 studi bias nonrespons hanya menemukan hubungan kecil antara tingkat respons dan bias yang sebenarnya. Pew menjalankan kuesioner yang sama dua kali, pada tingkat respons 9 persen dan 22 persen, dan 28 dari 40 pertanyaan yang sama hasilnya berselisih tidak lebih dari 2 poin. Lihat bias respons dan bias nonrespons.
Bagaimana menentukan ukuran sampel jika saya memerlukan hasil per departemen atau wilayah?
Tentukan ukuran setiap subkelompok secara terpisah. Margin kesalahan Anda hanya berlaku untuk suatu kelompok jika kelompok itu memiliki respons lengkap sebanyak itu. Jika Anda menginginkan plus minus 5 poin untuk setiap wilayah, setiap wilayah memerlukan 385 respons lengkapnya sendiri, atau angkanya sendiri setelah koreksi populasi terbatas. Gunakan pertanyaan demografis untuk mengidentifikasi kelompok-kelompok itu dan rencanakan oversampling pada kelompok yang kecil.
Berapa ukuran sampel yang saya perlukan agar hasilnya signifikan secara statistik?
Pertanyaan itu mencampur dua gagasan. Rumus ukuran sampel menentukan ukuran untuk sebuah estimasi dengan presisi yang dipilih. Uji signifikansi membandingkan dua angka dan menanyakan apakah selisihnya mungkin hanya kebetulan. Ukuran yang Anda perlukan bergantung pada seberapa kecil selisih yang ingin dapat Anda deteksi, bukan pada ambang batas yang tetap. Tentukan ukuran survei di sini, lalu baca signifikansi statistik sebelum Anda menguji satu hasil terhadap hasil lain.
Apakah rumus-rumus ini berlaku untuk penelitian kualitatif?
Tidak. Wawancara, diskusi kelompok terarah, dan pekerjaan dengan pertanyaan terbuka tidak ditentukan ukurannya dengan margin kesalahan, karena tidak mengestimasi persentase populasi. Ukuran sampel kualitatif ditentukan berdasarkan saturasi, yaitu titik ketika partisipan baru tidak lagi memunculkan tema baru, dan dilaporkan sebagai penilaian yang disertai bukti, bukan sebagai rumus. Jangan menjalankan studi kualitatif melalui kalkulator ini.
Referensi
- National Institute of Standards and Technology (NIST). (t.t.). Selecting Sample Sizes. Dalam NIST/SEMATECH e-Handbook of Statistical Methods, bagian 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.