
La dimensione del campione di un’indagine è il numero di risposte complete incluse nella tua analisi, indicato con n. È diversa dal numero di inviti o di persone nel tuo elenco. Con le ipotesi di campionamento del calcolatore, un campione più grande restringe il margine di errore; non elimina un reclutamento distorto né domande formulate male.
Calcolatore della dimensione del campione
Niente è nascosto dietro una registrazione e niente viene inviato altrove. Il calcolatore funziona nel tuo browser, parte con una risposta di esempio già sullo schermo e mostra la formula e i calcoli usati, così puoi verificarli o rifarli a mano.
Di quante risposte ho bisogno?
Imposta i sei valori. La risposta, la formula e i calcoli si aggiornano mentre digiti.
Risposte complete necessarie
370
Dopo la correzione per popolazione finita.
Persone da invitare
1,234
Con un tasso di risposta del 30%.
Frazione di campionamento
3.7%
Quota della popolazione da cui devi ricevere risposta.
Totale, dimensionato per sottogruppo
370
I calcoli, passo dopo passo
| Margine di errore | Risposte complete necessarie | Inviti necessari |
|---|
Una precisione maggiore costa risposte in proporzione circa al quadrato del miglioramento. Dimezzare il margine di errore moltiplica il campione per circa quattro.
Il pulsante di copia scrive un breve paragrafo metodologico con i tuoi numeri, la formula e la citazione, pronto da incollare in un documento di progetto o in un capitolo di metodologia.
Cita questo calcolatore: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Il risultato sono risposte complete, non inviti. È il numero che devi avere in mano alla fine della rilevazione sul campo. Il numero di inviti è quel valore diviso per il tasso di risposta che ti aspetti, ed è lì che sbaglia la maggior parte dei piani di campionamento. Una volta fissato l’obiettivo, crea il tuo questionario e fai uno studio pilota con il pubblico previsto. Usa lo studio pilota per verificare la formulazione e stimare il rapporto tra inviti e risposte complete per il tuo progetto.
Che cosa significa dimensione del campione
La dimensione del campione è il numero di persone che completano il tuo questionario. In ogni formula di questa pagina si indica con n, è l’unica grandezza che ottieni con la rilevazione sul campo invece di sceglierla sulla carta, ed è il dato da cui si calcola il tuo margine di errore.
Tre conteggi vengono scambiati per essa, e distinguerli è gran parte del lavoro di un piano di campionamento:
- Popolazione (N): tutti quelli che vuoi descrivere. Un elenco clienti, l’organico, un paese.
- Inviti: quante persone contatti. Sempre più di n, perché non tutti rispondono.
- Dimensione del campione (n): quante risposte complete hai quando la rilevazione finisce. È il numero che la formula dimensiona, e l’unico dei tre che cambia il tuo margine di errore.
La dimensione del campione ti dà precisione, cioè l’ampiezza della fascia di più o meno intorno a ogni risultato. Non ti dà accuratezza, cioè il fatto che le persone che hanno risposto somiglino a quelle che non l’hanno fatto. Un grande campione di convenienza può essere più lontano dalla verità di un piccolo campione casuale, e nessun valore di n ripara questo problema. Dove sbaglia la pianificazione della dimensione del campione spiega la differenza, e il modo in cui estrai il campione è ciò che la decide.
La risposta breve, se vuoi solo un numero
Numeri chiave
- 385 risposte complete è la risposta predefinita. È ciò che restituisce la formula con un livello di confidenza del 95 per cento, un margine di errore di più o meno 5 punti percentuali e nessuna stima preliminare del risultato.
- Le popolazioni piccole ne richiedono molte meno. Un elenco di 1.000 persone ne richiede 278. Un elenco di 100 ne richiede 80. È l’effetto della correzione per popolazione finita.
- La precisione costa cara. Dimezzare il margine di errore moltiplica il campione per circa quattro. Passare da più o meno 5 punti a più o meno 1 punto ti porta da 385 a 9.604.
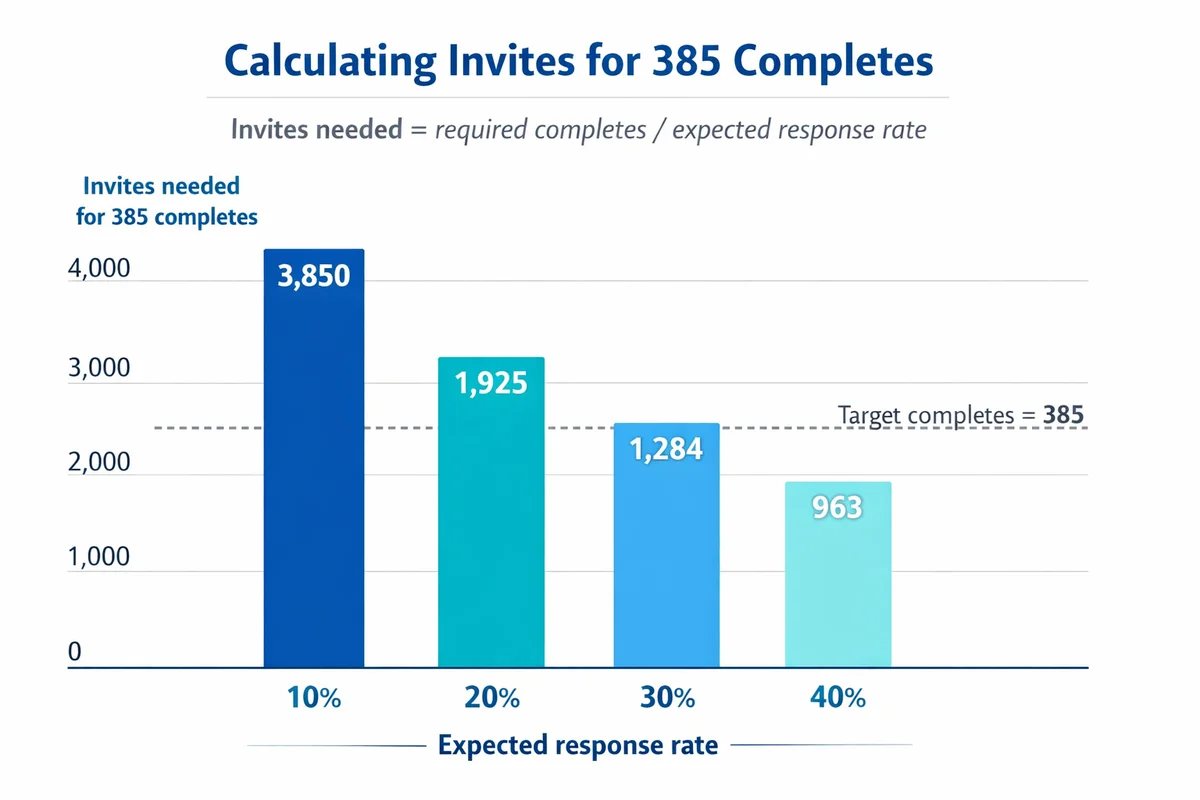
- Le formule contano le risposte complete, non gli inviti. Gli inviti necessari sono le risposte complete divise per il tasso di risposta atteso. Al 30 per cento, 385 risposte complete significano invitare 1.284 persone.
- Il margine di errore copre un solo tipo di errore. Misura il rumore dovuto al fatto di campionare alcune persone invece di tutte. Non dice nulla sulle persone che non hanno mai risposto.
La formula della dimensione del campione, e come calcolarla a mano
Per un’indagine che riporta una percentuale, il punto di partenza standard è la dimensione del campione per una popolazione abbastanza grande da considerarla illimitata:
n0 = (z^2 x p x (1 - p)) / E^2
Leggendola da sinistra a destra:
- n0 è il numero di risposte complete necessarie, prima di qualsiasi correzione per la popolazione.
- z è il valore z per il tuo livello di confidenza. Usa 1,96 per il 95 per cento.
- p è la proporzione che ti aspetti di misurare, in forma decimale. Usa 0,5 se non la conosci.
- E è il margine di errore in forma decimale. Cinque punti percentuali corrispondono a 0,05.
Il simbolo della dimensione del campione è n. Alcune fonti indicano il valore non corretto con n0 e quello corretto con n, che è la convenzione usata qui.
| Livello di confidenza | z | Quanto ti costa |
|---|---|---|
| 80% | 1.282 | 165 risposte complete con più o meno 5 punti |
| 90% | 1.645 | 271 risposte complete |
| 95% (standard) | 1.960 | 385 risposte complete |
| 99% | 2.576 | 664 risposte complete |
| 99,9% | 3.291 | 1.084 risposte complete |
Esempio svolto: da 385 a un elenco di inviti
Scenario. Vuoi la percentuale di clienti che ti consiglierebbero. Vuoi un livello di confidenza del 95 per cento e più o meno 5 punti. Non hai una stima preliminare, quindi p = 0,5.
Scegli il livello di confidenza e il margine di errore
Un livello di confidenza del 95 per cento fissa z = 1,96. Più o meno 5 punti percentuali corrisponde a E = 0,05.
Scegli un risultato atteso
p = 0,5, perché non c’è una stima preliminare e 0,5 produce il campione più grande. Niente di ciò che scoprirai in seguito potrà lasciarti sotto la soglia.
Applica la formula della dimensione del campione
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Arrotonda per eccesso: 385 risposte complete. Arrotonda sempre per eccesso. Non puoi raccogliere una frazione di questionario.
Correggi per una popolazione piccola
Se quei clienti sono un elenco di 1.000 persone e non un mercato aperto, applica la correzione: n = 384,16 / (1 + 383,16 / 1.000) = 384,16 / 1,38316 = 277,7, quindi 278 risposte complete. La correzione incide solo quando il campione è una quota consistente della popolazione.
Trasforma le risposte complete in inviti
Con un tasso di risposta del 30 per cento, inviti = 278 / 0,30 = 926,7, quindi invita 927 persone. Le risposte complete sono ciò che la formula dimensiona. Gli inviti sono ciò che invii davvero, e non possono mai superare la popolazione da cui estrai.
Con un livello di confidenza del 95 per cento e p = 0,5, l’intera formula si riduce a 0,9604 diviso E al quadrato. Questa sola scorciatoia risponde in una riga alla maggior parte delle domande sulla dimensione del campione, ed è il motivo per cui 385 continua a comparire nelle tabelle della dimensione del campione che trovi altrove.
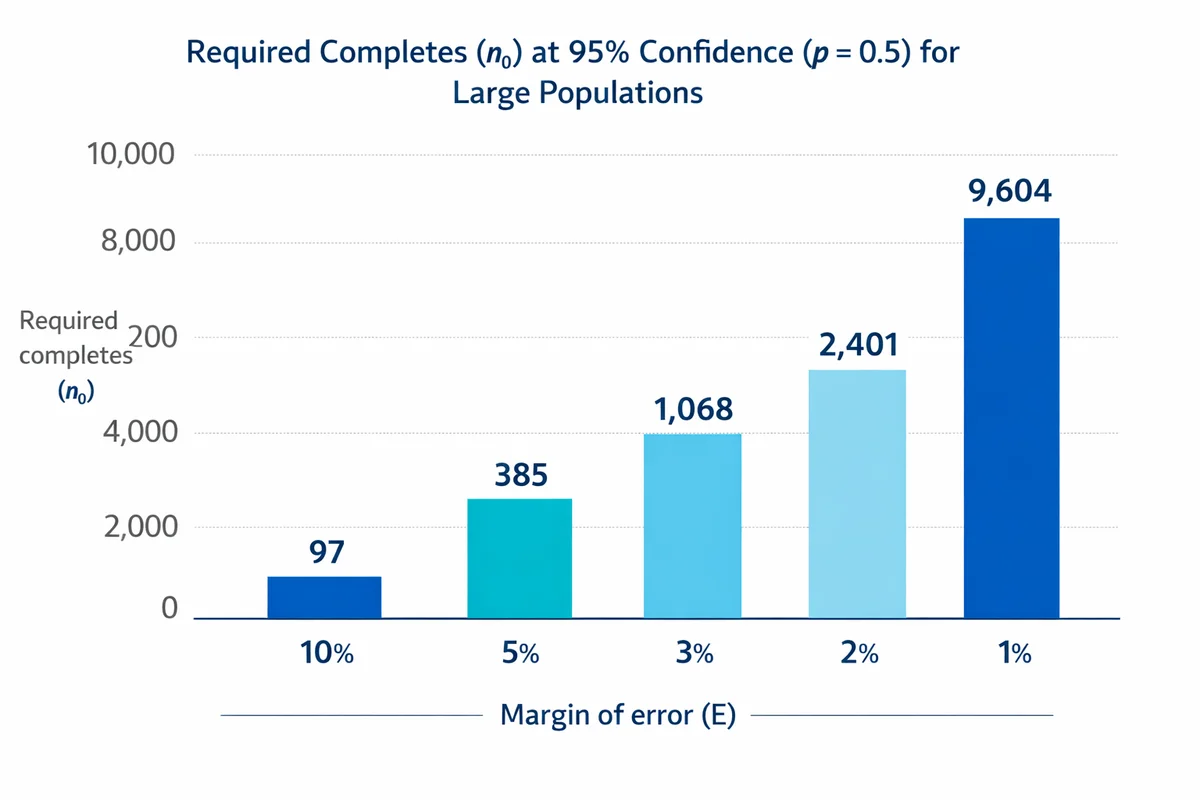
Tabella della dimensione del campione per le dimensioni di popolazione più comuni
Questi dati sono calcolati con la formula qui sopra con un livello di confidenza del 95 per cento, più o meno 5 punti e p = 0,5, poi corretti per la popolazione. Le ultime due colonne sono un nostro controllo rispetto alla tabella pubblicata da Krejcie e Morgan nel 1970, che è la tabella citata dalla maggior parte dei capitoli di metodologia.
| Popolazione (N) | Risposte complete necessarie | Krejcie e Morgan (1970) | Differenza |
|---|---|---|---|
| 10 | 10 | 10 | uguale |
| 25 | 24 | non presente | |
| 50 | 45 | 44 | 1 in più |
| 100 | 80 | 80 | uguale |
| 200 | 132 | 132 | uguale |
| 500 | 218 | 217 | 1 in più |
| 1,000 | 278 | 278 | uguale |
| 2,000 | 323 | 322 | 1 in più |
| 5,000 | 357 | 357 | uguale |
| 10,000 | 370 | 370 | uguale |
| 50,000 | 382 | 381 | 1 in più |
| 100,000 | 383 | 384 | 1 in meno |
Come l’abbiamo verificato. Abbiamo applicato la formula a 21 dimensioni di popolazione e confrontato ogni risultato con il valore pubblicato da Krejcie e Morgan. Dodici coincidevano esattamente. Gli altri nove differivano esattamente di una risposta, il che dipende dal punto in cui ciascun metodo arrotonda, non da un disaccordo sui calcoli. Se un relatore ti chiede perché il tuo numero differisce di uno dalla tabella, il motivo è questo.
Da sapere se citi quella tabella: Krejcie e Morgan non hanno ricavato una formula propria. Il loro articolo del 1970 è di circa 400 parole più una tabella, e la sua unica voce bibliografica attribuisce la formula a un bollettino di ricerca del 1960 della National Education Association. La loro sintesi dell’andamento resta la migliore descrizione in una riga: man mano che la popolazione cresce, il campione necessario aumenta a un ritmo decrescente e si stabilizza poco sopra i 380 casi.
Scegliere i valori di partenza, uno alla volta
Quattro numeri determinano la risposta. Tre di questi sono decisioni, non fatti, e per ognuno esiste un modo difendibile di sceglierlo.
Livello di confidenza: quanto spesso il metodo ha ragione
Il livello di confidenza descrive il metodo, non questa specifica indagine. Con un livello di confidenza del 95 per cento, gli intervalli costruiti in questo modo contengono il valore vero 95 volte su 100 nel lungo periodo. Non è una probabilità del 95 per cento che la tua risposta specifica sia corretta.
Usa il 95 per cento, a meno che tu non abbia un motivo per non farlo. Passare al 99 per cento porta il campione da 385 a 664 per la stessa precisione, cioè un aumento dei costi del 72 per cento per ottenere pochissimo. Il concetto collegato nella verifica delle ipotesi è alfa, ed è per questo che le persone confondono le due cose. Se la distinzione non ti è chiara, leggi significatività statistica e che cosa significano i p-value prima di scegliere un numero.
Margine di errore: la variabile decisiva
È quella su cui riflettere di più, perché è l’unico valore che lega il campione a una decisione. Sceglilo chiedendoti quale scarto cambierebbe ciò che fai.
Se agisci in modo diverso quando la soddisfazione è al 72 per cento invece che al 74 per cento, ti serve un margine stretto. Se cambi decisione solo quando il confronto è tra 72 e 82, più o meno 5 punti sono più che sufficienti. I report generali di sintesi di solito si attestano su 5 punti per un rilevamento rapido o su 3 punti per il monitoraggio nel tempo. Sotto i 2 punti il costo sale in fretta.
Dimensione della popolazione: quasi irrilevante, finché non lo è
Per le popolazioni grandi il campione necessario si sposta appena. Diecimila persone richiedono 370 risposte. Centomila ne richiedono 383. La dimensione della popolazione incide solo quando il tuo campione ne è una quota significativa, come nel caso di elenchi di dipendenti, registri dei soci e coorti scolastiche. È quello di cui si occupa la prossima sezione.
Risultato atteso (p): usa 0,5 quando non lo conosci
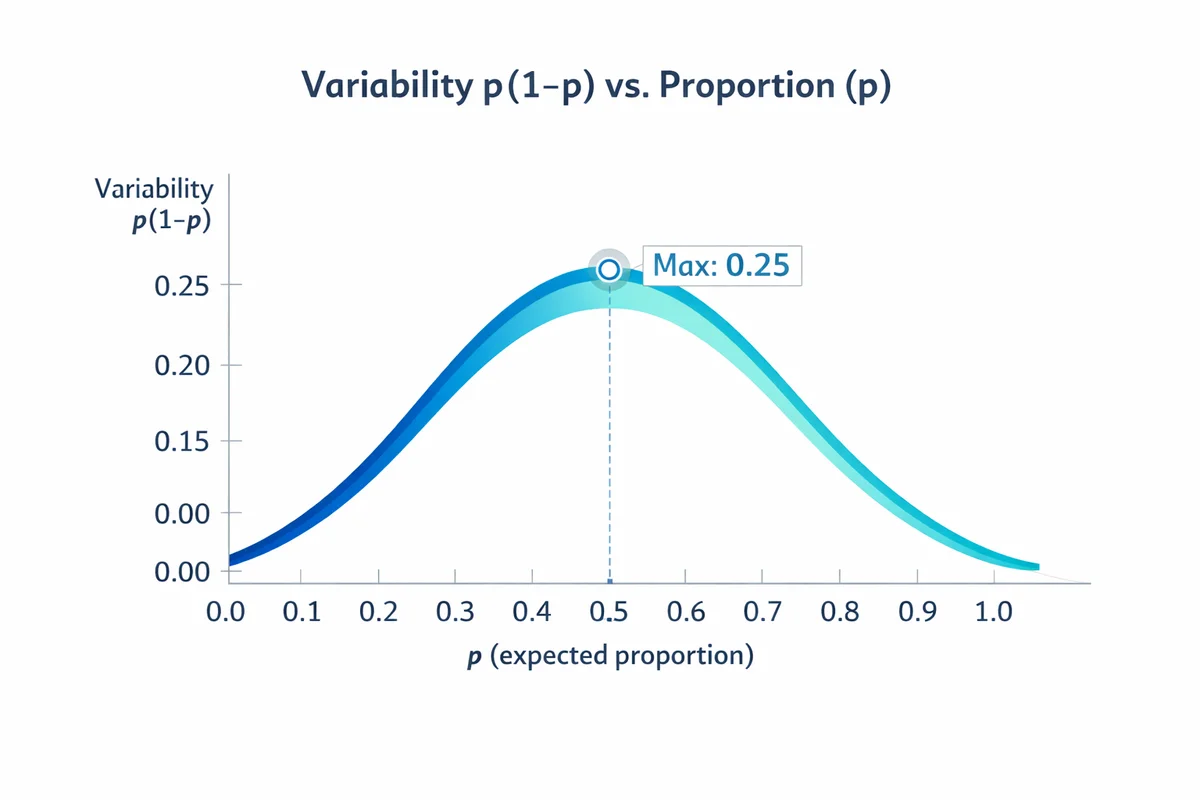
Per una domanda che produce una percentuale, l’incertezza dipende da p per (1 meno p). Questo termine è massimo con p = 0,5, quindi 0,5 è la scelta prudente e produce il campione più grande. È il valore predefinito giusto quando non hai una stima preliminare.
Se ce l’hai, usala, perché il risparmio è notevole. Con un livello di confidenza del 95 per cento e più o meno 5 punti, p = 0,5 richiede 385 risposte e p = 0,9 ne richiede 139. Indagini precedenti, uno studio pilota o un riferimento pubblicato sono tutte fonti valide per quella stima. Anche le domande poco chiare aumentano la dispersione, quindi una formulazione più chiara può stabilizzare un risultato senza alcuna risposta in più. Scrivere domande migliori costa spesso meno che raccoglierne di più.
Popolazioni piccole: la correzione per popolazione finita
La formula di base presuppone che tu stia estraendo da un bacino così ampio che togliere persone non cambia nulla. Quando il tuo campione è una fetta reale della popolazione, questa ipotesi ti fa pagare troppo. La correzione per popolazione finita ti restituisce le risposte in eccesso.
n = n0 / (1 + ((n0 - 1) / N))
- n è il numero corretto di risposte complete che ti servono.
- n0 è il valore non corretto della formula qui sopra.
- N è la dimensione della popolazione.
La soglia abituale è che n0 superi circa il 5 per cento di N. Al di sotto, la correzione non cambia quasi nulla, quindi non vale la pena spiegarla a nessuno.
Esempio svolto: un questionario per i dipendenti
Scenario. Hai 1.200 dipendenti. Vuoi un livello di confidenza del 95 per cento, più o meno 5 punti, e usi p = 0,5.
- Senza correzione, n0 = 384,16.
- Con la correzione: n = 384,16 / (1 + (383,16 / 1.200)) = 384,16 / 1,3193 = 291,2.
- Arrotonda per eccesso: 292 risposte complete.
Senza la correzione inseguiresti 385 risposte da un elenco di 1.200 persone, cioè il 32 per cento di tutti. Con la correzione, 292 danno la stessa precisione. Su un elenco di quella dimensione è un mese di solleciti che non devi fare.
Sotto le 200 persone circa, il campione corretto è una quota talmente grande dell’elenco che invitare tutti è più semplice e più difendibile. Un censimento di 150 persone non ha alcun errore di campionamento. Il tuo impegno va allora sul tasso di risposta e su chi manca, che è dove deve andare.
Margine di errore: la stessa formula, al contrario
Il margine di errore è la fascia di più o meno intorno al risultato di un’indagine, dovuta al fatto di aver interpellato alcune persone invece di tutte. Se il 62 per cento di 385 partecipanti sceglie un’opzione e il margine di errore è di 5 punti, riporti il 62 per cento e dici che l’intervallo plausibile va dal 57 al 67 per cento.
Riordinando la formula della dimensione del campione per ricavare E si ottiene:
E = z x radice quadrata di (p x (1 - p) / n)
Con una popolazione finita, moltiplica il risultato per la radice quadrata di (N - n) diviso (N - 1). Entrambe le versioni sono nel calcolatore qui sotto, che cambia automaticamente quando selezioni o deselezioni la casella della popolazione.
Qual è il margine di errore sulle risposte che ho già?
La stessa formula, riordinata. Inserisci le risposte che hai raccolto e leggi la precisione che ne risulta.
Margine di errore
5.0
Punti percentuali, in più o in meno.
Il tuo intervallo
da 45,0 a 55,0
Percentuale, con un livello di confidenza del 95%.
I calcoli, passo dopo passo
Il margine di errore aumenta con la dimensione del campione?
Diminuisce, e diminuisce con la radice quadrata di n. Quella radice quadrata è tutta l’economia delle indagini. Quattrocento risposte ti danno metà dell’errore di cento. Per dimezzarlo ancora te ne servono 1.600. Ogni ulteriore cifra decimale di precisione costa all’incirca quattro volte la rilevazione sul campo, ed è per questo che 385 è un punto di arrivo così comune: è lì che costo e precisione smettono di litigare.
Quattro termini che si confondono spesso
Errore standard, margine di errore, livello di confidenza e intervallo di confidenza vengono usati come se fossero intercambiabili. Sono quattro cose diverse, e la differenza conta quando qualcuno mette in dubbio il tuo numero.
| Termine | Che cos’è | Con 385 risposte e il 50% |
|---|---|---|
| Errore standard | La dispersione grezza della stima. La radice quadrata di p per (1 meno p) diviso n. | 0,0255, ovvero 2,55 punti percentuali |
| Margine di errore | L’errore standard moltiplicato per il valore z del livello di confidenza scelto. | Più o meno 5,0 punti al 95% |
| Livello di confidenza | Il valore z che hai scelto, espresso come percentuale. Una scelta, non una misura. | 95%, quindi z = 1,96 |
| Intervallo di confidenza | Il risultato con il margine di errore applicato, scritto come intervallo. | Dal 45,0% al 55,0% |
In breve: l’errore standard è una proprietà dei tuoi dati, il livello di confidenza è una scelta che hai fatto, il margine di errore è il prodotto dei due, e l’intervallo di confidenza è ciò che scrivi nel report.
Che cosa non copre il margine di errore
Copre l’errore di campionamento casuale e nient’altro. Non copre le persone che hanno ignorato l’invito, un elenco a cui mancava una parte della popolazione o una domanda che metà dei partecipanti ha letto in modo diverso da come la intendevi. Un’indagine può avere un margine di errore impeccabile ed essere comunque sbagliata. Vedi bias di risposta e bias di non risposta per gli errori che nessuna dimensione del campione corregge.
L’associazione professionale della ricerca tramite indagini lo dice in modo più netto di quanto farebbe la maggior parte dei fornitori. L’AAPOR afferma che non esiste un margine di errore complessivo misurabile per un sondaggio, perché le indagini contengono altri errori che non si possono misurare affatto, da come sono state scritte le domande a come sono state condotte le interviste. Quello che puoi calcolare è la componente campionaria. È la componente che ti dà il calcolatore, e conviene essere chiari sul fatto che è solo una componente.
Due regole d’uso della stessa fonte, che la maggior parte dei testi sulle indagini sbaglia:
- Sono punti percentuali, non una percentuale. Scrivi “più o meno 3 punti percentuali”, non “più o meno il 3 per cento”. Significano cose diverse.
- Non si applica affatto ai campioni ad adesione volontaria. Un margine di errore presuppone che ogni persona avesse una probabilità di selezione nota e diversa da zero. Un link aperto, un panel di volontari o un post sui social media non soddisfano questa condizione. Pubblicare un margine di errore accanto ai risultati di un link aperto significa dichiarare una precisione che non hai ottenuto.
Trasformare le risposte complete in inviti
La formula ti dà le risposte terminate. La rilevazione sul campo ti dà un tasso di risposta. Il divario tra i due è dove di solito falliscono i piani di campionamento, e il calcolo sta in una riga:
Inviti = risposte complete necessarie / tasso di risposta atteso
Usa il tasso in forma decimale, quindi 30 per cento diventa 0,30, e arrotonda per eccesso. Per 292 risposte complete al 35 per cento, si ha 292 diviso 0,35 = 834,3, quindi invita almeno 835 persone.
| Risposte complete necessarie | Tasso di risposta atteso | Inviti |
|---|---|---|
| 385 | 60% | 642 |
| 385 | 30% | 1,284 |
| 385 | 15% | 2,567 |
| 292 | 50% | 584 |
| 292 | 35% | 835 |
| 292 | 20% | 1,460 |
Scegliere un tasso di risposta difendibile
Lo storico dei tuoi dati batte qualsiasi riferimento pubblicato, purché si tratti dello stesso pubblico, dello stesso canale e di un questionario di lunghezza simile. Se non hai nulla su cui basarti, pianifica tre scenari al 20, 30 e 40 per cento e tratta l’elenco degli inviti come una leva regolabile durante la rilevazione. Promemoria, una finestra più lunga e un elenco più ampio sono tutte cose che puoi cambiare a metà strada. L’obiettivo di risposte complete no.
La maggior parte delle tabelle di riferimento su internet cita una sola media senza fonte. Non esiste una media unica. Ecco che cosa riportano davvero le fonti primarie, così puoi citare la riga che corrisponde alla tua situazione invece di un numero che qualcuno si è inventato.
| Contesto | Tasso di risposta | Dimensione e fonte |
|---|---|---|
| Agenzie federali statunitensi con meno di 1.000 dipendenti | 71% | Federal Employee Viewpoint Survey 2024 (OPM) |
| Agenzie federali statunitensi da 1.000 a 9.999 dipendenti | 60% | Stessa indagine, stesso anno (OPM) |
| Agenzie federali statunitensi con più di 75.000 dipendenti | 37% | Stessa indagine, stesso anno (OPM) |
| Tutti i dipendenti federali statunitensi | 41% | Oltre 1,6 milioni di invitati, oltre 674.000 risposte, 2024 (OPM) |
| Indagini online pubblicate, di ogni tipo | 44,1% in media | Meta-analisi di 1.071 tassi riportati (Wu e colleghi, 2022) |
| Ricerca organizzativa pubblicata | 68% nel 2020, rispetto al 48% del 2005 | 1.014 indagini in 17 riviste (Holtom e colleghi, 2022) |
| Sondaggi telefonici sulla popolazione generale | 6% nel 2018, rispetto al 36% del 1997 | Il tasso monitorato dal Pew Research Center (Kennedy e Hartig, 2019) |
| Modalità web rispetto a qualsiasi altra modalità | circa 12 punti in meno | Meta-analisi di 114 confronti sperimentali (Daikeler e colleghi, 2020) |
Da questa tabella emergono due cose. Primo, la dimensione del gruppo che stai interpellando predice il tasso meglio di quasi ogni altra cosa sotto il tuo controllo. Un’azienda di 300 persone e un’agenzia di 300.000 persone non stanno conducendo la stessa indagine. Secondo, l’affermazione tanto ripetuta che i tassi di risposta stiano crollando ovunque è vera solo in alcuni contesti. I sondaggi telefonici sono davvero crollati. La ricerca organizzativa pubblicata è andata nella direzione opposta, dal 48 al 68 per cento in quindici anni.
Un altro calcolo di pianificazione che vale la pena prendere in prestito: le linee guida standard dei servizi di divulgazione universitaria consigliano di aggiungere circa il 10 per cento all’elenco degli inviti per le persone che semplicemente non riesci a raggiungere, e circa il 30 per cento per quelle che potrebbero rispondere e non lo fanno.
Che cosa dice sulla lunghezza il nostro corpus di modelli
Un tasso di risposta preso in prestito dall’indagine di qualcun altro si trasferisce male, e la lunghezza è una delle poche cose di quella lista che controlli completamente. Ecco un dato che possiamo produrre noi e un concorrente no, perché nasce dal conteggio del nostro corpus pubblicato e non dal chiedere ai professionisti che cosa pensano di fare.
Nella nostra verifica del 21 agosto 2026, tutti gli 87 modelli di questionario avevano 14 domande o meno, e 86 ne avevano 10 o meno. In totale contenevano 799 domande. La mediana era di 9 domande e un solo modello superava le 10. Questi dati descrivono quella fotografia datata, non la libreria attuale.
| Domande nel modello | Modelli | Quota del corpus |
|---|---|---|
| 7 domande | 4 | 5% |
| 8 domande | 17 | 20% |
| 9 domande | 29 | 33% |
| 10 domande | 36 | 41% |
| 14 domande | 1 | 1% |
Per formato di risposta, 355 delle 799 domande sono scale di valutazione, 281 sono elenchi a scelta singola e 163 chiedono di scrivere qualcosa. Quest’ultimo gruppo è quello che ti costa risposte complete, quindi lo abbiamo letto a mano invece di fidarci del campo memorizzato. Delle 163, 137 sono caselle di commento su più righe. Le altre 26 sono caselle a riga singola, e leggendole è emerso che 22 sono brevi campi di identificazione o classificazione: un nome, un indirizzo email, una data, un reparto, una qualifica. Solo 4 sono vere risposte brevi di contenuto. Quindi il conteggio onesto delle domande davvero aperte è 141, circa una domanda su sei, non una su cinque come ci avrebbe indicato il campo grezzo.
Come abbiamo contato e come abbiamo verificato. Abbiamo analizzato l’elenco di domande memorizzato di ogni modello di questionario pubblicato su questo sito il 21 agosto 2026, abbiamo tenuto le voci con un testo di domanda, poi abbiamo scaricato ogni pagina pubblicata e confrontato i due insiemi invece di fidarci soltanto del nostro database. Tutte le 87 pagine hanno restituito HTTP 200, mentre un indirizzo che sappiamo non più attivo ha restituito 410 nella stessa esecuzione, quindi il controllo era discriminante e non uniformemente positivo. 785 delle 799 domande, cioè il 98 per cento, compaiono nella pagina pubblicata. Sei di queste corrispondenze differiscono dal database solo per il carattere di apostrofo usato, e le abbiamo contate come corrispondenze, cosa che preferiamo dichiarare piuttosto che arrotondare in silenzio. Ottantasei degli 87 modelli sono stati verificati per intero. Quello che non lo è stato è il più lungo, con 14 domande, e la sua pagina pubblicata al momento non mostra alcuna domanda di anteprima, quindi le sue domande non si sono potute confermare dall’esterno.
La lunghezza del modello non ti dice il tasso di risposta agli inviti. Il nostro riferimento sulle risposte ai questionari, separato da questo, esamina il comportamento dopo che le persone interagiscono con un questionario; non conta tutte le persone invitate. Per pianificare gli inviti, usa un tasso documentato di un progetto paragonabile o di uno studio pilota, e mantieni coerente il denominatore.
L’uso pratico è limitato ma reale. Se prendi in prestito un tasso di risposta per il numero di inviti nel calcolatore, prendilo da un questionario di lunghezza simile a quello che stai per inviare, rivolto a un pubblico simile su un canale simile. I nostri strumenti pubblicati hanno tra 7 e 10 domande, meno di quante ne abbia all’inizio la maggior parte delle bozze.
Più inviti non riducono il bias
Un basso tasso di risposta crea due problemi che sembrano uno solo. Il primo è che finisci sotto il tuo obiettivo, quindi il margine di errore è più ampio di quanto avevi pianificato. Il secondo è che le persone che hanno risposto possono differire da quelle che non l’hanno fatto, in modi che contano per il tuo risultato.
Invitare più persone risolve il primo problema. Non risolve in modo affidabile il secondo. Groves e Peytcheva hanno riunito 59 studi che misuravano il bias di non risposta effettivo rispetto a una verità nota, e hanno trovato solo una piccola relazione tra il tasso di risposta di un’indagine e quanto si è rivelata distorta. Pew ha verificato la stessa idea direttamente: ha somministrato lo stesso questionario due volte, una con metodi standard che hanno ottenuto un tasso di risposta del 9 per cento e una con un protocollo ad alto impegno che ha ottenuto il 22 per cento. Delle 40 domande comuni alle due indagini, 28 hanno dato risultati entro 2 punti l’una dall’altra.
Il controesempio onesto. Quel risultato non vale per ogni argomento, ed è utile sapere dove non regge. Nei questionari di soddisfazione la relazione è reale e forte. Uno studio su 717 questionari di soddisfazione dei pazienti in 164 ospedali svizzeri ha rilevato che il punteggio medio di soddisfazione e il tasso di risposta erano correlati con r = 0,61, perché le persone entusiaste e quelle furiose rispondono, mentre la fascia intermedia indifferente no. Se conduci questionari CSAT o NPS, un tasso di risposta in aumento può spostare da solo il tuo punteggio, e uno basso probabilmente ti restituisce un’immagine più lusinghiera della realtà.
Quindi: insegui il tasso di risposta quando misuri che cosa provano le persone nei tuoi confronti. Non trattarlo come un certificato di validità quando misuri qualsiasi altra cosa.
Dimensione del campione nella ricerca quantitativa: che cosa serve a un capitolo di metodologia
Non esiste un’unica dimensione del campione giusta per la ricerca quantitativa, e qualsiasi fonte te ne dia una senza chiederti che cosa stai misurando sta tirando a indovinare. Ciò che fa approvare un capitolo di metodologia non è un numero grande. È un numero dichiarato, con accanto il livello di confidenza, il margine di errore, la proporzione ipotizzata e la popolazione, e una formula con un nome.
I relatori di solito si aspettano uno di quattro approcci con un nome. Per lo più concordano tra loro, ed è utile sapere quale ti viene chiesto.
| Approccio | Che cosa ti chiede | Risultato per N = 1.000 al 95% e 5 punti | Usalo quando |
|---|---|---|---|
| Cochran (1977) | z, p, E, poi la correzione per popolazione finita se la popolazione è piccola | 278 | Il predefinito. È la formula di questa pagina, e quella da cui derivano le altre. |
| Krejcie e Morgan (1970) | Niente. Leggi la risposta su una tabella pubblicata in base alla dimensione della popolazione. | 278 | Vuoi una tabella da citare invece dei calcoli. È Cochran con impostazioni fisse. |
| Yamane (1967), spesso nota come formula di Slovin | Solo N e il margine di errore | 286 | Solo quando p è davvero sconosciuto e accetti un livello di confidenza del 95 per cento già incorporato. Vedi l’avvertenza qui sotto. |
| Analisi della potenza | Dimensione dell’effetto, potenza, alfa e il test che eseguirai | Dipende interamente dalla dimensione dell’effetto | Stai verificando un’ipotesi invece di stimare una percentuale. Usa G*Power o OpenEpi, non questa pagina. |
Cochran, e perché tutto il resto ne è una scorciatoia
La formula di Cochran è quella in cima a questa pagina: n0 = z al quadrato per p per (1 meno p), diviso E al quadrato, seguita dalla correzione per popolazione finita quando la popolazione è piccola. Gli altri metodi con un nome fissano alcuni di questi valori per abbreviare i calcoli. Una volta capito questo, la famiglia smette di sembrare quattro regole in competizione e comincia a sembrare una sola regola con tre preimpostazioni.
Yamane e Slovin: usali a occhi aperti
La formula n = N / (1 + N x e^2) compare in migliaia di tesi, di solito attribuita a Slovin. È rapida: per N = 1.000 ed e = 0,05 dà 286.
Prima di citarla vale la pena sapere tre cose.
- È Cochran con le impostazioni saldate. Ripercorrendola all’indietro, la formula è quella della proporzione con p fissato a 0,5, livello di confidenza fissato al 95 per cento e z arrotondato da 1,96 a 2. Non può rispondere a una domanda con nessun altro livello di confidenza, e non ha alcun valore di ingresso per la variabilità della tua popolazione. Due popolazioni della stessa dimensione ma con una dispersione molto diversa ottengono la stessa risposta, il che non può essere giusto.
- È per quell’arrotondamento che i suoi numeri risultano alti. Con z = 2 il tetto della formula per una popolazione illimitata è esattamente 1 diviso e al quadrato, cioè 400. Il tetto di Cochran è 384,16, perché 1,96 al quadrato fa 3,8416 e non 4. Ogni valore di Yamane nella tabella qui sopra è più grande di qualche per cento rispetto al valore di Cochran proprio per questo motivo. Se ti è mai capitato di chiederti perché due manuali ti danno due dimensioni del campione diverse per lo stesso studio, di solito la risposta è questa.
- L’attribuzione non regge. Una rivista di statistica ha ricostruito la storia della formula e ha concluso che dietro di essa non si trova alcuna persona di nome Slovin, e che la fonte più antica rintracciabile è il manuale di Taro Yamane del 1967. Wolfram MathWorld la descrive come una formula ad hoc priva di rigore matematico. Se il tuo dipartimento se la aspetta, usala e cita Yamane invece di Slovin. Se puoi scegliere, usa Cochran, perché regge alla domanda su da dove venga quel 95 per cento.
Regole pratiche, valutate con onestà
Queste circolano ovunque. Alcune sono utili, altre sono folclore, e aiuta sapere quali sono quali.
- Almeno 30 per gruppo. Ragionevole come soglia minima per i confronti tra gruppi, non come obiettivo. Nasce dal punto in cui le distribuzioni campionarie iniziano a comportarsi bene, non da un requisito di precisione.
- Dieci casi per variabile in una regressione. Un’euristica di lavoro, molto usata e molto criticata. Presentala come euristica, mai come regola.
- Il dieci per cento della popolazione. Questa è semplicemente sbagliata e la tabella qui sopra mostra perché. Il dieci per cento di 100.000 sono 10.000 risposte, quando 383 ti danno la stessa precisione.
- Sempre 385. Vale solo per una popolazione grande al 95 per cento e 5 punti. Citalo con queste condizioni, altrimenti non significa nulla.
- Piccoli n per studi di usabilità e di prodotto. Nielsen Norman Group ne pubblica la versione onesta: 40 partecipanti ti danno una misura sì o no con una precisione di più o meno 15 punti al 95 per cento di confidenza, e 47 ti danno una media con la stessa precisione. Questi numeri sono piccoli perché la precisione dichiarata è ampia. Dichiara apertamente la precisione e i campioni piccoli smettono di essere imbarazzanti.
Se il tuo studio confronta gruppi invece di stimare una percentuale, la dimensione del campione diventa una questione di potenza e questo non è il calcolatore giusto. Ti serve una dimensione dell’effetto che ti senti di difendere, più alfa e potenza. G*Power e OpenEpi sono gli strumenti che la maggior parte dei relatori si aspetta, ed entrambi sono gratuiti. Dire dove si ferma uno strumento è più utile che fingere che faccia tutto.
Il lavoro qualitativo si dimensiona in modo diverso
Interviste e focus group non si dimensionano con un margine di errore, perché non stimano una percentuale della popolazione. L’argomento abituale è la saturazione: si prosegue finché i nuovi partecipanti smettono di far emergere nuovi temi, poi si riporta quando è successo e come lo si è valutato. Far passare uno studio qualitativo in questo calcolatore produce un numero che sembra preciso e non significa nulla.
Se ti servono risultati per sottogruppo, dimensiona per il sottogruppo
Alla maggior parte delle indagini viene chiesto di riportare i risultati per regione, ruolo, anzianità o linea di prodotto. È qui che i piani di campionamento saltano senza che nessuno se ne accorga, e la regola è breve.
Il tuo margine di errore vale per un gruppo solo se quel gruppo ha altrettante risposte complete. Se vuoi più o meno 5 punti per ciascuna di sei regioni, ti servono circa 385 risposte complete in ogni regione, non 385 in totale. È un’indagine sei volte più grande di quella che pensavi di pianificare.
Due vie d’uscita oneste:
- Sovracampiona i gruppi piccoli. Invita deliberatamente una quota più alta dei segmenti più piccoli, così ciascuno raggiunge il proprio obiettivo. Poi ripondera i risultati.
- Accetta fasce più ampie per le suddivisioni. Mantieni un solo numero complessivo solido e pubblica ogni sottogruppo con accanto il proprio margine di errore, più ampio. Di solito è la risposta giusta.
Il calcolatore ha un campo apposta. Imposta Sottogruppi da riportare separatamente sul numero di gruppi per cui devi fornire un risultato, e il calcolatore dimensiona correttamente ogni gruppo e li somma.
Definisci il perimetro prima della rilevazione. Elenca i segmenti che devi riportare, non quelli che sarebbe bello avere. Stima le risposte complete che ciascuno può realisticamente produrre, usando le domande demografiche per identificarli. Se un segmento può dare solo 80 risposte, non promettere più o meno 5 punti per quel segmento. Con 80 risposte la fascia è di più o meno 11 punti.
L’AAPOR usa un esempio svolto che vale la pena memorizzare. Un’indagine su 1.000 adulti ha un margine di errore complessivo di circa più o meno 3 punti. Se 200 di queste persone sono il sottogruppo di cui vuoi davvero parlare, il margine di errore di quel sottogruppo è di più o meno 6,9 punti, più del doppio. Il dato principale in prima pagina del report non è quello che regge il grafico a pagina nove.
Le indicazioni pubblicate sulle dimensioni minime delle celle sono più vecchie e meno rigorose delle formule, ed è corretto trattarle come una soglia minima e non come un obiettivo: circa 100 risposte per un sottogruppo su cui riporterai risultati veri e propri, e da 20 a 50 per uno secondario che citerai di passaggio.
Dove sbaglia la pianificazione della dimensione del campione
La dimensione del campione gestisce l’errore di campionamento, il rumore casuale dovuto al non interpellare tutti. Le indagini reali hanno anche un errore sistematico, che nessuna dimensione del campione corregge e che un campione grande può mascherare.
Trattare un campione di convenienza come un campione probabilistico
Ogni formula qui presuppone che ogni persona avesse una probabilità di selezione nota e diversa da zero, e che il rispondere non fosse fortemente legato a ciò che misuri. Un link aperto sui social media non soddisfa nessuna delle due condizioni. Puoi comunque calcolare un margine di errore dalle risposte, sembrerà rassicurante e non significherà ciò che dice. Dichiara in modo esplicito quale tipo di campione hai effettivamente estratto.
Scambiare un n più grande per una misura migliore
Con un campione grande, una misura rumorosa resta rumorosa: solo, con più precisione. Se una domanda è ambigua, doppia o tendenziosa, più risposte non la salveranno. Tassi elevati di domande saltate e risposte incoerenti sono segnali che devi prima correggere lo strumento. Riscrivere una domanda sbagliata spesso fa più che triplicare il campione.
Scegliere la precisione senza una decisione alle spalle
La precisione ha una risposta giusta solo quando sai a che cosa serve. Una dimensione del campione è facile da difendere quando sai completare questa frase: dobbiamo distinguere risultati che differiscono di X punti. È impossibile da difendere quando l’unica motivazione è che un numero più grande sembrava più sicuro. Ricollegala al tuo disegno di ricerca e a ciò che farai con il risultato.
I numeri di questa pagina, e quanto sono affidabili
Ogni dato citato sopra è un calcolo che puoi riprodurre nel calcolatore o una citazione che puoi verificare. Il livello A indica un risultato replicato o calcolabile direttamente, il B un singolo studio solido, il C un’affermazione molto ripetuta ma contestata.
| Affermazione | Numero | Livello | Fonte |
|---|---|---|---|
| Con un livello di confidenza del 95 per cento e nessuna stima preliminare, una popolazione grande richiede 385 risposte complete per più o meno 5 punti. | 385 | A | Calcolo diretto dalla formula standard della proporzione. NIST sezione 3.3.3; Israel (1992). |
| La formula di questa pagina riproduce la tabella della dimensione del campione pubblicata da Krejcie e Morgan con uno scarto massimo di una risposta su tutte le 21 dimensioni di popolazione che abbiamo verificato. | 21 su 21 entro 1 | A | Nostro controllo rispetto a Krejcie e Morgan (1970). Metodo indicato sotto la tabella. |
| Il tasso di risposta è un debole predittore del bias di non risposta. Una meta-analisi di 59 studi dedicati al bias ha trovato solo una piccola relazione tra i due. | 59 studi | A | Groves e Peytcheva (2008), Public Opinion Quarterly. |
| Pew ha somministrato lo stesso questionario con un tasso di risposta del 9 per cento e del 22 per cento. Su 40 domande comuni, 28 hanno dato risultati entro 2 punti. | 28 su 40 entro 2 punti | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Ma nei questionari di soddisfazione la relazione è reale e forte. Su 717 questionari ospedalieri, il punteggio medio di soddisfazione era correlato al tasso di risposta con r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux e Combescure (2020), BMC Health Services Research. |
| Il tasso di risposta dei questionari per i dipendenti segue quasi perfettamente la dimensione dell’organizzazione. Nel 2024 il questionario per i dipendenti federali statunitensi ha ottenuto il 71 per cento dalle agenzie con meno di 1.000 persone e il 37 per cento da quelle con più di 75.000. | 71% contro 37% | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, oltre 1,6 milioni di dipendenti invitati. |
| Il tasso di risposta medio su 1.071 indagini online pubblicate era del 44,1 per cento. Non esiste un unico tasso normale. | 44,1% | A | Wu, Zhao e Fils-Aime (2022), meta-analisi, Computers in Human Behavior Reports. |
| I questionari web ottengono un tasso di risposta di circa 12 punti percentuali più basso rispetto alle altre modalità, su 114 confronti sperimentali. | 12 punti in meno | A | Daikeler, Bosnjak e Lozar Manfreda (2020), meta-analisi, JSSAM. |
| Dimezzare il margine di errore moltiplica il campione necessario per circa quattro, perché n cresce come 1 diviso E al quadrato. Raddoppiare un campione da 1.000 a 2.000 fa guadagnare circa un punto. | circa 4x | A | Proprietà algebrica della formula; l’AAPOR indica esplicitamente il caso da 1.000 a 2.000. |
| Ipotizzare p = 0,5 invece di un p noto di 0,9 quasi triplica il campione da raccogliere, da 139 a 385. | 139 contro 385 | A | Calcolo diretto. Riproducibile nel calcolatore cambiando il risultato atteso. |
| Tutti gli 87 modelli di questionario pubblicati su questo sito hanno 14 domande o meno, e 86 degli 87 ne hanno 10 o meno. 785 delle loro 799 domande sono state confermate nelle pagine pubblicate. | 87 modelli, 799 domande | A | Nostro conteggio del corpus di modelli attivi, 21 agosto 2026, verificato su tutte le 87 pagine pubblicate. Metodo, verifica manuale e tasso di conferma indicati con la tabella. |
| Dietro la formula che porta il nome di Slovin non c’è alcuna persona rintracciabile con quel nome. La fonte più antica rintracciabile è Yamane (1967). | nessun autore rintracciabile | B | Tejada e Punzalan (2012), The Philippine Statistician; Wolfram MathWorld la definisce ad hoc. |
“Servono sempre 385 risposte.” Solo con un livello di confidenza del 95 per cento, più o meno 5 punti, p = 0,5 e una popolazione grande. Citato senza condizioni, è sbagliato per ogni popolazione piccola.
“Interpella il 10 per cento della tua popolazione.” Non ha alcuna base statistica. Sovracampiona enormemente le popolazioni grandi e sottocampiona quelle piccole.
“Un tasso di risposta sotto il 50 o il 60 per cento invalida un’indagine.” Nessuna soglia lo fa. La scala del 50, 60 e 70 per cento è una regola pratica da manuale senza alcuna derivazione empirica, e la meta-analisi di Groves e Peytcheva la contraddice. Il tasso di risposta limita il bias nel caso peggiore. Non misura il bias effettivo.
“Il tasso di risposta medio dei questionari è del X per cento.” I dati verificati degli stessi pochi anni vanno dal 6 per cento al 71 per cento, a seconda solo di chi viene interpellato. Qualsiasi media unica nasconde questo fatto. Cita invece la riga della tabella qui sopra che corrisponde alla tua situazione.
La formula di Slovin presentata come una derivazione. È la formula di Cochran con il livello di confidenza del 95 per cento e p = 0,5 incorporati e z arrotondato a 2, e l’attribuzione a Slovin non ha una fonte rintracciabile.
Il modello di giustificazione
La maggior parte delle argomentazioni sulla dimensione del campione fallisce perché le ipotesi non sono mai state messe per iscritto. Il pulsante Copia la giustificazione del calcolatore la scrive con i tuoi numeri già inseriti. Se preferisci comporla in autonomia, queste sono le nove cose che un revisore cercherà.
- Popolazione (N): definisci la popolazione e indica il numero. Per esempio, tutti i clienti attivi negli ultimi 90 giorni, N = 48.200.
- Che cosa stai misurando: una proporzione (una percentuale) o una media (una valutazione media). La formula di questa pagina dimensiona le proporzioni, che coprono la maggior parte dei KPI riportati.
- Livello di confidenza: il livello scelto e il perché. La convenzione e la tolleranza al rischio sono entrambe ragioni accettabili, se lo dichiari.
- Margine di errore (E): la precisione che vuoi ottenere complessivamente e, separatamente, per ogni sottogruppo che hai promesso di riportare.
- Proporzione ipotizzata (p): il valore usato e da dove viene. Dichiara apertamente se è 0,5 perché non c’era niente di meglio.
- Correzione per popolazione finita: se l’hai applicata e che cosa l’ha resa necessaria, per esempio n0 superiore al 10 per cento di N.
- Obiettivo di risposte complete (n): il numero finale di risposte complete necessarie dopo ogni correzione.
- Tasso di risposta atteso: il tasso ipotizzato, lo storico da cui proviene e il numero di inviti che ne risulta.
- Come selezionerai le persone: casuale semplice, stratificato, censimento o convenienza, più l’eventuale sovracampionamento dei segmenti chiave. Chiamalo con il suo nome, onestamente.
Una volta avviata la rilevazione, continua a controllare le risposte complete per segmento invece del totale. Un buon numero complessivo può nascondere un segmento che non raggiungerà mai il suo obiettivo, ed è un problema che puoi ancora risolvere alla prima settimana ma non alla quarta. Quando riporti i risultati, accompagna ogni percentuale con il suo margine di errore, e leggi come analizzare i dati di un questionario prima di considerare reale uno spostamento di due punti.
Foglio di pianificazione della dimensione del campione
Una pagina che puoi stampare, compilare a mano e allegare a un documento di progetto. Compila la colonna centrale prima di iniziare la rilevazione, non dopo. Niente viene inviato altrove e non serve alcun account.
| Decisione | Il tuo valore | Promemoria |
|---|---|---|
| Popolazione (N) | Chi esattamente, e quanti. Scrivi la definizione, non solo il numero. | |
| Che cosa stai misurando | Una percentuale o una media. Questa pagina dimensiona le percentuali. | |
| Livello di confidenza | 95% a meno che tu non abbia un motivo. Scrivi il motivo. | |
| Margine di errore (E) | Lo scarto che devi saper distinguere, in punti. | |
| Proporzione ipotizzata (p) | 0,5 se non esiste niente di meglio. Indica da dove viene un valore diverso. | |
| Correzione per popolazione finita | Applicata o no, e che cosa l’ha resa necessaria. | |
| Obiettivo di risposte complete (n) | Il dato finale dopo ogni correzione. | |
| Sottogruppi riportati separatamente | Quanti, e le risposte complete che ciascuno deve fornire da solo. | |
| Tasso di risposta atteso | Il tasso e lo storico che lo giustifica. Non un numero preso da internet. | |
| Inviti da spedire | Risposte complete divise per il tasso, arrotondate per eccesso. Mai più di N. | |
| Come vengono selezionate le persone | Casuale, stratificato, censimento o convenienza. Chiamalo con il suo nome, onestamente. | |
| Verifica durante la rilevazione | La data in cui controllerai le risposte complete per segmento, non solo il totale. |
Formula: n0 = (z^2 x p x (1 - p)) / E^2, poi n = n0 / (1 + (n0 - 1) / N). Fonte: Cochran (1977); NIST/SEMATECH e-Handbook sezione 3.3.3; Israel (1992). Foglio tratto da https://www.supersurvey.com/Sample-Size
Domande frequenti
Che cos’è la dimensione del campione?
La dimensione del campione è il numero di risposte complete di un’indagine, indicato con n. Non è il numero di persone che hai invitato, e non è la dimensione della popolazione che stai descrivendo. È il numero con cui chiudi la rilevazione sul campo, ed è il dato da cui si calcola il tuo margine di errore: 385 risposte complete danno circa più o meno 5 punti con un livello di confidenza del 95 per cento quando la popolazione è grande. Che cosa significa dimensione del campione spiega la differenza tra la popolazione, gli inviti e n.
Di quante risposte ho bisogno per un questionario?
Per la maggior parte dei questionari la risposta operativa è 385 risposte complete. È ciò che restituisce la formula con un livello di confidenza del 95 per cento, un margine di errore di più o meno 5 punti percentuali e nessuna stima preliminare del risultato. Se la tua popolazione è piccola, te ne servono meno: 278 per un elenco di 1.000 persone, 80 per un elenco di 100. Inserisci i tuoi numeri nel calcolatore per vedere il dato esatto e i calcoli che ci stanno dietro.
Quale dimensione del campione mi serve per un livello di confidenza del 95 per cento e un margine di errore del 5 per cento?
385 risposte complete, se la popolazione è grande e usi p = 0,5. Il calcolo è n0 = 1,96 al quadrato per 0,5 per 0,5, diviso 0,05 al quadrato, cioè 0,9604 diviso 0,0025, cioè 384,16. Arrotonda per eccesso e ottieni 385. Se la tua popolazione è piccola, applica la correzione per popolazione finita e il numero scende.
Che cos’è il margine di errore?
Il margine di errore è la fascia di più o meno intorno al risultato di un’indagine, dovuta al fatto di aver campionato alcune persone invece di tutte. Un risultato del 62 per cento con un margine di errore di 5 punti significa che il metodo produrrebbe un intervallo contenente il valore vero nella maggior parte dei casi, e che questo particolare intervallo va dal 57 al 67 per cento. Descrive solo l’errore di campionamento casuale. Non dice nulla sulle persone che non hanno mai risposto.
Come si calcola il margine di errore?
Calcola la radice quadrata di p per (1 meno p) diviso n, poi moltiplicala per il valore z del tuo livello di confidenza. Con un livello di confidenza del 95 per cento, 385 risposte e p = 0,5, si ha 1,96 per la radice quadrata di 0,25 diviso 385, cioè 1,96 per 0,025482, cioè 0,0499. Quindi il margine di errore è di più o meno 5,0 punti percentuali. Il calcolatore del margine di errore di questa pagina lo fa per te e mostra i passaggi.
Il margine di errore aumenta con la dimensione del campione?
No, diminuisce, e diminuisce con la radice quadrata del campione. Passare da 100 risposte a 400 dimezza il margine di errore. Passare da 400 a 1.600 lo dimezza di nuovo. È questa relazione con la radice quadrata a rendere costosa la precisione: ogni ulteriore cifra decimale di accuratezza costa circa quattro volte le risposte.
Il margine di errore è la stessa cosa dell’errore standard?
No. L’errore standard è la dispersione di fondo della stima. Il margine di errore è l’errore standard moltiplicato per il valore z del livello di confidenza scelto. Con un livello di confidenza del 95 per cento il margine di errore è di circa 1,96 errori standard. L’errore standard è una proprietà dei dati. Il margine di errore è una scelta di presentazione che vi si sovrappone.
Qual è una buona dimensione del campione per la ricerca quantitativa?
Non esiste un unico numero giusto, e qualsiasi fonte te ne dia uno senza chiederti che cosa stai misurando sta tirando a indovinare. Per uno studio che riporta percentuali da una popolazione inferiore a circa 10.000 persone, la risposta difendibile è quella che restituisce la formula con un livello di confidenza del 95 per cento e un margine di errore che sai giustificare. Per un elenco di 1.000 sono 278. Il numero che fa approvare un capitolo di metodologia non è un numero grande, è un numero dichiarato con accanto il livello di confidenza, il margine di errore, la proporzione ipotizzata e la popolazione. Vedi la dimensione del campione nella ricerca quantitativa per le formule con un nome che il tuo relatore potrebbe aspettarsi.
Qual è un tasso di risposta normale per un questionario?
Non esiste un unico tasso normale, e qualsiasi pagina che citi un solo numero sta tirando a indovinare. I dati reali e con fonte dello stesso periodo vanno dal 6 per cento (sondaggi telefonici Pew nel 2018) al 71 per cento (piccole agenzie federali statunitensi nella Federal Employee Viewpoint Survey 2024). Una meta-analisi di 1.071 indagini online pubblicate ha trovato una media del 44,1 per cento. La dimensione dell’organizzazione conta moltissimo: la stessa indagine federale ha ottenuto il 71 per cento dalle agenzie con meno di 1.000 persone e il 37 per cento da quelle con più di 75.000. Usa prima di tutto il tuo storico, e consulta la tabella di riferimento per dati che puoi citare.
La dimensione della popolazione conta per la dimensione del campione?
Pochissimo, finché il tuo campione non diventa una quota consistente della popolazione. Passare da 100.000 persone a 1.000.000 porta il requisito da 383 a 385. Passare da 1.000 persone a 100 lo porta da 278 a 80. La dimensione della popolazione conta per le popolazioni piccole, che è proprio dove si applica la correzione per popolazione finita.
Quando p = 0,5 è la scelta giusta?
Usa p = 0,5 ogni volta che non hai una stima preliminare difendibile. Il termine p per (1 meno p) è massimo a 0,5, quindi produce il campione necessario più grande. Per questo è l’ipotesi sicura: non puoi restare sotto la soglia. Se hai uno studio pilota, un riferimento o il dato dell’anno scorso, usalo. Ipotizzare p = 0,9 invece di 0,5 riduce il campione necessario da 385 a 139.
Se invito più persone, elimino il bias di non risposta?
No. Più inviti ti danno più risposte complete, il che riduce il margine di errore. Il bias è un problema separato: dipende dal fatto che le persone che hanno risposto differiscano da quelle che non l’hanno fatto. Una meta-analisi di 59 studi sul bias di non risposta ha trovato solo una piccola relazione tra tasso di risposta e bias effettivo. Pew ha somministrato lo stesso questionario due volte, con un tasso di risposta del 9 per cento e del 22 per cento, e 28 delle 40 domande comuni hanno dato risultati entro 2 punti l’una dall’altra. Vedi bias di risposta e bias di non risposta.
Come gestisco la dimensione del campione se mi servono risultati per reparto o regione?
Dimensiona ogni sottogruppo separatamente. Il tuo margine di errore vale per un gruppo solo se quel gruppo ha altrettante risposte complete. Se vuoi più o meno 5 punti per ogni regione, ogni regione ha bisogno delle proprie 385 risposte complete, o del proprio numero corretto per popolazione finita. Usa le domande demografiche per identificare i gruppi e prevedi di sovracampionare quelli piccoli.
Quale dimensione del campione mi serve per un risultato statisticamente significativo?
Questa domanda mescola due idee. Le formule della dimensione del campione dimensionano una stima per una precisione scelta. I test di significatività confrontano due numeri e chiedono se lo scarto possa plausibilmente essere dovuto al caso. La dimensione che ti serve dipende da quanto piccolo è lo scarto che vuoi poter rilevare, non da una soglia fissa. Dimensiona l’indagine qui, poi leggi significatività statistica prima di confrontare un risultato con un altro.
Queste formule funzionano per la ricerca qualitativa?
No. Interviste, focus group e lavori con domande aperte non si dimensionano con un margine di errore, perché non stimano una percentuale della popolazione. La dimensione del campione qualitativo si argomenta con la saturazione, il punto in cui i nuovi partecipanti smettono di far emergere nuovi temi, e si riporta come un giudizio supportato da prove, non come una formula. Non far passare uno studio qualitativo in questo calcolatore.
Bibliografia
- National Institute of Standards and Technology (NIST). (s.d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, sezione 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.