
ขนาดกลุ่มตัวอย่างของแบบสำรวจคือจำนวนการตอบกลับที่สมบูรณ์ที่นำมาวิเคราะห์ เขียนแทนด้วย n ซึ่งต่างจากจำนวนคำเชิญหรือจำนวนคนในรายชื่อของคุณ ภายใต้ข้อสมมติด้านการสุ่มตัวอย่างของเครื่องคำนวณ กลุ่มตัวอย่างที่ใหญ่ขึ้นทำให้ค่าความคลาดเคลื่อนแคบลง แต่ไม่ได้ขจัดการสรรหาที่มีอคติหรือคำถามที่เขียนไม่ดี
เครื่องคำนวณขนาดกลุ่มตัวอย่าง
ไม่มีสิ่งใดต้องสมัครสมาชิกก่อนใช้ และไม่มีข้อมูลใดถูกส่งออกไป เครื่องคำนวณทำงานในเบราว์เซอร์ของคุณ เริ่มต้นด้วยคำตอบตัวอย่างที่คำนวณไว้บนหน้าจอแล้ว และแสดงสูตรกับการคำนวณที่ใช้ เพื่อให้คุณตรวจสอบหรือคำนวณซ้ำด้วยมือได้
คุณต้องการการตอบกลับกี่รายการ?
กำหนดค่าที่ป้อนทั้งหกค่า คำตอบ สูตร และการคำนวณจะอัปเดตทันทีขณะที่คุณพิมพ์
การตอบกลับที่สมบูรณ์ที่ต้องการ
370
หลังปรับแก้สำหรับประชากรจำกัด
จำนวนคนที่ต้องเชิญ
1,234
ที่อัตราการตอบกลับร้อยละ 30
สัดส่วนการสุ่ม
3.7%
สัดส่วนของประชากรที่คุณต้องได้รับคำตอบ
รวม เมื่อกำหนดขนาดต่อกลุ่มย่อย
370
การคำนวณทีละขั้น
| ค่าความคลาดเคลื่อน | การตอบกลับที่ต้องการ | คำเชิญที่ต้องการ |
|---|
ความแม่นยำที่สูงขึ้นต้องใช้การตอบกลับเพิ่มขึ้นประมาณกำลังสองของการปรับปรุง การลดค่าความคลาดเคลื่อนลงครึ่งหนึ่งทำให้กลุ่มตัวอย่างเพิ่มขึ้นราวสี่เท่า
ปุ่มคัดลอกจะเขียนย่อหน้าระเบียบวิธีสั้น ๆ พร้อมตัวเลขของคุณ สูตร และการอ้างอิง พร้อมวางลงในเอกสารสรุปโครงการหรือบทระเบียบวิธีวิจัย
อ้างอิงเครื่องคำนวณนี้: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
ผลลัพธ์คือการตอบกลับที่สมบูรณ์ ไม่ใช่คำเชิญ เป็นจำนวนที่คุณต้องมีอยู่ในมือเมื่อจบการเก็บข้อมูลภาคสนาม จำนวนคำเชิญคือตัวเลขนั้นหารด้วยอัตราการตอบกลับที่คาดไว้ ซึ่งเป็นจุดที่แผนกลุ่มตัวอย่างส่วนใหญ่ผิดพลาด เมื่อกำหนดเป้าหมายแล้ว ให้สร้างแบบสำรวจของคุณ และทดลองนำร่องกับกลุ่มเป้าหมายที่ตั้งใจไว้ ใช้การทดลองนำร่องตรวจถ้อยคำและประมาณอัตราจากคำเชิญถึงการตอบจนจบสำหรับโครงการของคุณเอง
ขนาดกลุ่มตัวอย่างหมายถึงอะไร
ขนาดกลุ่มตัวอย่างคือจำนวนคนที่ตอบแบบสำรวจของคุณจนจบ เขียนแทนด้วย n ในทุกสูตรในหน้านี้ เป็นปริมาณเดียวที่คุณได้มาด้วยการเก็บข้อมูลภาคสนาม ไม่ใช่เลือกบนกระดาษ และเป็นตัวเลขที่ใช้คำนวณค่าความคลาดเคลื่อนของคุณ
มีจำนวนสามแบบที่มักถูกเข้าใจผิดว่าเป็นขนาดกลุ่มตัวอย่าง และการแยกแยะทั้งสามคืองานส่วนใหญ่ของแผนกลุ่มตัวอย่าง:
- ประชากร (N): ทุกคนที่คุณต้องการอธิบาย เช่น รายชื่อลูกค้า จำนวนพนักงาน หรือประเทศหนึ่ง
- คำเชิญ: จำนวนคนที่คุณติดต่อ มากกว่า n เสมอ เพราะไม่ใช่ทุกคนจะตอบ
- ขนาดกลุ่มตัวอย่าง (n): จำนวนการตอบกลับที่สมบูรณ์ที่คุณมีเมื่อจบการเก็บข้อมูลภาคสนาม นี่คือตัวเลขที่สูตรคำนวณ และเป็นตัวเดียวในสามตัวที่เปลี่ยนค่าความคลาดเคลื่อนของคุณ
ขนาดกลุ่มตัวอย่างช่วยเพิ่มความแม่นยำ ซึ่งคือความกว้างของช่วงบวกลบรอบผลลัพธ์แต่ละตัว แต่ไม่ได้ช่วยเรื่องความถูกต้อง ซึ่งคือการที่คนที่ตอบคล้ายกับคนที่ไม่ได้ตอบหรือไม่ กลุ่มตัวอย่างแบบบังเอิญขนาดใหญ่อาจห่างจากความจริงมากกว่ากลุ่มตัวอย่างสุ่มขนาดเล็ก และไม่มีค่า n ใดแก้ปัญหานั้นได้ จุดที่การวางแผนขนาดกลุ่มตัวอย่างผิดพลาดอธิบายความต่างนี้ และวิธีที่คุณสุ่มกลุ่มตัวอย่างคือสิ่งที่ตัดสิน
คำตอบสั้น ๆ หากคุณต้องการแค่ตัวเลข
ตัวเลขสำคัญ
- การตอบกลับที่สมบูรณ์ 385 รายการคือคำตอบตั้งต้น นี่คือค่าที่สูตรให้ที่ระดับความเชื่อมั่นร้อยละ 95 ค่าความคลาดเคลื่อนบวกลบ 5 จุดเปอร์เซ็นต์ และไม่มีค่าประมาณผลล่วงหน้า
- ประชากรขนาดเล็กต้องการน้อยกว่ามาก รายชื่อ 1,000 คนต้องการ 278 รายชื่อ 100 คนต้องการ 80 นี่คือผลของการปรับแก้สำหรับประชากรจำกัด
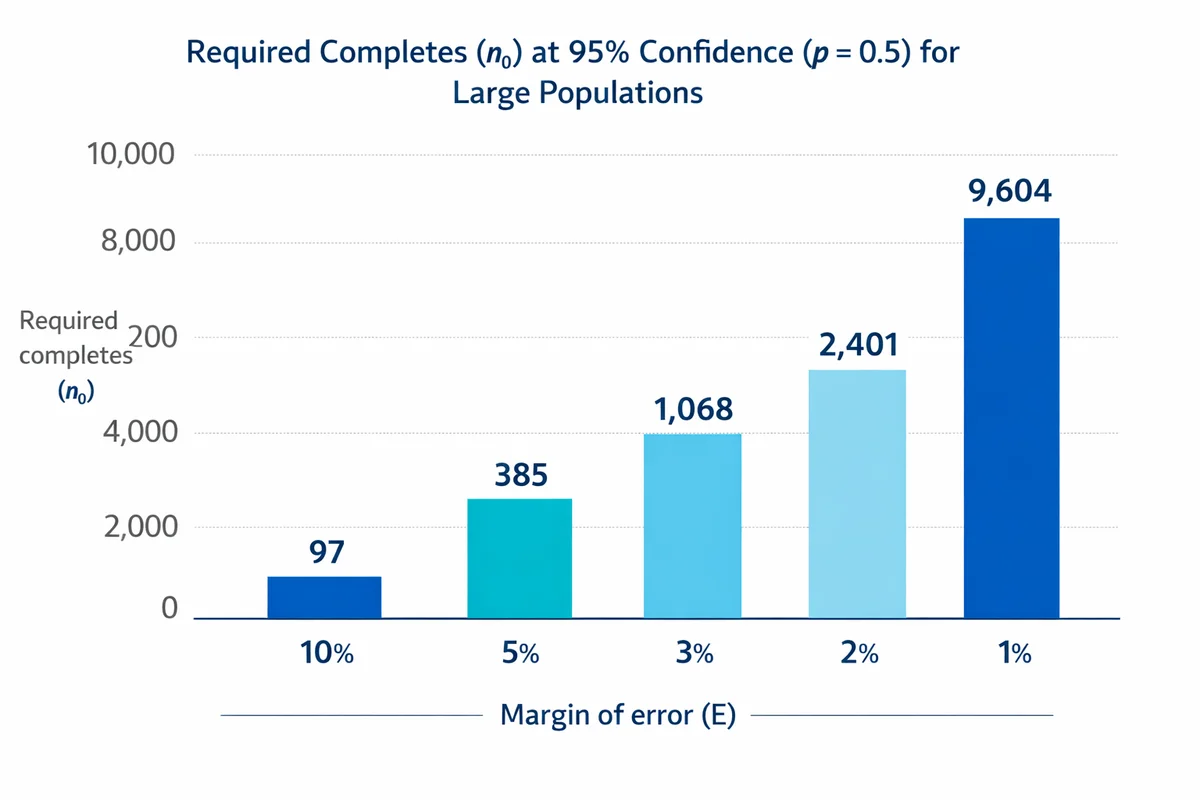
- ความแม่นยำมีราคาแพง การลดค่าความคลาดเคลื่อนลงครึ่งหนึ่งทำให้กลุ่มตัวอย่างเพิ่มขึ้นราวสี่เท่า การเปลี่ยนจากบวกลบ 5 จุดเป็นบวกลบ 1 จุด ทำให้จำนวนเพิ่มจาก 385 เป็น 9,604
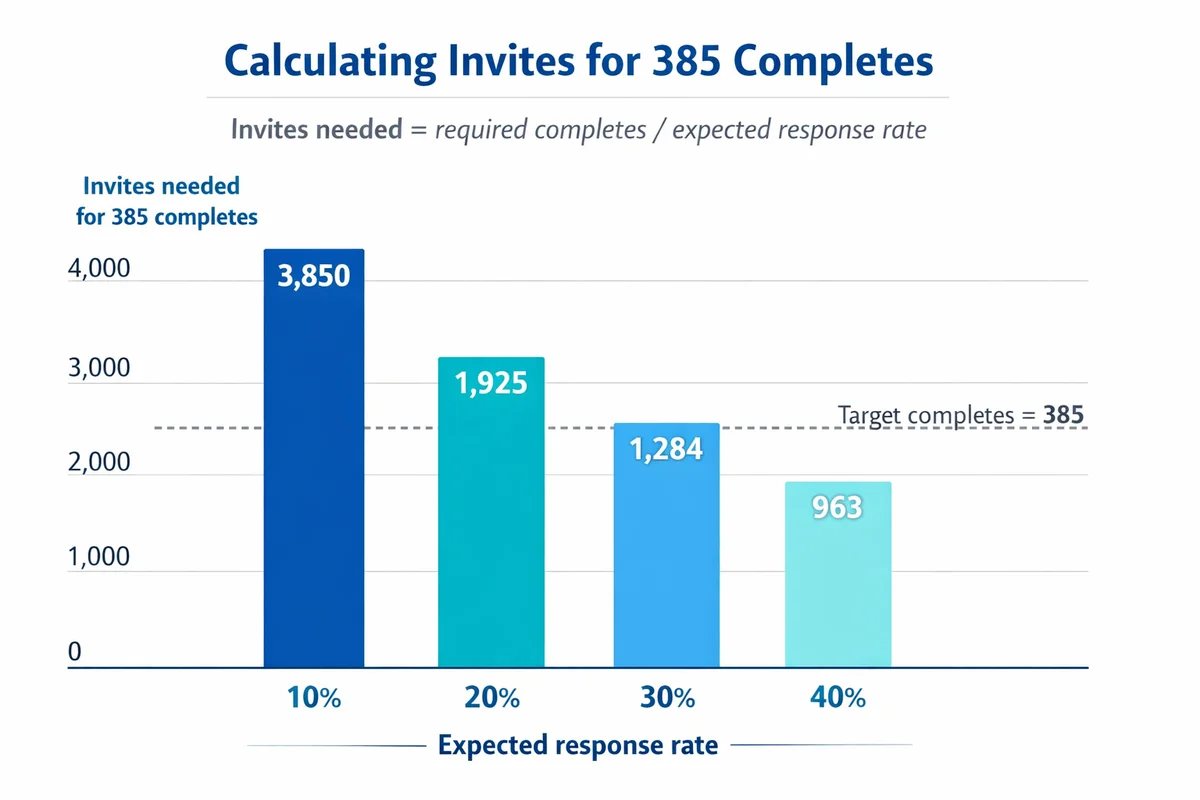
- สูตรนับการตอบกลับที่สมบูรณ์ ไม่ใช่คำเชิญ จำนวนคำเชิญที่ต้องการเท่ากับจำนวนการตอบกลับที่สมบูรณ์หารด้วยอัตราการตอบกลับที่คาดไว้ ที่ร้อยละ 30 การตอบกลับที่สมบูรณ์ 385 รายการหมายถึงต้องเชิญ 1,284 คน
- ค่าความคลาดเคลื่อนครอบคลุมความคลาดเคลื่อนเพียงแบบเดียว วัดความแปรปรวนที่เกิดจากการสุ่มบางคนแทนการวัดทุกคน และไม่ได้บอกอะไรเลยเกี่ยวกับคนที่ไม่เคยตอบ
สูตรขนาดกลุ่มตัวอย่าง และวิธีคำนวณด้วยมือ
สำหรับแบบสำรวจที่รายงานค่าร้อยละ จุดเริ่มต้นมาตรฐานคือขนาดกลุ่มตัวอย่างสำหรับประชากรที่ใหญ่พอจะถือว่าไม่จำกัด:
n0 = (z^2 x p x (1 - p)) / E^2
อ่านจากซ้ายไปขวา:
- n0 คือจำนวนการตอบกลับที่สมบูรณ์ที่ต้องการ ก่อนปรับแก้สำหรับประชากร
- z คือค่า z สำหรับระดับความเชื่อมั่นของคุณ ใช้ 1.96 สำหรับร้อยละ 95
- p คือสัดส่วนที่คุณคาดว่าจะวัดได้ ในรูปทศนิยม ใช้ 0.5 หากไม่ทราบ
- E คือค่าความคลาดเคลื่อนในรูปทศนิยม ห้าจุดเปอร์เซ็นต์คือ 0.05
สัญลักษณ์ของขนาดกลุ่มตัวอย่างคือ n บางแหล่งเขียนค่าก่อนปรับแก้เป็น n0 และค่าหลังปรับแก้เป็น n ซึ่งเป็นแบบที่ใช้ในหน้านี้
| ระดับความเชื่อมั่น | z | สิ่งที่ต้องแลก |
|---|---|---|
| ร้อยละ 80 | 1.282 | การตอบกลับที่สมบูรณ์ 165 รายการ ที่บวกลบ 5 จุด |
| ร้อยละ 90 | 1.645 | การตอบกลับที่สมบูรณ์ 271 รายการ |
| ร้อยละ 95 (มาตรฐาน) | 1.960 | การตอบกลับที่สมบูรณ์ 385 รายการ |
| ร้อยละ 99 | 2.576 | การตอบกลับที่สมบูรณ์ 664 รายการ |
| ร้อยละ 99.9 | 3.291 | การตอบกลับที่สมบูรณ์ 1,084 รายการ |
ตัวอย่างการคำนวณ: จาก 385 สู่รายชื่อผู้ได้รับเชิญ
สถานการณ์ คุณต้องการทราบร้อยละของลูกค้าที่จะแนะนำคุณต่อ ต้องการระดับความเชื่อมั่นร้อยละ 95 และบวกลบ 5 จุด คุณไม่มีค่าประมาณล่วงหน้า ดังนั้น p = 0.5
เลือกระดับความเชื่อมั่นและค่าความคลาดเคลื่อน
ระดับความเชื่อมั่นร้อยละ 95 ให้ z = 1.96 บวกลบ 5 จุดเปอร์เซ็นต์คือ E = 0.05
เลือกผลที่คาดไว้
p = 0.5 เพราะไม่มีค่าประมาณล่วงหน้า และ 0.5 ให้กลุ่มตัวอย่างใหญ่ที่สุด ไม่ว่าคุณจะพบอะไรภายหลังก็จะไม่ขาด
ใช้สูตรขนาดกลุ่มตัวอย่าง
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
ปัดขึ้น: การตอบกลับที่สมบูรณ์ 385 รายการ ปัดขึ้นเสมอ คุณเก็บแบบสำรวจเป็นเศษส่วนไม่ได้
ปรับแก้สำหรับประชากรขนาดเล็ก
หากลูกค้าเหล่านั้นเป็นรายชื่อ 1,000 คน ไม่ใช่ตลาดเปิด ให้ปรับแก้: n = 384.16 / (1 + 383.16 / 1,000) = 384.16 / 1.38316 = 277.7 จึงได้การตอบกลับที่สมบูรณ์ 278 รายการ การปรับแก้จะมีผลชัดก็ต่อเมื่อกลุ่มตัวอย่างเป็นสัดส่วนใหญ่ของประชากร
แปลงการตอบกลับที่สมบูรณ์เป็นคำเชิญ
ที่อัตราการตอบกลับร้อยละ 30 คำเชิญ = 278 / 0.30 = 926.7 จึงเชิญ 927 คน การตอบกลับที่สมบูรณ์คือสิ่งที่สูตรคำนวณ คำเชิญคือสิ่งที่คุณส่งจริง และต้องไม่เกินประชากรที่คุณสุ่มมา
ที่ระดับความเชื่อมั่นร้อยละ 95 และ p = 0.5 สูตรทั้งหมดจะเหลือเพียง 0.9604 หารด้วย E ยกกำลังสอง ทางลัดนี้ตอบคำถามเรื่องขนาดกลุ่มตัวอย่างส่วนใหญ่ได้ในบรรทัดเดียว และเป็นเหตุผลที่ 385 ปรากฏซ้ำในตารางขนาดกลุ่มตัวอย่างที่คุณพบที่อื่น
ตารางขนาดกลุ่มตัวอย่างสำหรับขนาดประชากรที่พบบ่อย
ตัวเลขเหล่านี้คำนวณด้วยสูตรข้างต้นที่ระดับความเชื่อมั่นร้อยละ 95 บวกลบ 5 จุด และ p = 0.5 แล้วปรับแก้ตามประชากร สองคอลัมน์สุดท้ายคือการตรวจสอบของเราเองเทียบกับตารางที่ Krejcie และ Morgan ตีพิมพ์ในปี 1970 ซึ่งเป็นตารางที่บทระเบียบวิธีวิจัยส่วนใหญ่อ้างถึง
| ประชากร (N) | การตอบกลับที่ต้องการ | Krejcie และ Morgan (1970) | ผลต่าง |
|---|---|---|---|
| 10 | 10 | 10 | เท่ากัน |
| 25 | 24 | ไม่มีในตาราง | |
| 50 | 45 | 44 | มากกว่าอยู่ 1 ราย |
| 100 | 80 | 80 | เท่ากัน |
| 200 | 132 | 132 | เท่ากัน |
| 500 | 218 | 217 | มากกว่าอยู่ 1 ราย |
| 1,000 | 278 | 278 | เท่ากัน |
| 2,000 | 323 | 322 | มากกว่าอยู่ 1 ราย |
| 5,000 | 357 | 357 | เท่ากัน |
| 10,000 | 370 | 370 | เท่ากัน |
| 50,000 | 382 | 381 | มากกว่าอยู่ 1 ราย |
| 100,000 | 383 | 384 | น้อยกว่าอยู่ 1 ราย |
วิธีที่เราตรวจสอบ เราคำนวณสูตรที่ขนาดประชากร 21 ค่า และเทียบผลแต่ละค่ากับค่าที่ Krejcie และ Morgan ตีพิมพ์ไว้ สิบสองค่าตรงกันพอดี อีกเก้าค่าต่างกันเพียงหนึ่งรายพอดี ซึ่งมาจากจุดที่แต่ละวิธีปัดเศษ ไม่ใช่จากความเห็นต่างเรื่องการคำนวณ หากอาจารย์ที่ปรึกษาถามว่าทำไมตัวเลขของคุณต่างจากตารางหนึ่งราย นั่นคือเหตุผล
สิ่งที่ควรรู้หากคุณอ้างถึงตารางนั้น: Krejcie และ Morgan ไม่ได้คิดสูตรขึ้นเอง บทความปี 1970 ของทั้งสองมีความยาวราว 400 คำบวกตารางหนึ่งตาราง และเอกสารอ้างอิงเพียงรายการเดียวระบุว่าสูตรมาจากวารสารวิจัยปี 1960 ของ National Education Association คำสรุปรูปแบบของทั้งสองเองยังคงเป็นคำอธิบายบรรทัดเดียวที่ดีที่สุด คือเมื่อประชากรเพิ่มขึ้น กลุ่มตัวอย่างที่ต้องการจะเพิ่มขึ้นในอัตราที่ลดลง และคงที่อยู่ที่มากกว่า 380 รายเล็กน้อย
การเลือกค่าที่ป้อนทีละค่า
ตัวเลขสี่ตัวกำหนดคำตอบ สามตัวเป็นการตัดสินใจ ไม่ใช่ข้อเท็จจริง และแต่ละตัวมีวิธีเลือกที่อธิบายได้อย่างมีน้ำหนัก
ระดับความเชื่อมั่น: วิธีนี้ถูกบ่อยแค่ไหน
ระดับความเชื่อมั่นอธิบายวิธีการ ไม่ใช่แบบสำรวจชุดนี้โดยเฉพาะ ที่ระดับความเชื่อมั่นร้อยละ 95 ช่วงที่สร้างด้วยวิธีนี้จะครอบคลุมค่าจริง 95 ครั้งจาก 100 ครั้งในระยะยาว ไม่ได้หมายความว่าคำตอบเฉพาะของคุณมีโอกาสถูกต้องร้อยละ 95
ใช้ร้อยละ 95 เว้นแต่มีเหตุผลที่จะไม่ใช้ การเปลี่ยนเป็นร้อยละ 99 ทำให้กลุ่มตัวอย่างเพิ่มจาก 385 เป็น 664 สำหรับความแม่นยำเท่าเดิม คือต้นทุนเพิ่มร้อยละ 72 เพื่อแลกกับประโยชน์น้อยมาก แนวคิดที่เกี่ยวข้องในการทดสอบสมมติฐานคือค่า alpha ซึ่งเป็นเหตุผลที่คนสับสนสองเรื่องนี้ หากยังแยกไม่ชัด อ่านนัยสำคัญทางสถิติและความหมายของค่า pก่อนเลือกตัวเลข
ค่าความคลาดเคลื่อน: ตัวแปรของการตัดสินใจ
นี่คือค่าที่ต้องคิดหนักที่สุด เพราะเป็นค่าที่ป้อนเพียงค่าเดียวที่ผูกกลุ่มตัวอย่างไว้กับการตัดสินใจ เลือกโดยถามว่าช่องว่างขนาดเท่าใดที่จะเปลี่ยนสิ่งที่คุณทำ
หากคุณจะทำต่างกันเมื่อความพึงพอใจอยู่ที่ร้อยละ 72 แทนที่จะเป็นร้อยละ 74 คุณต้องการค่าความคลาดเคลื่อนที่แคบ หากคุณจะทำต่างกันก็ต่อเมื่อเป็น 72 เทียบกับ 82 บวกลบ 5 จุดก็เพียงพอ การรายงานภาพรวมโดยทั่วไปมักอยู่ที่ 5 จุดสำหรับการวัดชีพจรอย่างรวดเร็ว หรือ 3 จุดสำหรับการติดตามแนวโน้ม ต่ำกว่า 2 จุดต้นทุนจะพุ่งขึ้นอย่างรวดเร็ว
ขนาดประชากร: แทบไม่มีผล จนกระทั่งมีผล
สำหรับประชากรขนาดใหญ่ กลุ่มตัวอย่างที่ต้องการแทบไม่เปลี่ยน คนหนึ่งหมื่นคนต้องการการตอบกลับ 370 รายการ หนึ่งแสนคนต้องการ 383 ขนาดประชากรจะมีผลก็ต่อเมื่อกลุ่มตัวอย่างเป็นสัดส่วนที่มีนัยของประชากร ซึ่งเป็นกรณีของรายชื่อพนักงาน ทะเบียนสมาชิก และนักเรียนในรุ่นหนึ่ง นั่นคือสิ่งที่ส่วนถัดไปอธิบาย
ผลที่คาดไว้ (p): ใช้ 0.5 เมื่อคุณไม่ทราบ
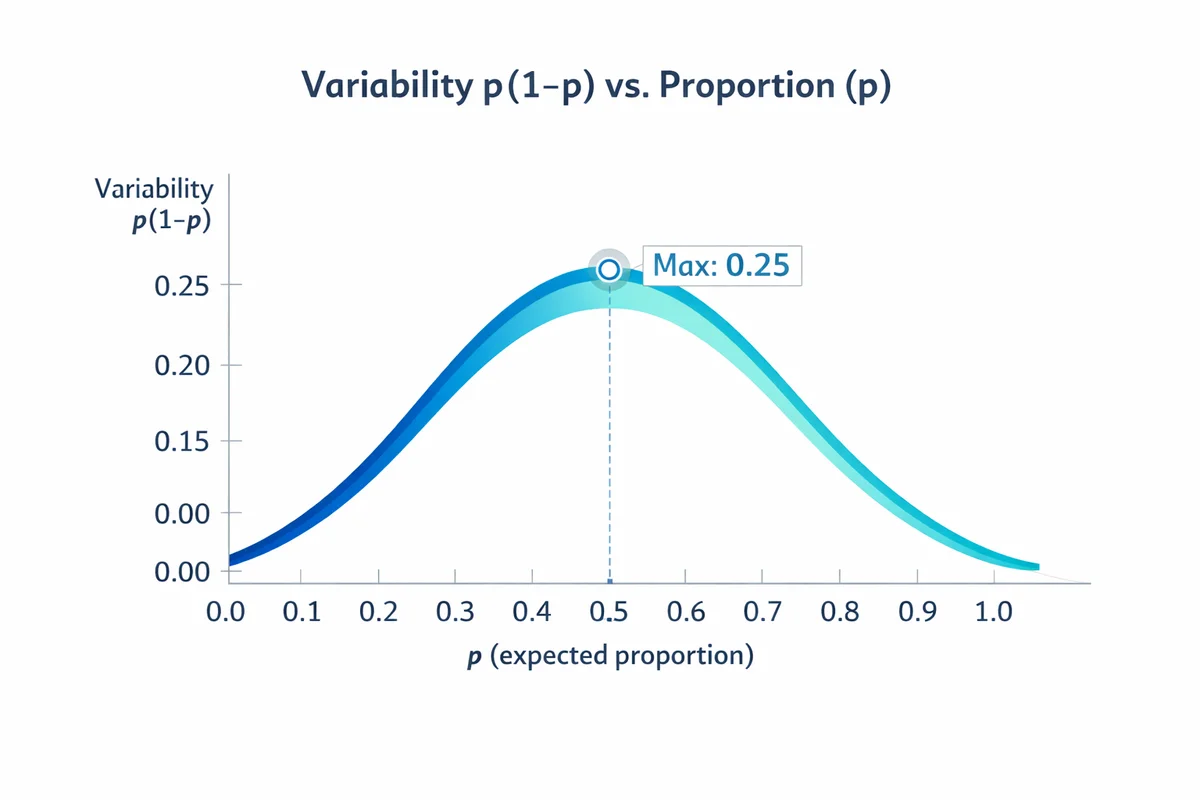
สำหรับคำถามที่วัดเป็นร้อยละ ความไม่แน่นอนขึ้นกับ p คูณ (1 ลบ p) ค่านี้สูงสุดที่ p = 0.5 ดังนั้น 0.5 จึงเป็นทางเลือกที่ระมัดระวังและให้กลุ่มตัวอย่างใหญ่ที่สุด และเป็นค่าตั้งต้นที่เหมาะสมเมื่อคุณไม่มีค่าประมาณล่วงหน้า
หากคุณมีค่าประมาณ ให้ใช้ เพราะประหยัดได้มาก ที่ระดับความเชื่อมั่นร้อยละ 95 และบวกลบ 5 จุด p = 0.5 ต้องการการตอบกลับ 385 รายการ และ p = 0.9 ต้องการ 139 รายการ แบบสำรวจในอดีต การทดลองนำร่อง หรือค่าอ้างอิงที่ตีพิมพ์ ล้วนเป็นแหล่งที่เหมาะสมสำหรับค่าประมาณนั้น คำถามที่คลุมเครือก็ทำให้การกระจายกว้างขึ้นเช่นกัน ถ้อยคำที่ชัดขึ้นจึงทำให้ผลนิ่งขึ้นได้โดยไม่ต้องเพิ่มการตอบกลับ การเขียนคำถามแบบสำรวจให้ดีขึ้นมักถูกกว่าการเก็บการตอบกลับเพิ่ม
ประชากรขนาดเล็ก: การปรับแก้สำหรับประชากรจำกัด
สูตรพื้นฐานสันนิษฐานว่าคุณสุ่มจากแหล่งที่ใหญ่พอ จนการดึงคนออกไปไม่ได้เปลี่ยนอะไร เมื่อกลุ่มตัวอย่างของคุณเป็นส่วนสำคัญของประชากร สมมติฐานนั้นจะทำให้คุณต้องเก็บเกินจำเป็น การปรับแก้สำหรับประชากรจำกัดจะคืนจำนวนการตอบกลับส่วนนั้นให้คุณ
n = n0 / (1 + ((n0 - 1) / N))
- n คือจำนวนการตอบกลับที่สมบูรณ์ที่ต้องการหลังปรับแก้
- n0 คือตัวเลขก่อนปรับแก้จากสูตรข้างต้น
- N คือขนาดประชากร
เกณฑ์ที่ใช้กันทั่วไปคือเมื่อ n0 มากกว่าราวร้อยละ 5 ของ N ต่ำกว่านั้นการปรับแก้แทบไม่เปลี่ยนอะไร จึงไม่คุ้มที่จะอธิบายให้ใครฟัง
ตัวอย่างการคำนวณ: แบบสำรวจพนักงาน
สถานการณ์ คุณมีพนักงาน 1,200 คน ต้องการระดับความเชื่อมั่นร้อยละ 95 บวกลบ 5 จุด และใช้ p = 0.5
- ก่อนปรับแก้ n0 = 384.16
- หลังปรับแก้: n = 384.16 / (1 + (383.16 / 1,200)) = 384.16 / 1.3193 = 291.2
- ปัดขึ้น: การตอบกลับที่สมบูรณ์ 292 รายการ
หากไม่ปรับแก้ คุณจะต้องตามเก็บการตอบกลับ 385 รายการจากรายชื่อ 1,200 คน คิดเป็นร้อยละ 32 ของทุกคน เมื่อปรับแก้แล้ว 292 รายการก็ได้ความแม่นยำเท่ากัน สำหรับรายชื่อขนาดนั้น นั่นคือการตามเก็บหนึ่งเดือนที่คุณไม่ต้องทำ
เมื่อมีคนต่ำกว่าราว 200 คน กลุ่มตัวอย่างหลังปรับแก้จะเป็นสัดส่วนที่ใหญ่มากของรายชื่อ การเชิญทุกคนจึงง่ายกว่าและอธิบายได้ดีกว่า สำมะโน 150 คนไม่มีความคลาดเคลื่อนจากการสุ่มตัวอย่างเลย ความพยายามของคุณจึงไปอยู่ที่อัตราการตอบกลับและที่ว่าใครขาดหายไป ซึ่งเป็นที่ที่ควรอยู่
ค่าความคลาดเคลื่อน: สูตรเดียวกัน คำนวณย้อนกลับ
ค่าความคลาดเคลื่อนคือช่วงบวกลบรอบผลแบบสำรวจ ที่เกิดจากการถามบางคนแทนการถามทุกคน หากร้อยละ 62 ของผู้ตอบ 385 คนเลือกตัวเลือกหนึ่ง และค่าความคลาดเคลื่อนคือ 5 จุด คุณรายงานร้อยละ 62 และระบุว่าช่วงที่เป็นไปได้อยู่ระหว่างร้อยละ 57 ถึง 67
เมื่อจัดสูตรขนาดกลุ่มตัวอย่างใหม่เพื่อหาค่า E จะได้:
E = z x รากที่สองของ (p x (1 - p) / n)
สำหรับประชากรจำกัด ให้คูณด้วยรากที่สองของ (N - n) หารด้วย (N - 1) ทั้งสองแบบอยู่ในเครื่องคำนวณด้านล่าง ซึ่งจะสลับให้อัตโนมัติเมื่อคุณติ๊กหรือเอาติ๊กออกจากช่องประชากร
การตอบกลับที่คุณมีอยู่แล้วมีค่าความคลาดเคลื่อนเท่าใด?
สูตรเดียวกันที่จัดรูปใหม่ ใส่จำนวนการตอบกลับที่คุณเก็บได้ แล้วอ่านค่าความแม่นยำที่ได้
ค่าความคลาดเคลื่อน
5.0
จุดเปอร์เซ็นต์ บวกลบ
ช่วงของคุณ
45.0 ถึง 55.0
ร้อยละ ที่ระดับความเชื่อมั่นร้อยละ 95
การคำนวณทีละขั้น
ค่าความคลาดเคลื่อนเพิ่มขึ้นตามขนาดกลุ่มตัวอย่างหรือไม่?
ค่าความคลาดเคลื่อนลดลง และลดลงตามรากที่สองของ n รากที่สองนี้คือเศรษฐศาสตร์ทั้งหมดของแบบสำรวจ การตอบกลับสี่ร้อยรายการให้ความคลาดเคลื่อนครึ่งหนึ่งของหนึ่งร้อยรายการ หากต้องการลดลงครึ่งหนึ่งอีกครั้ง คุณต้องใช้ 1,600 ความแม่นยำที่เพิ่มขึ้นทีละหนึ่งตำแหน่งทศนิยมมีต้นทุนราวสี่เท่าของงานภาคสนาม ซึ่งเป็นเหตุผลที่ 385 เป็นจุดที่คนเลือกกันบ่อย: เป็นจุดที่ต้นทุนกับความแม่นยำเลิกขัดแย้งกัน
สี่คำที่คนมักสับสน
ความคลาดเคลื่อนมาตรฐาน ค่าความคลาดเคลื่อน ระดับความเชื่อมั่น และช่วงความเชื่อมั่น ถูกใช้ราวกับว่าใช้แทนกันได้ แต่เป็นสี่สิ่งที่ต่างกัน และความต่างนั้นสำคัญเมื่อมีคนตั้งคำถามกับตัวเลขของคุณ
| คำ | ความหมาย | ที่การตอบกลับ 385 รายการ และร้อยละ 50 |
|---|---|---|
| ความคลาดเคลื่อนมาตรฐาน | การกระจายดิบของค่าประมาณ คือรากที่สองของ p คูณ (1 ลบ p) หารด้วย n | 0.0255 หรือ 2.55 จุดเปอร์เซ็นต์ |
| ค่าความคลาดเคลื่อน | ความคลาดเคลื่อนมาตรฐานคูณด้วยค่า z ของระดับความเชื่อมั่นที่คุณเลือก | บวกลบ 5.0 จุด ที่ร้อยละ 95 |
| ระดับความเชื่อมั่น | ค่า z ที่คุณเลือก แสดงเป็นร้อยละ เป็นทางเลือก ไม่ใช่ค่าที่วัดได้ | ร้อยละ 95 ดังนั้น z = 1.96 |
| ช่วงความเชื่อมั่น | ผลลัพธ์ที่นำค่าความคลาดเคลื่อนมาใช้แล้ว เขียนเป็นช่วง | ร้อยละ 45.0 ถึงร้อยละ 55.0 |
สรุปสั้น ๆ: ความคลาดเคลื่อนมาตรฐานเป็นคุณสมบัติของข้อมูลของคุณ ระดับความเชื่อมั่นเป็นสิ่งที่คุณเลือก ค่าความคลาดเคลื่อนคือสองค่านี้คูณกัน และช่วงความเชื่อมั่นคือสิ่งที่คุณพิมพ์ลงในรายงาน
สิ่งที่ค่าความคลาดเคลื่อนไม่ครอบคลุม
ค่าความคลาดเคลื่อนครอบคลุมความคลาดเคลื่อนจากการสุ่มตัวอย่างและไม่มีอะไรอื่น ไม่ครอบคลุมคนที่เพิกเฉยต่อคำเชิญ รายชื่อที่ขาดประชากรบางส่วน หรือคำถามที่ผู้ตอบครึ่งหนึ่งอ่านแล้วเข้าใจต่างจากที่คุณตั้งใจ แบบสำรวจอาจมีค่าความคลาดเคลื่อนที่ดูเรียบร้อยแต่ยังผิดได้ ดูอคติในการตอบและอคติจากการไม่ตอบกลับ สำหรับความคลาดเคลื่อนที่ขนาดกลุ่มตัวอย่างใดก็แก้ไม่ได้
องค์กรวิชาชีพด้านการวิจัยเชิงสำรวจพูดเรื่องนี้ตรงกว่าผู้ให้บริการส่วนใหญ่ AAPOR ระบุว่าไม่มีสิ่งที่เรียกว่าค่าความคลาดเคลื่อนโดยรวมที่วัดได้สำหรับโพล เพราะแบบสำรวจมีความคลาดเคลื่อนอื่นที่วัดไม่ได้เลย ตั้งแต่วิธีเขียนคำถามไปจนถึงวิธีดำเนินการสัมภาษณ์ สิ่งที่คุณคำนวณได้คือส่วนที่มาจากการสุ่มตัวอย่าง นั่นคือส่วนที่เครื่องคำนวณให้คุณ และควรชัดเจนว่ามันเป็นเพียงส่วนหนึ่ง
กฎการใช้สองข้อจากแหล่งเดียวกัน ซึ่งงานเขียนเกี่ยวกับแบบสำรวจส่วนใหญ่ทำผิดทั้งคู่:
- หน่วยคือจุดเปอร์เซ็นต์ ไม่ใช่เปอร์เซ็นต์ เขียนว่า “บวกลบ 3 จุดเปอร์เซ็นต์” ไม่ใช่ “บวกลบร้อยละ 3” ทั้งสองมีความหมายต่างกัน
- ใช้กับกลุ่มตัวอย่างแบบสมัครใจเข้าร่วมไม่ได้เลย ค่าความคลาดเคลื่อนสันนิษฐานว่าทุกคนมีโอกาสถูกเลือกที่ทราบค่าและไม่เป็นศูนย์ ลิงก์เปิด พาเนลอาสาสมัคร หรือโพสต์บนโซเชียลมีเดียไม่เป็นไปตามข้อนั้น การเผยแพร่ค่าความคลาดเคลื่อนคู่กับผลจากลิงก์เปิด คือการอ้างความแม่นยำที่คุณไม่ได้มีจริง
การแปลงการตอบกลับที่สมบูรณ์เป็นคำเชิญ
สูตรให้จำนวนการตอบกลับที่ตอบจนจบ งานภาคสนามให้อัตราการตอบกลับ ช่องว่างระหว่างสองอย่างนี้คือจุดที่แผนกลุ่มตัวอย่างมักล้มเหลว และการคำนวณมีเพียงบรรทัดเดียว:
คำเชิญ = การตอบกลับที่สมบูรณ์ที่ต้องการ / อัตราการตอบกลับที่คาดไว้
ใช้อัตราในรูปทศนิยม ร้อยละ 30 คือ 0.30 แล้วปัดขึ้น สำหรับการตอบกลับที่สมบูรณ์ 292 รายการที่ร้อยละ 35 คือ 292 หารด้วย 0.35 = 834.3 จึงต้องเชิญอย่างน้อย 835 คน
| การตอบกลับที่ต้องการ | อัตราการตอบกลับที่คาดไว้ | คำเชิญ |
|---|---|---|
| 385 | ร้อยละ 60 | 642 |
| 385 | ร้อยละ 30 | 1,284 |
| 385 | ร้อยละ 15 | 2,567 |
| 292 | ร้อยละ 50 | 584 |
| 292 | ร้อยละ 35 | 835 |
| 292 | ร้อยละ 20 | 1,460 |
การเลือกอัตราการตอบกลับที่อธิบายได้
ประวัติของคุณเองดีกว่าค่าอ้างอิงที่ตีพิมพ์ใด ๆ ตราบใดที่เป็นกลุ่มเป้าหมายเดียวกัน ช่องทางเดียวกัน และแบบสำรวจความยาวใกล้เคียงกัน หากไม่มีข้อมูลเลย ให้วางแผนสามสถานการณ์ที่ร้อยละ 20, 30 และ 40 และถือว่ารายชื่อผู้ได้รับเชิญเป็นคันโยกที่ปรับได้ระหว่างเก็บข้อมูลภาคสนาม ข้อความเตือน ช่วงเวลาที่ยาวขึ้น และรายชื่อที่กว้างขึ้น ล้วนเปลี่ยนได้ระหว่างทาง แต่เป้าหมายการตอบกลับที่สมบูรณ์เปลี่ยนไม่ได้
ตารางค่าอ้างอิงส่วนใหญ่บนอินเทอร์เน็ตอ้างค่าเฉลี่ยค่าเดียวโดยไม่มีแหล่งที่มา ไม่มีค่าเฉลี่ยเดียวแบบนั้น นี่คือสิ่งที่แหล่งที่มาปฐมภูมิรายงานจริง เพื่อให้คุณอ้างแถวที่ตรงกับสถานการณ์ของคุณ แทนตัวเลขที่ใครบางคนแต่งขึ้น
| บริบท | อัตราการตอบกลับ | ขนาดและแหล่งที่มา |
|---|---|---|
| หน่วยงานรัฐบาลกลางสหรัฐฯ ที่มีพนักงานไม่ถึง 1,000 คน | ร้อยละ 71 | Federal Employee Viewpoint Survey ปี 2024 (OPM) |
| หน่วยงานรัฐบาลกลางสหรัฐฯ ที่มีพนักงาน 1,000 ถึง 9,999 คน | ร้อยละ 60 | แบบสำรวจเดียวกัน ปีเดียวกัน (OPM) |
| หน่วยงานรัฐบาลกลางสหรัฐฯ ที่มีพนักงานมากกว่า 75,000 คน | ร้อยละ 37 | แบบสำรวจเดียวกัน ปีเดียวกัน (OPM) |
| พนักงานรัฐบาลกลางสหรัฐฯ ทั้งหมด | ร้อยละ 41 | เชิญกว่า 1.6 ล้านคน ตอบกลับกว่า 674,000 คน ปี 2024 (OPM) |
| แบบสำรวจออนไลน์ที่ตีพิมพ์ ทุกประเภท | ค่าเฉลี่ยร้อยละ 44.1 | การวิเคราะห์อภิมานของอัตราที่รายงาน 1,071 ค่า (Wu และคณะ, 2022) |
| งานวิจัยด้านองค์กรที่ตีพิมพ์ | ร้อยละ 68 ในปี 2020 เพิ่มจากร้อยละ 48 ในปี 2005 | แบบสำรวจ 1,014 ชุดจากวารสาร 17 ฉบับ (Holtom และคณะ, 2022) |
| โพลทางโทรศัพท์กับประชาชนทั่วไป | ร้อยละ 6 ในปี 2018 ลดลงจากร้อยละ 36 ในปี 1997 | อัตราที่ Pew Research Center ติดตามเอง (Kennedy และ Hartig, 2019) |
| ช่องทางเว็บเทียบกับช่องทางอื่นใด | ต่ำกว่าราว 12 จุด | การวิเคราะห์อภิมานของการเปรียบเทียบเชิงทดลอง 114 ครั้ง (Daikeler และคณะ, 2020) |
ตารางนี้บอกสองเรื่อง ประการแรก ขนาดของกลุ่มที่คุณสำรวจทำนายอัตราได้ดีกว่าเกือบทุกสิ่งที่คุณควบคุมได้ บริษัท 300 คนกับหน่วยงาน 300,000 คนไม่ได้ทำแบบสำรวจแบบเดียวกัน ประการที่สอง ข้อกล่าวอ้างที่พูดกันซ้ำ ๆ ว่าอัตราการตอบกลับกำลังดิ่งลงทุกที่นั้นจริงเพียงบางที่ โพลทางโทรศัพท์ดิ่งลงจริง แต่งานวิจัยด้านองค์กรที่ตีพิมพ์กลับไปในทางตรงข้าม จากร้อยละ 48 เป็นร้อยละ 68 ในสิบห้าปี
การคำนวณเพื่อวางแผนอีกข้อที่ควรนำไปใช้: แนวทางมาตรฐานคือเพิ่มรายชื่อผู้ได้รับเชิญอีกราวร้อยละ 10 สำหรับคนที่ติดต่อไม่ได้เลย และอีกราวร้อยละ 30 สำหรับคนที่ตอบได้แต่ไม่ตอบ
คลังเทมเพลตของเราเองบอกอะไรเรื่องความยาว
อัตราการตอบกลับที่ยืมมาจากแบบสำรวจของคนอื่นใช้ได้ไม่ดีนัก และความยาวเป็นหนึ่งในไม่กี่สิ่งในรายการนั้นที่คุณควบคุมได้ทั้งหมด นี่คือตัวเลขที่เราให้ได้แต่คู่แข่งให้ไม่ได้ เพราะมาจากการนับคลังที่เราเผยแพร่เอง ไม่ใช่การถามผู้ปฏิบัติงานว่าคิดว่าตนทำอะไร
ในการตรวจสอบของเราเมื่อวันที่ 21 สิงหาคม 2026 เทมเพลตแบบสำรวจทั้ง 87 ชุดมีคำถามไม่เกิน 14 ข้อ และ 86 ชุดมีคำถามไม่เกิน 10 ข้อ รวมกันมีคำถาม 799 ข้อ ค่ามัธยฐานคือ 9 ข้อ และมีเทมเพลตเพียงชุดเดียวที่เกิน 10 ข้อ ตัวเลขเหล่านี้อธิบายภาพ ณ วันที่ระบุ ไม่ใช่คลังเทมเพลตในปัจจุบัน
| จำนวนคำถามในเทมเพลต | เทมเพลต | สัดส่วนของคลัง |
|---|---|---|
| 7 ข้อ | 4 | ร้อยละ 5 |
| 8 ข้อ | 17 | ร้อยละ 20 |
| 9 ข้อ | 29 | ร้อยละ 33 |
| 10 ข้อ | 36 | ร้อยละ 41 |
| 14 ข้อ | 1 | ร้อยละ 1 |
แยกตามรูปแบบคำตอบ คำถาม 355 ข้อจาก 799 ข้อเป็นมาตราส่วนประมาณค่า 281 ข้อเป็นรายการตัวเลือกเดียว และ 163 ข้อให้ผู้ตอบพิมพ์คำตอบ กลุ่มสุดท้ายนี้คือกลุ่มที่ทำให้คุณเสียการตอบจนจบ เราจึงอ่านด้วยตาเองแทนการเชื่อช่องข้อมูลที่บันทึกไว้ จาก 163 ข้อ 137 ข้อเป็นช่องความคิดเห็นหลายบรรทัด อีก 26 ข้อเป็นช่องบรรทัดเดียว และเมื่ออ่านแล้วพบว่า 22 ข้อเป็นช่องสำหรับระบุตัวตนหรือจัดหมวดหมู่สั้น ๆ เช่น ชื่อ ที่อยู่อีเมล วันที่ แผนก หรือตำแหน่งงาน มีเพียง 4 ข้อที่เป็นคำตอบสั้นที่มีสาระ จำนวนคำถามปลายเปิดจริงที่นับอย่างตรงไปตรงมาจึงเป็น 141 ข้อ หรือราวหนึ่งในหกข้อ ไม่ใช่หนึ่งในห้าตามที่ช่องข้อมูลดิบจะบอกเรา
เรานับอย่างไร และตรวจสอบอย่างไร เราแยกรายการคำถามที่บันทึกไว้ของเทมเพลตแบบสำรวจทุกชุดที่เผยแพร่อยู่บนเว็บไซต์นี้เมื่อวันที่ 21 สิงหาคม 2026 เก็บเฉพาะรายการที่มีข้อความคำถาม แล้วดึงหน้าที่เผยแพร่แต่ละหน้ามาเทียบทั้งสองชุด แทนการเชื่อฐานข้อมูลของเราเพียงอย่างเดียว ทั้ง 87 หน้าตอบกลับ HTTP 200 ขณะที่ลิงก์ที่เรารู้ว่าใช้ไม่ได้แล้วตอบกลับ 410 ในการตรวจรอบเดียวกัน การตรวจจึงแยกแยะได้จริง ไม่ได้ผ่านทั้งหมดแบบไม่ดูอะไร คำถาม 785 ข้อจาก 799 ข้อ หรือร้อยละ 98 ปรากฏบนหน้าที่เผยแพร่ หกรายการในจำนวนนั้นต่างจากฐานข้อมูลเพียงอักขระเครื่องหมายอะพอสทรอฟีที่ใช้ และเรานับว่าตรงกัน ซึ่งเราขอเปิดเผยไว้มากกว่าจะปัดทิ้งอย่างเงียบ ๆ เทมเพลตแปดสิบหกชุดจาก 87 ชุดตรวจสอบได้ครบถ้วน ชุดที่ไม่ผ่านคือชุดที่ยาวที่สุดของเราซึ่งมี 14 ข้อ และหน้าที่เผยแพร่ของชุดนั้นไม่แสดงตัวอย่างคำถามเลยในขณะนี้ จึงยืนยันคำถามจากภายนอกไม่ได้
ความยาวของเทมเพลตไม่ได้บอกอัตราการตอบกลับจากคำเชิญ ค่าอ้างอิงการตอบแบบสำรวจของเราอีกชุดหนึ่งศึกษาพฤติกรรมหลังผู้คนเริ่มใช้แบบสำรวจแล้ว ไม่ได้นับทุกคนที่ได้รับเชิญ สำหรับการวางแผนคำเชิญ ให้ใช้อัตราที่มีการบันทึกไว้จากโครงการที่เทียบเคียงได้หรือจากการทดลองนำร่อง และใช้ตัวหารให้สอดคล้องกัน
ประโยชน์ในทางปฏิบัติมีขอบเขตแคบแต่มีอยู่จริง หากคุณยืมอัตราการตอบกลับมาใช้คำนวณจำนวนคำเชิญในเครื่องคำนวณ ให้ยืมจากแบบสำรวจที่ยาวพอ ๆ กับแบบที่คุณกำลังจะส่ง ไปยังกลุ่มเป้าหมายที่คล้ายกันผ่านช่องทางที่คล้ายกัน เครื่องมือที่เราเผยแพร่เองมีความยาว 7 ถึง 10 ข้อ ซึ่งสั้นกว่าร่างแรกของคนส่วนใหญ่
คำเชิญที่มากขึ้นไม่ได้ทำให้อคติน้อยลง
อัตราการตอบกลับที่ต่ำสร้างปัญหาสองข้อที่ดูเหมือนข้อเดียว ข้อแรกคือคุณได้ไม่ถึงเป้าหมาย ค่าความคลาดเคลื่อนจึงกว้างกว่าที่วางแผนไว้ ข้อที่สองคือคนที่ตอบอาจต่างจากคนที่ไม่ได้ตอบ ในแบบที่มีผลต่อผลลัพธ์ของคุณ
การเชิญคนเพิ่มแก้ปัญหาข้อแรกได้ แต่แก้ข้อที่สองได้ไม่แน่นอน Groves และ Peytcheva รวมการศึกษา 59 เรื่องที่วัดอคติจากการไม่ตอบกลับจริงเทียบกับความจริงที่ทราบ และพบความสัมพันธ์เพียงเล็กน้อยระหว่างอัตราการตอบกลับของแบบสำรวจกับระดับอคติที่เกิดขึ้น Pew ทดสอบแนวคิดเดียวกันโดยตรง: ทำแบบสอบถามเดียวกันสองครั้ง ครั้งหนึ่งด้วยวิธีมาตรฐานที่ได้อัตราการตอบกลับร้อยละ 9 และอีกครั้งด้วยวิธีที่ทุ่มความพยายามสูงซึ่งได้ร้อยละ 22 จากคำถาม 40 ข้อที่ทั้งสองแบบสำรวจมีร่วมกัน 28 ข้อได้ผลต่างกันไม่เกิน 2 จุด
กรณีโต้แย้งที่ต้องยอมรับ ข้อค้นพบนั้นใช้ไม่ได้กับทุกหัวข้อ และควรรู้ว่าใช้ไม่ได้ตรงไหน ในแบบสำรวจความพึงพอใจ ความสัมพันธ์นี้มีอยู่จริงและมีขนาดใหญ่ การศึกษาแบบสำรวจความพึงพอใจของผู้ป่วย 717 ชุดในโรงพยาบาล 164 แห่งในสวิตเซอร์แลนด์ พบว่าคะแนนความพึงพอใจเฉลี่ยกับอัตราการตอบกลับมีสหสัมพันธ์ r = 0.61 เพราะคนที่พอใจมากและโกรธมากจะตอบ ส่วนคนกลาง ๆ ไม่ตอบ หากคุณทำ CSAT หรือ NPS อัตราการตอบกลับที่สูงขึ้นอาจเปลี่ยนคะแนนของคุณได้เอง และอัตราที่ต่ำอาจทำให้คุณดูดีเกินจริง
สรุปคือ ให้ไล่ตามอัตราการตอบกลับเมื่อคุณวัดว่าผู้คนรู้สึกอย่างไรต่อคุณ อย่าถือว่าเป็นใบรับรองความถูกต้องเมื่อคุณวัดเรื่องอื่น
ขนาดกลุ่มตัวอย่างสำหรับการวิจัยเชิงปริมาณ: สิ่งที่บทระเบียบวิธีวิจัยต้องมี
ไม่มีขนาดกลุ่มตัวอย่างที่ดีเพียงค่าเดียวสำหรับการวิจัยเชิงปริมาณ และแหล่งใดที่ให้ตัวเลขโดยไม่ถามว่าคุณวัดอะไร ก็กำลังเดาเอา สิ่งที่ทำให้บทระเบียบวิธีวิจัยผ่านไม่ใช่ตัวเลขที่สูง แต่คือตัวเลขที่ระบุไว้ พร้อมระดับความเชื่อมั่น ค่าความคลาดเคลื่อน สัดส่วนที่สมมติ และขนาดประชากรกำกับไว้ข้าง ๆ และระบุชื่อสูตรที่ใช้
อาจารย์ที่ปรึกษามักคาดหวังหนึ่งในสี่แนวทางที่มีชื่อเรียก ซึ่งส่วนใหญ่ให้ผลสอดคล้องกัน และควรรู้ว่าคุณถูกขอให้ใช้แนวทางใด
| แนวทาง | สิ่งที่ต้องระบุ | ผลสำหรับ N = 1,000 ที่ร้อยละ 95 และ 5 จุด | ใช้เมื่อ |
|---|---|---|---|
| Cochran (1977) | z, p, E แล้วปรับแก้สำหรับประชากรจำกัดหากประชากรมีขนาดเล็ก | 278 | ค่าตั้งต้น เป็นสูตรในหน้านี้ และเป็นสูตรที่แนวทางอื่นพัฒนามา |
| Krejcie และ Morgan (1970) | ไม่ต้องระบุอะไร คุณอ่านคำตอบจากตารางที่ตีพิมพ์ตามขนาดประชากร | 278 | คุณต้องการตารางที่อ้างอิงได้แทนการคำนวณ ตารางนี้คือ Cochran ที่ตั้งค่าตายตัว |
| Yamane (1967) มักเรียกว่า Slovin | เพียง N และค่าความคลาดเคลื่อน | 286 | เฉพาะเมื่อไม่ทราบ p จริง ๆ และคุณยอมรับระดับความเชื่อมั่นร้อยละ 95 ที่ฝังอยู่ในสูตร ดูข้อควรระวังด้านล่าง |
| การวิเคราะห์อำนาจการทดสอบ | ขนาดอิทธิพล อำนาจการทดสอบ ค่า alpha และสถิติทดสอบที่คุณจะใช้ | ขึ้นกับขนาดอิทธิพลทั้งหมด | คุณกำลังทดสอบสมมติฐาน ไม่ใช่ประมาณค่าร้อยละ ให้ใช้ G*Power หรือ OpenEpi ไม่ใช่หน้านี้ |
Cochran และเหตุผลที่สูตรอื่นทั้งหมดเป็นทางลัดของสูตรนี้
สูตรของ Cochran คือสูตรที่อยู่ด้านบนของหน้านี้: n0 = z ยกกำลังสอง คูณ p คูณ (1 ลบ p) หารด้วย E ยกกำลังสอง ตามด้วยการปรับแก้สำหรับประชากรจำกัดเมื่อประชากรมีขนาดเล็ก แนวทางอื่นที่มีชื่อเรียกกำหนดค่าที่ป้อนบางค่าไว้ตายตัวเพื่อให้คำนวณสั้นลง เมื่อรู้เช่นนี้ กลุ่มสูตรนี้จะไม่ดูเหมือนกฎสี่ข้อที่แข่งกัน แต่ดูเหมือนกฎข้อเดียวที่มีค่าตั้งต้นสามชุด
Yamane และ Slovin: ใช้โดยรู้เท่าทัน
สูตร n = N / (1 + N x e^2) ปรากฏในวิทยานิพนธ์นับพันเล่ม มักให้เครดิตแก่ Slovin สูตรนี้คำนวณเร็ว: สำหรับ N = 1,000 และ e = 0.05 จะได้ 286
มีสามเรื่องที่ควรรู้ก่อนอ้างสูตรนี้
- สูตรนี้คือ Cochran ที่ล็อกค่าตั้งไว้ตายตัว เมื่อย้อนกลับไป สูตรนี้คือสูตรสัดส่วนที่กำหนด p ไว้ที่ 0.5 ความเชื่อมั่นไว้ที่ร้อยละ 95 และปัด z จาก 1.96 เป็น 2 ตอบคำถามที่ระดับความเชื่อมั่นอื่นไม่ได้ และไม่มีค่าที่ป้อนสำหรับความแปรปรวนของประชากรเลย ประชากรสองกลุ่มที่มีขนาดเท่ากันแต่การกระจายต่างกันมากจะได้คำตอบเดียวกัน ซึ่งไม่น่าจะถูกต้อง
- การปัดเศษนั้นคือเหตุผลที่ตัวเลขของสูตรนี้สูงกว่า เมื่อ z = 2 เพดานของสูตรสำหรับประชากรไม่จำกัดคือ 1 หารด้วย e ยกกำลังสองพอดี ซึ่งเท่ากับ 400 เพดานของ Cochran คือ 384.16 เพราะ 1.96 ยกกำลังสองเท่ากับ 3.8416 ไม่ใช่ 4 ตัวเลขของ Yamane ทุกตัวในตารางด้านบนจึงสูงกว่าตัวเลขของ Cochran อยู่ไม่กี่เปอร์เซ็นต์ด้วยเหตุผลนี้ หากคุณเคยสงสัยว่าทำไมตำราสองเล่มให้ขนาดกลุ่มตัวอย่างต่างกันสำหรับการศึกษาเดียวกัน นั่นมักเป็นคำตอบ
- การให้เครดิตไม่มีหลักฐานรองรับ วารสารสถิติฉบับหนึ่งสืบประวัติของสูตรนี้และสรุปว่าหาตัวบุคคลชื่อ Slovin เบื้องหลังสูตรไม่พบ และแหล่งที่เก่าที่สุดที่สืบได้คือตำราของ Taro Yamane ปี 1967 Wolfram MathWorld อธิบายว่าเป็นสูตรเฉพาะกิจที่ขาดความเข้มงวดทางคณิตศาสตร์ หากภาควิชาของคุณคาดหวังให้ใช้ ก็ใช้ได้ และให้อ้าง Yamane แทน Slovin หากคุณมีทางเลือก ให้ใช้ Cochran เพราะตอบคำถามได้ว่าร้อยละ 95 มาจากไหน
กฎจำง่าย พร้อมการให้ระดับอย่างตรงไปตรงมา
กฎเหล่านี้แพร่หลายมาก บางข้อมีประโยชน์ บางข้อเป็นแค่ความเชื่อที่เล่าต่อกันมา และควรรู้ว่าข้อไหนเป็นแบบไหน
- อย่างน้อย 30 รายต่อกลุ่ม สมเหตุสมผลในฐานะขั้นต่ำสำหรับการเปรียบเทียบกลุ่ม ไม่ใช่เป้าหมาย มาจากจุดที่การแจกแจงของตัวอย่างเริ่มมีพฤติกรรมตามคาด ไม่ใช่จากข้อกำหนดด้านความแม่นยำใด ๆ
- สิบรายต่อตัวแปรในการถดถอย หลักปฏิบัติที่ใช้กันแพร่หลายและถูกวิจารณ์แพร่หลาย ให้ระบุว่าเป็นหลักปฏิบัติ ไม่ใช่กฎ
- ร้อยละสิบของประชากร ข้อนี้ผิดเลย และตารางด้านบนแสดงเหตุผล ร้อยละสิบของ 100,000 คือการตอบกลับ 10,000 รายการ ขณะที่ 383 รายการให้ความแม่นยำเท่ากัน
- 385 เสมอ ถูกต้องเฉพาะประชากรขนาดใหญ่ที่ร้อยละ 95 และ 5 จุด ให้อ้างพร้อมเงื่อนไขเหล่านั้น มิฉะนั้นจะไม่มีความหมาย
- n ขนาดเล็กสำหรับการศึกษาด้านการใช้งานและผลิตภัณฑ์ Nielsen Norman Group เผยแพร่แนวทางที่ตรงไปตรงมาสำหรับเรื่องนี้: ผู้เข้าร่วม 40 คนให้การวัดแบบใช่หรือไม่ได้ที่บวกลบ 15 จุด ที่ระดับความเชื่อมั่นร้อยละ 95 และ 47 คนให้ค่าเฉลี่ยที่ความแม่นยำเท่ากัน ตัวเลขเหล่านี้เล็กเพราะความแม่นยำที่อ้างนั้นหลวม บอกความแม่นยำออกมาตรง ๆ แล้วกลุ่มตัวอย่างขนาดเล็กก็ไม่ใช่เรื่องน่าอาย
หากการศึกษาของคุณเปรียบเทียบกลุ่ม แทนการประมาณค่าร้อยละค่าเดียว ขนาดกลุ่มตัวอย่างจะกลายเป็นเรื่องอำนาจการทดสอบ และเครื่องคำนวณนี้ไม่ใช่เครื่องมือที่เหมาะสม คุณต้องมีขนาดอิทธิพลที่อธิบายได้ พร้อมค่า alpha และอำนาจการทดสอบ G*Power และ OpenEpi คือเครื่องมือฟรีที่อาจารย์ที่ปรึกษาส่วนใหญ่คาดหวัง และทั้งคู่ใช้ได้ฟรี การบอกว่าเครื่องมือหยุดที่ตรงไหนมีประโยชน์กว่าการทำเป็นว่าทำได้ทุกอย่าง
งานเชิงคุณภาพกำหนดขนาดต่างออกไป
การสัมภาษณ์และการสนทนากลุ่มไม่ได้กำหนดขนาดด้วยค่าความคลาดเคลื่อน เพราะไม่ได้ประมาณค่าร้อยละของประชากร เหตุผลที่ใช้กันทั่วไปคือความอิ่มตัว: คุณทำต่อไปจนผู้เข้าร่วมรายใหม่ไม่ให้ประเด็นใหม่ แล้วรายงานว่าเกิดขึ้นที่จุดใดและคุณตัดสินอย่างไร การนำการศึกษาเชิงคุณภาพมาคำนวณด้วยเครื่องคำนวณนี้จะได้ตัวเลขที่ดูแม่นยำแต่ไม่มีความหมาย
หากต้องการผลลัพธ์แยกตามกลุ่มย่อย ให้กำหนดขนาดสำหรับกลุ่มย่อย
แบบสำรวจส่วนใหญ่ถูกขอให้รายงานแยกตามภูมิภาค บทบาท อายุงาน หรือสายผลิตภัณฑ์ นี่คือจุดที่แผนกลุ่มตัวอย่างพังอย่างเงียบ ๆ และกฎนั้นสั้นมาก
ค่าความคลาดเคลื่อนใช้กับกลุ่มใดได้ก็ต่อเมื่อกลุ่มนั้นมีการตอบกลับที่สมบูรณ์มากพอ หากคุณต้องการบวกลบ 5 จุดสำหรับแต่ละภูมิภาคทั้งหก คุณต้องมีการตอบกลับที่สมบูรณ์ราว 385 รายการในแต่ละภูมิภาค ไม่ใช่ 385 รายการรวมกัน นั่นคือแบบสำรวจที่ใหญ่กว่าที่คุณคิดว่ากำลังวางแผนถึงหกเท่า
ทางออกที่ตรงไปตรงมาสองทาง:
- สุ่มกลุ่มเล็กเกินสัดส่วน จงใจเชิญกลุ่มที่เล็กกว่าในสัดส่วนที่สูงขึ้น เพื่อให้แต่ละกลุ่มถึงเป้าหมายของตนเอง แล้วถ่วงน้ำหนักผลลัพธ์กลับในภายหลัง
- ยอมรับช่วงที่กว้างขึ้นสำหรับผลแยกกลุ่ม เก็บตัวเลขรวมที่แข็งแรงไว้หนึ่งตัว และเผยแพร่ผลแต่ละกลุ่มย่อยพร้อมค่าความคลาดเคลื่อนของกลุ่มนั้นซึ่งกว้างกว่ากำกับไว้ข้าง ๆ นี่มักเป็นคำตอบที่ถูกต้อง
เครื่องคำนวณมีช่องสำหรับเรื่องนี้ ตั้งค่ากลุ่มย่อยที่ต้องรายงานแยกเป็นจำนวนกลุ่มที่คุณต้องรายงานผล แล้วเครื่องคำนวณจะกำหนดขนาดแต่ละกลุ่มอย่างเหมาะสมและรวมยอดให้
กำหนดขอบเขตก่อนลงภาคสนาม ระบุกลุ่มที่คุณต้องรายงาน ไม่ใช่กลุ่มที่อยากได้ ประมาณจำนวนการตอบกลับที่สมบูรณ์ที่แต่ละกลุ่มให้ได้จริง โดยใช้คำถามด้านประชากรศาสตร์ระบุกลุ่มเหล่านั้น หากกลุ่มใดให้การตอบกลับได้เพียง 80 รายการ อย่าสัญญาบวกลบ 5 จุดสำหรับกลุ่มนั้น ที่ 80 รายการ ช่วงจะเป็นบวกลบ 11 จุด
AAPOR ใช้ตัวอย่างการคำนวณที่ควรจำไว้ แบบสำรวจผู้ใหญ่ 1,000 คนมีค่าความคลาดเคลื่อนรวมราวบวกลบ 3 จุด หาก 200 คนในจำนวนนั้นคือกลุ่มย่อยที่คุณต้องการพูดถึงจริง ๆ ค่าความคลาดเคลื่อนของกลุ่มย่อยนั้นคือบวกลบ 6.9 จุด มากกว่าสองเท่า ตัวเลขหลักบนหน้าแรกของรายงานไม่ใช่ตัวเลขที่ใช้กับแผนภูมิในหน้าเก้า
แนวทางที่ตีพิมพ์เรื่องขนาดเซลล์ขั้นต่ำเก่ากว่าและหลวมกว่าสูตร และควรถือเป็นขั้นต่ำมากกว่าเป้าหมาย: ราว 100 รายการสำหรับกลุ่มย่อยที่คุณจะรายงานอย่างจริงจัง และ 20 ถึง 50 รายการสำหรับกลุ่มย่อยรองที่คุณจะกล่าวถึงผ่าน ๆ
จุดที่การวางแผนขนาดกลุ่มตัวอย่างผิดพลาด
ขนาดกลุ่มตัวอย่างจัดการความคลาดเคลื่อนจากการสุ่มตัวอย่าง ซึ่งเป็นความแปรปรวนแบบสุ่มจากการไม่ได้ถามทุกคน แบบสำรวจจริงยังมีความคลาดเคลื่อนอย่างเป็นระบบ ซึ่งไม่มีขนาดกลุ่มตัวอย่างใดแก้ได้ และกลุ่มตัวอย่างขนาดใหญ่อาจปกปิดไว้
การถือว่ากลุ่มตัวอย่างแบบบังเอิญเป็นกลุ่มตัวอย่างแบบอาศัยความน่าจะเป็น
ทุกสูตรในที่นี้สันนิษฐานว่าทุกคนมีโอกาสถูกเลือกที่ทราบค่าและไม่เป็นศูนย์ และการตอบไม่ได้ผูกแน่นกับสิ่งที่คุณวัด ลิงก์เปิดบนโซเชียลมีเดียไม่เป็นไปตามเงื่อนไขทั้งสองข้อ คุณยังคำนวณค่าความคลาดเคลื่อนจากการตอบกลับได้ และมันจะดูน่าอุ่นใจ แต่จะไม่ได้มีความหมายอย่างที่บอก ระบุให้ชัดว่าคุณสุ่มกลุ่มตัวอย่างแบบใดมาจริง
การมองว่า n ที่ใหญ่ขึ้นคือการวัดที่ดีขึ้น
กลุ่มตัวอย่างขนาดใหญ่ทำให้การวัดที่คลาดเคลื่อนกลายเป็นความคลาดเคลื่อนที่แม่นยำ หากคำถามกำกวม ถามสองเรื่องในข้อเดียว หรือชี้นำ การตอบกลับที่มากขึ้นก็กอบกู้ไม่ได้ อัตราการข้ามคำถามที่สูงและคำตอบที่ไม่สอดคล้องกันเป็นสัญญาณให้แก้เครื่องมือก่อน การเขียนคำถามที่ไม่ดีใหม่เพียงข้อเดียวมักได้ผลมากกว่าการเพิ่มกลุ่มตัวอย่างสามเท่า
การเลือกความแม่นยำโดยไม่มีการตัดสินใจรองรับ
ความแม่นยำจะมีคำตอบที่ถูกต้องก็ต่อเมื่อคุณรู้ว่าจะใช้ไปเพื่ออะไร ขนาดกลุ่มตัวอย่างอธิบายได้ง่ายเมื่อคุณเติมประโยคนี้ได้: เราต้องแยกผลที่ต่างกัน X จุดออกจากกันได้ และอธิบายไม่ได้เลยเมื่อเหตุผลเดียวคือตัวเลขที่ใหญ่กว่ารู้สึกปลอดภัยกว่า เชื่อมโยงกลับไปที่การออกแบบการวิจัยของคุณ และสิ่งที่คุณจะทำกับผลลัพธ์
ตัวเลขในหน้านี้ และคุณภาพของตัวเลข
ตัวเลขทุกตัวที่อ้างไว้ข้างต้น เป็นการคำนวณที่คุณทำซ้ำได้ในเครื่องคำนวณ หรือเป็นการอ้างอิงที่คุณตรวจสอบได้ ระดับ A หมายถึงทำซ้ำแล้วหรือคำนวณได้โดยตรง B หมายถึงการศึกษาที่แข็งแรงหนึ่งเรื่อง C หมายถึงพูดกันซ้ำอย่างแพร่หลายแต่ยังเป็นที่ถกเถียง
| ข้อกล่าวอ้าง | ตัวเลข | ระดับหลักฐาน | แหล่งที่มา |
|---|---|---|---|
| ที่ระดับความเชื่อมั่นร้อยละ 95 โดยไม่มีค่าประมาณล่วงหน้า ประชากรขนาดใหญ่ต้องการการตอบกลับที่สมบูรณ์ 385 รายการสำหรับบวกลบ 5 จุด | 385 | A | คำนวณโดยตรงจากสูตรสัดส่วนมาตรฐาน NIST section 3.3.3; Israel (1992) |
| สูตรในหน้านี้ให้ผลตรงกับตารางขนาดกลุ่มตัวอย่างที่ Krejcie และ Morgan ตีพิมพ์ โดยต่างกันไม่เกินหนึ่งรายการในทุกขนาดประชากรทั้ง 21 ค่าที่เราตรวจ | 21 จาก 21 ต่างกันไม่เกิน 1 | A | การตรวจสอบของเราเองเทียบกับ Krejcie และ Morgan (1970) ระบุวิธีไว้ใต้ตาราง |
| อัตราการตอบกลับเป็นตัวทำนายอคติจากการไม่ตอบกลับที่อ่อน การวิเคราะห์อภิมานของการศึกษาด้านอคติโดยเฉพาะ 59 เรื่องพบความสัมพันธ์ระหว่างสองสิ่งนี้เพียงเล็กน้อย | 59 การศึกษา | A | Groves และ Peytcheva (2008), Public Opinion Quarterly |
| Pew ทำแบบสอบถามเดียวกันที่อัตราการตอบกลับร้อยละ 9 และร้อยละ 22 จากคำถามร่วม 40 ข้อ 28 ข้อได้ผลต่างกันไม่เกิน 2 จุด | 28 จาก 40 ต่างกันไม่เกิน 2 จุด | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| แต่ในแบบสำรวจความพึงพอใจ ความสัมพันธ์นี้มีอยู่จริงและมีขนาดใหญ่ จากแบบสำรวจของโรงพยาบาล 717 ชุด คะแนนความพึงพอใจเฉลี่ยมีสหสัมพันธ์กับอัตราการตอบกลับที่ r = 0.61 | r = 0.61 | B | Perneger, Peytremann-Bridevaux และ Combescure (2020), BMC Health Services Research |
| อัตราการตอบกลับแบบสำรวจพนักงานแปรตามขนาดองค์กรแทบสมบูรณ์ ในปี 2024 แบบสำรวจพนักงานรัฐบาลกลางสหรัฐฯ ได้ร้อยละ 71 จากหน่วยงานที่มีพนักงานไม่ถึง 1,000 คน และร้อยละ 37 จากหน่วยงานที่มีพนักงานมากกว่า 75,000 คน | ร้อยละ 71 เทียบกับ 37 | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report เชิญพนักงานกว่า 1.6 ล้านคน |
| อัตราการตอบกลับเฉลี่ยจากแบบสำรวจออนไลน์ที่ตีพิมพ์ 1,071 ชุดคือร้อยละ 44.1 ไม่มีอัตราปกติเพียงค่าเดียว | ร้อยละ 44.1 | A | การวิเคราะห์อภิมานของ Wu, Zhao และ Fils-Aime (2022), Computers in Human Behavior Reports |
| แบบสำรวจทางเว็บได้การตอบกลับต่ำกว่าช่องทางอื่นราว 12 จุดเปอร์เซ็นต์ จากการเปรียบเทียบเชิงทดลอง 114 ครั้ง | ต่ำกว่า 12 จุด | A | การวิเคราะห์อภิมานของ Daikeler, Bosnjak และ Lozar Manfreda (2020), JSSAM |
| การลดค่าความคลาดเคลื่อนลงครึ่งหนึ่งทำให้กลุ่มตัวอย่างที่ต้องการเพิ่มขึ้นราวสี่เท่า เพราะ n แปรผันตาม 1 หารด้วย E ยกกำลังสอง การเพิ่มกลุ่มตัวอย่างเป็นสองเท่าจาก 1,000 เป็น 2,000 ได้ความแม่นยำเพิ่มราวหนึ่งจุด | ราว 4 เท่า | A | คุณสมบัติทางพีชคณิตของสูตร AAPOR ระบุกรณี 1,000 เป็น 2,000 ไว้อย่างชัดเจน |
| การสมมติ p = 0.5 แทน p = 0.9 ที่ทราบอยู่แล้ว ทำให้กลุ่มตัวอย่างที่คุณถูกบอกให้เก็บเพิ่มขึ้นเกือบสามเท่า จาก 139 เป็น 385 | 139 เทียบกับ 385 | A | คำนวณโดยตรง ทำซ้ำได้ในเครื่องคำนวณโดยเปลี่ยนผลที่คาดไว้ |
| เทมเพลตแบบสำรวจทั้ง 87 ชุดที่เผยแพร่บนเว็บไซต์นี้มีคำถามไม่เกิน 14 ข้อ และ 86 ชุดจาก 87 ชุดมีไม่เกิน 10 ข้อ คำถาม 785 ข้อจาก 799 ข้อได้รับการยืนยันบนหน้าที่เผยแพร่ | 87 เทมเพลต คำถาม 799 ข้อ | A | การนับคลังเทมเพลตที่เผยแพร่อยู่ของเราเอง เมื่อวันที่ 21 สิงหาคม 2026 ตรวจย้อนกับหน้าที่เผยแพร่ทั้ง 87 หน้า วิธีการ การตรวจด้วยตา และอัตราการยืนยันระบุไว้พร้อมตาราง |
| ไม่มีบุคคลชื่อ Slovin ที่สืบย้อนได้อยู่เบื้องหลังสูตรที่ใช้ชื่อนี้ แหล่งที่เก่าที่สุดที่สืบได้คือ Yamane (1967) | ไม่มีผู้เขียนที่สืบย้อนได้ | B | Tejada และ Punzalan (2012), The Philippine Statistician; Wolfram MathWorld เรียกสูตรนี้ว่าสูตรเฉพาะกิจ |
“คุณต้องการการตอบกลับ 385 รายการเสมอ” ใช้ได้เฉพาะที่ระดับความเชื่อมั่นร้อยละ 95 บวกลบ 5 จุด p = 0.5 และประชากรขนาดใหญ่ หากอ้างโดยไม่มีเงื่อนไข จะผิดสำหรับประชากรขนาดเล็กทุกกลุ่ม
“สำรวจร้อยละ 10 ของประชากร” ไม่มีพื้นฐานทางสถิติ ทำให้สุ่มประชากรขนาดใหญ่มากเกินไปอย่างมาก และสุ่มประชากรขนาดเล็กน้อยเกินไป
“อัตราการตอบกลับต่ำกว่าร้อยละ 50 หรือ 60 ทำให้แบบสำรวจใช้ไม่ได้” ไม่มีเกณฑ์ใดทำเช่นนั้น ขั้นร้อยละ 50, 60 และ 70 เป็นกฎจำง่ายจากตำราที่ไม่มีที่มาเชิงประจักษ์ และการวิเคราะห์อภิมานของ Groves และ Peytcheva ก็ขัดแย้งกับกฎนี้ อัตราการตอบกลับกำหนดขอบเขตของอคติในกรณีเลวร้ายที่สุด แต่ไม่ได้วัดอคติที่เกิดขึ้นจริง
“อัตราการตอบกลับแบบสำรวจโดยเฉลี่ยคือร้อยละ X” ตัวเลขที่ตรวจสอบแล้วจากช่วงไม่กี่ปีเดียวกันอยู่ระหว่างร้อยละ 6 ถึงร้อยละ 71 ขึ้นอยู่กับว่าสำรวจใครทั้งหมด ค่าเฉลี่ยค่าเดียวใด ๆ ล้วนซ่อนข้อนี้ไว้ ให้อ้างแถวที่ตรงกับสถานการณ์ของคุณจากตารางด้านบนแทน
การนำเสนอสูตรของ Slovin ราวกับเป็นการพิสูจน์ สูตรนี้คือสูตรของ Cochran ที่ฝังระดับความเชื่อมั่นร้อยละ 95 และ p = 0.5 ไว้ และปัด z เป็น 2 และการให้เครดิตแก่ Slovin ไม่มีแหล่งที่มาที่สืบย้อนได้
เทมเพลตคำอธิบายเหตุผล
ข้อโต้แย้งเรื่องขนาดกลุ่มตัวอย่างส่วนใหญ่ล้มเหลวเพราะไม่เคยเขียนข้อสมมติไว้ ปุ่มคัดลอกคำอธิบายเหตุผลในเครื่องคำนวณจะเขียนสิ่งนี้ให้พร้อมตัวเลขของคุณ หากคุณต้องการเรียบเรียงเอง นี่คือเก้าสิ่งที่ผู้ทบทวนจะมองหา
- ประชากร (N): นิยามประชากรและระบุจำนวน เช่น ลูกค้าที่ใช้งานอยู่ทั้งหมดในช่วง 90 วันที่ผ่านมา N = 48,200
- สิ่งที่คุณวัด: สัดส่วน (ค่าร้อยละ) หรือค่าเฉลี่ย (คะแนนประเมินเฉลี่ย) สูตรในที่นี้กำหนดขนาดสำหรับสัดส่วน ซึ่งครอบคลุมตัวชี้วัดส่วนใหญ่ที่รายงานกัน
- ระดับความเชื่อมั่น: ระดับที่คุณเลือกและเหตุผล ทั้งธรรมเนียมปฏิบัติและระดับความเสี่ยงที่ยอมรับได้เป็นเหตุผลที่ใช้ได้ หากคุณระบุไว้
- ค่าความคลาดเคลื่อน (E): ความแม่นยำเป้าหมายโดยรวม และแยกสำหรับกลุ่มย่อยใด ๆ ที่คุณสัญญาว่าจะรายงาน
- สัดส่วนที่สมมติ (p): ค่าที่ใช้และแหล่งที่มา ระบุตรง ๆ หากใช้ 0.5 เพราะไม่มีค่าที่ดีกว่า
- การปรับแก้สำหรับประชากรจำกัด: คุณใช้หรือไม่ และอะไรเป็นเหตุ เช่น n0 เกินร้อยละ 10 ของ N
- เป้าหมายการตอบกลับที่สมบูรณ์ (n): จำนวนการตอบกลับที่สมบูรณ์ที่ต้องการขั้นสุดท้าย หลังการปรับทุกอย่าง
- อัตราการตอบกลับที่คาดไว้: อัตราที่สมมติ ข้อมูลในอดีตที่เป็นที่มา และจำนวนคำเชิญที่ได้
- วิธีที่คุณจะเลือกคน: แบบง่าย แบบแบ่งชั้นภูมิ สำมะโน หรือแบบบังเอิญ รวมถึงการสุ่มเกินสัดส่วนสำหรับกลุ่มสำคัญ ระบุชื่ออย่างตรงไปตรงมา
เมื่อแบบสำรวจเริ่มเก็บข้อมูลแล้ว ให้ติดตามการตอบกลับที่สมบูรณ์แยกตามกลุ่ม ไม่ใช่ยอดรวม ตัวเลขรวมที่ดูดีอาจซ่อนกลุ่มที่จะไม่มีวันถึงเป้าหมาย และนั่นคือปัญหาที่คุณยังแก้ได้ในสัปดาห์แรก แต่แก้ไม่ได้ในสัปดาห์ที่สี่ เมื่อรายงาน ให้จับคู่ค่าร้อยละทุกค่ากับค่าความคลาดเคลื่อน และอ่านวิธีวิเคราะห์ข้อมูลแบบสำรวจก่อนถือว่าการเปลี่ยนแปลงสองจุดเป็นเรื่องจริง
แผ่นงานวางแผนขนาดกลุ่มตัวอย่าง
หนึ่งหน้าที่คุณพิมพ์ เติมด้วยมือ และแนบกับเอกสารสรุปโครงการได้ เติมคอลัมน์กลางก่อนเริ่มเก็บข้อมูลภาคสนาม ไม่ใช่หลังจากนั้น ไม่มีข้อมูลใดถูกส่งออกไป และไม่ต้องมีบัญชี
| การตัดสินใจ | ค่าของคุณ | คำแนะนำ |
|---|---|---|
| ประชากร (N) | ใครบ้าง และจำนวนเท่าใด เขียนนิยาม ไม่ใช่แค่ตัวเลข | |
| สิ่งที่คุณวัด | ค่าร้อยละหรือค่าเฉลี่ย หน้านี้กำหนดขนาดสำหรับค่าร้อยละ | |
| ระดับความเชื่อมั่น | ร้อยละ 95 เว้นแต่มีเหตุผล เขียนเหตุผลไว้ | |
| ค่าความคลาดเคลื่อน (E) | ช่องว่างที่คุณต้องแยกแยะให้ได้ หน่วยเป็นจุด | |
| สัดส่วนที่สมมติ (p) | 0.5 หากไม่มีค่าที่ดีกว่า ระบุแหล่งที่มาหากใช้ค่าอื่น | |
| การปรับแก้สำหรับประชากรจำกัด | ใช้หรือไม่ และอะไรเป็นเหตุ | |
| เป้าหมายการตอบกลับที่สมบูรณ์ (n) | ตัวเลขสุดท้ายหลังการปรับทุกอย่าง | |
| กลุ่มย่อยที่รายงานแยก | จำนวนกลุ่ม และการตอบกลับที่สมบูรณ์ที่แต่ละกลุ่มต้องมีเอง | |
| อัตราการตอบกลับที่คาดไว้ | อัตรา และข้อมูลในอดีตที่รองรับ ไม่ใช่ตัวเลขจากอินเทอร์เน็ต | |
| คำเชิญที่ต้องส่ง | การตอบกลับที่สมบูรณ์หารด้วยอัตรา ปัดขึ้น ไม่เกิน N | |
| วิธีเลือกคน | แบบสุ่ม แบบแบ่งชั้นภูมิ สำมะโน หรือแบบบังเอิญ ระบุชื่ออย่างตรงไปตรงมา | |
| จุดตรวจระหว่างเก็บข้อมูลภาคสนาม | วันที่คุณจะตรวจการตอบกลับที่สมบูรณ์แยกตามกลุ่ม ไม่ใช่แค่ยอดรวม |
สูตร: n0 = (z^2 x p x (1 - p)) / E^2 แล้ว n = n0 / (1 + (n0 - 1) / N) แหล่งที่มา: Cochran (1977); NIST/SEMATECH e-Handbook section 3.3.3; Israel (1992) แผ่นงานจาก https://www.supersurvey.com/Sample-Size
คำถามที่พบบ่อย
ขนาดกลุ่มตัวอย่างคืออะไร?
ขนาดกลุ่มตัวอย่างคือจำนวนการตอบกลับที่สมบูรณ์ในแบบสำรวจ เขียนแทนด้วย n ไม่ใช่จำนวนคนที่คุณเชิญ และไม่ใช่ขนาดของประชากรที่คุณอธิบาย เป็นจำนวนที่คุณมีเมื่อจบการเก็บข้อมูลภาคสนาม และเป็นตัวเลขที่ใช้คำนวณค่าความคลาดเคลื่อน: การตอบกลับที่สมบูรณ์ 385 รายการให้ค่าความคลาดเคลื่อนราวบวกลบ 5 จุด ที่ระดับความเชื่อมั่นร้อยละ 95 เมื่อประชากรมีขนาดใหญ่ ขนาดกลุ่มตัวอย่างหมายถึงอะไรอธิบายความต่างระหว่างประชากร คำเชิญ และ n
แบบสำรวจต้องการการตอบกลับกี่รายการ?
สำหรับแบบสำรวจส่วนใหญ่ คำตอบที่ใช้งานได้คือการตอบกลับที่สมบูรณ์ 385 รายการ นี่คือค่าที่สูตรให้ที่ระดับความเชื่อมั่นร้อยละ 95 ค่าความคลาดเคลื่อนบวกลบ 5 จุดเปอร์เซ็นต์ และไม่มีค่าประมาณผลล่วงหน้า หากประชากรของคุณมีขนาดเล็ก คุณต้องการน้อยกว่านั้น: 278 สำหรับรายชื่อ 1,000 คน และ 80 สำหรับรายชื่อ 100 คน ใส่ตัวเลขของคุณเองในเครื่องคำนวณเพื่อดูตัวเลขที่แน่นอนและการคำนวณเบื้องหลัง
ต้องใช้ขนาดกลุ่มตัวอย่างเท่าใดสำหรับระดับความเชื่อมั่นร้อยละ 95 และค่าความคลาดเคลื่อนร้อยละ 5?
การตอบกลับที่สมบูรณ์ 385 รายการ หากประชากรมีขนาดใหญ่และคุณใช้ p = 0.5 การคำนวณคือ n0 = 1.96 ยกกำลังสอง คูณ 0.5 คูณ 0.5 หารด้วย 0.05 ยกกำลังสอง ซึ่งเท่ากับ 0.9604 หารด้วย 0.0025 ได้ 384.16 ปัดขึ้นได้ 385 หากประชากรของคุณมีขนาดเล็ก ให้ใช้การปรับแก้สำหรับประชากรจำกัด แล้วตัวเลขจะลดลง
ค่าความคลาดเคลื่อนคืออะไร?
ค่าความคลาดเคลื่อนคือช่วงบวกลบรอบผลแบบสำรวจ ที่เกิดจากการสุ่มบางคนแทนการถามทุกคน ผลร้อยละ 62 ที่มีค่าความคลาดเคลื่อน 5 จุด หมายความว่าวิธีนี้จะให้ช่วงที่ครอบคลุมค่าจริงเกือบทุกครั้ง และช่วงนี้โดยเฉพาะอยู่ระหว่างร้อยละ 57 ถึง 67 ค่านี้อธิบายเฉพาะความคลาดเคลื่อนจากการสุ่มตัวอย่าง และไม่ได้บอกอะไรเกี่ยวกับคนที่ไม่เคยตอบ
หาค่าความคลาดเคลื่อนได้อย่างไร?
หารากที่สองของ p คูณ (1 ลบ p) หารด้วย n แล้วคูณด้วยค่า z ของระดับความเชื่อมั่นของคุณ ที่ระดับความเชื่อมั่นร้อยละ 95 การตอบกลับ 385 รายการ และ p = 0.5 จะได้ 1.96 คูณรากที่สองของ 0.25 หารด้วย 385 ซึ่งเท่ากับ 1.96 คูณ 0.025482 ได้ 0.0499 ค่าความคลาดเคลื่อนจึงเป็นบวกลบ 5.0 จุดเปอร์เซ็นต์ เครื่องคำนวณค่าความคลาดเคลื่อนในหน้านี้คำนวณให้และแสดงวิธีทำ
ค่าความคลาดเคลื่อนเพิ่มขึ้นตามขนาดกลุ่มตัวอย่างหรือไม่?
ไม่ ค่าความคลาดเคลื่อนลดลง และลดลงตามรากที่สองของกลุ่มตัวอย่าง การเพิ่มจากการตอบกลับ 100 รายการเป็น 400 รายการทำให้ค่าความคลาดเคลื่อนลดลงครึ่งหนึ่ง การเพิ่มจาก 400 เป็น 1,600 ลดลงครึ่งหนึ่งอีกครั้ง ความสัมพันธ์แบบรากที่สองนี้คือเหตุผลที่ความแม่นยำมีราคาแพง: ความถูกต้องที่เพิ่มขึ้นทีละหนึ่งตำแหน่งทศนิยมต้องใช้การตอบกลับราวสี่เท่า
ค่าความคลาดเคลื่อนเหมือนกับความคลาดเคลื่อนมาตรฐานหรือไม่?
ไม่เหมือน ความคลาดเคลื่อนมาตรฐานคือการกระจายพื้นฐานของค่าประมาณ ค่าความคลาดเคลื่อนคือความคลาดเคลื่อนมาตรฐานคูณด้วยค่า z ของระดับความเชื่อมั่นที่คุณเลือก ที่ระดับความเชื่อมั่นร้อยละ 95 ค่าความคลาดเคลื่อนเท่ากับราว 1.96 เท่าของความคลาดเคลื่อนมาตรฐาน ความคลาดเคลื่อนมาตรฐานเป็นคุณสมบัติของข้อมูล ค่าความคลาดเคลื่อนเป็นทางเลือกในการรายงานที่ซ้อนอยู่บนนั้น
ขนาดกลุ่มตัวอย่างที่ดีสำหรับการวิจัยเชิงปริมาณคือเท่าใด?
ไม่มีตัวเลขที่ดีเพียงค่าเดียว และแหล่งใดที่ให้ตัวเลขโดยไม่ถามว่าคุณวัดอะไร ก็กำลังเดาเอา สำหรับการศึกษาที่รายงานค่าร้อยละจากประชากรต่ำกว่าราว 10,000 คน คำตอบที่อธิบายได้คือค่าที่สูตรให้ ที่ระดับความเชื่อมั่นร้อยละ 95 และค่าความคลาดเคลื่อนที่คุณให้เหตุผลได้ สำหรับรายชื่อ 1,000 คน คือ 278 ตัวเลขที่ทำให้บทระเบียบวิธีวิจัยผ่านไม่ใช่ตัวเลขที่สูง แต่คือตัวเลขที่ระบุไว้ พร้อมระดับความเชื่อมั่น ค่าความคลาดเคลื่อน สัดส่วนที่สมมติ และขนาดประชากรกำกับไว้ข้าง ๆ ดูขนาดกลุ่มตัวอย่างสำหรับการวิจัยเชิงปริมาณ สำหรับสูตรที่มีชื่อเรียกซึ่งอาจารย์ที่ปรึกษาอาจคาดหวัง
อัตราการตอบกลับแบบสำรวจที่ปกติคือเท่าใด?
ไม่มีอัตราปกติเพียงค่าเดียว และหน้าใดที่อ้างตัวเลขเดียวก็กำลังเดาเอา ตัวเลขจริงที่มีแหล่งที่มาจากยุคเดียวกันอยู่ระหว่างร้อยละ 6 (โพลทางโทรศัพท์ของ Pew ในปี 2018) ถึงร้อยละ 71 (หน่วยงานรัฐบาลกลางสหรัฐฯ ขนาดเล็กใน Federal Employee Viewpoint Survey ปี 2024) การวิเคราะห์อภิมานของแบบสำรวจออนไลน์ที่ตีพิมพ์ 1,071 ชุดพบค่าเฉลี่ยร้อยละ 44.1 ขนาดองค์กรมีผลมาก: แบบสำรวจรัฐบาลกลางเดียวกันได้ร้อยละ 71 จากหน่วยงานที่มีพนักงานไม่ถึง 1,000 คน และร้อยละ 37 จากหน่วยงานที่มีพนักงานมากกว่า 75,000 คน ใช้ข้อมูลในอดีตของคุณเองก่อน และดูตารางค่าอ้างอิงสำหรับตัวเลขที่อ้างได้
ขนาดประชากรมีผลต่อขนาดกลุ่มตัวอย่างหรือไม่?
แทบไม่มี จนกระทั่งกลุ่มตัวอย่างกลายเป็นสัดส่วนใหญ่ของประชากร การเปลี่ยนจาก 100,000 คนเป็น 1,000,000 คน ทำให้จำนวนที่ต้องการเปลี่ยนจาก 383 เป็น 385 การเปลี่ยนจาก 1,000 คนเป็น 100 คน ทำให้เปลี่ยนจาก 278 เป็น 80 ขนาดประชากรมีผลที่ปลายด้านเล็ก ซึ่งเป็นจุดที่การปรับแก้สำหรับประชากรจำกัดใช้พอดี
เมื่อใดที่ p = 0.5 เป็นทางเลือกที่ถูกต้อง?
ใช้ p = 0.5 เมื่อใดก็ตามที่คุณไม่มีค่าประมาณล่วงหน้าที่อธิบายได้ ค่า p คูณ (1 ลบ p) สูงสุดที่ 0.5 จึงให้กลุ่มตัวอย่างที่ต้องการใหญ่ที่สุด ทำให้เป็นข้อสมมติที่ปลอดภัย: คุณจะไม่ขาด หากคุณมีการทดลองนำร่อง ค่าอ้างอิง หรือตัวเลขของปีที่แล้ว ให้ใช้ค่านั้น การสมมติ p = 0.9 แทน 0.5 ทำให้กลุ่มตัวอย่างที่ต้องการลดจาก 385 เหลือ 139
หากเชิญคนมากขึ้น จะขจัดอคติจากการไม่ตอบกลับได้หรือไม่?
ไม่ได้ คำเชิญที่มากขึ้นทำให้ได้การตอบกลับที่สมบูรณ์มากขึ้น ซึ่งทำให้ค่าความคลาดเคลื่อนแคบลง แต่อคติเป็นอีกปัญหาหนึ่ง: ขึ้นกับว่าคนที่ตอบต่างจากคนที่ไม่ได้ตอบหรือไม่ การวิเคราะห์อภิมานของการศึกษาด้านอคติจากการไม่ตอบกลับ 59 เรื่องพบความสัมพันธ์เพียงเล็กน้อยระหว่างอัตราการตอบกลับกับอคติที่เกิดขึ้นจริง Pew ทำแบบสอบถามเดียวกันสองครั้ง ที่อัตราการตอบกลับร้อยละ 9 และร้อยละ 22 และคำถามร่วม 28 ข้อจาก 40 ข้อได้ผลต่างกันไม่เกิน 2 จุด ดูอคติในการตอบและอคติจากการไม่ตอบกลับ
หากต้องการผลแยกตามแผนกหรือภูมิภาค จะจัดการขนาดกลุ่มตัวอย่างอย่างไร?
กำหนดขนาดแต่ละกลุ่มย่อยแยกกัน ค่าความคลาดเคลื่อนใช้กับกลุ่มใดได้ก็ต่อเมื่อกลุ่มนั้นมีการตอบกลับที่สมบูรณ์มากพอ หากคุณต้องการบวกลบ 5 จุดสำหรับทุกภูมิภาค ทุกภูมิภาคต้องมีการตอบกลับที่สมบูรณ์ 385 รายการของตนเอง หรือจำนวนที่ปรับแก้สำหรับประชากรจำกัดของตนเอง ใช้คำถามด้านประชากรศาสตร์เพื่อระบุกลุ่ม และวางแผนสุ่มกลุ่มเล็กเกินสัดส่วน
ต้องใช้ขนาดกลุ่มตัวอย่างเท่าใดเพื่อให้ได้ผลที่มีนัยสำคัญทางสถิติ?
คำถามนี้ผสมสองแนวคิดเข้าด้วยกัน สูตรขนาดกลุ่มตัวอย่างกำหนดขนาดของค่าประมาณให้ได้ความแม่นยำที่เลือก การทดสอบนัยสำคัญเปรียบเทียบตัวเลขสองตัวและถามว่าช่องว่างนั้นอาจเกิดจากความบังเอิญหรือไม่ ขนาดที่คุณต้องการขึ้นกับว่าคุณต้องการตรวจจับช่องว่างที่เล็กเพียงใด ไม่ใช่เกณฑ์ตายตัว กำหนดขนาดแบบสำรวจที่นี่ แล้วอ่านนัยสำคัญทางสถิติก่อนทดสอบผลหนึ่งเทียบกับอีกผลหนึ่ง
สูตรเหล่านี้ใช้กับการวิจัยเชิงคุณภาพได้หรือไม่?
ไม่ได้ การสัมภาษณ์ การสนทนากลุ่ม และงานแบบปลายเปิดไม่ได้กำหนดขนาดด้วยค่าความคลาดเคลื่อน เพราะไม่ได้ประมาณค่าร้อยละของประชากร ขนาดกลุ่มตัวอย่างเชิงคุณภาพอ้างเหตุผลจากความอิ่มตัว คือจุดที่ผู้เข้าร่วมรายใหม่ไม่ให้ประเด็นใหม่ และรายงานเป็นการตัดสินที่มีหลักฐาน ไม่ใช่สูตร อย่านำการศึกษาเชิงคุณภาพมาคำนวณด้วยเครื่องคำนวณนี้
เอกสารอ้างอิง
- National Institute of Standards and Technology (NIST). (n.d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, section 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.