
Cỡ mẫu khảo sát là số lượt trả lời hoàn tất được đưa vào phân tích, ký hiệu là n. Nó khác với số lời mời hay số người trong danh sách của bạn. Theo các giả định chọn mẫu của công cụ tính, mẫu lớn hơn sẽ thu hẹp sai số biên; nó không loại bỏ được cách tuyển chọn bị sai lệch hay câu hỏi diễn đạt kém.
Công cụ tính cỡ mẫu
Không có gì bị khóa sau bước đăng ký và không có gì được gửi đi đâu cả. Công cụ tính chạy ngay trong trình duyệt của bạn, mở ra với một đáp án mẫu đã tính sẵn trên màn hình, và in ra công thức cùng các phép tính đã dùng để bạn kiểm tra hoặc tự tính lại bằng tay.
Tôi cần bao nhiêu lượt trả lời?
Đặt sáu giá trị đầu vào. Đáp án, công thức và các phép tính đều cập nhật ngay khi bạn nhập.
Số lượt trả lời hoàn tất bạn cần
370
Sau khi hiệu chỉnh tổng thể hữu hạn.
Số người cần mời
1,234
Với tỷ lệ trả lời 30%.
Tỷ lệ chọn mẫu
3.7%
Tỷ lệ tổng thể mà bạn cần thu được câu trả lời.
Tổng cộng, tính theo từng nhóm con
370
Các phép tính, từng bước một
| Sai số biên | Lượt hoàn tất cần có | Lời mời cần gửi |
|---|
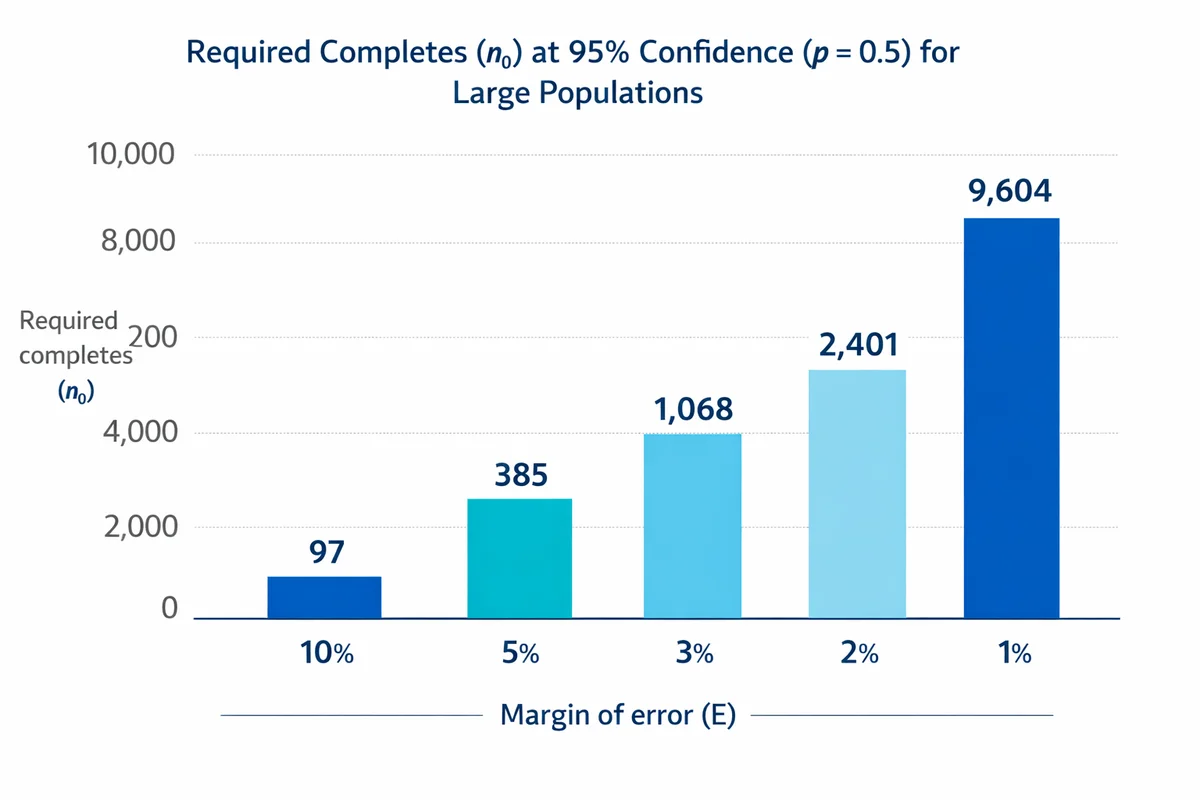
Độ chính xác cao hơn tốn thêm lượt trả lời theo xấp xỉ bình phương mức cải thiện. Giảm sai số biên đi một nửa sẽ nhân cỡ mẫu lên khoảng bốn lần.
Nút sao chép tạo một đoạn mô tả phương pháp ngắn với các con số của bạn, công thức và trích dẫn, sẵn sàng để dán vào bản mô tả dự án hoặc chương phương pháp nghiên cứu.
Trích dẫn công cụ tính này: Hodge, M. (2026). Survey Sample Size Calculator. SuperSurvey. https://www.supersurvey.com/Sample-Size
Kết quả là số lượt trả lời hoàn tất, không phải số lời mời. Đó là số lượng bạn cần có trong tay khi kết thúc giai đoạn thu thập dữ liệu. Số lời mời bằng con số đó chia cho tỷ lệ trả lời bạn dự kiến, và đây là chỗ hầu hết các kế hoạch chọn mẫu bị sai. Khi đã đặt mục tiêu, hãy tạo khảo sát của bạn và khảo sát thí điểm với đúng đối tượng dự định. Dùng đợt khảo sát thí điểm để kiểm tra cách diễn đạt và ước lượng tỷ lệ từ lời mời đến hoàn tất cho chính dự án của bạn.
Cỡ mẫu là gì
Cỡ mẫu là số người hoàn tất khảo sát của bạn. Nó được ký hiệu là n trong mọi công thức trên trang này, là đại lượng duy nhất bạn phải bỏ công thu thập chứ không thể chọn trên giấy, và là con số dùng để tính sai số biên của bạn.
Có ba con số hay bị nhầm với nó, và phân biệt được chúng là phần lớn việc một kế hoạch chọn mẫu phải làm:
- Tổng thể (N): tất cả những người bạn muốn mô tả. Một danh sách khách hàng, tổng số nhân sự, một quốc gia.
- Lời mời: số người bạn liên hệ. Luôn lớn hơn n, vì không phải ai cũng trả lời.
- Cỡ mẫu (n): số lượt trả lời hoàn tất bạn có khi kết thúc thu thập dữ liệu. Đây là con số mà công thức tính ra, và là con số duy nhất trong ba con số làm thay đổi sai số biên của bạn.
Cỡ mẫu mua được độ chính xác, tức là độ rộng của khoảng cộng trừ quanh mỗi kết quả. Nó không mua được độ đúng, tức là liệu những người đã trả lời có giống những người không trả lời hay không. Một mẫu thuận tiện lớn có thể nằm xa sự thật hơn một mẫu ngẫu nhiên nhỏ, và không giá trị n nào sửa được điều đó. Những chỗ việc lập kế hoạch cỡ mẫu bị sai trình bày sự khác biệt này, và cách bạn lấy mẫu mới là yếu tố quyết định.
Câu trả lời ngắn gọn, nếu bạn chỉ cần một con số
Các con số chính
- 385 lượt trả lời hoàn tất là đáp án mặc định. Đó là kết quả công thức trả về ở mức tin cậy 95%, sai số biên cộng trừ 5 điểm phần trăm, và không có ước lượng trước nào về kết quả.
- Tổng thể nhỏ cần ít hơn nhiều. Một danh sách 1.000 người cần 278. Một danh sách 100 người cần 80. Đó là tác dụng của hiệu chỉnh tổng thể hữu hạn.
- Độ chính xác rất tốn kém. Giảm sai số biên đi một nửa sẽ nhân cỡ mẫu lên khoảng bốn lần. Đi từ cộng trừ 5 điểm xuống cộng trừ 1 điểm đưa bạn từ 385 lên 9.604.
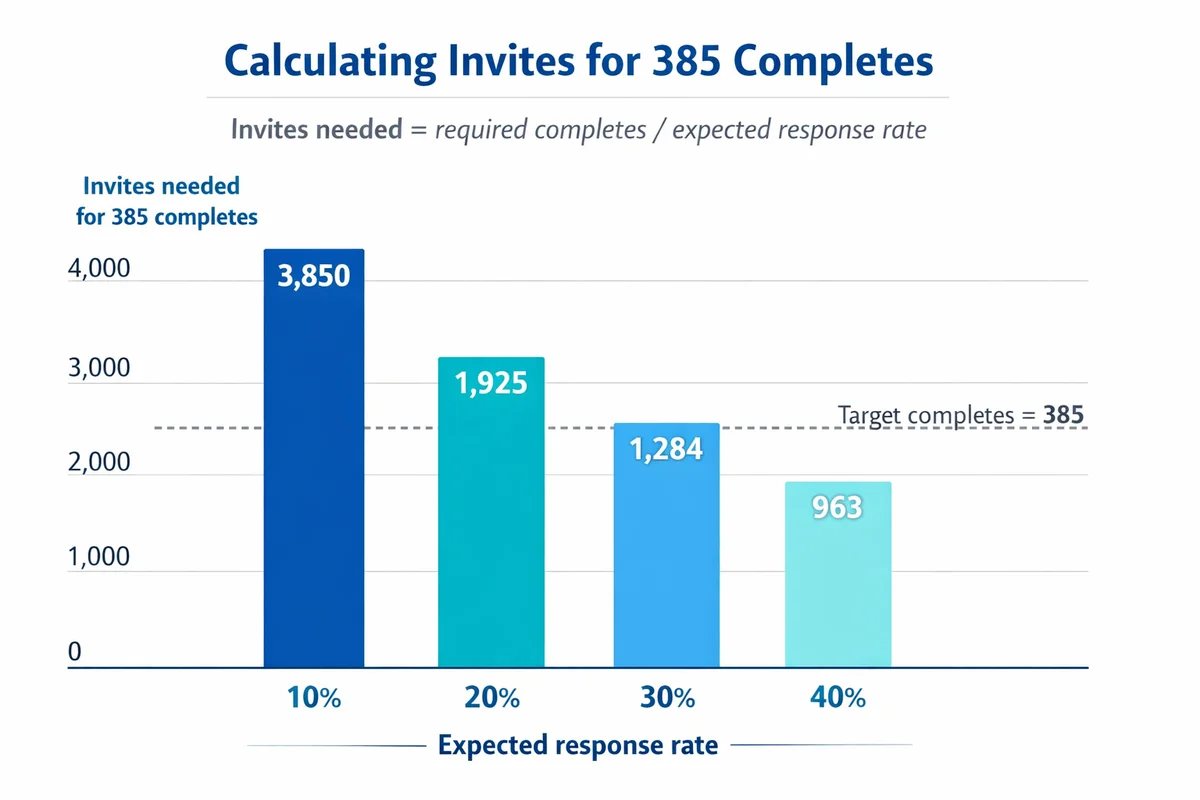
- Công thức đếm lượt hoàn tất, không phải lời mời. Số lời mời cần gửi bằng số lượt hoàn tất chia cho tỷ lệ trả lời dự kiến. Ở mức 30%, 385 lượt hoàn tất nghĩa là phải mời 1.284 người.
- Sai số biên chỉ bao hàm một loại sai số. Nó đo phần nhiễu do chỉ hỏi một số người thay vì tất cả. Nó không nói gì về những người không bao giờ trả lời.
Công thức tính cỡ mẫu, và cách tính bằng tay
Với một khảo sát báo cáo tỷ lệ phần trăm, điểm xuất phát tiêu chuẩn là cỡ mẫu cho một tổng thể đủ lớn để coi như không giới hạn:
n0 = (z^2 x p x (1 - p)) / E^2
Đọc từ trái sang phải:
- n0 là số lượt trả lời hoàn tất cần có, trước khi hiệu chỉnh theo tổng thể.
- z là điểm z cho mức tin cậy của bạn. Dùng 1,96 cho 95%.
- p là tỷ lệ bạn dự kiến đo được, viết dưới dạng số thập phân. Dùng 0,5 nếu bạn không biết.
- E là sai số biên viết dưới dạng số thập phân. Năm điểm phần trăm là 0,05.
Ký hiệu của cỡ mẫu là n. Một số tài liệu viết con số chưa hiệu chỉnh là n0 và con số đã hiệu chỉnh là n, đó cũng là quy ước được dùng ở đây.
| Mức tin cậy | z | Cái giá bạn phải trả |
|---|---|---|
| 80% | 1.282 | 165 lượt hoàn tất với cộng trừ 5 điểm |
| 90% | 1.645 | 271 lượt hoàn tất |
| 95% (tiêu chuẩn) | 1.960 | 385 lượt hoàn tất |
| 99% | 2.576 | 664 lượt hoàn tất |
| 99,9% | 3.291 | 1.084 lượt hoàn tất |
Ví dụ tính toán: từ 385 đến danh sách mời
Tình huống. Bạn muốn biết tỷ lệ khách hàng sẵn sàng giới thiệu bạn. Bạn muốn mức tin cậy 95% và cộng trừ 5 điểm. Bạn không có ước lượng trước nào, nên p = 0,5.
Chọn mức tin cậy và sai số biên
Mức tin cậy 95% cho z = 1,96. Cộng trừ 5 điểm phần trăm là E = 0,05.
Chọn kết quả dự kiến
p = 0,5, vì không có ước lượng trước và 0,5 cho ra cỡ mẫu lớn nhất. Không điều gì bạn biết được sau này có thể khiến mẫu của bạn bị thiếu.
Áp dụng công thức tính cỡ mẫu
n0 = (1.96^2 x 0.5 x 0.5) / 0.05^2
n0 = (3.8416 x 0.25) / 0.0025 = 0.9604 / 0.0025 = 384.16
Làm tròn lên: 385 lượt trả lời hoàn tất. Luôn làm tròn lên. Bạn không thể thu thập một phần lẻ của một bài khảo sát.
Hiệu chỉnh cho tổng thể nhỏ
Nếu số khách hàng đó là một danh sách 1.000 người chứ không phải một thị trường mở, hãy áp dụng hiệu chỉnh: n = 384,16 / (1 + 383,16 / 1.000) = 384,16 / 1,38316 = 277,7, vậy cần 278 lượt hoàn tất. Phép hiệu chỉnh chỉ có tác dụng đáng kể khi mẫu chiếm một phần lớn của tổng thể.
Chuyển lượt hoàn tất thành lời mời
Với tỷ lệ trả lời 30%, số lời mời = 278 / 0,30 = 926,7, vậy hãy mời 927 người. Lượt hoàn tất là thứ công thức tính ra. Lời mời là thứ bạn thực sự gửi đi, và chúng không bao giờ vượt quá tổng thể mà bạn đang lấy mẫu.
Ở mức tin cậy 95% với p = 0,5, cả công thức rút gọn thành 0,9604 chia cho E bình phương. Phép tính tắt đó trả lời hầu hết các câu hỏi về cỡ mẫu chỉ trong một dòng, và đó là lý do con số 385 cứ xuất hiện trong các bảng cỡ mẫu bạn thấy ở nơi khác.
Bảng cỡ mẫu cho các quy mô tổng thể thường gặp
Các con số này được tính bằng công thức ở trên với mức tin cậy 95%, cộng trừ 5 điểm và p = 0,5, rồi hiệu chỉnh theo tổng thể. Hai cột cuối là phần chúng tôi tự đối chiếu với bảng do Krejcie và Morgan công bố năm 1970, bảng được hầu hết các chương phương pháp nghiên cứu trích dẫn.
| Tổng thể (N) | Lượt hoàn tất cần có | Krejcie và Morgan (1970) | Chênh lệch |
|---|---|---|---|
| 10 | 10 | 10 | giống nhau |
| 25 | 24 | không có trong bảng | |
| 50 | 45 | 44 | nhiều hơn 1 |
| 100 | 80 | 80 | giống nhau |
| 200 | 132 | 132 | giống nhau |
| 500 | 218 | 217 | nhiều hơn 1 |
| 1,000 | 278 | 278 | giống nhau |
| 2,000 | 323 | 322 | nhiều hơn 1 |
| 5,000 | 357 | 357 | giống nhau |
| 10,000 | 370 | 370 | giống nhau |
| 50,000 | 382 | 381 | nhiều hơn 1 |
| 100,000 | 383 | 384 | ít hơn 1 |
Cách chúng tôi kiểm tra. Chúng tôi chạy công thức với 21 quy mô tổng thể và so sánh từng kết quả với giá trị Krejcie và Morgan đã công bố. Mười hai giá trị khớp hoàn toàn. Chín giá trị còn lại chênh đúng một lượt trả lời, do chỗ làm tròn của mỗi phương pháp, chứ không phải do bất đồng về phép tính. Nếu người hướng dẫn hỏi vì sao con số của bạn lệch một so với bảng, đó là lý do.
Điều nên biết nếu bạn trích dẫn bảng đó: Krejcie và Morgan không tự xây dựng công thức. Bài báo năm 1970 của họ chỉ khoảng 400 từ cộng một bảng, và tài liệu tham khảo duy nhất ghi nhận công thức thuộc về một bản tin nghiên cứu năm 1960 của National Education Association (Hiệp hội Giáo dục Quốc gia Hoa Kỳ). Lời tóm tắt của chính họ về quy luật này vẫn là cách mô tả trong một câu hay nhất: khi tổng thể tăng lên, cỡ mẫu cần có tăng với tốc độ giảm dần và ổn định ở mức hơn 380 trường hợp một chút.
Chọn từng giá trị đầu vào
Bốn con số quyết định đáp án. Ba trong số đó là quyết định của bạn chứ không phải dữ kiện có sẵn, và mỗi con số đều có cách chọn có thể bảo vệ được.
Mức tin cậy: phương pháp đúng thường xuyên đến đâu
Mức tin cậy mô tả phương pháp, không phải cuộc khảo sát cụ thể này. Ở mức tin cậy 95%, về lâu dài các khoảng được xây dựng theo cách này chứa giá trị thật 95 lần trong 100 lần. Đó không phải là 95% khả năng đáp án cụ thể của bạn là đúng.
Hãy dùng 95% trừ khi bạn có lý do không dùng. Chuyển lên 99% làm cỡ mẫu tăng từ 385 lên 664 cho cùng độ chính xác, tức chi phí tăng 72% để mua được rất ít. Ý tưởng liên quan trong kiểm định giả thuyết là alpha, đó là lý do người ta hay nhầm lẫn hai khái niệm này. Nếu sự phân biệt đó còn mơ hồ, hãy đọc ý nghĩa thống kê và ý nghĩa của giá trị p trước khi chọn một con số.
Sai số biên: biến quyết định
Đây là giá trị cần suy nghĩ kỹ nhất, vì nó là đầu vào duy nhất gắn cỡ mẫu với một quyết định. Hãy chọn nó bằng cách tự hỏi chênh lệch bao nhiêu sẽ làm thay đổi việc bạn làm.
Nếu bạn hành động khác đi khi mức độ hài lòng là 72% thay vì 74%, bạn cần một sai số biên hẹp. Nếu bạn chỉ hành động khi là 72 so với 82, thì cộng trừ 5 điểm là quá đủ. Báo cáo tổng quan thường dùng 5 điểm cho một lần khảo sát nhanh hoặc 3 điểm cho việc theo dõi định kỳ. Dưới 2 điểm, chi phí tăng rất nhanh.
Quy mô tổng thể: hầu như không quan trọng, cho đến khi nó quan trọng
Với tổng thể lớn, cỡ mẫu cần có hầu như không thay đổi. Mười nghìn người cần 370 lượt trả lời. Một trăm nghìn người cần 383. Quy mô tổng thể chỉ có tác dụng khi mẫu của bạn chiếm một phần đáng kể của nó, như trường hợp danh sách nhân viên, danh sách hội viên và các khóa học sinh. Đó là nội dung của phần tiếp theo.
Kết quả dự kiến (p): dùng 0,5 khi bạn không biết
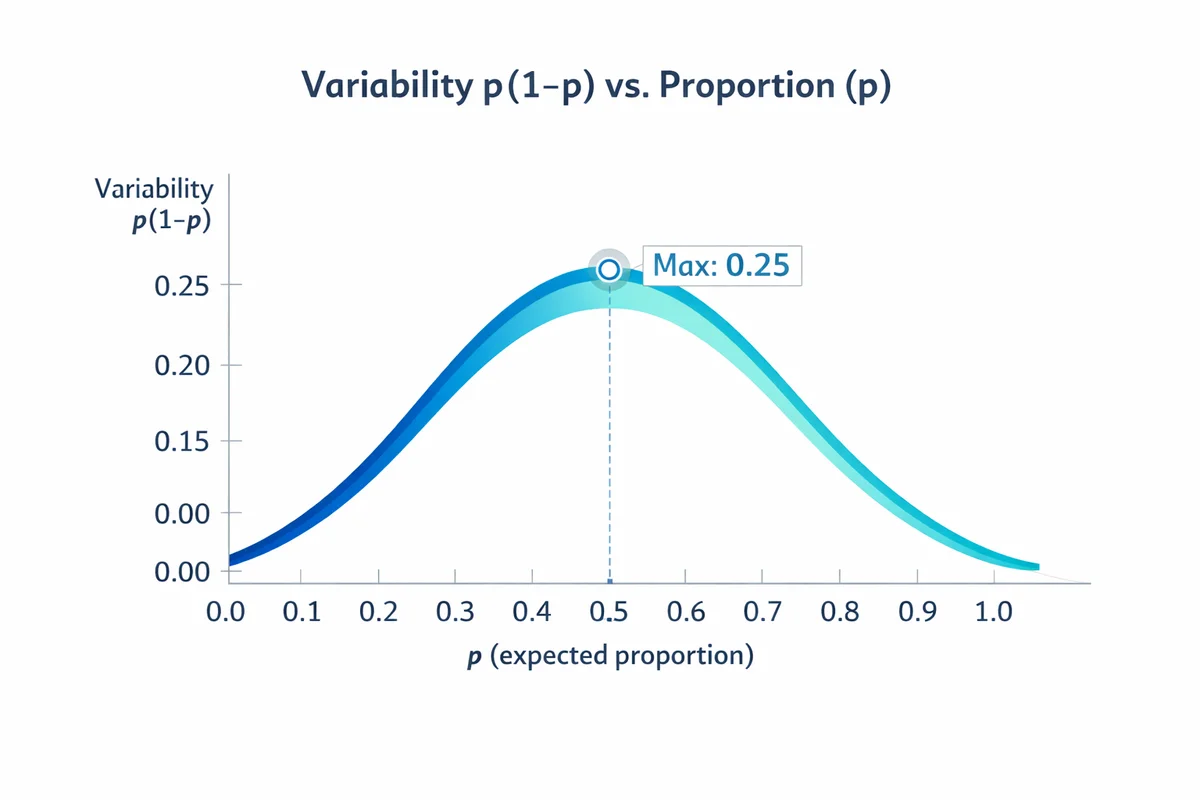
Với câu hỏi về tỷ lệ phần trăm, độ bất định được quyết định bởi p nhân (1 trừ p). Tích này lớn nhất khi p = 0,5, nên 0,5 là lựa chọn thận trọng và cho ra cỡ mẫu lớn nhất. Đó là giá trị mặc định đúng khi bạn không có ước lượng trước nào.
Nếu bạn có ước lượng trước, hãy dùng nó, vì khoản tiết kiệm rất lớn. Ở mức tin cậy 95% và cộng trừ 5 điểm, p = 0,5 đòi hỏi 385 lượt trả lời còn p = 0,9 chỉ cần 139. Các khảo sát trước đây, một đợt khảo sát thí điểm hoặc một chuẩn tham chiếu đã công bố đều là nguồn hợp lý cho ước lượng đó. Câu hỏi gây nhiễu cũng làm tăng độ phân tán, nên cách diễn đạt rõ ràng hơn có thể làm kết quả ổn định mà không cần thêm lượt trả lời nào. Viết câu hỏi khảo sát tốt hơn thường rẻ hơn việc thu thập thêm câu trả lời.
Tổng thể nhỏ: hiệu chỉnh tổng thể hữu hạn
Công thức cơ bản giả định rằng bạn đang lấy mẫu từ một nguồn đủ sâu để việc lấy bớt người ra không thay đổi gì. Khi mẫu của bạn là một phần thực sự của tổng thể, giả định đó khiến bạn phải trả quá nhiều. Hiệu chỉnh tổng thể hữu hạn trả lại cho bạn số lượt trả lời đó.
n = n0 / (1 + ((n0 - 1) / N))
- n là số lượt hoàn tất bạn cần sau khi hiệu chỉnh.
- n0 là con số chưa hiệu chỉnh từ công thức ở trên.
- N là quy mô tổng thể.
Ngưỡng thường dùng là khi n0 lớn hơn khoảng 5% của N. Dưới mức đó phép hiệu chỉnh hầu như không thay đổi gì, nên không đáng để giải thích với ai.
Ví dụ tính toán: khảo sát nhân viên
Tình huống. Bạn có 1.200 nhân viên. Bạn muốn mức tin cậy 95%, cộng trừ 5 điểm, và bạn dùng p = 0,5.
- Chưa hiệu chỉnh, n0 = 384,16.
- Đã hiệu chỉnh: n = 384,16 / (1 + (383,16 / 1.200)) = 384,16 / 1,3193 = 291,2.
- Làm tròn lên: 292 lượt trả lời hoàn tất.
Nếu không hiệu chỉnh, bạn sẽ phải theo đuổi 385 lượt trả lời từ một danh sách 1.200 người, tức 32% tất cả mọi người. Có hiệu chỉnh, 292 lượt mua được cùng độ chính xác. Với danh sách cỡ đó, đó là một tháng nhắc nhở mà bạn không phải làm.
Dưới khoảng 200 người, mẫu sau hiệu chỉnh chiếm một phần lớn đến mức mời tất cả mọi người sẽ đơn giản hơn và dễ bảo vệ hơn. Một cuộc tổng điều tra 150 người hoàn toàn không có sai số chọn mẫu. Khi đó công sức của bạn dồn vào tỷ lệ trả lời và vào việc ai còn thiếu, đúng là chỗ cần đặt công sức.
Sai số biên: cùng một công thức, chạy ngược lại
Sai số biên là khoảng cộng trừ quanh một kết quả khảo sát, sinh ra do bạn chỉ hỏi một số người thay vì tất cả. Nếu 62% trong 385 người trả lời chọn một phương án và sai số biên là 5 điểm, bạn báo cáo 62% và nói rằng khoảng hợp lý chạy từ 57 đến 67%.
Biến đổi công thức tính cỡ mẫu để giải ra E, ta được:
E = z x căn bậc hai của (p x (1 - p) / n)
Với tổng thể hữu hạn, nhân kết quả đó với căn bậc hai của (N - n) chia cho (N - 1). Cả hai phiên bản đều có trong công cụ tính bên dưới, công cụ sẽ tự chuyển đổi khi bạn đánh dấu hoặc bỏ đánh dấu ô tổng thể.
Sai số biên của số lượt trả lời tôi đã có là bao nhiêu?
Cùng một công thức, được biến đổi lại. Nhập số lượt trả lời bạn đã thu thập và đọc lại độ chính xác.
Sai số biên
5.0
Điểm phần trăm, cộng hoặc trừ.
Khoảng của bạn
45,0 đến 55,0
Phần trăm, ở mức tin cậy 95%.
Các phép tính, từng bước một
Sai số biên có tăng theo cỡ mẫu không?
Nó giảm, và giảm theo căn bậc hai của n. Căn bậc hai đó là toàn bộ bài toán kinh tế của khảo sát. Bốn trăm lượt trả lời cho bạn sai số bằng một nửa so với một trăm. Để giảm một nửa lần nữa, bạn cần 1.600. Mỗi chữ số thập phân độ chính xác tiếp theo tốn khoảng gấp bốn lần công thu thập, đó là lý do 385 là điểm dừng phổ biến đến vậy: đó là chỗ chi phí và độ chính xác thôi giằng co.
Bốn thuật ngữ hay bị nhầm lẫn
Sai số chuẩn, sai số biên, mức tin cậy và khoảng tin cậy thường được dùng như thể có thể thay thế cho nhau. Chúng là bốn thứ khác nhau, và sự khác biệt đó quan trọng khi có người chất vấn con số của bạn.
| Thuật ngữ | Nó là gì | Với 385 lượt trả lời và 50% |
|---|---|---|
| Sai số chuẩn | Độ phân tán thô của ước lượng. Căn bậc hai của p nhân (1 trừ p) chia cho n. | 0,0255, tức 2,55 điểm phần trăm |
| Sai số biên | Sai số chuẩn nhân với điểm z ứng với mức tin cậy bạn đã chọn. | Cộng trừ 5,0 điểm ở mức 95% |
| Mức tin cậy | Điểm z bạn đã chọn, biểu thị bằng phần trăm. Một lựa chọn, không phải một phép đo. | 95%, nên z = 1,96 |
| Khoảng tin cậy | Kết quả sau khi áp dụng sai số biên, viết dưới dạng một khoảng. | 45,0% đến 55,0% |
Tóm lại: sai số chuẩn là một tính chất của dữ liệu, mức tin cậy là một lựa chọn bạn đưa ra, sai số biên là tích của hai thứ đó, và khoảng tin cậy là thứ bạn in trong báo cáo.
Những gì sai số biên không bao hàm
Nó chỉ bao hàm sai số chọn mẫu ngẫu nhiên và không gì khác. Nó không tính đến những người đã bỏ qua lời mời, một danh sách thiếu mất một phần tổng thể, hay một câu hỏi mà một nửa số người trả lời hiểu khác với ý bạn. Một khảo sát có thể có sai số biên gọn gàng mà vẫn sai. Xem sai lệch trả lời và sai lệch do không trả lời để biết những sai số mà không cỡ mẫu nào khắc phục được.
Tổ chức nghề nghiệp của ngành nghiên cứu khảo sát nói điều này thẳng thắn hơn hầu hết các nhà cung cấp. AAPOR (Hiệp hội Nghiên cứu Dư luận Hoa Kỳ) khẳng định rằng không tồn tại thứ gọi là sai số biên tổng thể đo lường được cho một cuộc thăm dò, vì khảo sát còn mang những sai số khác hoàn toàn không đo được, từ cách viết câu hỏi đến cách thực hiện phỏng vấn. Thứ bạn có thể tính được là phần do chọn mẫu. Đó là phần mà công cụ tính đưa cho bạn, và cần nói rõ rằng nó chỉ là một phần.
Hai quy tắc sử dụng từ cùng nguồn đó, cả hai đều bị phần lớn các bài viết về khảo sát làm sai:
- Đó là điểm phần trăm, không phải phần trăm. Hãy viết “cộng trừ 3 điểm phần trăm”, không phải “cộng trừ 3 phần trăm”. Hai cách nói mang ý nghĩa khác nhau.
- Nó hoàn toàn không áp dụng cho mẫu tự nguyện tham gia. Sai số biên giả định rằng mỗi người đều có một khả năng được chọn đã biết và khác 0. Một liên kết mở, một nhóm tình nguyện viên hay một bài đăng mạng xã hội không đáp ứng điều đó. Công bố sai số biên bên cạnh kết quả từ một liên kết mở là tuyên bố một độ chính xác mà bạn không hề có.
Chuyển lượt hoàn tất thành lời mời
Công thức cho bạn số lượt trả lời hoàn tất. Quá trình thu thập cho bạn một tỷ lệ trả lời. Khoảng cách giữa hai thứ đó là chỗ các kế hoạch chọn mẫu thường thất bại, và phép tính chỉ có một dòng:
Số lời mời = số lượt hoàn tất cần có / tỷ lệ trả lời dự kiến
Dùng tỷ lệ dưới dạng số thập phân, tức 30% là 0,30, và làm tròn lên. Với 292 lượt hoàn tất ở mức 35%, phép tính là 292 chia 0,35 = 834,3, vậy hãy mời ít nhất 835 người.
| Lượt hoàn tất cần có | Tỷ lệ trả lời dự kiến | Số lời mời |
|---|---|---|
| 385 | 60% | 642 |
| 385 | 30% | 1,284 |
| 385 | 15% | 2,567 |
| 292 | 50% | 584 |
| 292 | 35% | 835 |
| 292 | 20% | 1,460 |
Chọn một tỷ lệ trả lời bạn có thể bảo vệ
Dữ liệu lịch sử của chính bạn tốt hơn mọi chuẩn tham chiếu đã công bố, miễn là cùng đối tượng, cùng kênh và độ dài khảo sát tương tự. Nếu không có căn cứ nào, hãy lên ba kịch bản ở mức 20, 30 và 40% và coi danh sách mời là một đòn bẩy có thể điều chỉnh trong quá trình thu thập. Lời nhắc, thời gian mở dài hơn và danh sách rộng hơn đều là những thứ bạn có thể thay đổi giữa chừng. Mục tiêu lượt hoàn tất thì không.
Hầu hết các bảng chuẩn tham chiếu trên internet chỉ đưa ra một con số trung bình không có nguồn. Không có một con số trung bình duy nhất. Đây là những gì các nguồn gốc thực sự báo cáo, để bạn có thể trích dẫn dòng phù hợp với tình huống của mình thay vì một con số ai đó tự nghĩ ra.
| Bối cảnh | Tỷ lệ trả lời | Quy mô và nguồn |
|---|---|---|
| Cơ quan liên bang Hoa Kỳ dưới 1.000 nhân viên | 71% | Federal Employee Viewpoint Survey năm 2024 (OPM) |
| Cơ quan liên bang Hoa Kỳ có 1.000 đến 9.999 nhân viên | 60% | Cùng khảo sát, cùng năm (OPM) |
| Cơ quan liên bang Hoa Kỳ trên 75.000 nhân viên | 37% | Cùng khảo sát, cùng năm (OPM) |
| Toàn bộ nhân viên liên bang Hoa Kỳ | 41% | Hơn 1,6 triệu người được mời, hơn 674.000 người trả lời, năm 2024 (OPM) |
| Khảo sát trực tuyến đã công bố, mọi loại | Trung bình 44,1% | Phân tích tổng hợp 1.071 tỷ lệ được báo cáo (Wu và cộng sự, 2022) |
| Nghiên cứu về tổ chức đã công bố | 68% năm 2020, tăng từ 48% năm 2005 | 1.014 khảo sát trên 17 tạp chí (Holtom và cộng sự, 2022) |
| Thăm dò qua điện thoại với công chúng | 6% năm 2018, giảm từ 36% năm 1997 | Tỷ lệ do chính Pew Research Center theo dõi (Kennedy và Hartig, 2019) |
| Hình thức web so với mọi hình thức khác | thấp hơn khoảng 12 điểm | Phân tích tổng hợp 114 phép so sánh thực nghiệm (Daikeler và cộng sự, 2020) |
Có hai điều rút ra từ bảng đó. Thứ nhất, quy mô nhóm bạn khảo sát dự báo tỷ lệ trả lời tốt hơn hầu hết mọi thứ khác bạn kiểm soát được. Một công ty 300 người và một cơ quan 300.000 người không chạy cùng một kiểu khảo sát. Thứ hai, nhận định được lặp lại rộng rãi rằng tỷ lệ trả lời đang sụt giảm ở mọi nơi chỉ đúng ở một số nơi. Thăm dò qua điện thoại quả thực đã sụt giảm. Nghiên cứu về tổ chức đã công bố lại đi theo hướng ngược lại, từ 48% lên 68% trong mười lăm năm.
Thêm một phép tính lập kế hoạch đáng học hỏi: hướng dẫn tiêu chuẩn của các chương trình phổ biến kiến thức (extension) của đại học là thêm khoảng 10% vào danh sách mời cho những người bạn đơn giản là không liên lạc được, và khoảng 30% cho những người có thể trả lời nhưng không trả lời.
Kho mẫu của chính chúng tôi nói gì về độ dài
Một tỷ lệ trả lời mượn từ khảo sát của người khác thường khó áp dụng, và độ dài là một trong số ít điều trong danh sách đó mà bạn hoàn toàn kiểm soát được. Đây là một con số chúng tôi tạo ra được còn đối thủ thì không, vì nó đến từ việc đếm kho mẫu đã công bố của chính chúng tôi chứ không phải hỏi những người làm nghề xem họ nghĩ mình làm gì.
Trong đợt rà soát ngày 21 tháng 8 năm 2026 của chúng tôi, cả 87 mẫu khảo sát đều có 14 câu hỏi trở xuống, và 86 mẫu có 10 câu hỏi trở xuống. Tổng cộng chúng có 799 câu hỏi. Trung vị là 9 câu hỏi và có đúng một mẫu vượt quá 10. Các con số này mô tả bản chụp tại thời điểm đó, không phải thư viện hiện tại.
| Số câu hỏi trong mẫu | Số mẫu | Tỷ trọng trong kho mẫu |
|---|---|---|
| 7 câu hỏi | 4 | 5% |
| 8 câu hỏi | 17 | 20% |
| 9 câu hỏi | 29 | 33% |
| 10 câu hỏi | 36 | 41% |
| 14 câu hỏi | 1 | 1% |
Theo định dạng trả lời, 355 trong 799 câu hỏi là thang đánh giá, 281 là danh sách một lựa chọn và 163 yêu cầu người đọc nhập nội dung. Nhóm cuối cùng là nhóm khiến bạn mất lượt hoàn tất, nên chúng tôi đọc thủ công thay vì tin vào trường dữ liệu được lưu. Trong 163 câu đó, 137 là ô nhận xét nhiều dòng. 26 câu còn lại là ô một dòng, và khi đọc chúng chúng tôi thấy 22 câu là trường định danh hoặc phân loại ngắn: tên, địa chỉ email, ngày tháng, phòng ban, chức danh. Chỉ có 4 câu là câu trả lời ngắn có nội dung thực chất. Vì vậy con số trung thực về các câu hỏi thực sự mở là 141, tức khoảng một trong sáu câu hỏi, không phải một trong năm như trường dữ liệu thô đã cho chúng tôi.
Cách chúng tôi đếm và kiểm tra. Chúng tôi phân tích danh sách câu hỏi được lưu của mọi mẫu khảo sát đang hoạt động trên trang này vào ngày 21 tháng 8 năm 2026, giữ lại các mục có nội dung câu hỏi, rồi tải từng trang đã công bố và so sánh hai tập hợp thay vì chỉ tin vào cơ sở dữ liệu của chính mình. Cả 87 trang đều trả về HTTP 200, trong khi một đường dẫn mà chúng tôi biết là đã ngừng hoạt động trả về 410 trong cùng lần chạy, nên phép kiểm tra có khả năng phân biệt chứ không phải lúc nào cũng báo đạt. 785 trong 799 câu hỏi, tức 98%, xuất hiện trên trang đã công bố. Sáu trong số các câu khớp đó chỉ khác cơ sở dữ liệu ở ký tự dấu nháy được dùng, và chúng tôi tính chúng là khớp, điều mà chúng tôi muốn công khai hơn là lặng lẽ làm tròn đi. Tám mươi sáu trong 87 mẫu được xác minh đầy đủ. Mẫu không được xác minh là mẫu dài nhất của chúng tôi, với 14 câu hỏi, và trang đã công bố của nó hiện không hiển thị câu hỏi xem trước nào, nên không thể xác nhận các câu hỏi của nó từ bên ngoài.
Độ dài mẫu không cho bạn biết tỷ lệ trả lời trên số lời mời. Chuẩn tham chiếu về lượt trả lời khảo sát riêng của chúng tôi xem xét hành vi sau khi mọi người tương tác với một khảo sát; nó không đếm tất cả những người được mời. Để lập kế hoạch lời mời, hãy dùng một tỷ lệ có ghi chép từ một dự án tương đương hoặc một đợt khảo sát thí điểm, và giữ mẫu số nhất quán.
Ứng dụng thực tế hẹp nhưng có thật. Nếu bạn mượn một tỷ lệ trả lời để tính số lời mời trong công cụ tính, hãy mượn từ một khảo sát có độ dài tương đương khảo sát bạn sắp gửi, tới một đối tượng tương tự qua một kênh tương tự. Các bảng câu hỏi đã công bố của chính chúng tôi có từ 7 đến 10 câu hỏi, ngắn hơn hầu hết các bản nháp ban đầu.
Gửi thêm lời mời không giúp bạn giảm sai lệch
Tỷ lệ trả lời thấp tạo ra hai vấn đề trông như một. Vấn đề thứ nhất là bạn kết thúc mà chưa đạt mục tiêu, nên sai số biên rộng hơn dự kiến. Vấn đề thứ hai là những người đã trả lời có thể khác những người không trả lời, theo những cách ảnh hưởng đến kết quả của bạn.
Mời thêm người giải quyết được vấn đề thứ nhất. Nó không chắc chắn giải quyết được vấn đề thứ hai. Groves và Peytcheva đã tổng hợp 59 nghiên cứu đo sai lệch do không trả lời thực tế so với giá trị thật đã biết, và chỉ thấy một mối quan hệ nhỏ giữa tỷ lệ trả lời của một khảo sát và mức độ sai lệch của nó. Pew đã trực tiếp kiểm chứng cùng ý tưởng đó: họ chạy một bảng câu hỏi hai lần, một lần với phương pháp tiêu chuẩn đạt tỷ lệ trả lời 9% và một lần với quy trình nỗ lực cao đạt 22%. Trong 40 câu hỏi chung của hai khảo sát, 28 câu cho kết quả chênh nhau trong vòng 2 điểm.
Trường hợp phản bác trung thực. Phát hiện đó không áp dụng chung cho mọi chủ đề, và cần biết nó không đúng ở đâu. Trong khảo sát mức độ hài lòng, mối quan hệ này có thật và lớn. Một nghiên cứu trên 717 khảo sát mức độ hài lòng của bệnh nhân tại 164 bệnh viện Thụy Sĩ cho thấy điểm hài lòng trung bình và tỷ lệ trả lời tương quan ở mức r = 0,61, vì những người rất hài lòng và những người rất bức xúc thì trả lời, còn nhóm ở giữa phân vân thì không. Nếu bạn chạy CSAT hoặc NPS, tỷ lệ trả lời tăng có thể tự nó làm thay đổi điểm của bạn, và tỷ lệ thấp có lẽ đang làm bạn trông đẹp hơn thực tế.
Vậy: hãy theo đuổi tỷ lệ trả lời khi bạn đang đo cảm nhận của mọi người về bạn. Đừng coi nó là giấy chứng nhận giá trị khi bạn đang đo bất cứ điều gì khác.
Cỡ mẫu cho nghiên cứu định lượng: chương phương pháp cần những gì
Không có một cỡ mẫu tốt duy nhất cho nghiên cứu định lượng, và bất kỳ nguồn nào đưa cho bạn một con số mà không hỏi bạn đang đo gì đều chỉ đang đoán. Điều giúp một chương phương pháp được duyệt không phải là một con số lớn. Đó là một con số được nêu rõ, có mức tin cậy, sai số biên, tỷ lệ giả định và tổng thể ghi bên cạnh, kèm tên công thức.
Người hướng dẫn thường mong đợi một trong bốn phương pháp có tên gọi. Chúng phần lớn cho kết quả giống nhau, và bạn nên biết mình đang được yêu cầu dùng phương pháp nào.
| Phương pháp | Phương pháp cần gì từ bạn | Kết quả cho N = 1.000 ở mức 95% và 5 điểm | Dùng khi |
|---|---|---|---|
| Cochran (1977) | z, p, E, rồi hiệu chỉnh tổng thể hữu hạn nếu tổng thể nhỏ | 278 | Mặc định. Đây là công thức trên trang này, và là công thức mà các phương pháp khác được suy ra từ đó. |
| Krejcie và Morgan (1970) | Không cần gì. Bạn tra đáp án từ một bảng đã công bố theo quy mô tổng thể. | 278 | Bạn muốn một bảng có thể trích dẫn thay vì phép tính. Đó là công thức Cochran với các thiết lập cố định. |
| Yamane (1967), thường được gọi là Slovin | Chỉ N và sai số biên | 286 | Chỉ khi p thực sự chưa biết và bạn chấp nhận mức tin cậy 95% được cố định sẵn. Xem lưu ý bên dưới. |
| Phân tích độ mạnh thống kê | Cỡ hiệu ứng, độ mạnh thống kê, alpha và kiểm định bạn sẽ chạy | Hoàn toàn phụ thuộc vào cỡ hiệu ứng | Bạn đang kiểm định một giả thuyết chứ không phải ước lượng một tỷ lệ phần trăm. Hãy dùng G*Power hoặc OpenEpi, không phải trang này. |
Cochran, và vì sao mọi phương pháp khác đều là cách tính tắt của nó
Công thức Cochran là công thức ở đầu trang này: n0 = z bình phương nhân p nhân (1 trừ p), chia cho E bình phương, sau đó hiệu chỉnh tổng thể hữu hạn khi tổng thể nhỏ. Các phương pháp có tên gọi khác cố định một số giá trị đầu vào đó để phép tính ngắn hơn. Khi bạn biết điều này, cả nhóm phương pháp không còn trông như bốn quy tắc cạnh tranh nhau mà trông như một quy tắc với ba thiết lập sẵn.
Yamane và Slovin: dùng khi đã hiểu rõ
Công thức n = N / (1 + N x e^2) xuất hiện trong hàng nghìn luận văn, thường được ghi là của Slovin. Nó tính nhanh: với N = 1.000 và e = 0,05, nó cho ra 286.
Có ba điều nên biết trước khi bạn trích dẫn nó.
- Đó là công thức Cochran với các thiết lập bị khóa cứng. Suy ngược lại, công thức này là công thức tỷ lệ với p cố định ở 0,5, mức tin cậy cố định ở 95% và z được làm tròn từ 1,96 thành 2. Nó không thể trả lời câu hỏi ở bất kỳ mức tin cậy nào khác, và hoàn toàn không có đầu vào nào cho mức độ biến thiên của tổng thể. Hai tổng thể cùng quy mô nhưng có độ phân tán khác xa nhau lại nhận cùng một đáp án, điều không thể đúng.
- Phép làm tròn đó là lý do các con số của nó cao hơn. Với z = 2, mức trần của công thức cho tổng thể không giới hạn đúng bằng 1 chia cho e bình phương, tức 400. Mức trần của Cochran là 384,16, vì 1,96 bình phương là 3,8416 chứ không phải 4. Mọi con số Yamane trong bảng ở trên đều lớn hơn con số Cochran vài phần trăm vì đúng lý do đó. Nếu bạn từng thắc mắc vì sao hai cuốn giáo trình cho bạn hai cỡ mẫu khác nhau cho cùng một nghiên cứu, thì đó thường là câu trả lời.
- Việc ghi tên tác giả không đứng vững. Một tạp chí thống kê đã truy lại lịch sử của công thức và kết luận rằng không thể tìm thấy người nào tên Slovin đứng sau nó, và nguồn cổ nhất có thể truy được là giáo trình năm 1967 của Taro Yamane. Wolfram MathWorld mô tả nó là một công thức tùy biến thiếu chặt chẽ về mặt toán học. Nếu khoa của bạn yêu cầu dùng nó, hãy dùng và trích dẫn Yamane thay vì Slovin. Nếu được lựa chọn, hãy dùng Cochran, vì nó trả lời được câu hỏi con số 95% đến từ đâu.
Các quy tắc kinh nghiệm, được đánh giá trung thực
Những quy tắc này được lan truyền rộng rãi. Một số hữu ích, một số chỉ là truyền miệng, và nên biết cái nào là cái nào.
- Ít nhất 30 mỗi nhóm. Hợp lý làm mức sàn cho việc so sánh nhóm, không phải làm mục tiêu. Nó xuất phát từ điểm mà phân phối mẫu bắt đầu ổn định, không phải từ yêu cầu nào về độ chính xác.
- Mười trường hợp cho mỗi biến trong hồi quy. Một quy tắc kinh nghiệm dùng được, được sử dụng rộng rãi và cũng bị chỉ trích rộng rãi. Hãy nêu nó như một quy tắc kinh nghiệm, đừng bao giờ như một quy định.
- Mười phần trăm tổng thể. Quy tắc này đơn giản là sai và bảng ở trên cho thấy vì sao. Mười phần trăm của 100.000 là 10.000 lượt trả lời, trong khi 383 đã cho bạn cùng độ chính xác.
- Luôn là 385. Chỉ đúng với tổng thể lớn ở mức 95% và 5 điểm. Hãy trích dẫn kèm các điều kiện đó, nếu không nó chẳng có ý nghĩa gì.
- n nhỏ cho nghiên cứu khả năng sử dụng và nghiên cứu sản phẩm. Nielsen Norman Group công bố phiên bản trung thực của quy tắc này: 40 người tham gia cho bạn một phép đo có/không với độ chính xác cộng trừ 15 điểm ở mức tin cậy 95%, và 47 người cho bạn một giá trị trung bình với cùng độ chính xác. Các con số đó nhỏ vì mức độ chính xác được đặt ra khá rộng. Hãy nói rõ độ chính xác, và mẫu nhỏ sẽ không còn đáng ngại.
Nếu nghiên cứu của bạn so sánh các nhóm thay vì ước lượng một tỷ lệ phần trăm, cỡ mẫu trở thành câu hỏi về độ mạnh thống kê và đây không phải công cụ tính phù hợp. Bạn cần một cỡ hiệu ứng mà bạn sẵn sàng bảo vệ, cùng với alpha và độ mạnh thống kê. G*Power và OpenEpi là các công cụ miễn phí mà hầu hết người hướng dẫn mong đợi, và cả hai đều miễn phí. Nói rõ một công cụ dừng ở đâu hữu ích hơn là giả vờ nó làm được mọi thứ.
Nghiên cứu định tính được xác định cỡ mẫu theo cách khác
Phỏng vấn và nhóm tập trung không được xác định cỡ mẫu bằng sai số biên, vì chúng không ước lượng một tỷ lệ phần trăm của tổng thể. Lập luận thường dùng là bão hòa: bạn tiếp tục cho đến khi người tham gia mới không còn đem lại chủ đề mới, rồi báo cáo điều đó xảy ra ở đâu và bạn đánh giá thế nào. Đưa một nghiên cứu định tính qua công cụ tính này sẽ cho ra một con số trông chính xác nhưng vô nghĩa.
Nếu bạn cần kết quả theo nhóm con, hãy tính cỡ mẫu cho nhóm con
Hầu hết các khảo sát được yêu cầu báo cáo theo khu vực, vai trò, thâm niên hoặc dòng sản phẩm. Đây là chỗ các kế hoạch chọn mẫu âm thầm đổ vỡ, và quy tắc rất ngắn.
Sai số biên chỉ áp dụng cho một nhóm nếu nhóm đó có đủ số lượt hoàn tất đó. Nếu bạn muốn cộng trừ 5 điểm cho mỗi khu vực trong sáu khu vực, bạn cần khoảng 385 lượt hoàn tất ở mỗi khu vực, không phải 385 tổng cộng. Đó là một khảo sát lớn gấp sáu lần quy mô bạn tưởng mình đang lên kế hoạch.
Hai cách giải quyết trung thực:
- Chọn mẫu dôi cho các nhóm nhỏ. Chủ động mời tỷ lệ cao hơn ở các phân khúc nhỏ để mỗi phân khúc đạt mục tiêu riêng. Sau đó bạn gán trọng số để đưa kết quả về đúng tỷ lệ.
- Chấp nhận khoảng rộng hơn cho các kết quả chi tiết. Giữ một con số tổng thể vững chắc và công bố từng nhóm con kèm sai số biên riêng, lớn hơn, ngay bên cạnh. Đây thường là cách đúng.
Công cụ tính có một ô cho việc này. Đặt Số nhóm con cần báo cáo riêng bằng số nhóm bạn phải báo cáo kết quả, và công cụ sẽ tính cỡ mẫu đúng cho từng nhóm rồi cộng tổng.
Hãy xác định phạm vi trước khi triển khai. Liệt kê các phân khúc bạn bắt buộc phải báo cáo, không phải những phân khúc có thì tốt. Ước lượng số lượt hoàn tất mà mỗi phân khúc thực tế có thể đạt được, dùng câu hỏi nhân khẩu học để xác định chúng. Nếu một phân khúc chỉ có thể cho 80 lượt trả lời, đừng hứa cộng trừ 5 điểm cho nó. Với 80 lượt trả lời, khoảng là cộng trừ 11 điểm.
AAPOR dùng một ví dụ tính toán đáng ghi nhớ. Một khảo sát 1.000 người trưởng thành có sai số biên tổng thể khoảng cộng trừ 3 điểm. Nếu 200 người trong số đó là nhóm con bạn thực sự muốn nói đến, sai số biên của nhóm con đó là cộng trừ 6,9 điểm, gấp hơn hai lần. Con số nổi bật ở trang đầu báo cáo không phải là con số chi phối biểu đồ ở trang chín.
Các hướng dẫn đã công bố về cỡ ô tối thiểu cũ hơn và lỏng hơn các công thức, và có thể coi chúng là mức sàn thay vì mục tiêu: khoảng 100 lượt trả lời cho một nhóm con bạn sẽ báo cáo đầy đủ, và 20 đến 50 cho một nhóm nhỏ bạn chỉ nhắc qua.
Những chỗ việc lập kế hoạch cỡ mẫu bị sai
Cỡ mẫu kiểm soát sai số chọn mẫu, phần nhiễu ngẫu nhiên do không hỏi tất cả mọi người. Khảo sát thực tế còn có sai số hệ thống, loại sai số mà không cỡ mẫu nào khắc phục được và một mẫu lớn còn có thể che giấu.
Coi mẫu thuận tiện như mẫu xác suất
Mọi công thức ở đây đều giả định rằng mỗi người có một khả năng được chọn đã biết và khác 0, và việc trả lời không gắn chặt với điều bạn đang đo. Một liên kết mở trên mạng xã hội không đáp ứng điều kiện nào trong hai điều đó. Bạn vẫn có thể tính sai số biên từ các lượt trả lời, nó sẽ trông rất yên tâm, nhưng nó sẽ không mang đúng ý nghĩa của nó. Hãy nói rõ bạn thực sự đã lấy loại mẫu nào.
Coi n lớn hơn là đo lường tốt hơn
Một mẫu lớn khiến một phép đo nhiễu trở thành nhiễu một cách chính xác. Nếu một câu hỏi mơ hồ, hỏi hai trong một hoặc mang tính dẫn dắt, thêm lượt trả lời cũng không cứu được nó. Tỷ lệ bỏ qua cao và câu trả lời không nhất quán là dấu hiệu cần sửa công cụ đo trước. Viết lại một câu hỏi tồi thường hiệu quả hơn tăng gấp ba cỡ mẫu.
Chọn độ chính xác mà không có quyết định nào đằng sau
Độ chính xác chỉ có đáp án đúng khi bạn biết nó dùng để làm gì. Một cỡ mẫu dễ bảo vệ khi bạn có thể hoàn thành câu này: chúng tôi cần phân biệt được các kết quả chênh nhau X điểm. Nó không thể bảo vệ khi lý do duy nhất là con số lớn hơn khiến bạn thấy an toàn hơn. Hãy gắn nó với thiết kế nghiên cứu của bạn và với việc bạn sẽ làm gì với kết quả.
Các con số trên trang này, và chúng đáng tin đến đâu
Mọi con số được nêu ở trên hoặc là phép tính bạn có thể tái tạo trong công cụ tính, hoặc là trích dẫn bạn có thể kiểm tra. Hạng A nghĩa là đã được lặp lại hoặc tính trực tiếp được, B nghĩa là một nghiên cứu đơn lẻ nhưng vững chắc, C nghĩa là được lặp lại rộng rãi nhưng còn tranh cãi.
| Nhận định | Con số | Mức | Nguồn |
|---|---|---|---|
| Ở mức tin cậy 95% và không có ước lượng trước, một tổng thể lớn cần 385 lượt trả lời hoàn tất để đạt cộng trừ 5 điểm. | 385 | A | Tính trực tiếp từ công thức tỷ lệ tiêu chuẩn. NIST mục 3.3.3; Israel (1992). |
| Công thức trên trang này tái tạo bảng cỡ mẫu Krejcie và Morgan đã công bố, lệch không quá một lượt trả lời ở cả 21 quy mô tổng thể chúng tôi đã kiểm tra. | 21 trên 21 lệch không quá 1 | A | Chúng tôi tự đối chiếu với Krejcie và Morgan (1970). Phương pháp được nêu bên dưới bảng. |
| Tỷ lệ trả lời là yếu tố dự báo yếu cho sai lệch do không trả lời. Một phân tích tổng hợp 59 nghiên cứu chuyên về sai lệch chỉ thấy một mối quan hệ nhỏ giữa hai yếu tố này. | 59 nghiên cứu | A | Groves và Peytcheva (2008), Public Opinion Quarterly. |
| Pew đã chạy cùng một bảng câu hỏi ở tỷ lệ trả lời 9% và 22%. Trong 40 câu hỏi chung, 28 câu cho kết quả chênh nhau trong vòng 2 điểm. | 28 trên 40 trong vòng 2 điểm | B | Pew Research Center (2012), Assessing the Representativeness of Public Opinion Surveys. |
| Nhưng trong khảo sát mức độ hài lòng, mối quan hệ này có thật và lớn. Trên 717 khảo sát bệnh viện, điểm hài lòng trung bình tương quan với tỷ lệ trả lời ở mức r = 0,61. | r = 0.61 | B | Perneger, Peytremann-Bridevaux và Combescure (2020), BMC Health Services Research. |
| Tỷ lệ trả lời khảo sát nhân viên gần như đi đúng theo quy mô tổ chức. Năm 2024, khảo sát nhân viên liên bang Hoa Kỳ đạt 71% ở các cơ quan dưới 1.000 người và 37% ở các cơ quan trên 75.000 người. | 71% so với 37% | A | US Office of Personnel Management (2024), FEVS Governmentwide Management Report, hơn 1,6 triệu nhân viên được mời. |
| Tỷ lệ trả lời trung bình của 1.071 khảo sát trực tuyến đã công bố là 44,1%. Không có một tỷ lệ bình thường duy nhất. | 44,1% | A | Wu, Zhao và Fils-Aime (2022), phân tích tổng hợp, Computers in Human Behavior Reports. |
| Khảo sát web có tỷ lệ trả lời thấp hơn khoảng 12 điểm phần trăm so với các hình thức khác, qua 114 phép so sánh thực nghiệm. | thấp hơn 12 điểm | A | Daikeler, Bosnjak và Lozar Manfreda (2020), phân tích tổng hợp, JSSAM. |
| Giảm sai số biên đi một nửa sẽ nhân cỡ mẫu cần có lên khoảng bốn lần, vì n tỷ lệ với 1 chia cho E bình phương. Tăng gấp đôi cỡ mẫu từ 1.000 lên 2.000 chỉ mua được khoảng một điểm. | khoảng 4 lần | A | Tính chất đại số của công thức; AAPOR nêu rõ trường hợp từ 1.000 lên 2.000. |
| Giả định p = 0,5 thay vì p = 0,9 đã biết làm cỡ mẫu bạn được yêu cầu thu thập tăng gần gấp ba, từ 139 lên 385. | 139 so với 385 | A | Tính trực tiếp. Có thể tái tạo trong công cụ tính bằng cách thay đổi kết quả dự kiến. |
| Cả 87 mẫu khảo sát đã công bố trên trang này đều có 14 câu hỏi trở xuống, và 86 trong 87 mẫu có 10 câu hỏi trở xuống. 785 trong 799 câu hỏi của chúng đã được xác nhận trên các trang đã công bố. | 87 mẫu, 799 câu hỏi | A | Chúng tôi tự đếm kho mẫu đang hoạt động, ngày 21 tháng 8 năm 2026, đối chiếu lại với cả 87 trang đã công bố. Phương pháp, phần rà soát thủ công và tỷ lệ xác minh được nêu cùng bảng. |
| Không có người nào tên Slovin có thể truy được đứng sau công thức mang tên này. Nguồn cổ nhất có thể truy được là Yamane (1967). | không truy được tác giả | B | Tejada và Punzalan (2012), The Philippine Statistician; Wolfram MathWorld gọi nó là công thức tùy biến. |
“Bạn luôn cần 385 lượt trả lời.” Chỉ đúng ở mức tin cậy 95%, cộng trừ 5 điểm, p = 0,5 và tổng thể lớn. Nêu trơ trọi như vậy, nó sai với mọi tổng thể nhỏ.
“Hãy khảo sát 10% tổng thể của bạn.” Không có cơ sở thống kê nào cho điều này. Nó lấy mẫu quá nhiều với tổng thể lớn và quá ít với tổng thể nhỏ.
“Tỷ lệ trả lời dưới 50 hoặc 60% làm khảo sát mất giá trị.” Không có ngưỡng nào làm được điều đó. Thang 50, 60 và 70% là một quy tắc kinh nghiệm trong giáo trình không có cơ sở thực nghiệm nào, và phân tích tổng hợp của Groves và Peytcheva mâu thuẫn với nó. Tỷ lệ trả lời giới hạn mức sai lệch trong trường hợp xấu nhất. Nó không đo sai lệch thực tế.
“Tỷ lệ trả lời khảo sát trung bình là X%.” Các con số đã được kiểm chứng trong cùng vài năm dao động từ 6% đến 71%, hoàn toàn tùy thuộc vào việc ai được khảo sát. Bất kỳ con số trung bình đơn lẻ nào cũng đang che giấu điều đó. Thay vào đó, hãy trích dẫn dòng phù hợp với tình huống của bạn trong bảng ở trên.
Công thức Slovin được trình bày như một phép suy dẫn. Đó là công thức Cochran với mức tin cậy 95% và p = 0,5 được cố định sẵn và z làm tròn thành 2, và việc ghi tên Slovin không có nguồn nào truy được.
Mẫu lập luận
Hầu hết các lập luận về cỡ mẫu thất bại vì các giả định chưa bao giờ được ghi lại. Nút Sao chép lập luận trong công cụ tính viết sẵn nội dung này với chính các con số của bạn. Nếu bạn muốn tự soạn, đây là chín điều mà người thẩm định sẽ tìm.
- Tổng thể (N): định nghĩa tổng thể và nêu số lượng. Ví dụ: tất cả khách hàng hoạt động trong 90 ngày qua, N = 48.200.
- Bạn đang đo gì: một tỷ lệ (phần trăm) hay một giá trị trung bình (điểm đánh giá trung bình). Công thức ở đây tính cỡ mẫu cho tỷ lệ, bao quát hầu hết các KPI được báo cáo.
- Mức tin cậy: mức bạn đã chọn và lý do. Quy ước và mức chấp nhận rủi ro đều là lý do chấp nhận được nếu bạn nói rõ.
- Sai số biên (E): độ chính xác mục tiêu tổng thể, và riêng cho từng nhóm con mà bạn đã hứa báo cáo.
- Tỷ lệ giả định (p): giá trị được dùng và nguồn của nó. Hãy nói thẳng nếu đó là 0,5 vì không có giá trị nào tốt hơn.
- Hiệu chỉnh tổng thể hữu hạn: bạn có áp dụng hay không và điều gì dẫn đến việc áp dụng, chẳng hạn n0 vượt quá 10% của N.
- Mục tiêu lượt hoàn tất (n): số lượt trả lời hoàn tất cuối cùng cần có sau mọi điều chỉnh.
- Tỷ lệ trả lời dự kiến: tỷ lệ được giả định, dữ liệu lịch sử làm căn cứ, và số lời mời tương ứng.
- Cách bạn chọn người tham gia: ngẫu nhiên đơn giản, phân tầng, tổng điều tra hay thuận tiện, cùng việc chọn mẫu dôi cho các phân khúc chính nếu có. Hãy gọi tên trung thực.
Khi khảo sát đã được triển khai, hãy tiếp tục theo dõi số lượt hoàn tất theo từng phân khúc thay vì chỉ xem tổng. Một con số tổng thể khả quan có thể che giấu một phân khúc sẽ không bao giờ đạt mục tiêu, và đó là vấn đề bạn còn sửa được ở tuần đầu tiên nhưng không sửa được ở tuần thứ tư. Khi báo cáo, hãy đi kèm mỗi tỷ lệ phần trăm với sai số biên của nó, và đọc cách phân tích dữ liệu khảo sát trước khi coi một thay đổi hai điểm là thật.
Bảng lập kế hoạch cỡ mẫu
Một trang bạn có thể in, điền bằng tay và kẹp vào bản mô tả dự án. Điền cột giữa trước khi bắt đầu thu thập dữ liệu, không phải sau đó. Không có gì được gửi đi đâu cả và không cần tài khoản.
| Quyết định | Giá trị của bạn | Gợi ý |
|---|---|---|
| Tổng thể (N) | Chính xác là ai, và có bao nhiêu người. Hãy viết định nghĩa, không chỉ con số. | |
| Bạn đang đo gì | Một tỷ lệ phần trăm hay một giá trị trung bình. Trang này tính cỡ mẫu cho tỷ lệ phần trăm. | |
| Mức tin cậy | 95% trừ khi bạn có lý do. Hãy ghi lý do. | |
| Sai số biên (E) | Chênh lệch bạn cần phân biệt được, tính bằng điểm. | |
| Tỷ lệ giả định (p) | 0,5 nếu không có giá trị nào tốt hơn. Nêu rõ nguồn nếu dùng giá trị khác. | |
| Hiệu chỉnh tổng thể hữu hạn | Có áp dụng hay không, và điều gì dẫn đến việc áp dụng. | |
| Mục tiêu lượt hoàn tất (n) | Con số cuối cùng sau mọi điều chỉnh. | |
| Số nhóm con báo cáo riêng | Bao nhiêu nhóm, và số lượt hoàn tất mỗi nhóm phải tự đạt được. | |
| Tỷ lệ trả lời dự kiến | Tỷ lệ, và dữ liệu lịch sử đằng sau nó. Không phải một con số lấy trên mạng. | |
| Số lời mời cần gửi | Lượt hoàn tất chia cho tỷ lệ, làm tròn lên. Không bao giờ lớn hơn N. | |
| Cách chọn người tham gia | Ngẫu nhiên, phân tầng, tổng điều tra hay thuận tiện. Hãy gọi tên trung thực. | |
| Mốc kiểm tra trong quá trình thu thập | Ngày bạn sẽ kiểm tra số lượt hoàn tất theo từng phân khúc, không chỉ tổng số. |
Công thức: n0 = (z^2 x p x (1 - p)) / E^2, rồi n = n0 / (1 + (n0 - 1) / N). Nguồn: Cochran (1977); NIST/SEMATECH e-Handbook mục 3.3.3; Israel (1992). Bảng lập kế hoạch từ https://www.supersurvey.com/Sample-Size
Câu hỏi thường gặp
Cỡ mẫu là gì?
Cỡ mẫu là số lượt trả lời hoàn tất trong một khảo sát, ký hiệu là n. Nó không phải là số người bạn đã mời, và cũng không phải quy mô của tổng thể bạn đang mô tả. Đó là số lượng bạn có khi kết thúc thu thập dữ liệu, và là con số dùng để tính sai số biên: 385 lượt trả lời hoàn tất cho khoảng cộng trừ 5 điểm ở mức tin cậy 95% khi tổng thể lớn. Cỡ mẫu là gì trình bày sự khác biệt giữa tổng thể, số lời mời và n.
Tôi cần bao nhiêu lượt trả lời cho một khảo sát?
Với hầu hết các khảo sát, đáp án thực tế là 385 lượt trả lời hoàn tất. Đó là kết quả công thức trả về ở mức tin cậy 95%, sai số biên cộng trừ 5 điểm phần trăm, và không có ước lượng trước nào về kết quả. Nếu tổng thể của bạn nhỏ, bạn cần ít hơn: 278 cho danh sách 1.000 người, 80 cho danh sách 100 người. Hãy nhập các con số của bạn vào công cụ tính để xem con số chính xác và phép tính đằng sau.
Tôi cần cỡ mẫu bao nhiêu cho mức tin cậy 95% và sai số biên 5%?
385 lượt trả lời hoàn tất, nếu tổng thể lớn và bạn dùng p = 0,5. Phép tính là n0 = 1,96 bình phương nhân 0,5 nhân 0,5, chia cho 0,05 bình phương, tức 0,9604 chia cho 0,0025, bằng 384,16. Làm tròn lên được 385. Nếu tổng thể của bạn nhỏ, hãy áp dụng hiệu chỉnh tổng thể hữu hạn và con số sẽ giảm.
Sai số biên là gì?
Sai số biên là khoảng cộng trừ quanh một kết quả khảo sát, sinh ra do bạn chỉ lấy mẫu một số người thay vì tất cả. Một kết quả 62% với sai số biên 5 điểm nghĩa là phương pháp này phần lớn thời gian sẽ tạo ra một khoảng chứa giá trị thật, và khoảng cụ thể này chạy từ 57 đến 67%. Nó chỉ mô tả sai số chọn mẫu ngẫu nhiên. Nó không nói gì về những người không bao giờ trả lời.
Làm thế nào để tính sai số biên?
Lấy căn bậc hai của p nhân (1 trừ p) chia cho n, rồi nhân với điểm z ứng với mức tin cậy của bạn. Ở mức tin cậy 95%, 385 lượt trả lời và p = 0,5, phép tính là 1,96 nhân căn bậc hai của 0,25 chia cho 385, tức 1,96 nhân 0,025482, bằng 0,0499. Vậy sai số biên là cộng trừ 5,0 điểm phần trăm. Công cụ tính sai số biên trên trang này làm việc đó cho bạn và hiển thị cách tính.
Sai số biên có tăng theo cỡ mẫu không?
Không, nó giảm, và giảm theo căn bậc hai của cỡ mẫu. Đi từ 100 lượt trả lời lên 400 làm sai số biên giảm một nửa. Đi từ 400 lên 1.600 lại giảm một nửa nữa. Quan hệ căn bậc hai đó là lý do độ chính xác trở nên đắt đỏ: mỗi chữ số thập phân độ chính xác tăng thêm tốn khoảng gấp bốn lần số lượt trả lời.
Sai số biên có giống sai số chuẩn không?
Không. Sai số chuẩn là độ phân tán nội tại của ước lượng. Sai số biên là sai số chuẩn nhân với điểm z ứng với mức tin cậy bạn đã chọn. Ở mức tin cậy 95%, sai số biên xấp xỉ 1,96 lần sai số chuẩn. Sai số chuẩn là một tính chất của dữ liệu. Sai số biên là một lựa chọn báo cáo đặt chồng lên trên nó.
Cỡ mẫu bao nhiêu là tốt cho nghiên cứu định lượng?
Không có một con số tốt duy nhất, và bất kỳ nguồn nào đưa cho bạn một con số mà không hỏi bạn đang đo gì đều chỉ đang đoán. Với một nghiên cứu báo cáo tỷ lệ phần trăm từ một tổng thể dưới khoảng 10.000 người, đáp án có thể bảo vệ được là bất cứ giá trị nào công thức trả về ở mức tin cậy 95% và một sai số biên bạn có thể lý giải. Với danh sách 1.000 người, đó là 278. Con số giúp một chương phương pháp được duyệt không phải là một con số lớn, mà là một con số được nêu rõ, có mức tin cậy, sai số biên, tỷ lệ giả định và tổng thể ghi bên cạnh. Xem cỡ mẫu cho nghiên cứu định lượng để biết các công thức có tên gọi mà người hướng dẫn có thể mong đợi.
Tỷ lệ trả lời khảo sát bình thường là bao nhiêu?
Không có một tỷ lệ bình thường duy nhất, và bất kỳ trang nào đưa ra một con số đều chỉ đang đoán. Các con số thực tế, có nguồn, từ cùng một giai đoạn dao động từ 6% (thăm dò qua điện thoại của Pew năm 2018) đến 71% (các cơ quan liên bang nhỏ của Hoa Kỳ trong Federal Employee Viewpoint Survey năm 2024). Một phân tích tổng hợp 1.071 khảo sát trực tuyến đã công bố cho thấy mức trung bình 44,1%. Quy mô tổ chức có ảnh hưởng rất lớn: cùng khảo sát liên bang đó đạt 71% ở các cơ quan dưới 1.000 người và 37% ở các cơ quan trên 75.000 người. Hãy dùng dữ liệu lịch sử của chính bạn trước, và xem bảng chuẩn tham chiếu để có các con số có thể trích dẫn.
Quy mô tổng thể có ảnh hưởng đến cỡ mẫu không?
Hầu như không, cho đến khi mẫu của bạn chiếm một phần lớn của tổng thể. Đi từ 100.000 người lên 1.000.000 người chỉ làm số cần có thay đổi từ 383 lên 385. Đi từ 1.000 người xuống 100 người làm nó thay đổi từ 278 xuống 80. Quy mô tổng thể chỉ quan trọng ở phía nhỏ, đúng là chỗ hiệu chỉnh tổng thể hữu hạn được áp dụng.
Khi nào p = 0,5 là lựa chọn đúng?
Dùng p = 0,5 bất cứ khi nào bạn không có ước lượng trước có thể bảo vệ được. Tích p nhân (1 trừ p) lớn nhất tại 0,5, nên nó cho ra cỡ mẫu cần có lớn nhất. Điều đó làm nó trở thành giả định an toàn: mẫu của bạn không thể bị thiếu. Nếu bạn có một đợt khảo sát thí điểm, một chuẩn tham chiếu hoặc con số năm ngoái, hãy dùng nó. Giả định p = 0,9 thay vì 0,5 cắt cỡ mẫu cần có từ 385 xuống 139.
Nếu mời thêm người, tôi có loại bỏ được sai lệch do không trả lời không?
Không. Thêm lời mời giúp bạn có thêm lượt hoàn tất, làm giảm sai số biên. Sai lệch là một vấn đề riêng: nó phụ thuộc vào việc những người đã trả lời có khác những người không trả lời hay không. Một phân tích tổng hợp 59 nghiên cứu về sai lệch do không trả lời chỉ thấy một mối quan hệ nhỏ giữa tỷ lệ trả lời và sai lệch thực tế. Pew đã chạy cùng một bảng câu hỏi hai lần, ở tỷ lệ trả lời 9% và 22%, và 28 trong 40 câu hỏi chung cho kết quả chênh nhau trong vòng 2 điểm. Xem sai lệch trả lời và sai lệch do không trả lời.
Tôi xử lý cỡ mẫu thế nào nếu cần kết quả theo phòng ban hoặc khu vực?
Tính cỡ mẫu riêng cho từng nhóm con. Sai số biên chỉ áp dụng cho một nhóm nếu nhóm đó có đủ số lượt hoàn tất đó. Nếu bạn muốn cộng trừ 5 điểm cho mọi khu vực, mỗi khu vực cần 385 lượt hoàn tất của riêng mình, hoặc con số đã hiệu chỉnh tổng thể hữu hạn của riêng mình. Dùng câu hỏi nhân khẩu học để xác định các nhóm và lên kế hoạch chọn mẫu dôi cho các nhóm nhỏ.
Tôi cần cỡ mẫu bao nhiêu để có kết quả có ý nghĩa thống kê?
Câu hỏi đó trộn lẫn hai ý tưởng. Công thức cỡ mẫu tính cỡ mẫu cho một ước lượng theo độ chính xác đã chọn. Kiểm định ý nghĩa thống kê so sánh hai con số và hỏi liệu chênh lệch có thể là do ngẫu nhiên hay không. Cỡ mẫu bạn cần phụ thuộc vào chênh lệch nhỏ đến đâu mà bạn muốn phát hiện được, không phụ thuộc vào một ngưỡng cố định. Hãy tính cỡ mẫu khảo sát ở đây, rồi đọc ý nghĩa thống kê trước khi kiểm định kết quả này với kết quả khác.
Các công thức này có dùng được cho nghiên cứu định tính không?
Không. Phỏng vấn, nhóm tập trung và các nghiên cứu mở không được xác định cỡ mẫu bằng sai số biên, vì chúng không ước lượng một tỷ lệ phần trăm của tổng thể. Cỡ mẫu định tính được lập luận dựa trên sự bão hòa, tức điểm mà người tham gia mới không còn đem lại chủ đề mới, và được báo cáo như một đánh giá kèm bằng chứng chứ không phải một công thức. Đừng đưa một nghiên cứu định tính qua công cụ tính này.
Tài liệu tham khảo
- National Institute of Standards and Technology (NIST). (n.d.). Selecting Sample Sizes. In NIST/SEMATECH e-Handbook of Statistical Methods, section 3.3.3.
- Israel, G. D. (1992). Determining Sample Size (Fact Sheet PEOD6). University of Florida, IFAS Extension.
- Krejcie, R. V., & Morgan, D. W. (1970). Determining Sample Size for Research Activities. Educational and Psychological Measurement, 30(3), 607-610.
- Groves, R. M., & Peytcheva, E. (2008). The Impact of Nonresponse Rates on Nonresponse Bias: A Meta-Analysis. Public Opinion Quarterly, 72(2), 167-189.
- American Association for Public Opinion Research (AAPOR). Margin of Sampling Error and Credibility Interval.
- Tejada, J. J., & Punzalan, J. R. B. (2012). On the Misuse of Slovin's Formula. The Philippine Statistician, 61(1), 129-136.
- Weisstein, E. W. Slovin's Formula. Wolfram MathWorld.
- US Office of Personnel Management. (2024). Federal Employee Viewpoint Survey: Governmentwide Management Report.
- Pew Research Center. (2012). Assessing the Representativeness of Public Opinion Surveys.
- Kennedy, C., & Hartig, H. (2019). Response rates in telephone surveys have resumed their decline. Pew Research Center.
- Wu, M.-J., Zhao, K., & Fils-Aime, F. (2022). Response rates of online surveys in published research: A meta-analysis. Computers in Human Behavior Reports, 7, 100206.
- Holtom, B., Baruch, Y., Aguinis, H., & Ballinger, G. A. (2022). Survey response rates: Trends and a validity assessment framework. Human Relations, 75(8), 1560-1584.
- Perneger, T. V., Peytremann-Bridevaux, I., & Combescure, C. (2020). Patient satisfaction and survey response in 717 hospital surveys in Switzerland. BMC Health Services Research, 20, 158.
- Daikeler, J., Bosnjak, M., & Lozar Manfreda, K. (2020). Web Versus Other Survey Modes: An Updated and Extended Meta-Analysis Comparing Response Rates. Journal of Survey Statistics and Methodology, 8(3), 513-539.
- Althubaiti, A. (2023). Sample size determination: A practical guide for health researchers. Journal of General and Family Medicine, 24(2), 72-78.
- Nielsen Norman Group. (2022). Summary of Sample Sizes Used in Quantitative UX Research.